
实战指南:如何免费接入AI大模型API并优化生产环境性能
快速体验
在开始今天关于 实战指南:如何免费接入AI大模型API并优化生产环境性能 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
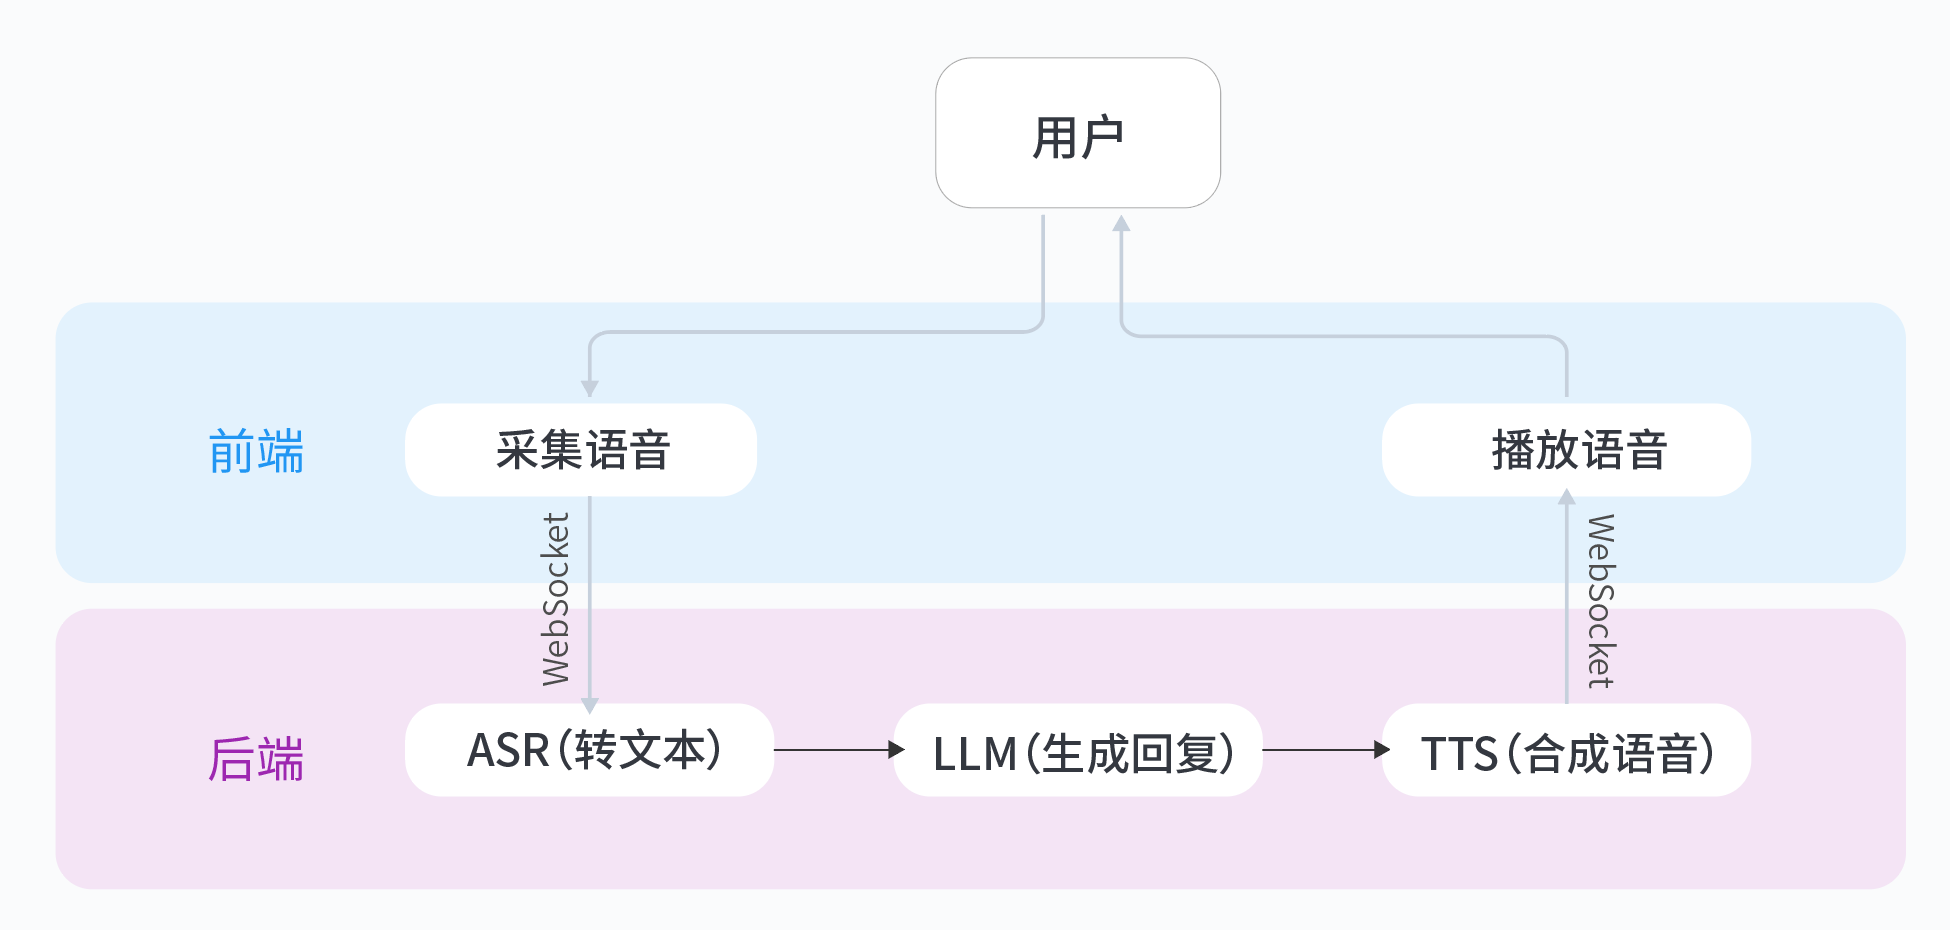
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
实战指南:如何免费接入AI大模型API并优化生产环境性能
背景痛点分析
免费AI大模型API虽然降低了技术门槛,但在实际应用中常遇到三类典型问题:
- 身份认证复杂化:不同平台采用OAuth2.0、API Key、临时令牌等多种鉴权方式,调试阶段容易因配置错误导致403拒绝访问
- 速率限制严格:免费层通常限制QPS(每秒查询数)在5-20次,突发流量会直接触发429 Too Many Requests错误
- 响应格式差异:JSON结构体字段命名不统一,部分平台返回streaming数据时需要特殊处理
主流平台API特性对比
通过实测对比三大平台的免费层限制:
-
OpenAI GPT-3.5
- QPS:20次/秒
- 每月免费额度:约100万tokens
- 特殊限制:禁止商用场景
-
Claude Instant
- QPS:15次/秒
- 上下文长度:9K tokens
- 优势:支持超长文本处理
-
文心一言
- QPS:10次/秒
- 每日免费额度:50万字符
- 特色:中文优化效果突出
核心实现方案
异步请求批处理
使用Python的asyncio+aiohttp实现高并发请求:
import aiohttp
import asyncio
from typing import List, Dict

async def batch_query(
    prompts: List[str],
    api_url: str,
    api_key: str,
    max_concurrency: int = 5
) -> List[Dict]:
    """
    异步批量查询大模型API
    :param prompts: 待处理的文本列表
    :param api_url: API端点地址
    :param api_key: 认证密钥
    :param max_concurrency: 最大并发数
    """
    semaphore = asyncio.Semaphore(max_concurrency)

    async def _query(prompt: str) -> Dict:
        async with semaphore:
            async with aiohttp.ClientSession() as session:
                headers = {"Authorization": f"Bearer {api_key}"}
                async with session.post(
                    api_url,
                    json={"prompt": prompt},
                    headers=headers
                ) as resp:
                    return await resp.json()

    return await asyncio.gather(*[_query(p) for p in prompts])
指数退避重试机制
import random
from time import sleep

def exponential_backoff_retry(
    func,
    max_retries: int = 3,
    initial_delay: float = 1.0
):
    """实现指数退避的重试装饰器"""
    def wrapper(*args, **kwargs):
        retries = 0
        while retries < max_retries:
            try:
                return func(*args, **kwargs)
            except Exception as e:
                if "429" in str(e):
                    delay = initial_delay * (2 ** retries)
                    delay += random.uniform(0, 0.2)  # 添加抖动
                    sleep(delay)
                    retries += 1
                else:
                    raise
        raise Exception("Max retries exceeded")
    return wrapper
Streaming响应处理示例
async def handle_stream_response(url: str):
    async with aiohttp.ClientSession() as session:
        async with session.get(url) as resp:
            async for chunk in resp.content:
                if chunk:
                    yield chunk.decode('utf-8')
性能优化技巧
本地缓存策略
使用functools实现LRU缓存:
from functools import lru_cache

@lru_cache(maxsize=1000)
def cached_query(prompt: str) -> str:
    """带缓存的查询函数"""
    # 实际API调用逻辑
    return api_call(prompt)
监控指标埋点
from prometheus_client import Summary, Counter

REQUEST_LATENCY = Summary('api_latency', 'API响应延迟')
ERROR_COUNT = Counter('api_errors', 'API错误计数')

@REQUEST_LATENCY.time()
def monitored_api_call():
    try:
        # 调用逻辑
    except Exception:
        ERROR_COUNT.inc()
        raise
避坑指南
-
处理429错误
- 优先读取响应头中的Retry-After字段
- 无明确时间时采用指数退避策略
- 在应用层实现请求队列限流
-
敏感数据过滤
def sanitize_input(text: str) -> str: patterns = [r'\d{4}-\d{4}-\d{4}', r'[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}'] for pattern in patterns: text = re.sub(pattern, '[REDACTED]', text) return text -
免费额度耗尽处理
- 降级到本地轻量模型
- 返回缓存的历史结果
- 提示用户服务受限状态
代码规范建议
所有代码应遵循:
- PEP8代码风格规范
- 关键函数添加类型注解
- 模块级docstring说明
- 错误处理覆盖所有已知异常
思考与延伸
如何设计分布式环境下的API调用配额管理系统?考虑以下维度:
- 基于Redis的分布式计数器
- 滑动窗口限流算法
- 多节点间的配额同步机制
- 动态调整策略(如夜间放宽限制)
想体验更完整的AI应用开发流程?推荐尝试从0打造个人豆包实时通话AI实验,亲手构建包含语音识别、智能对话、语音合成的完整AI交互系统。我在实际操作中发现其API接入流程非常清晰,适合快速验证创意。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
更多推荐

 10
 0
- 0


 已为社区贡献7条内容

所有评论(0)