
51.k8s的Pod管理-3
第3部:kubernetes集群概念Pod
工作负载
https://kubernetes.io/zh-cn/docs/concepts/workloads/
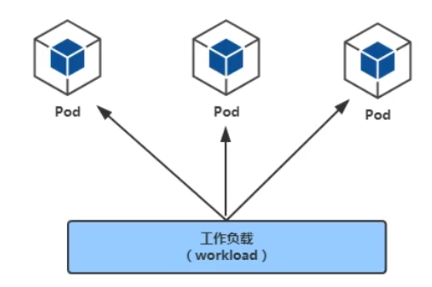
工作负载(workload)是在kubernetes集群中运行的应用程序。无论你的工作负载是单一服务还是多个一同工作的服务构成,在kubernetes中都可以使用pod来运行它。
workloads分为pod与controllers
- pod通过控制器实现应用的运行,如何伸缩,升级等
- controllers 在集群中管理pod
- pod与控制器之间通过label-selector相关联,是唯一的关联方式
在pod的YAML里指定pod标签
# 定义标签
labels:
  app: nginx
在控制器的YAML里指定标签选择器匹配标签
# 通过标签选择器选择对应的pod
selector:
  matchLabels:
    app: nginx
pod介绍
1:pod定义与分类
文档链接:https://kubernetes.io/zh-cn/docs/concepts/workloads/pods/
Pod定义
- Pod(豌豆夹)是Kubernetes集群管理(创建、部署)与调度的最小计算单元,表示处于运行状态的一组容器。
- Pod不是进程,而是容器运行的环境。
- 一个Pod可以封装一个容器或多个容器(主容器或sidecar边车容器)
- 一个pod内的多个容器之间共享部分命名空间,例如:Net Namespace,UTs Namespace,IPC Namespace及存储资源
- 用户pod默认会被调度运行在node节点之上(不运行在master节点上,但也有例外情况)
- pod内的IP不是固定的,集群外不能直接访问pod
Pod分类
- 静态Pod 也称之为“无控制器管理的自主式pod”,直接由特定节点上的 kubelet 守护进程管理,不需要API服务器看到它们,尽管大多数 Pod都是通过控制平面控制器(例如,Deployment)来管理 的,对于静态 Pod 而言,kubelet 直接监控每个 Pod,并在其失效时重启之。 (kind类型为Pod)
- 控制器管理的pod(动态pod) 控制器可以控制pod的副本数,扩容与裁剪,版本更新与回滚等 (kind类型是控制器)
2:查看pod方法
pod是一种计算资源,可以通过kubect1 get pod来查看
[root@master ~]# kubectl get pod     #pod或者pods都可以,不指定namespace,默认名是default的namespace

[root@master ~]# kubectl get pod -n kube-system
3:pod的YAML资源清单格式
先看一个yaml格式的pod定义文件解释
# yam1格式的pod定义文件完整内容:
apiVersion:v1           #必选,api版本号,例如v1
kind: Pod               #必选,Pod
metadata:               #必选,元数据
 name: string           #必选,Pod名称
 namespace:string       #Pod所属的命名空间,默认在default的namespace
 labels:                #自定义标签
   name: string         #自定义标签名字
 annotations :          #自定义注释列表
 name: string
spec:                   #必选,Pod中容器的详细定义(期望)
 containers:            #必选,Pod中容器列表
 - name: string         #必选,容器名称
   image: string        #必选,容器的镜像名称
   imagePullPolicy: [Always | Never | IfNotPresent]    #获取镜像的策略 Alawys表示下载镜像 Ifnotpresent表示优先使用本地镜像,否则下载镜像,Nerver表示仅使用本地镜像
   command: [string]       #容器的启动命令列表,如不指定,使用打包时的启动命令
   args: [string]          #容器的启动命令参数列表
   workingDir: string      #容器的工作目录
   volumeMounts:           #挂载到容器内部的存储卷配置
   - name: string          #引用pod定义的共享存储卷的名称,需用vo1umes[]部分定义的的卷名
     mountPath: string     #存储卷在容器内mount的绝对路径,应少于512字符
     readOnly:  boolean    #是否为只读模式
   ports:                  #需要暴露的端口库号列表
   - name: string          #端口号名称
     containerPort: int    #容器需要监听的端口号
     hostPort:int         #容器所在主机需要监听的端口号,默认与Container相同
     protocol: string      #端口协议,支持TCP和UDP,默认TCP
   env:                    #容器运行前需设置的环境变量列表
   - name: string          #环境变量名称
     value: string         #环境变量值
   resources:              #资源限制和请求的设置
     limits:               #资源限制设置
       cpu: string         #Cpu的限制,单位为core数,将用于docker run--cpu-shares参数
       memory: string      #内存限制,单位可以为Mib/Gib,将用于docker run --memory参数
     requests:             #资源请求的设置
       cpu: string         #cpu请求,容器启动的初始可用数量
       memory: string      #内存清求,容器启动的初始可用数量
     livenessProbe:        #对Pod内个容器健康检查的设置,当探测无响应几次后将自动重启该容器,检查方法有exec、httpGet和tcpsocket,对一个容器只需设置其中一种方法即可
       exec:                    #对Pod容器内检查方式设置为exec方式
         command: [string]      #exec方式需要制定的命令或脚本
       httpGet:                 #对Pod内个容器健康检查方法设置为HttpGet,需要制定Path、port
         path: string
         port: number
         host: string
         scheme: string
         HttpHeaders:
         - name: string
           value: string
       tcpSocket:                   #对Pod内个容器健康检查方式设置为tcpsocket方式
           port: number
         initialDelaySeconds: 0     #容器启动完成后首次探测的时间,单位为秒
         timeoutSeconds: 0          #对容器健康检查探测等待响应的超时时间,单位秒,默认1秒
         periodSeconds: 0           #对容器监控检查的定期探测时间设置,单位秒,默认10秒一次
         successThreshold: 0
         failureThreshold: 0
         securityContext:
           privileged: false
       restartPolicy: [Always | Never | OnFailure]       #pod的重启策略,Always表示一旦不管以何种方式终止运行,kubelet都将重启,0nFai1ure表示只有Pod以非0退出码退出才重启,Nerver表示不再重启该Pod
       nodeSelector: object      #设置NodeSelector表示将该Pod调度到包含这个1abel的node上,以key:value的格式指定
       imagePullSecrets:         #私有镜像仓库Pu11镜像时使用的secret名称,以key:secretkey格式指定
       - name: string
       hostNetwork:false         #是否使用主机网络模式,默认为fa1se,如果设置为true,表示使用宿主机网络
       volumes:                  #在该pod上定义共享存储卷列表
       - name: string            #共享存储卷名称(volumes类型有很多种)
         emptyDir: {}            #类型为emtyDir的存储卷,与Pod同生命周期的一个临时目录。为空值
         hostPath: string        #类型为hostPath的存储卷,表示挂载Pod所在宿主机的目录
           path: string          #Pod所在宿主机的目录,将被用于同期中mount的目录
YAML格式查找帮助
[root@master ~]# kubectl explain pod
[root@master ~]# kubectl explain pod.spec
[root@master ~]# kubectl explain pod.spec.containers
pod创建与验证
1:命令创建pod
创建名为pod-nginx的pod
[root@docker-master ~]# kubectl run -h
[root@docker-master ~]# kubectl run nginx1 --image=nginx:1.26-alpine

[root@docker-master ~]# kubectl get pods
NAME     READY   STATUS              RESTARTS   AGE
nginx1   0/1     ContainerCreating   0          21s
创建的是静态Pod,由kubelet管理
2:YAML创建pod
yaml文件
[root@master ~]# vim pod1.yml
apiVersion: v1     #api版本
kind: Pod          #资源类型为Pod
metadata:
 name: pod-stress  #自定义pod名称
spec:
 containers:       #定义pod里包含的容器
  - name: c1       #自定义pod中的容器名
   image: polinux/stress     #启动容器的镜像名
   command: ["stress"]       #自定义启动容器时要执行的命令(类似dockerfile里的CMD)
   args: ["--vm","1","--vm-bytes","150M","--vm-hang","1"]      #自定义启动容器执行命令的参数
#polinux/stress这个镜像用于压力测试,在启动容器时传命令与参数就是相当于分配容器运行时需要的压力
通过yaml文件创建pod
[root@docker-master pod.dir]# kubectl apply -f pod1.yaml
pod/pod-stress created

[root@docker-master pod.dir]# kubectl get pod
NAME         READY   STATUS              RESTARTS   AGE
nginx1       1/1     Running             0          16m
pod-stress   0/1     Running             0          17s
查看资源占用
[root@docker-master pod.dir]# kubectl top pod pod-stress
NAME         CPU(cores)   MEMORY(bytes)
pod-stress   20m          150M
描述pod详细信息
[root@docker-master pod.dir]# kubectl describe pod pod-stress
Name:             pod-stress
Namespace:        default
Priority:         0
Service Account:  default
Node:             docker-node2/192.168.108.32
Start Time:       Fri, 16 Jan 2026 10:35:23 +0800
Labels:           <none>
Annotations:      cni.projectcalico.org/containerID: 148fab97d1ad2c58b45e00ecf10185227f895d28adfb2bc338c198cd0afac29e
                  cni.projectcalico.org/podIP: 10.244.248.151/32
                  cni.projectcalico.org/podIPs: 10.244.248.151/32
Status:           Running
IP:               10.244.248.151
IPs:
  IP:  10.244.248.151
Containers:
  c1:
    Container ID:  docker://6efe3a1061cf0bb30230abbca7ef4ef7f88a122105fb423488c224f358c8ee21
    Image:         polinux/stress
    Image ID:      docker-pullable://polinux/stress@sha256:b6144f84f9c15dac80deb48d3a646b55c7043ab1d83ea0a697c09097aaad21aa
    Port:          <none>
    Host Port:     <none>
    Command:
      stress
    Args:
      --vm
      1
      --vm-bytes
      150M
      --vm-hang
      1
    State:          Running
      Started:      Fri, 16 Jan 2026 10:37:02 +0800
    Ready:          True
    Restart Count:  0
    Environment:    <none>
    Mounts:
      /var/run/secrets/kubernetes.io/serviceaccount from kube-api-access-csfnt (ro)
Conditions:
  Type              Status
  Initialized       True
  Ready             True
  ContainersReady   True
  PodScheduled      True
Volumes:
  kube-api-access-csfnt:
    Type:                    Projected (a volume that contains injected data from multiple sources)
    TokenExpirationSeconds:  3607
    ConfigMapName:           kube-root-ca.crt
    ConfigMapOptional:       <nil>
    DownwardAPI:             true
QoS Class:                   BestEffort
Node-Selectors:              <none>
Tolerations:                 node.kubernetes.io/not-ready:NoExecute op=Exists for 300s
                             node.kubernetes.io/unreachable:NoExecute op=Exists for 300s
Events:
  Type    Reason     Age    From               Message
  ----    ------     ----   ----               -------
  Normal  Scheduled  3m34s  default-scheduler  Successfully assigned default/pod-stress to docker-node2
  Normal  Pulling    3m33s  kubelet            Pulling image "polinux/stress"
  Normal  Pulled     116s   kubelet            Successfully pulled image "polinux/stress" in 1m37.756s (1m37.756s including waiting)
  Normal  Created    115s   kubelet            Created container c1
  Normal  Started    115s   kubelet            Started container c1
3:删除pod
单个pod删除
在没有控制器管理的前提下可以直接删除,但是如果有控制器管理,控制器就会重新拉起
pod 方法1:
[root@master ~]# kubectl delete pod pod-stress
pod "pod-stress" deleted
方法2:
[root@master ~]# kubectl delete -f pod1.yml
多个pod删除
方法1:后面接多个pod名
[root@docker-master pod.dir]# kubectl delete pod nginx1 pod-stress
方法2:通过awk截取要删除的pod名称(NR>1 从第2行开始取),然后管道给xargs
[root@docker-master pod.dir]# kubectl get pods | awk 'NR>1 {print $1}' | xargs kubectl delete pod
方法3:如果要删除的pod都在同一个非default的命名空间,则可直接删除命令空间
[root@docker-master pod.dir]# kubectl create ns game
namespace/game created
[root@docker-master pod.dir]# kubectl get ns
NAME                   STATUS   AGE
default                Active   2d18h
game                   Active   8s
kube-node-lease        Active   2d18h
kube-public            Active   2d18h
kube-system            Active   2d18h
kubernetes-dashboard   Active   42h

[root@docker-master pod.dir]# kubectl run nginx1 --image=nginx:1.26-alpine -n game
pod/nginx1 created
[root@docker-master pod.dir]# kubectl run nginx2 --image=nginx:1.26-alpine -n game
pod/nginx2 create

[root@docker-master pod.dir]# kubectl get pods -n game
NAME     READY   STATUS        RESTARTS   AGE
nginx1   1/1     Running       0          5m48s
nginx2   1/1     Running       0          57s
[root@docker-master pod.dir]# kubectl delete ns game
namespace "game" deleted
4:镜像拉取策略
由imagePullPolicy参数控制
- Always:不管本地有没有镜像,都要从仓库中下载镜像
- Never:从来不从仓库下载镜像,只用本地镜像,本地没有就算了
- IfNotPresent:如果本地存在就直接使用,不存在才从仓库下载
默认的策略是:
- 当镜像标签版本是latest,默认策略就是Always
- 如果指定特定版本默认拉取策略就是IfNotPresent.
1:将上面的pod删除再创建,使用下面命令查看信息
[root@docker-master pod.dir]# kubectl delete -f pod1.yaml
[root@docker-master pod.dir]# kubectl describe pod pod-stress
......
Events:
  Type    Reason     Age   From               Message
  ----    ------     ----  ----               -------
  Normal  Scheduled  41s   default-scheduler  Successfully assigned default/pod-stress to docker-node1
  Normal  Pulling    41s   kubelet            Pulling image "polinux/stress"
说明:可以看到第二行信息还是pulling image 下载镜像
2:修改YAML
[root@master ~]# vim pod1.yml
apiVersion: v1
kind: Pod
metadata:
 name: pod-stress
spec:
 containers:
  - name: c1
   image: polinux/stress
   imagePullPolicy: IfNotPresent     #增加这一句
   command: ["stress"]
   args: ["--vm","1","--vm-bytes","150M","--vm-hang","1"]
3:再次删除并创建
# 现在node节点下载本地镜像
docker pull polinux/stress

[root@docker-master pod.dir]# kubectl delete -f pod1.yaml
pod "pod-stress" deleted
[root@docker-master pod.dir]# kubectl apply -f pod1.yaml
pod/pod-stress created

[root@docker-master pod.dir]# kubectl describe pod pod-stress
......
Events:
  Type    Reason     Age   From               Message
  ----    ------     ----  ----               -------
  Normal  Scheduled  36s   default-scheduler  Successfully assigned default/pod-stress to docker-node1
  Normal  Pulled     36s   kubelet            Container image "polinux/stress" already present on machine
  Normal  Created    36s   kubelet            Created container c1
  Normal  Started    36s   kubelet            Started container c1
5:pod的标签
- 为pod设置label,用于控制器通过label与pod关联
- 语法与前面学的node标签几乎一致
通过命令管理pod标签
1:查看pod的标签
[root@docker-master pod.dir]# kubectl get pods --show-labels
NAME         READY   STATUS    RESTARTS   AGE   LABELS
pod-stress   1/1     Running   0          17s   <none>
2:打标签
[root@docker-master pod.dir]# kubectl label pod pod-stress region=nanjing zone=A env=test bussiness=game
pod/pod-stress labeled

[root@docker-master pod.dir]# kubectl get pod --show-labels
NAME         READY   STATUS    RESTARTS   AGE   LABELS
pod-stress   1/1     Running   0          11m   bussiness=game,env=test,region=nanjing,zone=A
3:通过等值关系标签查询
[root@docker-master pod.dir]# kubectl get pods -l zone=A
NAME         READY   STATUS    RESTARTS   AGE
pod-stress   1/1     Running   0          12m
4:通过集合关系标签查询
[root@docker-master pod.dir]# kubectl get pods -l "zone in (A,B,C)"
NAME         READY   STATUS    RESTARTS   AGE
pod-stress   1/1     Running   0          12m
5:通过–overwrite=true 修改标签
[root@docker-master pod.dir]# kubectl label pod pod-stress zone=B --overwrite=true
pod/pod-stress labeled

[root@docker-master pod.dir]# kubectl get pod --show-labels
NAME         READY   STATUS    RESTARTS   AGE   LABELS
pod-stress   1/1     Running   0          14m   zone=B
6:删除标签后再验证
[root@docker-master pod.dir]# kubectl label pod pod-stress region- env- bussiness-
pod/pod-stress unlabeled
[root@docker-master pod.dir]# kubectl get pod --show-labels
NAME         READY   STATUS    RESTARTS   AGE   LABELS
pod-stress   1/1     Running   0          13m   zone=B
总结:
- pod的label与node的label操作方式几乎相同
- node的label用于pod调度到指定label的node节点
- pod的label用于controller关联控制的pod
通过YAML创建pod时添加标签
1:修改yaml
[root@master ~]# vim pod1.yml
apiVersion: v1
kind: Pod
metadata:
 name: pod-stress
 namespace: default
 labels:           #添加
   env: dev        #添加 key
   app: nginx      #添加 value
spec:
 containers:
  - name: c1
   image: polinux/stress
   imagePullPolicy: IfNotPresent
   command: ["stress"]
   args: ["--vm","1","--vm-bytes","150M","--vm-hang","1"]
2:更新并验证
[root@docker-master pod.dir]# kubectl delete -f pod1.yaml
pod "pod-stress" deleted
[root@docker-master pod.dir]# kubectl apply -f pod1.yaml
pod/pod-stress created

[root@docker-master pod.dir]# kubectl get pod --show-labels
NAME         READY   STATUS    RESTARTS   AGE   LABELS
pod-stress   1/1     Running   0          18s   app=nginx,env=dev
6:pod资源限制
准备2个不同限制方式,创建pod的yaml文件
[root@docker-master pod.dir]# vim pod1.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-stress1
spec:
  containers:
  - name: c1
    image: polinux/stress
    imagePullPolicy: IfNotPresent
    command: ["stress"]
    args: ["--vm","1","--vm-bytes","150M","--vm-hang","1"]
    resources:
      limits:
        memory: "200Mi"    #运行限制200M
      requests:
        memory: "100Mi"    #启动限制100M
运行文件
[root@docker-master pod.dir]# kubectl apply -f pod1.yaml
pod/pod-stress1 created

# 查看资源
[root@docker-master pod.dir]# kubectl get pod
NAME          READY   STATUS    RESTARTS   AGE
pod-stress1   1/1     Running   0          21s
创建超出限制的资源文件
[root@docker-master pod.dir]# vim pod2.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-stress2    #名称更换
spec:
  containers:
  - name: c1
    image: polinux/stress
    imagePullPolicy: IfNotPresent
    command: ["stress"]
    args: ["--vm","1","--vm-bytes","250M","--vm-hang","1"]   #超出资源限制
    resources:
      limits:
        memory: "200Mi"
      requests:
        memory: "150Mi"    #启动升为150M
运行文件
[root@docker-master pod.dir]# kubectl apply -f pod2.yaml
pod/pod-stress2 created
[root@docker-master pod.dir]# kubectl get pod
NAME          READY   STATUS             RESTARTS     AGE
pod-stress1   1/1     Running            0            2m12s
pod-stress2   0/1     CrashLoopBackOff   1 (5s ago)   6s

# 等待一段时间出现以下状态
[root@docker-master pod.dir]# kubectl get pod
NAME          READY   STATUS      RESTARTS      AGE
pod-stress1   1/1     Running     0             2m55s
pod-stress2   0/1     OOMKilled   3 (35s ago)   49s    # restart 重启3次了
用describe查看问题
[root@docker-master pod.dir]# kubectl describe pod pod-stress2
    State:          Waiting
      Reason:       CrashLoopBackOff
    Last State:     Terminated
      Reason:       OOMKilled    #原因
      Exit Code:    1
      Started:      Fri, 16 Jan 2026 13:23:00 +0800
      Finished:     Fri, 16 Jan 2026 13:23:00 +0800
    Ready:          False
    Restart Count:  4
......
Events:
  Type     Reason     Age                   From               Message
  ----     ------     ----                  ----               -------
  Normal   Scheduled  2m17s                 default-scheduler  Successfully assigned default/pod-stress2 to docker-node2
  Normal   Pulled     49s (x5 over 2m17s)   kubelet            Container image "polinux/stress" already present on machine
  Normal   Created    49s (x5 over 2m17s)   kubelet            Created container c1
  Normal   Started    49s (x5 over 2m17s)   kubelet            Started container c1
  Warning  BackOff    36s (x10 over 2m15s)  kubelet            Back-off restarting failed container c1 in pod pod-stress2_default(49cc6ea1-1471-426a-9809-12ff38ec4754)
说明:
- 一旦pod中的容器挂了,容器会有重启策略,如下: Always:表示容器挂了总是重启,这是默认策略
- OnFailures:表容器状态为错误时才重启,也就是容器正常终止时不会重启
- Never:表示容器挂了不予重启
- 对于Always这种策略,容器只要挂了,就会立即重启,这样是很耗费资源的。所以Always重启策 略是这么做的:第一次容器挂了立即重启,如果再挂了就要延时10s重启,第三次挂了就等20s重启. 依次类推
修改重启策略
[root@docker-master pod.dir]# vim pod2.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-stress2
spec:
  restartPolicy: Never    # 添加
  containers:
  - name: c1
    image: polinux/stress
    imagePullPolicy: IfNotPresent
    command: ["stress"]
    args: ["--vm","1","--vm-bytes","250M","--vm-hang","1"]
    resources:
      limits:
        memory: "200Mi"
      requests:
        memory: "150Mi"
[root@docker-master pod.dir]# kubectl apply -f pod2.yaml
pod/pod-stress2 created
[root@docker-master pod.dir]# kubectl get pod pod-stress2
NAME          READY   STATUS      RESTARTS   AGE
pod-stress1   1/1     Running     0          3m39s
pod-stress2   0/1     OOMKilled   0          31s    # 不再重启
删除资源
[root@docker-master pod.dir]# kubectl delete pod pod-stress pod-stress2
7:pod包含多个容器
在yaml的pod中声明两个容器
[root@docker-master pod.dir]# vim pod1.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-stress1
  namespace: default
  labels:
    env: dev
    app: nginx
spec:
  containers:
  - name: c1
    image: polinux/stress
    imagePullPolicy: IfNotPresent
    command: ["stress"]
    args: ["--vm","1","--vm-bytes","150M","--vm-hang","1"]
  - name: c2
    image: polinux/stress
    imagePullPolicy: IfNotPresent
    command: ["stress"]
    args: ["--vm","1","--vm-bytes","150M","--vm-hang","1"]
查看pod状态
[root@docker-master pod.dir]# kubectl apply -f pod1.yaml
pod/pod-stress1 created
[root@docker-master pod.dir]# kubectl get pod
NAME          READY   STATUS    RESTARTS   AGE
pod-stress1   2/2     Running   0          8s
查看pod的节点分布
[root@docker-master pod.dir]# kubectl get pod -o wide
NAME          READY   STATUS    RESTARTS   AGE   IP               NODE           NOMINATED NODE   READINESS GATES
pod-stress1   2/2     Running   0          18s   10.244.248.156   docker-node2   <none>           <none>
在node2中验证,产生了2个容器
[root@docker-node2 ~]# docker ps -a| grep stress
825c5b616415   df58d15b053d                                        "stress --vm 1 --vm-…"   About a minute ago   Up About a minute                          k8s_c2_pod-stress1_default_6d9e7e5f-9c76-48e8-89c4-27c397a4e9c6_0
b8ccc38dd57c   df58d15b053d                                        "stress --vm 1 --vm-…"   About a minute ago   Up About a minute                          k8s_c1_pod-stress1_default_6d9e7e5f-9c76-48e8-89c4-27c397a4e9c6_0
5e948316e7a5   registry.aliyuncs.com/google_containers/pause:3.9   "/pause"                  About a minute ago   Up About a minute                          k8s_POD_pod-stress1_default_6d9e7e5f-9c76-48e8-89c4-27c397a4e9c6_0
pause:3.9,基础容器,负责网络和存储卷
如果用的是containerd运行时,则使用(只在containerd运行时使用)
[root@node2 ~]# crictl ps
8:对pod里的容器进行操作
命令帮助
[root@docker-master pod.dir]# kubectl exec -h
不用交互直接执行命令
格式为: kubectl exec pod名 -c 容器名 -- 命令
注意:
- -c 容器名为可选项,如果是1个pod中1个容器,则不用指定。
- 如果是1个pod中多个容器,不指定默认为第1个。
#默认命名空间
[root@docker-master pod.dir]# kubectl exec pod-stress1 -- date
Defaulted container "c1" out of: c1, c2
Fri Jan 16 06:22:05 UTC 2026

[root@docker-master pod.dir]# kubectl exec pod-stress1 -c c1 -- date
Fri Jan 16 06:22:20 UTC 2026
[root@docker-master pod.dir]# kubectl exec pod-stress1 -c c2 -- date
Fri Jan 16 06:22:28 UTC 2026

#其他命名空间
[root@docker-master pod.dir]# kubectl exec pod-stress1  -n <namespace>  -- date
不指定容器名,则默认为pod里的第1个容器
[root@docker-master pod.dir]# kubectl exec pod-stress1 -- touch abc.txt
Defaulted container "c1" out of: c1, c2
和容器交互操作
和docker exec几乎一样,会发现刚才创建的abc.txt
[root@docker-master pod.dir]# kubectl exec -it pod-stress1 -c c1 -- /bin/bash
bash-5.0# ls
abc.txt  dev      home     media    opt      root     sbin     sys      usr
bin      etc      lib      mnt      proc     run      srv      tmp      var
同一个pod中两个容器IP地址相同,是共享的10.244.248.156/32
[root@docker-master pod.dir]# kubectl exec -it pod-stress1 -c c1 -- /bin/bash
bash-5.0# ip a s
1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    inet 127.0.0.1/8 scope host lo
       valid_lft forever preferred_lft forever
    inet6 ::1/128 scope host
       valid_lft forever preferred_lft forever
2: tunl0@NONE: <NOARP> mtu 1480 qdisc noop state DOWN qlen 1000
    link/ipip 0.0.0.0 brd 0.0.0.0
4: eth0@if10: <BROADCAST,MULTICAST,UP,LOWER_UP,M-DOWN> mtu 1480 qdisc noqueue state UP
    link/ether 9a:cd:c6:d8:4a:20 brd ff:ff:ff:ff:ff:ff
    inet 10.244.248.156/32 scope global eth0
       valid_lft forever preferred_lft forever
    inet6 fe80::98cd:c6ff:fed8:4a20/64 scope link
       valid_lft forever preferred_lft forever
bash-5.0# exit

[root@docker-master pod.dir]# kubectl exec -it pod-stress1 -c c2 -- /bin/bash
bash-5.0# ip a s
1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    inet 127.0.0.1/8 scope host lo
       valid_lft forever preferred_lft forever
    inet6 ::1/128 scope host
       valid_lft forever preferred_lft forever
2: tunl0@NONE: <NOARP> mtu 1480 qdisc noop state DOWN qlen 1000
    link/ipip 0.0.0.0 brd 0.0.0.0
4: eth0@if10: <BROADCAST,MULTICAST,UP,LOWER_UP,M-DOWN> mtu 1480 qdisc noqueue state UP
    link/ether 9a:cd:c6:d8:4a:20 brd ff:ff:ff:ff:ff:ff
    inet 10.244.248.156/32 scope global eth0
       valid_lft forever preferred_lft forever
    inet6 fe80::98cd:c6ff:fed8:4a20/64 scope link
       valid_lft forever preferred_lft forever
bash-5.0# exit
9:验证pod中多个容器网络共享
1:编写YAML
[root@docker-master pod.dir]# cat pod-nginx.yaml
apiVersion: v1
kind: Pod
metadata:
  name: nginx2
spec:
  containers:
  - name: c1
    image: nginx:1.26-alpine
  - name: c2
    image: nginx:1.26-alpine
2:应用YAML
[root@docker-master pod.dir]# kubectl apply -f pod-nginx.yaml
pod/nginx2 created
3:查看pod信息与状态
[root@docker-master pod.dir]# kubectl get pod
NAME          READY   STATUS    RESTARTS      AGE
nginx2        1/2     Error     1 (10s ago)   14s
pod-stress1   2/2     Running   0             10m

[root@docker-master pod.dir]# kubectl describe pod nginx2
......
Events:
  Type     Reason     Age                From               Message
  ----     ------     ----               ----               -------
  Normal   Scheduled  31s                default-scheduler  Successfully assigned default/nginx2 to docker-node2
  Normal   Pulled     30s                kubelet            Container image "nginx:1.26-alpine" already present on machine
  Normal   Created    30s                kubelet            Created container c1
  Normal   Started    30s                kubelet            Started container c1
  Normal   Pulled     13s (x3 over 30s)  kubelet            Container image "nginx:1.26-alpine" already present on machine
  Normal   Created    13s (x3 over 30s)  kubelet            Created container c2
  Normal   Started    13s (x3 over 30s)  kubelet            Started container c2
  Warning  BackOff    10s (x2 over 24s)  kubelet            Back-off restarting failed container c2 in pod nginx2_default(9ccfb3ac-2785-457a-8af6-666192296b3b)

[root@docker-master pod.dir]# kubectl get pod
NAME          READY   STATUS             RESTARTS      AGE
nginx2        1/2     CrashLoopBackOff   3 (15s ago)   60s
pod-stress1   2/2     Running            0             10m
在node节点中查看
[root@docker-master pod.dir]# kubectl get pod -o wide
NAME          READY   STATUS             RESTARTS      AGE   IP               NODE           NOMINATED NODE   READINESS GATES
nginx2        1/2     CrashLoopBackOff   3 (31s ago)   76s   10.244.248.157   docker-node2   <none>           <none>
pod-stress1   2/2     Running            0             11m   10.244.248.156   docker-node2   <none>           <none>

[root@docker-node2 ~]# docker ps -a
CONTAINER ID   IMAGE                                               COMMAND                   CREATED             STATUS                           PORTS     NAMES
8d328cbf0a55   42ce3d3585d4                                        "/docker-entrypoint.…"   8 seconds ago       Exited (1) 5 seconds ago
......
查看日志
# 在node节点
[root@docker-node2 ~]# docker logs 8d328cbf0a55

# 或者在master节点    logs查看的是容器日志,-f 后面跟Pod名称
[root@docker-master pod.dir]# kubectl logs -f nginx2 -c2
/docker-entrypoint.sh: /docker-entrypoint.d/ is not empty, will attempt to perform configuration
/docker-entrypoint.sh: Looking for shell scripts in /docker-entrypoint.d/
/docker-entrypoint.sh: Launching /docker-entrypoint.d/10-listen-on-ipv6-by-default.sh
10-listen-on-ipv6-by-default.sh: info: Getting the checksum of /etc/nginx/conf.d/default.conf
10-listen-on-ipv6-by-default.sh: info: Enabled listen on IPv6 in /etc/nginx/conf.d/default.conf
/docker-entrypoint.sh: Sourcing /docker-entrypoint.d/15-local-resolvers.envsh
/docker-entrypoint.sh: Launching /docker-entrypoint.d/20-envsubst-on-templates.sh
/docker-entrypoint.sh: Launching /docker-entrypoint.d/30-tune-worker-processes.sh
/docker-entrypoint.sh: Configuration complete; ready for start up
2026/01/20 09:11:41 [emerg] 1#1: bind() to 0.0.0.0:80 failed (98: Address in use)
nginx: [emerg] bind() to 0.0.0.0:80 failed (98: Address in use)
2026/01/20 09:11:41 [emerg] 1#1: bind() to [::]:80 failed (98: Address in use)
nginx: [emerg] bind() to [::]:80 failed (98: Address in use)
2026/01/20 09:11:41 [notice] 1#1: try again to bind() after 500ms
-f:开启日志跟随模式,实时输出新日志
不加-f是仅打印已产生的日志
发现有1个容器启动失败,主要原因是在同一个网络环境中两个nginx都启动的80端口产生冲突
pod调度
调度流程
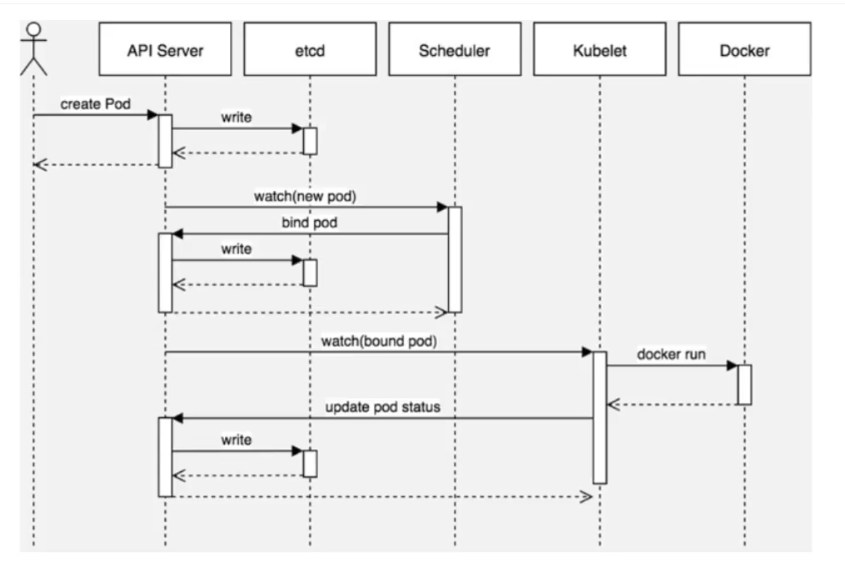
第1步
通过kubect1命令应用资源清单文件(yam]格式)向api server 发起一个create pod 请求
第2步
api server接收到pod创建请求后,生成一个包含创建信息资源清单文件
第3步
api server 将资源清单文件中信息写入etcd数据库
第4步
scheduler启动后会一直watch API server,获取 podspec.NodeName为空的Pod,即判断
pod.spec.Node == nu11?若为nu11,表示这个Pod请求是新的,需要创建,因此先进行调度计算(共计2
步;1、过滤不满足条件的,2、选择优先级高的),找到合适的node,然后将信息在etcd数据库中更新分配结
果:pod.spec.Node =nodeA(设置一个具体的节点)
第5步
Kubelet 通过watch etcd数据库(即不停地看etcd中的记录),发现有新的Node出现,如果这条记录中的
Node与所在节点编号相同,即这个Pod由scheduler分配给自己,则调用node中的container Runtime,
进而创建container,并将创建后的结果返回到给api server用于更新etcd数据库中数据状态。
调度约束方法
我们为了实现容器主机资源平衡使用,可以使用约束把pod调度到指定的node节点
- nodeName用于将pod调度到指定的node名称上
- nodeSelector用于将pod调度到匹配Label的node上
1:nodeName
编写YAML文件
[root@docker-master pod.dir]# vim pod-nodename.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-nodename
spec:
  nodeName: docker-node1
  containers:
  - name: node-nginx
    image: nginx:1.26-alpine
应用YAML文件创建pod
[root@docker-master pod.dir]# kubectl apply -f pod-nodename.yaml
pod/pod-nodename created
验证
[root@docker-master pod.dir]# kubectl describe pod pod-nodename |tail -10
QoS Class:                   BestEffort
Node-Selectors:              <none>
Tolerations:                 node.kubernetes.io/not-ready:NoExecute op=Exists for 300s
                             node.kubernetes.io/unreachable:NoExecute op=Exists for 300s
Events:
  Type    Reason   Age   From     Message
  ----    ------   ----  ----     -------
  Normal  Pulled   59s   kubelet  Container image "nginx:1.26-alpine" already present on machine
  Normal  Created  59s   kubelet  Created container node-nginx
  Normal  Started  59s   kubelet  Started container node-nginx
发现:没有使用scheduler,而是直接给运行了,说明nodeName约束生效,使用nodeName直接跳过scheduler
[root@docker-master pod.dir]# kubectl get pod -o wide | grep pod-nodename
pod-nodename   1/1     Running   0          2m51s   10.244.148.216   docker-node1   <none>           <none>
2:nodeSelector
给node1节点打上标签为game
[root@docker-master pod.dir]# kubectl label node docker-node1 bussiness=game
node/docker-node1 labeled
编写YAML文件
[root@docker-master pod.dir]# vim pod-nodeselector.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-nodeselect
spec:
  nodeSelector:
    bussiness: game   #名称匹配
  containers:
  - name: nodeselect-nginx
    image: nginx:1.26-alpine
应用YAML文件创建pod
[root@docker-master pod.dir]# kubectl apply -f pod-nodeselector.yaml
pod/pod-nodeselect created
验证
[root@docker-master pod.dir]# kubectl describe pod pod-nodeselect | tail -10
Node-Selectors:              bussiness=game
Tolerations:                 node.kubernetes.io/not-ready:NoExecute op=Exists for 300s
                             node.kubernetes.io/unreachable:NoExecute op=Exists for 300s
Events:
  Type    Reason     Age   From               Message
  ----    ------     ----  ----               -------
  Normal  Scheduled  37s   default-scheduler  Successfully assigned default/pod-nodeselect to docker-node1
  Normal  Pulled     37s   kubelet            Container image "nginx:1.26-alpine" already present on machine
  Normal  Created    37s   kubelet            Created container nodeselect-nginx
  Normal  Started    36s   kubelet            Started container nodeselect-nginx
发现:经过了scheduler,分配到了node1节点上
通过nodeSelector匹配到标签bussiness=game的节点
pod的生命周期
1:pod生命周期
- 有些pod(比如运行httpd服务),正常情况下会一直运行中,但如果手动删除它,此pod会终止。
- 也有些pod(比如执行计算任务),任务计算完后就会自动终止。
上面两种场景中,pod从创建到终止的过程就是pod的生命周期。
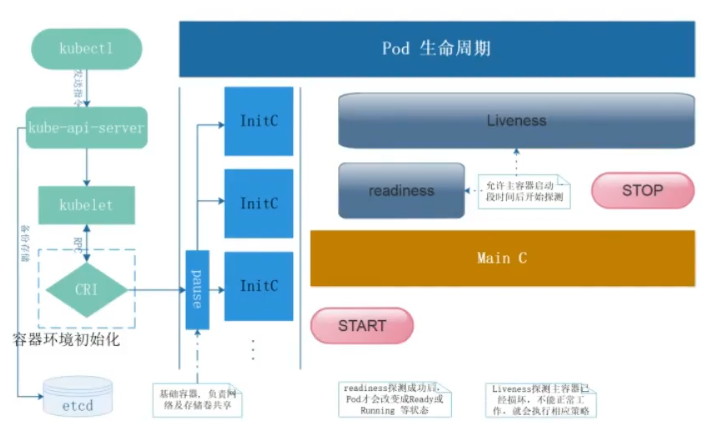
kubectl到CRI通过RPC(远程过程调度)
pause,底层容器,管理网络和存储卷,为应用容器作前期准备
容器初始化主要做两件事:namespace和Cgroup
容器启动
-
pod中的容器在创建前,有初始化容器(init container)来进行初始化环境
-
初化完后,主容器(main container)开始启动
-
主容器启动后,有一个post start的操作(启动后的触发型操作,或者叫启动后钩子)
-
post start后,就开始做健康检查
- 第一个健康检查叫存活状态检查(liveness probe),用来检查主容器存活状态的
- 第二个健康检查叫准备就绪检查(readiness probe),用来检查主容器是否启动就绪
容器终止
- 可以在容器终止前设置pre stop操作(终止前的触发型操作,或者叫终止前钩子)
- 当出现特殊情况不能正常销毁pod时,大概等待30秒会强制终止
- 终止容器后还可能会重启容器(视容器重启策略而定)。
容器重启策略
- Always:表示容器挂了总是重启,这是默认策略
- OnFailure:表容器状态为错误时才重启,也就是容器正常终止时不重启
- Never:表示容器挂了不予重启
- 对于Always这种策略,容器只要挂了,就会立即重启,这样是很耗费资源的。所以Always重启策 略是这么做的:第一次容器挂了立即重启,如果再挂了就要延时10s重启,第三次挂了就等20s重启… 依次类推
2:HealthCheck健康检查
当Pod启动时,容器可能会因为某种错误(服务未启动或端口不正确)而无法访问等。
Health Check方式
kubelet拥有两个检测器,它们分别对应不同的触发器(根据触发器的结构执行进一步的动作)
| 方式 | 说明 |
|---|---|
| Liveness Probe(存活状态探 测) | 指示容器是否正在运行。如果存活态探测失败,则 kubelet 会杀死容器, 并且容器将根据其重启策略决定未来。如果容器不提供存活探针,则默认状态为 success。 |
| readiness Probe(就绪型探 测) | 指示容器是否准备好为请求提供服务。如果就绪态探测失败,端点控制器将从与 Pod 匹配的所有服务的端点列表中删除该Pod 的IP地址。 初始延迟之前的就绪态的状态值默认为 Failure。 如果容器不提供就绪态探针,则默认状态为success。注: 检查后不健康,将容器设置为Noready;如果使用service来访问,流量不会转发给此 种状态的pod |
| startup Probe | 指示容器中的应用是否已经启动。如果提供了启动探针,则所有其他探针都会被禁用,直到此探针成功为止。如果启动探测失败,kubelet 将杀死容器,而容器依其重启策略进行重启。如果容器没有提供启动探测,则默认状态为 success。 |
Probe探测方式
| Probe探测方式 | 说明 |
|---|---|
| Exec | 执行命令 |
| HTTPGet | http请求某一个URL路径,查看返回状态码 |
| TCP | tcp连接某一个端口 |
| gRPC | 使用gRPC执行一个远程过程调用。目标应该实现gRPC健康检查。如果响应的状态是 “SERVING”,则认为诊断成功。gRPC探针是一个alpha特性,只有在你启动了“GRPC ContainerProbe”特性门控时才能使用。 |
liveness-exec 案例
准备YAML文件
[root@docker-master pod.dir]# vim pod-live.yaml
apiVersion: v1
kind: Pod
metadata:
  name: liveness-exec
spec:
  containers:
  - name: c1
    image: busybox
    imagePullPolicy: IfNotPresent
    args:
    - /bin/sh
    - -c
    - touch /tmp/abc.txt; sleep 30;rm -rf /tmp/abc.txt;sleep 600
    # 存活探针
    livenessProbe:
      exec:
        command:
        - cat
        - /tmp/abc.txt
      # pod启动延迟5秒后探测
      initialDelaySeconds: 5
      #每5秒探测1次
      periodSeconds: 5
应用YAML文件
[root@docker-master pod.dir]# kubectl apply -f pod-live.yaml
pod/liveness-exec created

[root@docker-master pod.dir]# kubectl get pod
NAME            READY   STATUS    RESTARTS   AGE
liveness-exec   1/1     Running   0          67s
通过下面的命令观察
[root@docker-master pod.dir]# kubectl describe pod liveness-exec
......
Events:
  Type     Reason     Age                From               Message
  ----     ------     ----               ----               -------
  Normal   Scheduled  79s                default-scheduler  Successfully assigned default/liveness-exec to docker-node2
  Normal   Pulling    4s                 kubelet            Pulling image "busybox"
  Normal   Pulled     4s                 kubelet            Container image "busybox" already present on machine
  Normal   Created    4s                 kubelet            Created container c1
  Normal   Started    4s                 kubelet            Started container c1
过几分钟再观察
[root@docker-master pod.dir]# kubectl describe pod liveness-exec
......
Events:
  Type     Reason     Age                   From               Message
  ----     ------     ----                  ----               -------
  Normal   Scheduled  13m                   default-scheduler  Successfully assigned default/liveness-exec to docker-node2
  Normal   Pulling    13m                   kubelet            Pulling image "busybox"
  Normal   Pulled     13m                   kubelet            Successfully pulled image "busybox" in 35.681s (35.681s including waiting)
  Normal   Killing    10m (x3 over 12m)     kubelet            Container c1 failed liveness probe, will be restarted
  Normal   Created    9m32s (x4 over 13m)   kubelet            Created container c1
  Normal   Started    9m32s (x4 over 13m)   kubelet            Started container c1
  Normal   Pulled     9m32s (x3 over 12m)   kubelet            Container image "busybox" already present on machine
  Warning  Unhealthy  3m47s (x20 over 12m)  kubelet            Liveness probe failed: cat: can't open '/tmp/abc.txt': No such file or directory
容器被探针检测失败又会被重新拉起,注意看RESTARTS
[root@docker-master pod.dir]# kubectl get pod
NAME                READY   STATUS      RESTARTS         AGE
liveness-exec       1/1     Running     26 (5m25s ago)   126m
扩展:容器重启策略验证
[root@docker-master pod.dir]# kubectl delete -f pod-live.yaml
pod "liveness-exec" deleted

[root@docker-master pod.dir]# vim pod-live.yaml
apiVersion: v1
kind: Pod
metadata:
  name: liveness-exec
spec:
  restartPolicy: Never  # 把容器重启策略由默认的always改为Never
  containers:
  - name: c1
    image: busybox
    imagePullPolicy: IfNotPresent
    args:
    - /bin/sh
    - -c
    - touch /tmp/abc.txt; sleep 30;rm -rf /tmp/abc.txt;sleep 600
    # 存活探针
    livenessProbe:
      exec:
        command:
        - cat
        - /tmp/abc.txt
      # pod启动延迟5秒后探测
      initialDelaySeconds: 5
      #每5秒探测1次
      periodSeconds: 5
验证结果为:容器健康检查出现问题后,不再重启,也不会继续sleep 600秒,而是直接关闭了
[root@docker-master pod.dir]# kubectl get pod
NAME                READY   STATUS      RESTARTS       AGE
liveness-exec       1/1     Running     0              5s
[root@docker-master pod.dir]# kubectl get pod
NAME                READY   STATUS      RESTARTS       AGE
liveness-exec       0/1     Error       0              2m57s
若状态为Error,说明探针检测失败
liveness-httpget案例
1:使用Python编写YAML文件
安装kubernetes插件
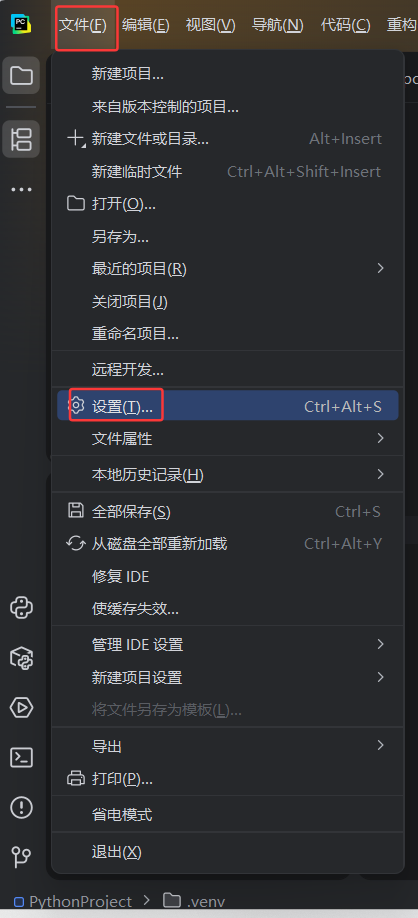
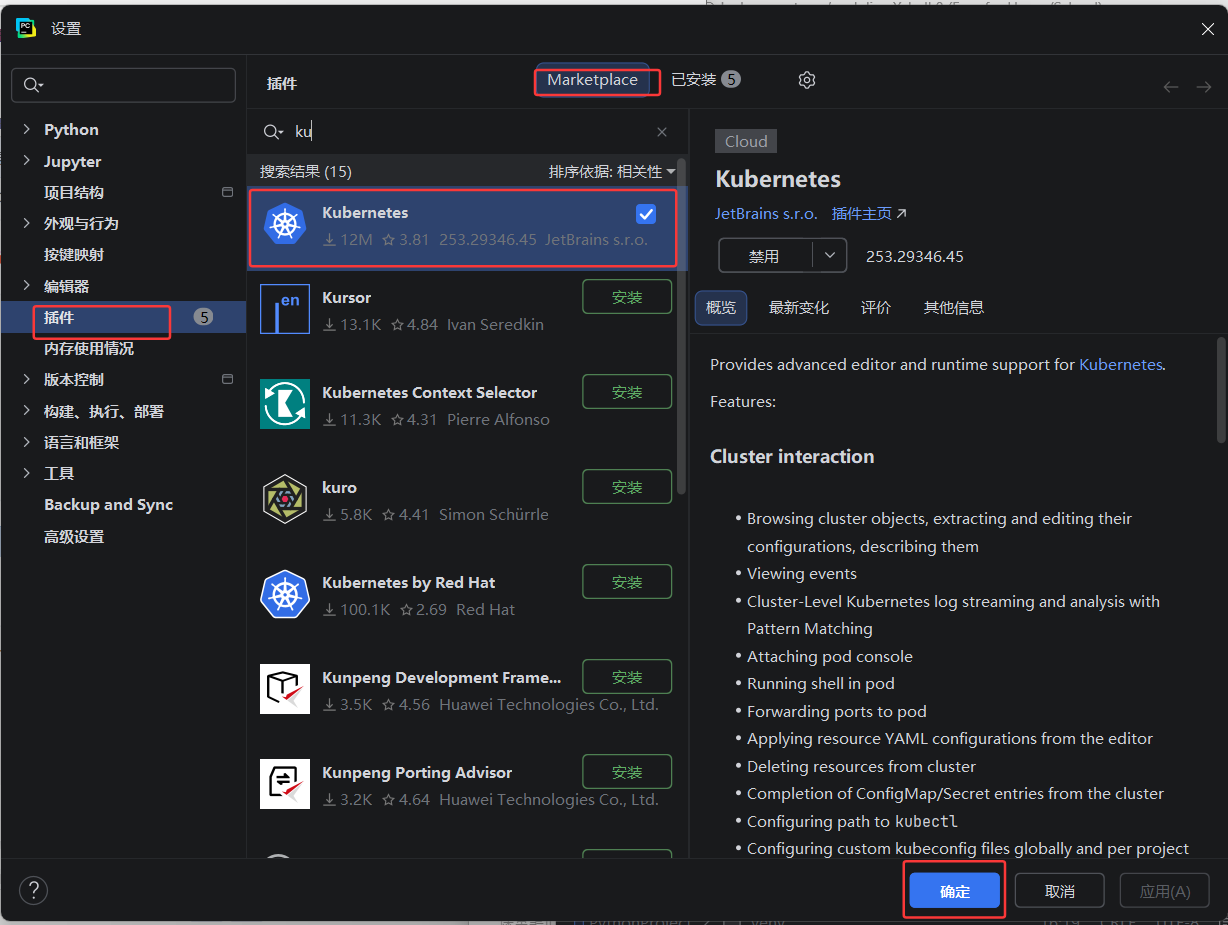
编写python文件,文件名为pod-http.yaml,传入到master主机上
apiVersion: v1
kind: Pod
metadata:
  name: liveness-httpget
spec:
  containers:
    - name: c1
      image: nginx:1.26-alpine
      imagePullPolicy: IfNotPresent
      ports:                    #指定容器端口,这一行不写也行,端口由镜像决定
        - name: http            #自定义名称,不需要与下面的port:http对应
          containerPort: 80     #类似dockerfile里的expose 80
      livenessProbe:
        httpGet:                #使用httpGet方式
          port: http            #http协议,也可以直接写80端口
          path: /index.html     #探测家目录下的index.html
        initialDelaySeconds: 3  #延迟3秒开始探测
        periodSeconds: 5        #每个5s探测一次
2:应用YAML文件
[root@docker-master pod.dir]# kubectl apply -f pod-http.yaml
pod/liveness-httpget created
3:检查验证
[root@docker-master pod.dir]# kubectl get pod
NAME               READY   STATUS             RESTARTS      AGE
liveness-httpget   1/1     Running            0             22s
4:交互删除nginx里的主页文件
[root@docker-master pod.dir]# kubectl exec -it liveness-httpget -- rm -rf /usr/share/nginx/html/index.html
5:验证查看
[root@docker-master pod.dir]# kubectl describe pod liveness-httpget | tail -10
                             node.kubernetes.io/unreachable:NoExecute op=Exists for 300s
Events:
  Type     Reason     Age                 From               Message
  ----     ------     ----                ----               -------
  Normal   Scheduled  110s                default-scheduler  Successfully assigned default/liveness-httpget to docker-node2
  Normal   Pulled     19s (x2 over 109s)  kubelet            Container image "nginx:1.26-alpine" already present on machine
  Normal   Created    19s (x2 over 109s)  kubelet            Created container c1
  Normal   Started    19s (x2 over 109s)  kubelet            Started container c1
  Warning  Unhealthy  19s (x3 over 29s)   kubelet            Liveness probe failed: HTTP probe failed with statuscode: 404
  Normal   Killing    19s                 kubelet            Container c1 failed liveness probe, will be restarted
重新启动了
[root@docker-master pod.dir]# kubectl get pod
NAME               READY   STATUS             RESTARTS        AGE
liveness-httpget   1/1     Running            1 (63s ago)     2m34s
liveness-tcp案例
1:编写YAML文件
apiVersion: v1
kind: Pod
metadata:
  name: liveness-tcp
spec:
  containers:
    - name: c1
      image: nginx:1.26-alpine
      imagePullPolicy: IfNotPresent
      ports:
        - containerPort: 82      #容器端口
          name: http
      livenessProbe:
        tcpSocket:               #使用tcp连接方式
          port: 80               #连接pod的80端口进行探测,跟容器端口无关
        initialDelaySeconds: 5
        periodSeconds: 5
2:应用YAML文件创建pod
[root@docker-master pod.dir]# kubectl apply -f pod-tcp.yaml
pod/liveness-tcp created
3:查看验证
[root@docker-master pod.dir]# kubectl get pod
NAME               READY   STATUS             RESTARTS        AGE
liveness-tcp       1/1     Running            0               3s
4:交互关闭nginx
[root@docker-master pod.dir]# kubectl exec -it liveness-tcp -- /usr/sbin/nginx -s stop
2026/01/19 03:14:56 [notice] 35#35: signal process started
5:再次验证查看
[root@docker-master pod.dir]# kubectl describe pod liveness-tcp |tail -10
Tolerations:                 node.kubernetes.io/not-ready:NoExecute op=Exists for 300s
                             node.kubernetes.io/unreachable:NoExecute op=Exists for 300s
Events:
  Type     Reason     Age                  From               Message
  ----     ------     ----                 ----               -------
  Normal   Scheduled  2m29s                default-scheduler  Successfully assigned default/liveness-tcp to docker-node2
  Warning  Unhealthy  84s                  kubelet            Liveness probe failed: dial tcp 10.244.248.167:80: connect: connection refused
  Normal   Pulled     83s (x2 over 2m28s)  kubelet            Container image "nginx:1.26-alpine" already present on machine
  Normal   Created    83s (x2 over 2m28s)  kubelet            Created container c1
  Normal   Started    83s (x2 over 2m28s)  kubelet            Started container c1
[root@docker-master pod.dir]# kubectl get pods
NAME                READY   STATUS    RESTARTS        AGE
liveness-tcp        1/1     Running   1 (5m34s ago)   6m39s
扩展:容器重启策略验证
apiVersion: v1
kind: Pod
metadata:
  name: liveness-tcp
spec:
  restartPolicy: Never
  containers:
    - name: c1
      image: nginx:1.26-alpine
      imagePullPolicy: IfNotPresent
      ports:
        - containerPort: 82      #容器端口
          name: http
      livenessProbe:
        tcpSocket:               #使用tcp连接方式
          port: 80               #连接pod的80端口进行探测,跟容器端口无关
        initialDelaySeconds: 5
        periodSeconds: 5
[root@docker-master pod.dir]# kubectl apply -f pod-tcp.yaml
pod/liveness-tcp created
[root@docker-master pod.dir]# kubectl get pod
NAME               READY   STATUS             RESTARTS        AGE
liveness-tcp       1/1     Running            0               3s
[root@docker-master pod.dir]# kubectl exec -it liveness-tcp -- /usr/sbin/nginx -s stop
2026/01/19 03:14:56 [notice] 35#35: signal process started
[root@docker-master pod.dir]# kubectl get pod
NAME               READY   STATUS             RESTARTS         AGE
liveness-tcp       0/1     Completed          0                80s

[root@docker-master pod.dir]# kubectl describe pod liveness-tcp
......
Events:
  Type    Reason     Age   From               Message
  ----    ------     ----  ----               -------
  Normal  Scheduled  94s   default-scheduler  Successfully assigned default/liveness-tcp to docker-node2
  Normal  Pulled     93s   kubelet            Container image "nginx:1.26-alpine" already present on machine
  Normal  Created    93s   kubelet            Created container c1
  Normal  Started    93s   kubelet            Started container c1
readiness案例
1:编写YAML文件
[root@docker-master pod.dir]# vim pod-readiness.yaml
apiVersion: v1
kind: Pod
metadata:
  name: readiness-httpget
spec:
  containers:
  - name: c1
    image: nginx:1.26-alpine
    imagePullPolicy: Never
    ports:
    - name: http
      containerPort: 80
    # 就绪探针
    readinessProbe:
      httpGet:
        port: http
        path: /index.html
      initialDelaySeconds: 3
      periodSeconds: 5
2:应用YAML文件
[root@docker-master pod.dir]# kubectl apply -f pod-readiness.yaml
pod/readiness-httpget created
3:验证查看
[root@docker-master pod.dir]# kubectl get pod
NAME                READY   STATUS      RESTARTS         AGE
readiness-httpget   0/1     Running     0                4s
4:交互删除nginx主页
[root@docker-master pod.dir]# kubectl exec -it readiness-httpget -- rm -rf /usr/share/nginx/html/index.html
5:再次验证
[root@docker-master pod.dir]# kubectl describe pod readiness-httpget| tail -10
Tolerations:                 node.kubernetes.io/not-ready:NoExecute op=Exists for 300s
                             node.kubernetes.io/unreachable:NoExecute op=Exists for 300s
Events:
  Type     Reason     Age               From               Message
  ----     ------     ----              ----               -------
  Normal   Scheduled  81s               default-scheduler  Successfully assigned default/readiness-httpget to docker-node2
  Normal   Pulled     80s               kubelet            Container image "nginx:1.26-alpine" already present on machine
  Normal   Created    80s               kubelet            Created container c1
  Normal   Started    80s               kubelet            Started container c1
  Warning  Unhealthy  1s (x6 over 21s)  kubelet            Readiness probe failed: HTTP probe failed with statuscode: 404
[root@docker-master pod.dir]# kubectl get pod
NAME                READY   STATUS      RESTARTS       AGE
readiness-httpget   0/1     Running     0              96s
就绪探针不影响运行状态,但影响ready状态
6:恢复删除的文件
[root@docker-master pod.dir]# kubectl exec -it readiness-httpget -- touch /usr/share/nginx/html/index.html
7:再次查看状态
[root@docker-master pod.dir]# kubectl get pod
NAME                READY   STATUS             RESTARTS       AGE
readiness-httpget   1/1     Running            0              2m16s
总结:readiness会把pod标记为noready状态,直到文件恢复,才会正常
readiness+liveness综合案例
1:编写YAML文件
[root@docker-master pod.dir]# vim live-ready.yaml
apiVersion: v1
kind: Pod
metadata:
  name: live-ready
spec:
  containers:
    - name: c1
      image: nginx:1.26-alpine
      imagePullPolicy: IfNotPresent
      ports:
        - containerPort: 80
          name: http
      # 存活探针
      livenessProbe:
        httpGet:
          port: http
          path: /index.html
        initialDelaySeconds: 1
        periodSeconds: 3
      # 就绪探针
      readinessProbe:
        httpGet:
          port: http
          path: /login.html
        initialDelaySeconds: 5
        periodSeconds: 5
2:应用YAML文件
[root@docker-master pod.dir]# kubectl apply -f live-ready.yaml
pod/live-ready created
3:验证,pod正常运行,但是没有就绪
[root@docker-master pod.dir]# kubectl get pod
NAME         READY   STATUS    RESTARTS   AGE
live-ready   0/1     Running   0          6s
4:创建登录login文件
[root@docker-master pod.dir]# kubectl exec -it live-ready -- touch /usr/share/nginx/html/login.html
5:再次查看状态,进入到ready状态
[root@docker-master pod.dir]# kubectl get pod
NAME         READY   STATUS    RESTARTS   AGE
live-ready   1/1     Running   0          22s
3:post-start
启动资源时容器执行的操作
1:编写YAML文件
[root@docker-master pod.dir]# vim live-start.yaml
apiVersion: v1
kind: Pod
metadata:
  name: post-start
spec:
  containers:
    - name: c1
      image: nginx:1.26-alpine
      imagePullPolicy: IfNotPresent
      ports:
        - containerPort: 80
          name: http
      lifecycle:
        postStart:
          exec:
            command: ["mkdir","-p","/usr/share/nginx/html/abc"]
2:应用YAML文件
[root@docker-master pod.dir]# kubectl apply -f post-start.yaml
pod/post-start created
3:验证,可以直接看到资源中有创建的abc目录
[root@docker-master pod.dir]# kubectl get pods
NAME         READY   STATUS    RESTARTS   AGE
post-start   1/1     Running   0          30s

[root@docker-master pod.dir]# kubectl exec -it post-start -- ls /usr/share/nginx/html
50x.html    abc         index.html
4:pre-stop
容器终止前执行的命令
1:编写YAML文件
[root@docker-master pod.dir]# vim pre-stop.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pre-stop
spec:
  containers:
    - name: c1
      image: nginx:1.26-alpine
      imagePullPolicy: IfNotPresent
      ports:
        - containerPort: 80
          name: http
      lifecycle:
        postStart:
          exec:
            command: ["/bin/sh","-c","sleep 60000"]
2:应用YAML文件创建Pod
[root@docker-master pod.dir]# kubectl apply -f pre-stop.yaml
pod/pre-stop created
3:删除pod验证
[root@docker-master pod.dir]# kubectl delete -f pre-stop.yaml
pod "pre-stop" deleted   #会在这一步等待一定的时间才能删除,说明验证成功
结论:当出现特殊情况不能正常销毁pod时,大概等待30秒会强制终止
5:pod故障排除
| 状态 | 描述 |
|---|---|
| Pending(悬决) | Pod已被Kubernetes 系统接受,但有一个或者多个容器尚未创建亦未运行。此阶段包括等待Pod被调度的时间和通过网络下载镜像时间 |
| Running(运行) | Pod已经绑定到一个节点,并且已经创建了所有容器。至少有一个容器正在运行中,或正在启动或重新启动。 |
| completed(完成) | Pod中的所有容器都已经成功终止,不会重新启动。 |
| Failed(失败) | Pod的所有容器均已终止,且至少有一个容器已在故障中终止。也就是说,容器要么以非零状态退出,要么被系统终止。 |
| Unknown(未知) | 由于某种原因apiserver无法获得Pod的状态,通常是由于Master与Pod所在主机kubelet通信时出错。 |
| CrashLoopBackOff | 多见于CMD语句错误或者找不到container入口语句导致了快速退出,可以用kubelet logs查看日志进行排错 |
通过以下命令查看状态:
kubectl describe pod pod名称kubectl logs pod [-c CONTAINER]kubectl exec POD [-c CONTAINER] -- COMMAND [args...]
更多推荐

 8
 0
- 0


 已为社区贡献14条内容

所有评论(0)