
AI大模型论文学习路线:从零构建系统化知识体系
快速体验
在开始今天关于 AI大模型论文学习路线:从零构建系统化知识体系 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
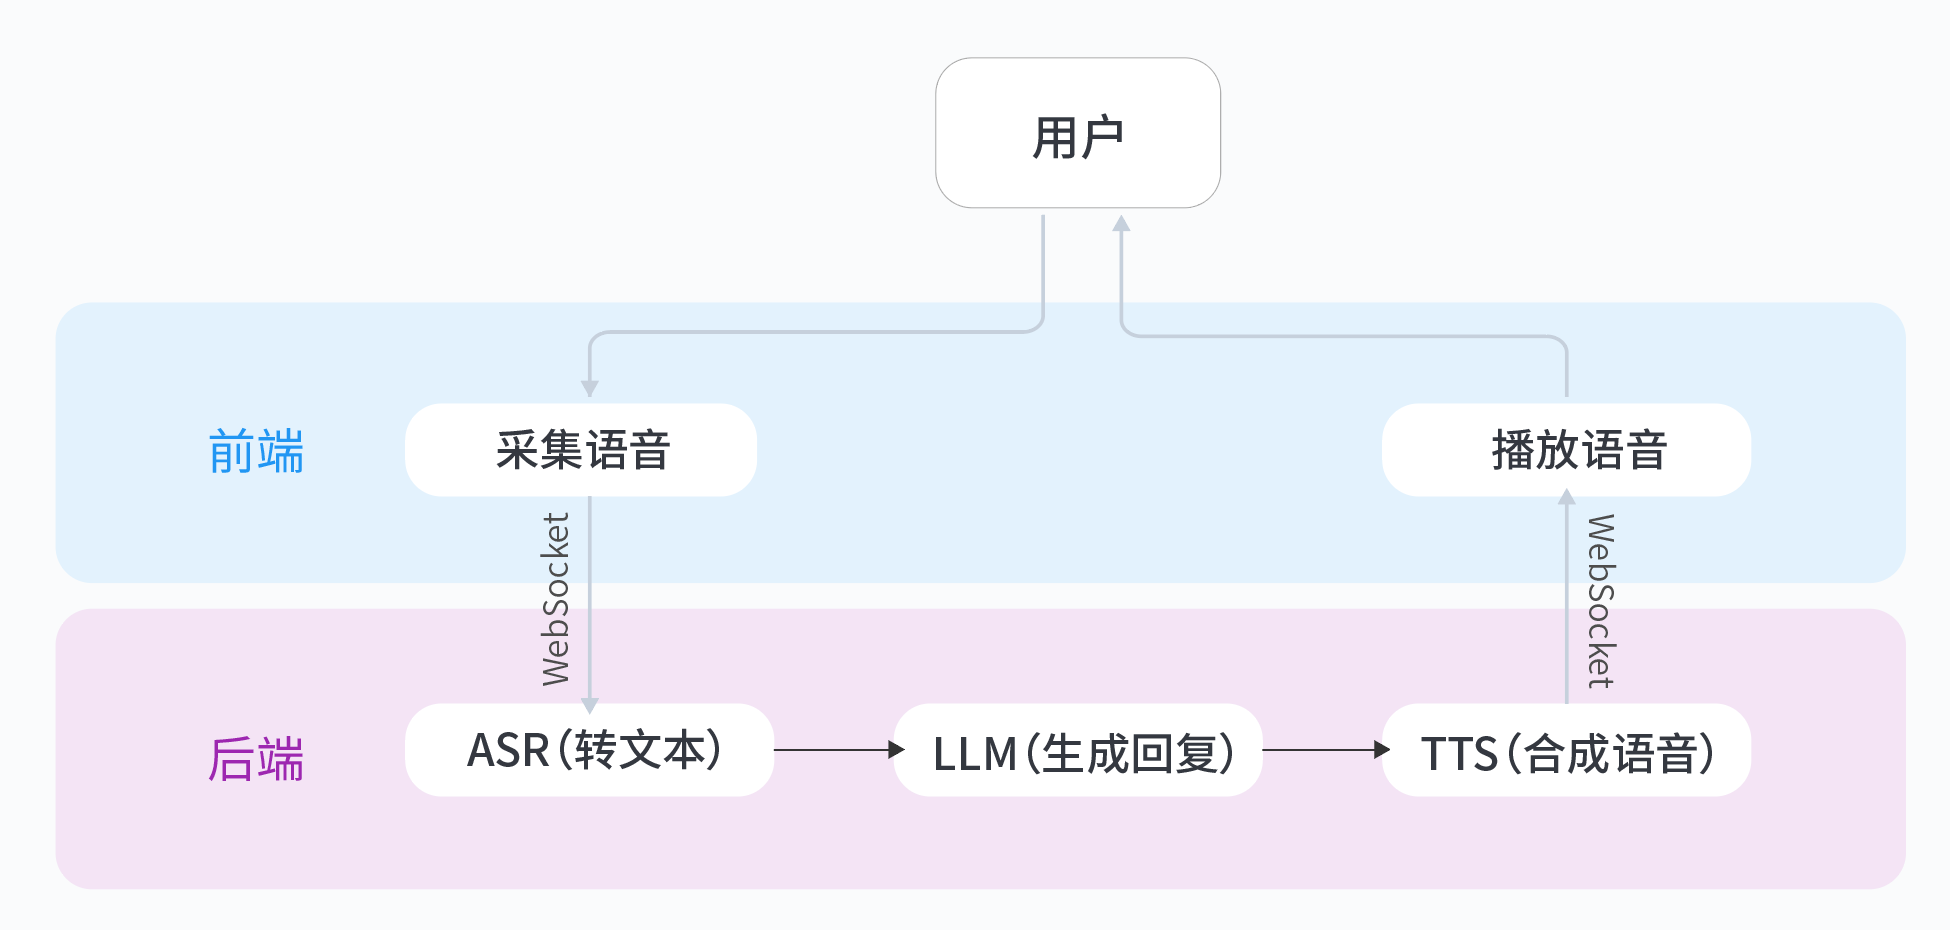
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
AI大模型论文学习路线:从零构建系统化知识体系
刚接触AI领域时,面对arXiv上每天新增的数百篇论文,我经常陷入"打开PDF→看不懂→关掉"的死循环。后来通过系统化的学习路径,终于摸索出一套适合新手的论文学习方法,今天就把这套实战经验分享给大家。
为什么我们总是读不懂AI论文?
刚开始读论文时,我发现主要有三个拦路虎:
- 术语轰炸:每个领域都有专属术语,像Transformer里的QKV矩阵、扩散模型里的马尔可夫链,没基础根本看不懂
- 数学恐惧:看到论文里大段的矩阵推导和概率公式就直接懵了
- 复现困难:即使看懂了理论,真要动手实现时,发现论文里经常省略关键实现细节
三阶段渐进式学习路线
第一阶段:吃透基础模型(1-2个月)
建议从这些经典论文开始,配合代码实现一起学习:
-
Attention Is All You Need(Transformer开山之作)
- 重点理解self-attention公式:$Attention(Q,K,V)=softmax(\frac{QK^T}{\sqrt{d_k}})V$
- 配套代码:HuggingFace的Transformer实现
-
BERT: Pre-training of Deep Bidirectional Transformers
- 掌握MLM和NSP两个预训练任务
- 注意层归一化和残差连接的位置
-
ResNet(CV必读)
- 跳连结构解决梯度消失
- 对比不同深度的网络效果
| 学习阶段 | 时间投入 | 预期产出 |
|---|---|---|
| 基础阶段 | 40-60小时 | 掌握3-5个核心模型架构 |
| 进阶阶段 | 80-120小时 | 能复现经典论文实验 |
| 领域专精 | 100+小时 | 提出改进方案并验证 |
第二阶段:领域专项突破
根据兴趣方向选择细分领域:
NLP方向:
- 先读综述论文《Pre-trained Models for Natural Language Processing》
- 按时间线学习:Word2Vec → ELMo → BERT → GPT-3 → ChatGPT
CV方向:
- 从AlexNet开始,到ResNet、EfficientNet
- 重点关注模型轻量化方法
多模态:
- CLIP模型的跨模态对齐机制
- Stable Diffusion的文本到图像生成
第三阶段:动手复现
以BERT模型改进为例,分享我的复现checklist:
# 数据预处理示例
from transformers import BertTokenizer
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')
inputs = tokenizer("Hello world!", return_tensors="pt")

# 模型修改关键点
class CustomBert(BertPreTrainedModel):
    def __init__(self, config):
        super().__init__(config)
        self.bert = BertModel(config)
        # 添加自定义层
        self.new_layer = nn.Linear(config.hidden_size, 10)

    def forward(self, inputs):
        outputs = self.bert(**inputs)
        # 修改输出层
        return self.new_layer(outputs.last_hidden_state[:,0,:])
实用工具推荐
- arXiv Sanity:适合追踪最新论文,但筛选功能较弱
- Papers With Code:直接关联开源实现,更新有时滞后
- Connected Papers:可视化论文关联关系,适合溯源研究脉络
新手避坑指南
识别低质量论文:
- 实验部分缺少消融研究
- 对比基线选择不合理
- 效果提升仅靠调参
数学公式理解技巧:
- 先看文字描述,再对照公式
- 用具体数值代入验证
- 画出计算流程图
资源不足怎么办:
- 使用Colab免费GPU
- 减小batch size和模型尺寸
- 先复现关键部分而非完整实验
BERT改进论文精读Checklist
- [ ] 是否明确了改进动机?
- [ ] 实验设计是否控制变量?
- [ ] 消融实验是否充分?
- [ ] 计算成本是否合理?
- [ ] 开源代码是否完整?
思考题
- 如果让你改进Transformer的attention机制,会从哪些角度入手?
- 如何设计实验验证论文提出的方法确实有效?
- 当论文效果无法复现时,应该按什么顺序排查问题?
如果想体验更直观的AI应用开发,可以试试这个从0打造个人豆包实时通话AI动手实验,它能帮你快速理解语音AI的完整技术链路。我亲自尝试后发现,通过实际项目反推论文原理,学习效率会高很多。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
更多推荐

 7
 0
- 0


 已为社区贡献6条内容

所有评论(0)