
AI生成视频大模型入门指南:从原理到实战部署
快速体验
在开始今天关于 AI生成视频大模型入门指南:从原理到实战部署 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
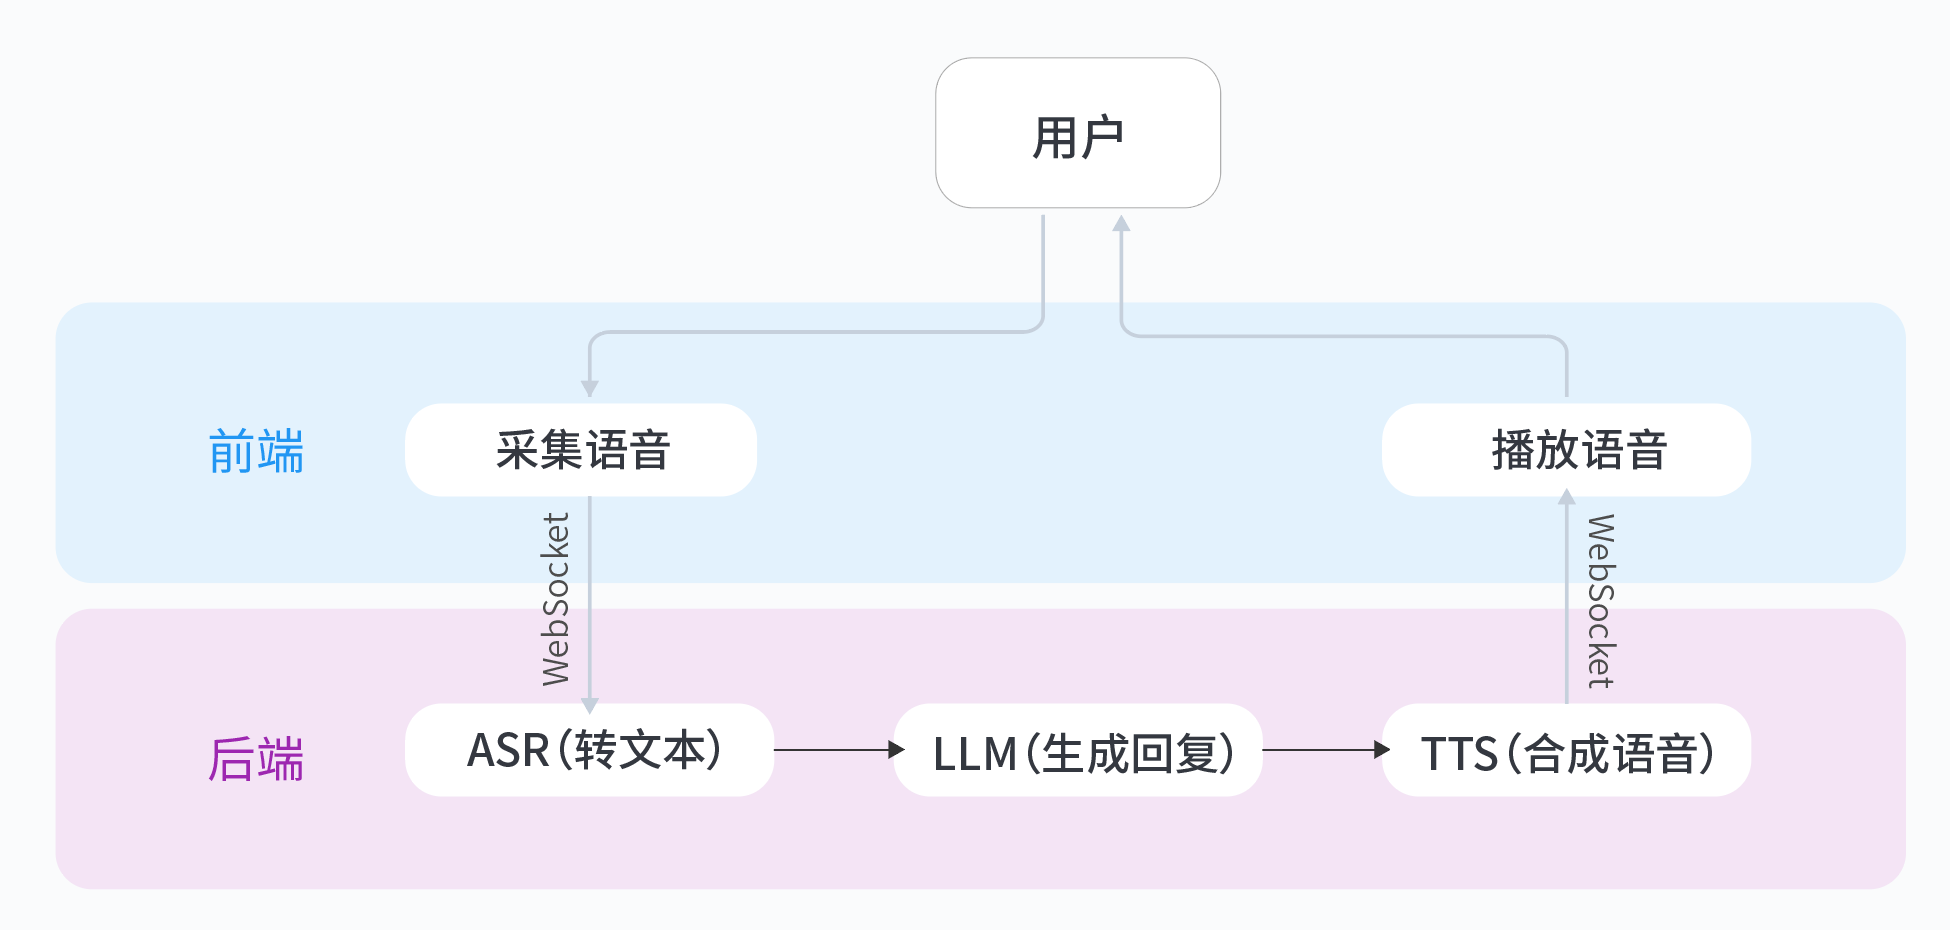
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
AI生成视频大模型入门指南:从原理到实战部署
背景痛点:为什么视频生成比图片更难?
视频生成任务相比静态图像生成面临几个核心挑战:
- 时序一致性:需要保持物体在不同帧之间的连贯运动,避免出现"闪烁"或"突变"现象
- 计算复杂度:处理时间维度导致显存占用和计算量呈指数级增长
- 运动控制:难以精确控制物体运动轨迹和速度
- 分辨率限制:高分辨率视频对硬件要求极高,目前主流模型输出通常在512×512或更低
主流模型技术对比
| 模型名称 | 核心技术 | 最大分辨率 | 突出特点 | 适用场景 |
|---|---|---|---|---|
| Stable Video Diffusion | 潜在扩散模型 | 1024×576 | 开源可用,社区生态丰富 | 创意短片、产品演示 |
| Pika | 3D卷积+时空注意力 | 1080p | 运动控制精确 | 动画制作、影视辅助 |
| Sora | Diffusion Transformer | 4K | 长视频生成能力 | 专业影视制作 |
核心实现:基于Diffusers的视频生成管道
环境准备
# 安装必要库
pip install diffusers transformers torch accelerate
基础生成代码示例
from diffusers import StableVideoDiffusionPipeline
import torch

# 1. 加载预训练模型
pipe = StableVideoDiffusionPipeline.from_pretrained(
    "stabilityai/stable-video-diffusion-img2vid",
    torch_dtype=torch.float16,
    variant="fp16"
).to("cuda")

# 2. 配置生成参数
generator = torch.Generator("cuda").manual_seed(42)

# 3. 生成视频帧序列
frames = pipe(
    image="input_image.png",  # 输入引导图像
    height=512,
    width=512,
    num_frames=24,  # 帧数
    num_inference_steps=25,  # 推理步数
    min_guidance_scale=1.0,  # 最小引导系数
    max_guidance_scale=3.0,  # 最大引导系数
    fps=12,  # 帧率
    motion_bucket_id=127,  # 运动强度(80-255)
    noise_aug_strength=0.02,  # 噪声增强
    generator=generator
).frames[0]

# 4. 保存为GIF或视频
frames[0].save("output.gif", save_all=True, append_images=frames[1:], duration=100, loop=0)
关键参数说明:
motion_bucket_id:控制运动幅度,值越大运动越剧烈noise_aug_strength:影响视频稳定性,建议0.01-0.1num_inference_steps:平衡质量与速度,通常20-50步
优化实践:提升生成效率与质量
显存优化技巧
-
梯度检查点:
pipe.enable_model_cpu_offload() pipe.enable_vae_slicing() -
低精度推理:
pipe = pipe.to(torch.float16)
提示词工程建议
- 明确时间描述:"从左向右缓慢平移"
- 避免矛盾指令:"同时出现晴天和雨天"
- 使用运动关键词:"缓慢旋转"、"平稳缩放"
避坑指南:常见问题解决方案
帧间闪烁问题
- 增加
noise_aug_strength(0.05-0.1) - 使用一致性损失函数:
pipe.config.use_consistency_loss = True
运动失真处理
- 调整
motion_bucket_id至中间值(120-150) - 添加运动约束提示词:"自然流畅的运动"
生产环境部署建议
-
实现批量处理:
def batch_process(images, batch_size=4): # 实现批量推理逻辑 -
添加容错机制:
try:
    frames = pipe(...)
except torch.cuda.OutOfMemoryError:
    # 自动降级处理
延伸思考:ControlNet视频控制
尝试将ControlNet应用于视频生成,实现更精确的控制:
- 姿势序列控制舞蹈动作
- 深度图引导场景转换
- 边缘检测保持角色一致性
from diffusers import ControlNetModel

controlnet = ControlNetModel.from_pretrained(
    "lllyasviel/sd-controlnet-openpose",
    torch_dtype=torch.float16
)
通过这篇指南,你应该已经掌握了AI视频生成的基础流程和关键技巧。如果想进一步实践完整的实时AI应用开发,推荐尝试从0打造个人豆包实时通话AI实验项目,它提供了从语音识别到生成的完整闭环体验,对理解多模态AI系统很有帮助。我在实际操作中发现,这种端到端的项目能快速建立对AI应用开发的整体认知,特别适合想要动手实践的开发者。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
更多推荐

 4
 0
- 0


 已为社区贡献7条内容

所有评论(0)