
机器学习-朴素贝叶斯分类器
环境
C++:VS2022
Python:Pycharm、anaconda环境下的包numpy
贝叶斯公式
公式原理
贝叶斯公式是概率论中用于逆推条件概率的核心定理,核心是用先验概率结合新证据,计算后验概率,实现对概率的动态修正。
核心公式:
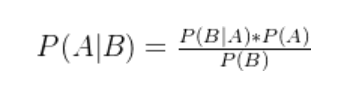
推导
条件概率定义:
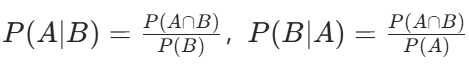
乘法公式:由上述两式得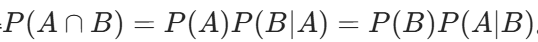
贝叶斯公式推导:联立两式得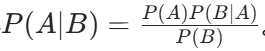
全概率补充:分母P(B)常通过全概率公式展开,将复杂概率拆解为可计算的分量。
为什么朴素贝叶斯分类器有个“朴素”前缀
在朴素贝叶斯分类器中,我们需要概率来预测事件,以此达到分类的目的。如果严格按照原来的贝叶斯公式计算,遇到事件不相互独立的情况时,我们需要计算很多个事件共同发生的概率和在我们要预测的事件的前提下共同发生的概率,计算量比较大,但是我们默认事件是相互独立的,计算量就小很多了。这个朴素就是假设事件相互独立,减小计算量。
公式说明
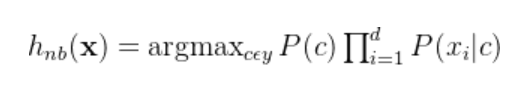
nb是naive bayes的缩写,就是朴素贝叶斯的意思;argmax是取最大值,从右边的一整串乘法式子中取出最大的后验概率;Π这种符号就是累乘的意思,从第一个特征累乘到d;P()就是概率。我们最终认为,后验概率最大的事件就是会发生的事件。
相比贝叶斯公式,这个公式是没有除以P(x)的,原因是最终比较时,都是除以P(x)的,也就是有没有使用到这个数据处理,结果不会变,所以我们不需要特地在进行除法运算,减少计算量。
误差修正
朴素贝叶斯分类器计算后验概率时进行了累乘,如果里面出现了零,整个结果就会为零,其他因素就相当于是没有在考虑范围内。当某个类别中的离散特征没有出现所有类别时,空缺的类别概率就会计算出0,当我们使用这个标记为0的特征对应的类别时,只有训练集上的样本能被正确分类,而训练集以外的样本在这一类别下计算出来的一定是0,和别的概率比较下来,一定不会被选中。这种情况会导致过拟合。
这时我们用到拉普拉斯修正:
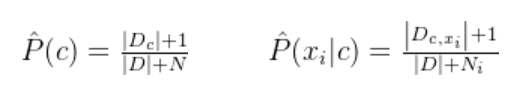
防溢出处理
在进行乘法运算时,难免会遇到数值很小的两个数相乘,无论是C++还是Python,当数据小于可以表示的精度时,数据将被设置为0。为了防止这种情况发生,我们使用对数运算来解决,因为ln可以把数据从比较小的映射到比较大的数据,防溢出使用正好合适。
公式:
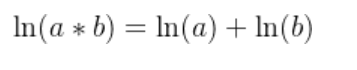
获取概率
对于离散特征
直接求出占比即可,用到的公式:
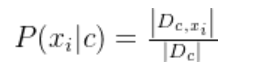
对于连续特征
使用概率密度公式,要对当前的数据集中连续特征的所有值求均值、方差和标准差;
用到的公式:
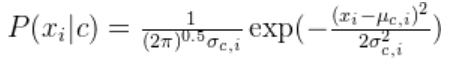
示例
预测西瓜是不是好瓜
训练集:
色泽,根蒂,敲声,纹理,脐部,触感,密度,含糖率,好瓜
青绿,蜷缩,浊响,清晰,凹陷,硬滑,0.697,0.460,是
乌黑,蜷缩,沉闷,清晰,凹陷,硬滑,0.774,0.376,是
乌黑,蜷缩,浊响,清晰,凹陷,硬滑,0.634,0.264,是
青绿,蜷缩,沉闷,清晰,凹陷,硬滑,0.608,0.318,是
浅白,蜷缩,浊响,清晰,凹陷,硬滑,0.556,0.215,是
青绿,稍蜷,浊响,清晰,稍凹,软粘,0.403,0.237,是
乌黑,稍蜷,浊响,稍糊,稍凹,软粘,0.481,0.149,是
乌黑,稍蜷,浊响,清晰,稍凹,硬滑,0.437,0.211,是
乌黑,稍蜷,沉闷,稍糊,稍凹,硬滑,0.666,0.091,否
青绿,硬挺,清脆,清晰,平坦,软粘,0.243,0.267,否
浅白,硬挺,清脆,模糊,平坦,硬滑,0.245,0.057,否
浅白,蜷缩,浊响,模糊,平坦,软粘,0.343,0.099,否
青绿,稍蜷,浊响,稍糊,凹陷,硬滑,0.639,0.161,否
浅白,稍蜷,沉闷,稍糊,凹陷,硬滑,0.657,0.198,否
乌黑,稍蜷,浊响,清晰,稍凹,软粘,0.360,0.370,否
浅白,蜷缩,浊响,模糊,平坦,硬滑,0.593,0.042,否
青绿,蜷缩,沉闷,稍糊,稍凹,硬滑,0.719,0.103,否
测试集:
色泽,根蒂,敲声,纹理,脐部,触感,密度,含糖率,好瓜
青绿,蜷缩,浊响,清晰,凹陷,硬滑,0.697,0.460
将文字转换成数字,便于观察:
数据集:
0,0,0,0,0,0,0.697,0.460,0
1,0,1,0,0,0,0.774,0.376,0
1,0,0,0,0,0,0.634,0.264,0
0,0,1,0,0,0,0.608,0.318,0
2,0,0,0,0,0,0.556,0.215,0
0,1,0,0,1,1,0.403,0.237,0
1,1,0,1,1,1,0.481,0.149,0
1,1,0,0,1,0,0.437,0.211,0
1,1,1,1,1,0,0.666,0.091,1
0,2,2,0,2,1,0.243,0.267,1
2,2,2,2,2,0,0.245,0.057,1
2,0,0,2,2,1,0.343,0.099,1
0,1,0,1,0,0,0.639,0.161,1
2,1,1,1,0,0,0.657,0.198,1
1,1,0,0,1,1,0.360,0.370,1
2,0,0,2,2,0,0.593,0.042,1
0,0,1,1,1,0,0.719,0.103,1
测试机:
0,0,0,0,0,0,0.697,0.460
然后我们需要导入数据,用特定的数据结构存(Python使用numpy),把数据整理成一张概率表,最后到对应的框中获取概率累乘就能算出多个标签的概率,根据MAP准则选择最大的,认为是这个样本的标签。
C++实现
结构体
// 存数据样本的
struct Data
{
	vector<int> disperse;
	vector<double> continuous;
	int tag;
};

// 存连续特征的
struct ContinuousStats
{
	double mean; // 平均值
	double variance; // 方差
	double deviation; // 标准差
};
统计连续特征的函数
ContinuousStats stats(std::vector<double>& values)
{
	Assert(!values.empty(), "stats: values is empty!");
	double avg = accumulate(values.begin(), values.end(), 0.0) / values.size();
	double sum = 0.0;
	for (double value : values)
	{
		double gap = value - avg;
		sum += gap * gap;
	}
	double variance = sum / values.size();
	double deviation = sqrt(variance);

	return {avg, variance, deviation};
}
遍历特征列,计算均值、方差和标准差。
生成概率表
pair<
	unordered_map<int, double>,
	pair<
		vector<vector<unordered_map<int, double>>>,
		vector<vector<ContinuousStats>>
		>
	> compressData(vector<Data>& data)
{
	Assert(!data.empty(), "compressData: data is empty");

	vector<vector<unordered_map<int, double>>> ds_list;
	vector<vector<ContinuousStats>> ct_list;

	auto transformation = transform(data);
	vector<vector<int>> ds_tf(transformation.first.begin(), transformation.first.end() - 1);
	vector<int> tag_tf(*(transformation.first.end() - 1));
	vector<vector<double>> ct_tf = transformation.second;

	double total = data.size();
	int ds_num = data[0].disperse.size();
	int ct_num = data[0].continuous.size();

	unordered_map<int, int> group_data;
	for (int tag : tag_tf)
		group_data[tag]++;

	ds_list.resize(group_data.size());
	ct_list.resize(group_data.size());

	vector<int> ds_vocab;
	ds_vocab.reserve(ds_num);
	for (auto& ds : ds_tf)
		ds_vocab.push_back(unique(ds).size());

	unordered_map<int, double> prior_prob;
	prior_prob.reserve(group_data.size());

	int tag_pos = 0;
	for (const auto& d : group_data)
	{
		// 计算先验概率
	#ifndef RAW
		prior_prob[d.first] = log(d.second / total);
	#else
		prior_prob[d.first] = d.second / total;
	#endif
		// 计算离散特征的概率
		cout << "离散特征:" << endl;
		vector<unordered_map<int, double>> ds_prob;
		ds_prob.reserve(ds_num);
		for (int i = 0; i < ds_num; ++i)
		{
			auto ds = ds_tf[i];
			int vocab = ds_vocab[i];
			unordered_map<int, double> feature_prob;
			for (int j = 0; j < total; ++j)
			{
				if(d.first == tag_tf[j])
					feature_prob[ds[j]]++;
			}
			for (auto& port : feature_prob)
			{
				port.second = (port.second + 1) / (d.second + vocab);
	#ifndef RAW
				port.second = log(port.second);
	#endif
				cout << port.second << " ";
			}
			cout << endl;
			ds_prob.push_back(feature_prob);
		}
		ds_list[tag_pos] = move(ds_prob);

		// 计算连续特征的概率密度
		cout << "连续特征:" << endl;
		vector<ContinuousStats> feature_density;
		feature_density.reserve(ct_num);
		for (auto& ct : ct_tf)
		{
			vector<double> sub;
			for (int j = 0; j < total; ++j)
			{
				if (d.first == tag_tf[j])
					sub.push_back(ct[j]);
			}
			feature_density.push_back(stats(sub));
		}
		for (auto& feature : feature_density)
			cout << feature.mean << " " << feature.variance << " " << feature.deviation << endl;
		ct_list[tag_pos] = move(feature_density);

		tag_pos++;
	}

	return make_pair(prior_prob, make_pair(ds_list, ct_list));
}
在离散特征计算中,需要提前统计特征类别数量,参与拉普拉斯计算
在连续特征计算中,需要获取一整列的数据,传入stats中统计,生成ContinuousStats变量。
预测函数
int bayes(unordered_map<int, double> prior_prob,
	vector<vector<unordered_map<int, double>>> ds_list,
	vector<vector<ContinuousStats>> ct_list, Data test)
{
	double max = -1e18;
	int label = -1;
	for (const auto& port : prior_prob)
	{
		double val = port.second;

#ifndef RAW
		for (int i = 0; i < test.disperse.size(); ++i)
			val += ds_list[port.first][i][test.disperse[i]];
		for (int i = 0; i < test.continuous.size(); ++i)
			val += prob_density(ct_list[port.first][i], test.continuous[i]);
#else
		for (int i = 0; i < test.disperse.size(); ++i)
			val *= ds_list[port.first][i][test.disperse[i]];
		for (int i = 0; i < test.continuous.size(); ++i)
			val *= prob_density(ct_list[port.first][i], test.continuous[i]);
#endif
		cout << val << endl;
		if (max < val)
		{
			max = val;
			label = port.first;
		}
	}

	return label;
}
遍历概率表,获取对应的特征类别的概率,或者当场计算,如果使用了防溢出处理,累加这些概率,否则需要累乘,然后选出最合适的标签。
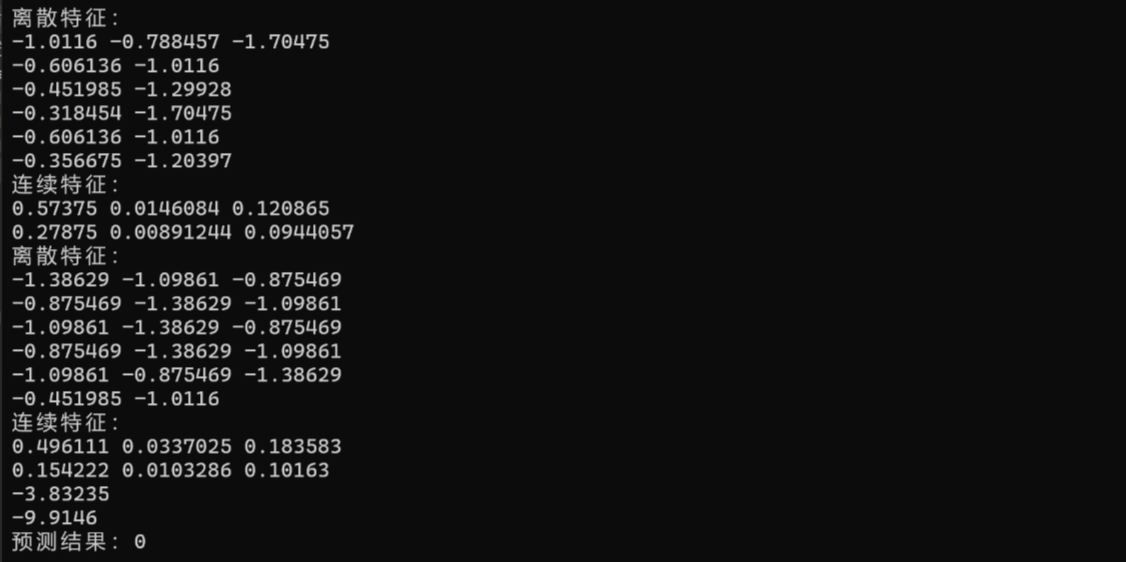
结果展示
Python实现
类
class ContinuousStats:
    def __init__(self, mean = 0.0, variance = 0.0, deviation = 0.0):
        self.mean = mean
        self.variance = variance
        self.deviation = deviation
统计连续特征的函数
def stats(values: list) -> ContinuousStats | None:
    if values is None:
        return None
    avg = float(np.mean(values))
    cnt = 0.0
    for val in values:
        gap = val-avg
        cnt += gap*gap
    variance = cnt / len(values)
    deviation = variance**0.5

    return ContinuousStats(avg, variance, deviation)
生成概率表
def get_prob_cnt(data: np.ndarray, preserve: bool = False) -> (dict, dict, dict):
    ds_list = {}
    ct_list = {}

    # 分离离散特征和连续特征
    transform_data = data.T
    disperse = []
    continuous = []
    tag_t = transform_data[-1]
    for feature in transform_data[:-1]:
        flag = 0
        for f in feature:
            if f != int(f):
                flag = 1
                break
        if flag:
            continuous.append(feature)
        else:
            disperse.append(feature)

    # 计算拉普拉斯修正需要的同一特征的所有类型
    ds_vocab = []
    for ds_feature in disperse:
        vocab = len(np.unique(ds_feature))
        ds_vocab.append(vocab)

    # 计算先验概率
    total = float(len(data))
    tag_list, tag_num = np.unique(data[:,-1], return_counts=True)
    tag_num = tag_num.astype(float)
    prior_prob = {}
    for tag, num in zip(tag_list, tag_num):
        prior_prob[tag] = num / total if not preserve else np.log(num / total)

    for (tag, num) in zip(tag_list, tag_num):
        # 计算离散特征概率
        ds_prob = []
        for i in range(len(disperse)):
            ds_feature = disperse[i]
            vocab = np.unique(ds_feature)
            feature_cnt = {x:1.0 for x in vocab}
            for j in range(len(tag_t)):
                if tag_t[j] == tag:
                    feature_cnt[ds_feature[j]] += 1.0
            for (key, value) in feature_cnt.items():
                prob = value/(num+ds_vocab[i])
                feature_cnt[key] = prob if not preserve else np.log(prob)
            ds_prob.append(feature_cnt)
        ds_list[tag] = ds_prob

        # 计算连续特征概率密度
        ct_prob_dense = []
        for ct_feature in continuous:
            mask = (tag == tag_t)
            sub_ct = ct_feature[mask]
            ct_prob_dense.append(stats(sub_ct))
        ct_list[tag] = ct_prob_dense


    return prior_prob, ds_list, ct_list
预测函数
def bayes_classifier(prior_prob: dict, ds_list: dict, ct_list: dict, test: np.ndarray, preserve: bool = False) -> int:
    disperse = []
    continuous = []
    for t in test:
        if t != int(t):
            continuous.append(t)
        else:
            disperse.append(t)

    max_label = -1
    max_value = -1e18
    for tag, prob in prior_prob.items():
        val = prob
        if preserve:
            for i in range(len(disperse)):
                val += ds_list[tag][i][disperse[i]]
            for i in range(len(continuous)):
                val += prob_density(ct_list[tag][i], continuous[i], preserve)
        else:
            for i in range(len(disperse)):
                val *= ds_list[tag][i][disperse[i]]
            for i in range(len(continuous)):
                val *= prob_density(ct_list[tag][i], continuous[i], preserve)
        print(f"类别{tag:.0f}的概率:{val}")
        if max_value < val:
            max_value = val
            max_label = tag
    return max_label
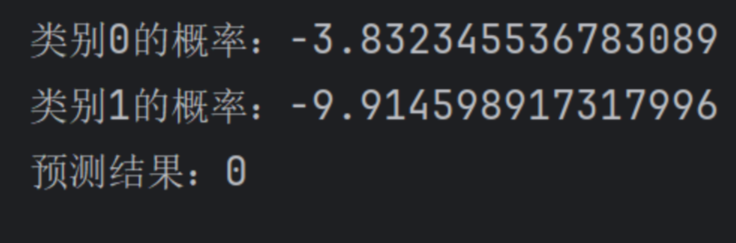
测试结果
更多推荐

 16
 0
- 0


 已为社区贡献5条内容

所有评论(0)