
【SpringCloud】微服务保护和分布式事务
目录
前言
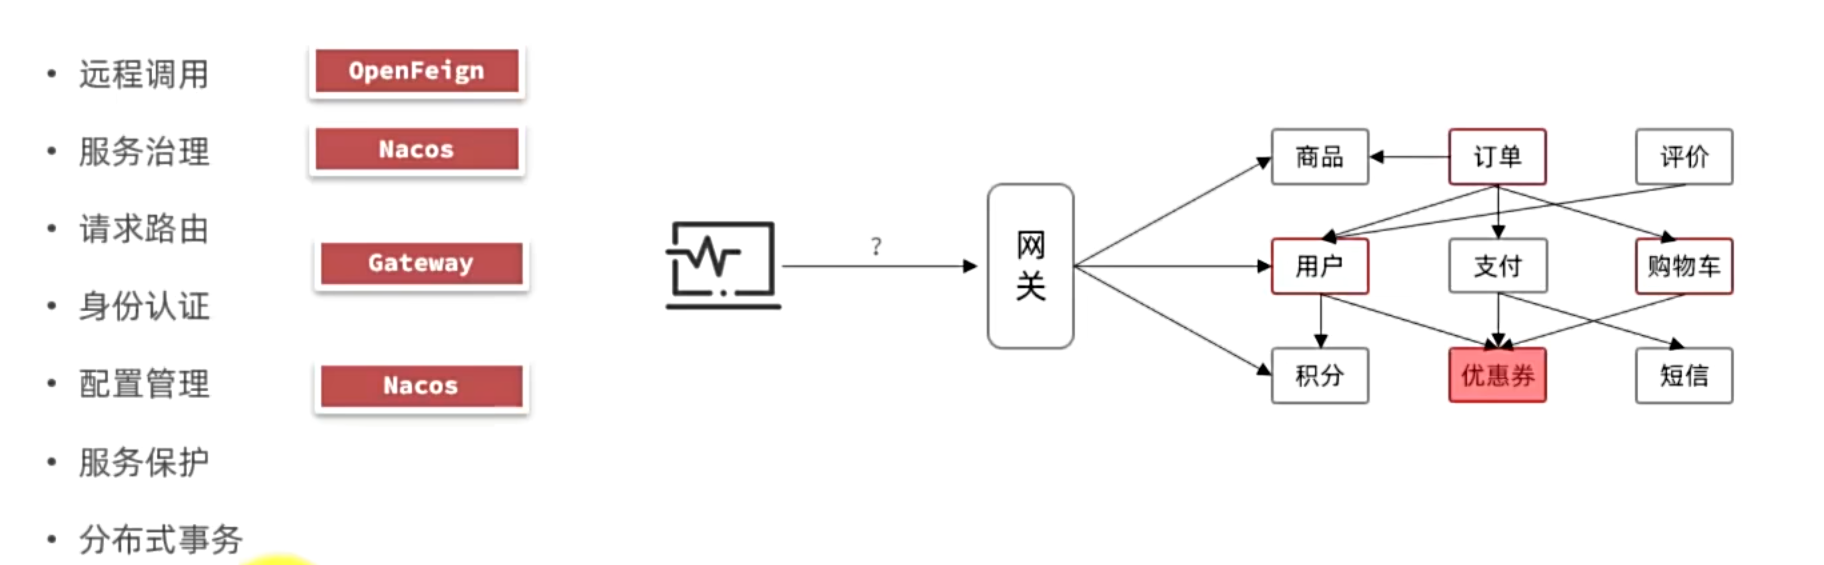
在微服务远程调用的过程中,还存在一些问题需要解决。
首先是业务健壮性问题:
例如现在有这样的一个项目,当查询购物车列表的时候,需要同时查询最新的商品信息,与当前购物车中的数据做对比。如果商品微服务模块此时出现了故障,那么查询购物车列表也会出现异常。但从业务角度来看,即使查询商品出现了问题,购物车列表也应该显示出来,哪怕不包含最新的商品信息。
还有级联失效问题:
还是查询购物车的业务,如果此时对商品查询业务的并发较高,占用过多的Tomcat连接。可能会导致商品服务中所有接口响应时间增加。
此时查询购物车业务需要查询并等待商品的查询结果,因为商品查询并发较高,因此也就导致查询购物车业务响应时间变长。因为请求是源源不断的,如果前面的请求接收不到响应,就会一直占用Tomcat中的线程,后面的请求就会占用新的线程,最终可能会导致Tomcat中的资源耗尽,服务的性能就会很差。
同理,如果有其他服务需要调用购物车模块中的查询购物车功能,该服务也会受到影响,从而影响整个项目。
这就是雪崩问题。(一个小的问题从而引发一个十分严重的问题)
总结:当某个服务因资源耗尽、响应延迟或代码错误而失效时,依赖它的上游服务会因等待响应而阻塞线程。若未及时释放资源,阻塞会持续蔓延,直至整个系统不可用。这一过程类似雪崩,由局部故障演变为全局瘫痪。
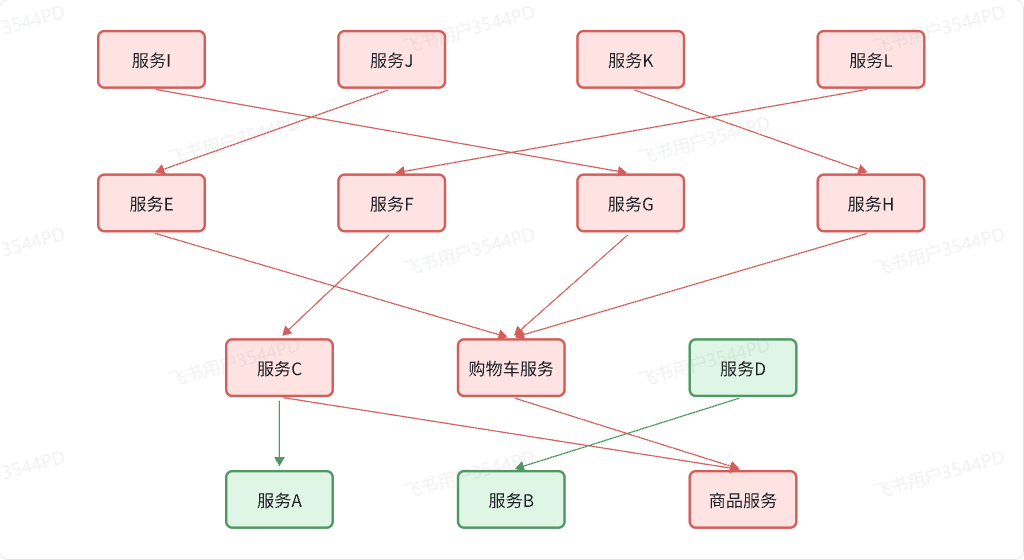
雪崩问题产生的原因是什么?
- 微服务相互调用,服务提供者出现故障或阻塞。
- 服务调用者没有做好异常处理,导致自身故障。
- 调用链中的所有服务级联失败,导致整个集群故障
解决问题的思路有哪些?
- 尽量避免服务出现故障或阻塞。
- ✅ 保证代码的健壮性;
- ✅ 保证网络畅通;
- ✅ 能应对较高的并发请求;
- 服务调用者做好远程调用异常的后备方案,避免故障扩散
一、微服务保护
1. 微服务保护方案
微服务保护方案有很多,常用的有以下三种:请求限流、线程隔离、服务熔断。
1.1 请求限流
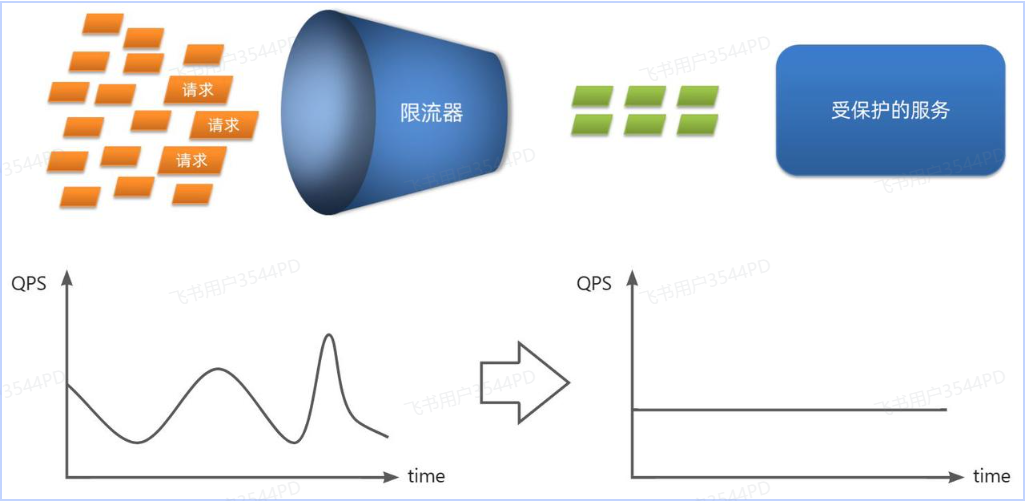
服务故障的一个重要原因就是并发太高。因此请求限流就是限制或控制接口访问的并发流量,避免服务因流量激增而出现故障。
请求限流往往会有一个限流器,数量高低起伏的并发请求曲线,经过限流器就变的非常平稳。这就像是水电站的大坝,起到蓄水的作用,可以通过开关控制水流出的大小,让下游水流始终维持在一个平稳的量。
1.2 线程隔离
当一个业务接口响应时间过长,而且并发高时,就可能耗尽服务器的线程资源,导致服务内的其他接口受到影响。就需要用到线程隔离。
线程隔离可以限定每个接口可以用到的资源范围,也就是将其“隔离”起来。
线程隔离:也叫做舱壁模式,模拟船舱隔板的防水原理。通过限定每个业务能使用的线程数量而将故障业务隔离,避免故障扩散。
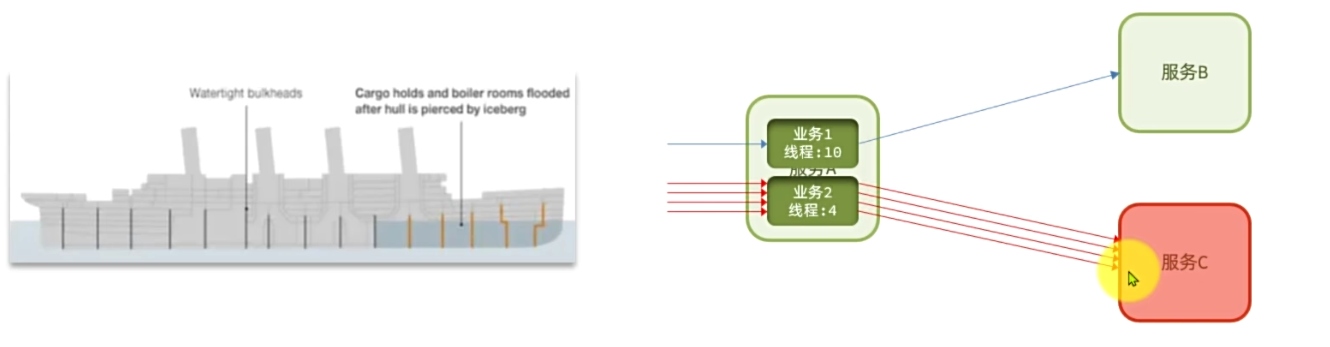
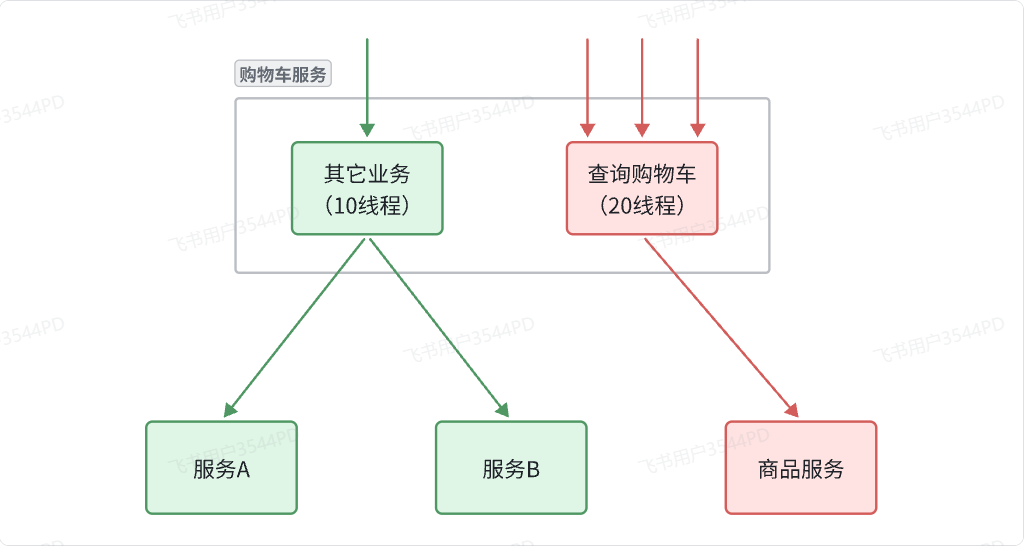
如图所示,给查询购物车的接口只分配了20个线程,这时就算查询购物车业务发生了异常,也不会影响到购物车服务中的其他接口正常运行。
1.3 服务熔断
线程隔离虽然避免了雪崩问题,但故障服务(商品服务)依然会拖慢购物车服务(服务调用方的接口响应速度)。而且商品查询的故障依然会导致查询购物车的功能出现故障,购物车的业务也就不可用了。
所以,要做两件事:
编写服务降级逻辑:就是服务调用失败后的处理逻辑,根据业务场景,可以抛出异常,也可以返回友好提示或默认数据
异常统计和熔断:统计服务提供方的异常比例,当比例过高表明该接口会影响到其他业务,此时就拒绝调用该接口,直接走降级逻辑。
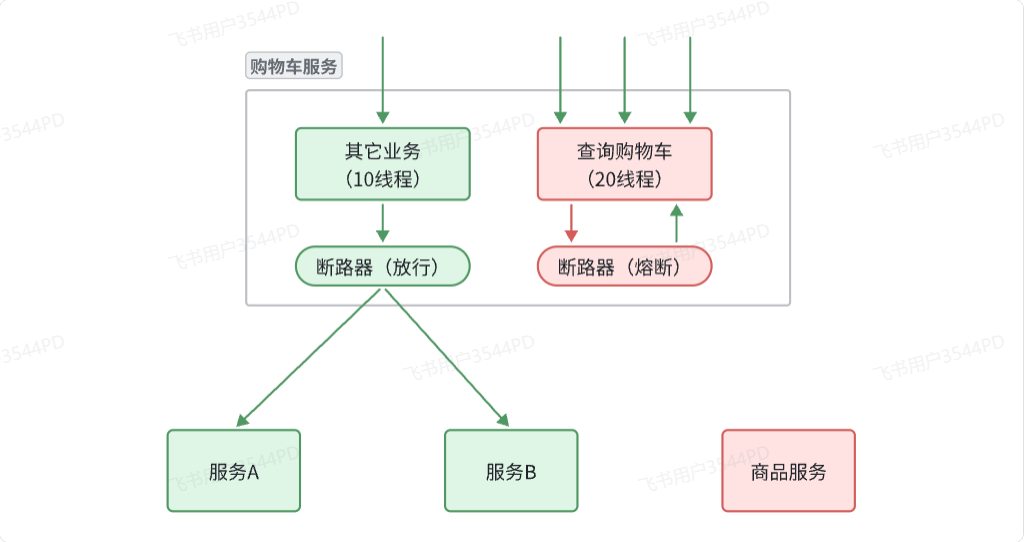
服务熔断:由断路器统计请求的异常比例或慢调用比例,如果超出阈值则会熔断该业务,则拦截该接口的请求。熔断期间,所有请求快速失败,全都走 fallback 逻辑。
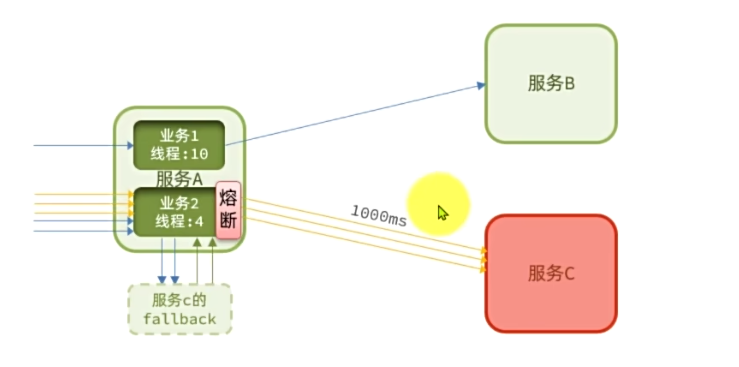
解决雪崩问题的常见方案有哪些?
- 请求限流:限制流量在服务可以处理的范围,避免因突发流量而故障
- 线程隔离:控制业务可用的线程数量,将故障隔离在一定范围
- 服务熔断:将异常比例过高的接口断开,拒绝所有请求,直接走 fallback
- 失败处理:定义 fallback 逻辑,让业务失败时不再抛出异常,而是返回默认数据或友好提示
2. Sentinel
2.1 安装
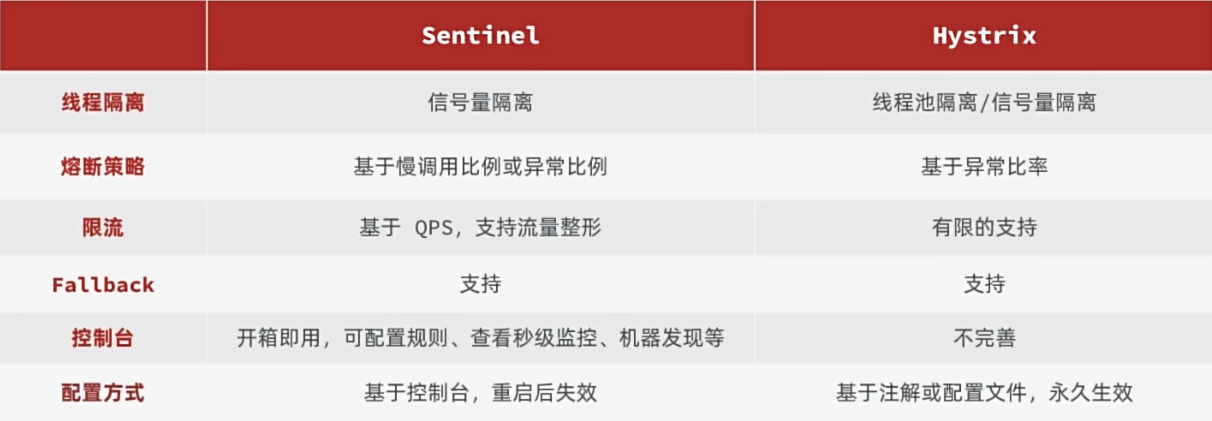
Sentinel是阿里巴巴开源的一款服务保护框架,目前已经加入SpringCloudAlibaba中。
Sentinel 是阿里巴巴开源的一款微服务流量控制组件。官网地址:https://sentinelguard.io/zh-cn/index.html
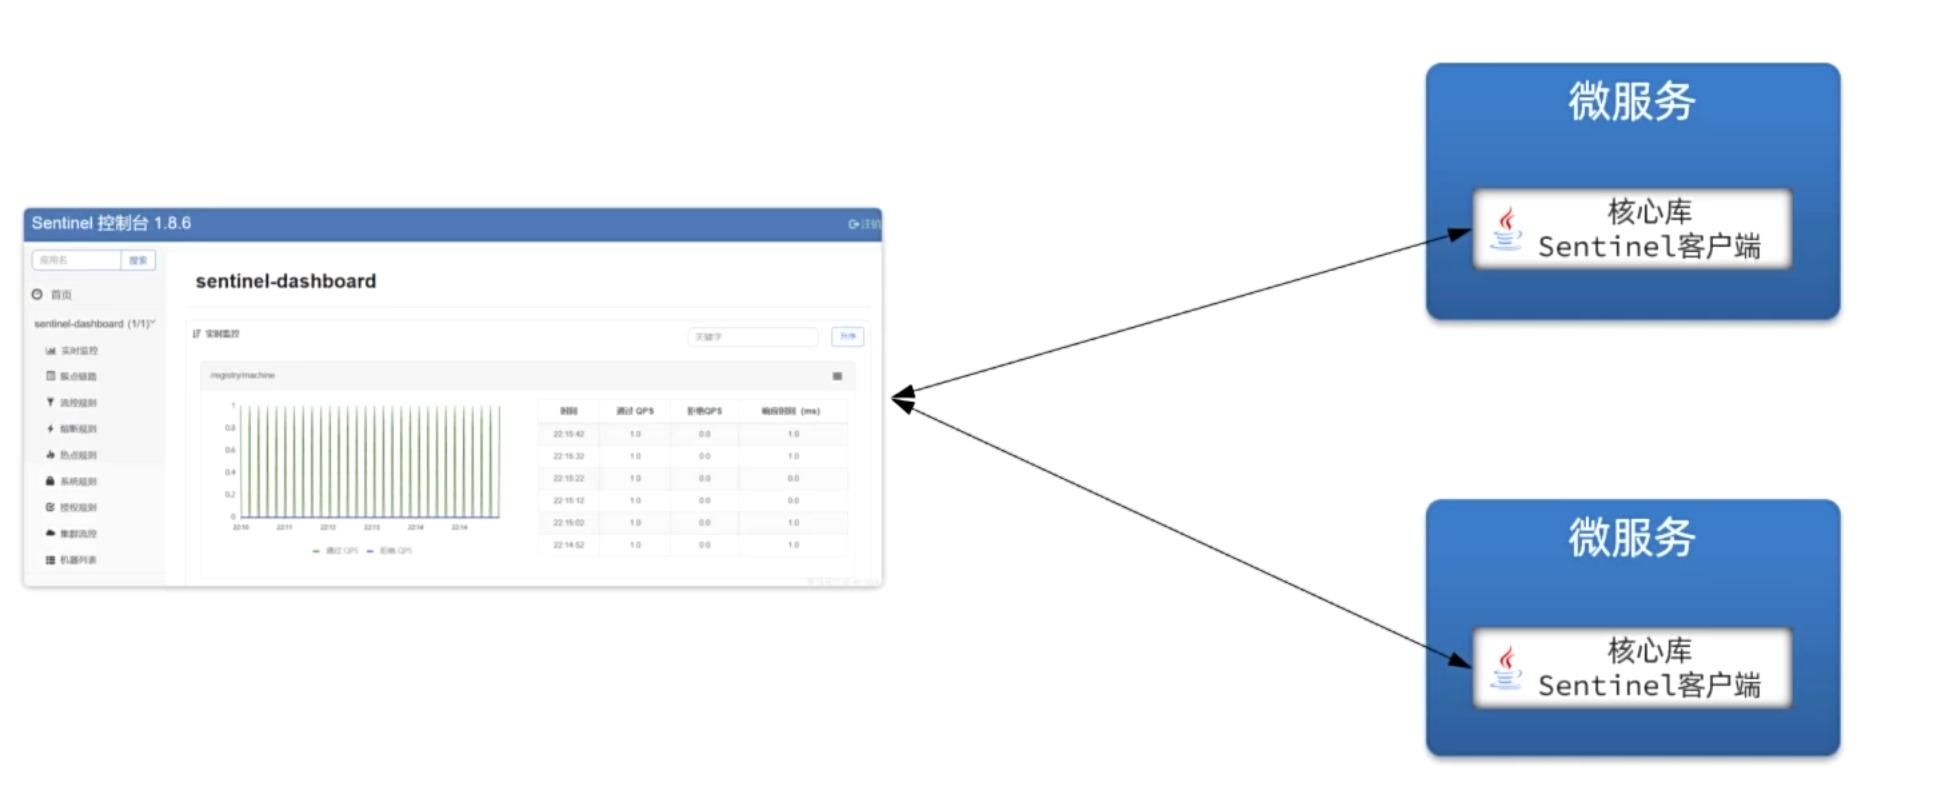
首先先去GitHub中下载响应的jar包https://github.com/alibaba/Sentinel/releases。
然后将jar包放在任意非中文、不包含特殊字符的目录下,重命名为sentinel-dashboard.jar
运行下面的命令启动控制台:
java -Dserver.port=8090 -Dcsp.sentinel.dashboard.server=localhost:8090 -Dproject.name=sentinel-dashboard -jar sentinel-dashboard.jar访问http://localhost:8090页面,就可以看到sentinel的控制台了:
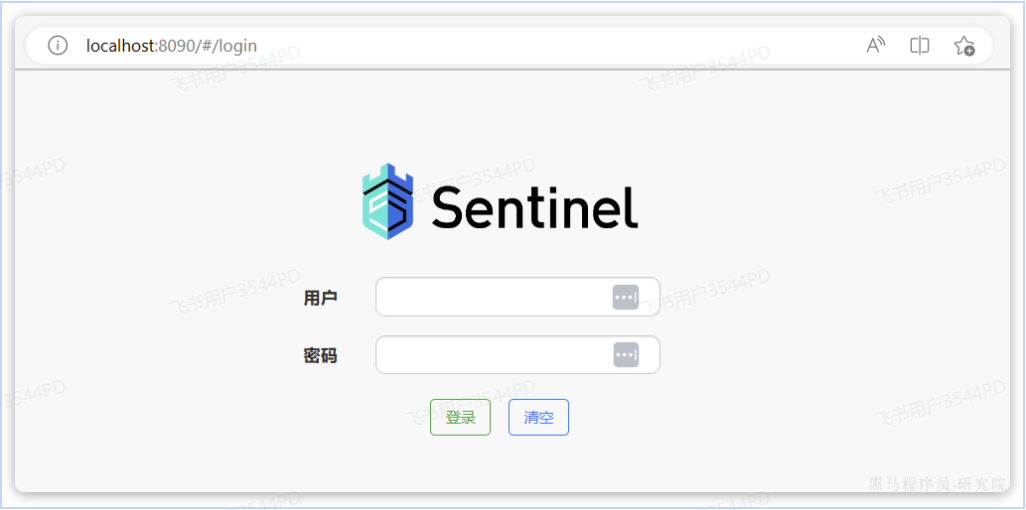
需要输入账号和密码,默认都是:sentinel。登录后,即可看到控制台,默认会监控sentinel-dashboard服务本身:
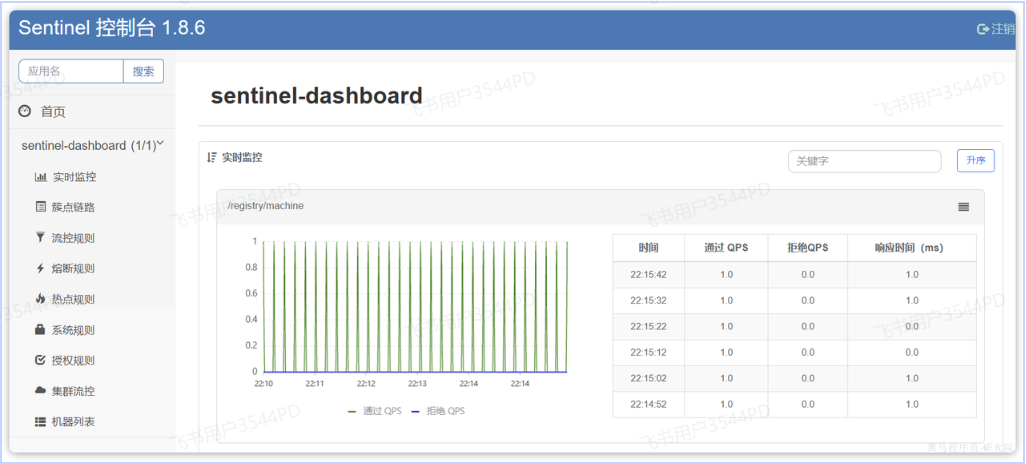
2.2 微服务整合
若要在微服务模块中整合Sentinel,连接控制台,步骤如下:
1)引入依赖
<!--sentinel-->
<dependency>
    <groupId>com.alibaba.cloud</groupId>
    <artifactId>spring-cloud-starter-alibaba-sentinel</artifactId>
</dependency>
2)配置yaml文件
添加如下内容(换成你自己设置的地址和ip端口):
spring:
  cloud:
    sentinel:
      transport:
        dashboard: localhost:8090  # sentinel控制台地址
3)访问微服务模块的任意接口,以cart-service为例
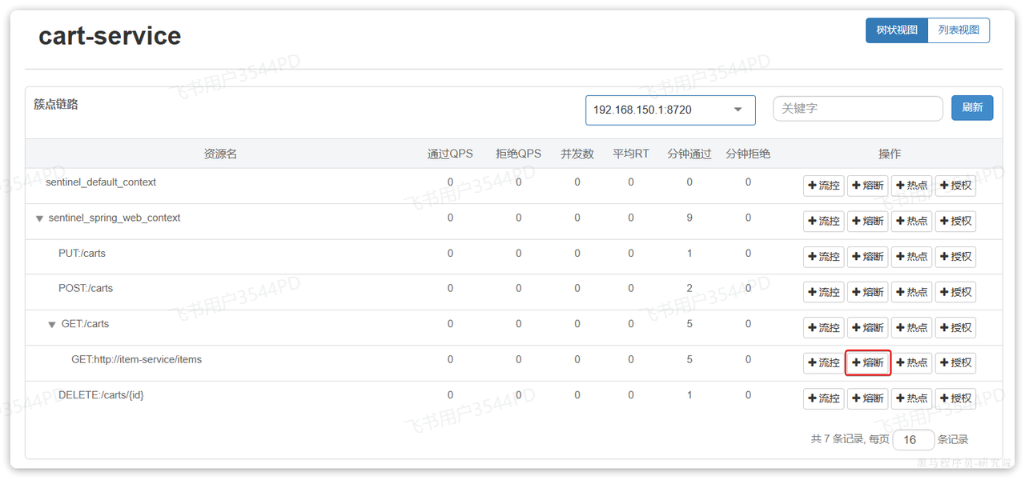
查询购物车接口,sentinel的客户端就会将服务访问的信息提交到sentinel-dashboard控制台。并展示出统计信息:
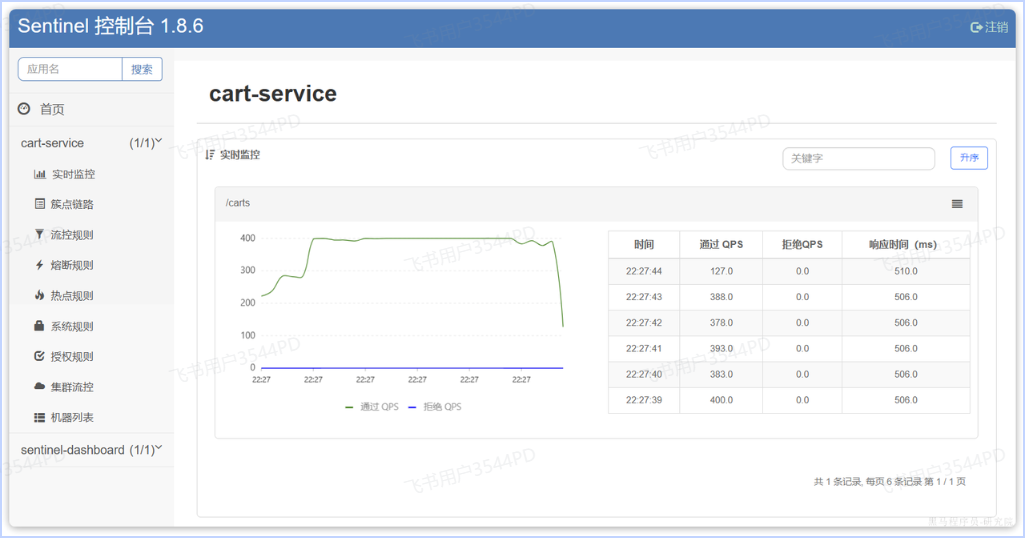
点击簇点链路菜单,会看到下面的页面:
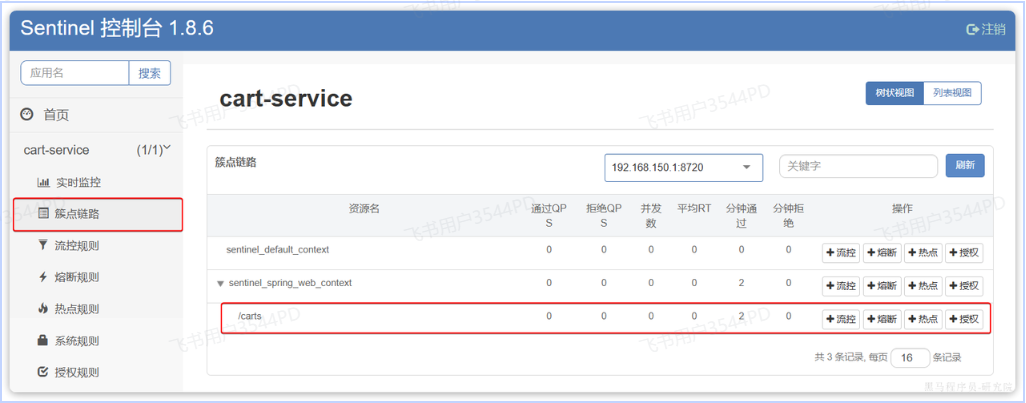
簇点链路就是一次请求在微服务内部走过的“完整路径”,例如在电商网站点“购买”按钮,请求会经过:下单接口 → 支付服务 → 库存服务 → 数据库。简单来说,就是当对一个业务进行请求时,完成该业务所需要的所有服务组成的链路。
我们看到/carts这个接口路径就是其中一个簇点,我们可以对其进行限流、熔断、隔离等保护措施。
不过可能在一个服务中多个接口请求的地址是相同的
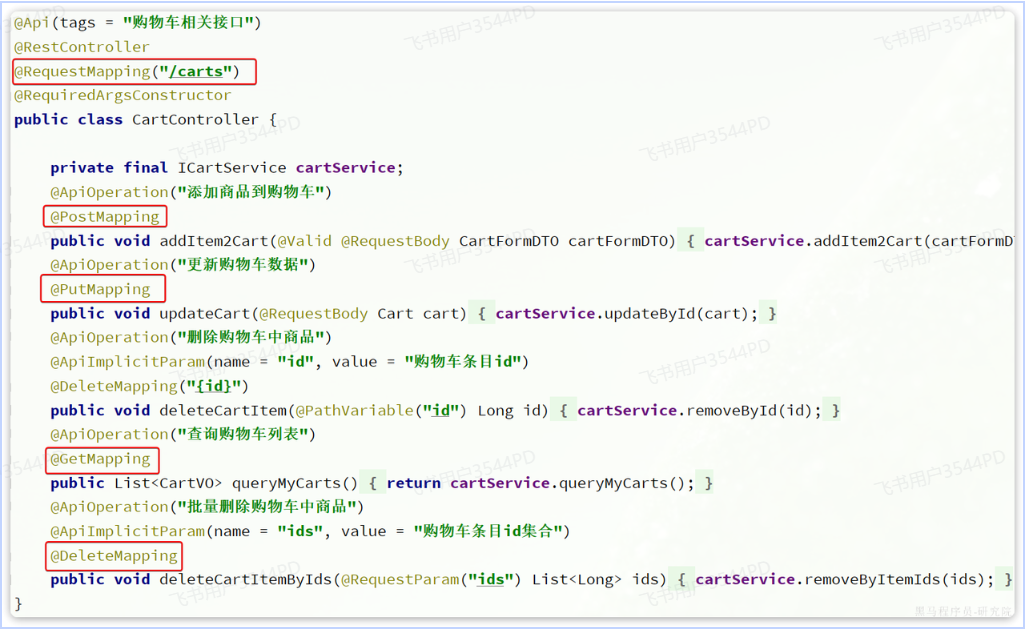
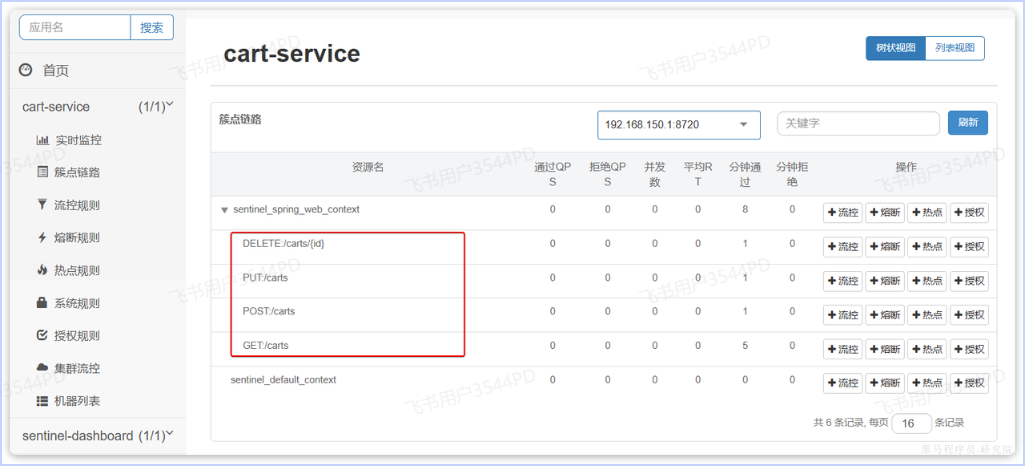
所以我们可以选择打开Sentinel的请求方式前缀,把请求方式 + 请求路径作为簇点资源名:
首先,在cart-service的application.yml中添加下面的配置:
spring:
  cloud:
    sentinel:
      transport:
        dashboard: localhost:8090
      http-method-specify: true # 开启请求方式前缀
重启服务,通过页面访问购物车的相关接口,可以看到sentinel控制台的簇点链路发生了变化:
3. 请求限流
在簇点链路后面点击流控按钮,即可对其做限流配置:
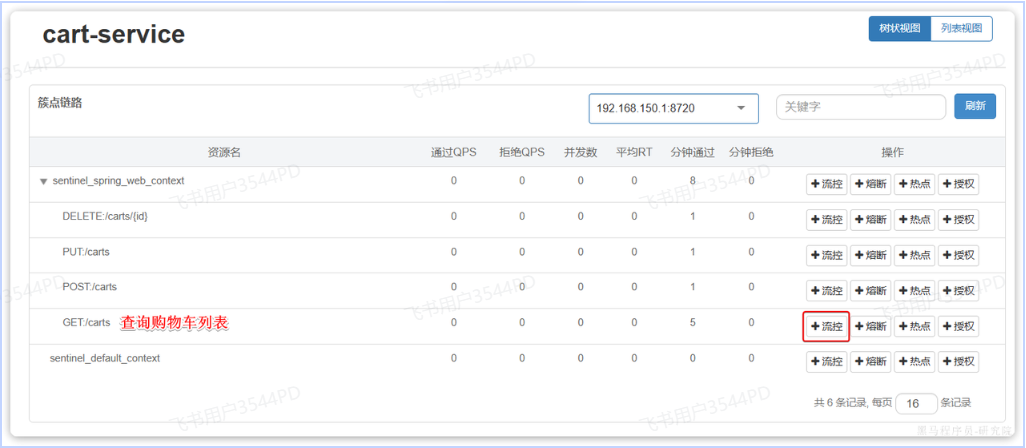
弹出的菜单如下:
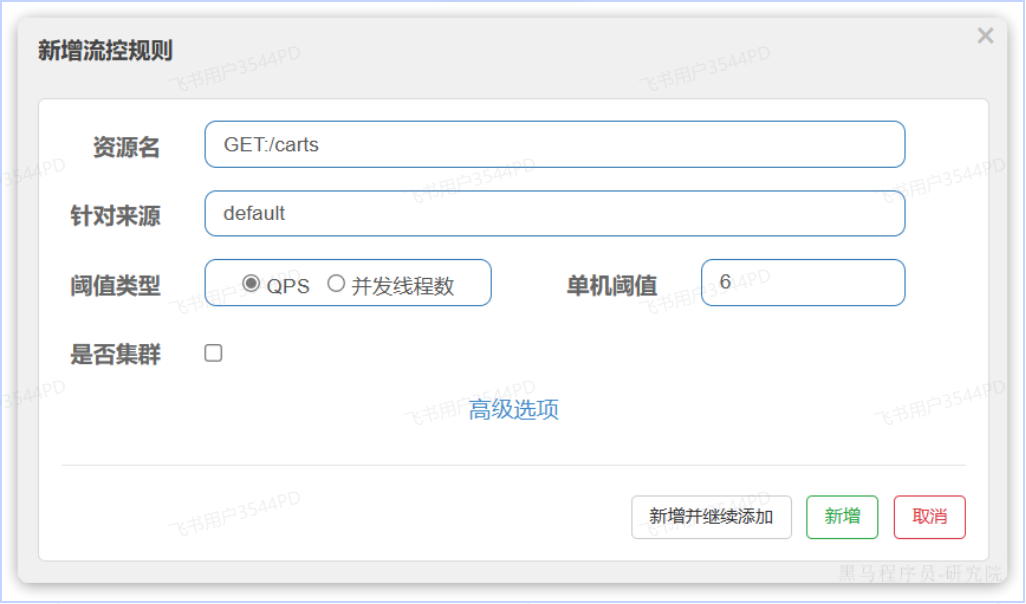
注:QPS是每秒请求的流量
上述信息表明把查询购物车的这个簇点资源的流量限制在了每秒6个请求。如果我们每秒发送10个请求,通过的只有6个。
4. 线程隔离
4.1 OpenFeign整合Sentinel
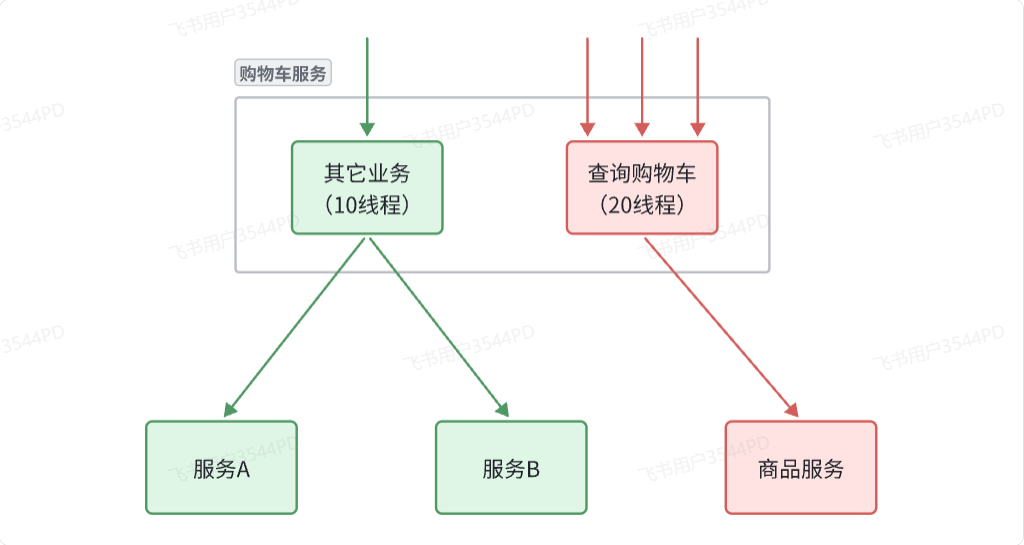
我们要对查询购物车接口做线程隔离。
首先,修改购物车微服务模块的application.yml文件,开启Feign的sentinel功能
feign:
  sentinel:
enabled: true # 开启feign对sentinel的支持需要注意的是,默认情况下SpringBoot项目的tomcat最大线程数是200,允许的最大连接是8492,单机测试很难打满。
所以我们需要配置一下购物车模块的application.yml文件,修改tomcat连接,这样在测试的时候才可以看到效果。
server:
  port: 8082
  tomcat:
    threads:
      max: 50 # 允许的最大线程数
    accept-count: 50 # 最大排队等待数量
    max-connections: 100 # 允许的最大连接
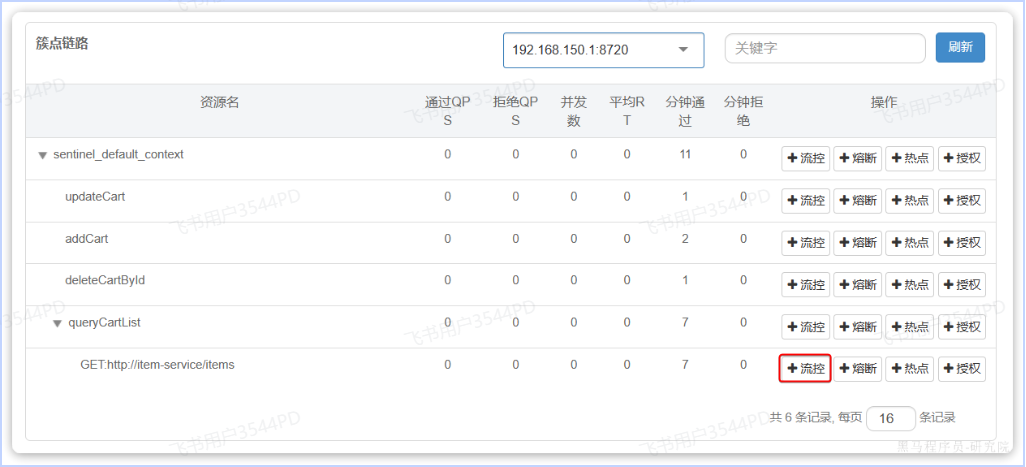
然后重启购物车服务,可以看到查询商品的FeignClient自动变成了一个簇点资源:
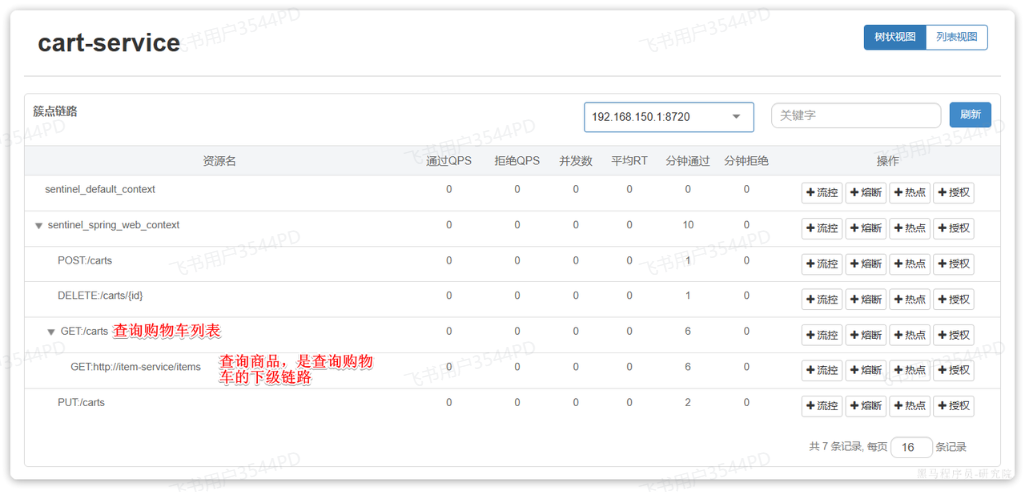
4.2 配置线程隔离
点击查询商品的FeignClient对应的簇点资源后面的流控按钮:
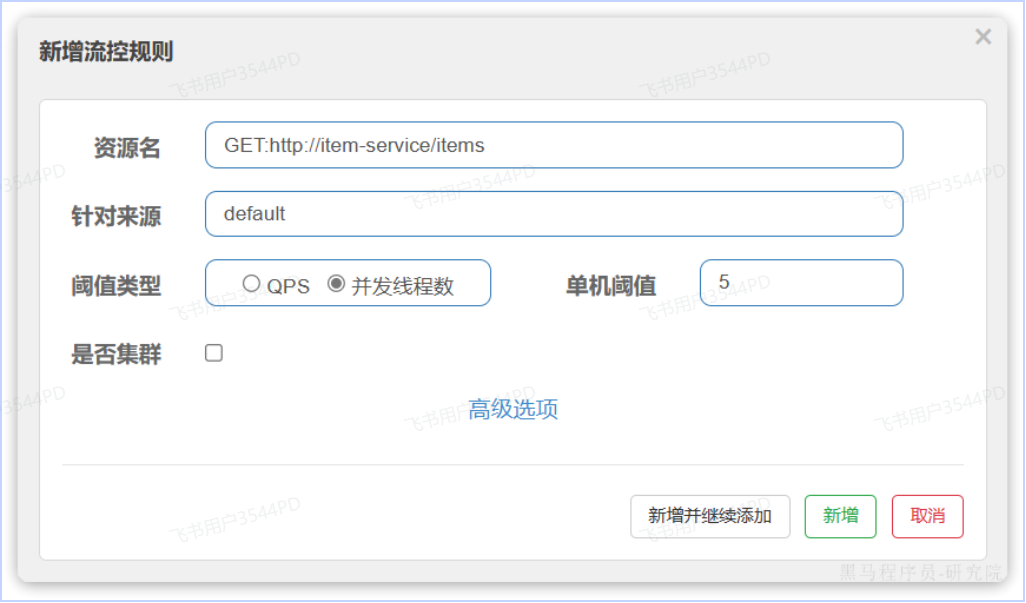
这里勾选的是并发线程数限制,也就是说这个查询功能最多使用5个线程,而不是5QPS。如果查询商品的接口每秒处理2个请求,则5个线程的实际QPS在10左右,而超出的请求自然会被拒绝。
此时就实现了线程隔离的需求。
5.Fallback
当调用商品服务失败时,触发查询商品 fallback逻辑,返回默认数据或友好提示,保证用户体验。
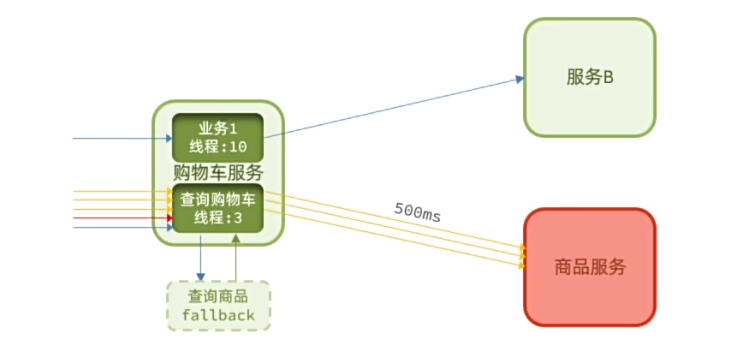
1)将 FeignClient 作为 Sentinel 的簇点资源:
feign:
  sentinel:
    enabled: true
2)FeignClient 的 Fallback 有两种配置方式:
- 方式一:FallbackClass,无法对远程调用的异常做处理
- 方式二:FallbackFactory,可以对远程调用的异常做处理,通常都会选择这种
FallbackFactory 是更灵活的降级方案,核心优势是能通过 Throwable 参数获取远程调用的异常详情,便于问题排查和精细化降级。
步骤 1:编写 FallbackFactory 实现类
以商品服务调用为例,实现带异常处理的降级逻辑:
@Slf4j
public class ItemClientFallbackFactory implements FallbackFactory<ItemClient> {
    @Override
    public ItemClient create(Throwable cause) {
        return new ItemClient() {
            @Override
            public List<ItemDTO> queryItemByIds(Collection<Long> ids) {
                log.error("查询商品服务失败,IDS:{}", ids, cause);
                return CollUtils.emptyList(); // 降级时返回空列表
            }

            @Override
            public void deductStock(List<OrderDetailDTO> items) {
                log.error("扣减商品库存失败", cause);
                throw new RuntimeException("库存服务暂时不可用,请稍后再试");
            }
        };
    }
}
步骤 2:将降级工厂注册为 Bean
在配置类中,把我们定义的 FallbackFactory 注册为 Spring Bean,这样 Spring 才能管理和注入它。或者可以直接在步骤1加上@Component注解。
@Configuration
public class FeignConfig {
    @Bean
    public ItemClientFallbackFactory itemClientFallbackFactory() {
        return new ItemClientFallbackFactory();
    }
}
步骤 3:关联到 FeignClient 接口(在 Feign 接口上指定降级工厂)
在 @FeignClient 注解中通过 fallbackFactory 属性关联我们的降级工厂。
@FeignClient(value = "item-service", fallbackFactory = ItemClientFallbackFactory.class)
public interface ItemClient {
    @GetMapping("/items")
    List<ItemDTO> queryItemByIds(@RequestParam("ids") Collection<Long> ids);

    @PutMapping("/items/stock/deduct")
    void deductStock(@RequestBody List<OrderDetailDTO> items);
}
6.服务熔断
线程隔离保护了购物车业务的其它接口,但是超出的QPS上限的请求就只能抛出异常,从而导致购物车的查询失败。但从业务角度来说,即便没有查询到最新的商品信息,购物车也应该展示给用户,用户体验更好。也就是给查询失败设置一个降级处理逻辑。
同时,如果查询商品的延迟比较高,从而导致查询购物车的响应时间也变的很长。这样不仅拖慢了购物车服务,消耗了购物车服务的更多资源,而且用户体验也很差。对于商品服务这种不太健康的接口,我们应该直接停止调用,直接走降级逻辑,避免影响到当前服务。也就是将商品查询接口熔断。当商品服务接口恢复正常后,再允许调用。这其实就是断路器的工作模式了。
Sentinel中的断路器不仅可以统计某个接口的慢请求比例,还可以统计异常请求比例。当这些比例超出阈值时,就会熔断该接口,即拦截访问该接口的一切请求,降级处理;当该接口恢复正常时,再放行对于该接口的请求。
断路器的工作状态切换有一个状态机来控制:
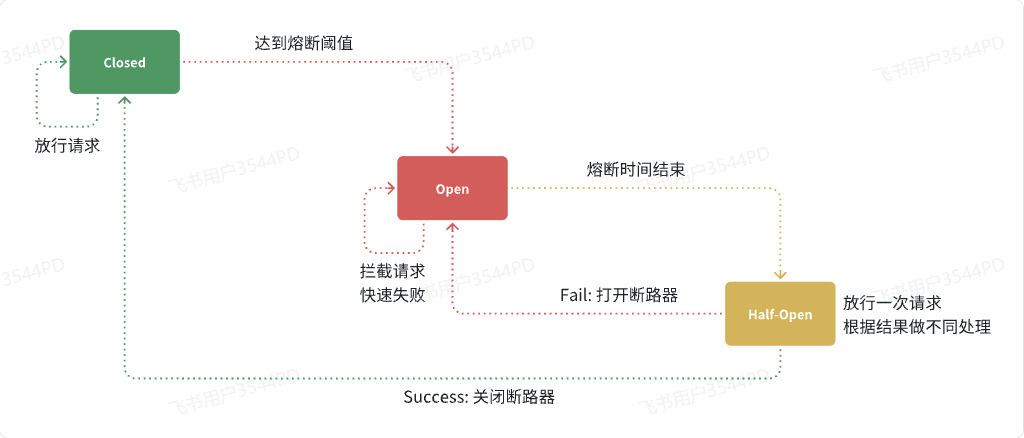
状态机包括三个状态:
-
closed:关闭状态,断路器放行所有请求,并开始统计异常比例、慢请求比例。超过阈值则切换到open状态
-
open:打开状态,服务调用被熔断,访问被熔断服务的请求会被拒绝,快速失败,直接走降级逻辑。Open状态持续一段时间后会进入half-open状态
-
half-open:半开状态,放行一次请求,根据执行结果来判断接下来的操作。
——>请求成功:则切换到closed状态
——>请求失败:则切换到open状态
我们可以在控制台通过点击簇点后的熔断按钮来配置熔断策略:
二、分布式事务
在分布式系统中,如果一个业务需要多个服务合作完成,而且每一个服务都有事务,多个事务必须同时成功或失败,这样的事务就是分布式事务。其中的每个服务的事务就是一个分支事务。整个业务称为全局事务。
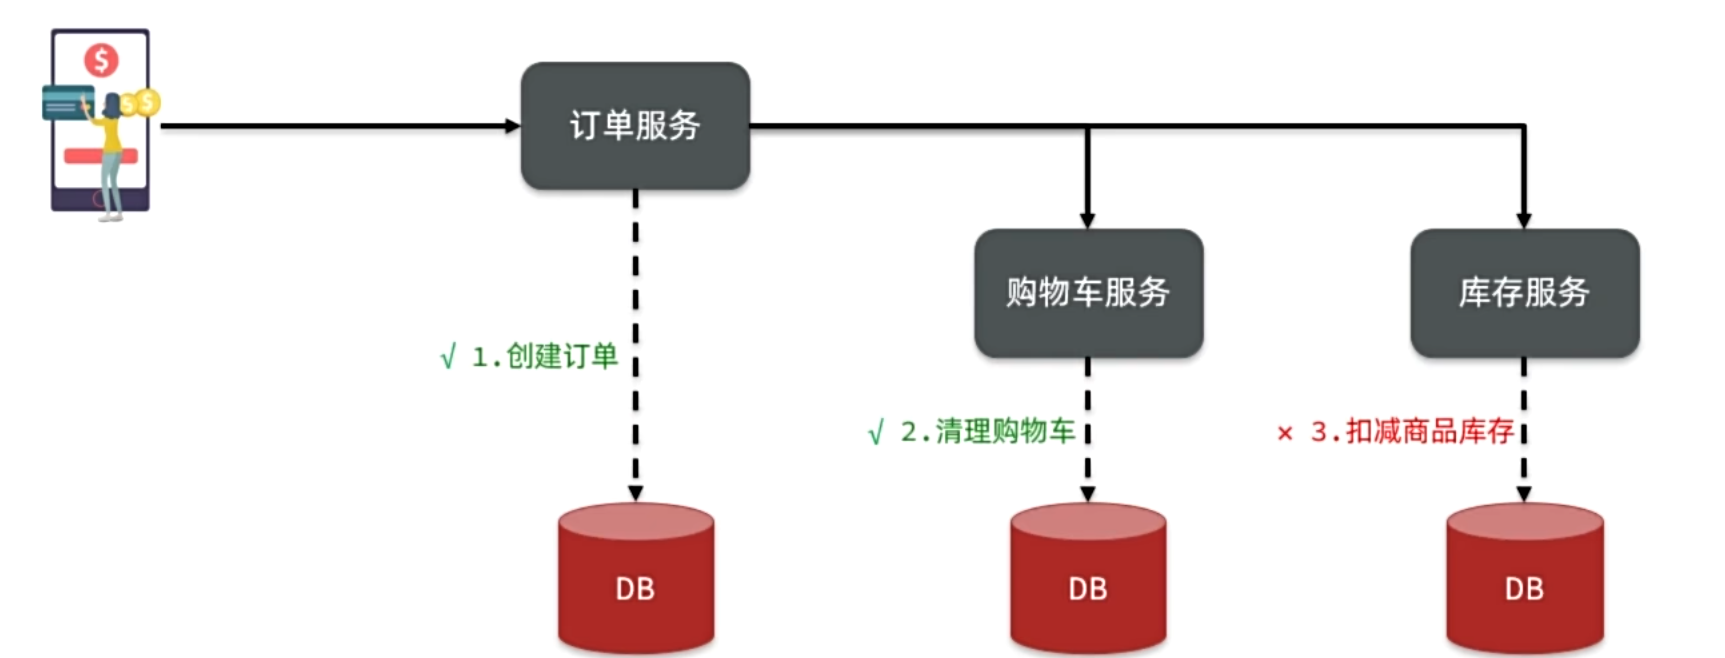
项目中下单业务流程如下:
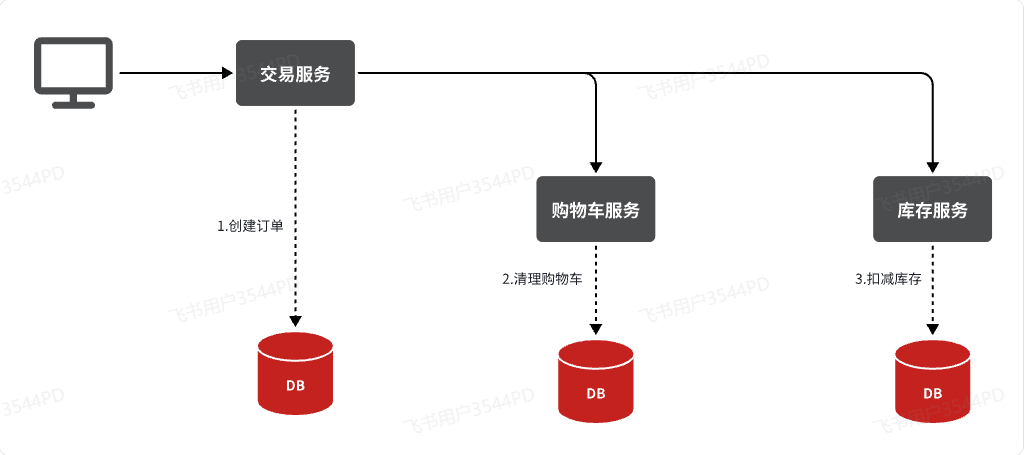
由于订单、购物车、商品分别在三个不同的微服务,而每个微服务都有自己独立的数据库,因此下单过程中就会跨多个数据库完成业务。而每个微服务都会执行自己的本地事务。
整个业务中,各个本地事务是有关联的。因此每个微服务的本地事务,也可以称为分支事务。多个有关联的分支事务一起就组成了全局事务。我们必须保证整个全局事务同时成功或失败。
每一个分支事务就是传统的单体事务,是满足ACID特性的。但是在全局事务中,ACID特性就不一定会满足了。因为它们跨越了不同的数据库,相互之间没有感知,可能已经下单成功,扣减库存了,但是购物车缺清理失败,就导致最终的结果无法统一。
1. 认识Seata
解决分布式事务的方案有很多,但实现起来都比较复杂,因此我们一般会使用开源的框架来解决分布式事务问题。在众多的开源分布式事务框架中,功能最完善、使用最多的就是阿里巴巴在2019年开源的Seata了。
解决分布式事务,各个子事务之间必须能感知到彼此的事务状态,才能保证状态一致。
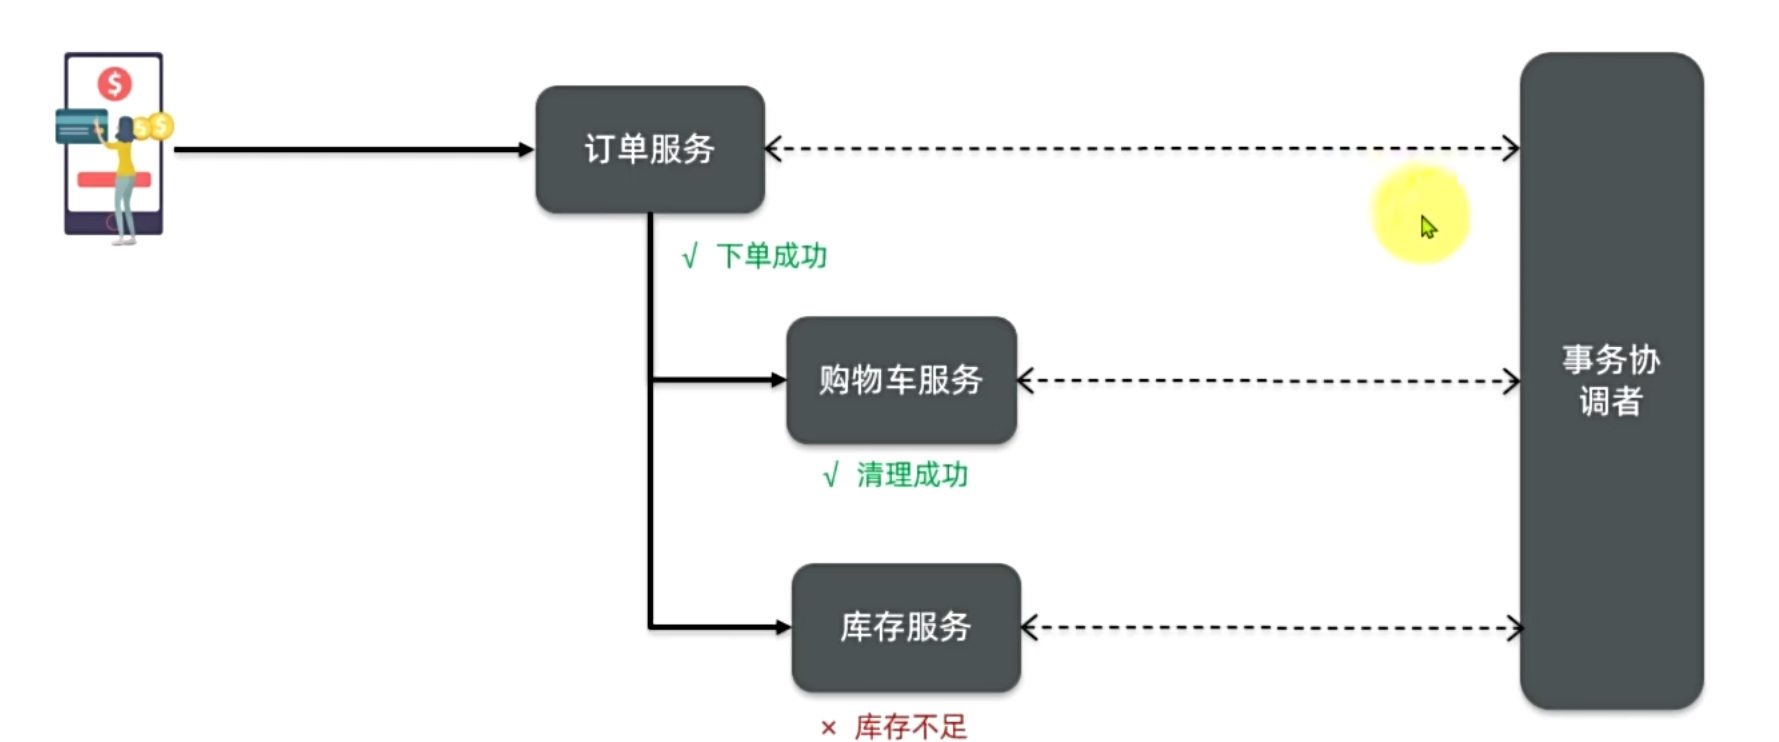
在Seata的事务管理中有三个重要的角色:
- TC (Transaction Coordinator) - 事务协调者:维护全局和分支事务的状态,协调全局事务提交或回滚。
- TM (Transaction Manager) - 事务管理器:定义全局事务的范围、开始全局事务、提交或回滚全局事务。
- RM (Resource Manager) - 资源管理器:管理分支事务,与TC交谈以注册分支事务和报告分支事务的状态,并驱动分支事务提交或回滚。
Seata的工作架构如图所示:
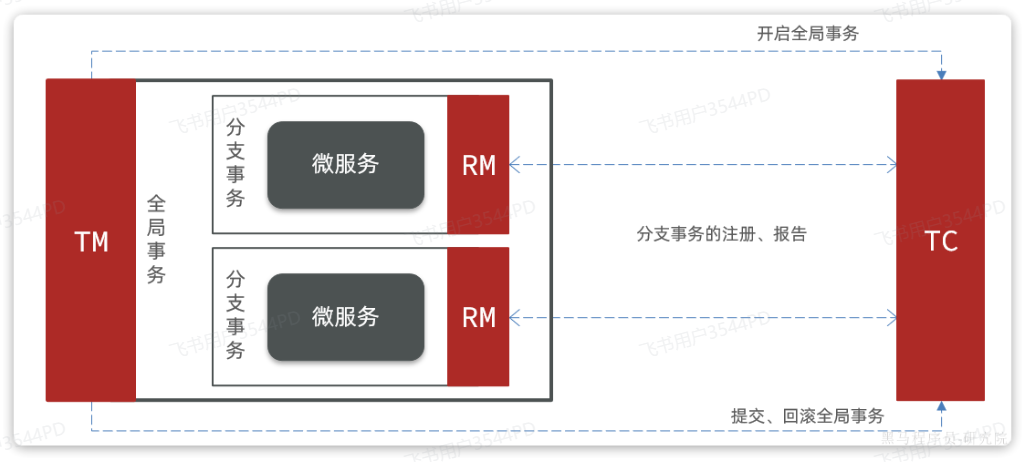
其中,TM和RM可以理解为Seata的客户端部分,引入到参与事务的微服务依赖中即可。将来TM和RM就会协助微服务,实现本地分支事务与TC之间交互,实现事务的提交或回滚。
而TC服务则是事务协调中心,是一个独立的微服务,需要单独部署(可以部署到docker容器当中)。
2.部署TC服务
2.1 准备数据库表
Seata支持多种存储模式,但考虑到持久化的需要,我们一般选择基于数据库存储。导入数据库表:
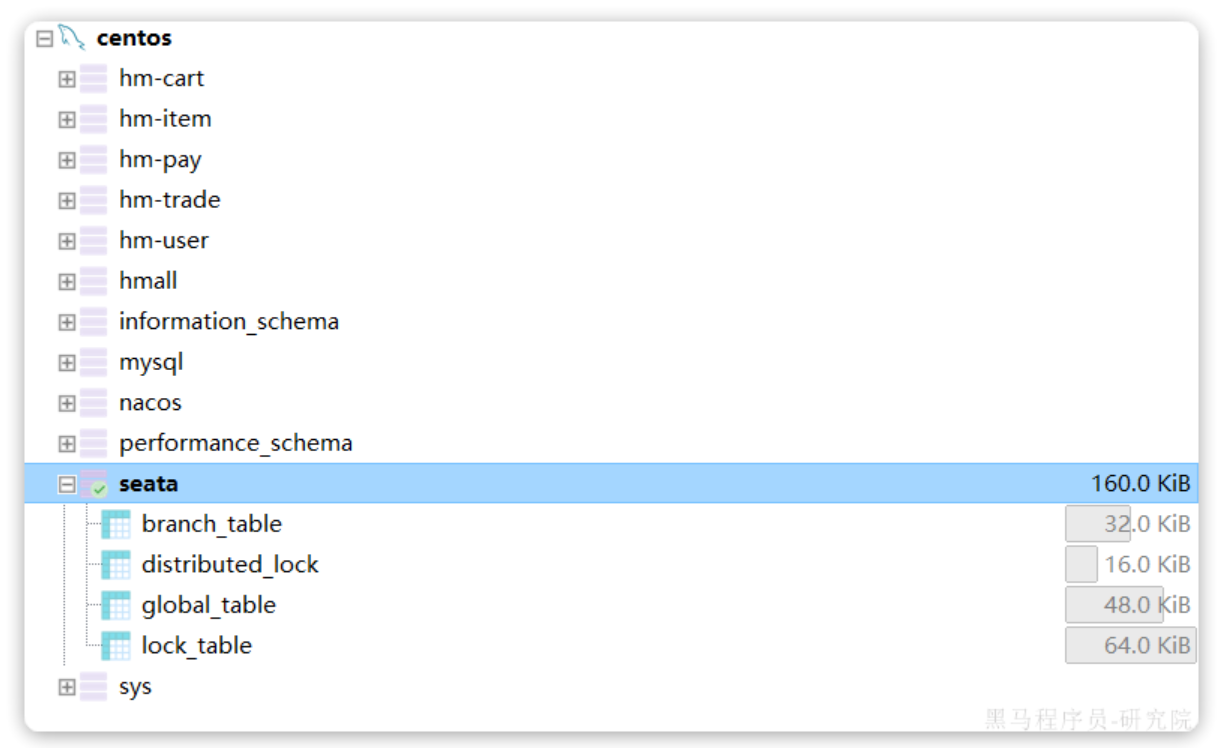
2.2 准备配置文件
课前资料准备了一个seata目录,其中包含了seata运行时所需要的配置文件:
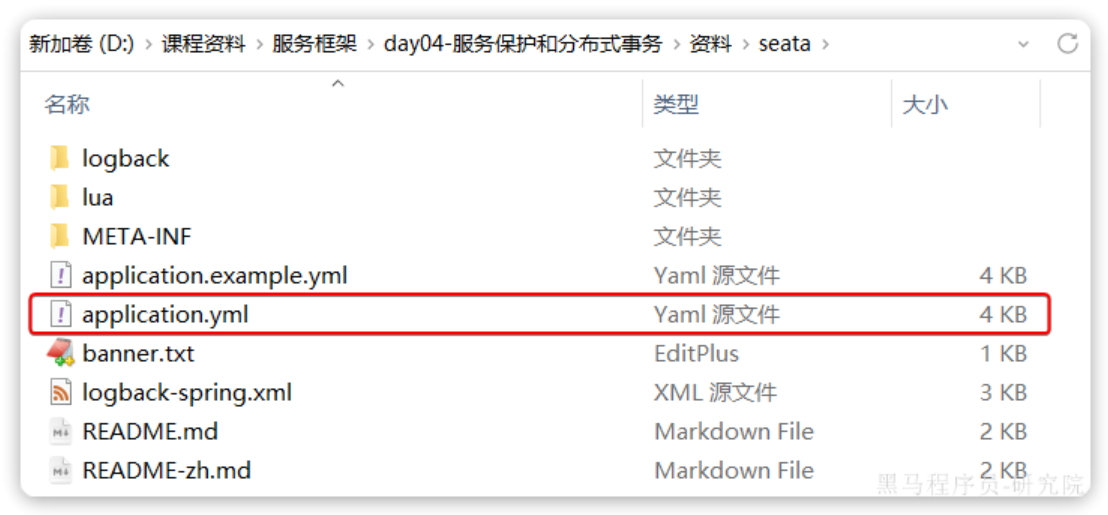
server:
  port: 7099

spring:
  application:
    name: seata-server

logging:
  config: classpath:logback-spring.xml
  file:
    path: ${user.home}/logs/seata
  # extend:
  #   logstash-appender:
  #     destination: 127.0.0.1:4560
  #   kafka-appender:
  #     bootstrap-servers: 127.0.0.1:9092
  #     topic: logback_to_logstash

console:
  user:
    username: admin
    password: admin

seata:
  config:
    # support: nacos, consul, apollo, zk, etcd3
    type: file
    # nacos:
    #   server-addr: nacos:8848
    #   group: "DEFAULT_GROUP"
    #   namespace: ""
    #   dataId: "seataServer.properties"
    #   username: "nacos"
    #   password: "nacos"
  registry:
    # support: nacos, eureka, redis, zk, consul, etcd3, sofa
    type: nacos
    nacos:
      application: seata-server
      server-addr: nacos:8848
      group: "DEFAULT_GROUP"
      namespace: ""
      username: "nacos"
      password: "nacos"
  security:
    secretKey: SeataSecretKey0c382ef121d778043159209298fd40bf3850a017
    tokenValidityInMilliseconds: 1800000
    ignore:
      urls: /,/**/*.css,/**/*.js,/**/*.html,/**/*.map,/**/*.svg,/**/*.png,/**/*.ico,/console-fe/public/**,/api/v1/auth/login
  server:
    # service-port: 8091 #If not configured, the default is '${server.port} + 1000'
    max-commit-retry-timeout: -1
    max-rollback-retry-timeout: -1
    rollback-retry-timeout-unlock-enable: false
    enable-check-auth: true
    enable-parallel-request-handle: true
    retry-dead-threshold: 130000
    xaer-nota-retry-timeout: 60000
    enableParallelRequestHandle: true
    recovery:
      committing-retry-period: 1000
      async-committing-retry-period: 1000
      rollbacking-retry-period: 1000
      timeout-retry-period: 1000
    undo:
      log-save-days: 7
      log-delete-period: 86400000
    session:
      branch-async-queue-size: 5000 #branch async remove queue size
      enable-branch-async-remove: false #enable to asynchronous remove branchSession
  store:
    # support: file, db, redis
    mode: db
    session:
      mode: db
    lock:
      mode: db
    db:
      datasource: druid
      db-type: mysql
      driver-class-name: com.mysql.cj.jdbc.Driver
      url: jdbc:mysql://mysql:3306/seata?rewriteBatchedStatements=true&serverTimezone=UTC
      user: root
      password: 123
      min-conn: 10
      max-conn: 100
      global-table: global_table
      branch-table: branch_table
      lock-table: lock_table
      distributed-lock-table: distributed_lock
      query-limit: 1000
      max-wait: 5000
    # redis:
    #   mode: single
    #   database: 0
    #   min-conn: 10
    #   max-conn: 100
    #   password:
    #   max-total: 100
    #   query-limit: 1000
    #   single:
    #     host: 192.168.150.101
    #     port: 6379
  metrics:
    enabled: false
    registry-type: compact
    exporter-list: prometheus
    exporter-prometheus-port: 9898
  transport:
    rpc-tc-request-timeout: 15000
    enable-tc-server-batch-send-response: false
    shutdown:
      wait: 3
    thread-factory:
      boss-thread-prefix: NettyBoss
      worker-thread-prefix: NettyServerNIOWorker
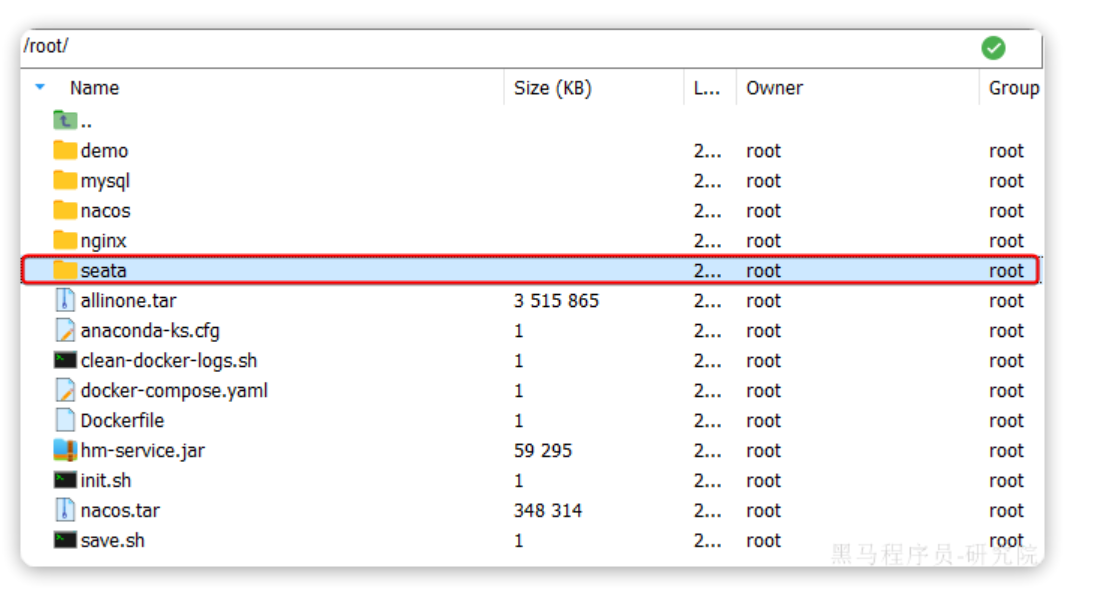
boss-thread-size: 1我们将整个seata文件夹拷贝到虚拟机的/root目录:
2.3 Docker部署
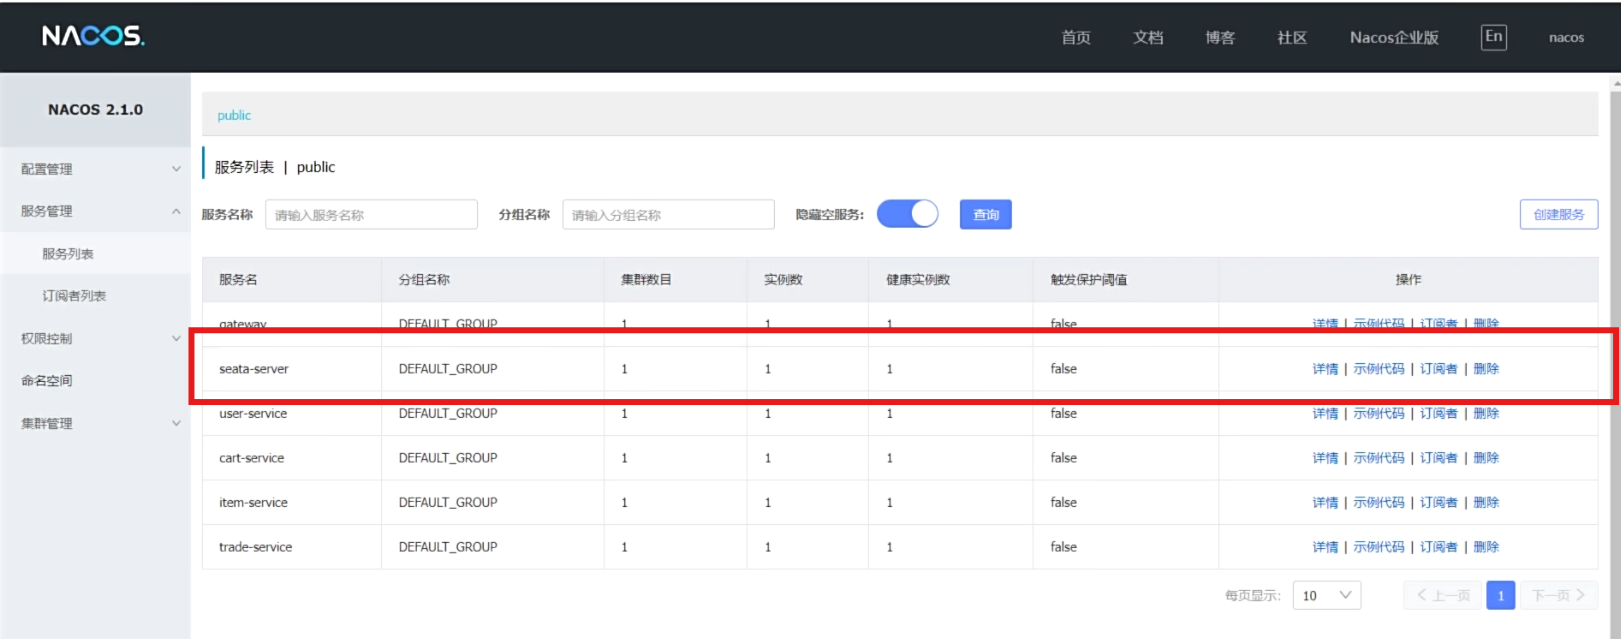
需要注意,要确保nacos、mysql都在hm-net网络中。如果某个容器不再hm-net网络,可以参考下面的命令将某容器加入指定网络:
docker network connect [网络名] [容器名]在虚拟机的/root目录执行下面的命令:
docker run --name seata \
-p 8099:8099 \
-p 7099:7099 \
-e SEATA_IP=192.168.150.101 \  # 自己的虚拟IP地址
-v ./seata:/seata-server/resources \
--privileged=true \
--network hm-net \
-d \
seataio/seata-server:1.5.2
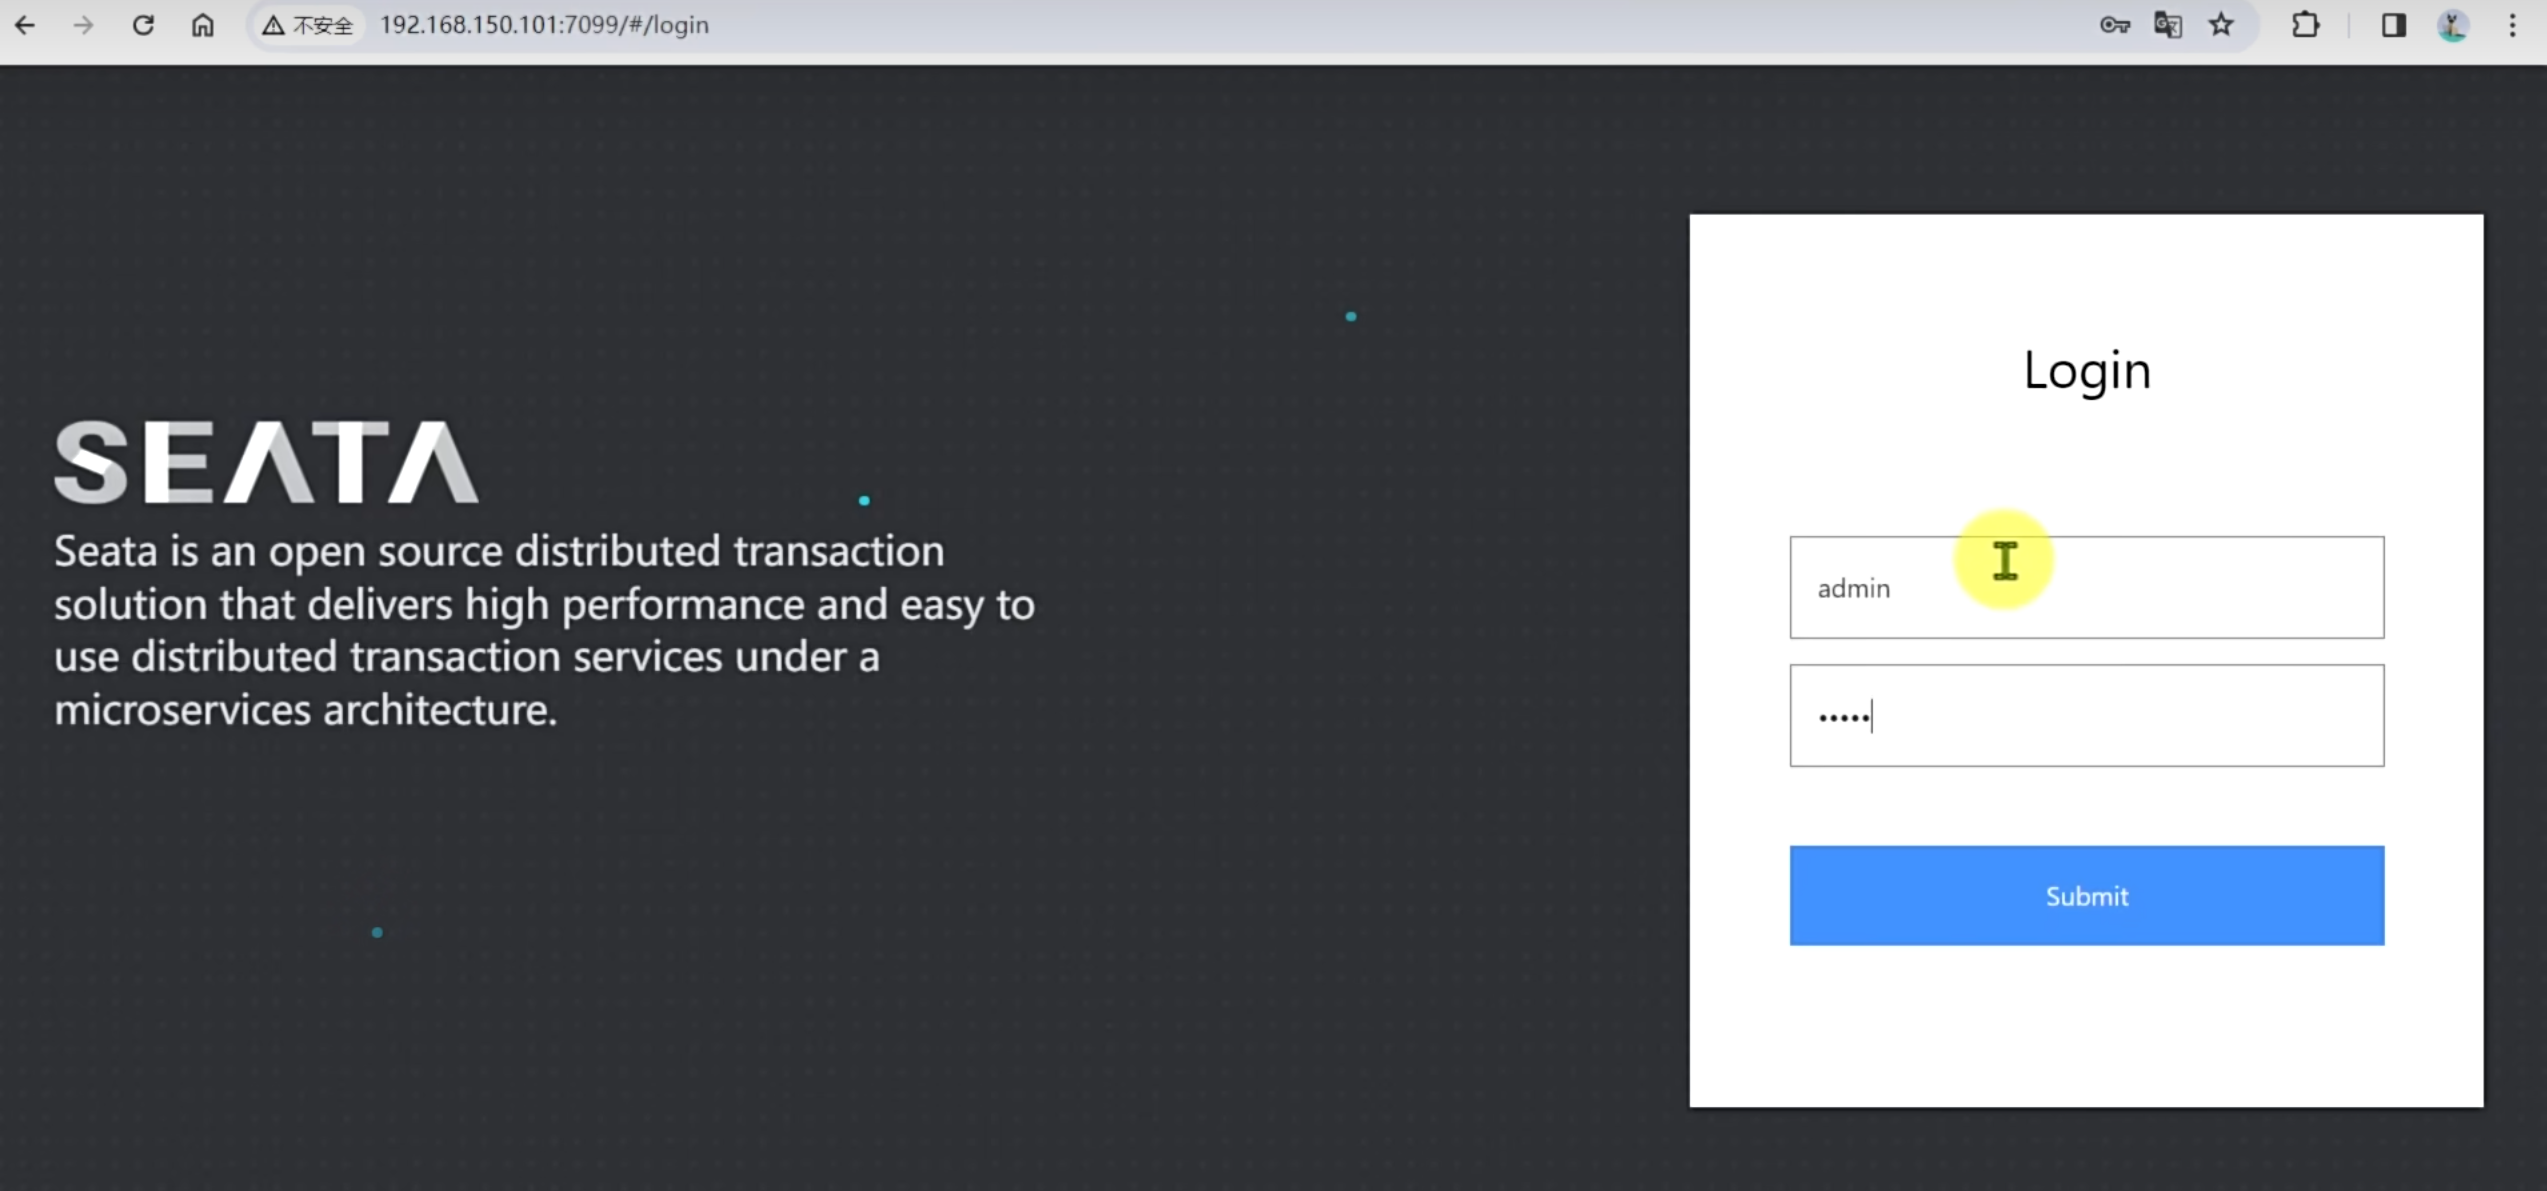
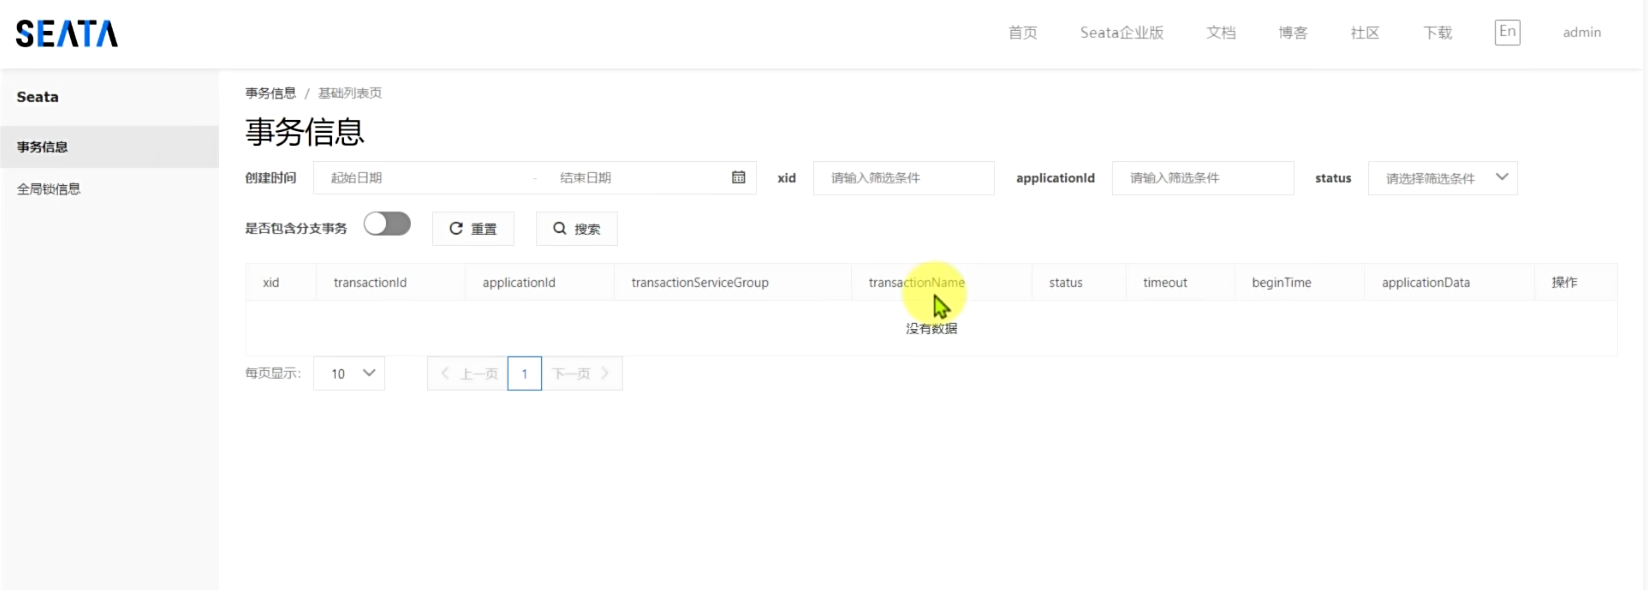
启动后:
3.微服务集成Seata
参与分布式事务的每一个微服务都需要集成Seata,我们以trade-service为例。
3.1 引入依赖
为了方便各个微服务集成seata,我们需要把seata配置共享到nacos,因此trade-service模块不仅仅要引入seata依赖,还要引入nacos依赖:
<!--统一配置管理-->
  <dependency>
      <groupId>com.alibaba.cloud</groupId>
      <artifactId>spring-cloud-starter-alibaba-nacos-config</artifactId>
  </dependency>
  <!--读取bootstrap文件-->
  <dependency>
      <groupId>org.springframework.cloud</groupId>
      <artifactId>spring-cloud-starter-bootstrap</artifactId>
  </dependency>
  <!--seata-->
  <dependency>
      <groupId>com.alibaba.cloud</groupId>
      <artifactId>spring-cloud-starter-alibaba-seata</artifactId>
  </dependency>
3.2 改造配置
首先在nacos上添加一个共享的seata配置,命名为shared-seata.yaml:
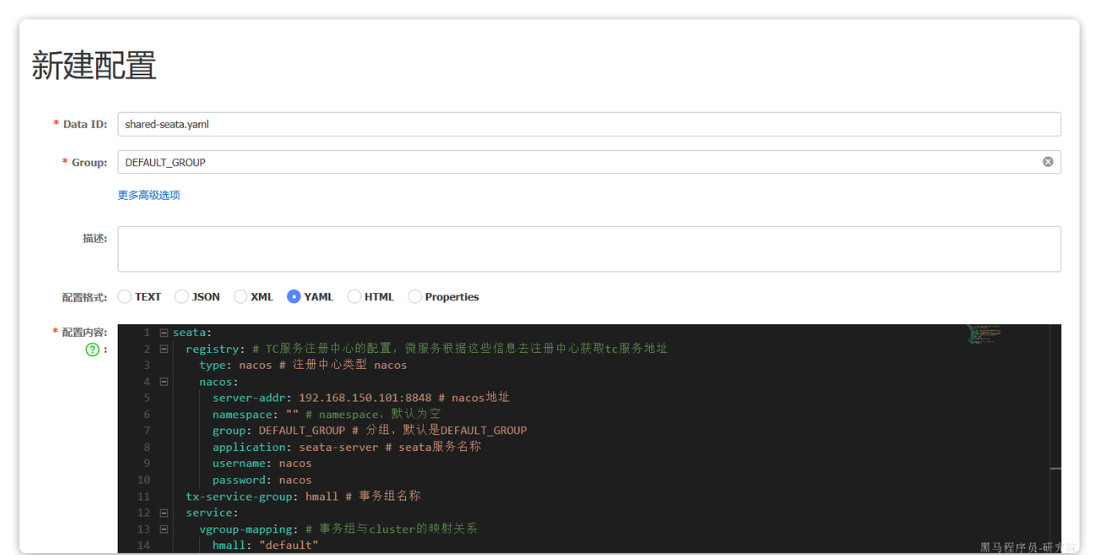
内容如下:
seata:
  registry: # TC服务注册中心的配置,微服务根据这些信息去注册中心获取tc服务地址
    type: nacos # 注册中心类型 nacos
    nacos:
      server-addr: 192.168.150.101:8848 # nacos地址
      namespace: "" # namespace,默认为空
      group: DEFAULT_GROUP # 分组,默认是DEFAULT_GROUP
      application: seata-server # seata服务名称
      username: nacos
      password: nacos
  tx-service-group: hmall # 事务组名称
  service:
    vgroup-mapping: # 事务组与tc集群的映射关系
      hmall: "default"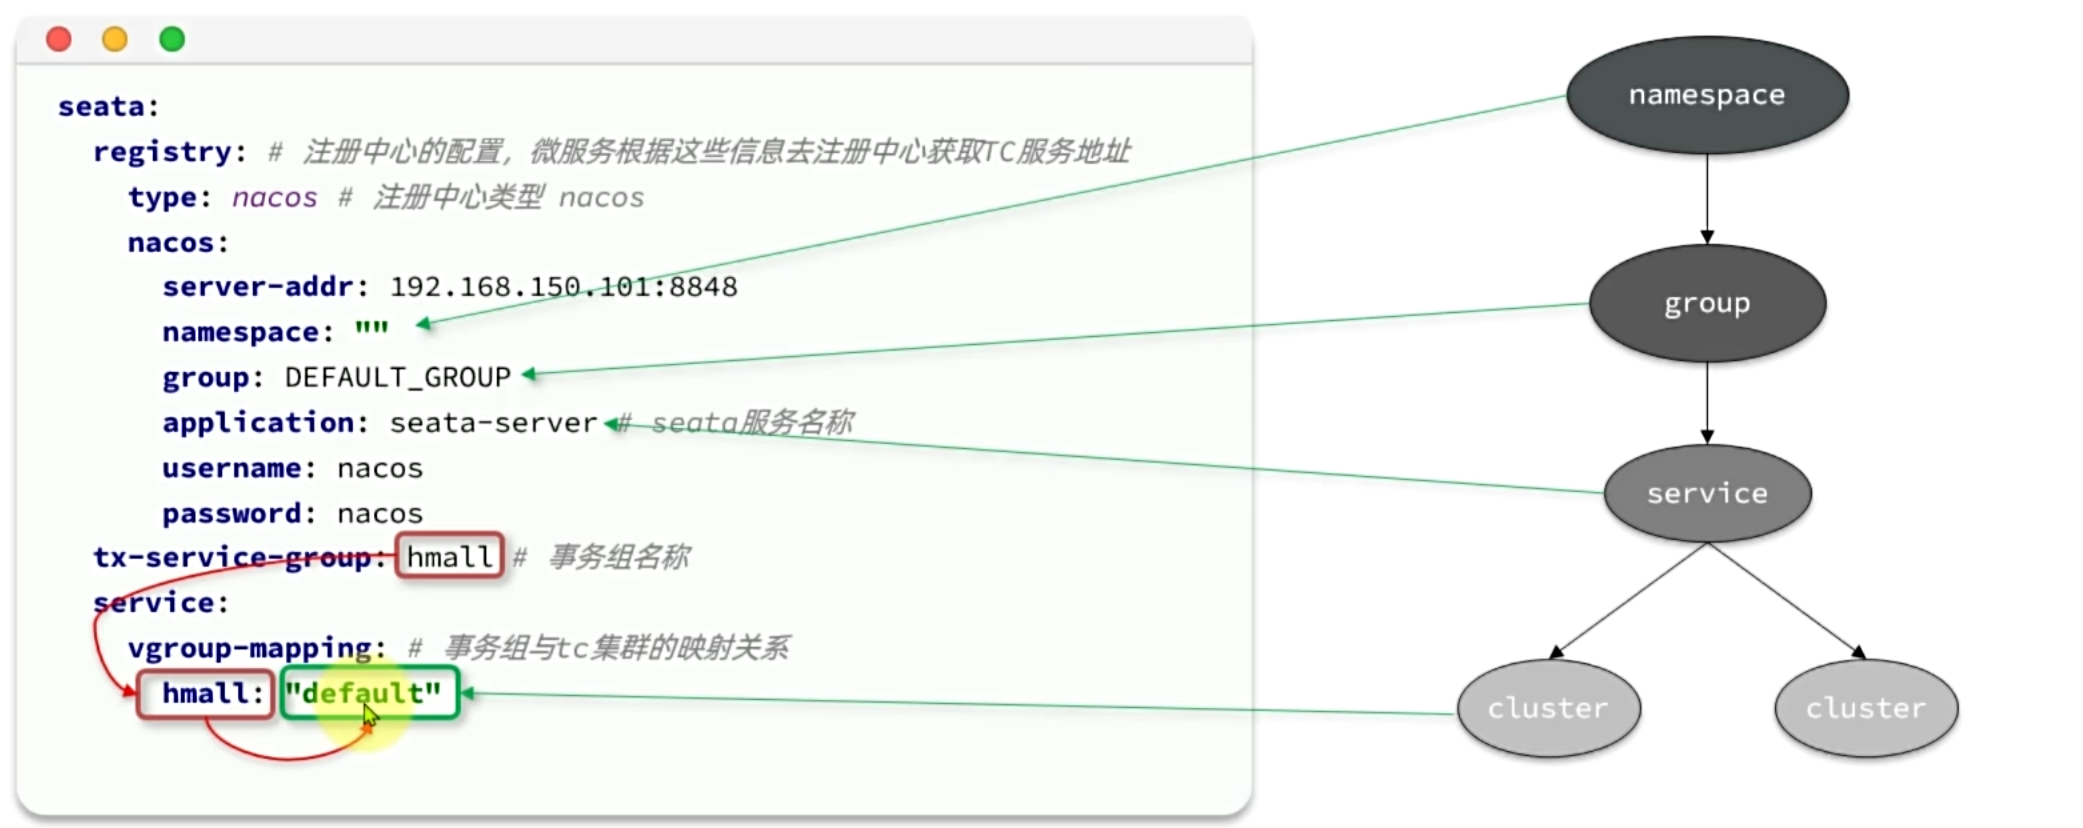
然后,改造trade-service模块,添加bootstrap.yaml:
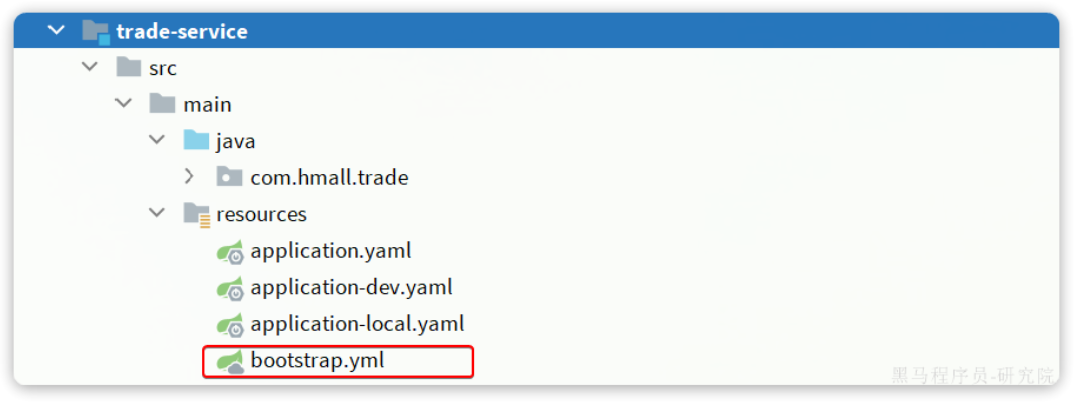
内容如下:
spring:
  application:
    name: trade-service # 服务名称
  profiles:
    active: dev
  cloud:
    nacos:
      server-addr: 192.168.150.101 # nacos地址
      config:
        file-extension: yaml # 文件后缀名
        shared-configs: # 共享配置
          - dataId: shared-jdbc.yaml # 共享mybatis配置
          - dataId: shared-log.yaml # 共享日志配置
          - dataId: shared-swagger.yaml # 共享日志配置
          - dataId: shared-seata.yaml # 共享seata配置
可以看到这里加载了共享的seata配置。
然后改造application.yaml文件,内容如下:
server:
  port: 8085
feign:
  okhttp:
    enabled: true # 开启OKHttp连接池支持
  sentinel:
    enabled: true # 开启Feign对Sentinel的整合
hm:
  swagger:
    title: 交易服务接口文档
    package: com.hmall.trade.controller
  db:
database: hm-trade参考上述办法分别改造hm-cart和hm-item两个微服务模块。
4. XA模式
4.1 模型架构
Seata对原始的XA模式做了简单的封装和改造,以适应自己的事务模型,基本架构如图:
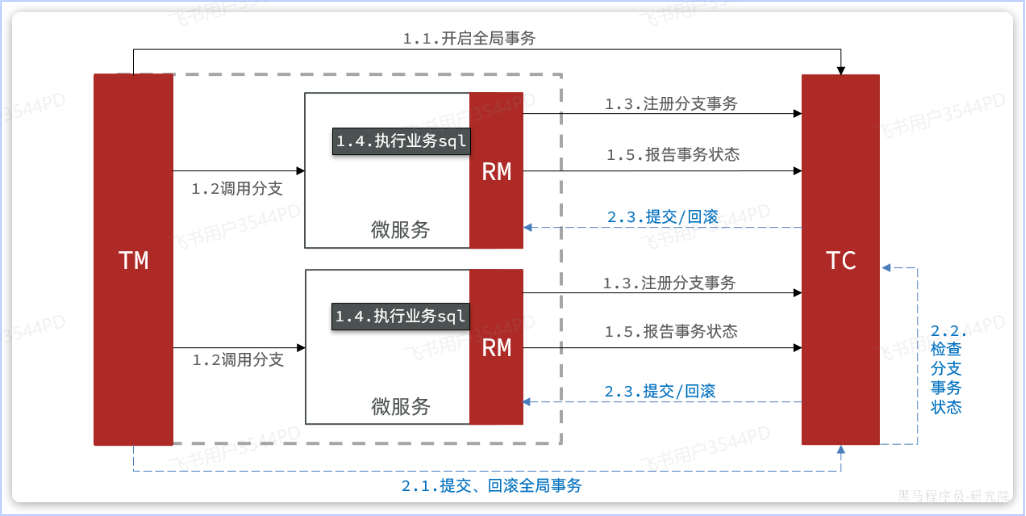
首先TM会告知TC全局事务已开启-->调用分支事务-->注册分支事务-->执行业务sql(执行完后不对事务进行提交,而是等待)--> 报告事务状态 --> 提交全局事务 --> 提交/回滚(如果所有分支事务状态都正常就提交,若存在异常就对所有分支事务进行回滚)。
RM一阶段的工作:
- 注册分支事务到
TC - 执行分支业务sql但不提交
- 报告执行状态到
TC
TC二阶段的工作:
TC检测各分支事务执行状态- 如果都成功,通知所有RM提交事务
- 如果有失败,通知所有RM回滚事务
RM二阶段的工作:
-
接收
TC指令,提交或回滚事务
4.2 两阶段提交
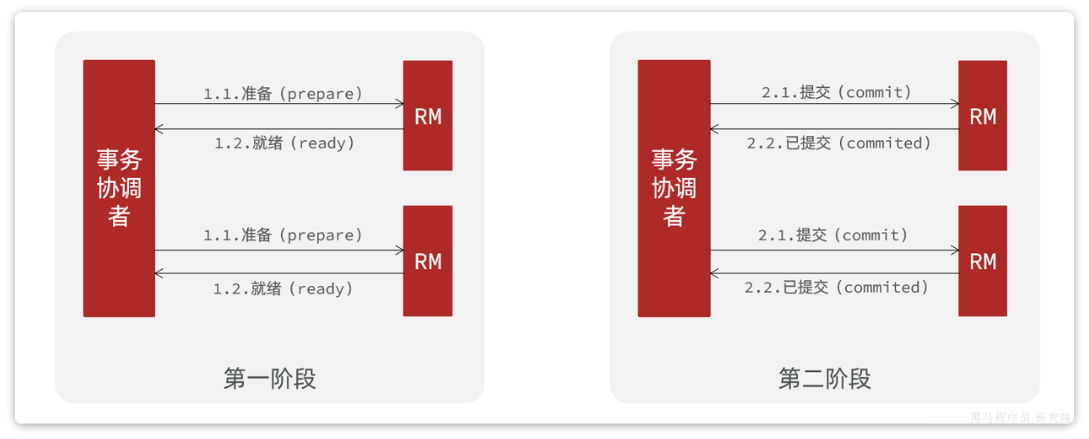
A是规范,目前主流数据库都实现了这种规范,实现的原理都是基于两阶段提交。
正常情况:
异常情况:
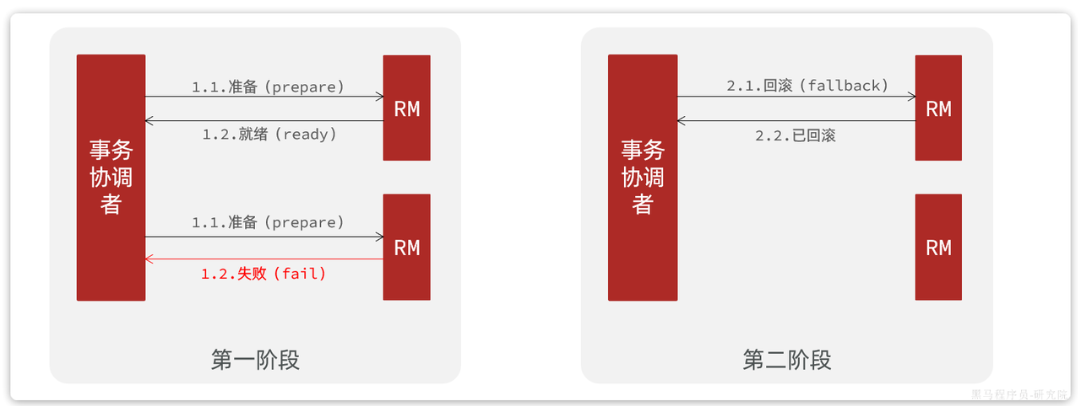
一阶段:
-
事务协调者通知每个事务参与者执行本地事务
-
本地事务执行完成后报告事务执行状态给事务协调者,此时事务不提交,继续持有数据库锁
二阶段:
-
事务协调者基于一阶段的报告来判断下一步操作
-
如果一阶段都成功,则通知所有事务参与者,提交事务
-
如果一阶段任意一个参与者失败,则通知所有事务参与者回滚事务
4.3 优缺点
XA模式的优点:
-
事务的强一致性,满足ACID原则
-
常用数据库都支持,实现简单,并且没有代码侵入
XA模式的缺点:
-
因为一阶段需要锁定数据库资源,等待二阶段结束才释放,性能较差
-
依赖关系型数据库实现事务
4.4 实现步骤
在配置文件中指定要采用的分布式事务模式
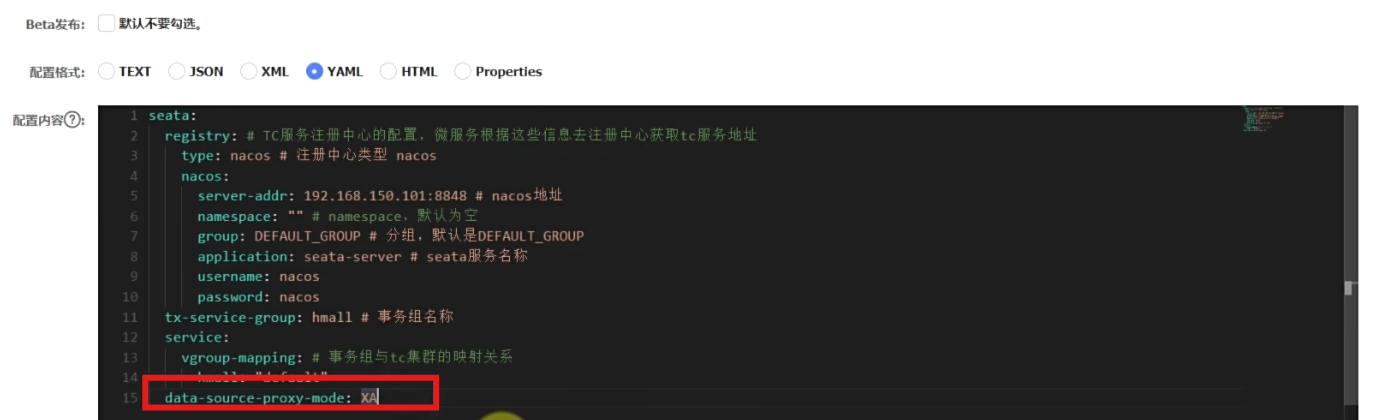
seata:
data-source-proxy-mode: XA其次,我们要利用@GlobalTransactional标记分布式事务的入口方法:
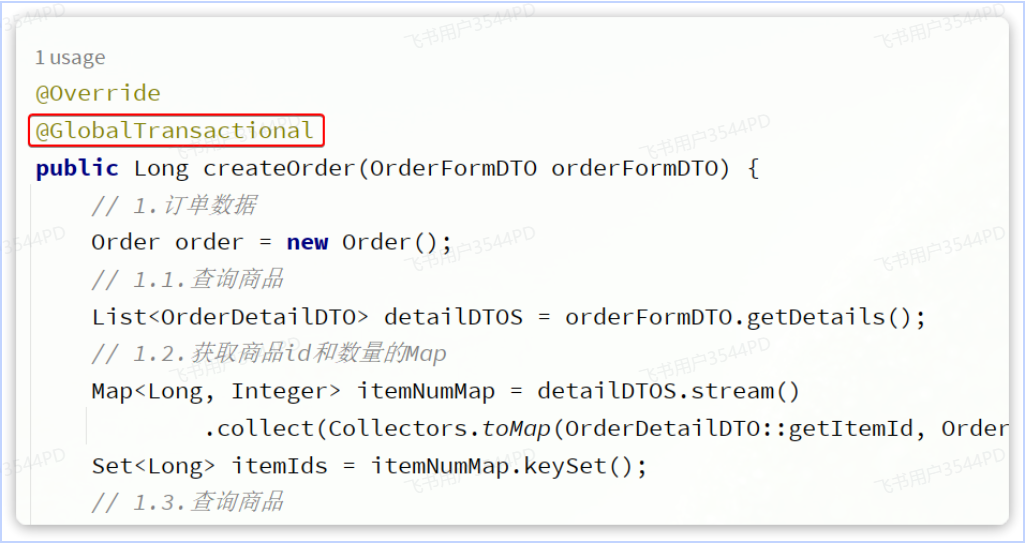
其他微服务相关操作加上@Transactional
5. AT模式
5.1 模型架构
Seata 主推的是 AT 模式,AT 模式同样是分阶段提交的事务模型,不过却弥补了 XA 模型中资源锁定周期过长的缺陷。
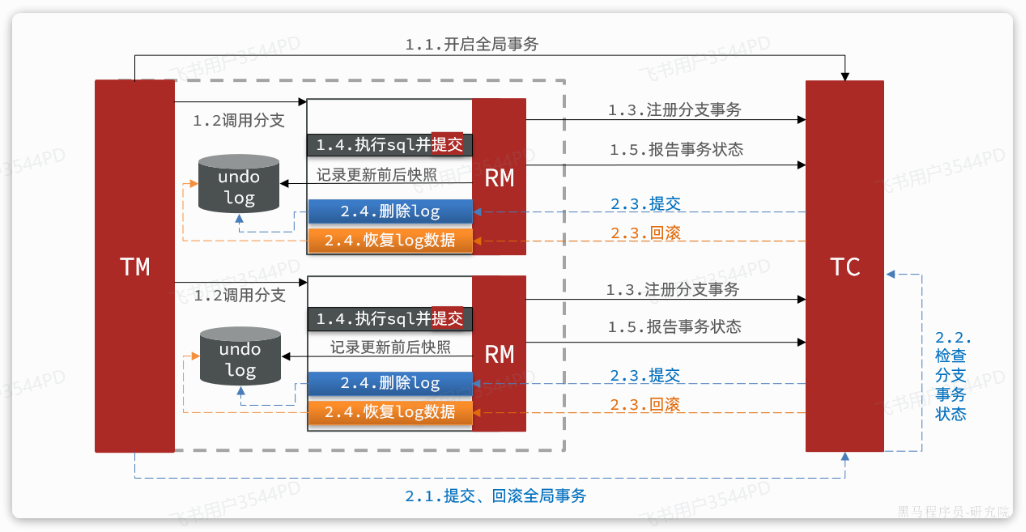
与XA模式不同的是分支事务在执行sql之后会直接进行提交,但是会在提交事务之前保存一个快照文件,如果存在异常,就可以直接使用快照文件来恢复数据。如果都成功,快照文件就会直接删除。
5.2 AT与XA的区别
-
XA模式一阶段不提交事务,锁定资源;AT模式一阶段直接提交,不锁定资源。 -
XA模式依赖数据库机制实现回滚;AT模式利用数据快照实现数据回滚。 -
XA模式强一致;AT模式最终一致
5.3 使用步骤
因为Seata默认就是AT模式,所以我们只需要在分布式事务的入口方法上面加上@GlobalTransa ctional注解即可。
第一步:添加 undo_log 表到微服务数据库
创建 AT 模式必须的回滚日志表:
CREATE TABLE IF NOT EXISTS `undo_log`
(
    `branch_id`     BIGINT       NOT NULL COMMENT '分支事务id',
    `xid`           VARCHAR(128) NOT NULL COMMENT '全局事务id',
    `context`       VARCHAR(128) NOT NULL COMMENT 'undo_log context,such as serialization',
    `rollback_info` LONGBLOB     NOT NULL COMMENT 'rollback info',
    `log_status`    INT(11)      NOT NULL COMMENT '0:normal status,1:defense status',
    `log_created`   DATETIME(6)  NOT NULL COMMENT 'create datetime',
    `log_modified`  DATETIME(6)  NOT NULL COMMENT 'modify datetime',
    UNIQUE KEY `ux_undo_log` (`xid`, `branch_id`)
) ENGINE = InnoDB
  AUTO_INCREMENT = 1
  DEFAULT CHARSET = utf8mb4 COMMENT ='AT transaction mode undo table';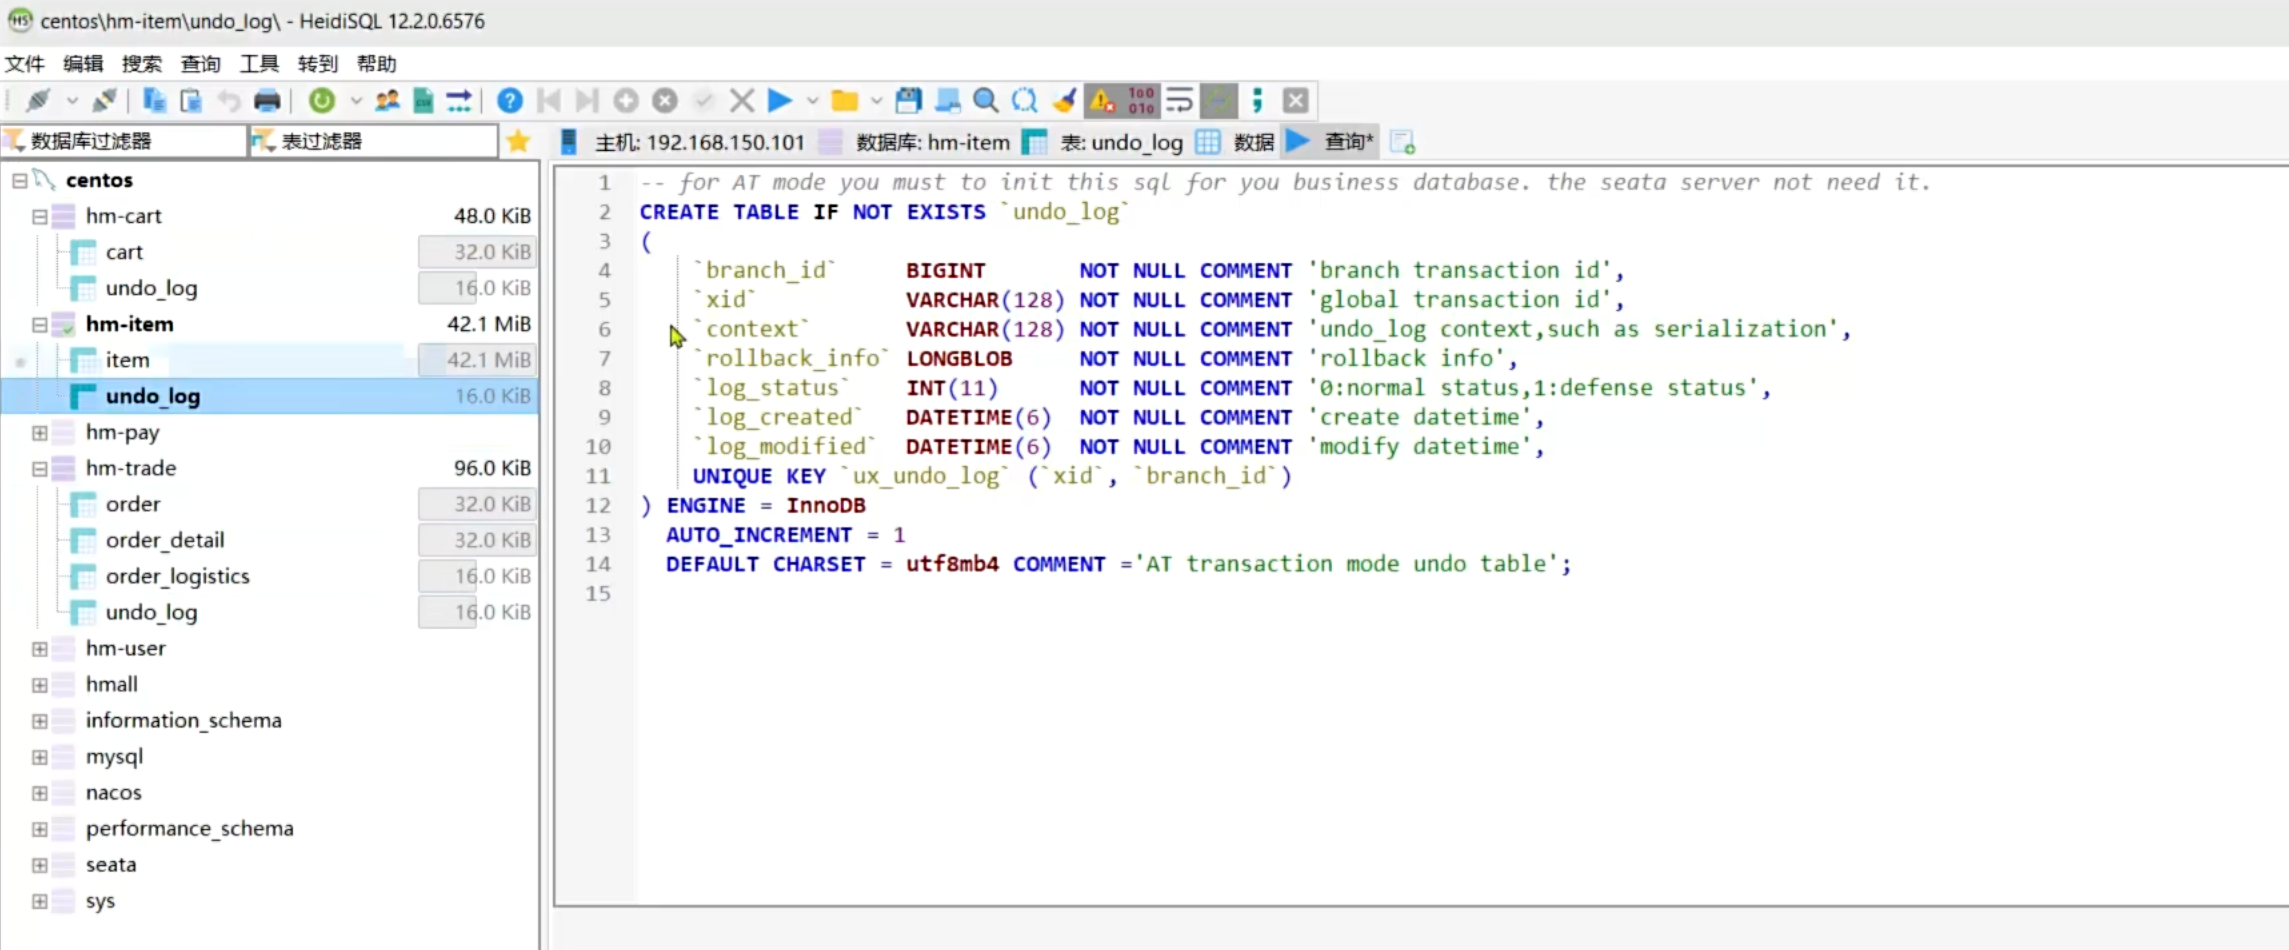
第二步:修改微服务配置文件 application.yml
开启 AT 模式的数据源代理:(也可以直接不写,因为默认AT)
seata:
data-source-proxy-mode: AT # 开启数据源代理的AT模式更多推荐


 25
 0
- 0


 已为社区贡献3条内容

所有评论(0)