
机器学习————层次聚类
层次聚类是一种无监督聚类算法,核心是通过构建聚类树对样本进行分层聚类,无需提前指定聚类个数k,这是它和 K-Means 最核心的区别。
层次聚类按聚类的推进方向和层级构建逻辑,核心分为凝聚型层次聚类(Agglomerative) 和分裂型层次聚类(Divisive) 两种,二者是完全相反的聚类思路,其中凝聚型是实际应用中 99% 以上的选择,所以接下来以凝聚型为目标讲解。如果大家对分裂型感兴趣的话,大家可以留言。
- 凝聚型(Agglomerative):也叫自底向上法,初始时每个样本是一个独立聚类,之后不断合并最相似的聚类,直到所有样本归为一个聚类。
- 分裂型(Divisive):也叫自顶向下法,初始时所有样本是一个聚类,之后不断拆分最不相似的聚类,直到每个样本是一个独立聚类。
(注:如果大家对分裂型感兴趣的话,大家可以留言。)
一、核心概念
1.核心思想
初始状态:n个样本对应n个聚类,记为,每个聚类仅含 1 个样本。
迭代过程:计算所有聚类对之间的相似度,每次将相似度最高,也是距离最近 的两个聚类合并为一个新聚类,聚类个数减少 1。
终止条件:所有样本合并为 1 个聚类或提前指定聚类个数k。
最终结果:得到一棵聚类树——树状图,通过切割树状图可得到任意k个聚类的结果。
2.概念解读
(1)样本间的距离
衡量单个样本之间的相似性,距离越小,相似度越高,是聚类的基础,适用于连续型数据,如果是离散型需用匹配系数等,常用:
- 欧氏距离:适用于低维、各特征量纲一致的数据;
- 曼哈顿距离:对异常值更鲁棒,适用于高维数据;
- 切比雪夫距离:衡量样本在各特征上的最大差异。
(2)类间的距离
层次聚类的核心关键:当聚类从 “单个样本” 合并为 “样本集合” 后,需要定义两个聚类集合之间的距离,不同的定义方式对应不同的层次聚类变体,常用 4 种:
- 单链接:两个聚类中最近的两个样本的距离,易形成 “链式聚类”,对异常值敏感;
- 全链接:两个聚类中最远的两个样本的距离,聚类更紧凑,易受异常值影响;
- 平均链接:两个聚类中所有样本对的平均距离,兼顾单 、 全链接的优点,应用最广;
- 沃德链接:合并两个聚类后总平方和的增量最小,生成的聚类大小相近,是工业界主流选择。
(3)树状图
层次聚类的可视化结果,横轴是样本编号,纵轴是聚类合并时的距离(相似度),纵轴数值越大,说明合并的两个聚类相似度越低。通过切割树状图的纵轴,可得到任意数量的聚类:比如纵轴切割值为d,所有纵轴高度 <d的合并都会保留,最终得到的独立分支数就是聚类个数k。
(4)聚类的树状结构
层次聚类的结果是嵌套的聚类结构:比如将样本聚为 3 类时,这 3 类是聚为 2 类时其中一个大类的子聚类,这种嵌套性是层次聚类的独特优势。
二、数学原理
1.计算前提
设数据集为,其中每个样本是d维向量:
;
设两个聚类集合为,其中
含
个样本,
含
个样本,
,
;
记样本
和
的距离,
为聚类
和
的类间距离。
2.样本间距离公式
(1)欧氏距离
计算样本在欧式空间中的直线距离:
(2)曼哈顿距离
也叫城市街区距离,计算样本在各特征上的绝对差之和:
(3)切比雪夫距离
计算样本在各特征上的最大绝对差:
3.4 种类间距离
这是层次聚类的核心公式,所有链接方式均基于样本间距离推导,以欧氏距离为样本间距离为例,当然也可替换为其他距离。
(1)单链接
取两个聚类中样本对的最小距离:
(2)全链接
取两个聚类中样本对的最大距离:
(3)平均链接
取两个聚类中所有样本对的平均距离:
(4)沃德链接
核心是最小化聚类内的总平方和增量,合并和
为新聚类
,则类间距离为合并后的总平方和增量:
其中聚类内平方和(SSE) 定义为:聚类中所有样本到聚类中心的欧氏距离平方和,为聚类C的中心:
4. 凝聚型层次聚类的迭代公式
凝聚型层次聚类的迭代过程可通过公式抽象为以下步骤,设第t步的聚类集合为,初始步t=0:
1.初始状态(t=0):每个样本为一个聚类,聚类个数;
2.迭代合并(t≥1):在聚类集合中,找到类间距离最小的两个聚类
。将
合并为新聚类
,得到第t步的聚类集合,此时聚类个数
;
3.终止条件:当聚类个数时,迭代停止,共迭代n−1步;
4.聚类结果:根据需求切割聚类树,取任意时的聚类集合
作为最终聚类结果;
三、代码解读
模块一:导入所需库
层次聚类的核心实现依赖scipy.cluster.hierarchy,这是 Python 中最成熟、最高效的层次聚类库,比手动实现更稳定;
import numpy as np  # 数值计算基础库,处理数组、矩阵、均值/方差计算等
import matplotlib.pyplot as plt  # 绘图库,绘制树状图、散点图
from scipy.cluster.hierarchy import linkage, dendrogram, fcluster  # scipy层次聚类核心函数
from sklearn.datasets import make_blobs  # 生成模拟聚类数据,方便测试算法
from sklearn.preprocessing import StandardScaler  # 数据标准化器,消除量纲影响
模块二:生成测试数据并标准化
选择二维数据是为了可视化聚类结果,实际应用中可处理高维数据;
标准化是层次聚类的必做预处理,因为层次聚类基于距离计算,若特征量纲不同(比如特征 1 是身高:cm,特征 2 是体重:kg),量纲大的特征会主导距离计算,导致聚类结果失真;
make_blobs生成的y_true是真实聚类标签,用于和算法预测的标签对比,验证聚类效果。
# 生成二维模拟数据:200个样本、2维特征、4个真实聚类,聚类标准差0.6,随机种子42保证结果可复现
X, y_true = make_blobs(n_samples=200, n_features=2, centers=4, cluster_std=0.6, random_state=42)
# 初始化标准化器(均值0,方差1)
scaler = StandardScaler()
# 对数据做拟合+转换,得到标准化后的数据X_scaled
X_scaled = scaler.fit_transform(X)
模块三:执行层次聚类
函数linkage(X, method, metric):输入标准化数据,输出链接矩阵 Z,记录每一步的合并信息;
参数method:链接方式,可选ward、single、complete、average,对应 4 种核心类间距离;
参数metric:样本间距离,可选euclidean、cityblock(曼哈顿)、chebyshev(切比雪夫);
# 生成层次聚类的链接矩阵Z
Z = linkage(X_scaled, method='ward', metric='euclidean')
模块四:绘制树状图
truncate_mode='lastp':截断树状图,只显示最后p个聚类的分支,避免样本数过多时树状图杂乱;
p=20:截断后显示最后 20 个聚类,可根据样本数调整;
show_leaf_counts=True:在叶节点显示该分支的样本总数;
leaf_rotation=90:叶节点标签旋转 90 度,防止重叠;
leaf_font_size=10:叶节点字体大小。
plt.figure(figsize=(12, 6))  # 设置画布大小,宽12高6,树状图需要更宽的画布
# 绘制树状图
dendrogram(Z, truncate_mode='lastp', p=20, show_leaf_counts=True, leaf_rotation=90, leaf_font_size=10)
plt.title('层次聚类-树状图(Ward链接+欧氏距离)', fontsize=14)  # 标题
plt.xlabel('样本编号(聚类叶节点)', fontsize=12)  # x轴标签:样本/叶节点
plt.ylabel('合并距离(沃德距离)', fontsize=12)  # y轴标签:合并时的类间距离
plt.grid(axis='y', linestyle='--', alpha=0.7)  # 绘制y轴虚线网格,方便切割树状图
plt.tight_layout()  # 自动调整布局,防止标签重叠
plt.show()  # 显示图像
模块五:切割树状图,得到聚类标签
k = 4  # 设定聚类个数
# 切割链接矩阵,得到每个样本的聚类标签
y_pred = fcluster(Z, t=k, criterion='maxclust')
模块六:可视化聚类结果
聚类中心是聚类的 “代表点”,计算方式为聚类内所有样本的特征均值;
二维散点图可直观观察聚类效果:若聚类紧凑、类间分离度高,说明聚类效果好;
高维数据无法直接可视化,可通过 PCA或TSNE 降维后再可视化。
plt.figure(figsize=(8, 6))  # 设置画布大小
# 绘制样本散点图:x轴=特征1,y轴=特征2,c=y_pred=按聚类标签着色,cmap=颜色映射,s=点大小,alpha=透明度
plt.scatter(X_scaled[:, 0], X_scaled[:, 1], c=y_pred, cmap='viridis', s=50, alpha=0.8, edgecolors='black', linewidth=0.5)
plt.title(f'层次聚类结果(k={k}个聚类,Ward链接)', fontsize=14)  # 标题,嵌入k值
plt.xlabel('标准化特征1', fontsize=12)  # x轴标签
plt.ylabel('标准化特征2', fontsize=12)  # y轴标签
plt.grid(linestyle='--', alpha=0.7)  # 绘制网格线,增强可读性
# 遍历每个聚类,计算并绘制聚类中心
for cluster in range(1, k+1):
    # 筛选出该聚类的所有样本,计算均值(聚类中心),axis=0表示按列求均值
    cluster_center = np.mean(X_scaled[y_pred == cluster], axis=0)
    # 绘制聚类中心:红色星号,大小200,白色边缘,增强辨识度
    plt.scatter(cluster_center[0], cluster_center[1], s=200, marker='*', c='red', edgecolors='white', linewidth=2)
plt.tight_layout()  # 自动调整布局
plt.show()  # 显示图像
模块七:输出关键结果
print('层次聚类链接矩阵Z的形状:', Z.shape)  # 输出Z的形状:(199,4),200个样本对应199次合并
print('前5行链接矩阵Z:\n', Z[:5])  # 输出前5次合并的信息
print('前10个样本的聚类标签:', y_pred[:10])  # 输出前10个样本的聚类标签
print('各聚类的样本数量:', np.bincount(y_pred)[1:])  # 统计每个聚类的样本数,[1:]排除0(无0标签)
运行结果
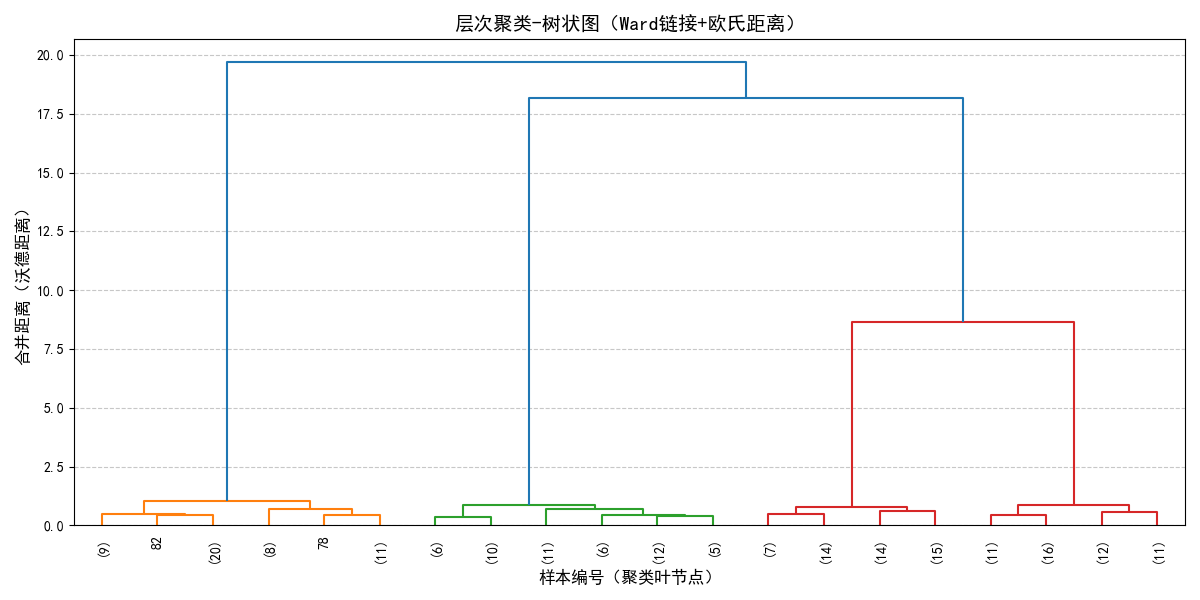
从图中看到,在距离≈5–8 之间时,聚类合并的距离增长平缓;当距离从≈8 跳到≈17–20 时,出现了明显的 “距离突变”。这个突变说明此时合并的两个聚类内部差异已经很大,因此最优聚类个数为 4,这和我们代码中设定的k=4完全吻合。
聚类的相似度分析
- 橙色、绿色聚类:它们的合并距离都在 0–2.5 之间,说明内部样本相似度极高,聚类非常紧凑。
- 红色聚类:合并距离在 0–8 之间,内部样本相似度略低于橙、绿聚类,但仍属于紧凑聚类。
- 蓝色聚类:合并距离跨度最大(0–20),说明它是最后才和其他聚类合并的,与其他聚类的差异最大。
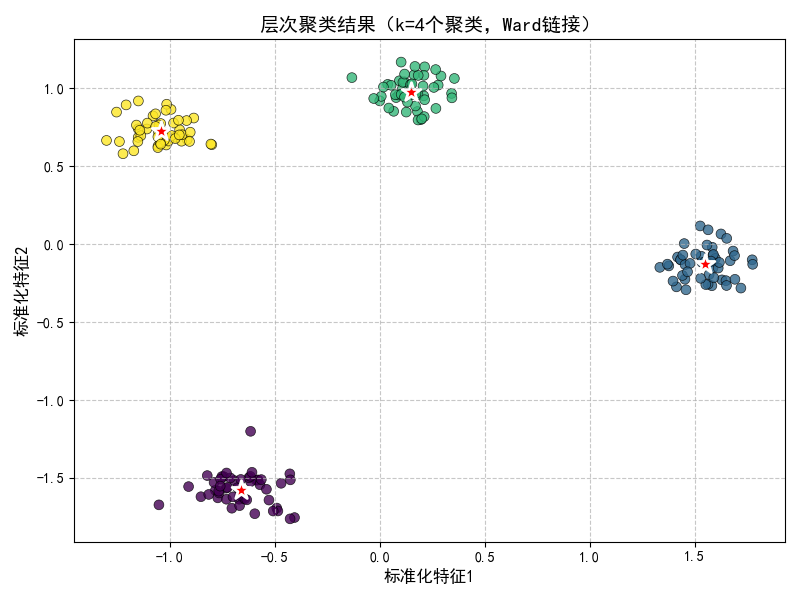
4 个聚类在二维平面上边界清晰、类间分离度高,且每个聚类内部样本都非常紧凑,没有明显的重叠。这说明我们用沃德链接的层次聚类算法,成功识别出了数据中天然存在的 4 个分组。
层次聚类链接矩阵Z的形状: (199, 4)
前5行链接矩阵Z:
[[6.60000000e+01 7.60000000e+01 1.31614835e-03 2.00000000e+00]
[1.10000000e+02 1.69000000e+02 4.79731862e-03 2.00000000e+00]
[5.00000000e+01 1.20000000e+02 5.81057784e-03 2.00000000e+00]
[2.80000000e+01 1.94000000e+02 5.90579448e-03 2.00000000e+00]
[1.30000000e+01 1.49000000e+02 7.07282981e-03 2.00000000e+00]]
前10个样本的聚类标签: [2 3 4 4 1 1 2 4 2 1]
各聚类的样本数量: [50 50 50 50]
四、结语
- 层次聚类是自底向上凝聚型的无监督聚类,核心是通过合并最相似的聚类生成树状图,无需提前指定 k,树状图切割后可得到任意数量的聚类;
- 层次聚类的核心是类间距离——链接方式,常用 4 种:Ward——工业界首选、平均、单、全链接,样本间距离最常用欧氏距离,且聚类前必须做数据标准化;
- 层次聚类的优势是可解释性强、生成分层结构,缺点是时间复杂度高,适用于小样本的探索性聚类或需要分层结果的场景。
感谢大家的观看!内容有限,只具体写了一部分的相关内容,如有不足,期待大家的批评指正!
更多推荐

 22
 0
- 0


 已为社区贡献17条内容

所有评论(0)