
机器学习 | 为什么医生总说有大概率是...?逻辑回归
哈喽,我是黑棠
在《当机器学会“预测”:一次搞懂三大回归技术》文章中,我们通过南瓜市场的例子,介绍了线性回归、多项式回归和逻辑回归的应用。但你可能想知道:这些模型内部的数学原理究竟是什么?它们是如何“学习”和“预测”的?
今天,我们就来揭开这层神秘的面纱,用最直观的方式理解回归背后的数学思想。
逻辑回归篇
在医院的诊断室,你很少听到医生说:“这肯定是流感。”
更多时候,你会听到:“根据你的症状,大概率是流感。”
这种“概率思维”正是逻辑回归的核心。虽然名字里有“回归”,但它其实是解决分类问题的利器。
今天,我们就通过医疗诊断的场景,看看逻辑回归如何将复杂的证据转化为清晰的概率判断。
猜硬币游戏
游戏规则
我手里藏着一枚硬币,让你猜是正面还是反面。但我会给你线索:
- 线索1:我抛硬币的高度(高/中/低)
- 线索2:我接住的方式(手背/手心)
- 线索3:今天的日期(单数/双数)
你需要根据这些线索,设计一个能预测硬币正反面概率的系统。
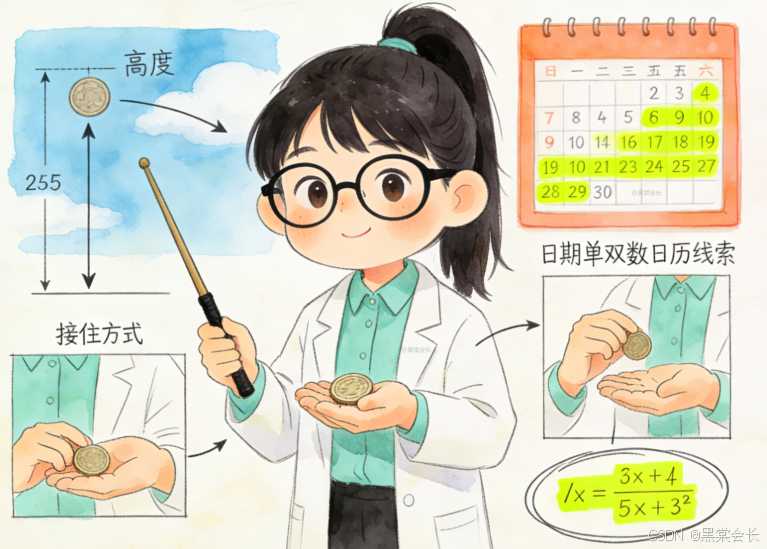
这就是逻辑回归!
逻辑回归的独特思维:
它不直接说“是正面”,而是说“有70%的概率是正面”。
- 收集线索:记录100次抛硬币的(高度,接法,日期)和结果
- 计算得分:根据线索计算一个“正面积分”
- 高抛:+2分(更容易是正面)
- 手心接:-1分(更可能是反面)
- 单数日:+0.5分
- 转换为概率:通过一个神奇的S形函数,把“正面积分”变成“正面概率”
- 做出决策:如果概率>50%,猜正面;否则猜反面
生活中的逻辑回归
- 判断:根据症状,得流感概率有多大
- 评估:贷款申请人违约的可能性
- 预测:客户购买产品的概率
- 诊断:肿瘤是恶性的概率
关键点:逻辑回归其实是用回归方法解决分类问题——它先计算一个“证据得分”,再把得分转化为概率,最后根据概率做分类。
⚖️ 逻辑回归:概率世界的“天平”
关键突破:从数值预测到概率预测
逻辑回归最核心的数学创新是Sigmoid函数(也叫Logistic函数)。
Sigmoid函数:
σ(𝑧) = 1 / (1 + 𝑒⁻ᶻ)
这个函数的神奇之处在于:
- 无论输入𝑧是多少,输出都被压缩到**(0, 1)**之间
- 当𝑧=0时,σ(𝑧)=0.5
- 当𝑧→∞时,σ(𝑧)→1
- 当𝑧→-∞时,σ(𝑧)→0
逻辑回归的完整公式:
- 首先像线性回归一样计算:𝑧 = 𝑤𝑥 + 𝑏
- 然后通过Sigmoid函数:𝑃(𝑦=1|𝑥) = σ(𝑧) = 1 / (1 + 𝑒⁻⁽ʷˣ⁺ᵇ⁾)
这里𝑃(𝑦=1|𝑥)表示在给定特征𝑥的条件下,样本属于类别1的概率。
损失函数的变化:从均方误差到交叉熵
线性回归用均方误差,但这对概率问题不合适。
逻辑回归使用交叉熵损失:
𝐿 = -[𝑦·log(𝑃) + (1-𝑦)·log(1-𝑃)]
这个函数的特点是:
- 当真实标签𝑦=1时,如果预测概率𝑃接近1,损失接近0
- 当真实标签𝑦=1时,如果预测概率𝑃接近0,损失会非常大
- 对𝑦=0的情况对称
决策边界:
虽然我们得到的是概率,但最终需要做出分类决策。通常设置一个阈值(如0.5):
- 如果𝑃 ≥ 0.5,预测为类别1
- 如果𝑃 < 0.5,预测为类别0
这个0.5的阈值对应的𝑧值就是:𝑧 = 𝑤𝑥 + 𝑏 = 0
因此,𝑤𝑥 + 𝑏 = 0 定义了一条“决策边界”。
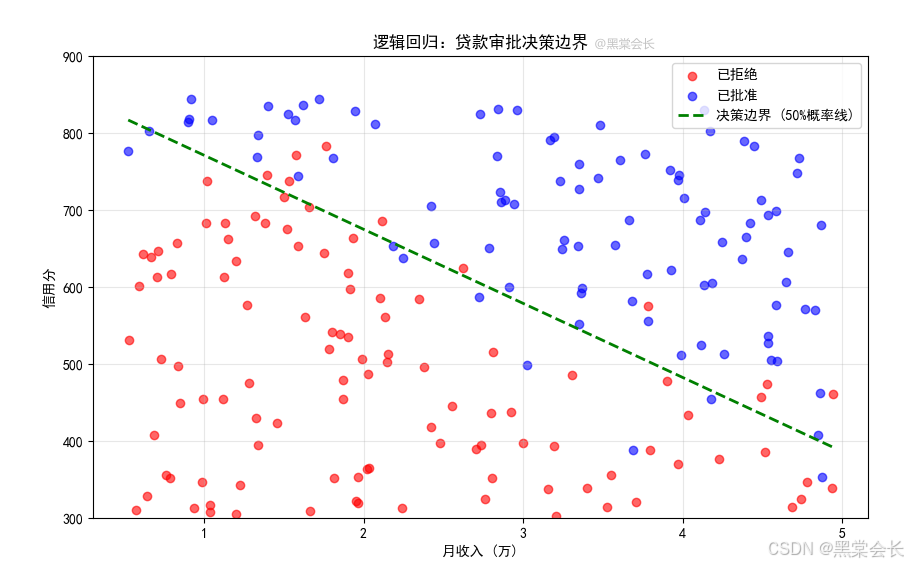
💻 代码实战
如何用逻辑回归决定是否批准一笔贷款?
这个脚本模拟了基于“收入”和“信用分”的审批逻辑,并画出了那条隐形的“决策边界”。
👉 代码示例:
import os
import sys
import io
# 设置控制台输出为 UTF-8 编码
if sys.platform == 'win32':
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
os.system('chcp 65001 > nul 2>&1')
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix
import matplotlib.pyplot as plt
# 配置 matplotlib 中文字体
plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei', 'DejaVu Sans'] # 使用黑体或微软雅黑
plt.rcParams['axes.unicode_minus'] = False # 解决负号显示问题
def generate_loan_data(n_samples=200):
"""
生成模拟贷款数据
特征1: 月收入 (0.5万 - 5万)
特征2: 信用分 (300 - 850)
标签: 0 (拒绝) 或 1 (批准)
"""
np.random.seed(42)
income = np.random.uniform(0.5, 5, n_samples) # 单位:万
credit = np.random.uniform(300, 850, n_samples)
# 真实的决策逻辑(包含一些随机性)
# 综合得分 = 收入 * 2 + (信用分-600)/50
# 如果得分 > 5,则批准概率高
score = income * 2 + (credit - 600) / 50
probability = 1 / (1 + np.exp(-(score - 5))) # Sigmoid转换
# 根据概率生成标签
labels = (np.random.random(n_samples) < probability).astype(int)
X = np.column_stack((income, credit))
return X, labels
def main():
print("🤖 开始执行逻辑回归任务:贷款审批预测...\n")
# 1. 准备数据
print("1. 收集申请人数据(收入 & 信用分)...")
X, y = generate_loan_data()
print(f" 样本数量: {len(X)}")
print(f" 批准比例: {np.mean(y)*100:.1f}%")
# 2. 训练模型
print("\n2. 训练逻辑回归模型...")
model = LogisticRegression()
model.fit(X, y)
# 获取参数
w = model.coef_[0]
b = model.intercept_[0]
print(f" ✅ 模型训练完成!")
print(f" 特征权重: 收入 w1={w[0]:.2f}, 信用分 w2={w[1]:.2f}")
print(f" (正权重表示该特征越高,越容易获得批准)")
# 3. 模拟新申请人评估
print("\n3. 评估新申请人...")
applicants = [
[1.5, 500], # 收入低,信用低 -> 应该拒绝
[4.0, 750], # 收入高,信用高 -> 应该批准
[2.5, 650] # 中等 -> 看概率
]
for i, app in enumerate(applicants):
# 预测概率
prob = model.predict_proba([app])[0][1] # 获取类别1(批准)的概率
# 预测结果
pred = model.predict([app])[0]
result = "✅ 批准" if pred == 1 else "❌ 拒绝"
print(f" 申请人{i+1}: 收入{app[0]}万, 信用{app[1]}分")
print(f" -> 批准概率: {prob*100:.1f}%")
print(f" -> 最终决策: {result}")
print("-" * 30)
# 4. 可视化决策边界
try:
plt.figure(figsize=(10, 6))
# 绘制数据点
plt.scatter(X[y==0][:,0], X[y==0][:,1], color='red', alpha=0.6, label='已拒绝')
plt.scatter(X[y==1][:,0], X[y==1][:,1], color='blue', alpha=0.6, label='已批准')
# 绘制决策边界 (w1*x1 + w2*x2 + b = 0)
# x2 = -(w1*x1 + b) / w2
x1_min, x1_max = X[:, 0].min(), X[:, 0].max()
x1_vals = np.linspace(x1_min, x1_max, 100)
x2_vals = -(w[0] * x1_vals + b) / w[1]
plt.plot(x1_vals, x2_vals, color='green', linewidth=2, linestyle='--', label='决策边界 (50%概率线)')
plt.title('逻辑回归:贷款审批决策边界')
plt.xlabel('月收入 (万)')
plt.ylabel('信用分')
plt.legend()
plt.grid(True, alpha=0.3)
plt.ylim(300, 900) # 限制y轴范围
plt.savefig('logistic_regression_plot.png')
print("\n📊 决策边界图已保存为 'logistic_regression_plot.png'")
except Exception as e:
print(f"绘图失败: {e}")
if __name__ == "__main__":
main()
试着修改代码中的申请人数据,看看模型会给出什么样的概率判断?
总结一下
💎 本期核心要点
逻辑回归本质:先计算“证据积分”,再用Sigmoid函数转换为概率
Sigmoid函数:将任意实数压缩到(0,1),完美表示概率
决策边界:概率=0.5对应的那条“分界线”
交叉熵损失:专为概率预测设计的误差衡量方式
🔍 一个巧妙类比
逻辑回归的思考过程,很像法官判案:
收集证据(症状、化验结果)→ 计算证据积分(z = w₁x₁ + w₂x₂ + …)
评估证据强度 → 通过Sigmoid函数得到“有罪概率”
做出判决(概率>0.5判有罪)→ 确定诊断结果
下一篇预告:三大回归的数学对比
本文首发于CSDN:[黑棠会长],转载请注明来源。
关注我,一起用轻松的方式读懂前沿科技。
更多推荐

 17
 0
- 0


 已为社区贡献6条内容

所有评论(0)