
【机器学习教程】第08章_核方法【上】
第 08 章 核方法 (Kernel Methods)
“The curse of dimensionality is the blessing of kernel methods.”
很多时候,我们在低维空间撞得头破血流(比如 XOR 问题),却不知道只要退后一步,升到一个更高的维度,一切都会因为稀疏而变得线性可分。
核方法是机器学习中**“升维打击”**的数学实现。它的魔力在于:我们可以在无限维的空间中挥舞利剑,却只需要支付有限维的计算代价。本章将揭示这个"免费午餐"背后的数学秘密——核技巧 (Kernel Trick)。
与前序章节的联系:
- 第 5 章(线性回归) 为我们建立了岭回归的原始形式: w ∗ = ( X T X + λ I ) − 1 X T y w^* = (X^T X + \lambda I)^{-1} X^T y w∗=(XTX+λI)−1XTy
- 本章将展示如何通过核技巧将其推广到无穷维特征空间: α ∗ = ( K + λ I ) − 1 y \alpha^* = (\mathbf{K} + \lambda I)^{-1} y α∗=(K+λI)−1y
- 两者通过对偶性完美呼应:线性岭回归在特征空间优化,核岭回归在样本空间优化
目录
1. 直觉:维度打击
1.1 XOR 问题:二维空间的绝望
考虑经典的 XOR (异或) 问题:
| x 1 x_1 x1 | x 2 x_2 x2 | 类别 |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
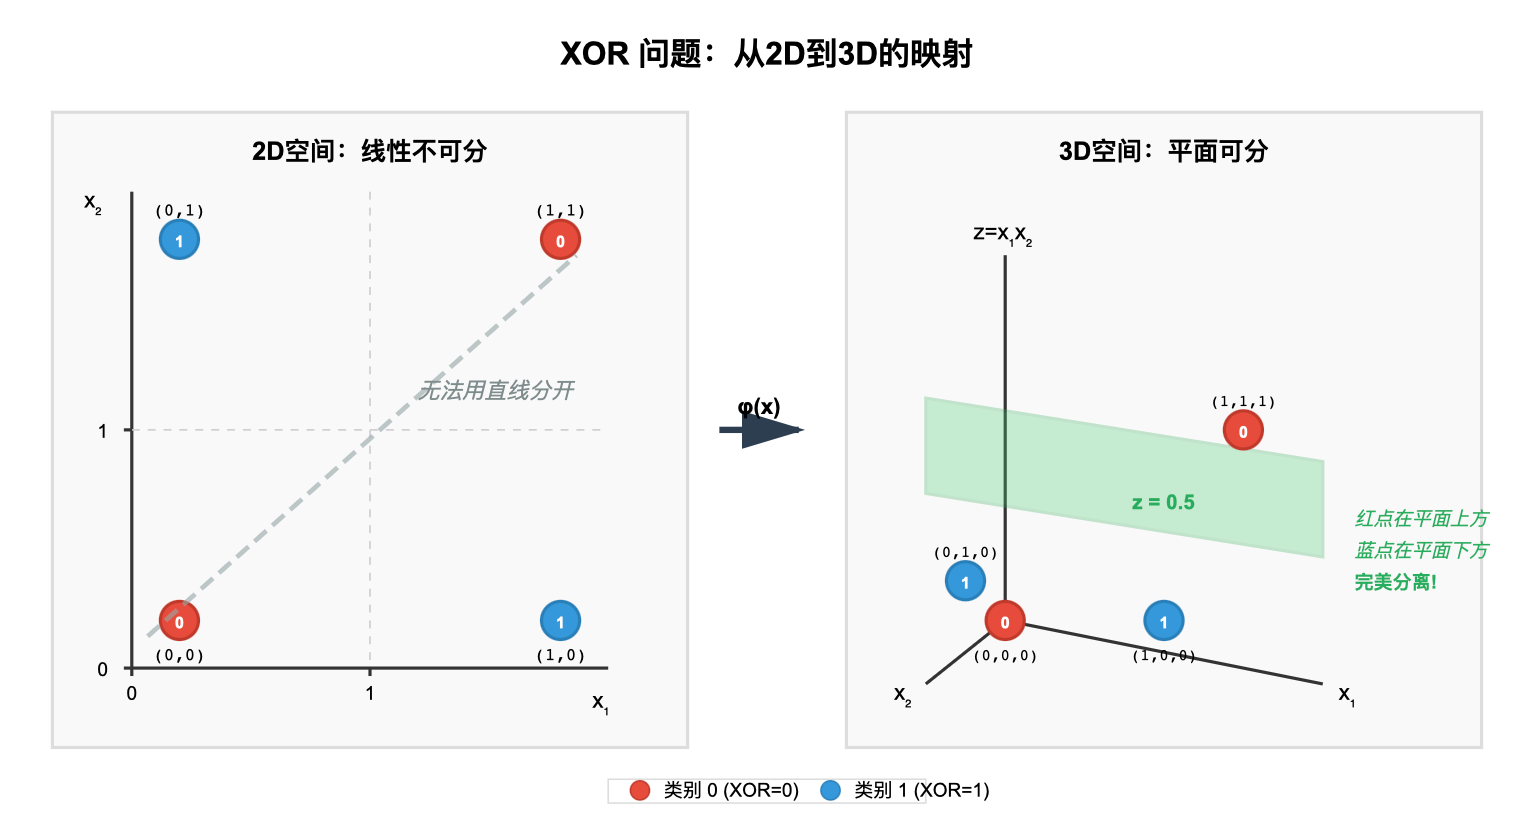
问题:在二维平面上,不存在一条直线能够将两个类别分开。
无论你怎么尝试,任何线性分类器 w 1 x 1 + w 2 x 2 + b = 0 w_1 x_1 + w_2 x_2 + b = 0 w1x1+w2x2+b=0 都会犯错。这是线性模型的根本局限。
1.2 升维的魔法:三维空间的救赎
定义映射 ϕ : R 2 → R 3 \phi: \mathbb{R}^2 \to \mathbb{R}^3 ϕ:R2→R3:
ϕ ( x ) = ϕ ( x 1 x 2 ) = ( x 1 x 2 x 1 x 2 ) \phi(x) = \phi\begin{pmatrix} x_1 \\ x_2 \end{pmatrix} = \begin{pmatrix} x_1 \\ x_2 \\ x_1 x_2 \end{pmatrix} ϕ(x)=ϕ(x1x2)= x1x2x1x2
将 XOR 数据映射到三维空间:
ϕ ( 0 0 ) = ( 0 0 0 ) (类别 0) ϕ ( 0 1 ) = ( 0 1 0 ) (类别 1) ϕ ( 1 0 ) = ( 1 0 0 ) (类别 1) ϕ ( 1 1 ) = ( 1 1 1 ) (类别 0) \begin{aligned} \phi\begin{pmatrix} 0 \\ 0 \end{pmatrix} &= \begin{pmatrix} 0 \\ 0 \\ 0 \end{pmatrix} \quad &\text{(类别 0)} \\[0.5em] \phi\begin{pmatrix} 0 \\ 1 \end{pmatrix} &= \begin{pmatrix} 0 \\ 1 \\ 0 \end{pmatrix} \quad &\text{(类别 1)} \\[0.5em] \phi\begin{pmatrix} 1 \\ 0 \end{pmatrix} &= \begin{pmatrix} 1 \\ 0 \\ 0 \end{pmatrix} \quad &\text{(类别 1)} \\[0.5em] \phi\begin{pmatrix} 1 \\ 1 \end{pmatrix} &= \begin{pmatrix} 1 \\ 1 \\ 1 \end{pmatrix} \quad &\text{(类别 0)} \end{aligned} ϕ(00)ϕ(01)ϕ(10)ϕ(11)= 000 = 010 = 100 = 111 (类别 0)(类别 1)(类别 1)(类别 0)
奇迹发生:在三维空间中,一个简单的平面 z 3 = 0.5 z_3 = 0.5 z3=0.5 就能完美分割两个类别!
1.3 推导:为什么升维有效?
Cover 定理 (Cover’s Theorem):
将复杂模式投射到高维空间,模式更可能线性可分。
直觉:
- 在 d d d 维空间中, n n n 个点被随机二分的方式有 2 n 2^n 2n 种
- 用超平面线性可分的方式数量随着维度 d d d 增加而增加
- 当 d ≥ n − 1 d \geq n-1 d≥n−1 时,几乎所有的二分都是线性可分的
数学表达:
在 d d d 维空间中, n n n 个一般位置的点,线性可分的二分数量为:
C ( n , d ) = 2 ∑ k = 0 d ( n − 1 k ) C(n, d) = 2 \sum_{k=0}^{d} \binom{n-1}{k} C(n,d)=2k=0∑d(kn−1)
当 d = n − 1 d = n-1 d=n−1 时, C ( n , d ) = 2 n C(n, d) = 2^n C(n,d)=2n,即所有二分都可分!
XOR 的验证:
对于 XOR, n = 4 n = 4 n=4,原始维度 d = 2 d = 2 d=2:
- C ( 4 , 2 ) = 2 ( ( 3 0 ) + ( 3 1 ) + ( 3 2 ) ) = 2 ( 1 + 3 + 3 ) = 14 < 2 4 = 16 C(4, 2) = 2(\binom{3}{0} + \binom{3}{1} + \binom{3}{2}) = 2(1 + 3 + 3) = 14 < 2^4 = 16 C(4,2)=2((03)+(13)+(23))=2(1+3+3)=14<24=16
升维到 d = 3 d = 3 d=3:
- C ( 4 , 3 ) = 2 ( ( 3 0 ) + ( 3 1 ) + ( 3 2 ) + ( 3 3 ) ) = 2 ( 1 + 3 + 3 + 1 ) = 16 = 2 4 C(4, 3) = 2(\binom{3}{0} + \binom{3}{1} + \binom{3}{2} + \binom{3}{3}) = 2(1 + 3 + 3 + 1) = 16 = 2^4 C(4,3)=2((03)+(13)+(23)+(33))=2(1+3+3+1)=16=24
所有二分都可分,包括 XOR!
2. 代价:维度的诅咒
2.1 多项式特征的维度爆炸
假设我们要将 n n n 维输入映射到 d d d 阶多项式特征空间。
例子:2 维输入 x = ( x 1 , x 2 ) x = (x_1, x_2) x=(x1,x2),2 阶多项式映射:
ϕ ( x ) = ( 1 , x 1 , x 2 , x 1 2 , x 1 x 2 , x 2 2 ) \phi(x) = (1, x_1, x_2, x_1^2, x_1 x_2, x_2^2) ϕ(x)=(1,x1,x2,x12,x1x2,x22)
维度从 2 → 6 2 \to 6 2→6。
一般情况: n n n 维输入, d d d 阶多项式,特征空间维度为:
dim ( ϕ ( x ) ) = ( n + d d ) = ( n + d ) ! n ! d ! \text{dim}(\phi(x)) = \binom{n+d}{d} = \frac{(n+d)!}{n! \, d!} dim(ϕ(x))=(dn+d)=n!d!(n+d)!
推导:
d d d 阶多项式的单项式数量,等价于将 d d d 个相同的球放入 n n n 个不同的盒子(允许空盒),即多重集合问题:
( n + d d ) = ( n + d n ) \binom{n+d}{d} = \binom{n+d}{n} (dn+d)=(nn+d)
2.2 复杂度爆炸实例
| n n n (维度) | d d d (阶数) | 特征维度 | 增长倍数 |
|---|---|---|---|
| 10 | 2 | 66 | 6.6× |
| 10 | 3 | 286 | 28.6× |
| 10 | 5 | 3,003 | 300× |
| 100 | 2 | 5,151 | 51.5× |
| 100 | 3 | 176,851 | 1,769× |
| 100 | 5 | 79,208,745 | 792,087× |
问题:
- 存储开销:需要 O ( ( n + d d ) ) O(\binom{n+d}{d}) O((dn+d)) 空间存储 ϕ ( x ) \phi(x) ϕ(x)
- 计算开销:计算 ϕ ( x ) \phi(x) ϕ(x) 需要 O ( ( n + d d ) ) O(\binom{n+d}{d}) O((dn+d)) 时间
- 内积开销:计算 ϕ ( x ) T ϕ ( z ) \phi(x)^T \phi(z) ϕ(x)Tϕ(z) 需要 O ( ( n + d d ) ) O(\binom{n+d}{d}) O((dn+d)) 次乘法
当 n = 100 n = 100 n=100, d = 3 d = 3 d=3 时,每个内积需要 176,851 次乘法!
2.3 无穷维的梦魇
如果我们想要包含所有阶数的多项式特征(类似泰勒展开):
ϕ ( x ) = ( 1 , x 1 , x 2 , … , x 1 2 , x 1 x 2 , … , x 1 3 , … ) \phi(x) = (1, x_1, x_2, \ldots, x_1^2, x_1 x_2, \ldots, x_1^3, \ldots) ϕ(x)=(1,x1,x2,…,x12,x1x2,…,x13,…)
特征空间变成无穷维!
这似乎是不可能计算的。但核方法会告诉我们:这不仅可能,而且高效。
3. 救赎:核技巧 (Kernel Trick)
3.1 核心观察:我们不需要 ϕ ( x ) \phi(x) ϕ(x)
回顾线性分类器的决策函数(如 SVM):
f ( x ) = w T ϕ ( x ) + b f(x) = w^T \phi(x) + b f(x)=wTϕ(x)+b
关键发现:在很多算法中(SVM、岭回归等),最优解 w w w 可以表示为:
w = ∑ i = 1 m α i ϕ ( x i ) w = \sum_{i=1}^m \alpha_i \phi(x_i) w=i=1∑mαiϕ(xi)
代入决策函数:
f ( x ) = ∑ i = 1 m α i ϕ ( x i ) T ϕ ( x ) + b = ∑ i = 1 m α i ⟨ ϕ ( x i ) , ϕ ( x ) ⟩ ⏟ K ( x i , x ) + b f(x) = \sum_{i=1}^m \alpha_i \phi(x_i)^T \phi(x) + b = \sum_{i=1}^m \alpha_i \underbrace{\langle \phi(x_i), \phi(x) \rangle}_{K(x_i, x)} + b f(x)=i=1∑mαiϕ(xi)Tϕ(x)+b=i=1∑mαiK(xi,x) ⟨ϕ(xi),ϕ(x)⟩+b
结论:我们只需要计算内积 ϕ ( x i ) T ϕ ( x ) \phi(x_i)^T \phi(x) ϕ(xi)Tϕ(x),而不需要知道 ϕ ( x ) \phi(x) ϕ(x) 本身!
3.2 核函数的定义
定义:核函数 K : X × X → R K: \mathcal{X} \times \mathcal{X} \to \mathbb{R} K:X×X→R 满足:
K ( x , z ) = ⟨ ϕ ( x ) , ϕ ( z ) ⟩ K(x, z) = \langle \phi(x), \phi(z) \rangle K(x,z)=⟨ϕ(x),ϕ(z)⟩
其中 ϕ : X → H \phi: \mathcal{X} \to \mathcal{H} ϕ:X→H 是从输入空间到某个希尔伯特空间的映射。
核技巧的承诺:
如果 K ( x , z ) K(x, z) K(x,z) 可以在原始空间(低维)中高效计算,我们就可以:
- 避免显式计算 ϕ ( x ) \phi(x) ϕ(x)(避免维度爆炸)
- 避免在高维空间中存储和计算(节省空间和时间)
- 享受高维空间的表达能力(解决非线性问题)
3.3 核心推导:多项式核
目标:证明 ( x T z ) 2 (x^T z)^2 (xTz)2 等价于某个二阶多项式映射的内积。
设 x = ( x 1 , x 2 ) T x = (x_1, x_2)^T x=(x1,x2)T, z = ( z 1 , z 2 ) T z = (z_1, z_2)^T z=(z1,z2)T。
步骤 1:展开内积的平方
( x T z ) 2 = ( x 1 z 1 + x 2 z 2 ) 2 (x^T z)^2 = (x_1 z_1 + x_2 z_2)^2 (xTz)2=(x1z1+x2z2)2
步骤 2:展开平方
( x T z ) 2 = ( x 1 z 1 ) 2 + 2 ( x 1 z 1 ) ( x 2 z 2 ) + ( x 2 z 2 ) 2 = x 1 2 z 1 2 + 2 x 1 x 2 z 1 z 2 + x 2 2 z 2 2 \begin{aligned} (x^T z)^2 &= (x_1 z_1)^2 + 2(x_1 z_1)(x_2 z_2) + (x_2 z_2)^2 \\ &= x_1^2 z_1^2 + 2 x_1 x_2 z_1 z_2 + x_2^2 z_2^2 \end{aligned} (xTz)2=(x1z1)2+2(x1z1)(x2z2)+(x2z2)2=x12z12+2x1x2z1z2+x22z22
步骤 3:配成内积形式
注意到可以写成:
( x T z ) 2 = x 1 2 z 1 2 + ( 2 x 1 x 2 ) ( 2 z 1 z 2 ) + x 2 2 z 2 2 (x^T z)^2 = x_1^2 z_1^2 + (\sqrt{2} x_1 x_2)(\sqrt{2} z_1 z_2) + x_2^2 z_2^2 (xTz)2=x12z12+(2x1x2)(2z1z2)+x22z22
步骤 4:识别特征映射
定义:
ϕ ( x ) = ( x 1 2 2 x 1 x 2 x 2 2 ) , ϕ ( z ) = ( z 1 2 2 z 1 z 2 z 2 2 ) \phi(x) = \begin{pmatrix} x_1^2 \\ \sqrt{2} x_1 x_2 \\ x_2^2 \end{pmatrix}, \quad \phi(z) = \begin{pmatrix} z_1^2 \\ \sqrt{2} z_1 z_2 \\ z_2^2 \end{pmatrix} ϕ(x)= x122x1x2x22 ,ϕ(z)= z122z1z2z22
则:
ϕ ( x ) T ϕ ( z ) = x 1 2 z 1 2 + 2 x 1 x 2 z 1 z 2 + x 2 2 z 2 2 = ( x T z ) 2 \phi(x)^T \phi(z) = x_1^2 z_1^2 + 2 x_1 x_2 z_1 z_2 + x_2^2 z_2^2 = (x^T z)^2 ϕ(x)Tϕ(z)=x12z12+2x1x2z1z2+x22z22=(xTz)2
验证完毕:
K ( x , z ) = ( x T z ) 2 = ⟨ ϕ ( x ) , ϕ ( z ) ⟩ \boxed{K(x, z) = (x^T z)^2 = \langle \phi(x), \phi(z) \rangle} K(x,z)=(xTz)2=⟨ϕ(x),ϕ(z)⟩
计算复杂度对比:
| 方法 | 计算 ϕ ( x ) \phi(x) ϕ(x) | 计算内积 | 总计 |
|---|---|---|---|
| 显式映射 | O ( n 2 ) O(n^2) O(n2) | O ( n 2 ) O(n^2) O(n2) | O ( n 2 ) O(n^2) O(n2) |
| 核函数 | - | O ( n ) O(n) O(n) | O ( n ) O(n) O(n) |
对于 n = 100 n = 100 n=100,这是 100 倍的加速!
3.4 一般多项式核
d d d 阶多项式核:
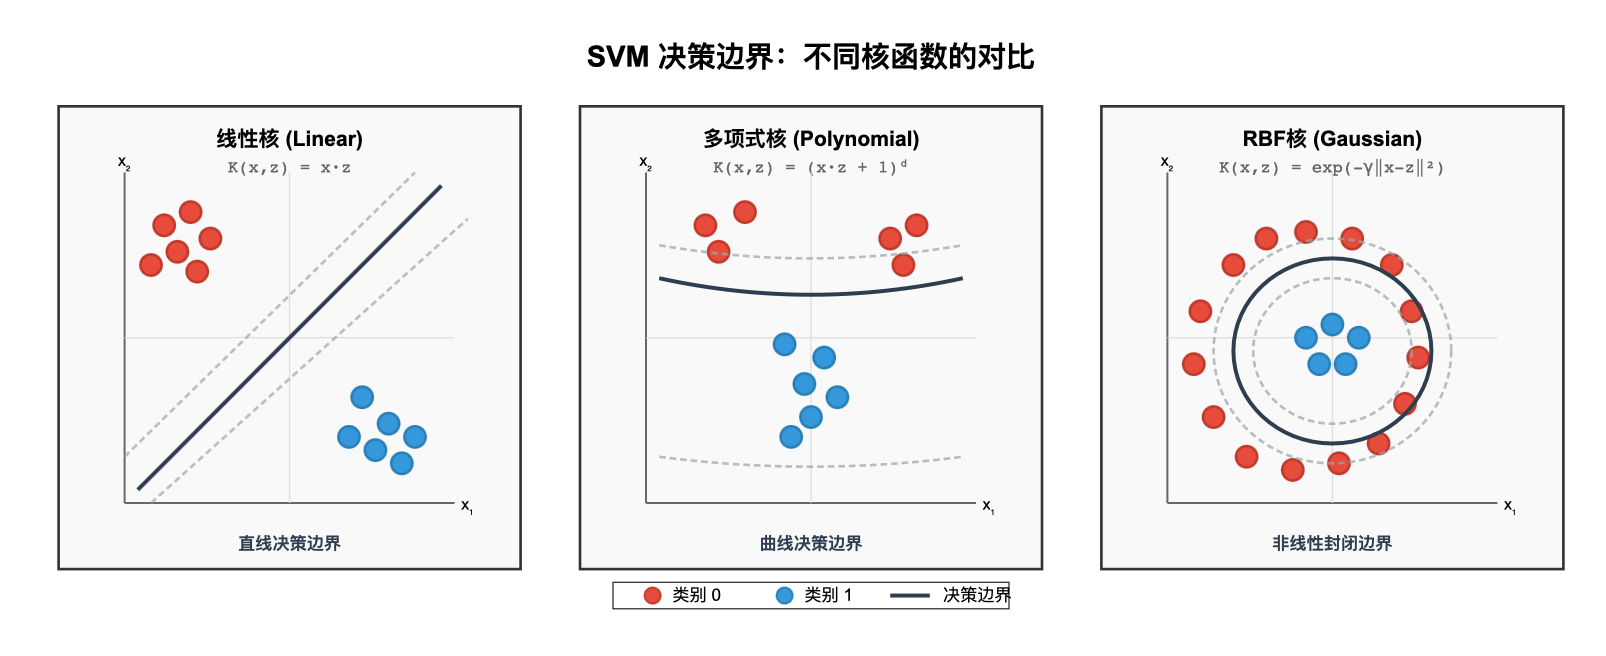
K ( x , z ) = ( x T z + c ) d K(x, z) = (x^T z + c)^d K(x,z)=(xTz+c)d
其中 c ≥ 0 c \geq 0 c≥0 是常数。
特征空间维度: ( n + d d ) \binom{n+d}{d} (dn+d)
计算复杂度: O ( n ) O(n) O(n)(计算 x T z x^T z xTz 然后取 d d d 次方)
加速比: ( n + d d ) n ≈ n d d ! ⋅ n = n d − 1 d ! \frac{\binom{n+d}{d}}{n} \approx \frac{n^d}{d! \cdot n} = \frac{n^{d-1}}{d!} n(dn+d)≈d!⋅nnd=d!nd−1
例子: n = 100 n = 100 n=100, d = 3 d = 3 d=3
- 特征维度:176,851
- 核计算:100 次乘法 + 1 次立方
- 加速比:约 1,769 倍
3.5 核技巧的威力总结
核技巧的本质:
用 O ( n ) O(n) O(n) 的计算代价,获得 O ( n d ) O(n^d) O(nd) 甚至 O ( ∞ ) O(\infty) O(∞) 维空间的表达能力。
这是机器学习中少有的"免费午餐"——不是真的免费,而是数学的巧妙重组。
4. Mercer 定理:什么样的函数能当核?
4.1 问题的提出
不是任意函数都能作为核函数。
反例 1: K ( x , z ) = − x T z K(x, z) = -x^T z K(x,z)=−xTz
如果这是核函数,应该有 K ( x , x ) = ∥ ϕ ( x ) ∥ 2 ≥ 0 K(x, x) = \|\phi(x)\|^2 \geq 0 K(x,x)=∥ϕ(x)∥2≥0。
但 K ( x , x ) = − x T x = − ∥ x ∥ 2 < 0 K(x, x) = -x^T x = -\|x\|^2 < 0 K(x,x)=−xTx=−∥x∥2<0(当 x ≠ 0 x \neq 0 x=0)。
矛盾!所以它不是核函数。
反例 2: K ( x , z ) = ( x T z ) 3 K(x, z) = (x^T z)^3 K(x,z)=(xTz)3(在某些情况下)
虽然看起来像多项式核,但对于某些数据,核矩阵可能不是半正定的。
问题:什么样的函数 K ( x , z ) K(x, z) K(x,z) 能保证对应某个 ϕ \phi ϕ?
4.2 核矩阵 (Gram Matrix)
给定数据集 { x 1 , … , x m } \{x_1, \ldots, x_m\} {x1,…,xm} 和核函数 K K K,定义核矩阵:
K = ( K ( x 1 , x 1 ) K ( x 1 , x 2 ) ⋯ K ( x 1 , x m ) K ( x 2 , x 1 ) K ( x 2 , x 2 ) ⋯ K ( x 2 , x m ) ⋮ ⋮ ⋱ ⋮ K ( x m , x 1 ) K ( x m , x 2 ) ⋯ K ( x m , x m ) ) \mathbf{K} = \begin{pmatrix} K(x_1, x_1) & K(x_1, x_2) & \cdots & K(x_1, x_m) \\ K(x_2, x_1) & K(x_2, x_2) & \cdots & K(x_2, x_m) \\ \vdots & \vdots & \ddots & \vdots \\ K(x_m, x_1) & K(x_m, x_2) & \cdots & K(x_m, x_m) \end{pmatrix} K= K(x1,x1)K(x2,x1)⋮K(xm,x1)K(x1,x2)K(x2,x2)⋮K(xm,x2)⋯⋯⋱⋯K(x1,xm)K(x2,xm)⋮K(xm,xm)
性质:
- 对称性: K i j = K ( x i , x j ) = K ( x j , x i ) = K j i \mathbf{K}_{ij} = K(x_i, x_j) = K(x_j, x_i) = \mathbf{K}_{ji} Kij=K(xi,xj)=K(xj,xi)=Kji
- 如果 K K K 是核,则 K \mathbf{K} K 应该满足什么性质?
4.3 Mercer 定理(标准形式)
Mercer 定理 (Mercer’s Theorem):
一个对称函数 K : X × X → R K: \mathcal{X} \times \mathcal{X} \to \mathbb{R} K:X×X→R 是核函数,当且仅当对于任意有限数据集 { x 1 , … , x m } \{x_1, \ldots, x_m\} {x1,…,xm},核矩阵 K \mathbf{K} K 是半正定 (positive semi-definite) 的。
半正定的定义:
矩阵 K \mathbf{K} K 是半正定的,如果对于任意向量 α ∈ R m \alpha \in \mathbb{R}^m α∈Rm:
α T K α = ∑ i = 1 m ∑ j = 1 m α i α j K ( x i , x j ) ≥ 0 \alpha^T \mathbf{K} \alpha = \sum_{i=1}^m \sum_{j=1}^m \alpha_i \alpha_j K(x_i, x_j) \geq 0 αTKα=i=1∑mj=1∑mαiαjK(xi,xj)≥0
直觉解释:为什么半正定矩阵能分解成内积?
这是线性代数中特征分解的优美应用:
- 半正定 ⇒ 非负特征值:半正定矩阵 K \mathbf{K} K 的所有特征值 λ i ≥ 0 \lambda_i \geq 0 λi≥0
- 特征分解 = 坐标系旋转:分解 K = U Λ U T \mathbf{K} = \mathbf{U} \mathbf{\Lambda} \mathbf{U}^T K=UΛUT 等价于在新坐标系下重新表示数据
- 构造特征映射:将每个点 x i x_i xi 映射到 ϕ ( x i ) = Λ U i , : T \phi(x_i) = \sqrt{\mathbf{\Lambda}} \mathbf{U}_{i,:}^T ϕ(xi)=ΛUi,:T,本质是用特征值"拉伸"各维度
- 内积恢复核:新坐标系下的内积 ⟨ ϕ ( x i ) , ϕ ( x j ) ⟩ \langle \phi(x_i), \phi(x_j) \rangle ⟨ϕ(xi),ϕ(xj)⟩ 恰好等于原核矩阵元素 K ( x i , x j ) K(x_i, x_j) K(xi,xj)
本质:半正定矩阵 K \mathbf{K} K 可以看作是某个隐藏特征空间中的"距离/相似度矩阵",特征分解帮我们逆向工程出这个隐藏空间的坐标 ϕ ( x ) \phi(x) ϕ(x)。
直观例子:
考虑 3 个点的核矩阵:
K = ( 1.0 0.8 0.3 0.8 1.0 0.5 0.3 0.5 1.0 ) \mathbf{K} = \begin{pmatrix} 1.0 & 0.8 & 0.3 \\ 0.8 & 1.0 & 0.5 \\ 0.3 & 0.5 & 1.0 \end{pmatrix} K= 1.00.80.30.81.00.50.30.51.0
特征分解后得到: λ 1 = 1.95 , λ 2 = 0.73 , λ 3 = 0.32 \lambda_1 = 1.95, \lambda_2 = 0.73, \lambda_3 = 0.32 λ1=1.95,λ2=0.73,λ3=0.32(均非负 ✓)
构造特征映射:
ϕ ( x 1 ) = ( 1.95 ⋅ u 11 0.73 ⋅ u 12 0.32 ⋅ u 13 ) \phi(x_1) = \begin{pmatrix} \sqrt{1.95} \cdot u_{11} \\ \sqrt{0.73} \cdot u_{12} \\ \sqrt{0.32} \cdot u_{13} \end{pmatrix} ϕ(x1)= 1.95⋅u110.73⋅u120.32⋅u13
则 K ( x 1 , x 2 ) = ϕ ( x 1 ) T ϕ ( x 2 ) = 0.8 K(x_1, x_2) = \phi(x_1)^T \phi(x_2) = 0.8 K(x1,x2)=ϕ(x1)Tϕ(x2)=0.8 自动满足!
这就是 Mercer 定理的构造性证明:从核矩阵反推特征空间。
4.4 定理的证明(充分性)
命题:如果 K ( x , z ) = ⟨ ϕ ( x ) , ϕ ( z ) ⟩ K(x, z) = \langle \phi(x), \phi(z) \rangle K(x,z)=⟨ϕ(x),ϕ(z)⟩,则 K \mathbf{K} K 半正定。
证明:
α T K α = ∑ i = 1 m ∑ j = 1 m α i α j K ( x i , x j ) = ∑ i = 1 m ∑ j = 1 m α i α j ⟨ ϕ ( x i ) , ϕ ( x j ) ⟩ = ⟨ ∑ i = 1 m α i ϕ ( x i ) , ∑ j = 1 m α j ϕ ( x j ) ⟩ = ∥ ∑ i = 1 m α i ϕ ( x i ) ∥ 2 ≥ 0 \begin{aligned} \alpha^T \mathbf{K} \alpha &= \sum_{i=1}^m \sum_{j=1}^m \alpha_i \alpha_j K(x_i, x_j) \\ &= \sum_{i=1}^m \sum_{j=1}^m \alpha_i \alpha_j \langle \phi(x_i), \phi(x_j) \rangle \\ &= \left\langle \sum_{i=1}^m \alpha_i \phi(x_i), \sum_{j=1}^m \alpha_j \phi(x_j) \right\rangle \\ &= \left\| \sum_{i=1}^m \alpha_i \phi(x_i) \right\|^2 \geq 0 \end{aligned} αTKα=i=1∑mj=1∑mαiαjK(xi,xj)=i=1∑mj=1∑mαiαj⟨ϕ(xi),ϕ(xj)⟩=⟨i=1∑mαiϕ(xi),j=1∑mαjϕ(xj)⟩= i=1∑mαiϕ(xi) 2≥0
最后一步使用了范数的非负性。
4.5 定理的证明(必要性)
命题:如果 K \mathbf{K} K 半正定,则存在 ϕ \phi ϕ 使得 K ( x , z ) = ⟨ ϕ ( x ) , ϕ ( z ) ⟩ K(x, z) = \langle \phi(x), \phi(z) \rangle K(x,z)=⟨ϕ(x),ϕ(z)⟩。
证明(构造性):
步骤 1:对 K \mathbf{K} K 进行特征值分解
由于 K \mathbf{K} K 对称半正定:
K = U Λ U T \mathbf{K} = \mathbf{U} \mathbf{\Lambda} \mathbf{U}^T K=UΛUT
其中:
- Λ = diag ( λ 1 , … , λ m ) \mathbf{\Lambda} = \text{diag}(\lambda_1, \ldots, \lambda_m) Λ=diag(λ1,…,λm), λ i ≥ 0 \lambda_i \geq 0 λi≥0
- U = [ u 1 , … , u m ] \mathbf{U} = [u_1, \ldots, u_m] U=[u1,…,um] 是正交矩阵
步骤 2:构造特征映射
定义 ϕ : X → R m \phi: \mathcal{X} \to \mathbb{R}^m ϕ:X→Rm,对于 x i x_i xi:
ϕ ( x i ) = Λ U i , : T = ∑ k = 1 m λ k u i k e k \phi(x_i) = \sqrt{\mathbf{\Lambda}} \mathbf{U}_{i,:}^T = \sum_{k=1}^m \sqrt{\lambda_k} u_{ik} \, e_k ϕ(xi)=ΛUi,:T=k=1∑mλkuikek
其中 e k e_k ek 是标准基向量, U i , : \mathbf{U}_{i,:} Ui,: 是 U \mathbf{U} U 的第 i i i 行。
更直观地写成列向量形式:
ϕ ( x i ) = ( λ 1 u i 1 λ 2 u i 2 ⋮ λ m u i m ) \phi(x_i) = \begin{pmatrix} \sqrt{\lambda_1} u_{i1} \\ \sqrt{\lambda_2} u_{i2} \\ \vdots \\ \sqrt{\lambda_m} u_{im} \end{pmatrix} ϕ(xi)= λ1ui1λ2ui2⋮λmuim
几何直觉:
- U i , : \mathbf{U}_{i,:} Ui,:(第 i i i 行)是 x i x_i xi 在特征向量基下的旋转坐标
- Λ \sqrt{\mathbf{\Lambda}} Λ 对每个坐标轴进行拉伸(拉伸量 = λ k \sqrt{\lambda_k} λk)
- 结果: x i x_i xi 被映射到一个 m m m 维空间,使得点之间的内积恰好等于原始核值
这正是**主成分分析(PCA)**的几何:特征值 = 方差,特征向量 = 主方向。
步骤 3:验证内积
⟨ ϕ ( x i ) , ϕ ( x j ) ⟩ = ∑ k = 1 m ( λ k u i k ) ( λ k u j k ) = ∑ k = 1 m λ k u i k u j k = ( U Λ U T ) i j = K i j = K ( x i , x j ) \begin{aligned} \langle \phi(x_i), \phi(x_j) \rangle &= \sum_{k=1}^m (\sqrt{\lambda_k} u_{ik})(\sqrt{\lambda_k} u_{jk}) \\ &= \sum_{k=1}^m \lambda_k u_{ik} u_{jk} \\ &= (\mathbf{U} \mathbf{\Lambda} \mathbf{U}^T)_{ij} \\ &= \mathbf{K}_{ij} = K(x_i, x_j) \end{aligned} ⟨ϕ(xi),ϕ(xj)⟩=k=1∑m(λkuik)(λkujk)=k=1∑mλkuikujk=(UΛUT)ij=Kij=K(xi,xj)
证毕。
可视化建议:
Mercer 定理的核心可以用以下流程图表示:
核矩阵 K (m×m)
    ↓
特征分解 K = UΛU^T
    ↓
构造特征映射 φ(xᵢ) = √Λ Uᵢ,:^T
    ↓
验证内积 ⟨φ(xᵢ), φ(xⱼ)⟩ = Kᵢⱼ ✓
这个过程展示了如何从"观测到的相似度矩阵 K \mathbf{K} K“逆向工程出"隐藏的特征空间坐标 ϕ ( x ) \phi(x) ϕ(x)”。
4.6 核函数的组合性质
定理:如果 K 1 , K 2 K_1, K_2 K1,K2 是核函数,则以下也是核函数:
- 线性组合: K ( x , z ) = α K 1 ( x , z ) + β K 2 ( x , z ) K(x,z) = \alpha K_1(x,z) + \beta K_2(x,z) K(x,z)=αK1(x,z)+βK2(x,z),其中 α , β ≥ 0 \alpha, \beta \geq 0 α,β≥0
- 乘积: K ( x , z ) = K 1 ( x , z ) ⋅ K 2 ( x , z ) K(x,z) = K_1(x,z) \cdot K_2(x,z) K(x,z)=K1(x,z)⋅K2(x,z)
- 函数复合: K ( x , z ) = f ( x ) K 1 ( x , z ) f ( z ) K(x,z) = f(x) K_1(x,z) f(z) K(x,z)=f(x)K1(x,z)f(z),其中 f f f 是任意函数
- 指数: K ( x , z ) = exp ( K 1 ( x , z ) ) K(x,z) = \exp(K_1(x,z)) K(x,z)=exp(K1(x,z))(如果 K 1 K_1 K1 有界)
- 多项式: K ( x , z ) = p ( K 1 ( x , z ) ) K(x,z) = p(K_1(x,z)) K(x,z)=p(K1(x,z)),其中 p p p 是非负系数多项式
证明(乘积):
设 K 1 ( x , z ) = ⟨ ϕ 1 ( x ) , ϕ 1 ( z ) ⟩ K_1(x,z) = \langle \phi_1(x), \phi_1(z) \rangle K1(x,z)=⟨ϕ1(x),ϕ1(z)⟩, K 2 ( x , z ) = ⟨ ϕ 2 ( x ) , ϕ 2 ( z ) ⟩ K_2(x,z) = \langle \phi_2(x), \phi_2(z) \rangle K2(x,z)=⟨ϕ2(x),ϕ2(z)⟩。
设 ϕ 1 ( x ) ∈ R d 1 \phi_1(x) \in \mathbb{R}^{d_1} ϕ1(x)∈Rd1, ϕ 2 ( x ) ∈ R d 2 \phi_2(x) \in \mathbb{R}^{d_2} ϕ2(x)∈Rd2。
定义 ϕ ( x ) = ϕ 1 ( x ) ⊗ ϕ 2 ( x ) \phi(x) = \phi_1(x) \otimes \phi_2(x) ϕ(x)=ϕ1(x)⊗ϕ2(x) (张量积),即:
ϕ ( x ) = ( ϕ 1 ( 1 ) ( x ) ϕ 2 ( 1 ) ( x ) ϕ 1 ( 1 ) ( x ) ϕ 2 ( 2 ) ( x ) ⋮ ϕ 1 ( i ) ( x ) ϕ 2 ( j ) ( x ) ⋮ ϕ 1 ( d 1 ) ( x ) ϕ 2 ( d 2 ) ( x ) ) ∈ R d 1 × d 2 \phi(x) = \begin{pmatrix} \phi_1^{(1)}(x) \phi_2^{(1)}(x) \\ \phi_1^{(1)}(x) \phi_2^{(2)}(x) \\ \vdots \\ \phi_1^{(i)}(x) \phi_2^{(j)}(x) \\ \vdots \\ \phi_1^{(d_1)}(x) \phi_2^{(d_2)}(x) \end{pmatrix} \in \mathbb{R}^{d_1 \times d_2} ϕ(x)= ϕ1(1)(x)ϕ2(1)(x)ϕ1(1)(x)ϕ2(2)(x)⋮ϕ1(i)(x)ϕ2(j)(x)⋮ϕ1(d1)(x)ϕ2(d2)(x) ∈Rd1×d2
则:
⟨ ϕ ( x ) , ϕ ( z ) ⟩ = ∑ i = 1 d 1 ∑ j = 1 d 2 ϕ 1 ( i ) ( x ) ϕ 2 ( j ) ( x ) ϕ 1 ( i ) ( z ) ϕ 2 ( j ) ( z ) = ( ∑ i = 1 d 1 ϕ 1 ( i ) ( x ) ϕ 1 ( i ) ( z ) ) ( ∑ j = 1 d 2 ϕ 2 ( j ) ( x ) ϕ 2 ( j ) ( z ) ) = K 1 ( x , z ) ⋅ K 2 ( x , z ) \begin{aligned} \langle \phi(x), \phi(z) \rangle &= \sum_{i=1}^{d_1} \sum_{j=1}^{d_2} \phi_1^{(i)}(x) \phi_2^{(j)}(x) \phi_1^{(i)}(z) \phi_2^{(j)}(z) \\ &= \left(\sum_{i=1}^{d_1} \phi_1^{(i)}(x) \phi_1^{(i)}(z)\right) \left(\sum_{j=1}^{d_2} \phi_2^{(j)}(x) \phi_2^{(j)}(z)\right) \\ &= K_1(x,z) \cdot K_2(x,z) \end{aligned} ⟨ϕ(x),ϕ(z)⟩=i=1∑d1j=1∑d2ϕ1(i)(x)ϕ2(j)(x)ϕ1(i)(z)ϕ2(j)(z)=(i=1∑d1ϕ1(i)(x)ϕ1(i)(z))(j=1∑d2ϕ2(j)(x)ϕ2(j)(z))=K1(x,z)⋅K2(x,z)
证毕。
更多推荐

 11
 0
- 0


 已为社区贡献10条内容

所有评论(0)