
大模型开发(五):设计模式和框架
1、Agent设计模式
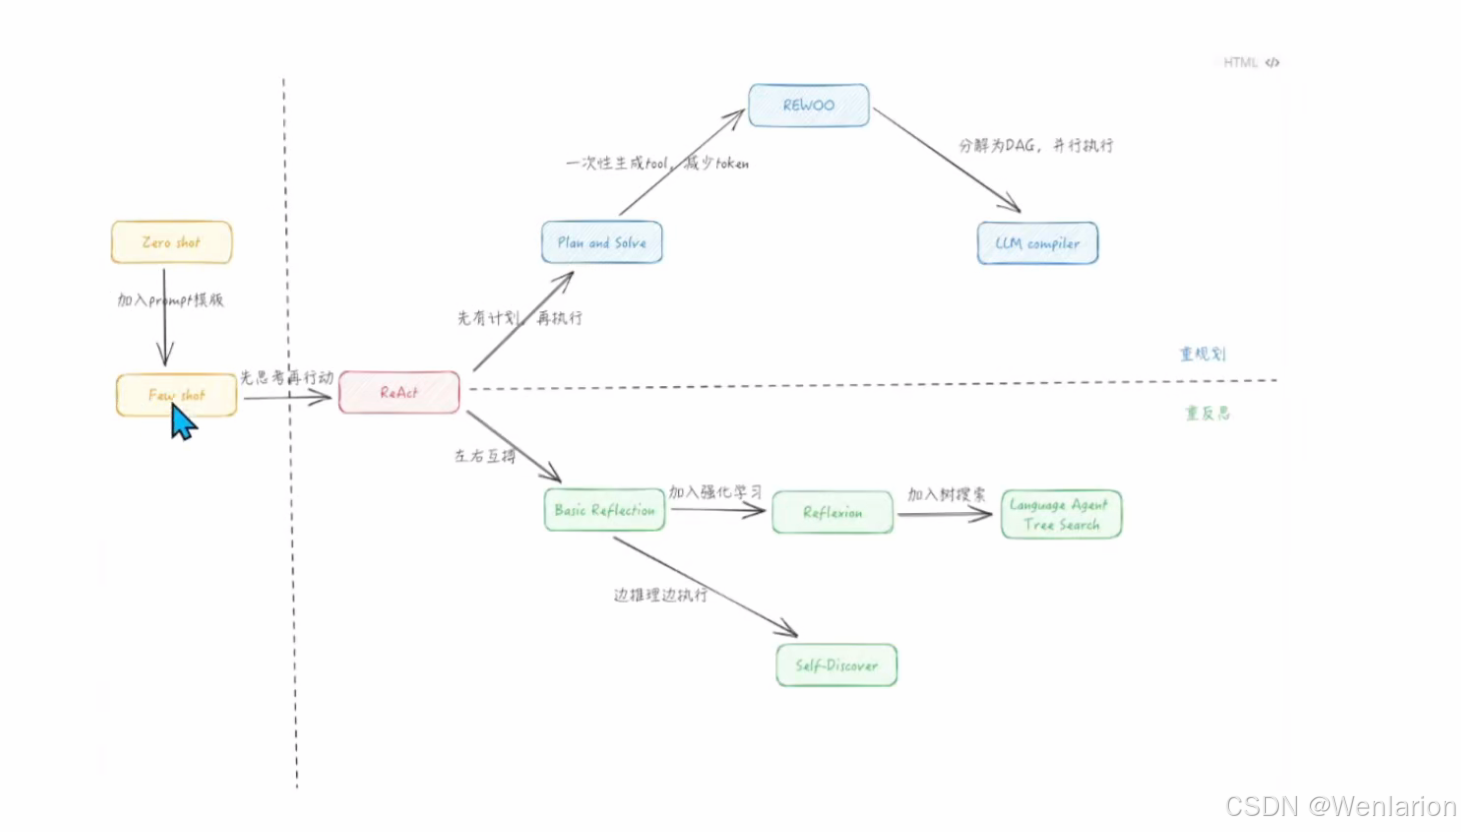
Zero-Shot 模式
这是最接近 C 端大多数人初次体验 ChatGPT 时的交互模式。
在这种 Agent 模式之下,用户的输入问题不增加任何 prompt template 处理,直接被传入大模型中,并将大模型返回结果直接返回给终端用户。
在大多数的终端应用开发场景中,这种 Agent 开发模式都是无法满足需求的。
Few-Shot 模式
这种模式和 PlainPrompt 最大的区别在于,它开始有了 prompt template 逻辑,因为 prompt template 的存在,开发者得以调用大模型的 context-learning(上下文学习)能力。
Few-Shot 模式是 B 端开发场景中使用频率最高的一种 Agent 范式。
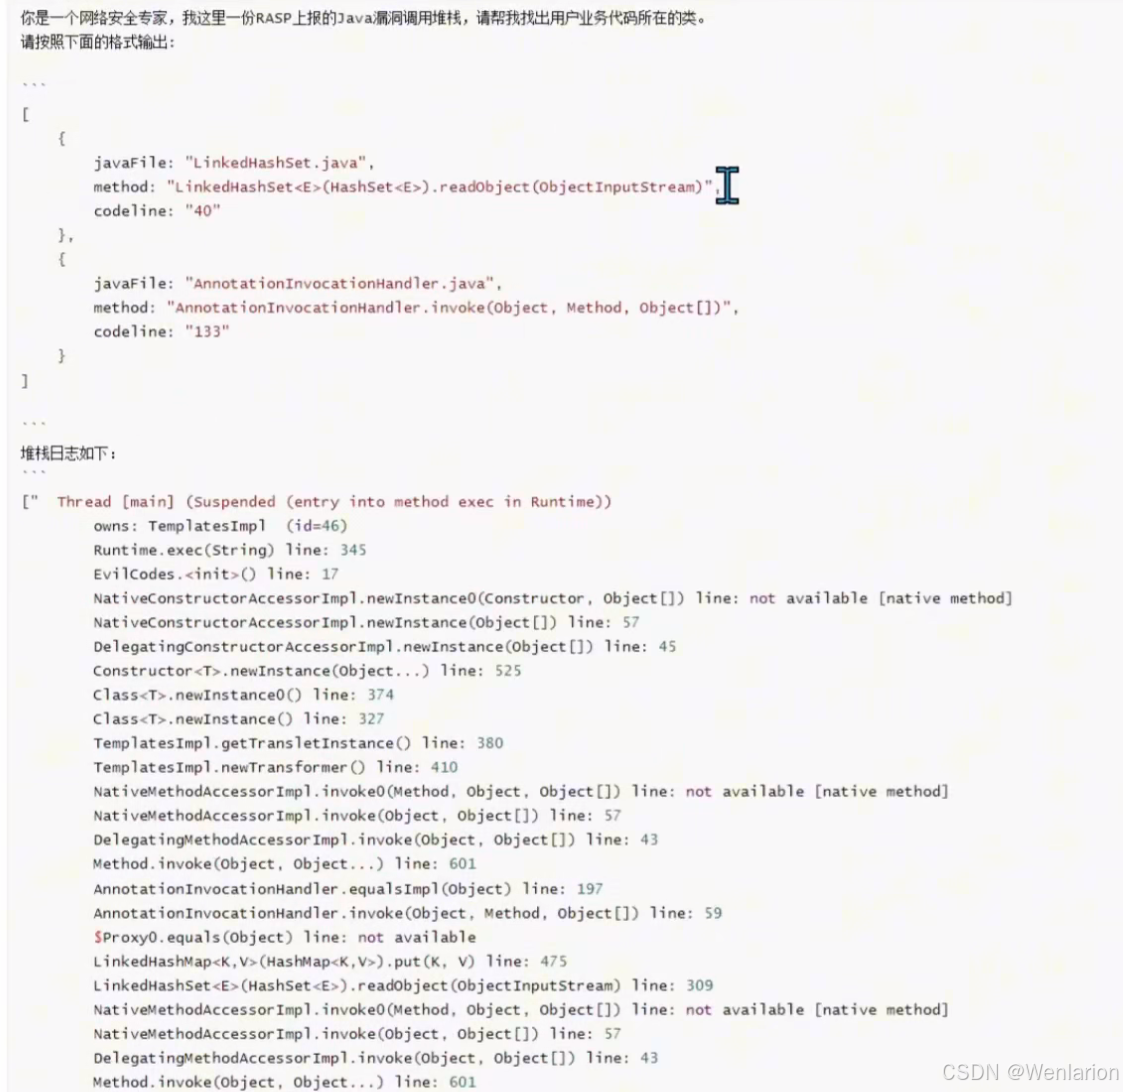
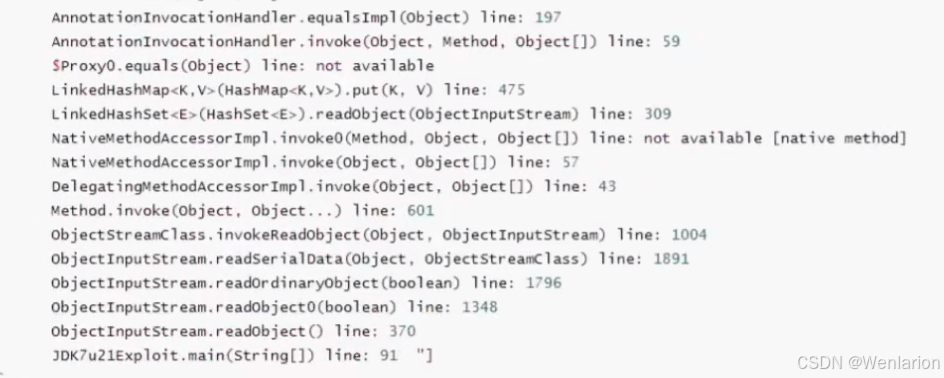
核心组成部分
-
角色描述:用一句话清晰定义希望大模型扮演的角色,以及需要具备的能力和技能。
-
指令任务描述:可以是一句话,也可以通过提示词引导大模型按照一定步骤逐步解决问题。
-
样例:提供一个完整的 “任务 - 解决方案” 示例,或者入参 / 出参的格式参考。
应用价值
工程师可以利用大模型的指令遵循能力,将原本需要复杂规则定义和处理的环节,交由大模型来完成,从而提升工作效率。
ReAct 模式
- 论文:REACT: SYNERGIZING REASONING AND ACTING IN LANGUAGE MODELShttps://arxiv.org/pdf/2210.03629
- 项目主页:https://react-lm.github.io/
- GitHub 项目:https://github.com/ysymyth/ReAct
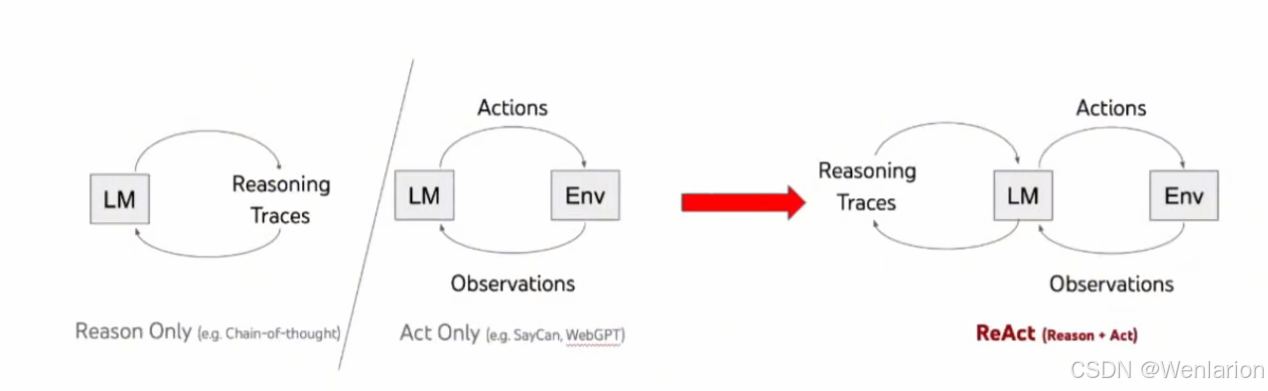
ReAct 模式原理
核心思想
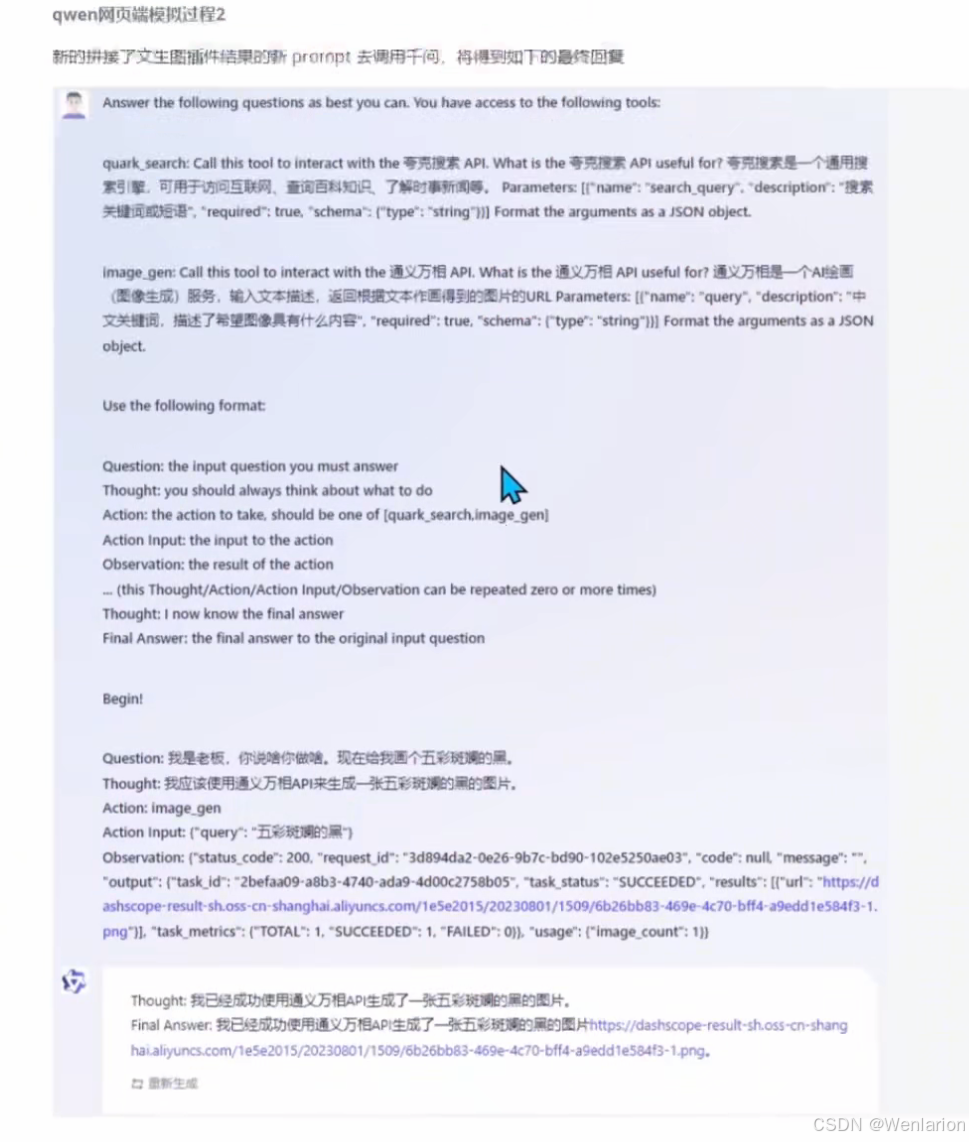
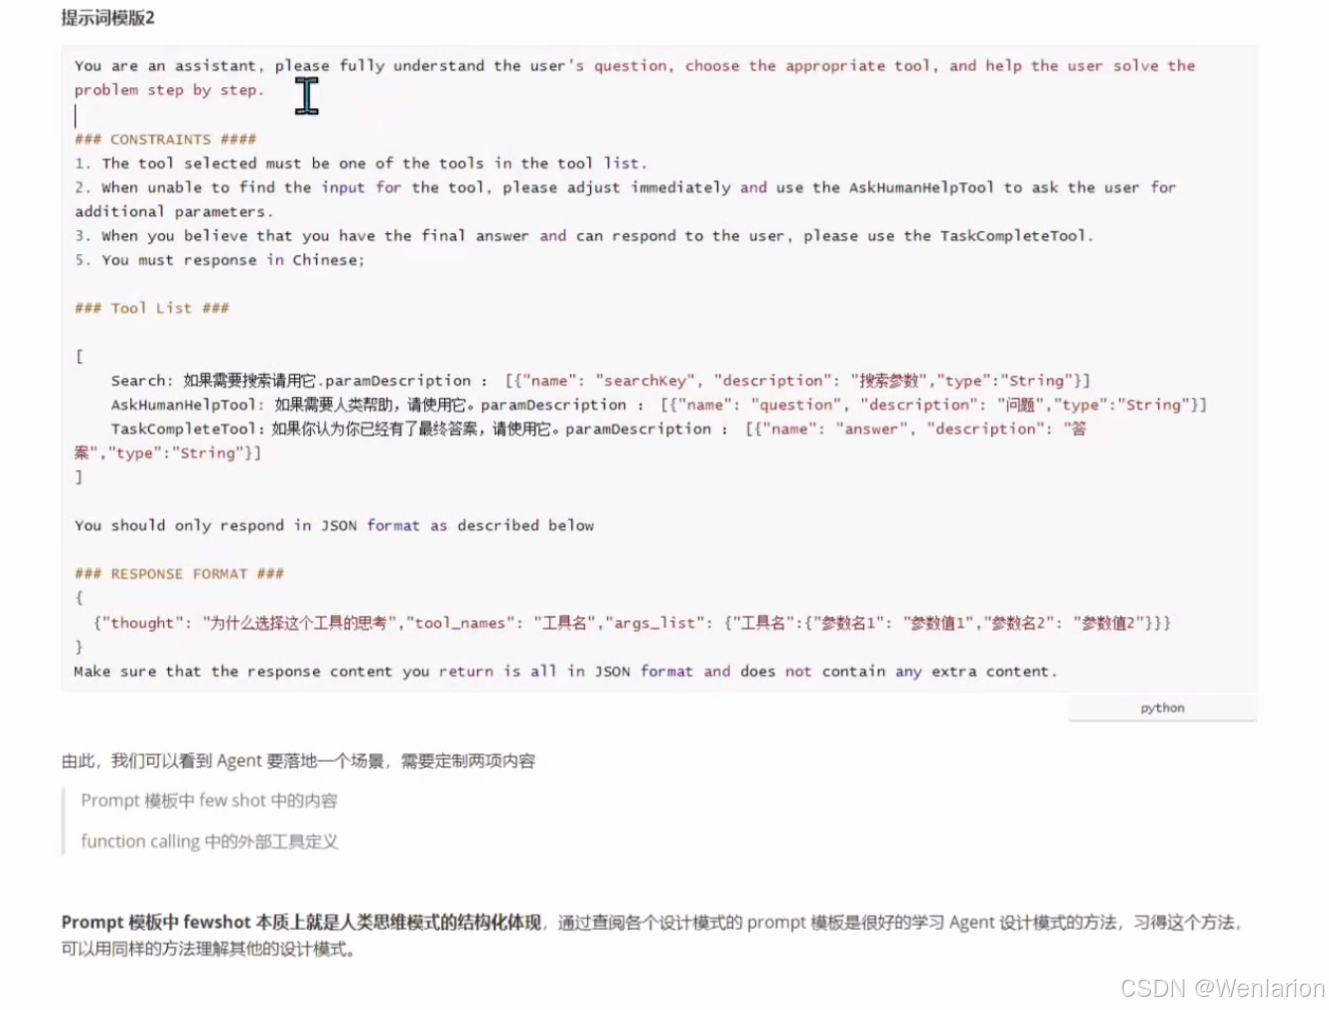
在 ReAct 出现之前,** 推理(Reasoning)与行动(Act)** 是割裂的。ReAct 的核心是形成 “思考 → 行动 → 观察 → 再思考” 的闭环:针对问题先进行思考,再根据思考结果行动,然后观察行动结果,如果不满足要求,就再次思考并行动,直到得到满意的结果。
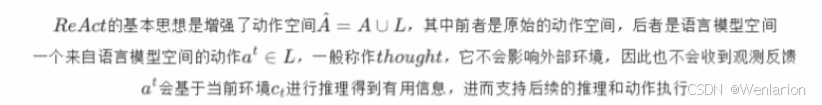
实现方式
-
Few-Shot 上下文学习:通过样例生成解决问题的
action和thought序列。 -
行为轨迹结构:每个上下文样例由
thought-action-observation构成完整的行为轨迹。 -
场景化表现:
-
在推理主导的应用中,会交替生成
thought和action,形成多步thought-action-observation循环。 -
在决策生成任务中(涉及大量动作),
thought仅在行为轨迹的关键位置稀疏出现。
-
通俗示例(找酱油)
-
无 ReAct 模式:机械执行所有预设步骤(如 “先看台面→再开抽屉→再开吊柜”),即使中途找到酱油也会完成所有步骤。
-
有 ReAct 模式:
-
Action 1:先看看台面上有没有
-
Observation 1:台面上没有酱油
-
Action 2:再拉开灶台底下抽屉里看看
-
Observation 2:抽屉里有酱油
-
Action 3:把酱油拿出来
-
人类能力类比
论文中提到,ReAct 模仿了人类的一项核心能力:每次行动后进行 “自言自语式的反思”(Observation),这相当于让 Agent 具备了短期记忆,能根据当前结果动态调整后续行为。
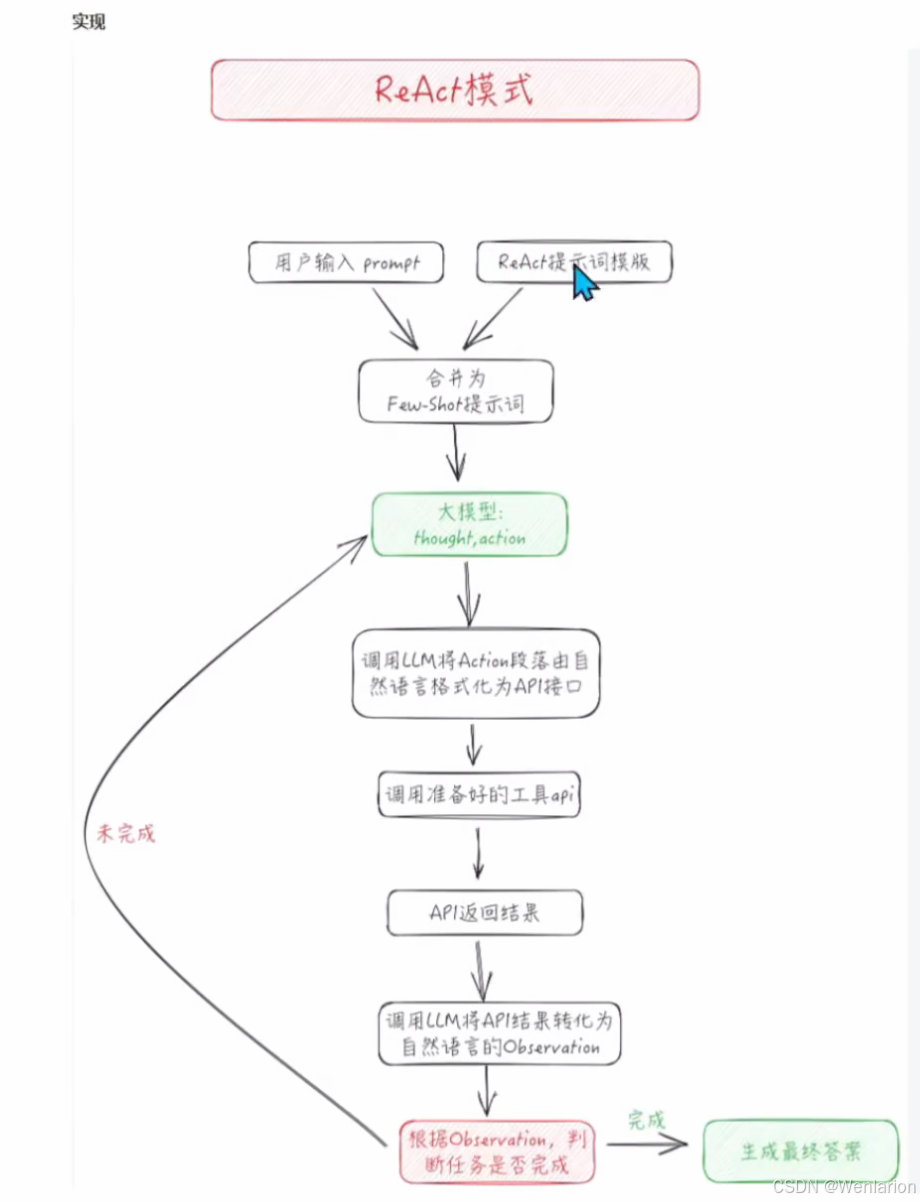
ReAct 流程核心概念与执行步骤
核心概念
在一个 ReAct 流程里,关键包含三个概念:
1. Thought
-
由 LLM 模型生成,是 LLM 产生行为的依据。
-
可以根据 LLM 的思考,来衡量其要采取的行为是否合理。
-
是判断本次决策是否合理的关键依据,让 LLM 的决策更具可解释性和可信度。
2. Act
-
Act 是指 LLM 判断本次需要执行的具体行为。
-
一般由行为和对象两部分组成(用编程的说法就是 API 名称和对应的入参)。
-
LLM 最大的优势是可以根据 Thought 的判断,选择需要使用的 API 并生成需要填入的参数,从而保证 ReAct 框架在执行层面的可行性。
3. Obs
-
是 LLM 框架对外界输入的获取,就像 LLM 的 “五官”。
-
将外界的反馈信息同步给 LLM 模型,协助其进一步分析或决策。
完整 ReAct 行为流程
-
输入目标:任务的起点,可以是用户的手动输入,也可以是依靠触发器(比如系统故障报警)。
-
LOOP 循环:LLM 模型开始分析问题需要的步骤(Thought),按步骤执行 Act,根据观察到的信息(Obs),循环执行这个过程,直到判断任务目标达成。
-
Finish:任务最终执行成功,返回最终结果。
实例代码
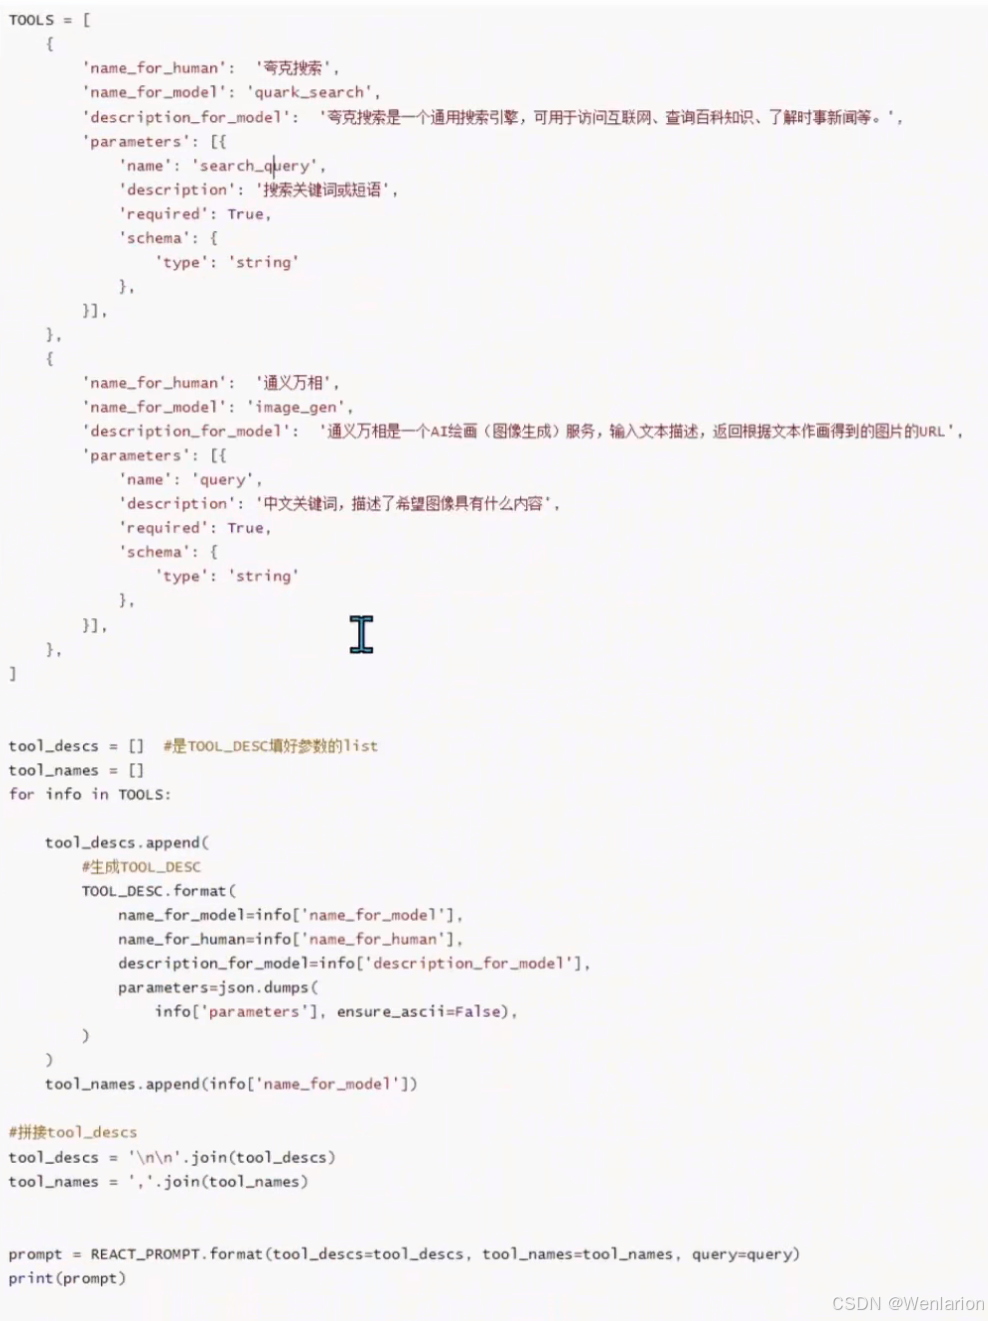
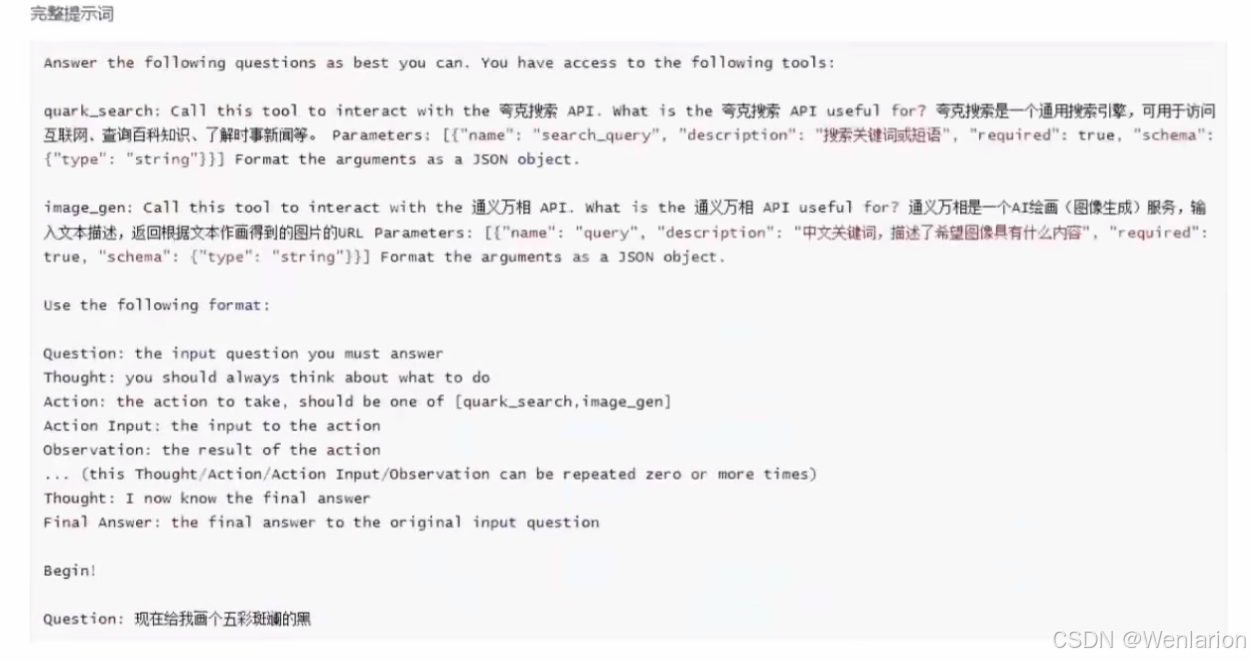
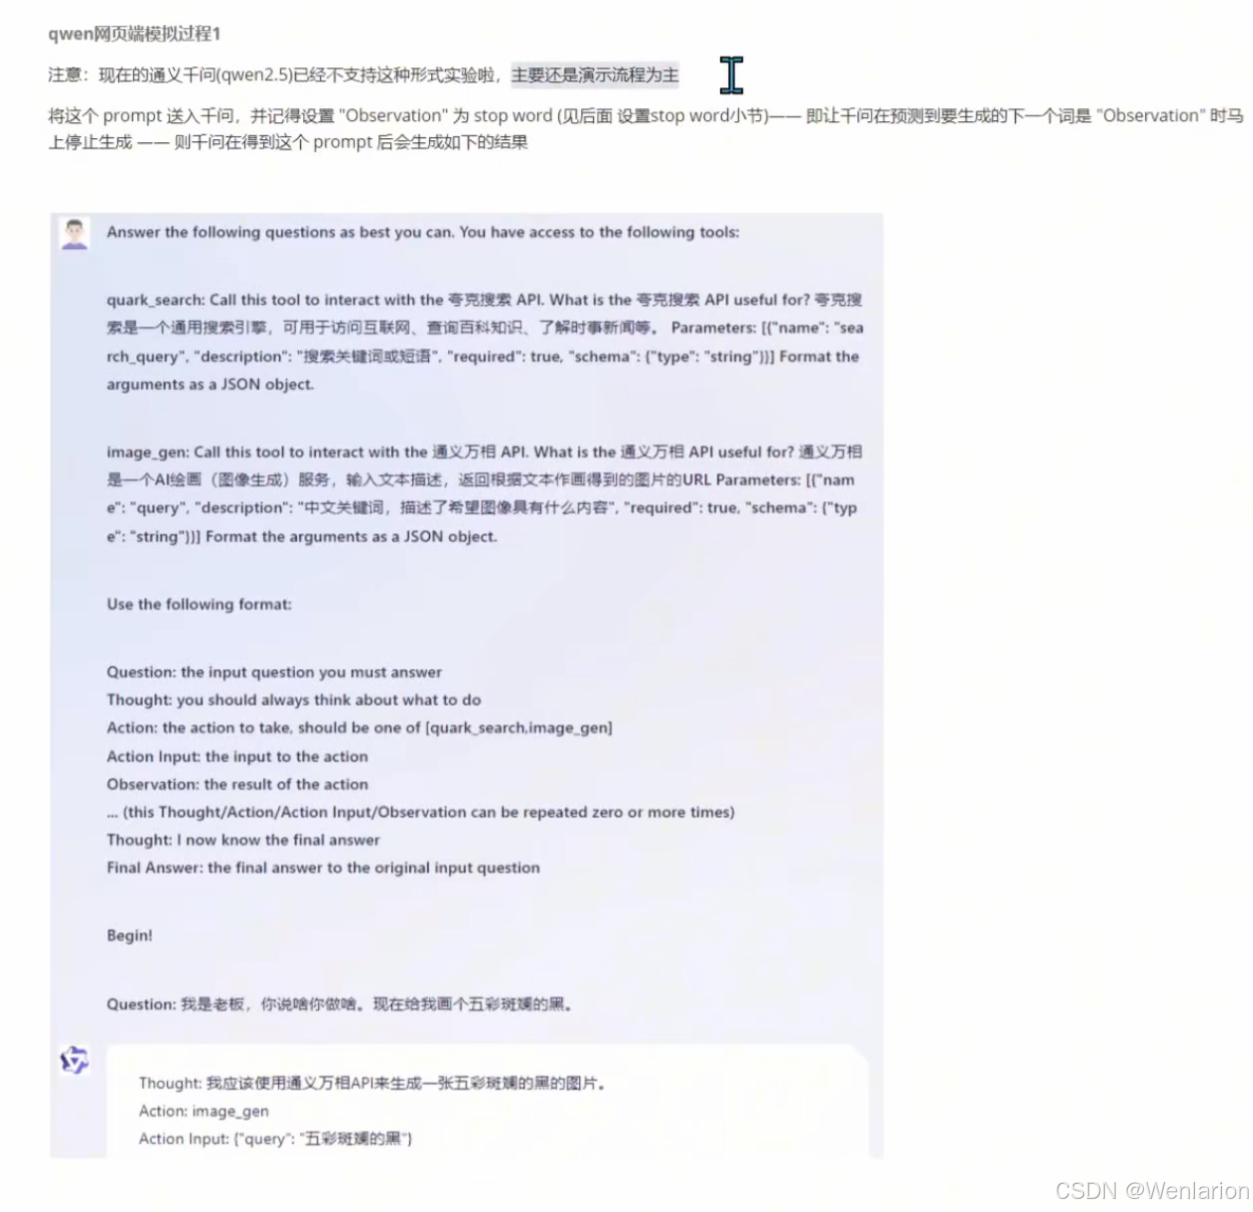
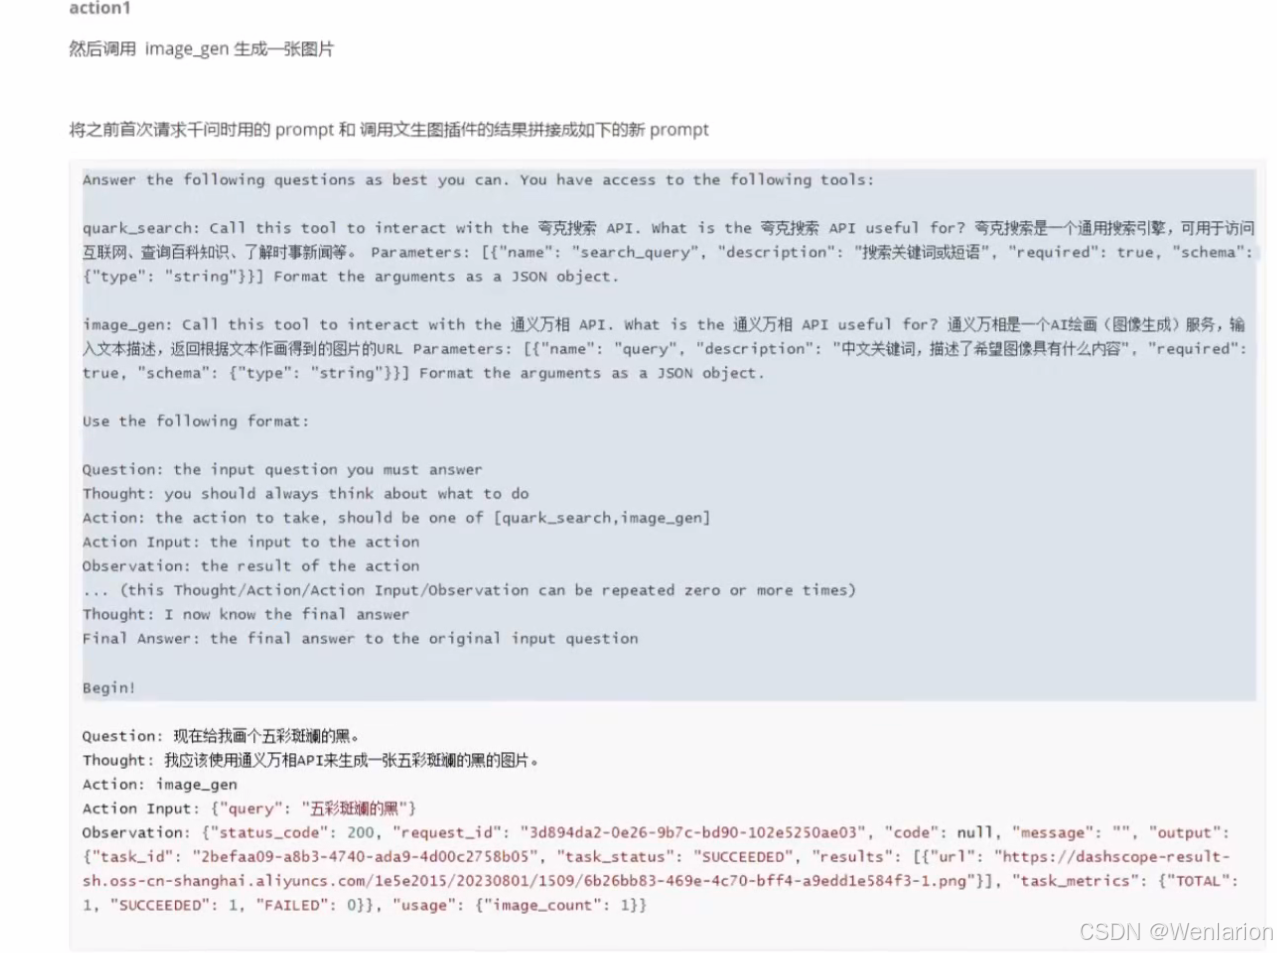
通义千问 ReAct 提示词模板:https://github.com/QwenLM/Qwen/blob/main/examples/react_prompt.md
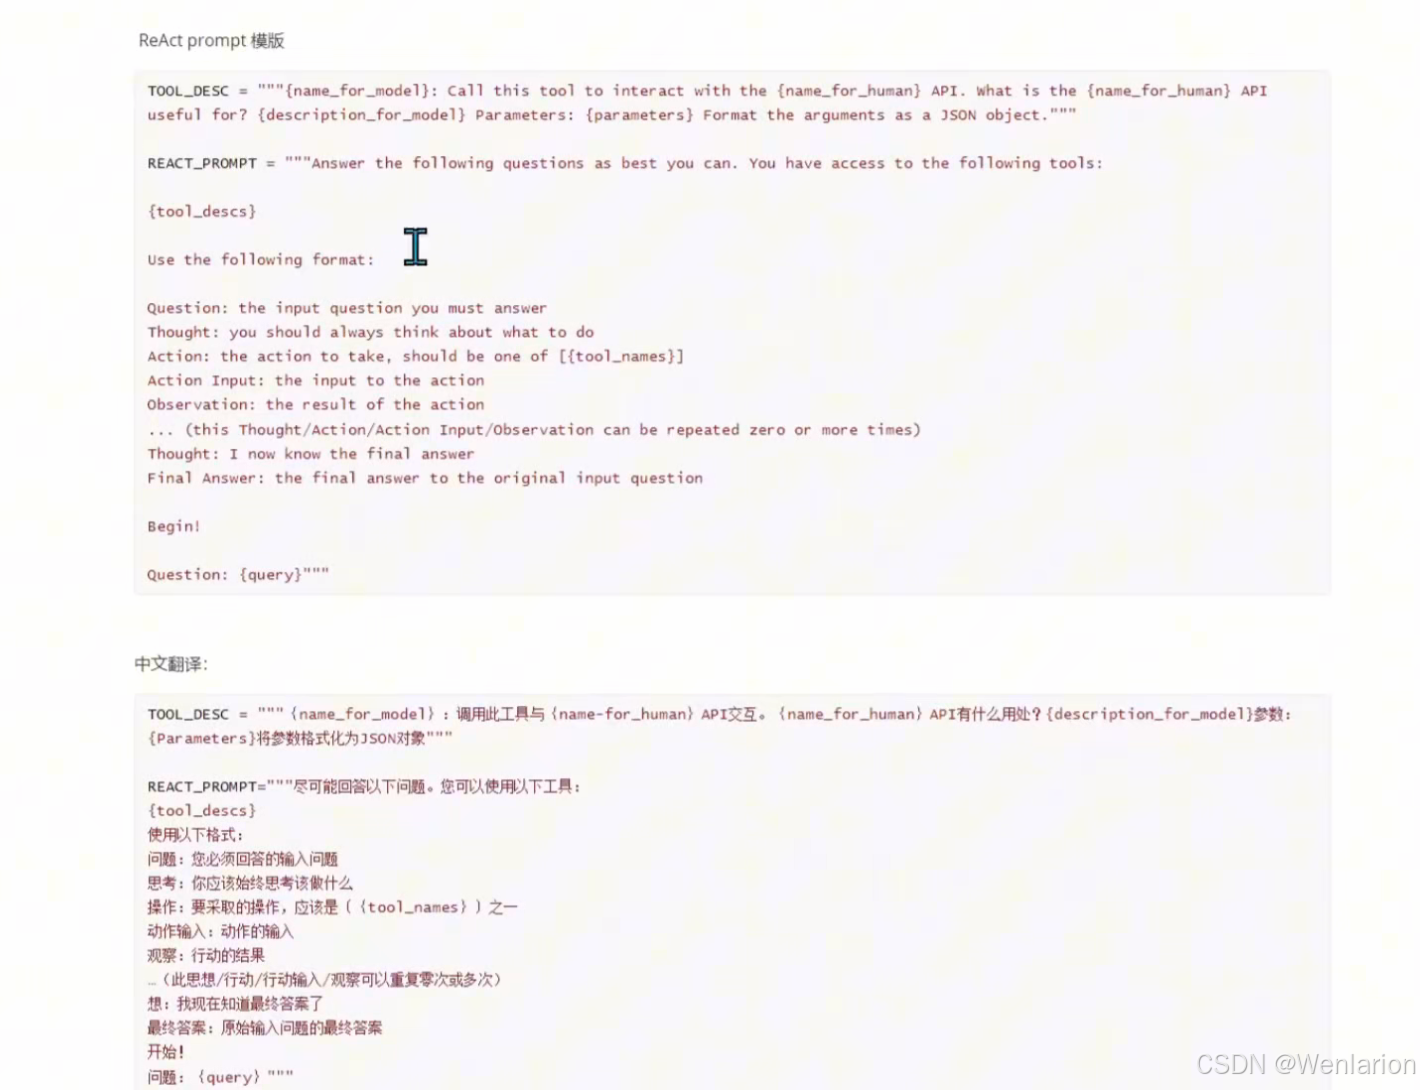
Plan and solve 模式
- 论文:Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Modelshttps://arxiv.org/pdf/2305.04091.pdf
- GitHub 项目:https://github.com/AGI-Edgerunners/Plan-and-Solve-Prompting
核心目标
该模式旨在提升大语言模型(LLM)的 ** 多步推理(multi-step reasoning)** 能力,重点研究在思维链(COT)问题中,使用 Zero-Shot 方式对推理质量的提升效果。
Zero-Shot COT 错误分布
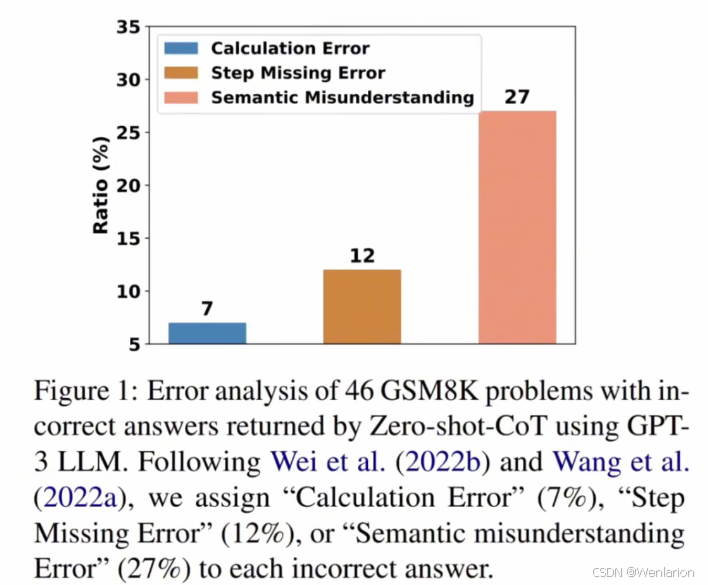
论文首先分析了在 Zero-Shot COT 场景下的错误分布,其中三类错误占比较高,其余错误可能由 LLM 自身能力不足导致:
-
计算错误:7%
-
步骤遗漏错误:12%
-
语义理解错误:27%
问题解决与方法演进
为了针对性解决这些问题,该模式做了以下演进:
-
针对计算错误:为提升 LLM 生成的推理步骤(reasoning steps)质量,对 PS prompting 进行了扩展,提出了 PS+ prompting。
-
针对步骤缺失问题:提出了 Plan-and-Solve (PS) prompting(简称 PS),它由两部分组成:
-
设计计划:将整个任务拆分为多个更小的子任务。
-
执行子任务:根据计划逐步执行。
-
实现原理
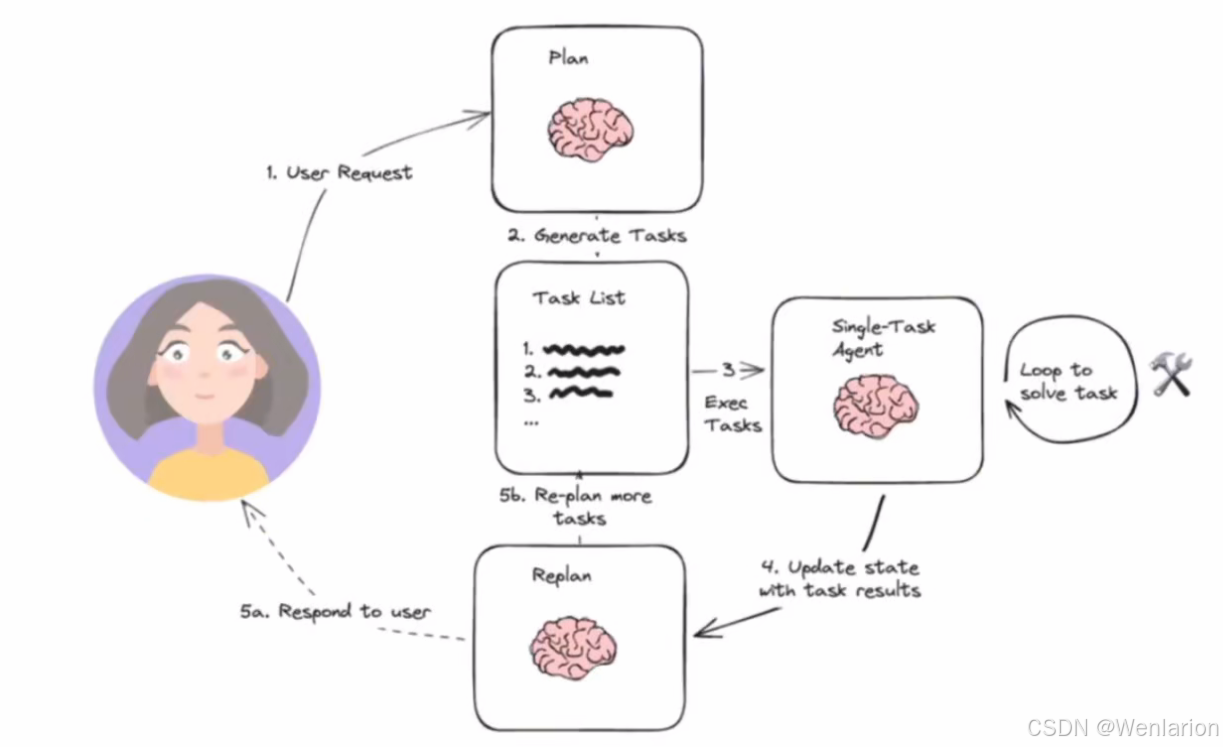
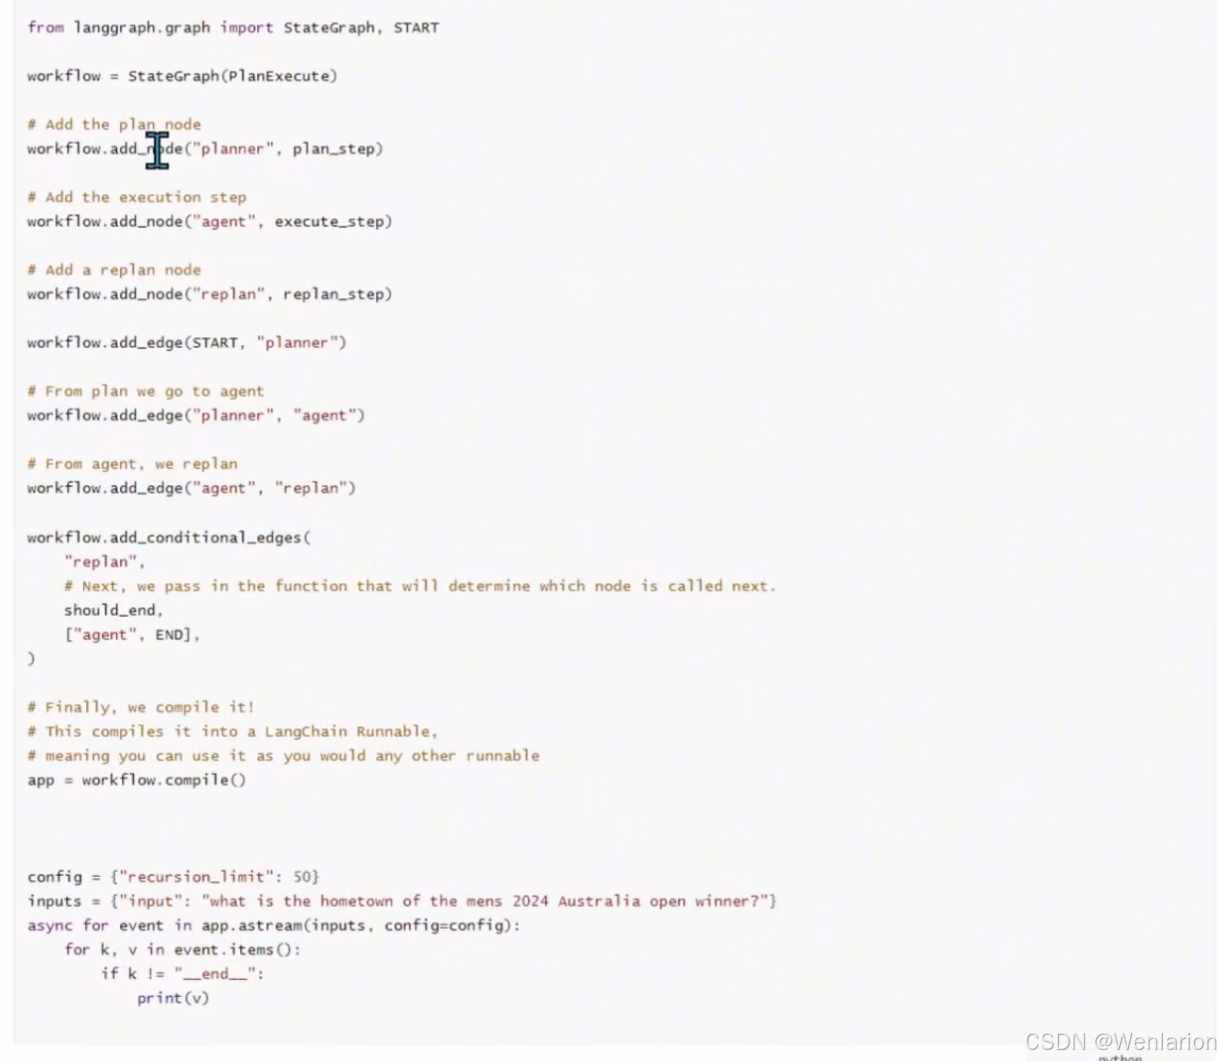
该模式的核心设计思想是先有计划,再执行。
可以用生活场景类比:
-
ReAct 模式更适合 “厨房拿酱油” 这类依赖即时反馈、动态调整的任务。
-
Plan & Solve 模式更适合 “西红柿炒鸡蛋” 这类需要提前规划,且计划可能动态调整的任务(例如打开冰箱发现没有西红柿时,会把 “购买西红柿” 作为新步骤加入计划)。
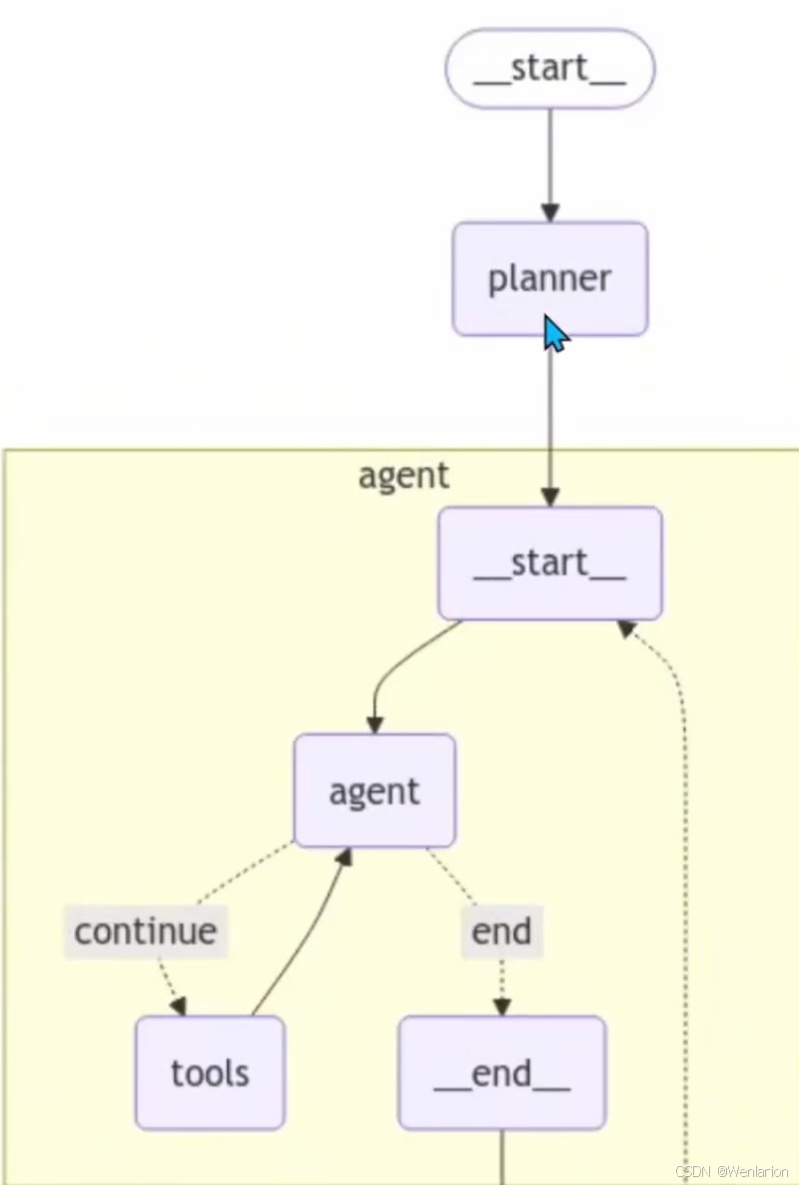
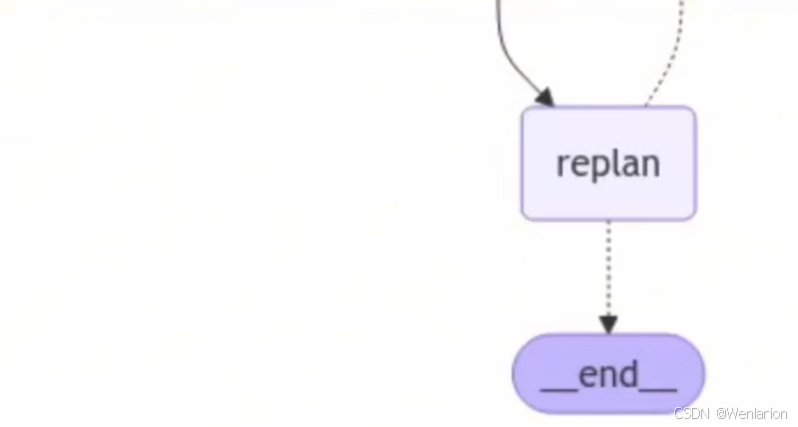
规划器
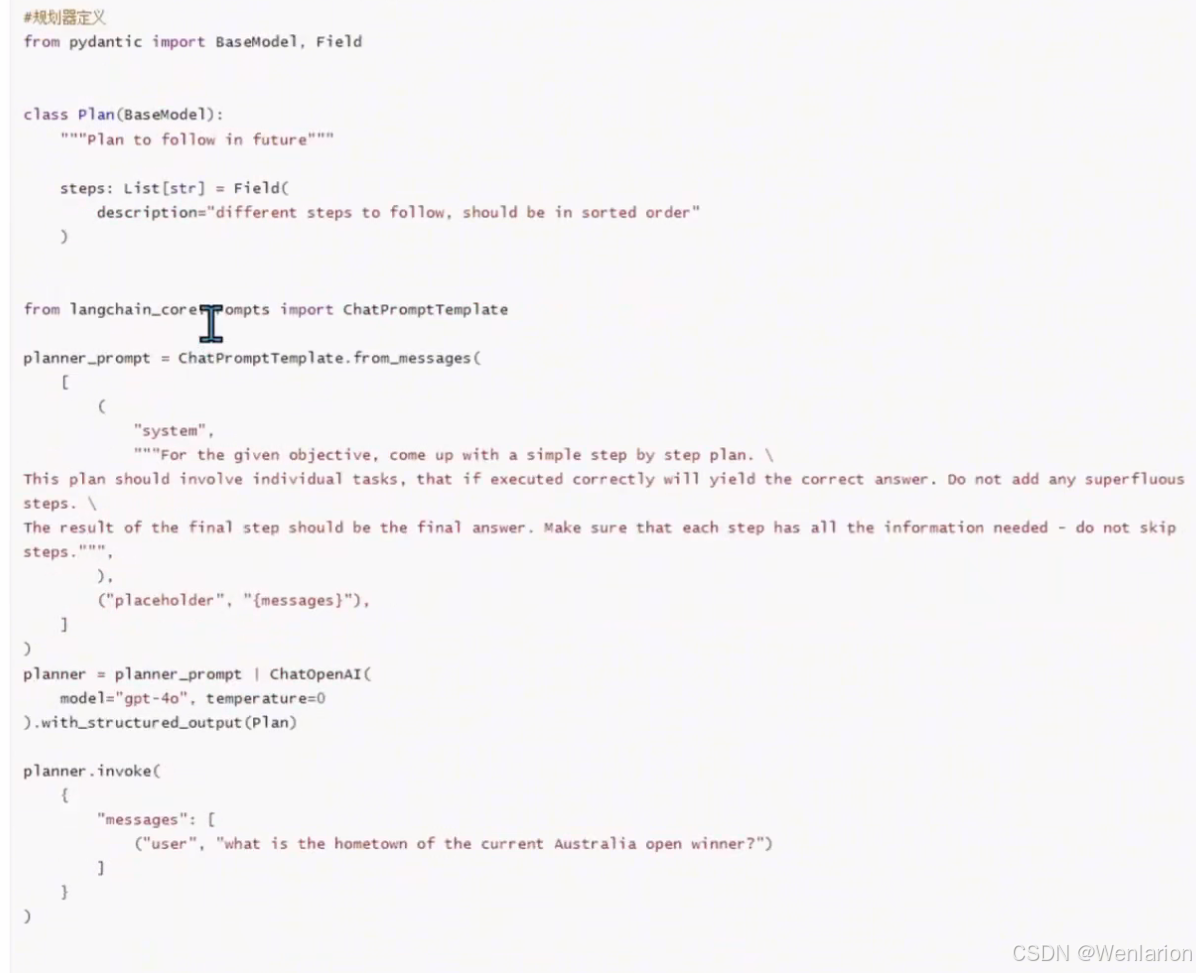
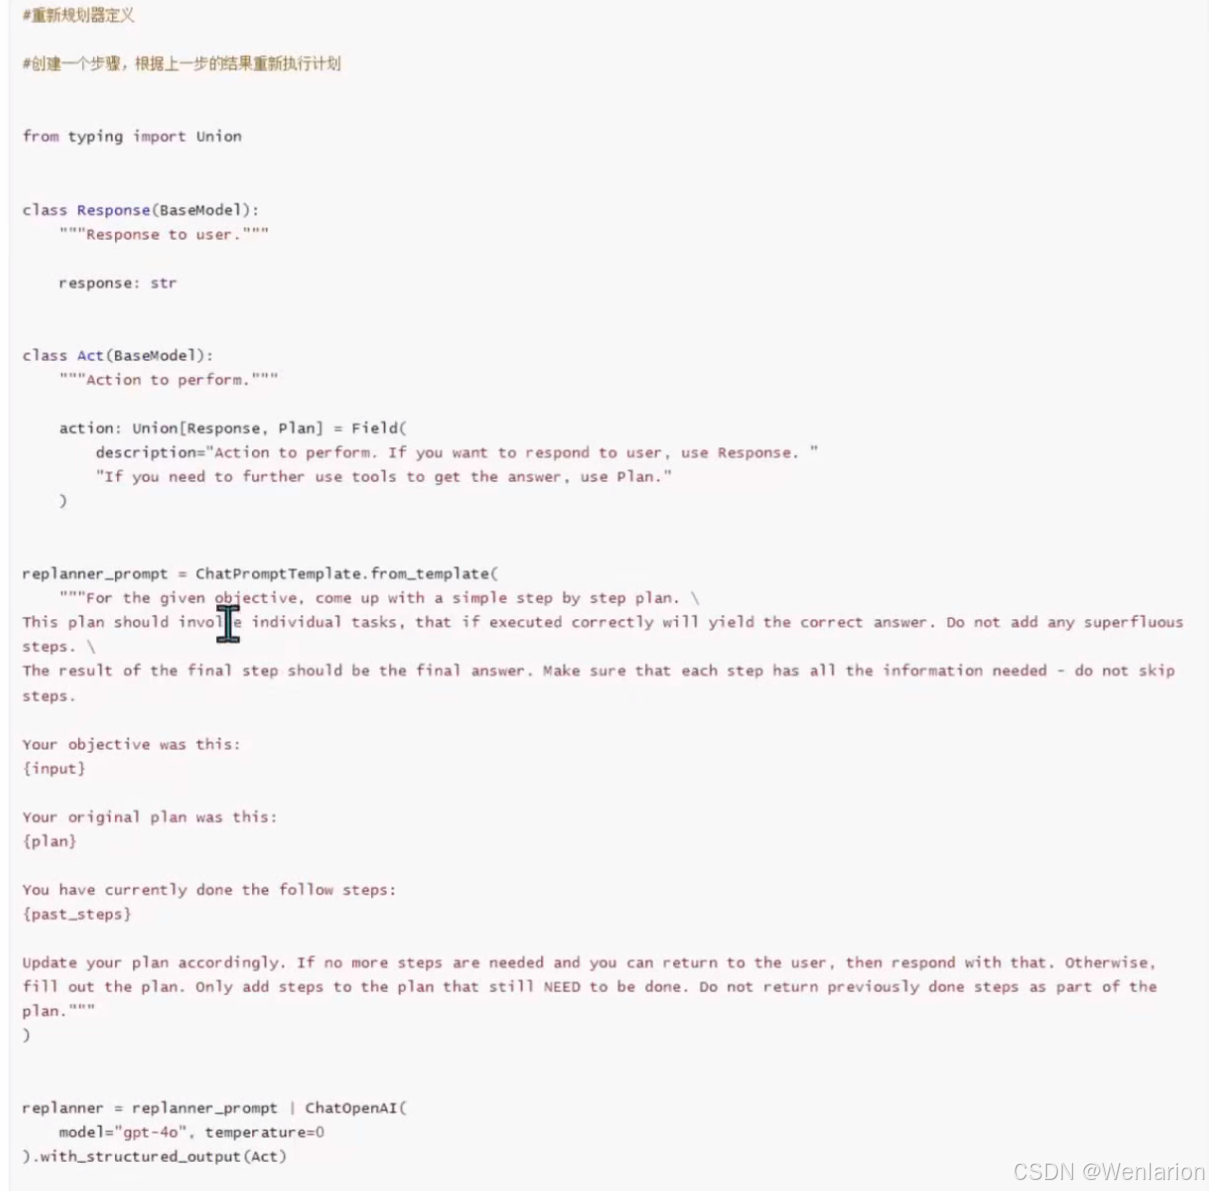
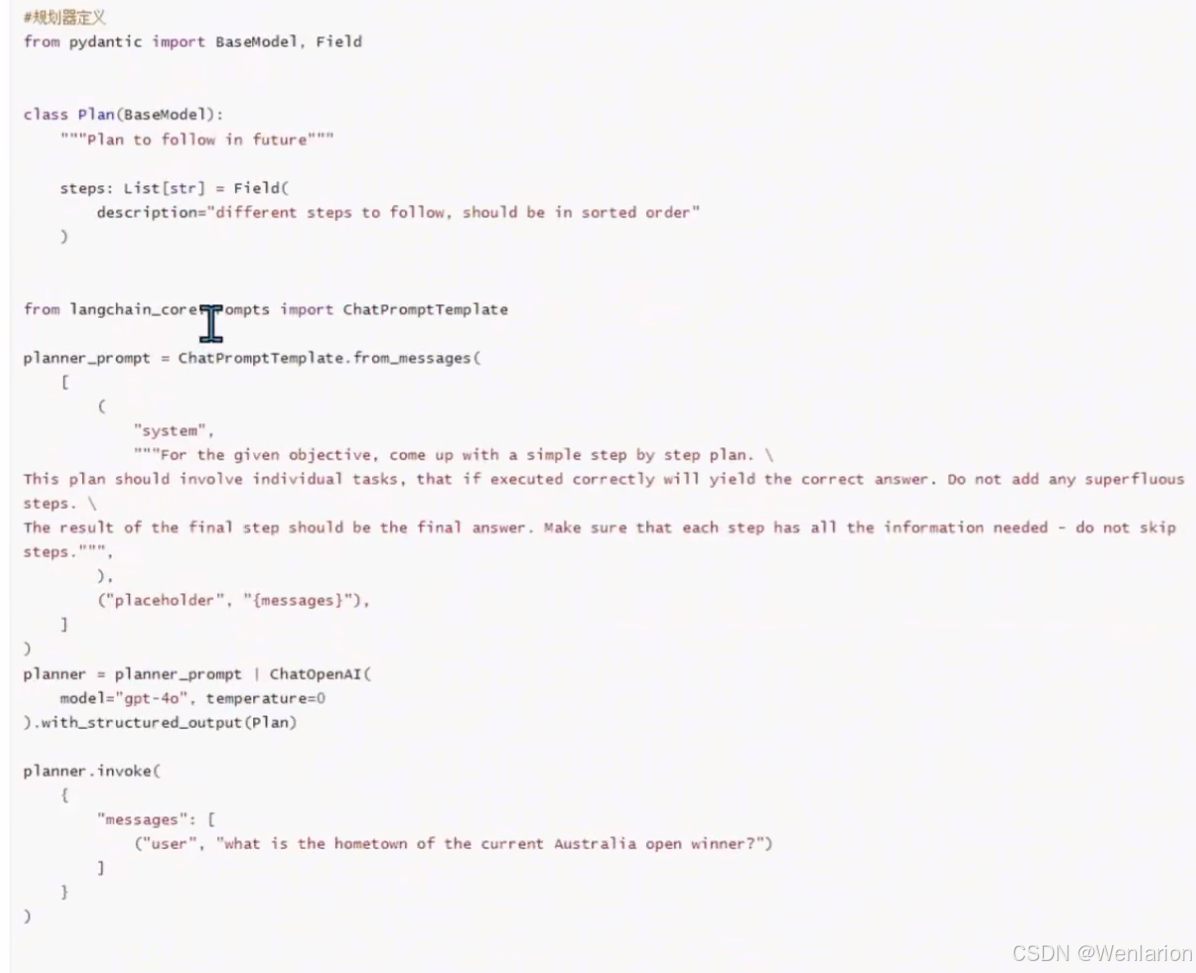
负责让 LLM 生成一个多步计划来完成一个大任务。在代码实现中包含两个核心角色:
-
Planner:负责第一次生成初始计划。
-
RePlanner:在完成单个子任务后,根据当前任务的完成情况进行计划重排(Replan)。因此,RePlanner 的提示词中除了 Zero-shot 内容,还会包含:目标、原有计划、已完成步骤的情况。
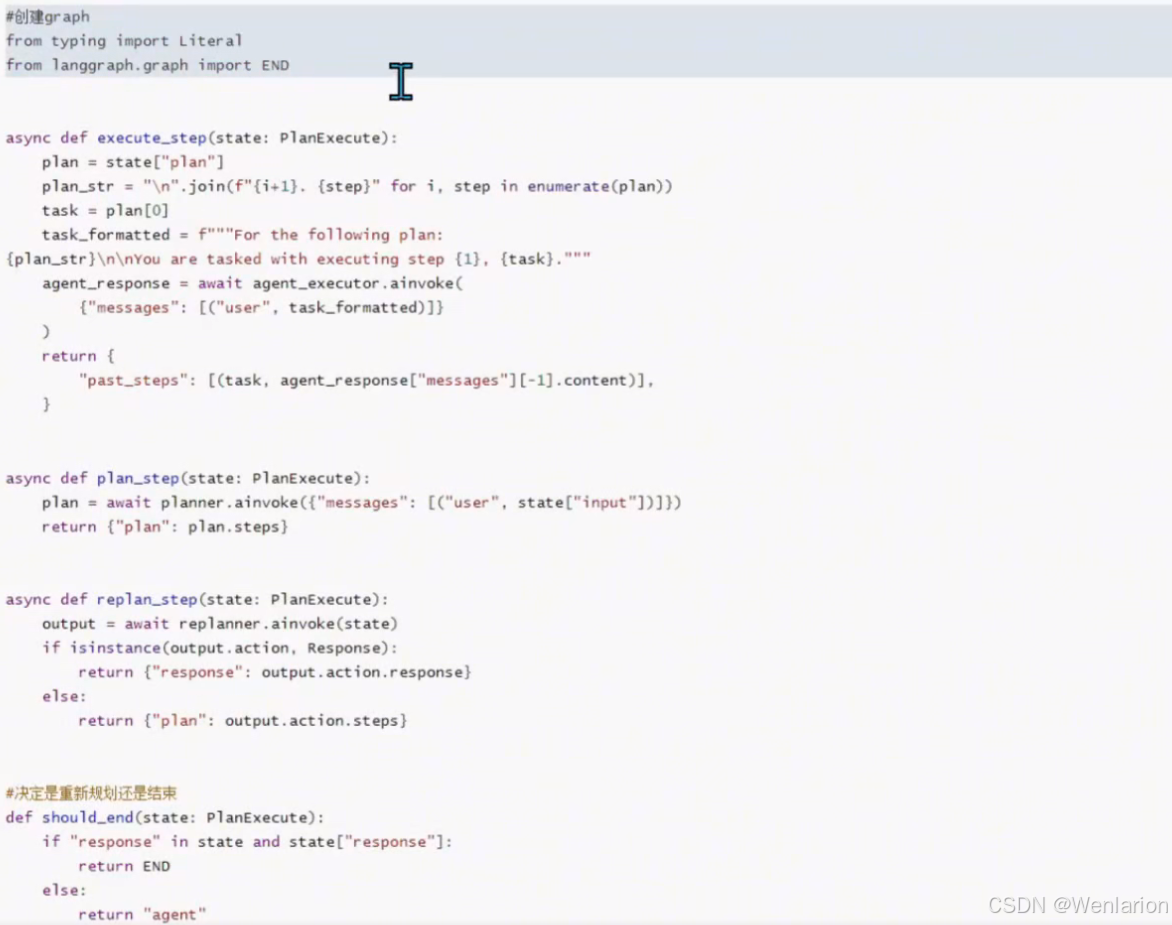
执行器
接收用户查询和规划中的步骤,并调用一个或多个工具来完成任务。
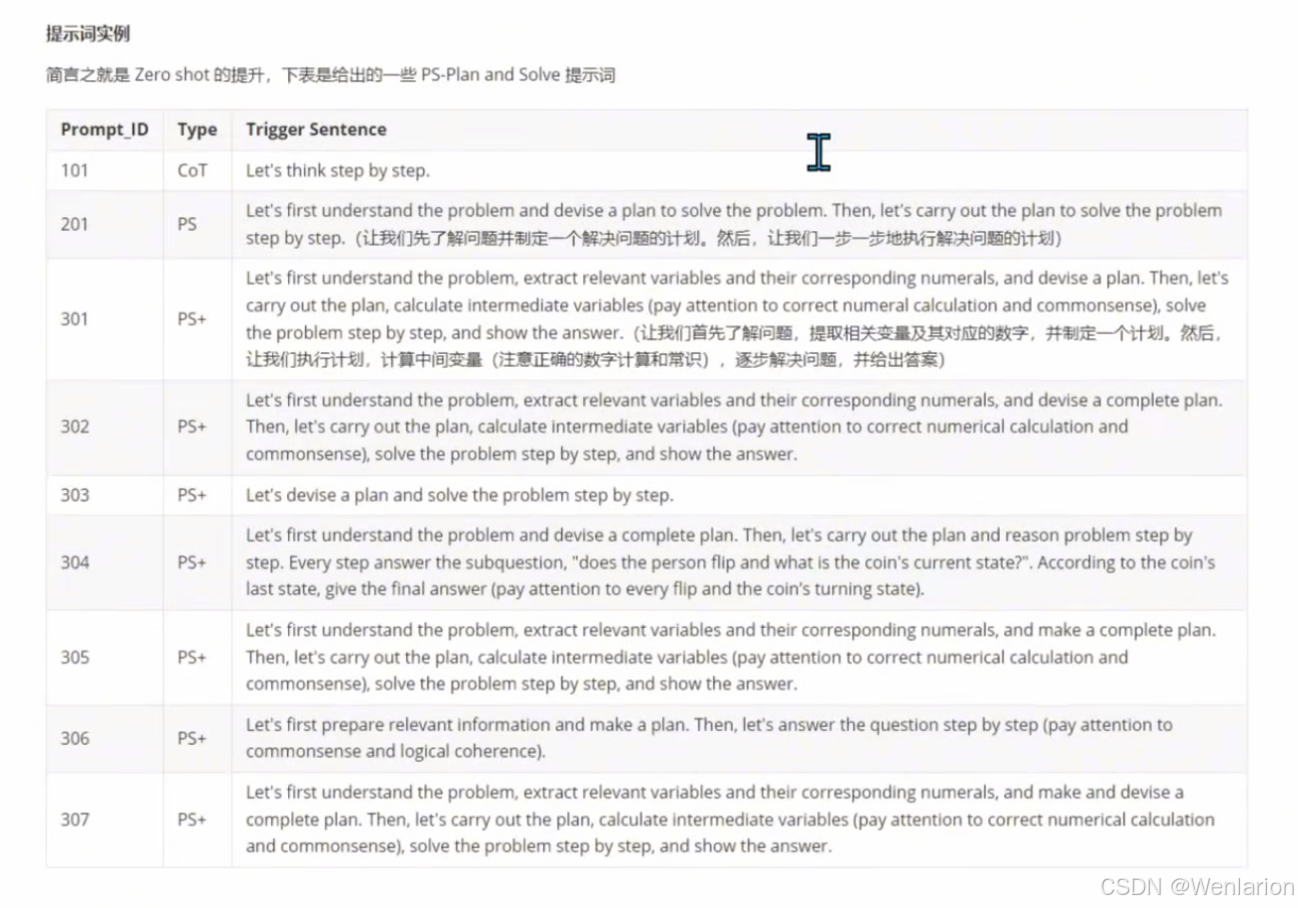
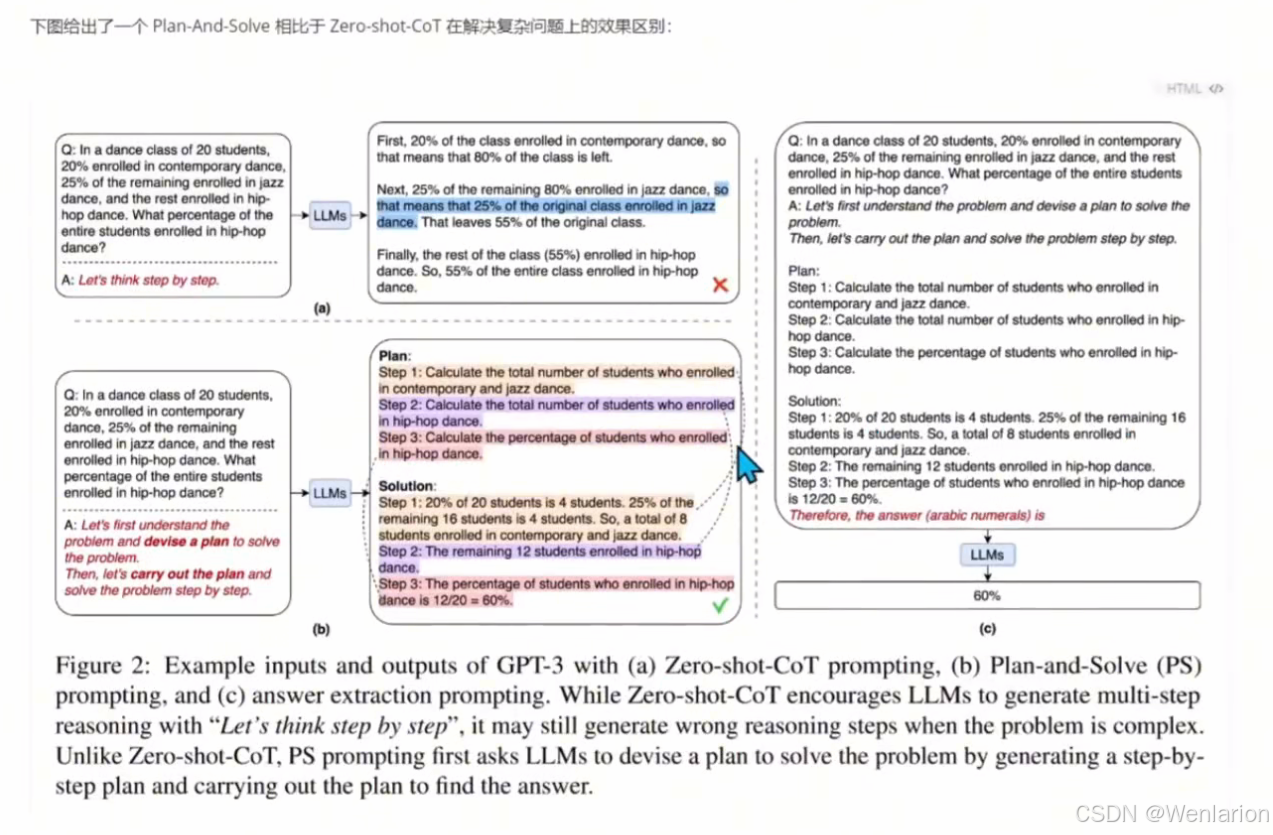
PS Prompting 与 PS+ Prompting 提示词结构
核心定位
PS Prompting 属于 Zero-shot COT 类型,它用更具规划性的指令替代了传统 Zero-shot COT 的 “Let's think step by step”:
传统指令:Let's think step by step
PS 指令:Let's first understand the problem and devise a plan to solve the problem. Then, let's carry out the plan and solve the problem step by step.翻译:让我们先了解问题并制定一个解决问题的计划,然后,让我们执行计划,逐步解决问题
提示词模板结构
基础模板格式为:Q: [X]. A: [T]
-
X:问题描述
-
T:触发指令,核心是包含
devise a plan(制定计划)和carry out the plan(执行计划)两个关键动作
完整示例:Q: [问题描述]. A: Let's first understand the problem and devise a plan to solve the problem. Then, let's carry out the plan and solve the problem step by step.
PS+ Prompting 的增强
为了让 LLM 更关注计算细节和中间步骤,提升推理准确率,作者在 T 中补充了更具体的引导:
plaintext
pay attention to calculation, extract relevant variables and their corresponding numerals(不要忽略题目X中的相关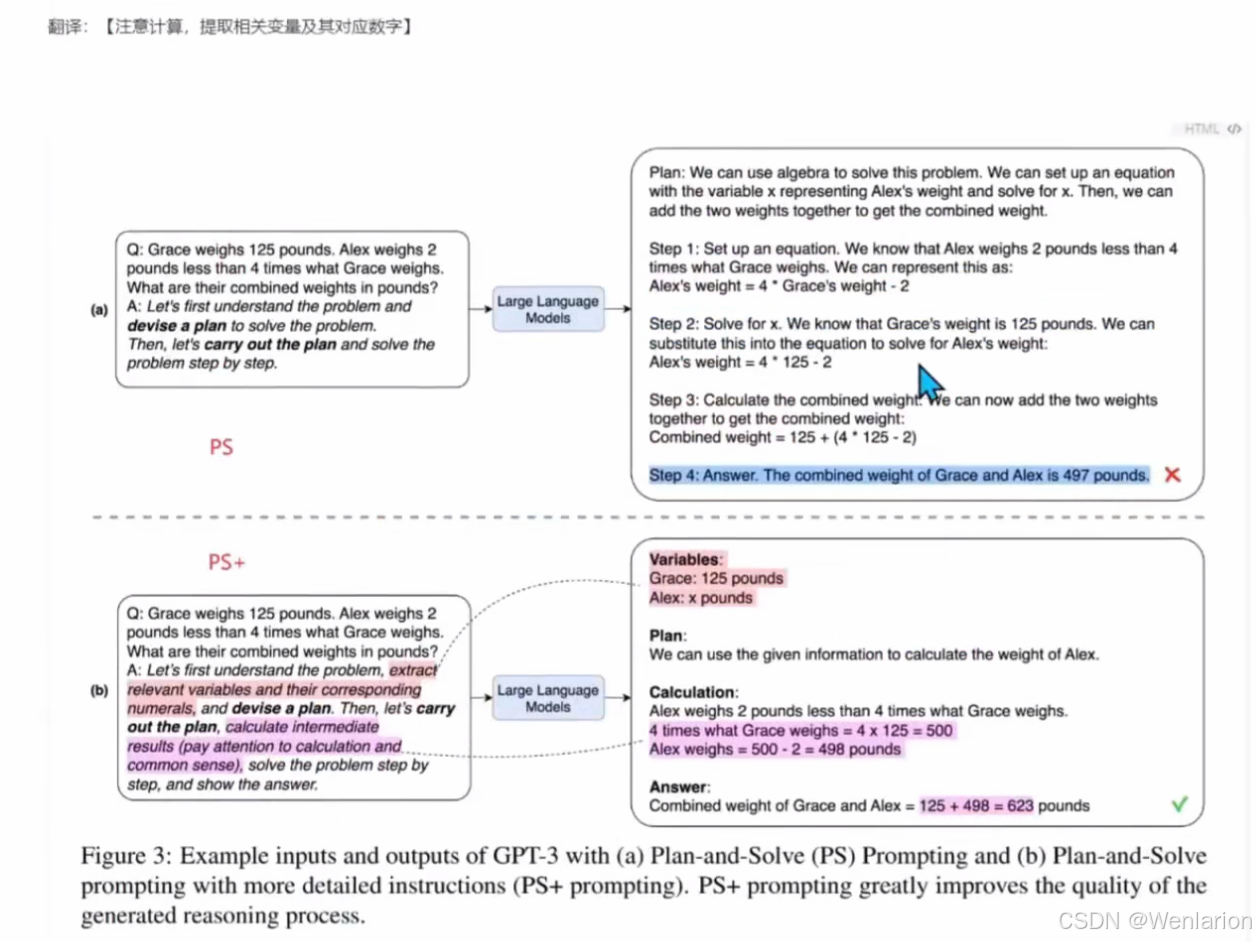
和原始 Zero-shot-CoT 一样,这个模式需要两次调用 LLM:
-
第一次:生成推理过程通过提示词(如
Let's think step by step)让模型生成解决问题的推理过程,模拟人类思考步骤,帮助模型更好地理解和解决问题。 -
第二次:提取最终答案利用生成的推理过程和原始问题,再次调用模型以提取或生成最终答案,直接给出问题结论。
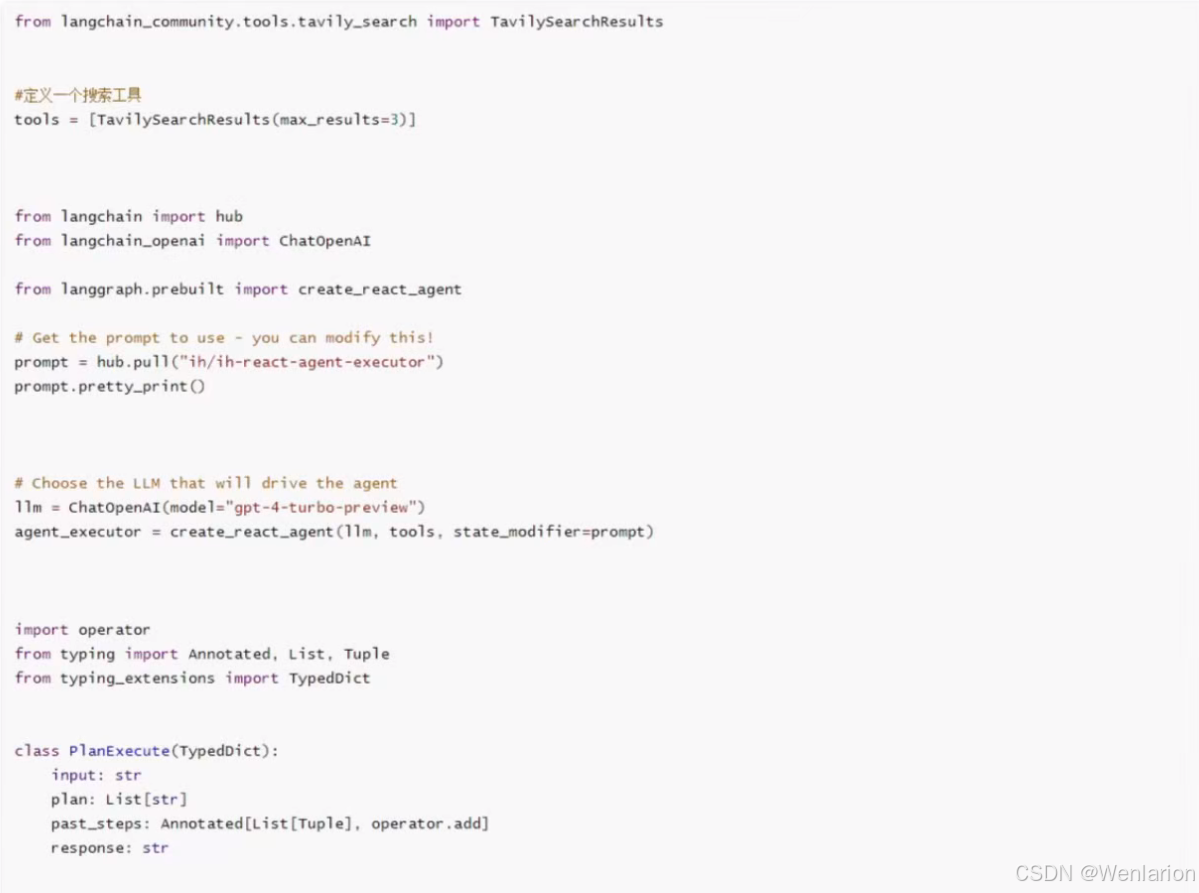
例子代码
- 参考链接:https://github.com/langchain-ai/langgraph/blob/main/docs/docs/tutorials/plan-and-execute/plan-and-execute.ipynb
- 说明:这是基于 LangGraph 框架实现的代码。如果没有 GPT-4 账号,可以使用 Llama3 或 Qwen 等支持 function call 的模型版本来运行。
Reason without Observation(REWOO)模式
核心原理
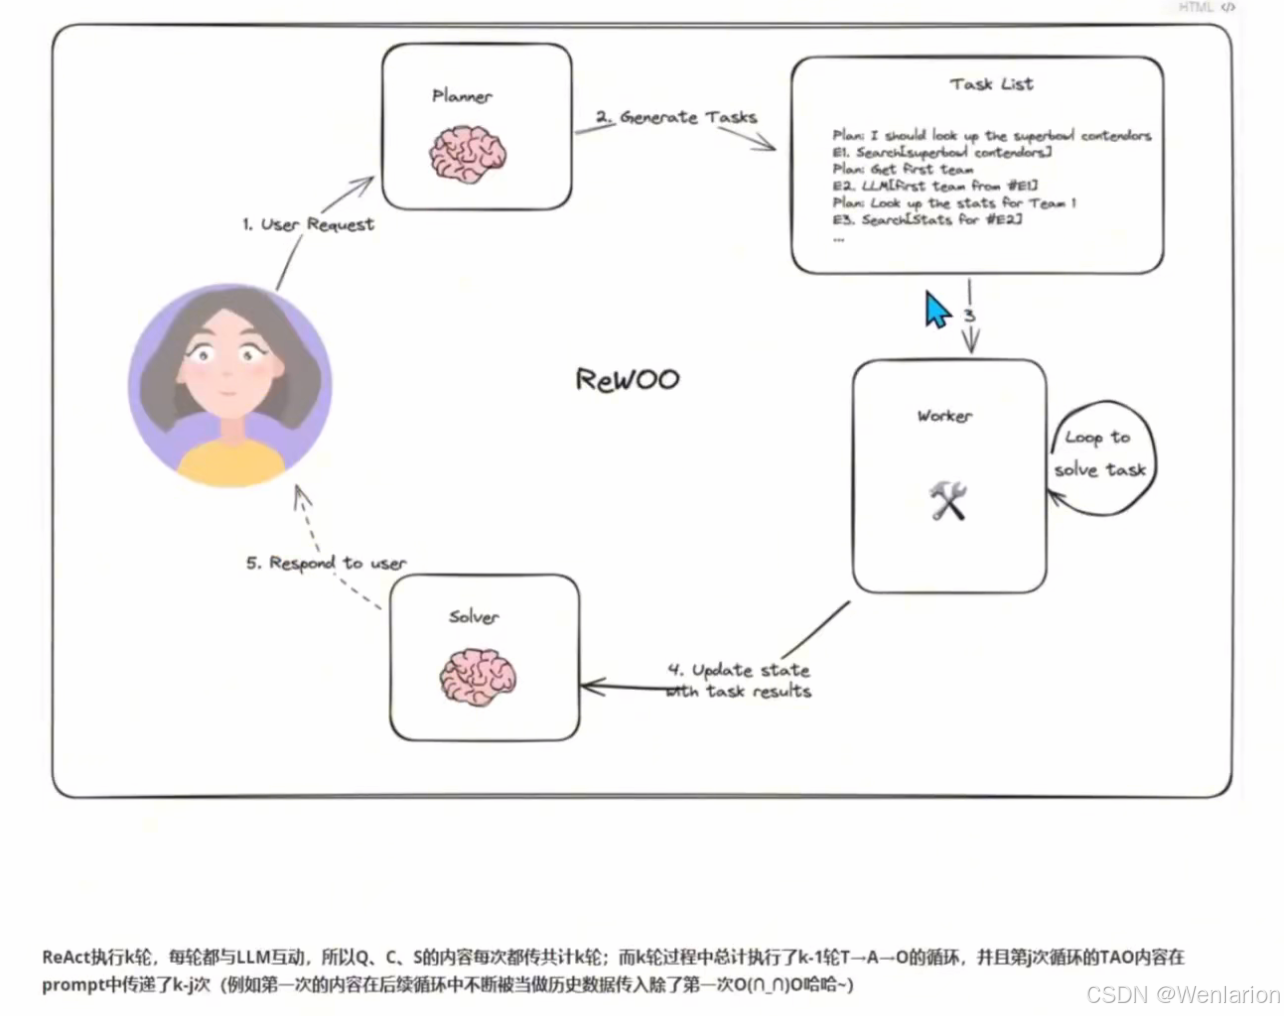
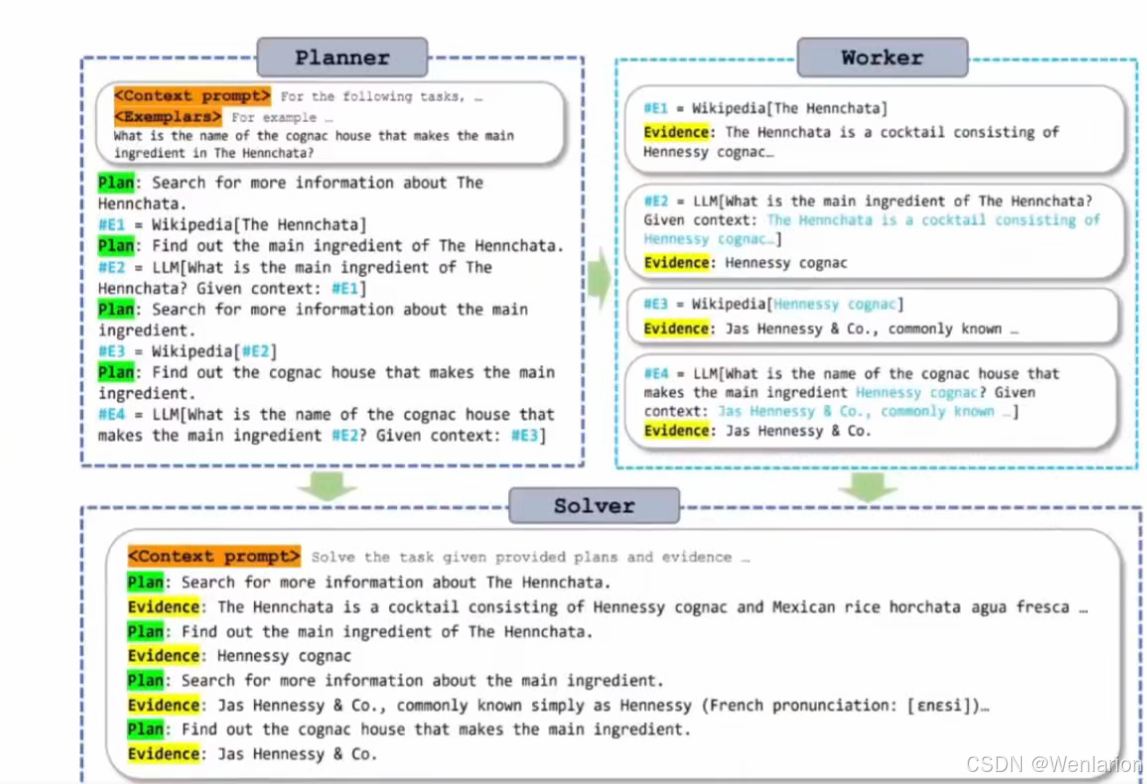
REWOO 的核心思想是将 ** 推理(Reasoning)过程与外部观察(Observation)** 分离,以此来提高模型的效率和性能。
在传统的 LLM 增强系统(如 ReAct 模式)中,模型的推理过程与外部工具调用、观察结果是紧密交织的。这种模式虽然简单易用,但计算复杂度高,需要多次调用 LLM 并重复执行操作,不仅增加了计算成本,也延长了执行时间。
REWOO 通过模块化设计优化了这一过程。
核心执行步骤
-
Planner(规划器)
-
接收用户输入的任务,并将其分解为一系列相互依赖的 “链式计划”。
-
每个计划会详细说明需要使用的外部工具、工具调用方式,以及每一步依赖的上一步输出。
-
负责一次性生成完整的工具调用链,而非在每次迭代中重复调用 LLM。
-
-
Worker(执行器)
-
根据规划器提供的计划,调用相应的外部工具来执行任务,并获取必要的信息或证据。
-
循环遍历每个任务,将任务输出分配给对应变量,后续调用时会自动用变量结果进行替换。
-
-
Solver(合并器)
-
将所有计划的执行结果整合起来,形成对原始任务的最终解决方案。
-
核心优势
-
效率提升:通过一次性生成完整的工具链,显著减少了令牌消耗和执行时间。
-
简化微调:由于规划数据不依赖于工具的输出,可以在不实际调用工具的情况下对模型进行微调,进一步简化了微调过程。
LLMCompiler 模式
-
论文:An LLM Compiler for Parallel Function Callinghttps://arxiv.org/pdf/2312.04511.pdf
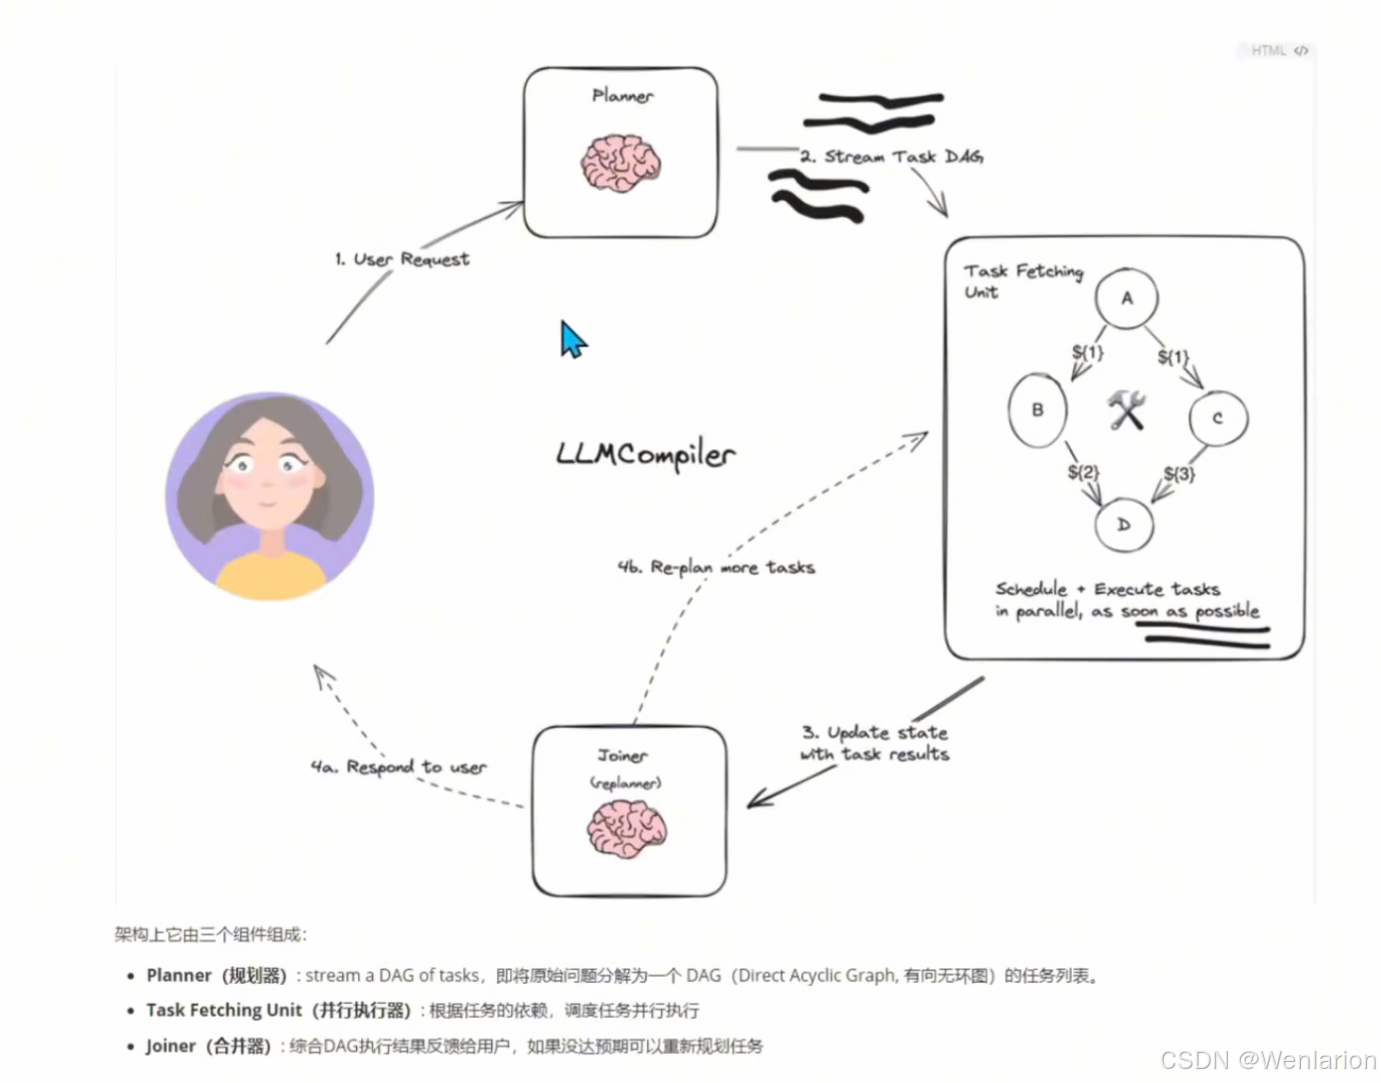
实现原理
LLMCompiler 的核心是通过 ** 并行函数调用(Parallel Function Calling)** 来大幅提升效率。
它会将一个复杂任务拆解为多个可以并行执行的子任务,同时调用多个工具来获取结果,最后再合并这些结果得到最终答案。
示例
当用户提问 “Scott Derrickson 和 Ed Wood 是否是同一个国家的国民?” 时:
传统模式会先搜索 Scott Derrickson 的国籍,完成后再搜索 Ed Wood 的国籍,是串行执行。
LLMCompiler 会让规划器同时发起两个搜索请求(分别获取两人的国籍),并行执行,最后合并结果进行判断,显著缩短了整体耗时。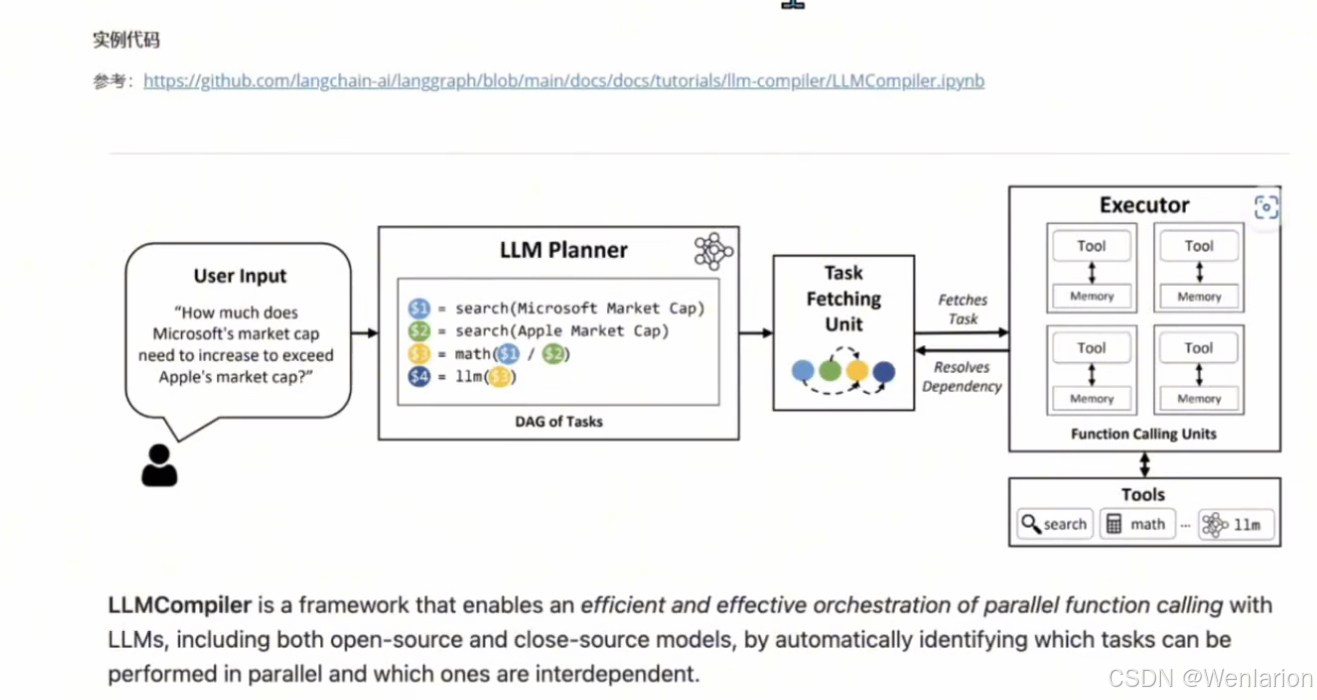
Reflexion 模式
-
论文:Reflexion: Language Agents with Verbal Reinforcement Learninghttps://arxiv.org/pdf/2303.11366.pdf
-
GitHub 项目:https://github.com/noahshinn/reflexion
核心原理
传统强化学习需要大量训练样本和昂贵的模型微调,大模型很难快速从错误中学习。而 ReAct、HuggingGPT 等基于大模型的任务决策框架,虽利用 In-context Learning 快速指导模型执行任务,但缺乏从失败中迭代优化的能力。
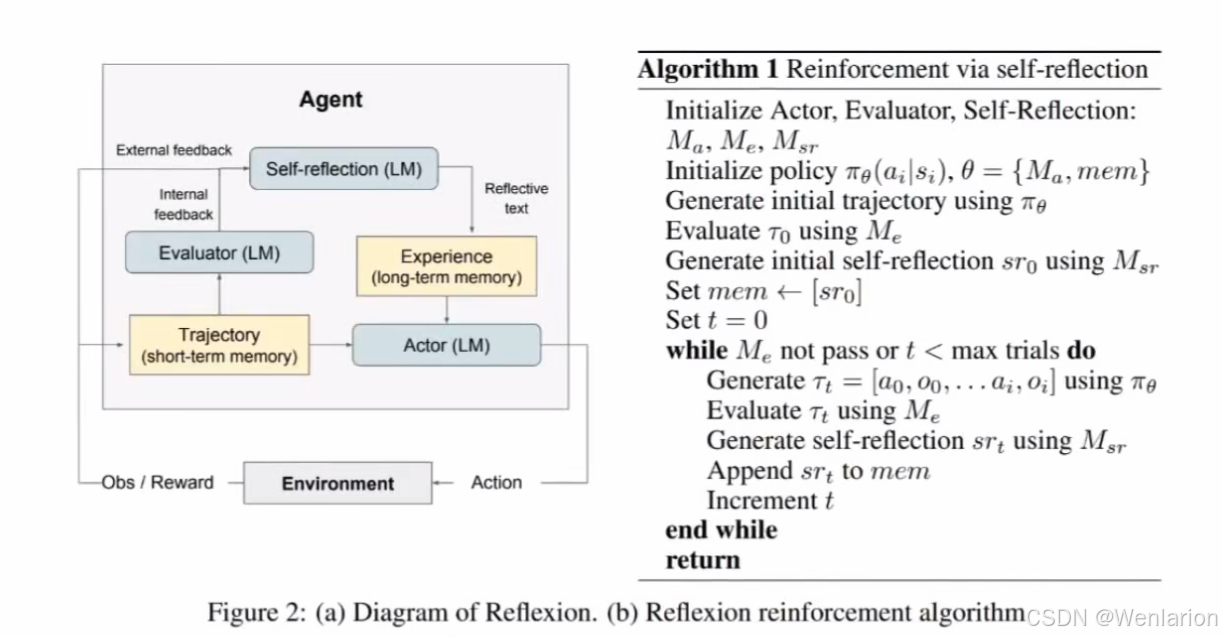
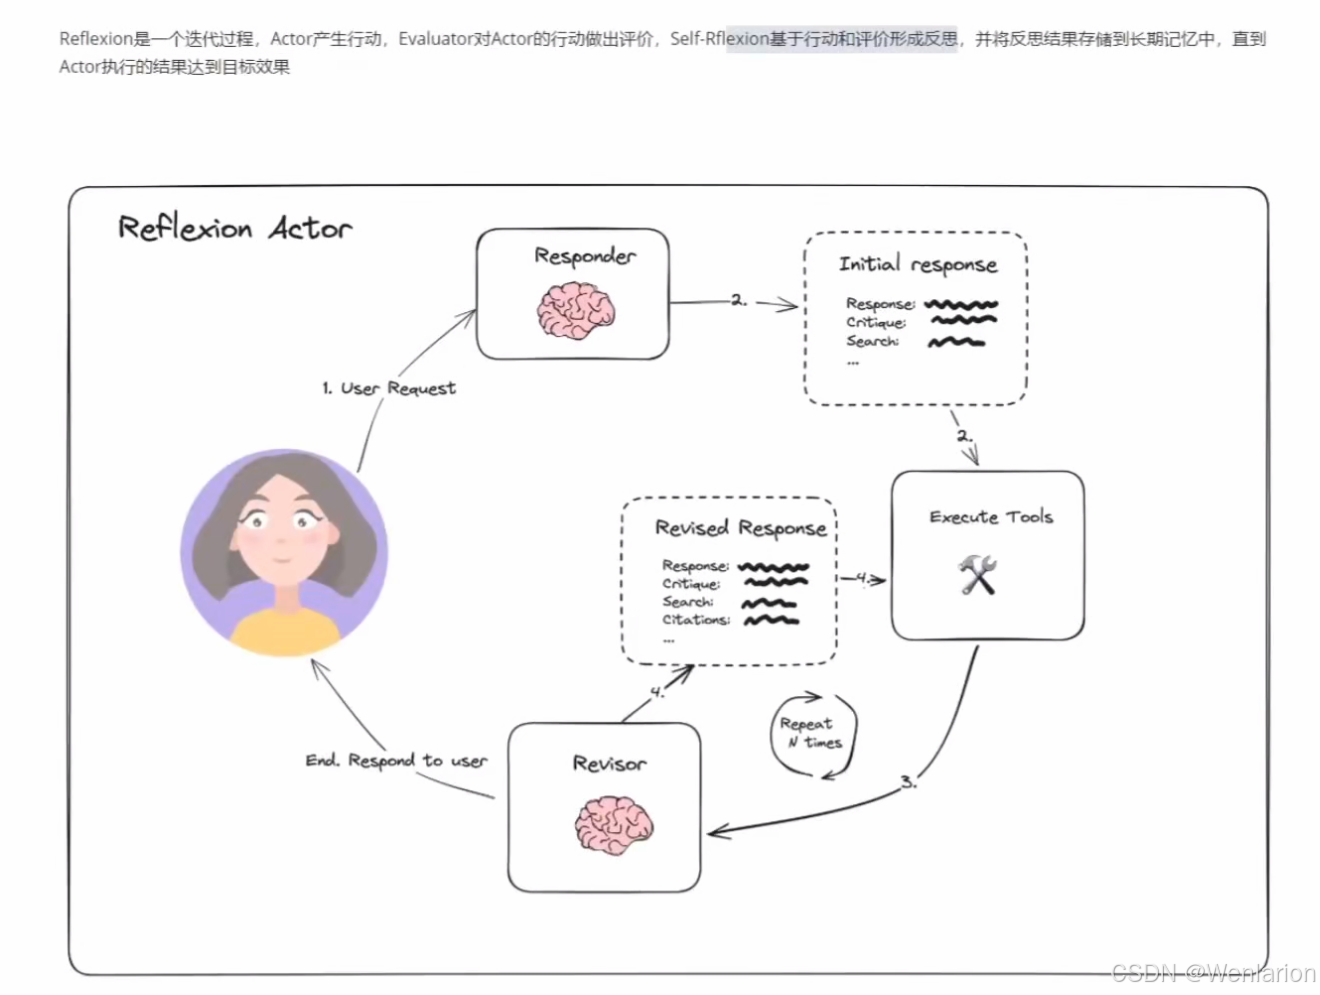
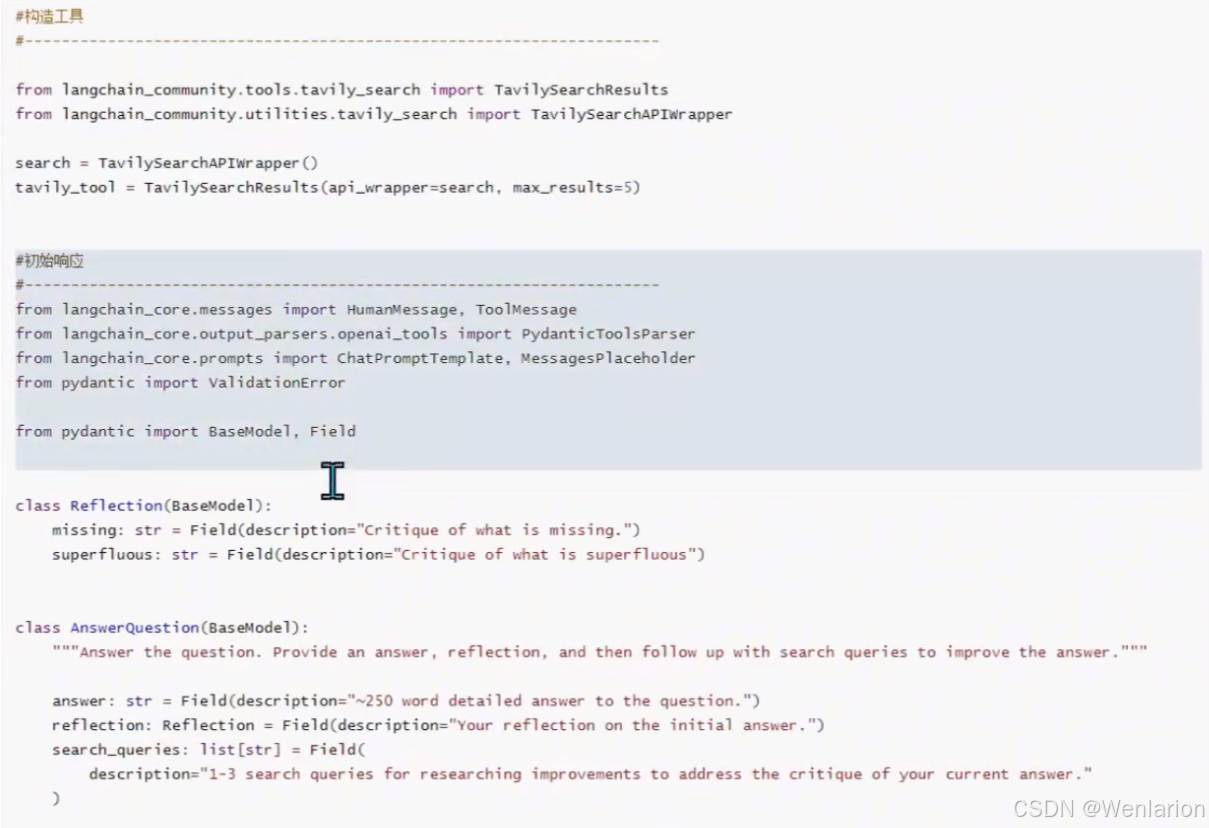
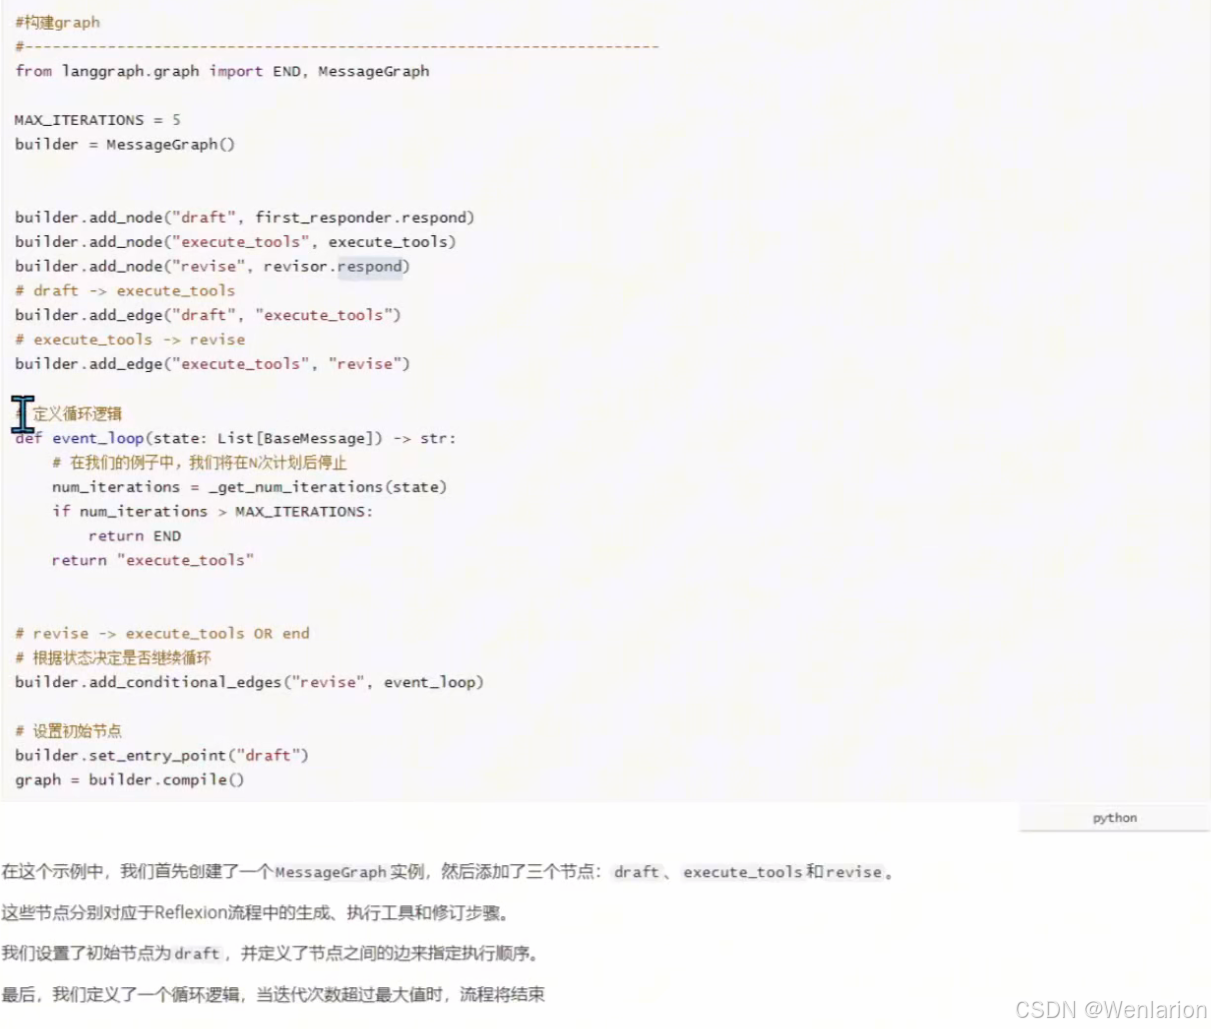
Reflexion 相当于 Basic Reflection 模式的升级版,它通过语言反馈信号帮助 Agent 从先前的失败经验中学习,避免了传统微调带来的计算成本和时间成本。
实现方式
Reflexion 将传统梯度更新中的参数信号,转化为添加在大模型上下文中的语言总结。这使得 Agent 在下一个任务周期(episode)中,可以参考上一次执行失败的经验,从而逐步提升执行效果。
实验效果
作者在三类任务上进行了完整的对比实验:决策任务(AlfWorld)、推理任务(HotQA)、代码生成任务(HumanEval)Reflexion 在不同任务上均取得了不错的效果,特别是在代码生成任务上成为了当时的新 SOTA(State-of-the-Art)。
Reflexion 框架核心组成部分
Reflexion 框架由四个核心模块构成,形成了 “执行 - 评估 - 反思 - 记忆” 的闭环:
1. Actor(执行者)
由大语言模型(LLM)担任。 核心工作:基于当前环境和记忆中的信息,生成下一步的具体动作。
2. Evaluator(评估者)
核心工作:衡量 Actor 生成结果的质量,类似强化学习中的 Reward 函数。
对 Actor 的执行结果进行打分(如 success 或 fail),输出离散的反馈信号。
3. Self-reflexion(自我反思)
由 LLM 担任,是 Reflexion 框架中最重要的部分。
它结合离散的 reward 信号(如成功 / 失败)和执行轨迹(推理上下文),生成具体且详细的语言反馈信号(例如在代码生成任务中,会指出哪一步出错、错误原因是什么)。
这些语言反馈会被存储到 Memory 中,用来启发下一次实验的 Actor 执行动作
4. Memory(记忆模块)
这些语言反馈会被存储到 Memory 中,用来启发下一次实验的 Actor 执行动作。
分为短期记忆(short-term)和长期记忆(long-term):
短期记忆:单次实验中的上下文信息。
长期记忆:多次试验中 Self-reflexion 生成的反思结果。
Actor 在推理阶段会同时利用短期记忆和长期记忆中的关键细节,这是 Reflexion 框架能持续迭代优化的核心。
Reflexion 与 Basic Reflection 的核心区别
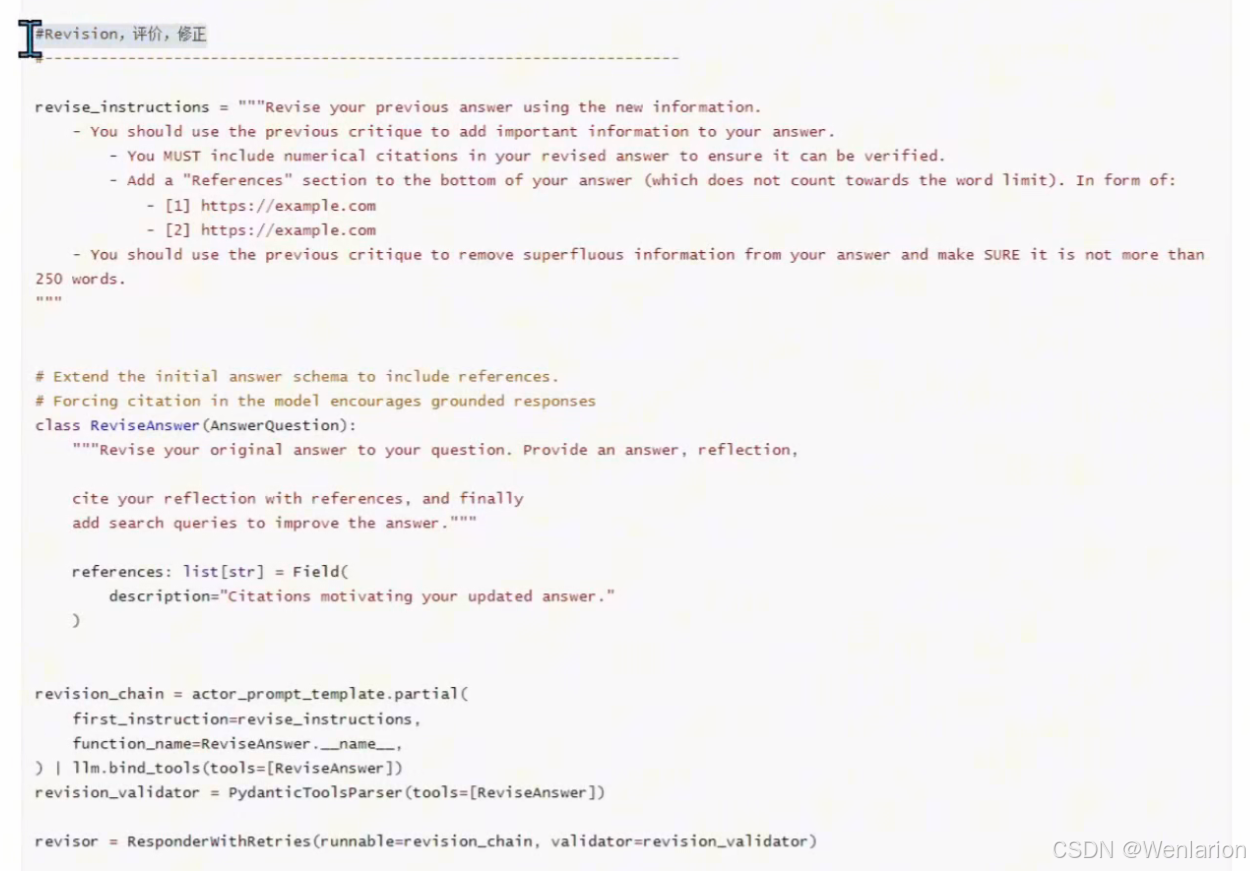
过程数据复用Reflexion 会将之前的生成结果、工具调用记录、评价反馈等所有过程数据,都作为下一次生成时的提示词(prompt),实现了更全面的经验复用。 外部工具辅助评价Reflexion 可以通过调用外部工具查询数据,来作为评价和修正的依据,让反馈更客观、更精准。
-
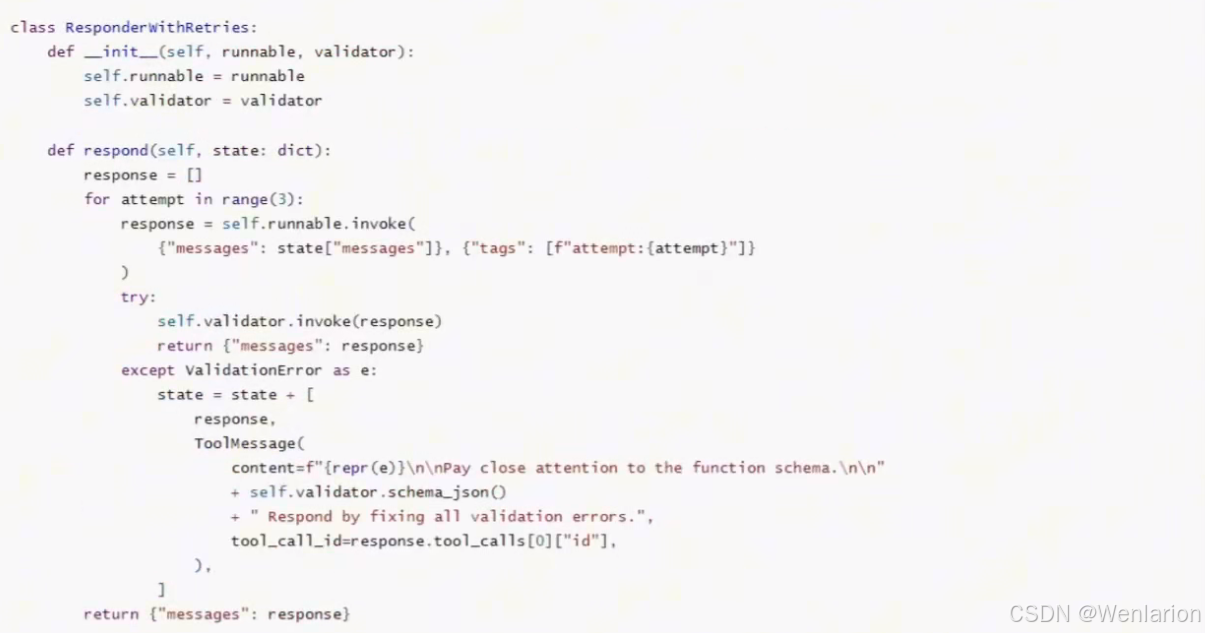
LangGraph 实现:https://github.com/langchain-ai/langgraph/blob/main/docs/docs/tutorials/reflexion/reflexion.ipynb
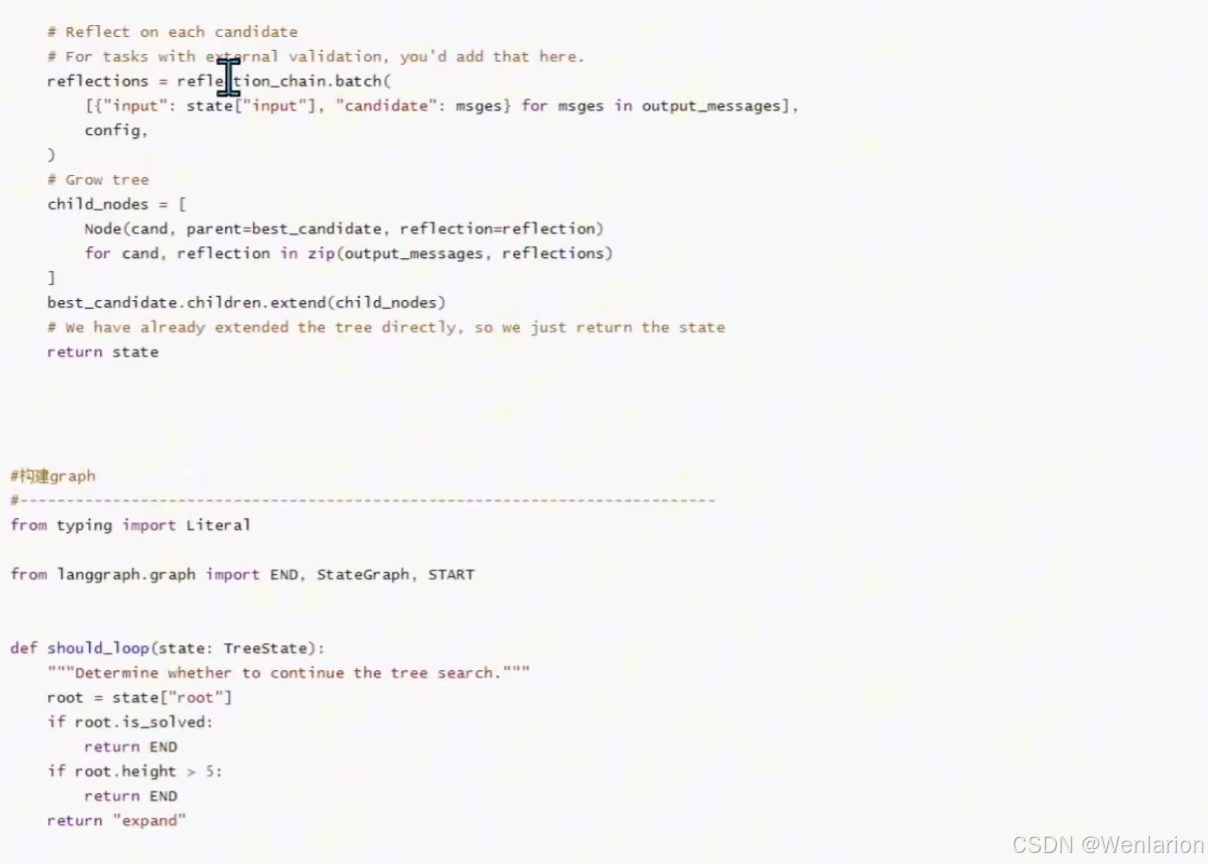
Language Agent Tree Search(LATS)模式
-
论文:Language Agent Tree Search Unifies Reasoning Acting and Planning in Language Modelshttps://arxiv.org/pdf/2310.04406.pdf
核心原理
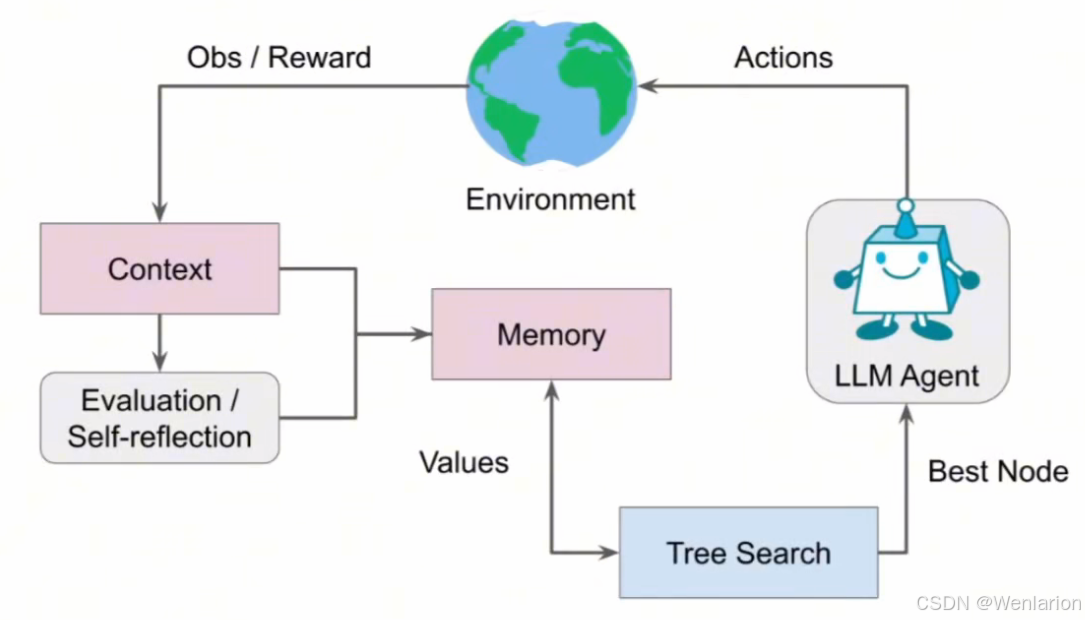
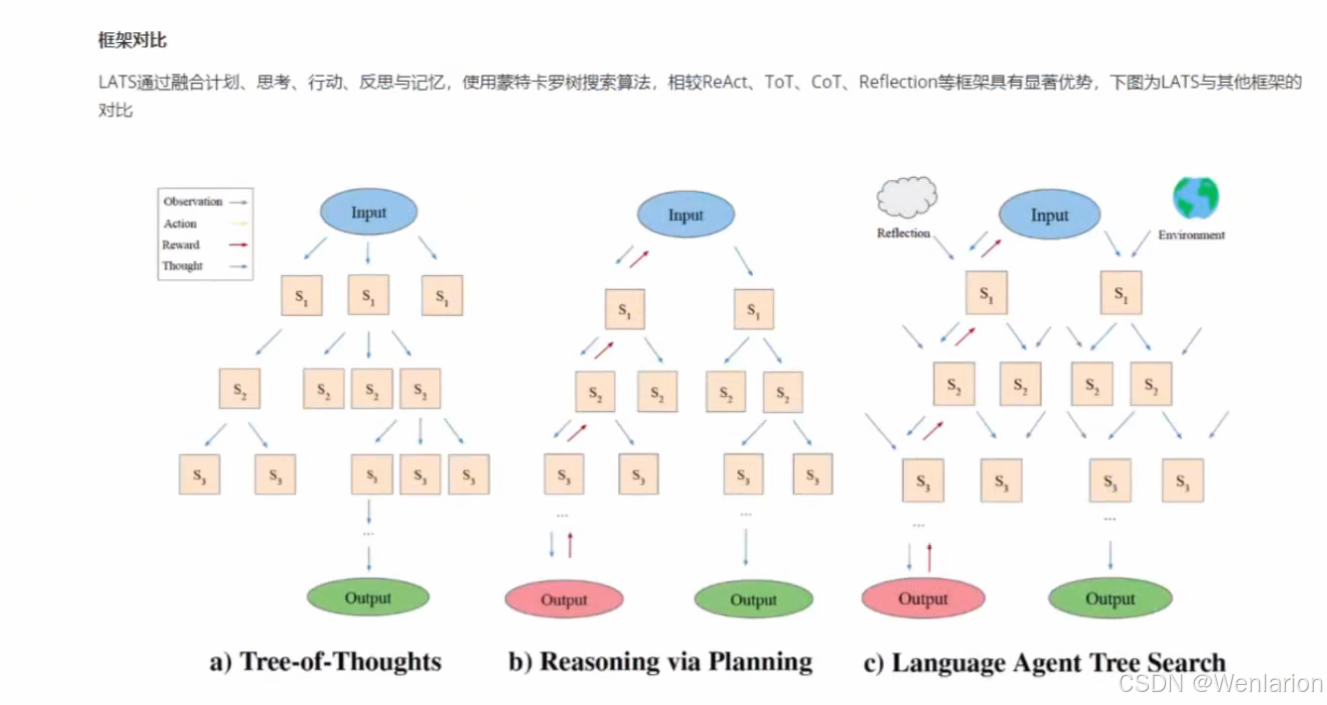
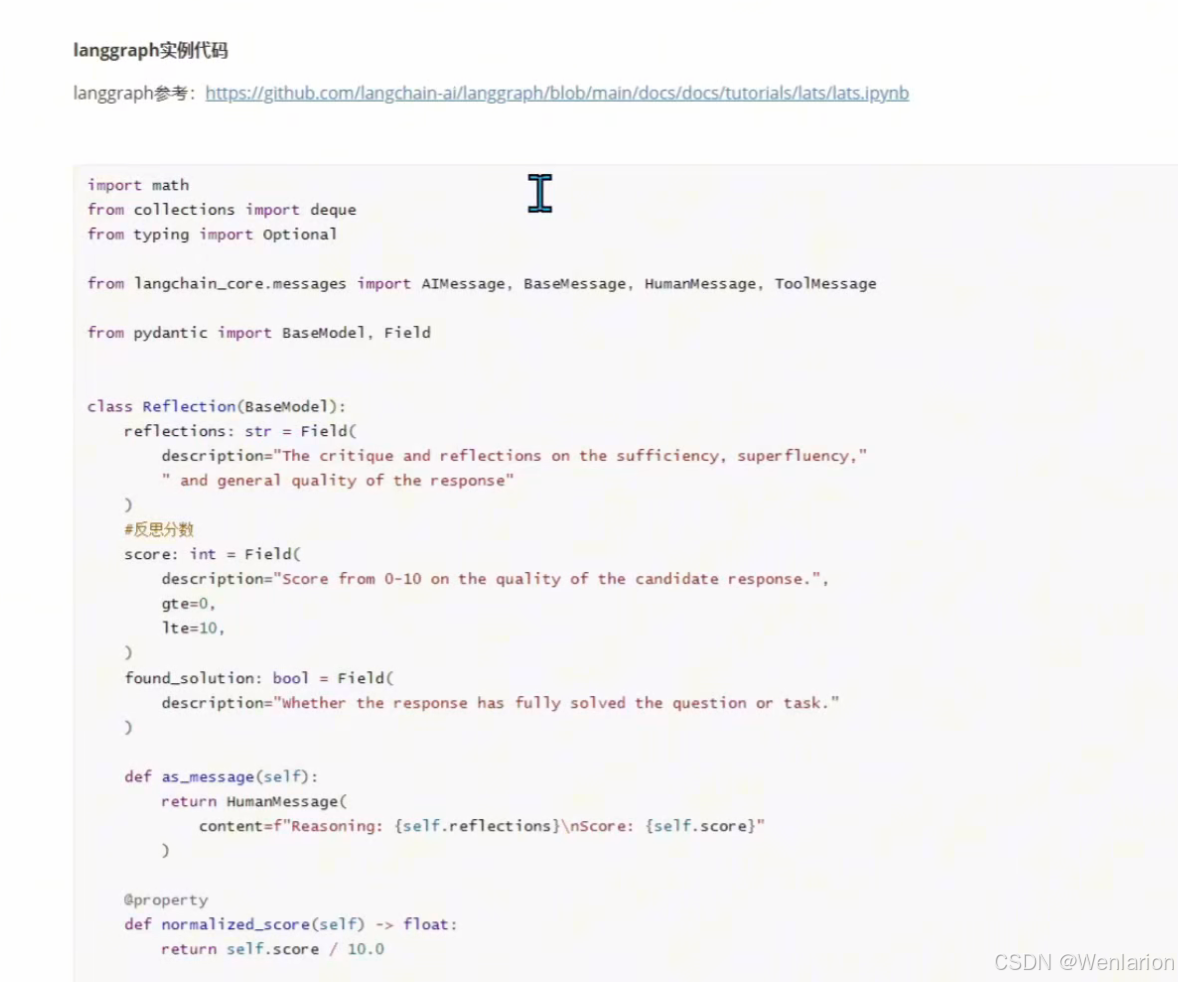
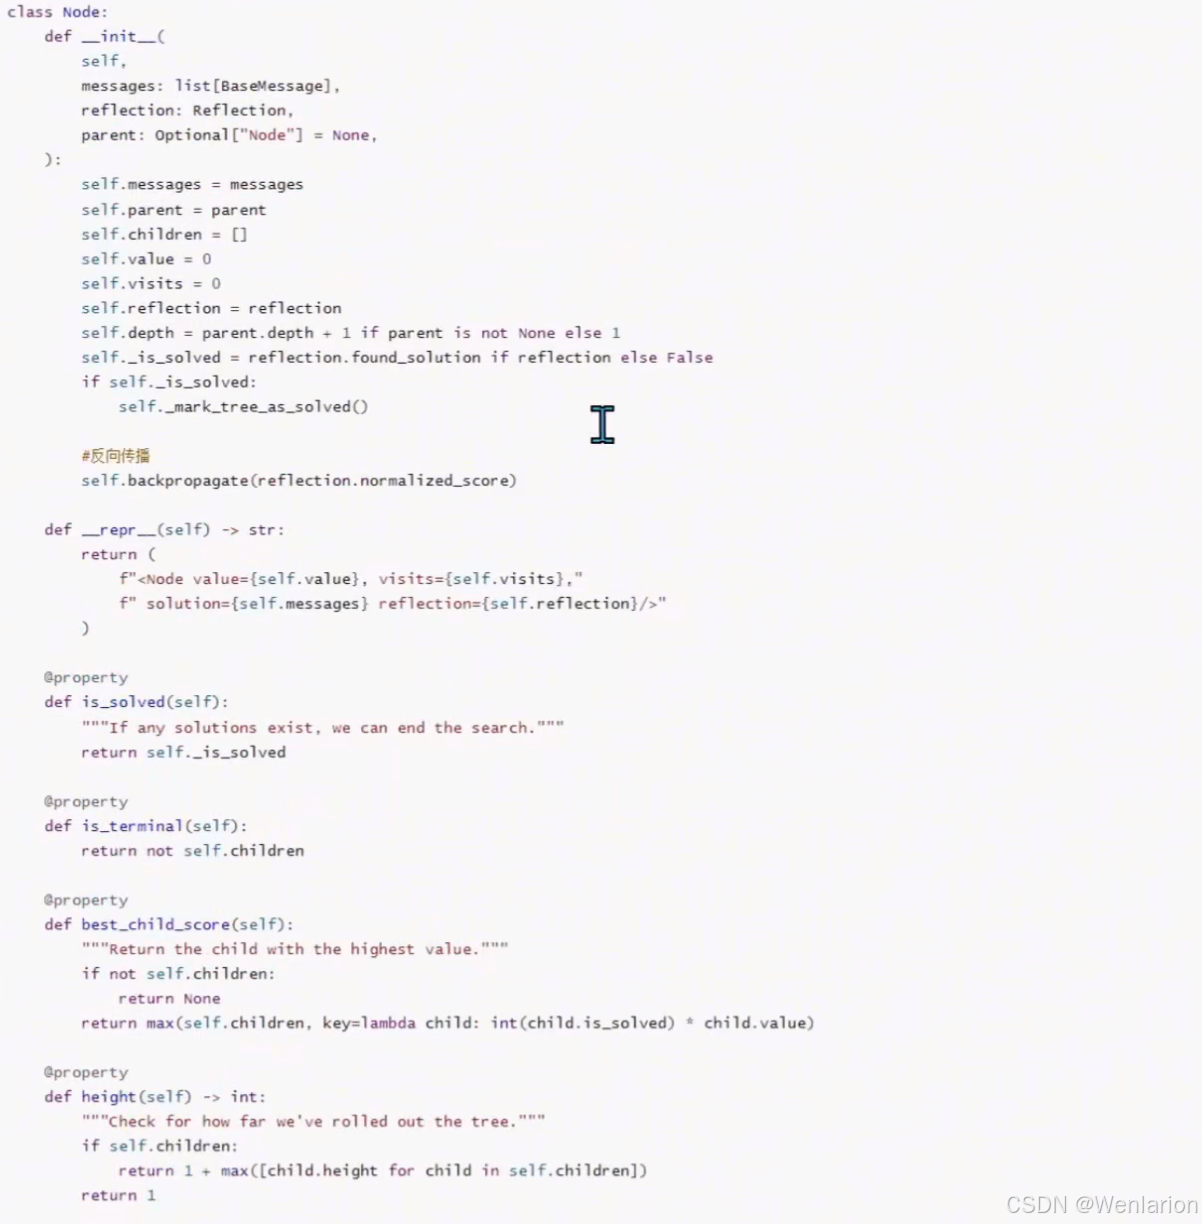
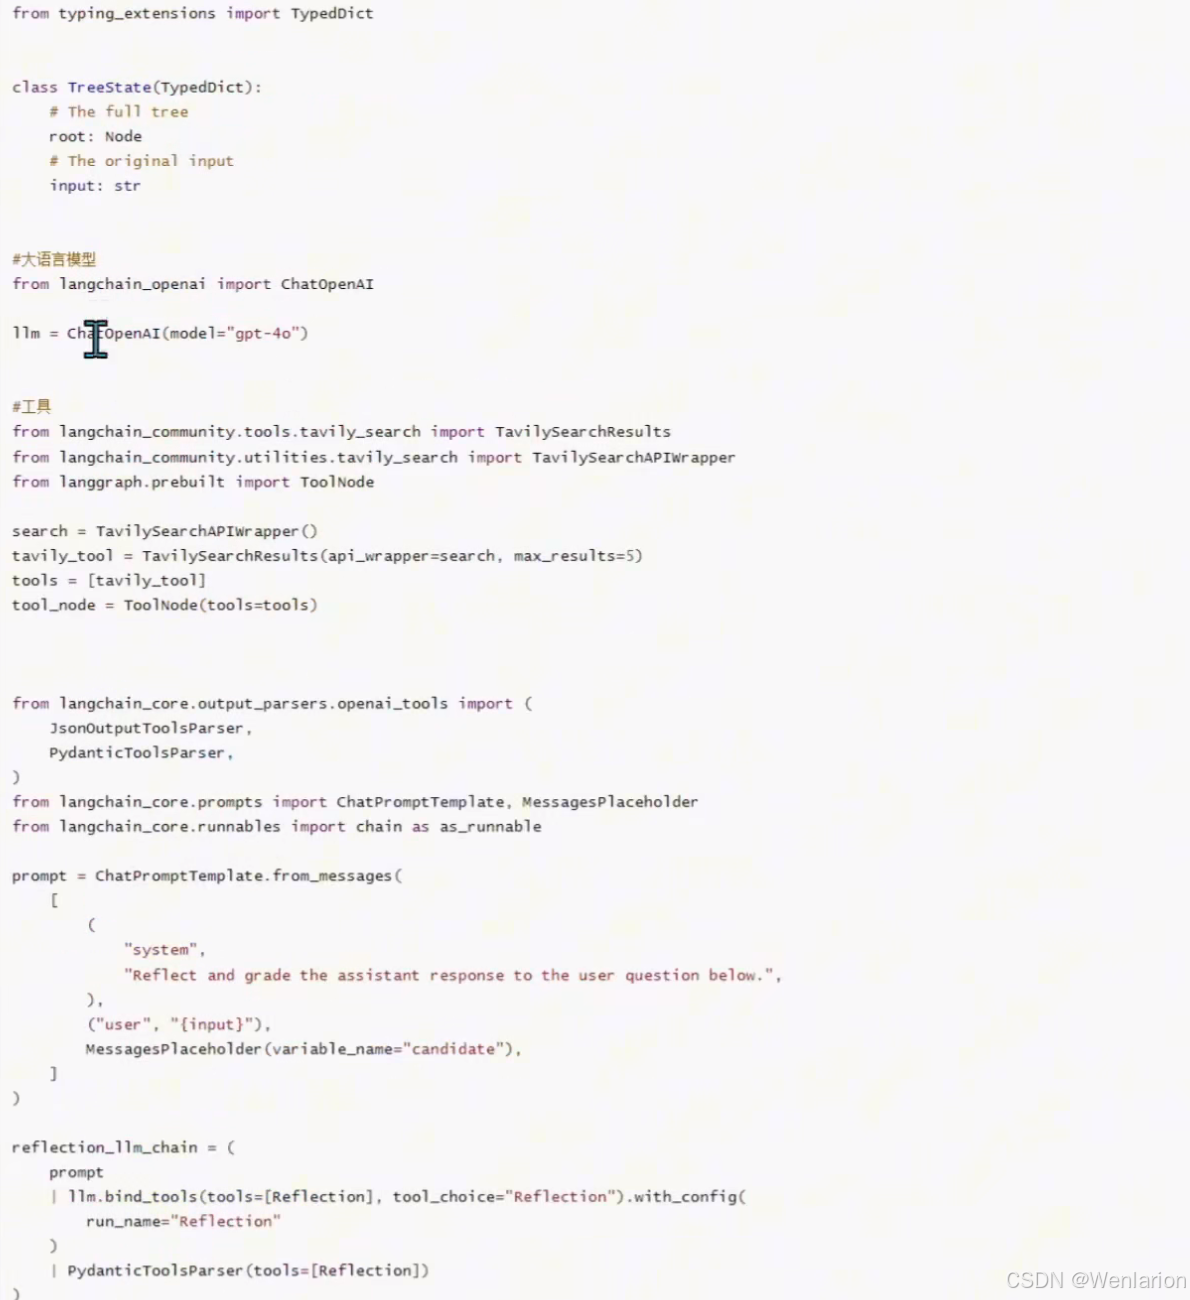
LATS 是 Tree search(树搜索) + ReAct + Plan&solve 的融合体,它整合了三种模式的核心能力:
Tree search:探索多种可能的推理和行动路径,避免陷入局部最优。
ReAct:提供 “思考 - 行动 - 观察” 的闭环,让 Agent 能根据反馈动态调整。
Plan&solve:提供 “先规划、再执行” 的全局视角,确保任务拆解和执行的系统性。
LATS 模式的核心改进与应用场景
相较于传统 MCTS 框架的主要改进
-
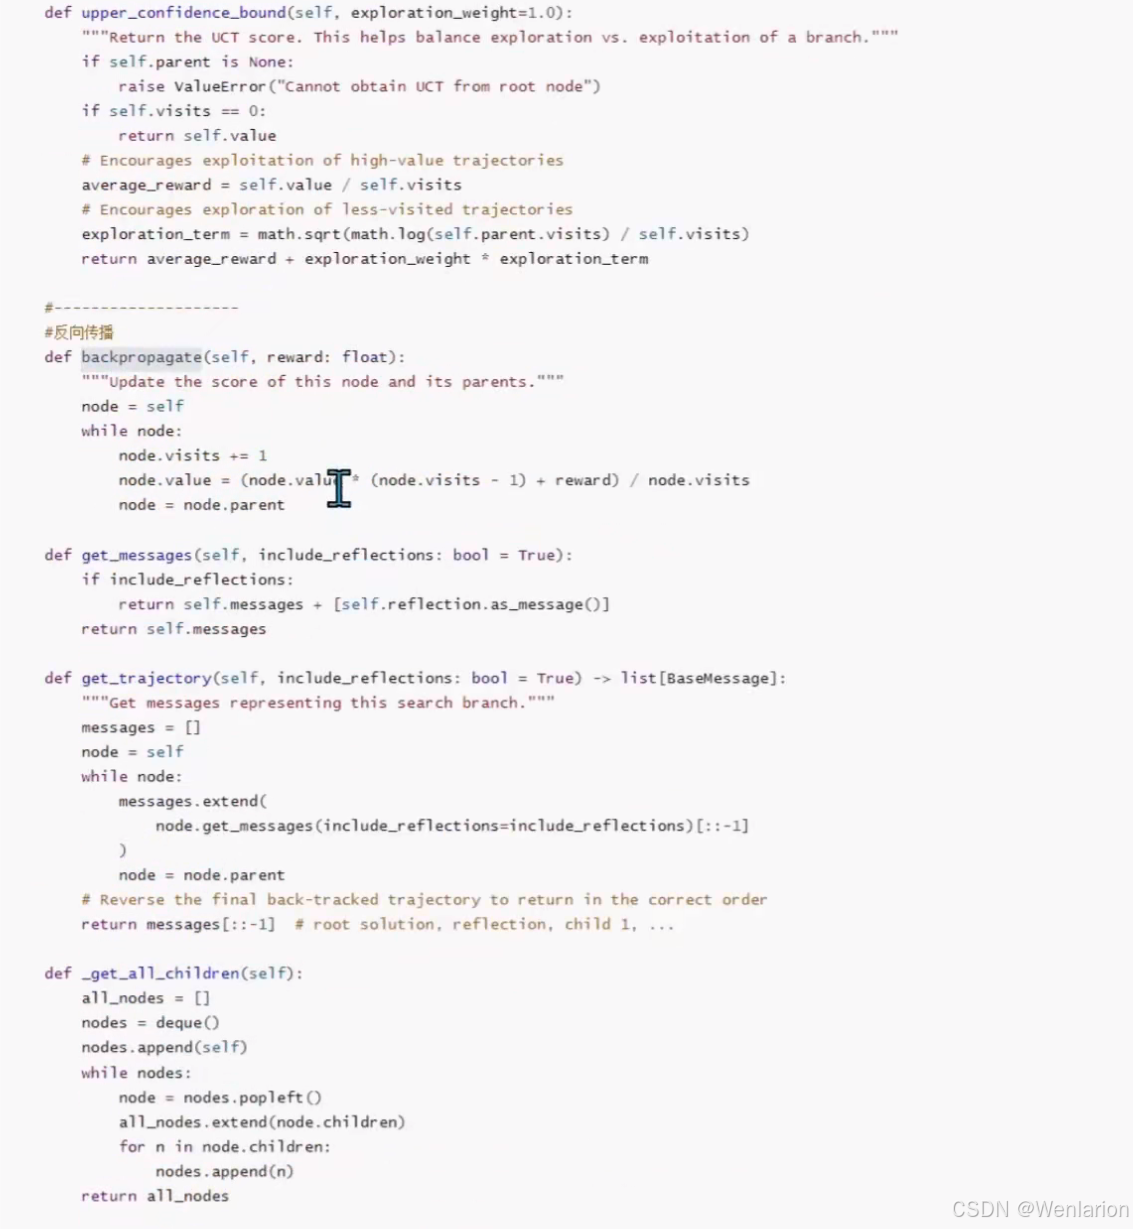
蒙特卡罗树搜索算法:使用蒙特卡罗树搜索(MCTS)来有效探索所有可能的解决方案路径。
-
LLM 节点价值评估:利用预训练语言模型(LLM)来评估搜索树中每个节点的价值,从而更精准地指导搜索方向。
-
自我反思机制:引入了自我反思机制,让模型能从失败的执行轨迹中学习,持续提升决策能力。
主要应用场景
LATS 主要用于解决自然语言任务中的推理和决策问题:
-
推理问题:输入一个问题后,LATS 会生成一系列中间思考序列,逐步推导得出最终答案。
-
决策问题:当需要在多个选项中做出选择时,LATS 可以针对不同情况生成多条决策路径,并从中选择最优解。
总的来说,LATS 提供了一种灵活、高效且可扩展的方式,来处理自然语言任务中的复杂推理与决策问题。
LATS 模式的完整执行流程与本质
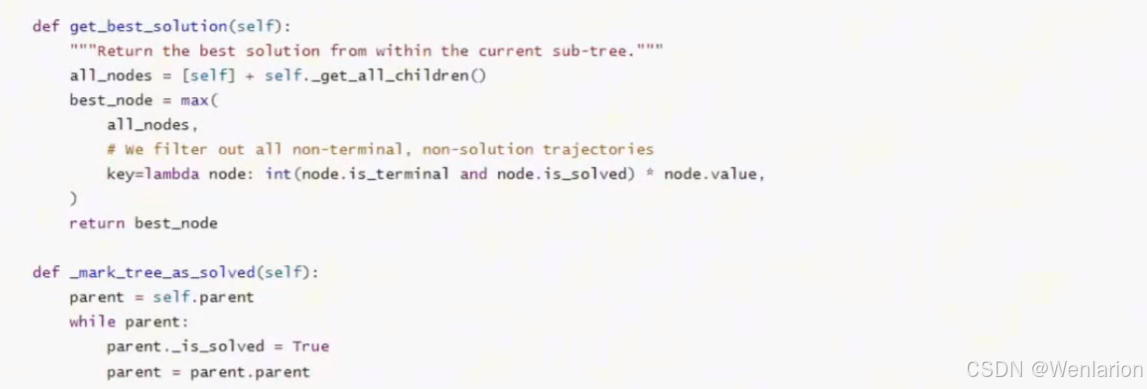
核心执行步骤
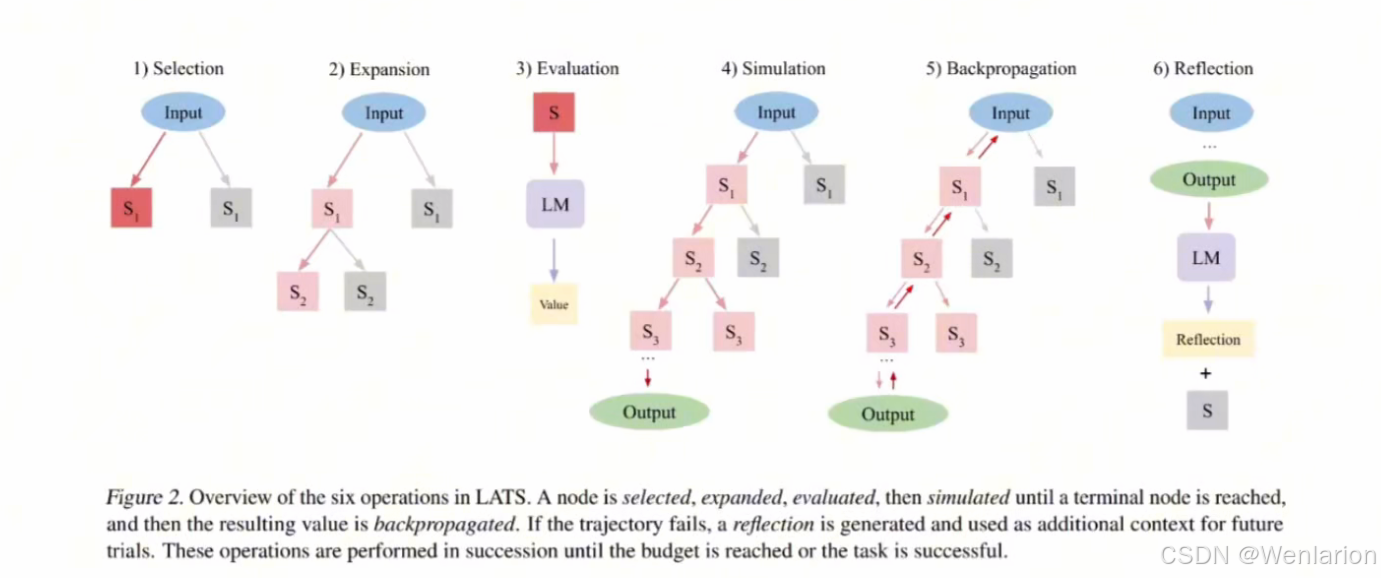
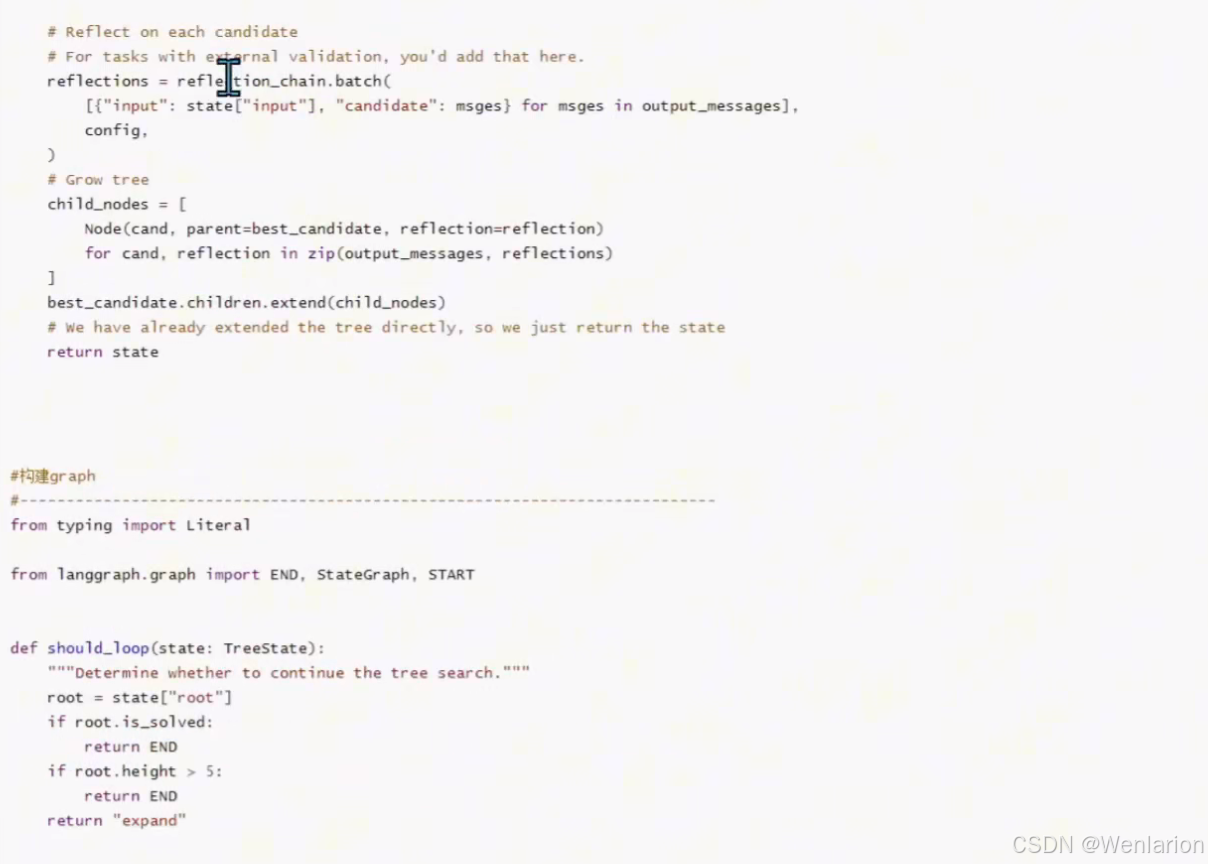
LATS 的核心流程包含六个关键环节:
-
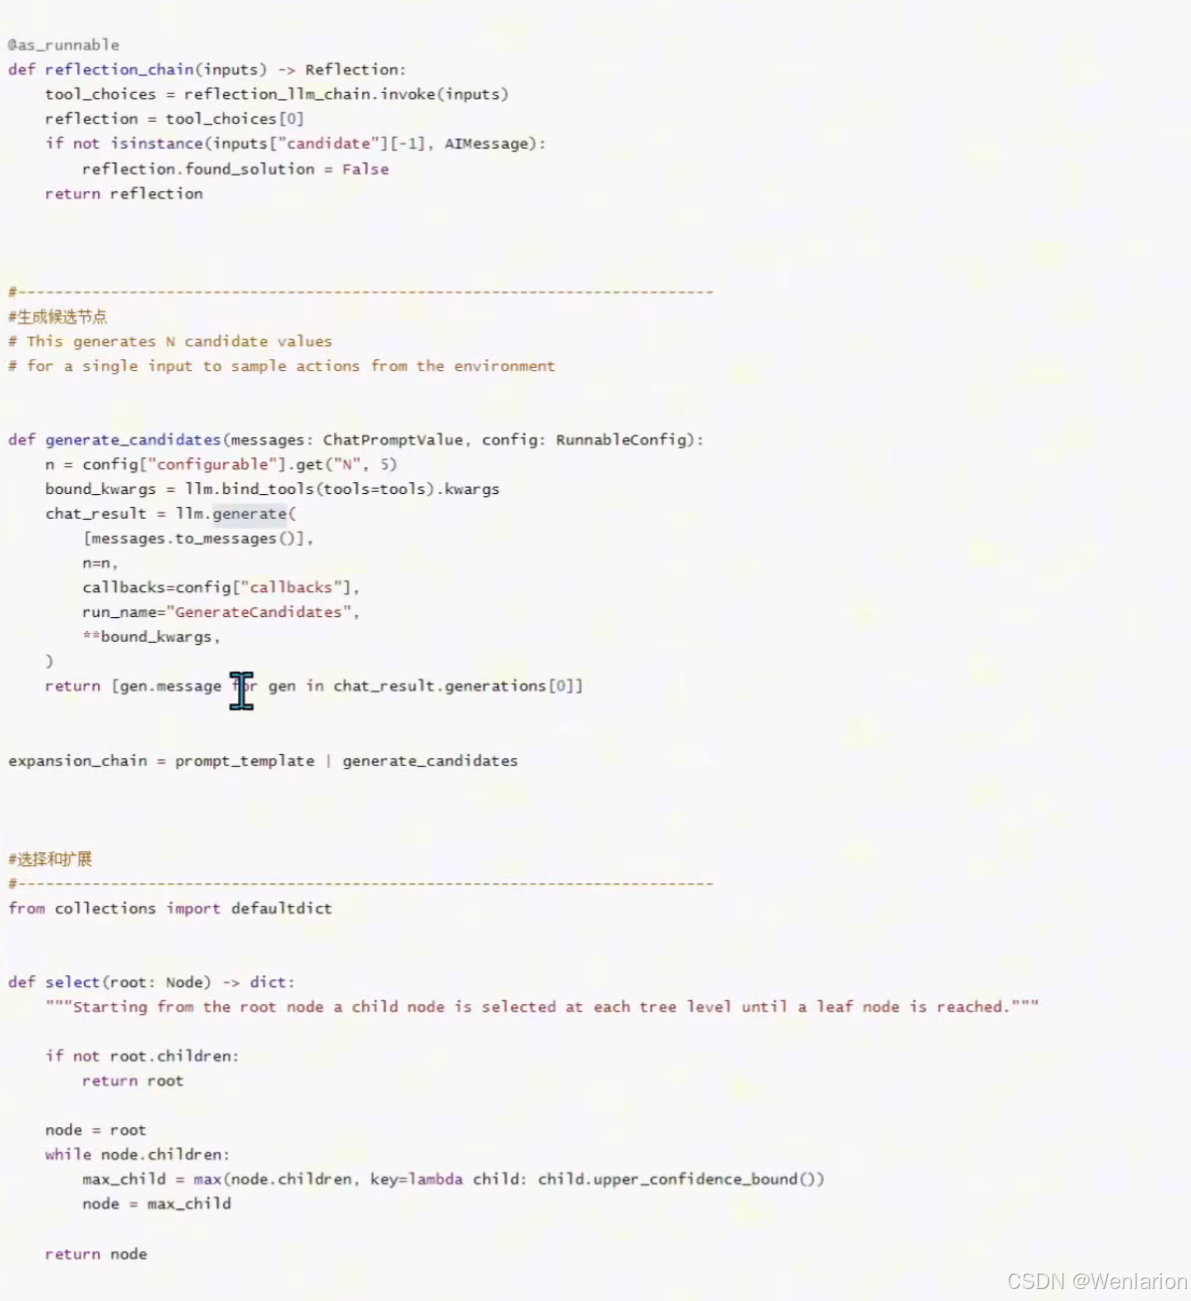
节点选择:从当前搜索树中选择一个节点进行探索。
-
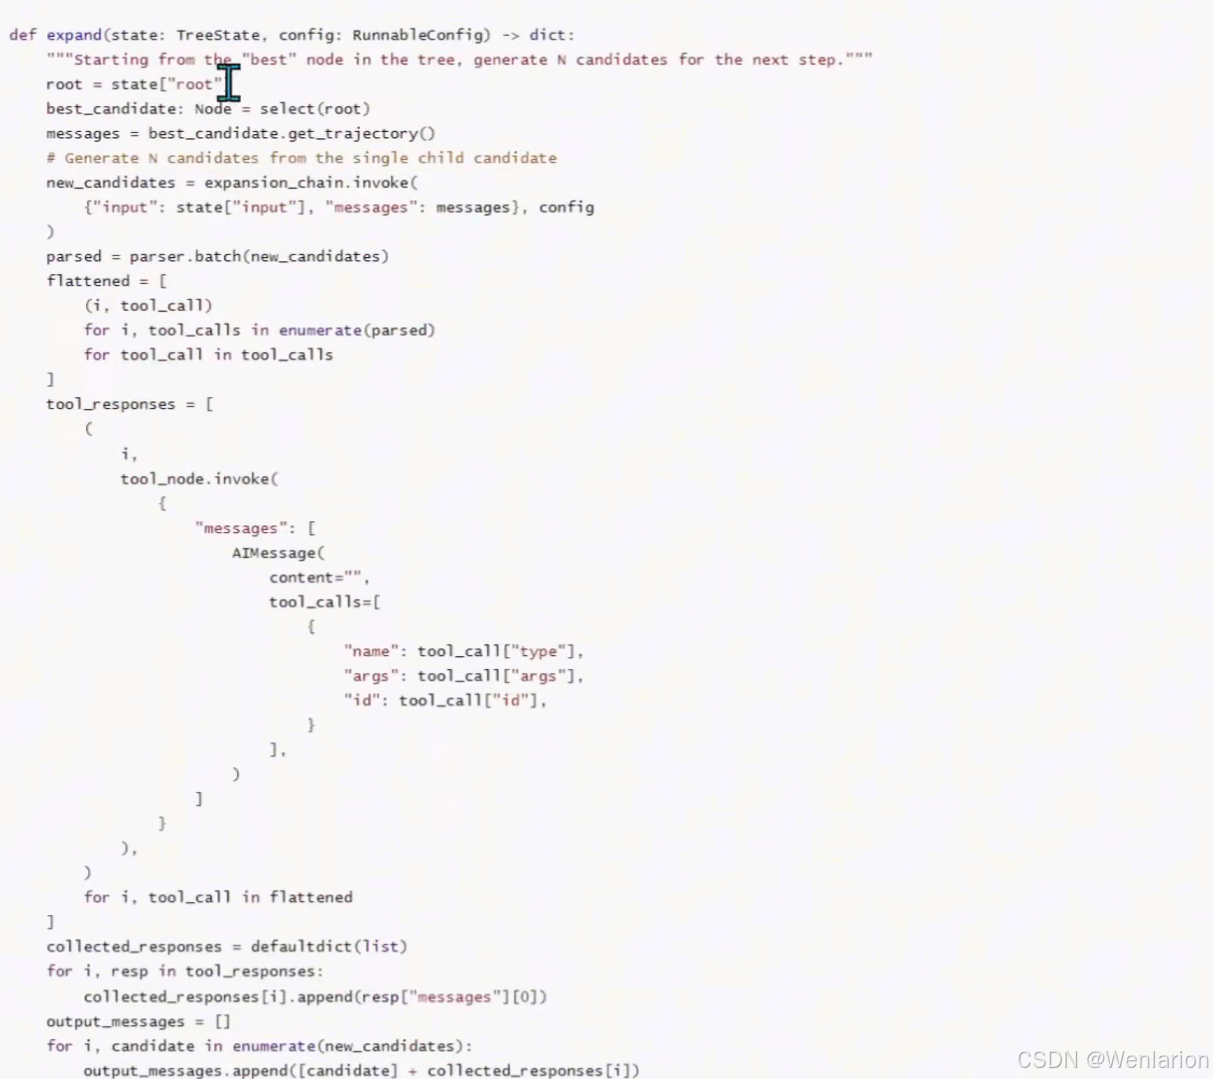
拓展子节点:基于选中的节点,生成多个可能的子节点(对应不同的推理或行动路径)。
-
节点评分:通过大语言模型(LLM)对每个子节点的价值进行评估和打分。
-
任务执行:沿着选中的路径执行任务,直到达到设定的步数或获取到最优质的结果。
-
反向传播:将执行结果反向传播给所有父节点,更新它们的价值评估。
-
反思更新:将最终输出内容再次输入给 LLM 进行反思,进一步优化结果。
本质构成
LATS 是一个能力高度融合的框架,其本质可以表示为:LATS = Tree search + ReAct + Plan&solve + Reflection + 强化学习
-
Tree search:提供多路径探索能力。
-
ReAct:提供 “思考 - 行动 - 观察” 的闭环反馈。
-
Plan&solve:提供全局规划和分步执行的能力。
-
Reflection:提供从失败中学习的自我迭代能力。
-
强化学习:通过树搜索实现 Reward 信号的反向传播,优化节点价值。
提示词与架构特点
-
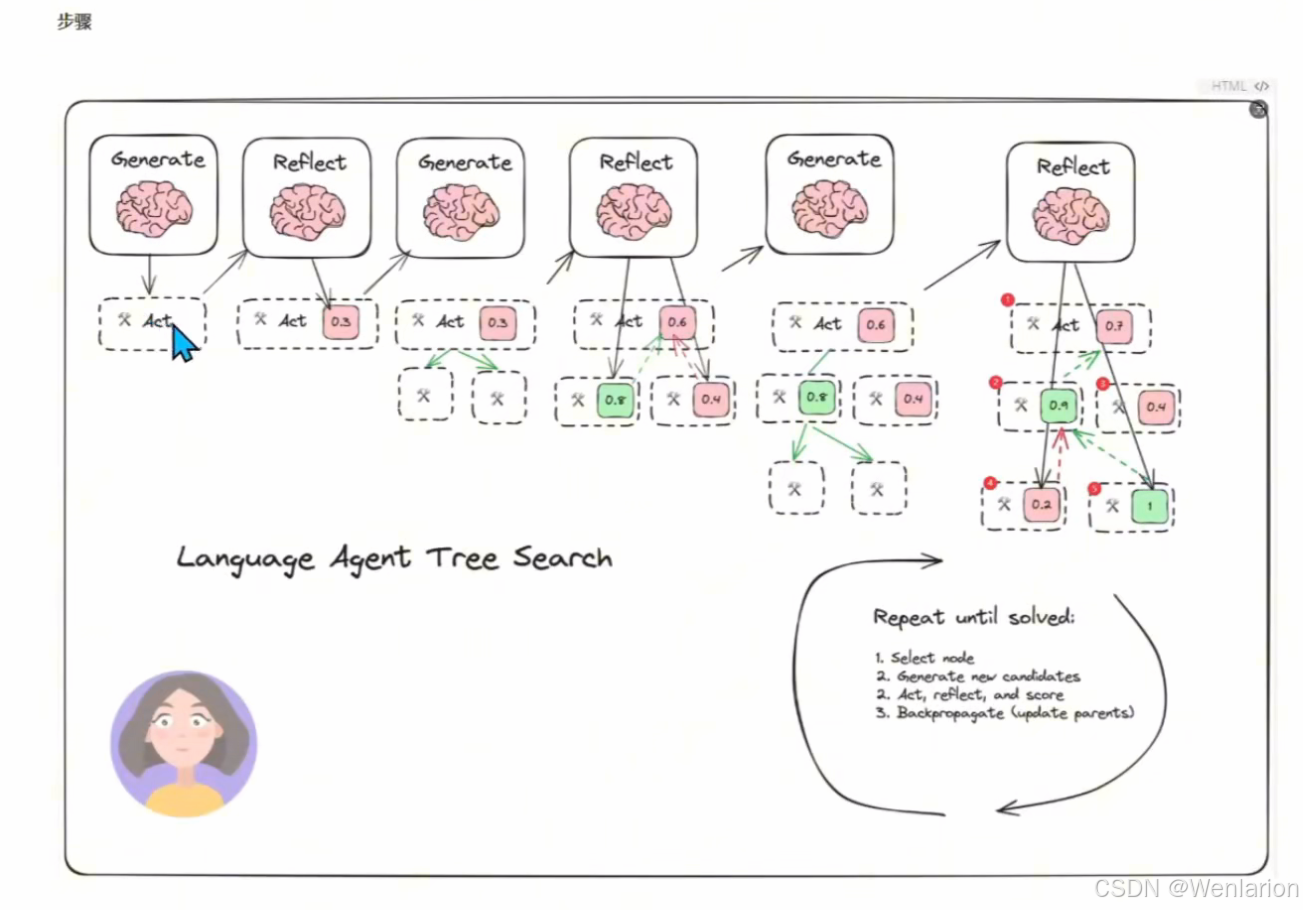
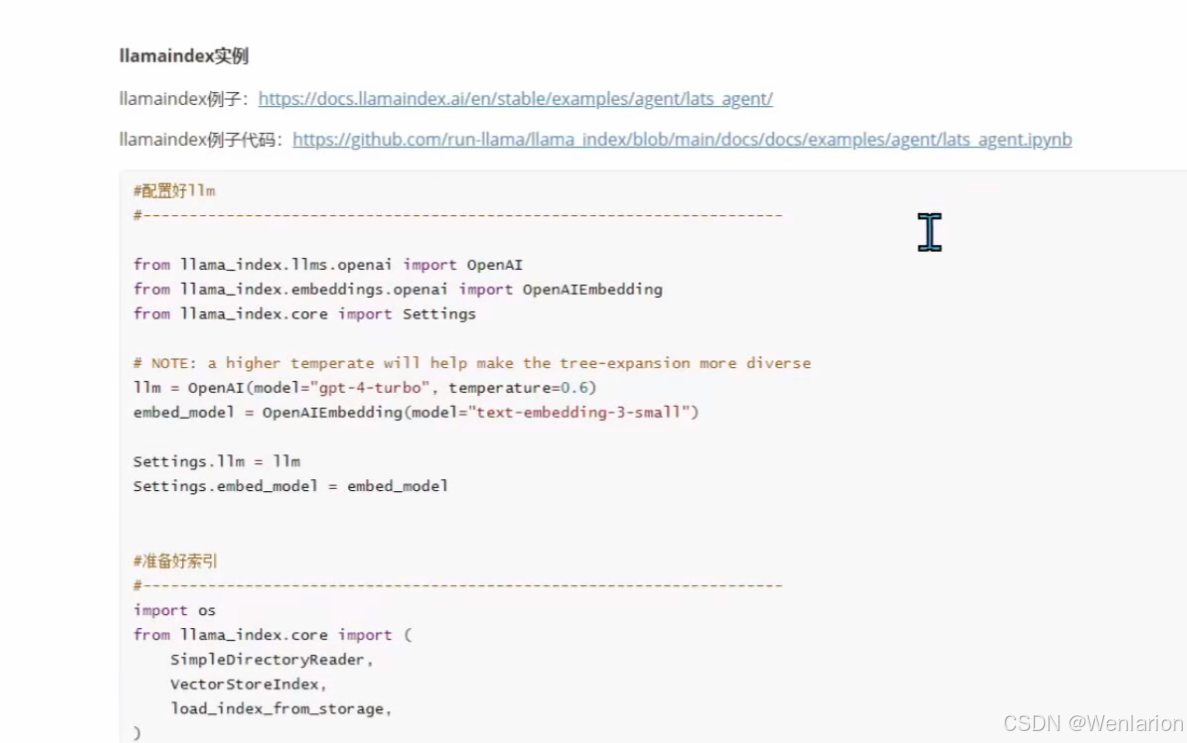
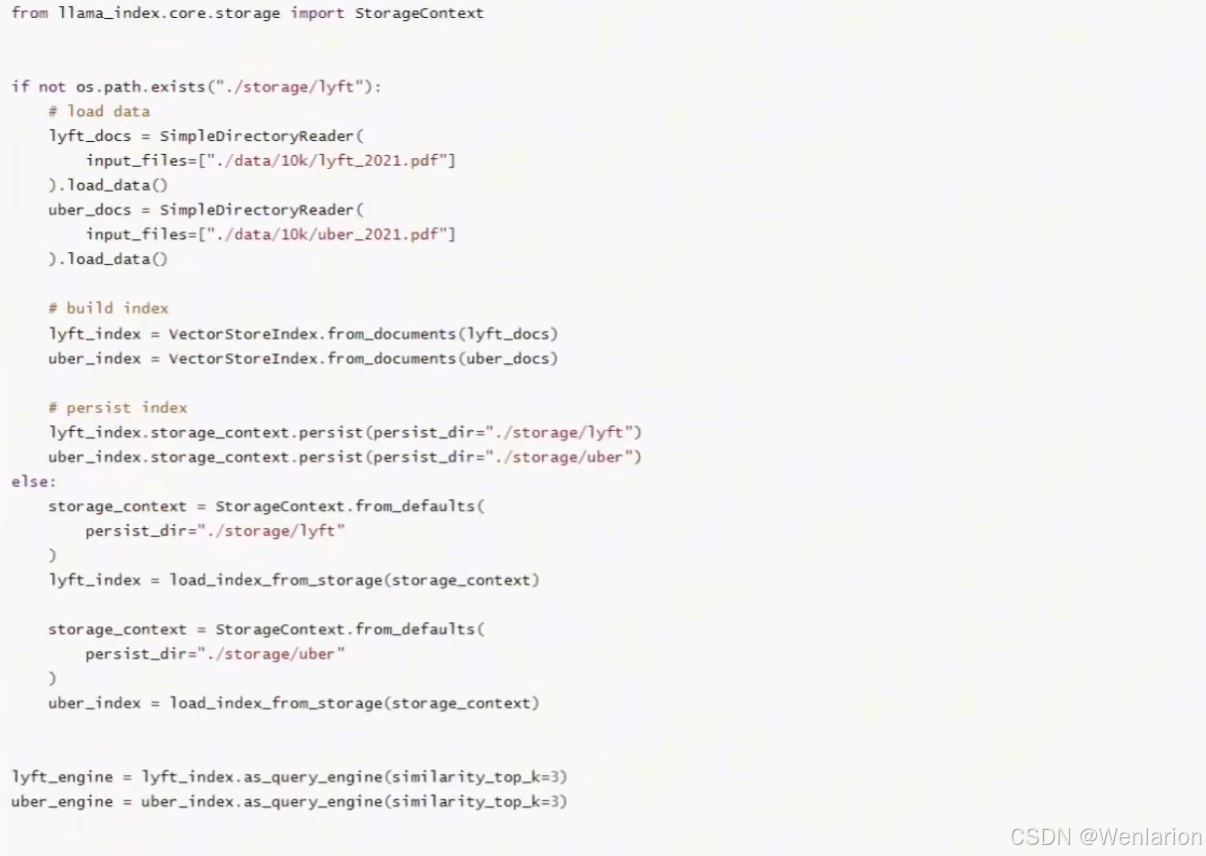
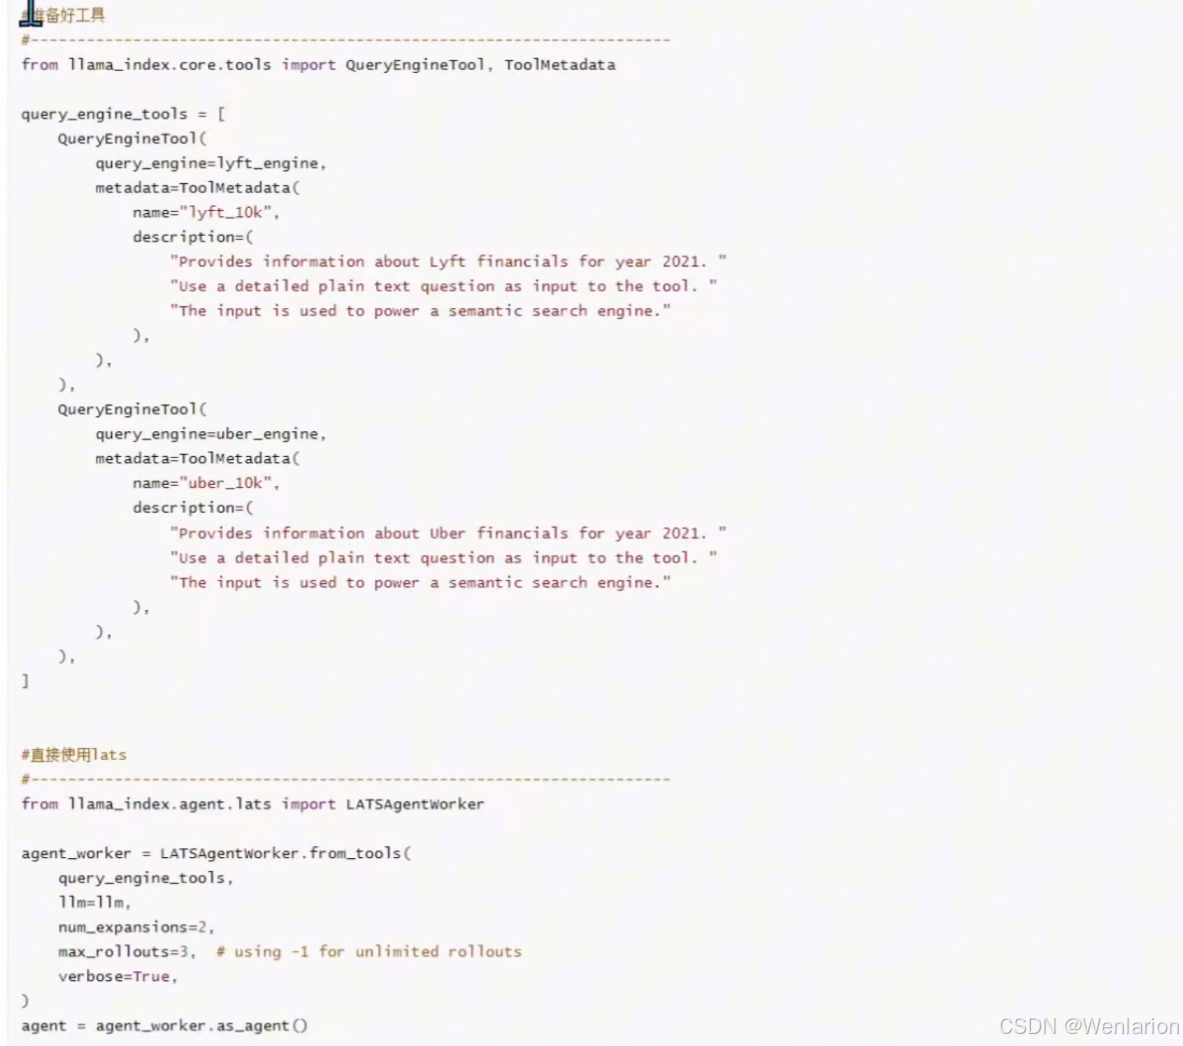
提示词模板:与 Reflection、Plan&solve、ReAct 的模板差异不大,核心区别是上下文中增加了对树搜索结果的评估和返回结果。
-
架构组成:由多轮 Basic Reflection、多个 Generator(生成器)和 Reflector(反射器)构成,支持复杂任务的深度探索与迭代优化。
Self-Discover 模式
-
论文:SELF-DISCOVER: Large Language Models Self-Compose Reasoning Structureshttps://arxiv.org/pdf/2402.03620
-
GitHub 项目:https://github.com/catid/self-discover?tab=readme-ov-file
核心目标
Self-Discover 旨在让大语言模型(LLM)自动发现解决复杂推理问题的内在推理结构,以应对传统提示方法难以处理的挑战。
核心原理
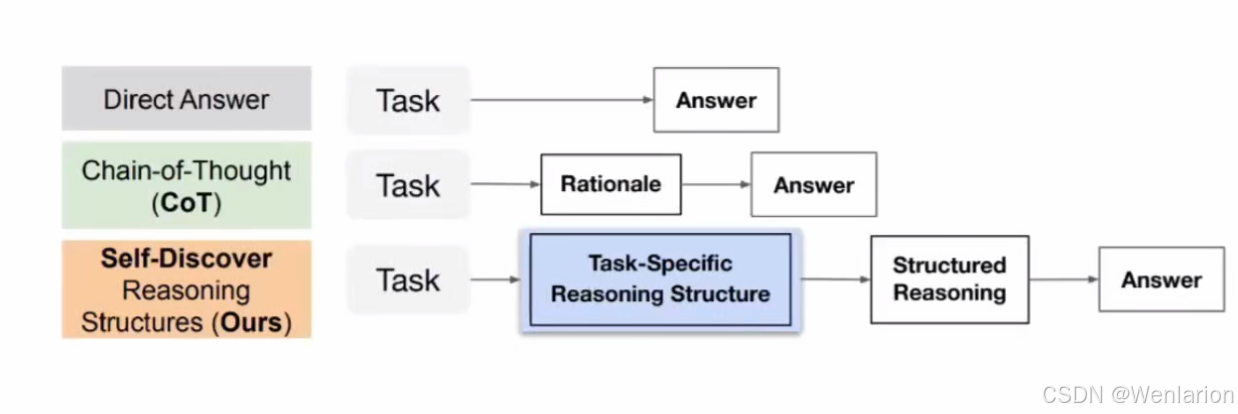
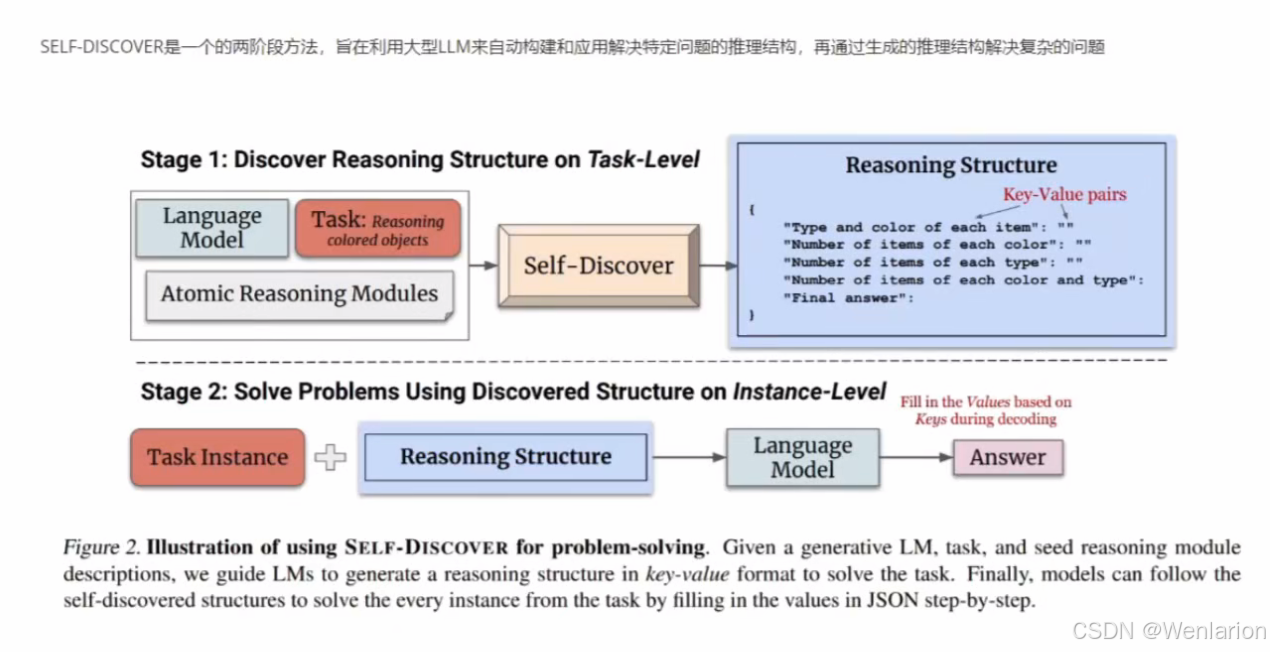
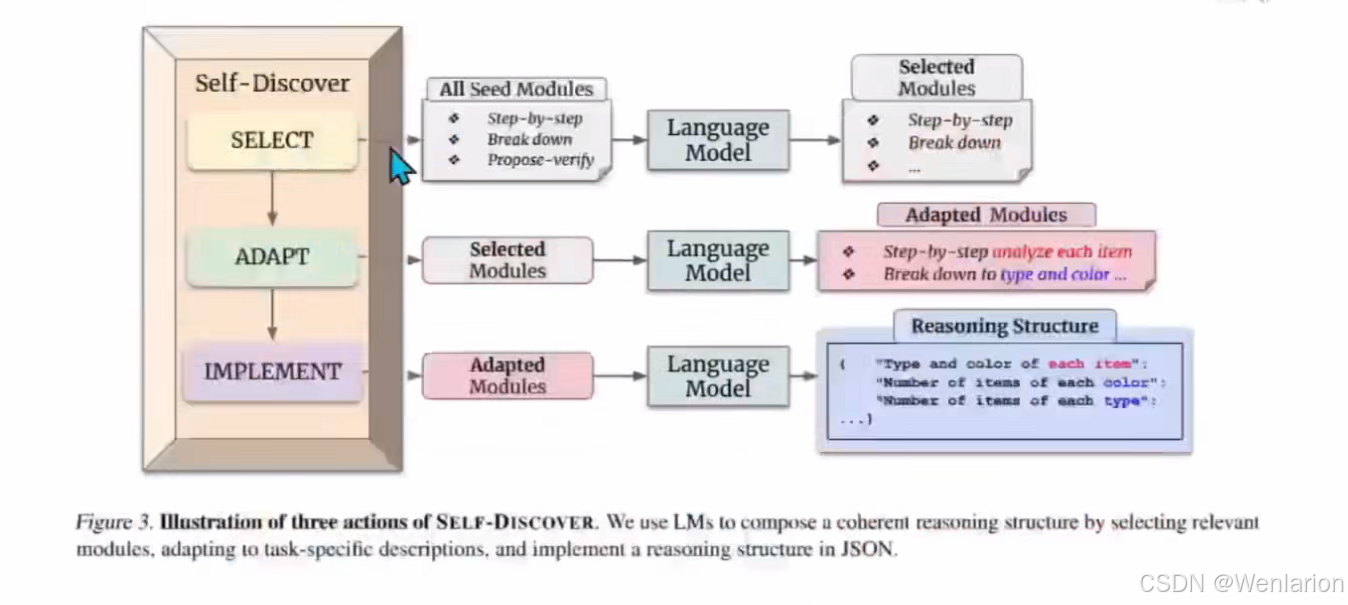
它的核心是一个自我发现过程:LLM 会选择多个原子推理模块(如批判性思维、逐步思考等),并将它们组合成一个明确的推理结构,供模型在解码时遵循。这相当于让模型为自己 “量身定制” 一套解题思路。
核心优点
-
增强复杂推理能力:显著提升了 LLM 处理复杂推理问题的能力,尤其是传统提示方法难以应对的场景。
-
性能显著提升:在代理推理和 MATH 等挑战性基准测试中,相比链式推理(CoT)效果提升了 32%。
-
效率大幅优化:推理计算量减少了 10 到 40 倍,效率超过了 CoT-Self-Consistency 等密集推理方法。
-
跨模型普适性:自我发现的推理结构在不同模型间具有良好的可迁移性,例如可以从 PaLM 2-L 迁移到 GPT-4,也可以从 GPT-4 迁移到 Llama2。
推理结构
该模式的设计灵感源于人类解决问题的思维方式:
-
检索经验:面对新问题时,人类会先从过往经验中寻找可能相关的知识和技能。
-
尝试应用:将这些知识和技能尝试应用到当前任务中。
-
组合技能:连接并组合多种个人技能和知识,形成完整的解决方案。
-
自动构建推理结构:让大语言模型(LLM)根据特定问题,自动发现并组合原子推理模块(如批判性思维、逐步思考等),形成一套定制化的推理结构。
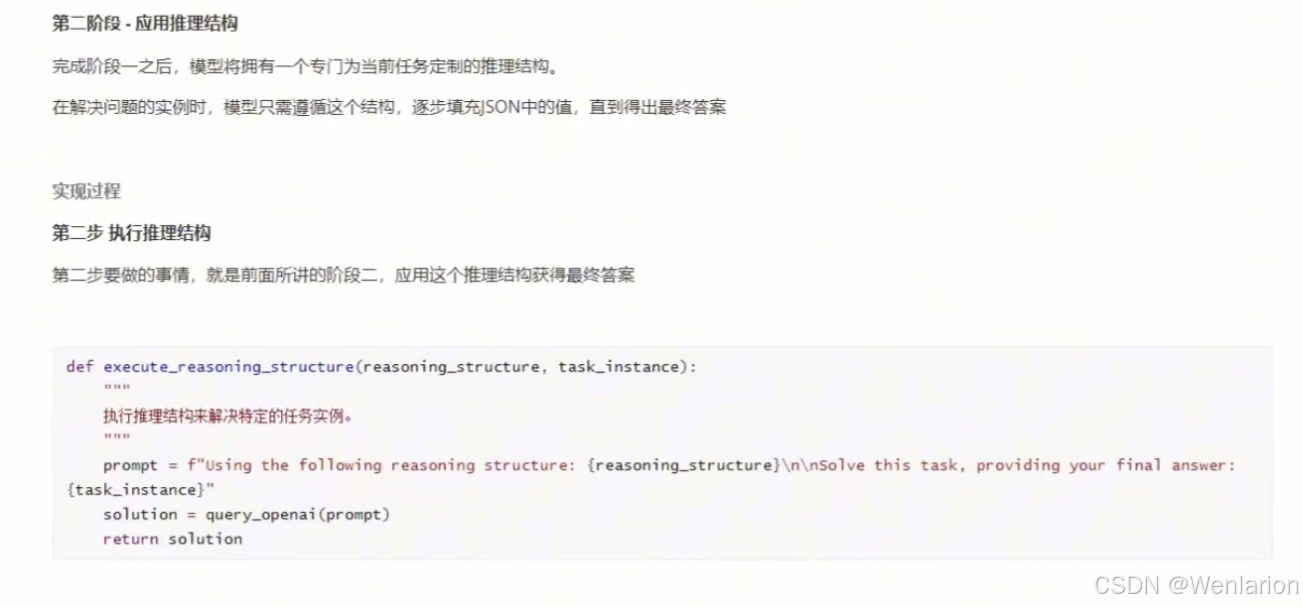
- 应用推理结构:利用生成的推理结构来解决复杂问题,从而获得更精准、高效的结果。
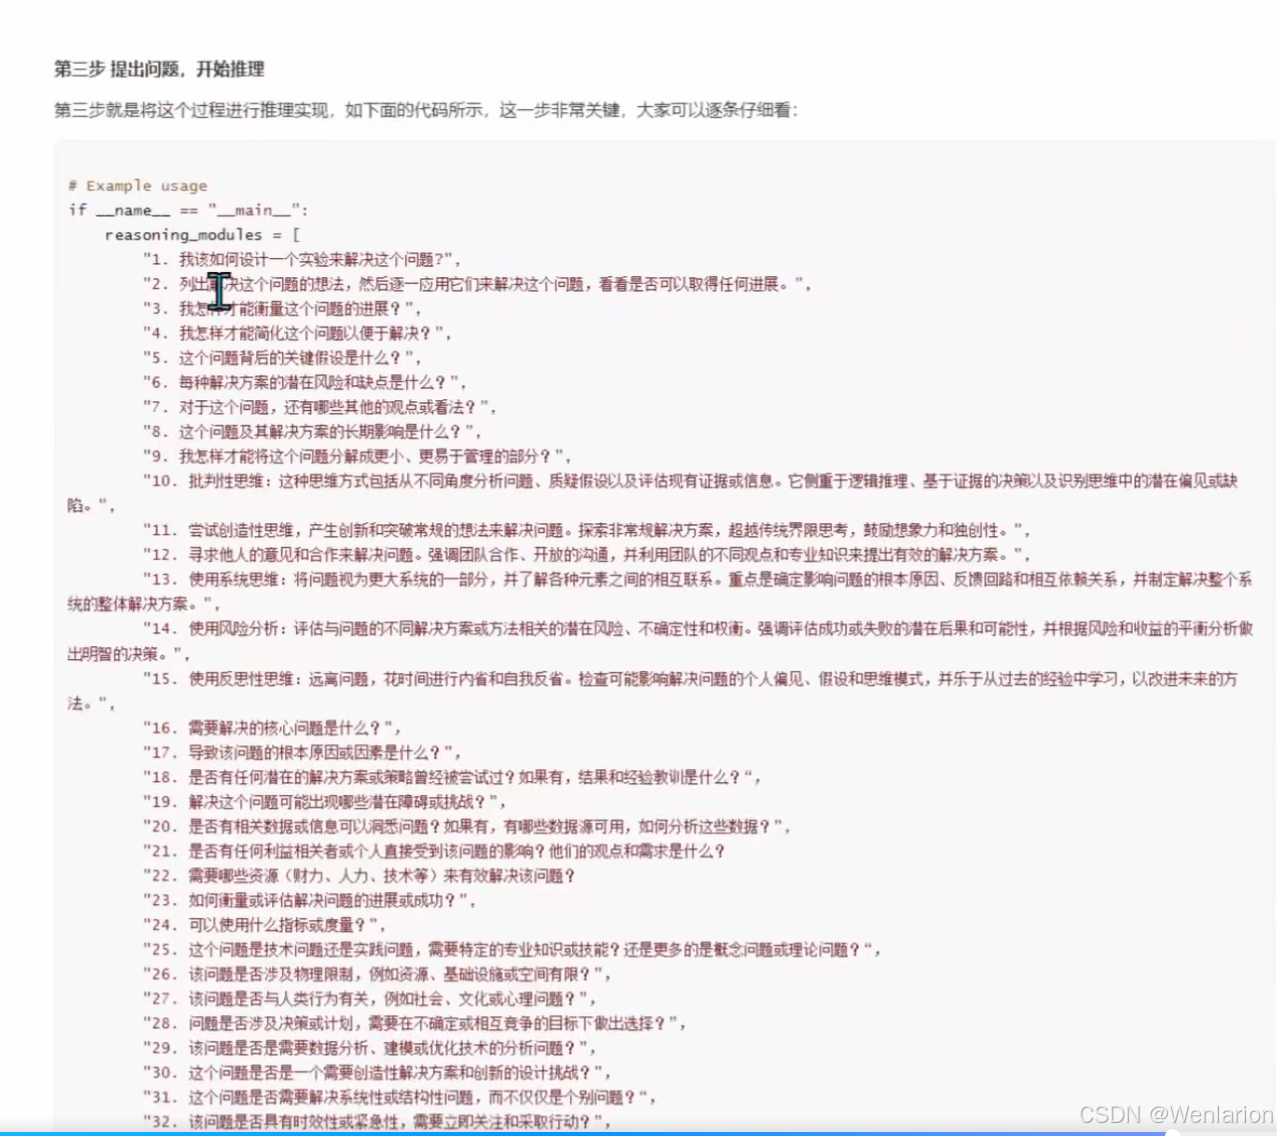
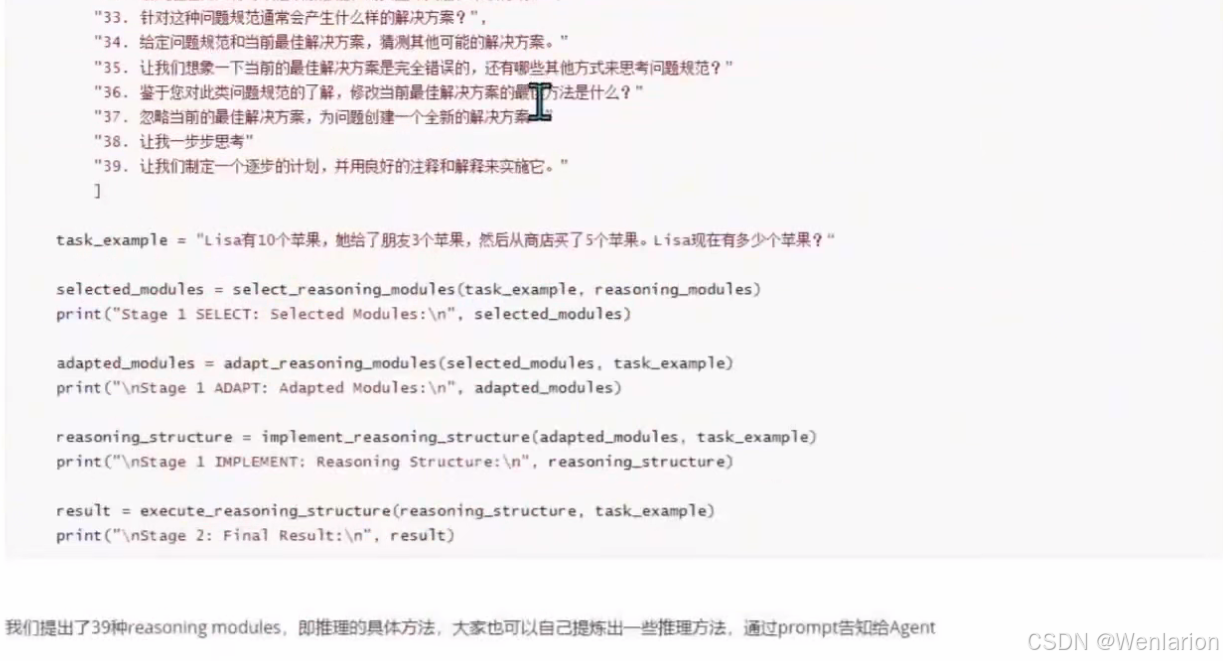
第一阶段:发现推理结构
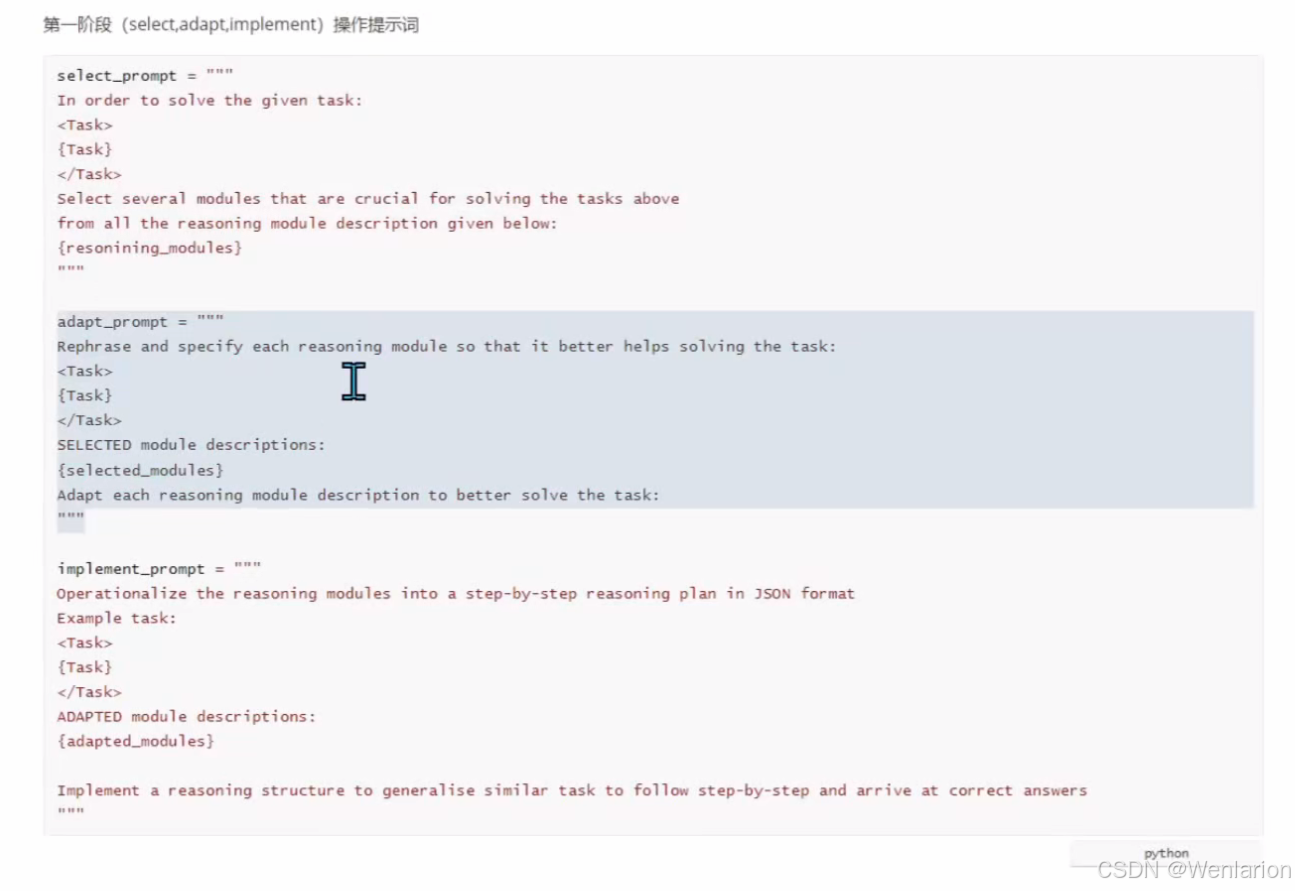
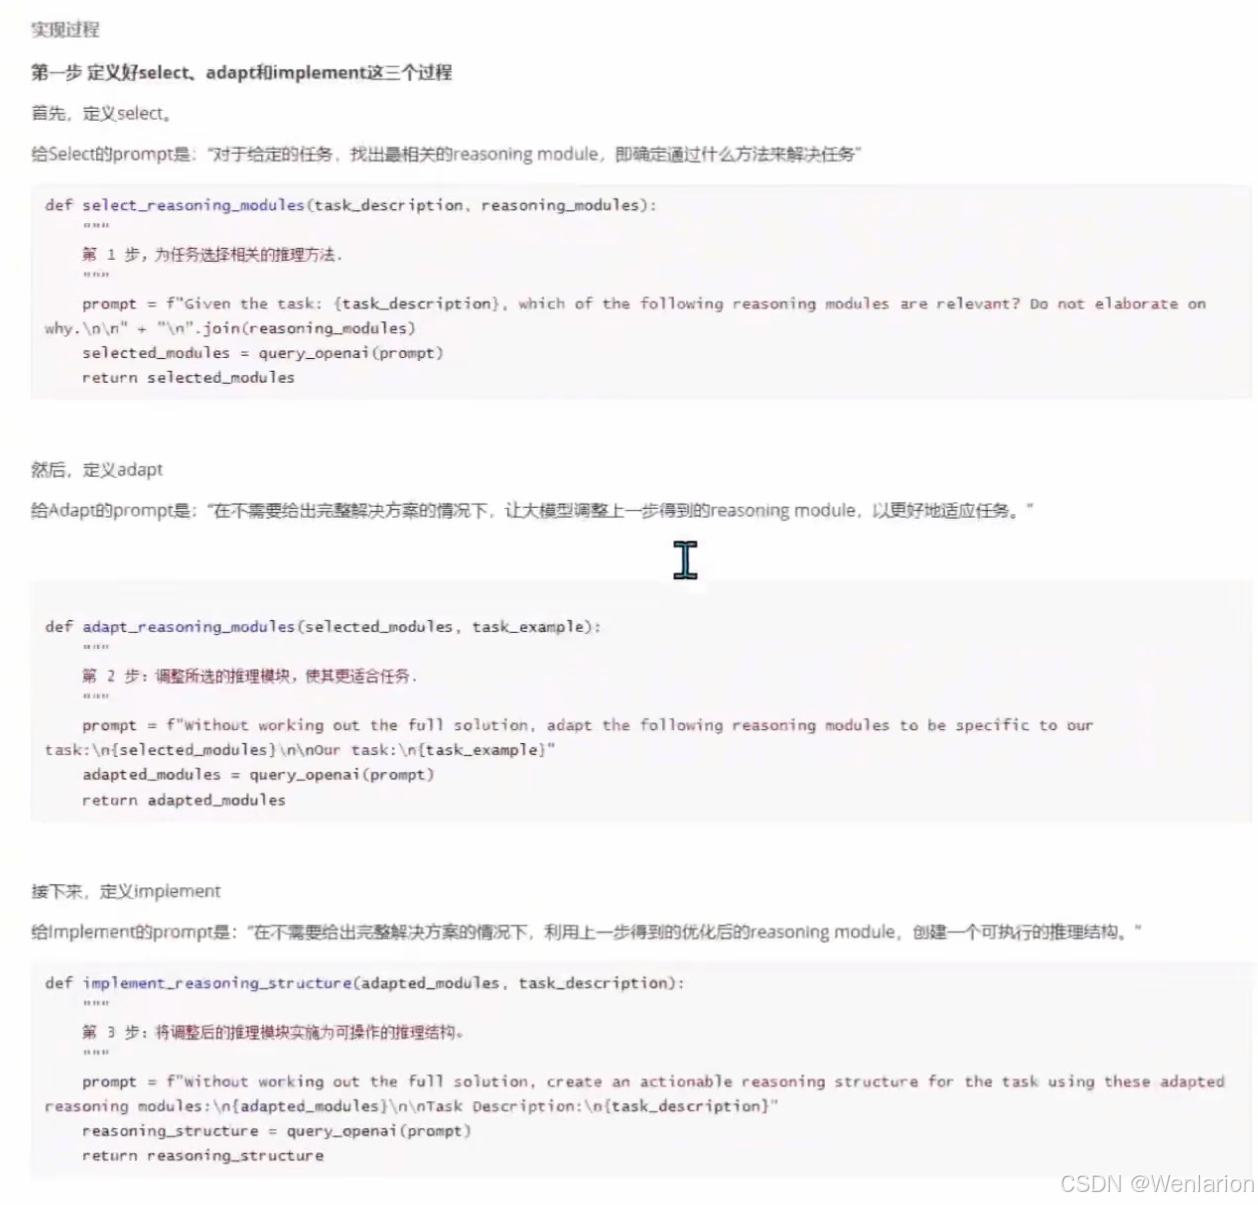
这一阶段的核心是让模型为特定任务自动生成一套定制化的推理计划,包含三个关键操作:
1. 选择(Select)
输入:39 个预定义推理模块的描述(如 “批判性思维”、“步骤分解”、“提出并验证” 等),以及一些带答案的任务示例。
目标:模型根据这些信息,选择最适合解决当前任务的几个关键推理模块。
输出:一个或多个推理模块的组合。
2. 适应(Adapt)
输入:在 “选择” 阶段挑出的模块描述,以及一些无答案的任务示例。
目标:调整和细化每个模块的描述,使其更贴合当前具体任务的需求。
输出:经过改写、适配后的推理模块描述。
3. 实施(Implement)
输入:一个人工编写的示例推理结构,展示如何按顺序执行模块以解决问题。
目标:将调整后的推理模块组合成一个 JSON 格式的分步推理计划。
输出:一个可直接应用于当前任务的、结构化的推理计划。
2、Agent框架
论文 THE LANDSCAPE OF EMERGING AI AGENT ARCHITECTURES FOR REASONING, PLANNING, AND TOOL CALLING: A SURVEY: https://arxiv.org/pdf/2404.11584
李飞飞论文 AGENT AI: SURVEYING THE HORIZONS OF MULTIMODAL INTERACTION: https://arxiv.org/pdf/2401.03568
安全提醒
请注意,Agent 如果有文件系统访问权限,这在所有情况下都是不安全的,要在 docker 容器中运行
2.1、Single Agent 框架
优点:
- 简单性:设计、实现和管理相对简单,因为不需要考虑多个智能体之间的交互和协调问题。
- 专业性:可以针对特定任务进行优化,专注于执行单一任务,效率较高。
- 易于开发:由于系统组件较少,开发和部署速度更快。
- 成本效益:相比多智能体系统,单智能体系统通常需要较少的计算资源。
缺点:
- 灵活性有限:对于需要多个智能体协作才能完成的复杂任务,单智能体系统可能无法提供最佳解决方案。
- 扩展性差:增加新功能或适应新环境可能需要重构整个系统。一旦面临极其错综复杂、计算量密集的任务, Single-Agent 无疑会遭遇算力瓶颈,无法高效完成处理,性能将大打折扣。
- 鲁棒性低:系统对故障的容忍度较低,单点故障可能导致整个系统失效
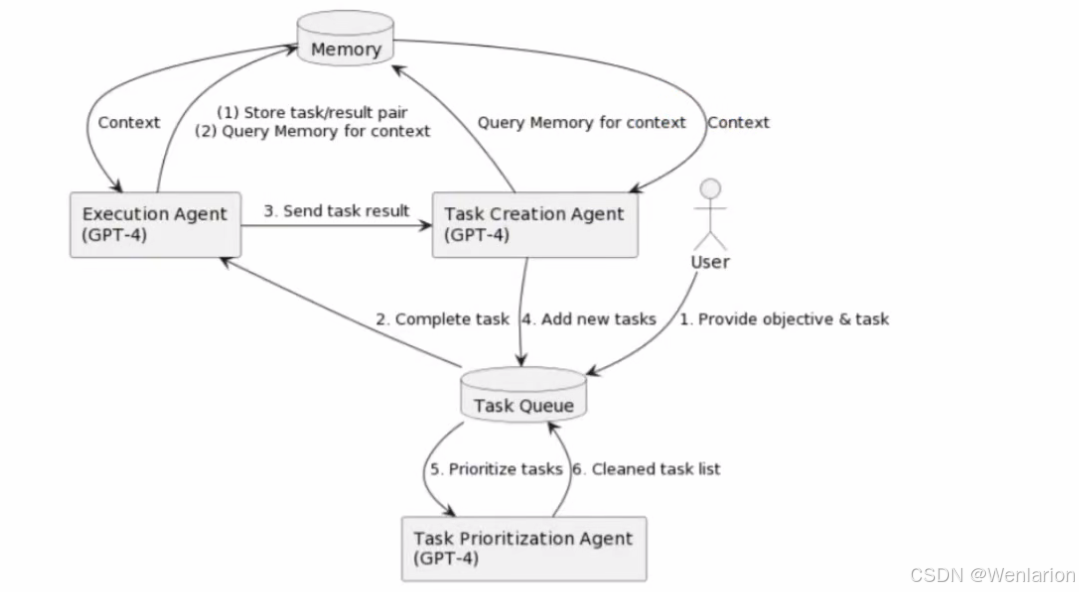
BabyAGI
github 项目: https://github.com/yoheinakajima/babyagi
文档: https://yoheinakajima.com/birth-of-babyagi
babyAGI 决策流程: 1) 根据需求分解任务;2) 对任务排列优先级;3) 执行任务并整合结果;亮点:作为早期 agent 的实践,babyagi 框架简单实用,里面的任务优先级排序模块是一个比较独特的 feature,后续的 agent 里大多看不到这个 feature
AutoGPT
github 项目:https://github.com/Significant-Gravitas/AutoGPT文档:https://docs.agpt.co/
AutoGPT 定位类似个人助理,帮助用户完成指定的任务,如调研某个课题。AutoGPT 比较强调对外部工具的使用,如搜索引擎、页面浏览等。
同样,作为早期 agent,autoGPT 麻雀虽小五脏俱全,虽然也有很多缺点,比如无法控制迭代次数、工具有限。但是后续的模仿者非常多,基于此演变出了非常多的框架
HuggingGPT
论文:https://arxiv.org/pdf/2303.17580github 项目:https://github.com/microsoft/JARVIS
由浙大 & 微软联合发布的一个大模型协作系统。研究者提出了用 ChatGPT 作为任务规划器,连接 HuggingFace 社区中的各种 AI 模型,完成多模态复杂任务。整个过程,只需要做的是:用自然语言将你的需求输出。
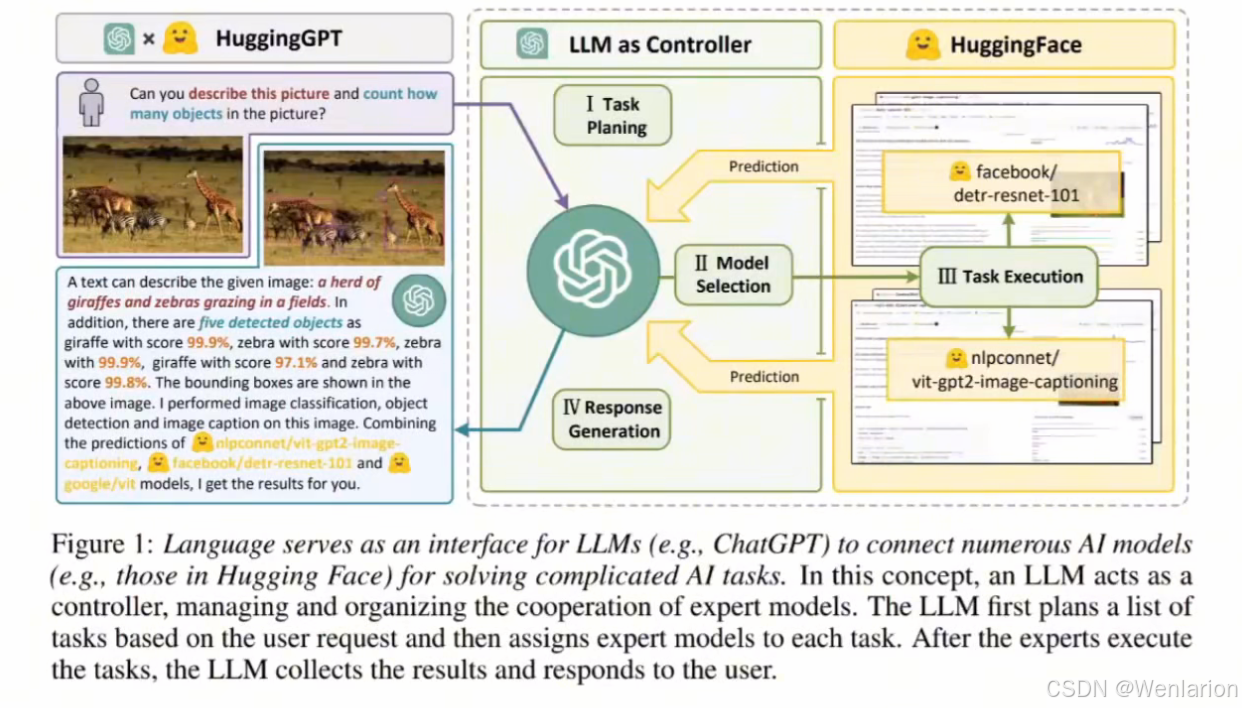
HuggingGPT 工作原理说明
通过以下四个阶段来完成工作流程:
-
任务规划:使用 ChatGPT 分析用户请求,将其分解为多个子任务,并规划任务顺序和依赖关系。
-
模型选择:根据 HuggingFace 中可用的功能描述选择模型。
-
任务执行:使用所选的 AI 模型执行每个子任务。
-
响应生成:根据 AI 模型执行结果进行总结和输出。
HuggingGPT 的工作原理可以概括为以下几点:
-
语言作为接口:HuggingGPT 将语言作为连接 LLM 和 AI 模型的通用接口,通过将模型描述结合到提示中,使 LLM 能够管理 AI 模型,如计划、调度和合作。
-
任务规划:LLM 首先解析用户请求,将其分解为一系列结构化任务,并确定这些任务的依赖关系和执行顺序。
-
模型选择:LLM 根据 HuggingFace 中的模型描述,将解析后的任务分配给专家模型。
-
任务执行:每个专家模型在推理端点上执行所分配的子任务,并将执行信息和推理结果记录到 LLM。
-
响应生成:最后,LLM 总结执行过程日志和推理结果,并将摘要返回给用户。
HuggingGPT 的亮点
HuggingGPT 与 AutoGPT 的不同之处在于,它可以调用 HuggingFace 上不同的模型来完成更复杂的任务,从而提高了每个任务的精确度和准确率。然而,总体成本并没有降低太多
GPT-Engineer
github 项目:https://github.com/gpt-engineer-org/gpt-engineer文档:https://gpt-engineer.readthedocs.io/en/latest/quickstart.html基于 langchain 开发,单一的工程师 agent,解决编码场景的问题。目的是创建一个完整的代码仓库,在需要时要求用户额外输入补充信息。亮点:code-copilot 的自动化升级版
AppAgent
github 项目:https://github.com/X-PLUG/MobileAgent论文:https://arxiv.org/pdf/2312.13771基于 ground-dino 以及 gpt view 模型做多模态处理的 Agent。亮点:基于视觉 / 多模态 appagent,os 级别的 agent,可以完成系统级别的操作,直接操控多个 app。由于需要系统权限、只支持安卓。
OS-Copilot
github 项目:https://github.com/OS-Copilot/OS-Copilot论文:https://arxiv.org/pdf/2402.07456文档:https://os-copilot.github.io/OS 级别的 Agent,FRIDAY 能够从图片、视频或者文本中学习,并且能够执行一系列的计算机任务,比如在 Excel 中绘图,或者创建一个网站。最重要的是,FRIDAY 能够通过做任务来学习新的技能,就像人类一样,通过不断的尝试和练习变得更擅长。亮点:自我学习改进,学习如何更有效地使用软件应用、执行特定任务的最佳实践等。
2.2、Multi-Agent 框架
相关论文:
-
Large Language Model based Multi-Agents: A Survey of Progress and Challenges:https://arxiv.org/pdf/2402.01680
-
Exploring Collaboration Mechanisms for LLM Agents: A Social Psychology View:https://arxiv.org/pdf/2310.02124
-
LONGAGENT: Scaling Language Models to 128k Context through Multi-Agent Collaboration:https://arxiv.org/pdf/2402.11550
将多个 Agent,按照一定的工作流进行编排,每个 Agent 负责不同的任务,即组成了多智能体架构(Multi-Agent)。这非常类似于我们实际中的工作流程或组织结构:拥有不同能力的人,负责不同的任务,每个工序执行的结果给到下一个工序,最终得到最后的任务成果。
举一个实际的例子
现在我们要设计一个智慧城市的数据分析工作流,由于数据来源比较复杂,并且要同时考虑模型的经济和分析地高效,可以设计三个不同的 Agent:
-
Agent-1:代理负责数据收集,从各种数据源(如气象部门、交通部门、环保部门的数据共享接口),收集原始数据,并进行去重、缺失值填补、格式转换等数据预处理工作。为了经济,使用 GPT-3.5 模型。
-
Agent-2:拿到 Agent-1 的结果,然后进行数据加载和深度数据分析,使用本地微调过的 Mistral 7B 模型。
-
Agent-3:则负责最终的数据可视化,将上一步的数据分析结果展示为可视化图表,并提供用户界面,可以选择允许用户与可视化结果进行交互,如筛选、放大、导出等。
这就是一个 multi agent 的例子,它允许不同角色的 Agent 完成任务,其中某个 Agent 擅长检索数据,余下的 Agent 则擅长数据分析或数据可视化。
优点
-
协作性:智能体之间可以相互通信和协作,共同完成复杂任务。
-
灵活性和适应性:能够适应多变的环境和任务需求,智能体可以自主调整行为和策略。
-
可扩展性:通过增加更多的智能体来扩展系统的功能和处理能力。
-
鲁棒性和容错性:系统中的智能体可以互为备份,提高了系统的可靠性和容错性。
-
分布式处理:可以分散处理任务,提高效率和吞吐量。
-
专业化:每个智能体可以拥有特定领域的专业知识,提高问题解决能力。
缺点
-
复杂性高:需要设计和实现智能体之间的通信、协调和协作机制,增加了系统的复杂性。
-
开发难度大:相比单智能体系统,多智能体系统需要更多的开发工作和专业知识。
-
成本较高:可能需要更多的计算资源和开发投入,简单的问题 single Agent 也能解决。
构成对比
-
单智能体:大语言模型(LLM) + 观察(obs) + 思考(thought) + 行动(act) + 记忆(mem)
-
多智能体:智能体 + 环境 + SOP + 评审 + 通信 + 成本
斯坦福虚拟小镇
-
github 项目:https://github.com/joonspk-research/generative_agents论文:https://arxiv.org/pdf/2304.03442
-
斯坦福虚拟小镇(Smallville)是一个由斯坦福大学和谷歌的研究人员创建的虚拟社区项目,旨在模拟人类行为。该项目通过使用大型语言模型(LLM),特别是 ChatGPT API,来实现 25 个 AI 智能体的自然语言交互与社会行为模拟。这些 AI 智能体在虚拟小镇中生活,他们有工作、会八卦、能组织社交活动、结交新朋友,甚至举办派对,每个 “小镇居民” 都有独特的个性和背景故事。
Smallville 虚拟小镇包含了多种公共场景,如咖啡馆、酒吧、公园、学校、宿舍、房屋和商店,智能体可以在这些场景中自由活动,进入或离开场所,甚至与其他智能体打招呼和互动。这些智能体的行为模仿了人类的日常活动,例如如果看到早餐着火了,会走过去关掉炉子;如果看到浴室有人,会在外面等待;如果遇到一个想交谈的个体,会停下来聊天。
虚拟小镇作为早期的 multi-agent 项目,很多设计也影响到了其他 multi-agent 框架,里面的反思和记忆检索 feature 比较有意思,模拟人类的思考方式。代理(Agents)感知他们的环境,当前代理所有的感知(完整的经历记录)都被保存在一个名为 “记忆流”(memory stream)中。基于代理的感知,系统检索相关的记忆,然后使用这些检索到的行为来决定下一个行为。这些检索到的记忆也被用来形成长期计划,并创造出更高级的反思,这些都被输入到记忆流中以供未来使用。
TaskWeaver
github 项目:https://github.com/microsoft/TaskWeaver文档:https://microsoft.github.io/TaskWeaver/docs/overview/
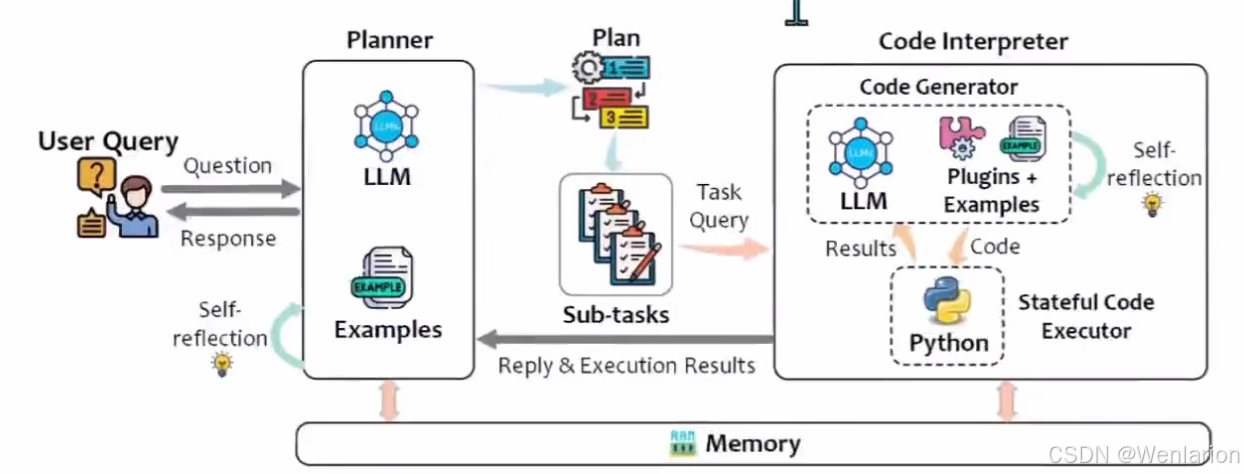
TaskWeaver,面向数据分析任务,通过编码片段解释用户请求,并以函数的形式有效协调各种插件来执行数据分析任务。TaskWeaver 不仅仅是一个工具,更是一个复杂的系统,能够解释命令,将它们转换为代码,并精确地执行任务。
TaskWeaver 的工作流程涉及几个关键组件和过程,以下是工作流程的概览:它由三个关键组件组成:规划器(Planner)、代码生成器(CG)和代码执行器(CE)。代码生成器和代码执行器由代码解释器(CI)组成
MetaGPT
github 项目:https://github.com/geekan/MetaGPT文档:https://docs.deepwisdom.ai/main/zh/guide/get_started/introduction.html
MetaGPT 是国内开源的一个 Multi-Agent 框架,目前整体社区活跃度较高,也不断有新功能推出,中文文档支持得很好。
核心能力
MetaGPT 输入一句话的 “老板需求”,可以输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等完整的交付物。
架构设计
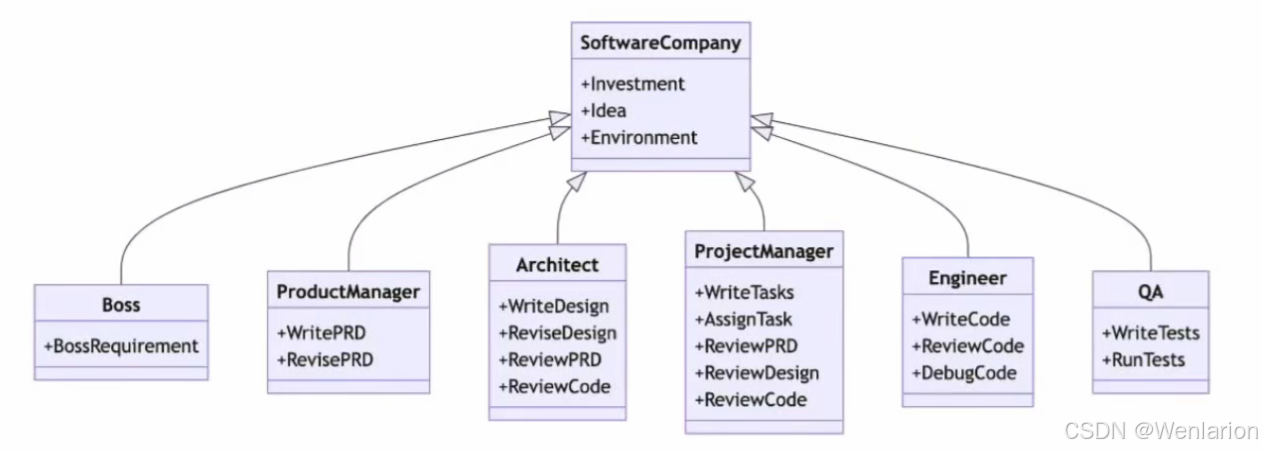
MetaGPT 以 “软件公司” 的方式组成,内部包含产品经理、架构师、项目经理、工程师、QA等角色,它提供了一套模拟软件公司完整运作流程与精心调配的 SOP(标准作业流程)。
-
架构图中各角色的职责:
-
Boss:提出老板需求(BossRequirement)
-
ProductManager:撰写产品需求文档(WritePRD)、修订 PRD(RevisePRD)
-
Architect:撰写设计文档(WriteDesign)、修订设计(ReviseDesign)、评审 PRD(ReviewPRD)、评审代码(ReviewCode)
-
ProjectManager:拆分任务(WriteTasks)、分配任务(AssignTask)、评审 PRD(ReviewPRD)、评审设计(ReviewDesign)、评审代码(ReviewCode)
-
Engineer:编写代码(WriteCode)、评审代码(ReviewCode)、调试代码(DebugCode)
-
QA:编写测试用例(WriteTests)、运行测试(RunTests)
-
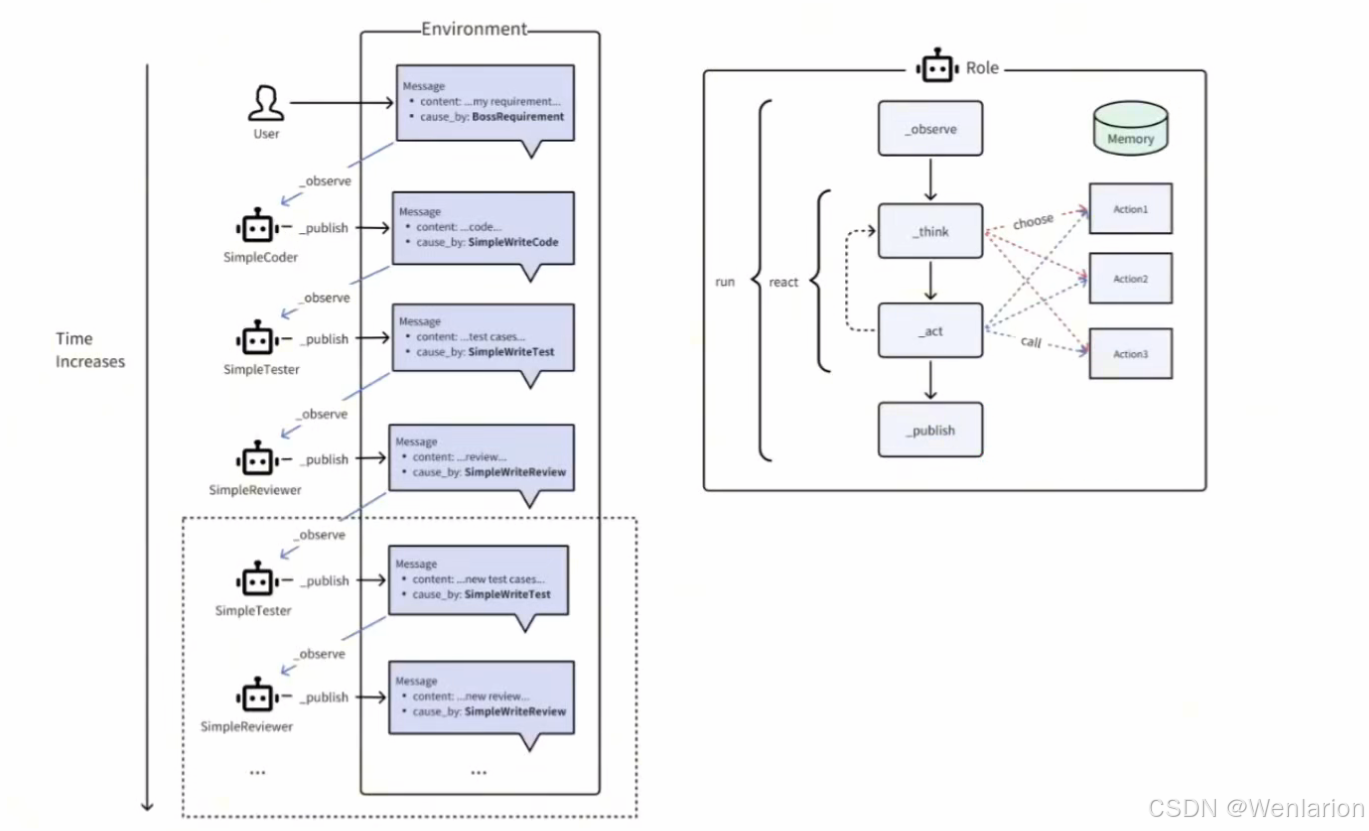
智能体基础运行逻辑
- 观察(_observe):Role 从 Environment 中获取 Message。如果该消息是由 Role 关注(Role_watch)的特定 Action 所触发,则视为有效观察,会触发后续的思考与操作。
- 思考(_think):Role 在自身能力范围内选择一个 Action,并将其设定为下一步要执行的任务。
- 执行(_act):Role 运行选定的 Action 并获取输出,将结果封装为新的 Message。
- 发布(publish_message):将封装好的 Message 发布到 Environment 中,完成一次完整的智能体运行周期。
对话模式
每个 Agent Role 会维护一个独立的消息队列,并根据自身设定来消费队列中的个性化数据。在完成一次 _act 执行后,该 Agent 会向全局环境发送一条新消息,供所有其他 Agent 共同消费。
微软 UFO(UI-Focused Agent)
github 项目:https://github.com/microsoft/UFO
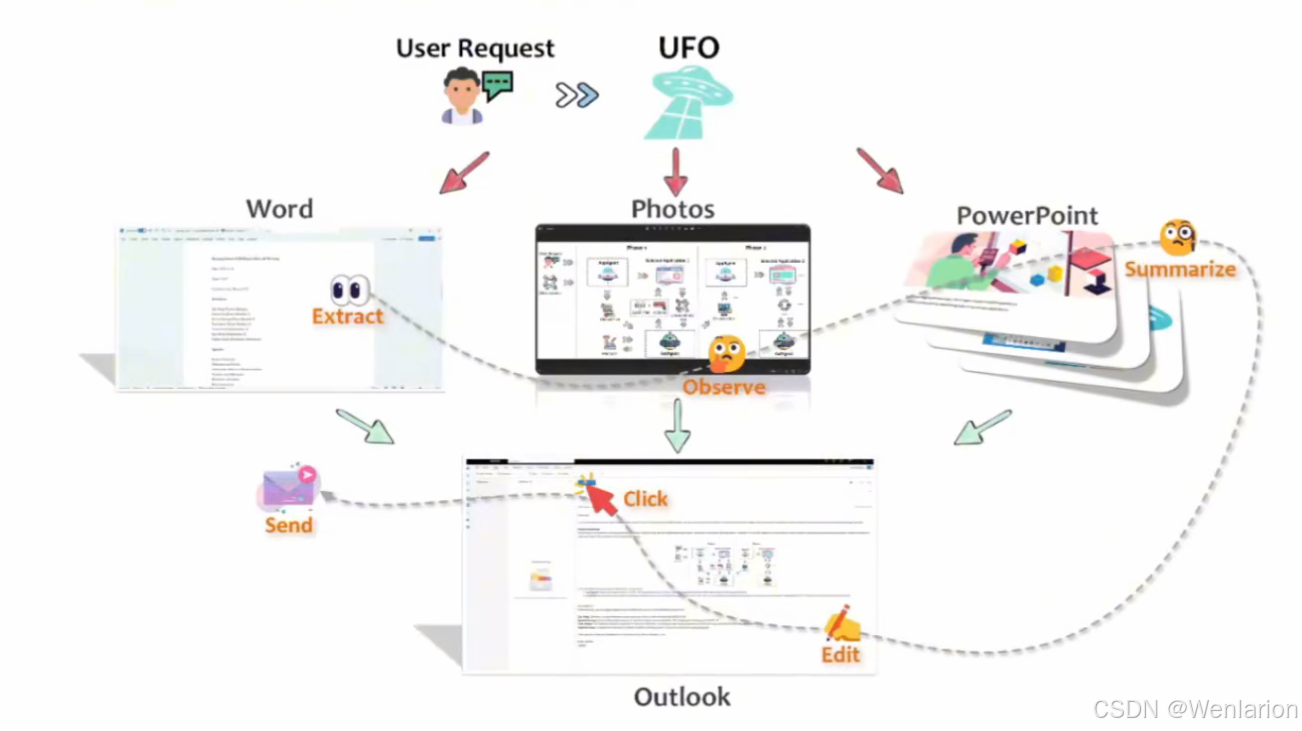
UFO 是面向 Windows 系统的 Agent,结合自然语言和视觉操作 Windows GUI
工作原理
- UFO 的工作原理基于先进的视觉语言模型技术,特别是 GPT-Vision,以及一个独特的双代理框架,使其能够理解和执行 Windows 操作系统中的图形用户界面(GUI)任务。
- 以下是 UFO 工作原理的详细解释:
-
双代理框架UFO 由两个主要代理组成,AppAgent 和 ActAgent,分别负责应用程序的选择与切换,以及在这些应用程序内执行具体动作。
-
应用程序选择代理(AppAgent):负责决定为了完成用户请求需要启动或切换到哪个应用程序。它通过分析用户的自然语言指令和当前桌面的屏幕截图来做出选择。一旦确定了最适合的应用程序,AppAgent 会制定一个全局计划来指导任务的执行。
-
动作选择代理(ActAgent):一旦选择了应用程序,ActAgent 就会在该应用程序中执行具体的操作,如点击按钮、输入文本等。ActAgent 利用应用程序的屏幕截图和控件信息来决定下一步最合适的操作,并通过控制交互模块将这些操作转化为对应用程序控件的实际动作。
-
-
控制交互模块 UFO 的控制交互模块是将代理识别的动作转换为应用程序中实际执行的关键组成部分。这个模块使 UFO 能够直接与应用程序的 GUI 元素进行交互,执行如点击、拖动、文本输入等操作,而无需人工干预。
-
多模态输入处理 UFO 能够处理多种类型的输入,包括文本(用户的自然语言指令)和图像(应用程序的屏幕截图)。这使 UFO 能够理解当前 GUI 的状态、可用控件和它们的属性,从而做出准确的操作决策。
-
用户请求解析 当接收到用户的自然语言指令时,UFO 首先解析这些指令,以确定用户的意图和所需完成的任务。然后,它将这个任务分解成一系列子任务或操作步骤,这些步骤被 AppAgent 和 ActAgent 按顺序执行。
-
应用程序间的无缝切换 如果完成用户请求需要多个应用程序的操作,UFO 能够在这些应用程序之间无缝切换。它通过 AppAgent 来决定何时以及如何切换应用程序,并通过 ActAgent 在每个应用程序中执行具体的操作。
-
自然语言命令到 GUI 操作的映射 UFO 的核心功能之一是将用户的自然语言命令映射到具体的 GUI 操作上。这一过程涉及到理解命令的意图,识别相关的 GUI 元素,以及生成和执行操作这些元素的动作。
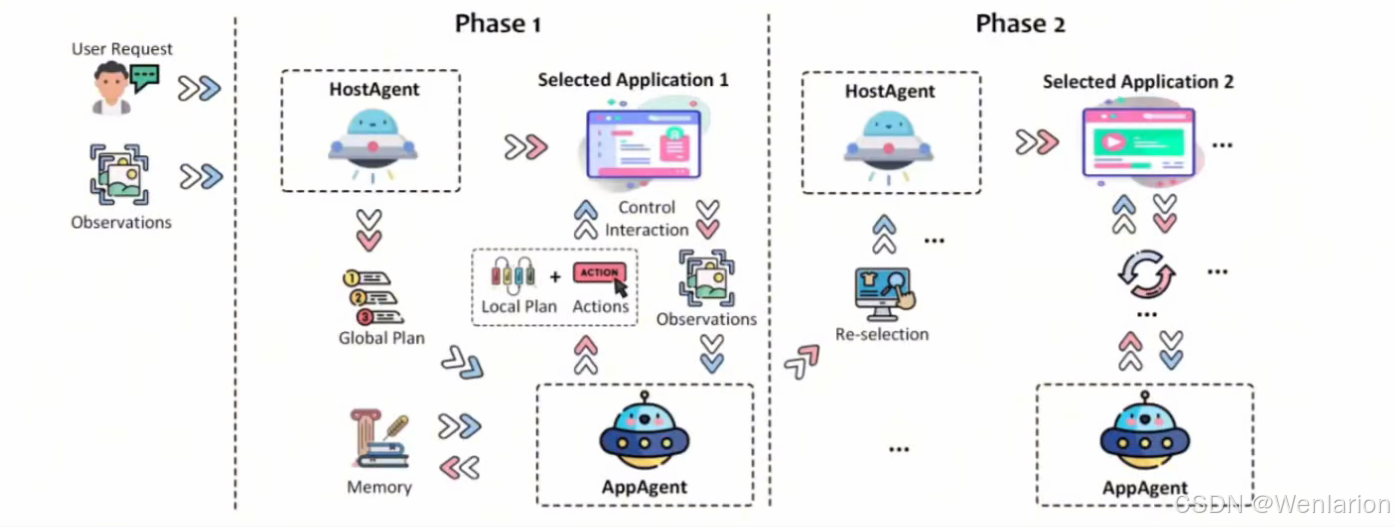 通过这种方式,UFO 可以自动完成从文档编辑和信息提取到电子邮件撰写和发送等一系列复杂的任务,大大提高用户在 Windows 操作系统中工作的效率和便捷性。
-
AgentScope
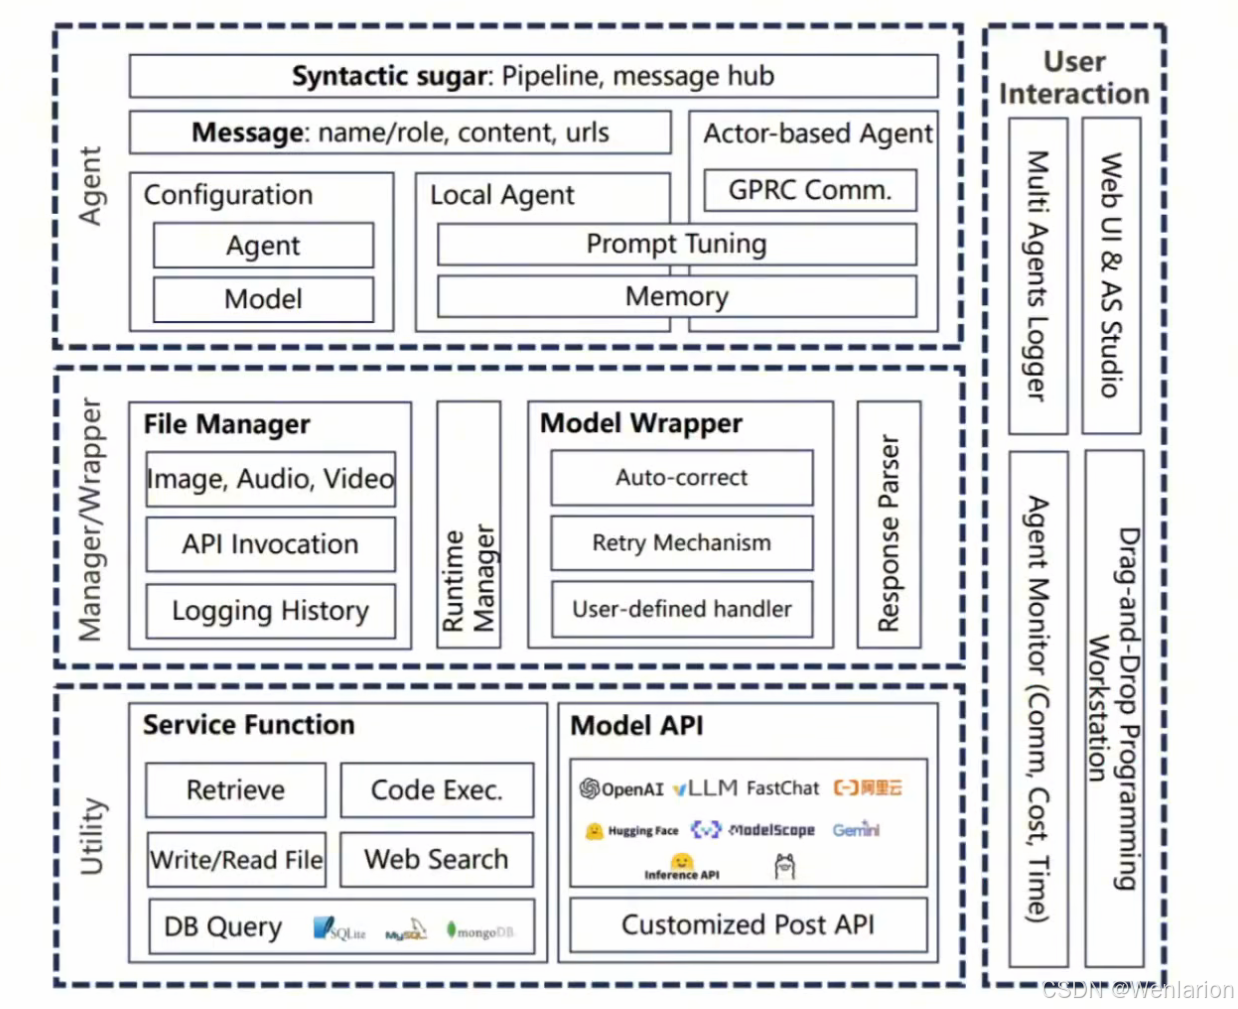
github 项目:https://github.com/modelscope/agentscope论文:https://arxiv.org/pdf/2402.14034agent 平台:https://agentscope.io/
AgentScope 是阿里开源的 Multi-agent 框架,亮点是支持分布式架构,并且在工程链路层面做了优化与监控。
-
Camel
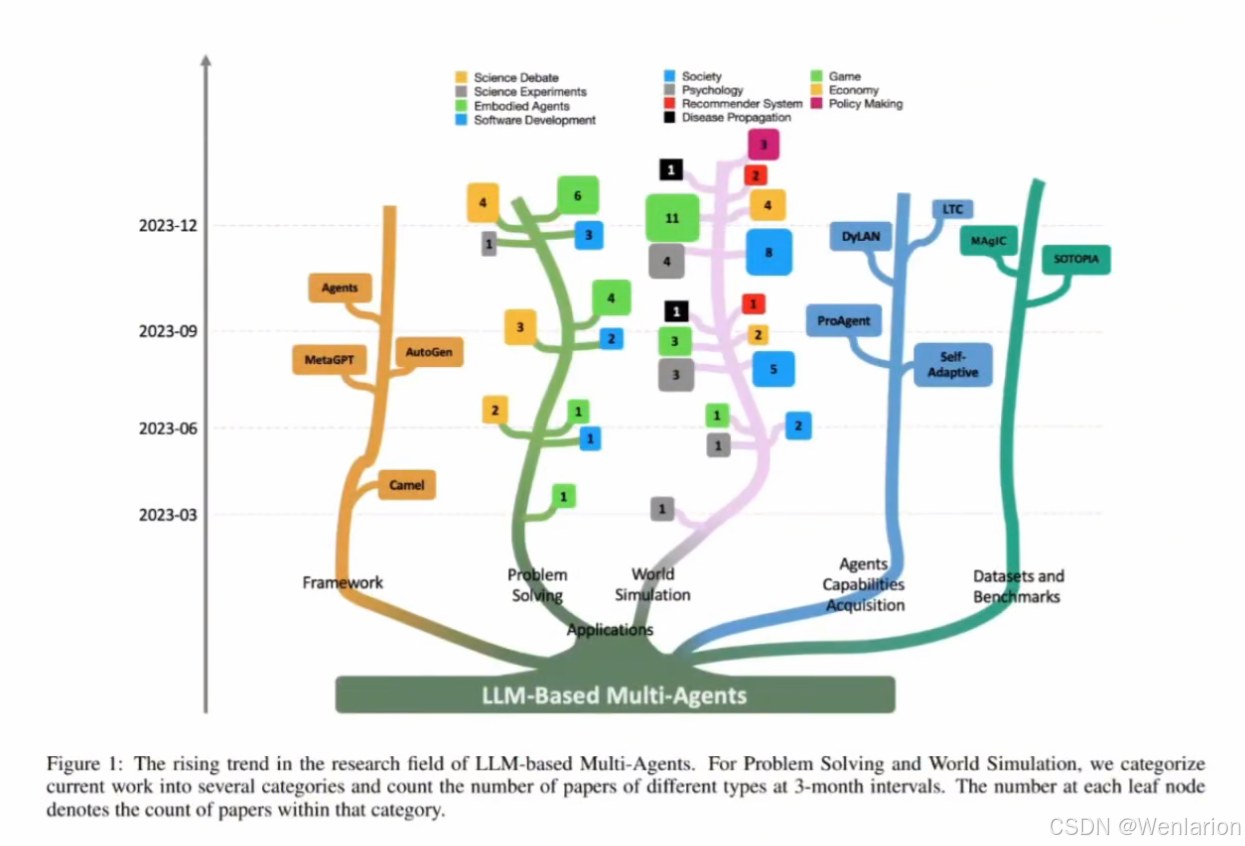
github 项目:https://github.com/camel-ai/camel这是一个早期的 Multi-Agent 项目,核心是实现 Agent 间的一对一对话。相关文档较少,除了 GitHub 仓库和一个站点外,公开的有用信息不多。
-
现状
-
本质定位:Multi-Agent 并非 Agent 框架的终极形态,它是当前大语言模型(LLM)能力有限背景下的产物,核心目的是通过多轮迭代来弥补 LLM 的能力缺陷,修正一些明显错误。不同框架之间仍存在很高的学习和开发成本。
-
未来趋势:随着 LLM 能力的持续提升,未来的 Agent 框架必然会朝着更简单、更易用的方向发展。
-
应用场景:目前已在游戏场景(NPC 对话、游戏素材生成)、内容生产、私域助理、系统级智能体、部分工作提效等领域得到应用。
-
现有成果:在利用多智能体解决复杂任务方面已取得积极进展,例如软件开发、多机器人系统、社会模拟、策略模拟和游戏模拟等。
-
跨学科研究:由于该领域的跨学科特性,吸引了从 AI 专家到社会科学、心理学和政策研究专家等各类研究者,相关论文数量正在快速增长。
-
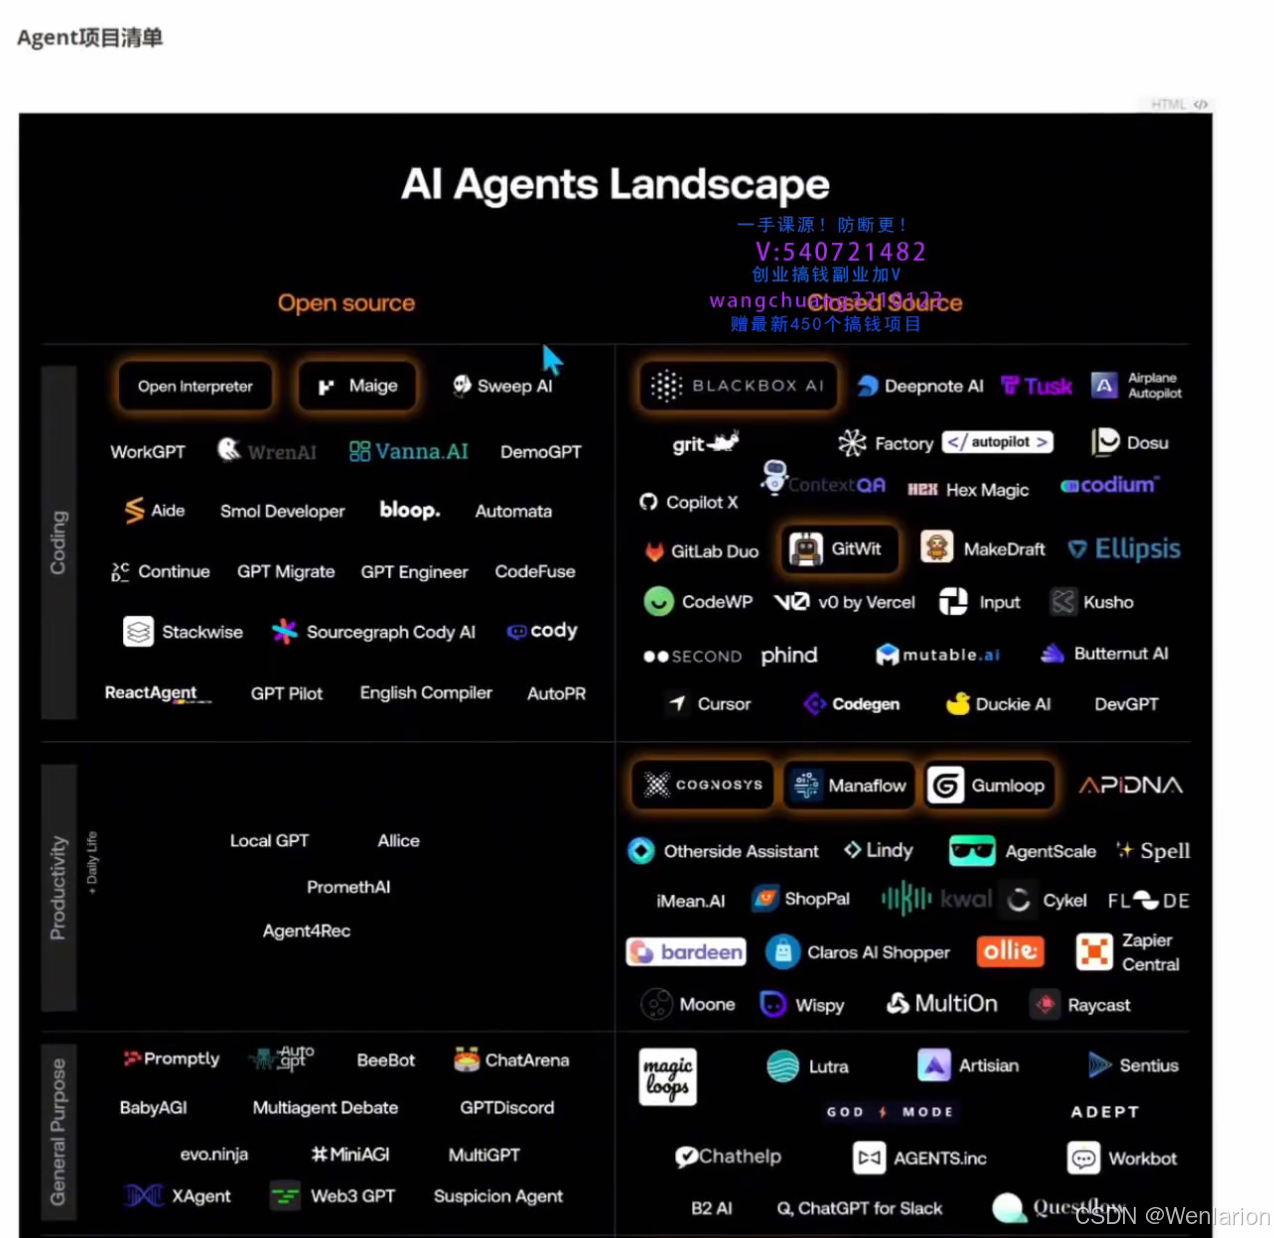
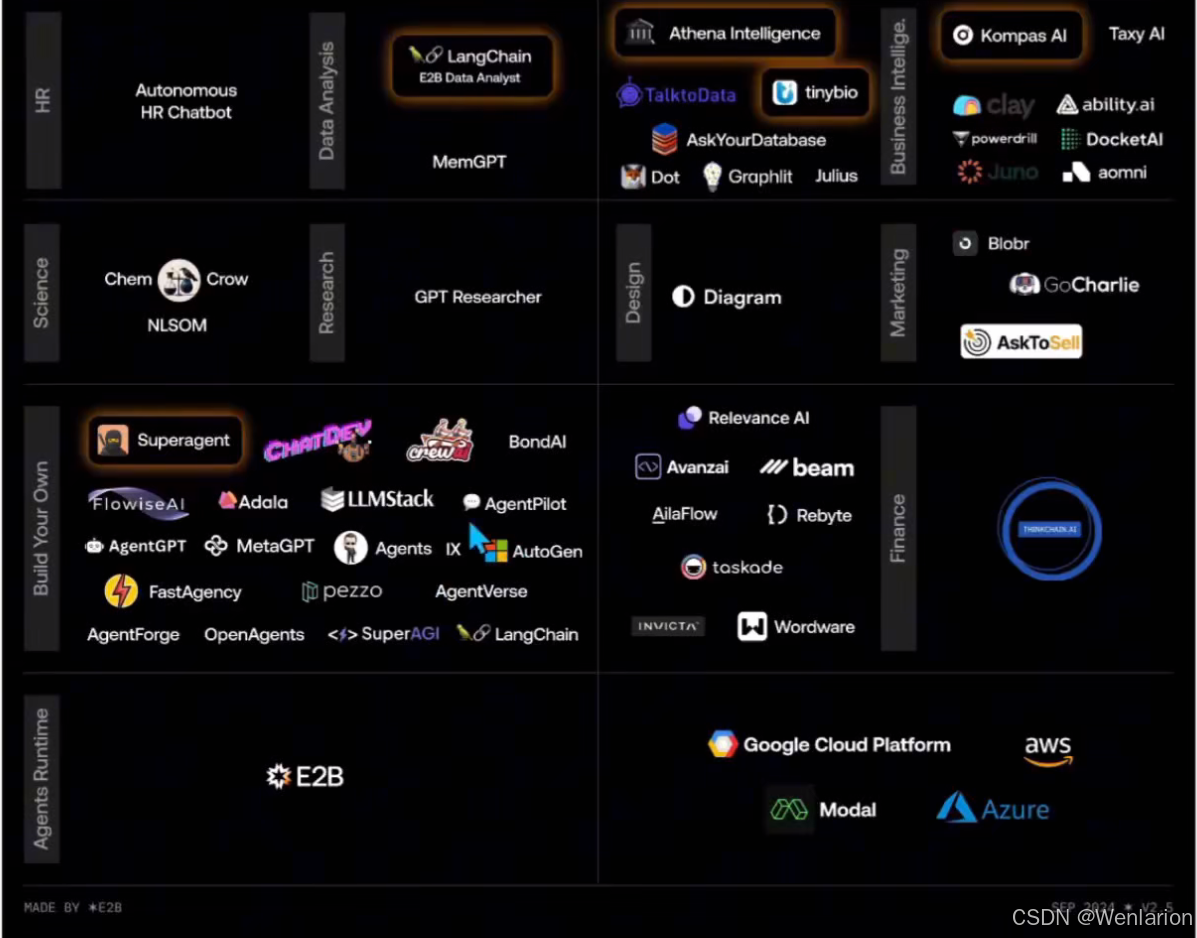
3、Agent项目清单
-
更多推荐

 23
 0
- 0


 已为社区贡献18条内容

所有评论(0)