
【机器学习】欠拟合、过拟合识别与L1/L2正则化实战(附代码)
在机器学习建模过程中,新手最容易踩的坑就是「欠拟合」和「过拟合」——明明模型原理懂了、代码也能跑通,但测试集准确率上不去,要么拟合不够、要么拟合过度,甚至出现“训练集满分、测试集翻车”的情况。
本文专门针对逻辑回归场景,从「欠拟合/过拟合的识别」「核心原因」「解决方法」三个维度,重点拆解工业界最常用的L1、L2正则化原理+实操,结合Python sklearn代码演示,通俗易懂、可直接复用,帮你快速避开拟合陷阱,提升模型泛化能力,适合机器学习初学者和入门实践者收藏学习!
一、先搞懂:什么是欠拟合、过拟合?
不管是线性回归,逻辑回归,还是决策树、随机森林,欠拟合和过拟合的核心本质是「模型复杂度与数据规律的匹配度失衡」——简单说,就是模型“学不会”或者“学太死”,我们用最通俗的语言+逻辑回归场景案例,帮你区分清楚。
1.1 欠拟合(Underfitting):模型“学不会”数据规律
核心定义
欠拟合是指模型的复杂度太低,无法捕捉到数据中的核心规律,不仅在测试集上表现差,在训练集上的表现也不好——相当于老师讲了一堆知识点,学生连基础内容都没学会,考试(训练集)和实战(测试集)都考不及格。
实战案例(线性回归演示,见下文)
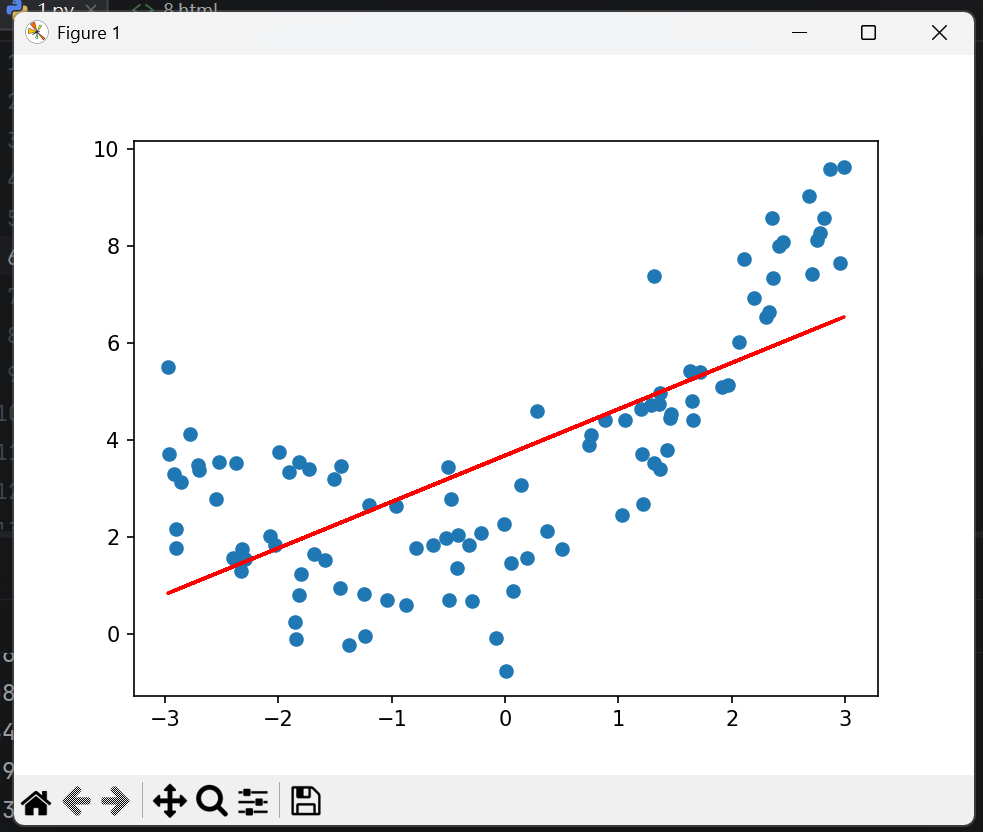
生成含噪声的非线性数据(y = 0.5x² + x + 2 + 噪声),用简单线性回归(仅用x作为特征)建模,模型只能拟合出一条直线,无法捕捉数据的二次曲线规律,导致拟合效果差、均方误差较大。
关键识别特征(必记)
-
训练集准确率低、测试集准确率也低(两者差距≤5%);
-
模型预测结果“一刀切”,无法区分边缘样本(如逻辑回归的概率输出大多集中在0或1,很少有0.3-0.7之间的中间值);
-
增加训练数据量,模型性能几乎没有提升。
核心原因
模型复杂度不足:逻辑回归本身是线性模型,若数据中存在非线性规律(如特征与类别概率呈非线性关联),未做特征工程,模型无法拟合;
特征不足或质量差:用于建模的特征太少、特征与目标变量相关性弱,或特征存在大量噪声,模型无法捕捉有效规律;
训练不充分:梯度下降迭代次数不足(max_iter太小),模型未找到最优权重,还没“学会”数据规律就停止训练。
1.2 过拟合(Overfitting):模型“学太死”,泛化能力差
核心定义
过拟合是指模型的复杂度太高,不仅捕捉到了数据中的核心规律,还把训练数据中的噪声、异常值当成了“规律”去拟合——相当于学生死记硬背考试题库,考试(训练集)能考满分,但遇到新题目(测试集)就翻车,泛化能力极差。
实战案例(线性回归演示,见下文)
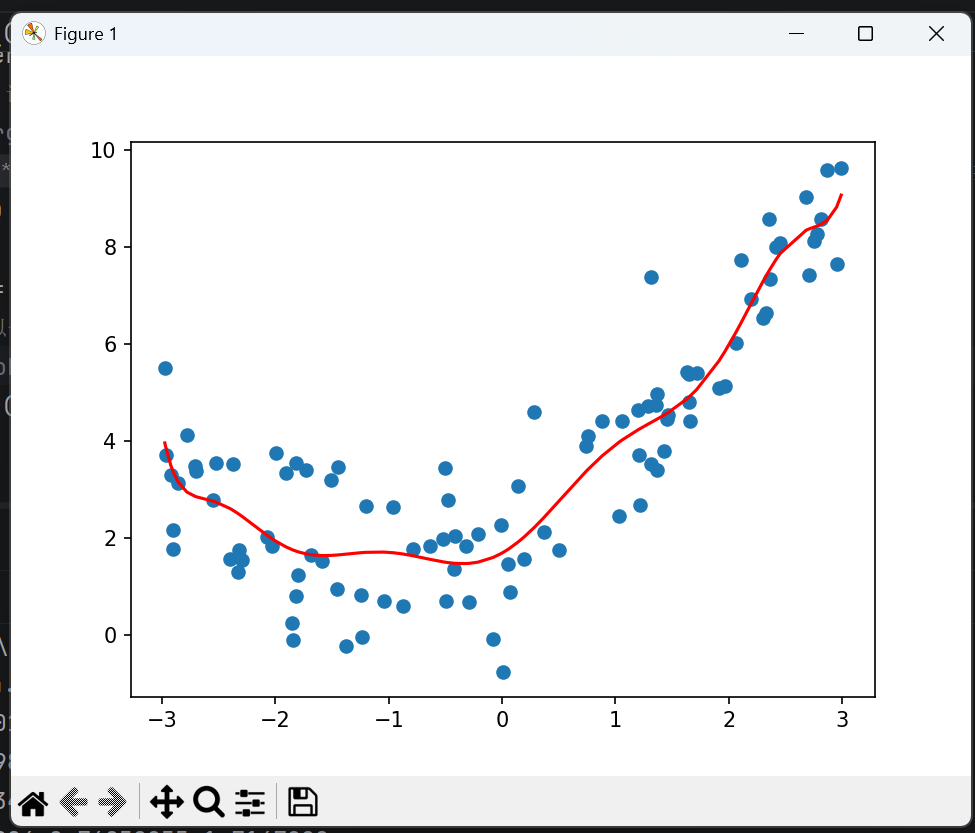
同样使用上述非线性数据,建模时加入x的1次到10次高次项,用线性回归拟合,模型会过度贴合每个数据点(包括噪声点),拟合曲线变得极度复杂,虽然训练集均方误差极小,但无法适配新数据,泛化能力极差。
关键识别特征(必记)
-
训练集准确率极高(≥95%),但测试集准确率明显偏低(两者差距≥10%);
-
逻辑回归的特征系数绝对值极大(部分系数达到几十、上百),说明模型过度依赖某些特征;
-
增加测试数据量,测试集准确率会明显提升(因为新数据中的噪声与训练集不同,模型“死记硬背”的规律失效)。
核心原因
模型复杂度过高:逻辑回归中,特征过多、未做特征筛选,或未使用正则化,导致模型过度拟合训练数据;
训练数据不足或失衡:训练样本太少,或正负类样本比例悬殊,模型容易把少量样本的规律当成普遍规律;
训练数据存在噪声/异常值:未对异常值、噪声数据进行处理,模型拟合了无效信息,干扰了核心规律的捕捉。
1.3 欠拟合vs过拟合 核心对比
|
对比维度 |
欠拟合 |
过拟合 |
|
核心表现 |
训练集、测试集准确率都低 |
训练集准确率高,测试集准确率低 |
|
模型复杂度 |
过低(无法捕捉数据规律) |
过高(拟合噪声和异常值) |
|
逻辑回归特征系数 |
系数绝对值普遍偏小,部分为0 |
系数绝对值极大,波动剧烈 |
|
解决核心思路 |
提升模型复杂度、补充有效特征 |
降低模型复杂度、抑制过拟合(正则化为主) |
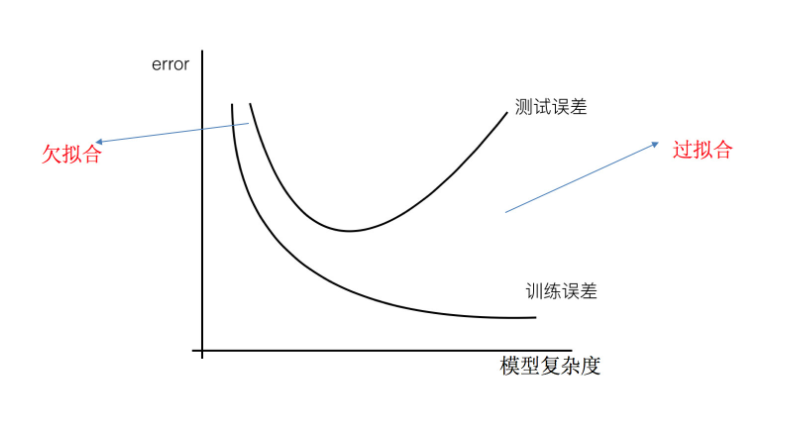
我们可以通过一张图来更清晰的观测到欠拟合和过拟合的区别,如下:
二、欠拟合的原因以及解决办法
欠拟合产生原因: 学习到数据的特征过少
2.1 提升模型复杂度(适配逻辑回归)
逻辑回归是线性模型,默认只能拟合线性规律,若数据存在非线性关联,可通过以下2种方式提升复杂度(优先选第一种,简单且不易过拟合):
-
特征工程(核心):构造非线性特征,如对连续特征做多项式扩展(比如把单个连续特征做平方处理、把两个不同的连续特征做相乘处理),或对类别特征做交叉特征,让线性模型能捕捉到非线性规律;
-
调整模型参数:逻辑回归中,可适当增加迭代次数(max_iter),确保模型充分训练,找到最优权重(避免训练不充分导致的欠拟合)。
2.2 补充有效特征(最直接)
若建模时使用的特征太少、相关性弱,可补充与目标变量强相关的特征,比如做肿瘤分类时,补充“肿瘤纹理、光滑度、凹陷度”等核心特征,让模型有足够的信息捕捉规律。
小技巧:用相关性分析(如Pearson相关系数)筛选特征,保留与目标变量相关性绝对值≥0.3的特征,剔除无关特征,避免特征冗余的同时,补充有效信息。
2.3 优化训练数据质量
若训练数据中存在大量噪声、异常值,会干扰模型对核心规律的捕捉,导致欠拟合,可做以下处理:
-
异常值处理:用箱线图、Z-score方法识别异常值,根据场景选择删除、替换(如用均值、中位数替换);
-
数据清洗:剔除重复样本、填补缺失值(连续特征用均值/中位数,类别特征用众数),确保数据的完整性和准确性。
2.4 实操演示(完整代码,可直接运行)
以下代码包含「欠拟合案例」「拟合良好案例」,对比演示欠拟合的解决过程,注释详细,新手可直接复制运行:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error  # 计算均方误差


def dm01_欠拟合():
    # 1. 准备x, y数据, 增加上噪声.
    # 用于设置随机数生成器的种子(seed), 种子一样, 每次生成相同序列.
    np.random.seed(666)
    # x: 随机数, 范围为 (-3, 3), 100个.
    x = np.random.uniform(-3, 3, size=100)
    # loc: 均值, scale: 标准差, normal: 正态分布.
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, size=100)
    # 2. 实例化 线性回归模型.
    estimator = LinearRegression()
    # 3. 训练模型
    X = x.reshape(-1, 1)
    estimator.fit(X, y)

    # 4. 模型预测.
    y_predict = estimator.predict(X)
    print("预测值:", y_predict)

    # 5. 计算均方误差 => 模型评估(欠拟合时均方误差较大)
    print(f'均方误差: {mean_squared_error(y, y_predict)}')
    # 6. 画图
    plt.scatter(x, y)           # 散点图(实际数据点)
    plt.plot(x, y_predict, color='r')   # 折线图(预测值, 拟合回归线)
    plt.title("欠拟合案例(简单线性回归拟合二次数据)")
    plt.show()                  # 具体的绘图


def dm02_模型ok():
    # 1. 准备x, y数据, 增加上噪声.
    # 用于设置随机数生成器的种子(seed), 种子一样, 每次生成相同序列.
    np.random.seed(666)
    # x: 随机数, 范围为 (-3, 3), 100个.
    x = np.random.uniform(-3, 3, size=100)
    # loc: 均值, scale: 标准差, normal: 正态分布.
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, size=100)
    # 2. 实例化 线性回归模型.
    estimator = LinearRegression()
    # 3. 训练模型(增加x²高次项,解决欠拟合)
    X = x.reshape(-1, 1)
    X2 = np.hstack([X, X ** 2])  # 拼接x和x²,补充非线性特征
    estimator.fit(X2, y)

    # 4. 模型预测.
    y_predict = estimator.predict(X2)
    print("预测值:", y_predict)

    # 5. 计算均方误差 => 模型评估(拟合良好时均方误差显著降低)
    print(f'均方误差: {mean_squared_error(y, y_predict)}')
    # 6. 画图
    plt.scatter(x, y)  # 散点图(实际数据点)
    # sort()  该函数直接返回一个排序后的新数组。
    # numpy.argsort()   该函数返回的是数组值从小到大排序时对应的索引值
    plt.plot(np.sort(x), y_predict[np.argsort(x)], color='r')  # 折线图(预测值, 拟合回归线)
    plt.title("拟合良好案例(补充x²高次项,解决欠拟合)")
    plt.show()  # 具体的绘图


# 运行代码,对比欠拟合与拟合良好的效果
if __name__ == '__main__':
    dm01_欠拟合()
    dm02_模型ok()
第一种情况:欠拟合
第二种情况:添加二次项,绘制图像,正好拟合:
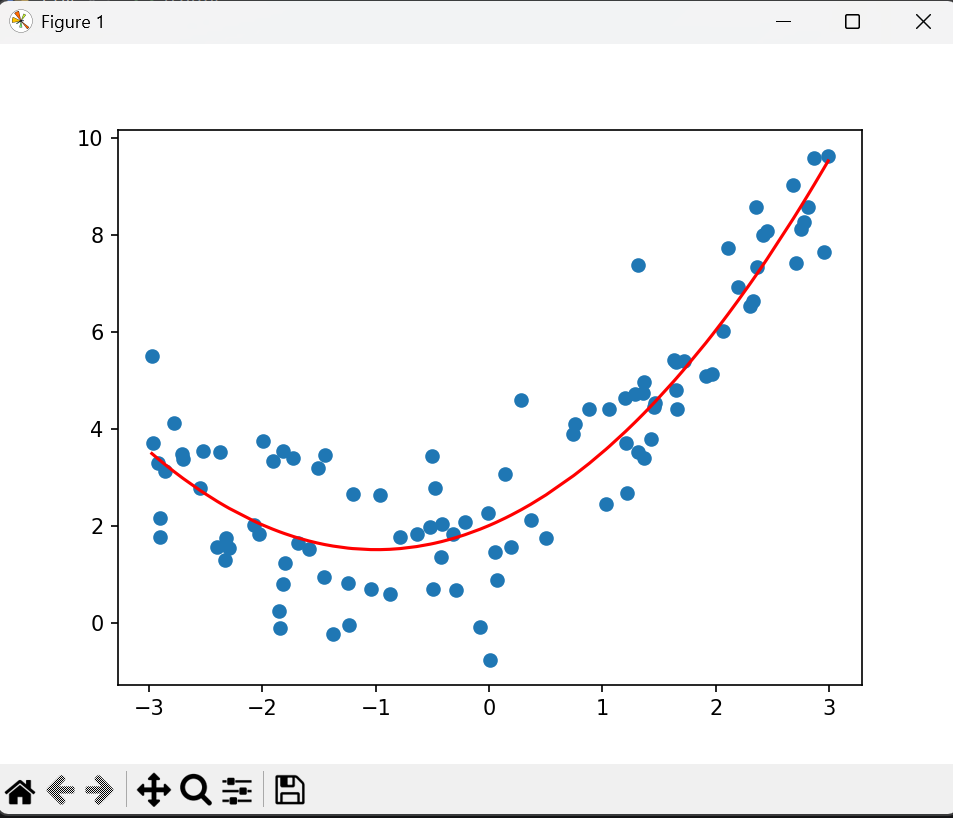
分析:运行后可观察到:欠拟合案例均方误差较大(约 3.0 左右),拟合良好案例(补充 x²)均方误差显著降低(约 1.0 左右),说明补充高次项可有效解决欠拟合;
三、过拟合的核心解决方法:L1、L2正则化(工业界首选)
过拟合的解决思路是「降低模型复杂度,抑制模型对噪声的拟合」,其中L1、L2正则化是逻辑回归中最常用、最有效的方法——无需删除特征、无需大量调整数据,只需在模型中添加正则化项,就能快速抑制过拟合,还能保留模型的可解释性。
先明确核心逻辑:正则化的本质是「对模型权重施加惩罚」,让权重绝对值尽可能小,避免某些特征被过度依赖,从而降低模型复杂度,提升泛化能力。
注意:sklearn中,用参数C表示正则化强度,C的值越小,正则化的惩罚力度越强(模型越简单,不易过拟合);C的值越大,正则化的惩罚力度越弱(模型越复杂,易过拟合),记准这个规律,避免调参踩坑!
3.1 过拟合实战演示(可直接运行)
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error  # 计算均方误差


def dm03_过拟合():
    # 1. 准备x, y数据, 增加上噪声.
    # 用于设置随机数生成器的种子(seed), 种子一样, 每次生成相同序列.
    np.random.seed(666)
    # x: 随机数, 范围为 (-3, 3), 100个.
    x = np.random.uniform(-3, 3, size=100)
    # loc: 均值, scale: 标准差, normal: 正态分布.
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, size=100)
    # 2. 实例化 线性回归模型.
    estimator = LinearRegression()
    # 3. 训练模型(加入过多高次项,导致过拟合)
    X = x.reshape(-1, 1)
    # hstack() 函数用于将多个数组在行上堆叠起来, 即: 数据增加高次项.
    X3 = np.hstack([X, X**2, X**3, X**4, X**5, X**6, X**7, X**8, X**9, X**10])
    estimator.fit(X3, y)

    # 4. 模型预测.
    y_predict = estimator.predict(X3)
    print("预测值:", y_predict)

    # 5. 计算均方误差 => 模型评估(过拟合时训练集均方误差极小)
    print(f'均方误差: {mean_squared_error(y, y_predict)}')
    # 6. 画图
    plt.scatter(x, y)  # 散点图(实际数据点)
    # sort()  该函数直接返回一个排序后的新数组。
    # numpy.argsort()   该函数返回的是数组值从小到大排序时对应的索引值
    plt.plot(np.sort(x), y_predict[np.argsort(x)], color='r')  # 折线图(预测值, 拟合回归线)
    plt.title("过拟合案例(加入过多高次项,过度拟合噪声)")
    plt.show()  # 具体的绘图


# 运行代码,观察过拟合现象
if __name__ == '__main__':
    dm03_过拟合()
第三种情况:过拟合(再次加入高次项,绘制图像,观察均方误差结果):
3.2 L1正则化(Lasso Regression,拉索回归)—— 适合特征筛选
核心定义
假设L(W)是未加正则项的原始损失,λ(lambda)是超参数,用于控制正则化项的惩罚力度,L1正则化是在逻辑回归原始损失的基础上,加入“所有特征权重的绝对值和”作为惩罚项,最终的损失函数数学公式为:
公式解读:式中L(W)为原始损失,λ控制惩罚强度,n为特征数量,|wᵢ|为第i个特征权重的绝对值,正则化项通过惩罚权重的绝对值,可将无关特征的权重压缩至0。
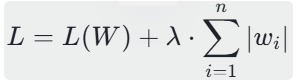
核心特点(必记)
-
惩罚权重绝对值:会将不重要特征的权重压缩到0,实现「自动特征筛选」(相当于删除无关特征);
-
适合场景:特征数量多、存在大量无关特征的场景(如文本分类、多特征风控建模);
-
注意事项:对异常值敏感,若数据存在较多异常值,优先用L2正则化;
-
sklearn参数:penalty='l1',且solver需选择支持L1的(如liblinear、saga)。
通俗解读
L1正则化相当于给权重“做减法”,把不重要的特征权重直接变成0,只保留对结果影响大的特征——比如做用户流失预测时,有50个特征,L1正则化会自动筛选出10个核心特征,删除40个无关特征,简化模型的同时,抑制过拟合。
3.3 L2正则化(Ridge Regression,岭回归)—— 最常用,工业界首选
核心定义
假设L(W)是未加正则项的原始损失,λ(lambda)是超参数,用于控制正则化项的惩罚力度,L2正则化是在逻辑回归原始损失的基础上,加入“所有特征权重的平方和”作为惩罚项,最终的损失函数数学公式为:
公式解读:式中L(W)为原始损失,λ控制惩罚强度,n为特征数量,wᵢ为第i个特征的权重,正则化项通过惩罚权重的平方,约束权重取值不能过大。
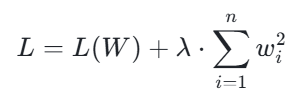
核心特点(必记)
-
惩罚权重平方:会将权重压缩到接近0,但不会等于0(所有特征都会被保留);
-
鲁棒性强:对异常值不敏感,适合大多数逻辑回归场景(如风控、医疗诊断);
-
核心作用:抑制过拟合,同时保留所有特征的影响,不改变模型的线性特性;
-
sklearn参数:penalty='l2'(逻辑回归默认参数,无需手动设置)。
通俗解读
L2正则化相当于给权重“戴了一个枷锁”,让所有权重都不能太大,避免某个特征被过度依赖——比如做肿瘤分类时,不会因为“某个异常样本的半径特征”,就让半径的权重变得极大,从而忽略其他核心特征。
3.4 L1 vs L2 正则化 核心对比(表格总结,实操选型必备)
|
对比维度 |
L1正则化(Lasso) |
L2正则化(Ridge) |
|
惩罚项 |
权重绝对值和(公式: |
权重平方和(公式: |
|
权重影响 |
部分权重压缩至0(特征筛选) |
权重压缩至接近0(不删除特征) |
|
对异常值敏感 |
敏感(不适合异常值多的场景) |
不敏感(工业界首选) |
|
sklearn参数 |
penalty='l1',solver='liblinear/saga' |
penalty='l2'(默认),solver无特殊限制 |
|
适用场景 |
特征多、存在无关特征(需筛选特征) |
大多数场景(抑制过拟合,保留所有特征) |
四、Python sklearn 正则化实战
L1正则化实战演示(完整代码,可直接运行)
用L1正则化解决上文的过拟合问题,观察模型权重变化、均方误差和拟合效果
from sklearn.linear_model import Lasso  # L1正则
import numpy as np
import matplotlib.pyplot as plt
from sklearn.metrics import mean_squared_error  # 计算均方误差


def dm04_模型过拟合_L1正则化():
    # 1. 准备x, y数据, 增加上噪声.
    # 用于设置随机数生成器的种子(seed), 种子一样, 每次生成相同序列.
    np.random.seed(666)
    # x: 随机数, 范围为 (-3, 3), 100个.
    x = np.random.uniform(-3, 3, size=100)
    # loc: 均值, scale: 标准差, normal: 正态分布.
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, size=100)
    # 2. 实例化L1正则化模型, 做实验: alpha惩罚力度越来越大, 权重越来越小.
    estimator = Lasso(alpha=0.005)  # alpha越小,惩罚越弱;越大,惩罚越强
    # 3. 训练模型(沿用过拟合案例的高次项特征,用L1正则化抑制过拟合)
    X = x.reshape(-1, 1)
    # hstack() 函数用于将多个数组在行上堆叠起来, 即: 数据增加高次项.
    X3 = np.hstack([X, X**2, X**3, X**4, X**5, X**6, X**7, X**8, X**9, X**10])
    estimator.fit(X3, y)
    print(f'权重: {estimator.coef_}')  # 可观察到无关高次项的权重被压缩至0(特征筛选)

    # 4. 模型预测.
    y_predict = estimator.predict(X3)
    print("预测值:", y_predict)

    # 5. 计算均方误差 => 模型评估(正则化后,均方误差略高于过拟合,但泛化能力更强)
    print(f'均方误差: {mean_squared_error(y, y_predict)}')
    # 6. 画图
    plt.scatter(x, y)  # 散点图(实际数据点)
    # sort()  该函数直接返回一个排序后的新数组。
    # numpy.argsort()   该函数返回的是数组值从小到大排序时对应的索引值
    plt.plot(np.sort(x), y_predict[np.argsort(x)], color='r')  # 折线图(预测值, 拟合回归线)
    plt.title("L1正则化解决过拟合案例")
    plt.show()  # 具体的绘图


# 运行代码,观察L1正则化抑制过拟合的效果
if __name__ == '__main__':
    dm04_模型过拟合_L1正则化()
在进行L1正则化后效果如图所示:
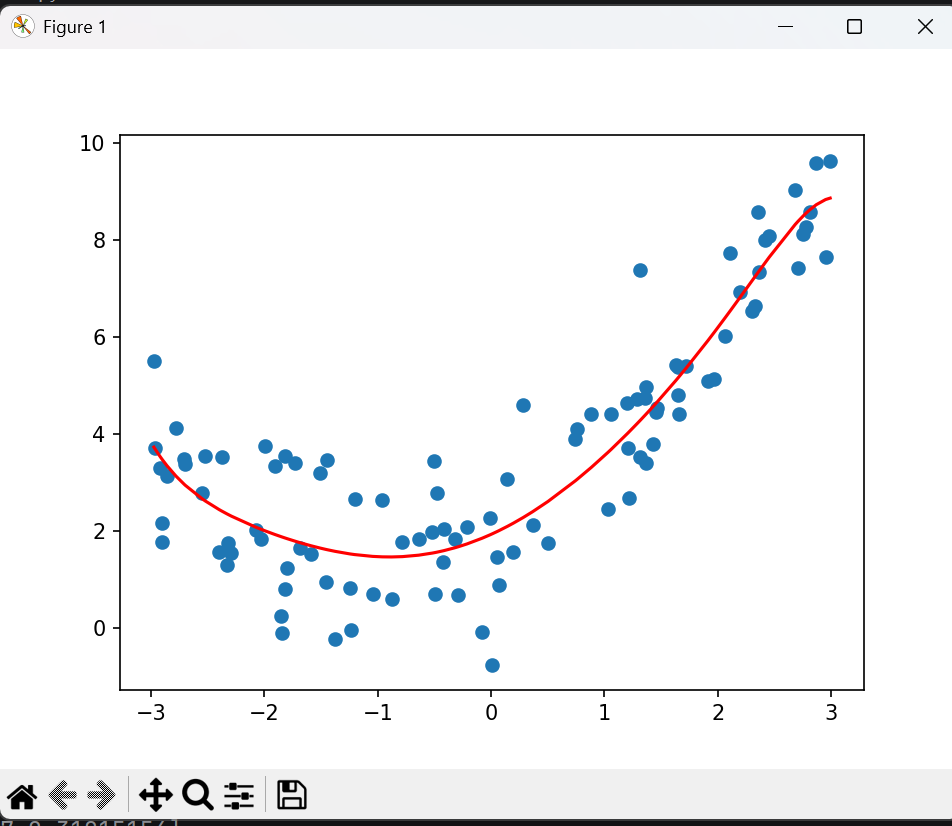
分析:运行后可观察到:无关高次项(如 x^3、x^4)的权重被压缩至 0,仅保留 x、x² 的权重,实现特征筛选,均方误差略高于过拟合案例,但泛化能力更强”
L2正则化实战演示(完整代码,可直接运行)
L2正则化(Ridge)解决过拟合的代码,与L1正则化对比使用,完整覆盖两种正则化的实操:
from sklearn.linear_model import Ridge  # 岭回归 L2正则
import numpy as np
import matplotlib.pyplot as plt
from sklearn.metrics import mean_squared_error  # 计算均方误差


def dm05_模型过拟合_L2正则化():
    # 1. 准备x, y数据, 增加上噪声.
    # 用于设置随机数生成器的种子(seed), 种子一样, 每次生成相同序列.
    np.random.seed(666)
    # x: 随机数, 范围为 (-3, 3), 100个.
    x = np.random.uniform(-3, 3, size=100)
    # loc: 均值, scale: 标准差, normal: 正态分布.
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, size=100)
    # 2. 实例化L2正则化模型, 做实验: alpha惩罚力度越来越大, k值越来越小.
    estimator = Ridge(alpha=0.005)
    # 3. 训练模型
    X = x.reshape(-1, 1)
    # hstack() 函数用于将多个数组在行上堆叠起来, 即: 数据增加高次项.
    X3 = np.hstack([X, X ** 2, X ** 3, X ** 4, X ** 5, X ** 6, X ** 7, X ** 8, X ** 9, X ** 10])
    estimator.fit(X3, y)
    print(f'权重: {estimator.coef_}')

    # 4. 模型预测.
    y_predict = estimator.predict(X3)
    print("预测值:", y_predict)

    # 5. 计算均方误差 => 模型评估
    print(f'均方误差: {mean_squared_error(y, y_predict)}')
    # 6. 画图
    plt.scatter(x, y)  # 散点图
    # sort()  该函数直接返回一个排序后的新数组。
    # numpy.argsort()   该函数返回的是数组值从小到大排序时对应的索引值
    plt.plot(np.sort(x), y_predict[np.argsort(x)], color='r')  # 折线图(预测值, 拟合回归线)
    plt.show()  # 具体的绘图

# 运行代码,对比L1和L2正则化的效果
if __name__ == '__main__':
    dm05_模型过拟合_L2正则化()
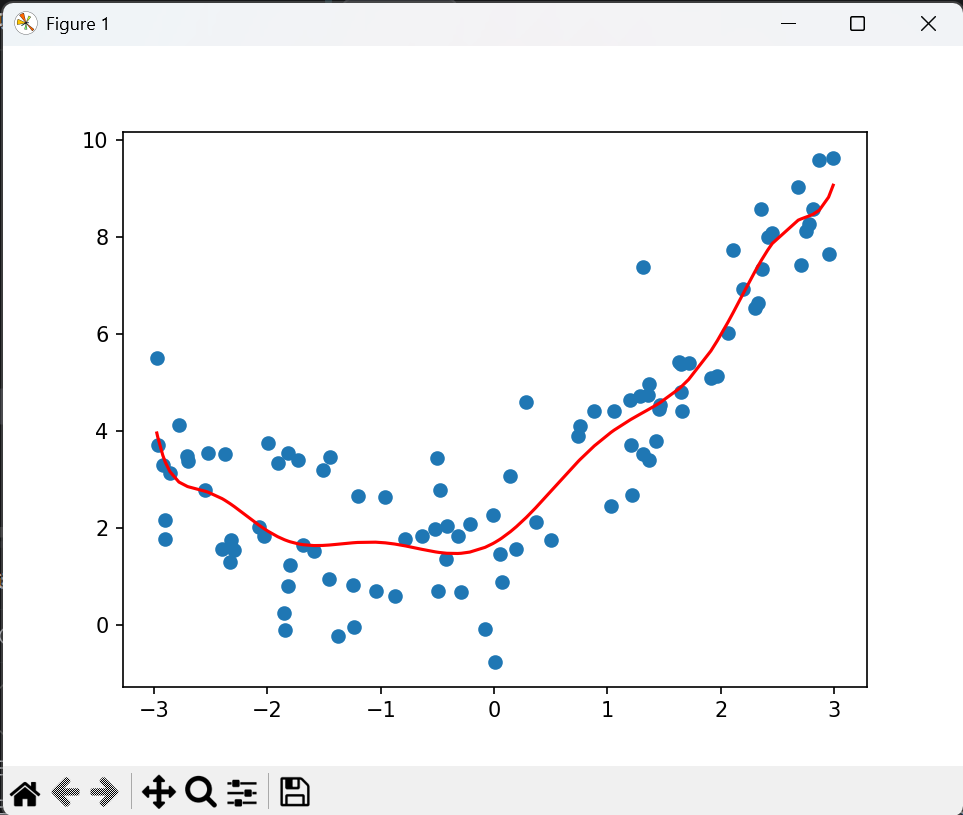
在进行L2正则化后如图所示:
五、常见踩坑点总结(新手必看,避免走弯路)
-
踩坑1:误解alpha的含义——alpha越大,正则化惩罚越强(模型越简单);alpha越小,惩罚越弱(模型越复杂),记反会导致调参无效;
-
踩坑2:混淆L1和L2对应的模型——L1对应Lasso、L2对应Ridge,导入时不要混淆;
-
踩坑3:未做特征预处理直接用正则化——特征量纲差异会导致权重惩罚不均,建议先做标准化/归一化;
-
踩坑4:过度依赖正则化——正则化只能抑制过拟合,若数据存在大量噪声、异常值,需先做数据清洗,再用正则化;
-
踩坑5:欠拟合时用正则化——欠拟合是模型拟合能力不足,正则化会进一步降低模型复杂度,导致欠拟合更严重(欠拟合需提升模型复杂度,而非用正则化);
-
踩坑6:过拟合时仅增加alpha——alpha过大会导致模型欠拟合,需合理调整alpha(可从0.001、0.01、0.1、1.0逐步尝试)。
六、总结
本文通过完整实战代码,详细拆解了欠拟合、过拟合的识别方法、核心原因,重点讲解了L1、L2正则化的原理、区别和实操方法,帮你快速避开拟合陷阱。
最后用一句话总结核心要点,方便大家记忆和实操:
欠拟合:学不会,需提升模型复杂度(补充高次项等特征);过拟合:学太死,需用正则化抑制(L2首选,L1适合特征筛选);正则化调参看alpha,越大惩罚越强,泛化优先选平衡。
文中所有代码均可直接复制运行,建议大家实际操作一遍,对比欠拟合、过拟合、正则化后的效果,加深理解。如果觉得本文对你有帮助,欢迎点赞、收藏、关注,后续会持续更新机器学习实战技巧,助力大家从新手快速成长为实操达人!
更多推荐


 29
 0
- 0


 已为社区贡献9条内容

所有评论(0)