
机器学习-数据清洗(处理缺失值、异常值和重复值)
·
摘要
数据预处理是机器学习项目成功的基石,通常占据数据科学家80%的工作时间。本文将系统性地总结数据预处理的完整流程、关键技术方法和最佳实践,并附带Python代码示例,帮助读者构建全面的数据处理知识体系。
一、数据预处理的重要性与整体流程
1.1 为什么数据预处理如此关键?
- 数据质量决定模型上限:高质量的数据比复杂的算法更能提升模型性能
- 现实数据的不完美性:现实世界数据通常存在缺失、噪声、不一致等问题
- 算法要求:大多数机器学习算法对数据格式和分布有特定要求
1.2 数据预处理完整流程
数据收集 → 数据清洗 → 特征工程 → 数据变换 → 数据集划分 → 特征缩放 → 最终数据集
二、数据清洗:处理不完整、不一致的数据
2.1 缺失值处理
import pandas as pd
import numpy as np
from sklearn.impute import SimpleImputer, KNNImputer
# 创建示例数据
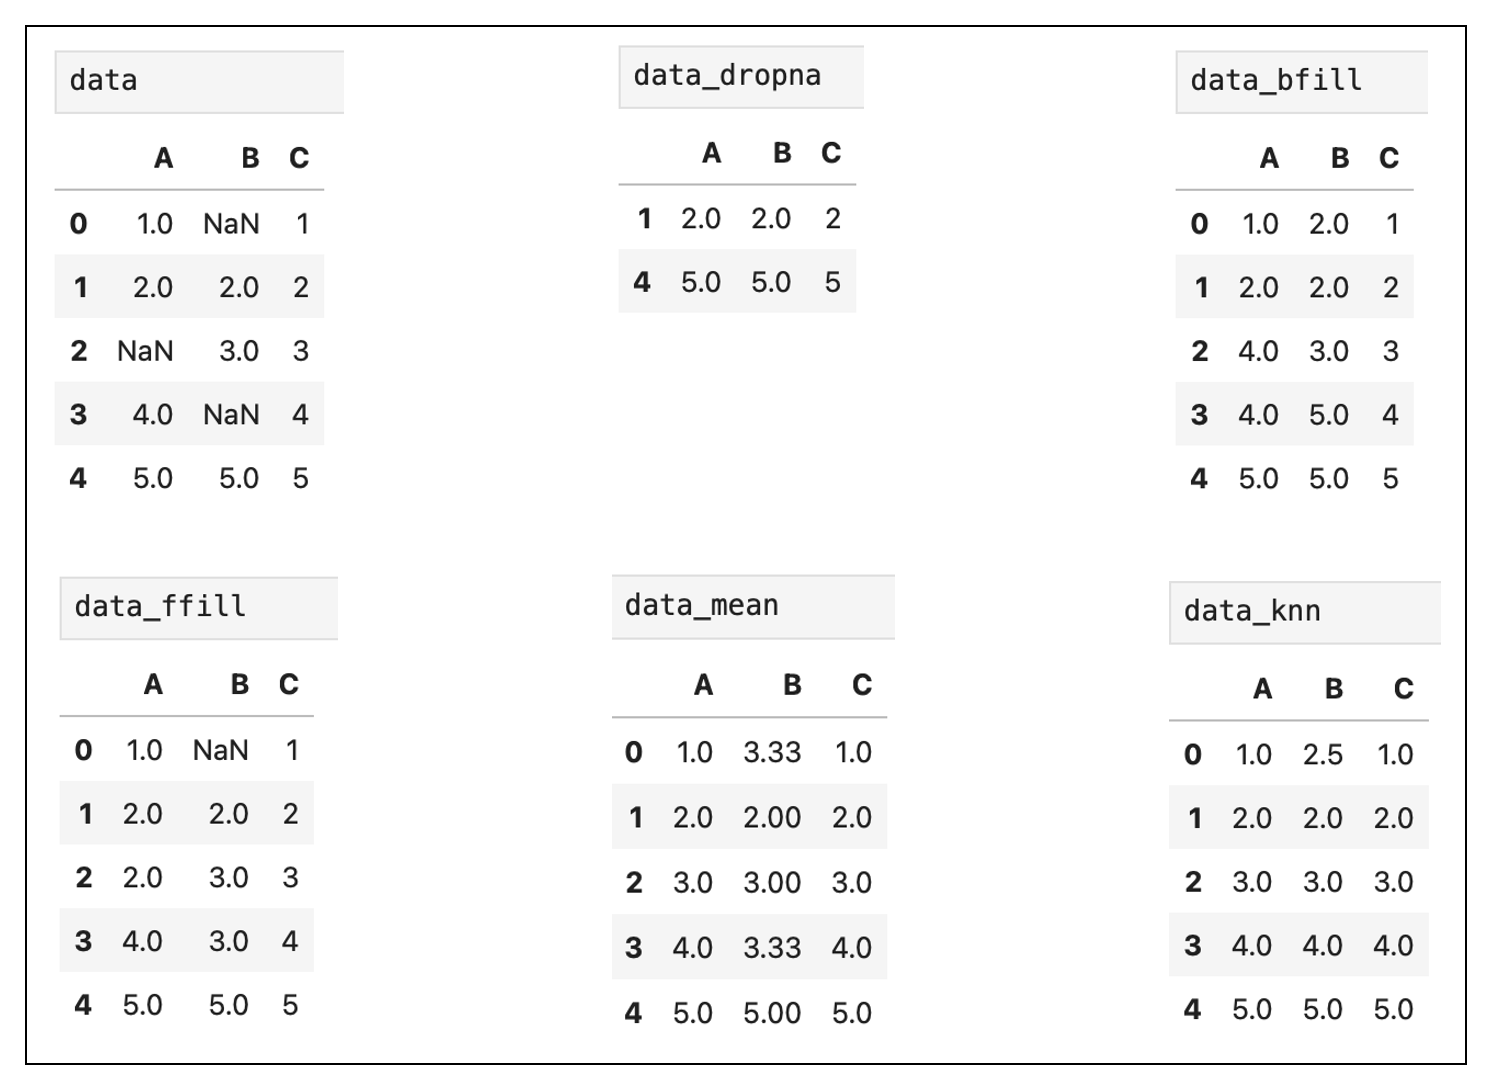
data = pd.DataFrame({
'A': [1, 2, np.nan, 4, 5],
'B': [np.nan, 2, 3, np.nan, 5],
'C': [1, 2, 3, 4, 5]
})
# 1. 删除缺失值(仅适用于缺失很少的情况)
data_dropna = data.dropna()
# 2. 均值/中位数/众数填充
imputer_mean = SimpleImputer(strategy='mean') # 'median','most_frequent'
data_mean = pd.DataFrame(imputer_mean.fit_transform(data), columns=data.columns).round(2) # 四舍五入到两位小数
# 3. 前后值填充(时间序列常用)
data_ffill = data.ffill() # 前向填充
data_bfill = data.bfill() # 后向填充
# 4. KNN填充(考虑特征相似性)
knn_imputer = KNNImputer(n_neighbors=2)
data_knn = pd.DataFrame(knn_imputer.fit_transform(data), columns=data.columns)
# 5. 模型预测填充(使用其他特征预测缺失值)
from sklearn.ensemble import RandomForestRegressor
# 此处省略具体实现,思路:用非缺失数据训练模型预测缺失值
2.2 异常值检测与处理
import matplotlib.pyplot as plt
import seaborn as sns
from scipy import stats

# 创建包含异常值的数据
np.random.seed(42)
data_normal = np.random.normal(0, 1, 1000)
data_with_outliers = np.append(data_normal, [10, -10, 15, -15])

# 1. 基于统计方法的检测
# Z-score方法
z_scores = np.abs(stats.zscore(data_with_outliers))
outliers_z = np.where(z_scores > 3)[0]  # 阈值通常设为3

# IQR方法
Q1 = np.percentile(data_with_outliers, 25)
Q3 = np.percentile(data_with_outliers, 75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
outliers_iqr = np.where((data_with_outliers < lower_bound) |
                       (data_with_outliers > upper_bound))[0]

# 2. 可视化检测
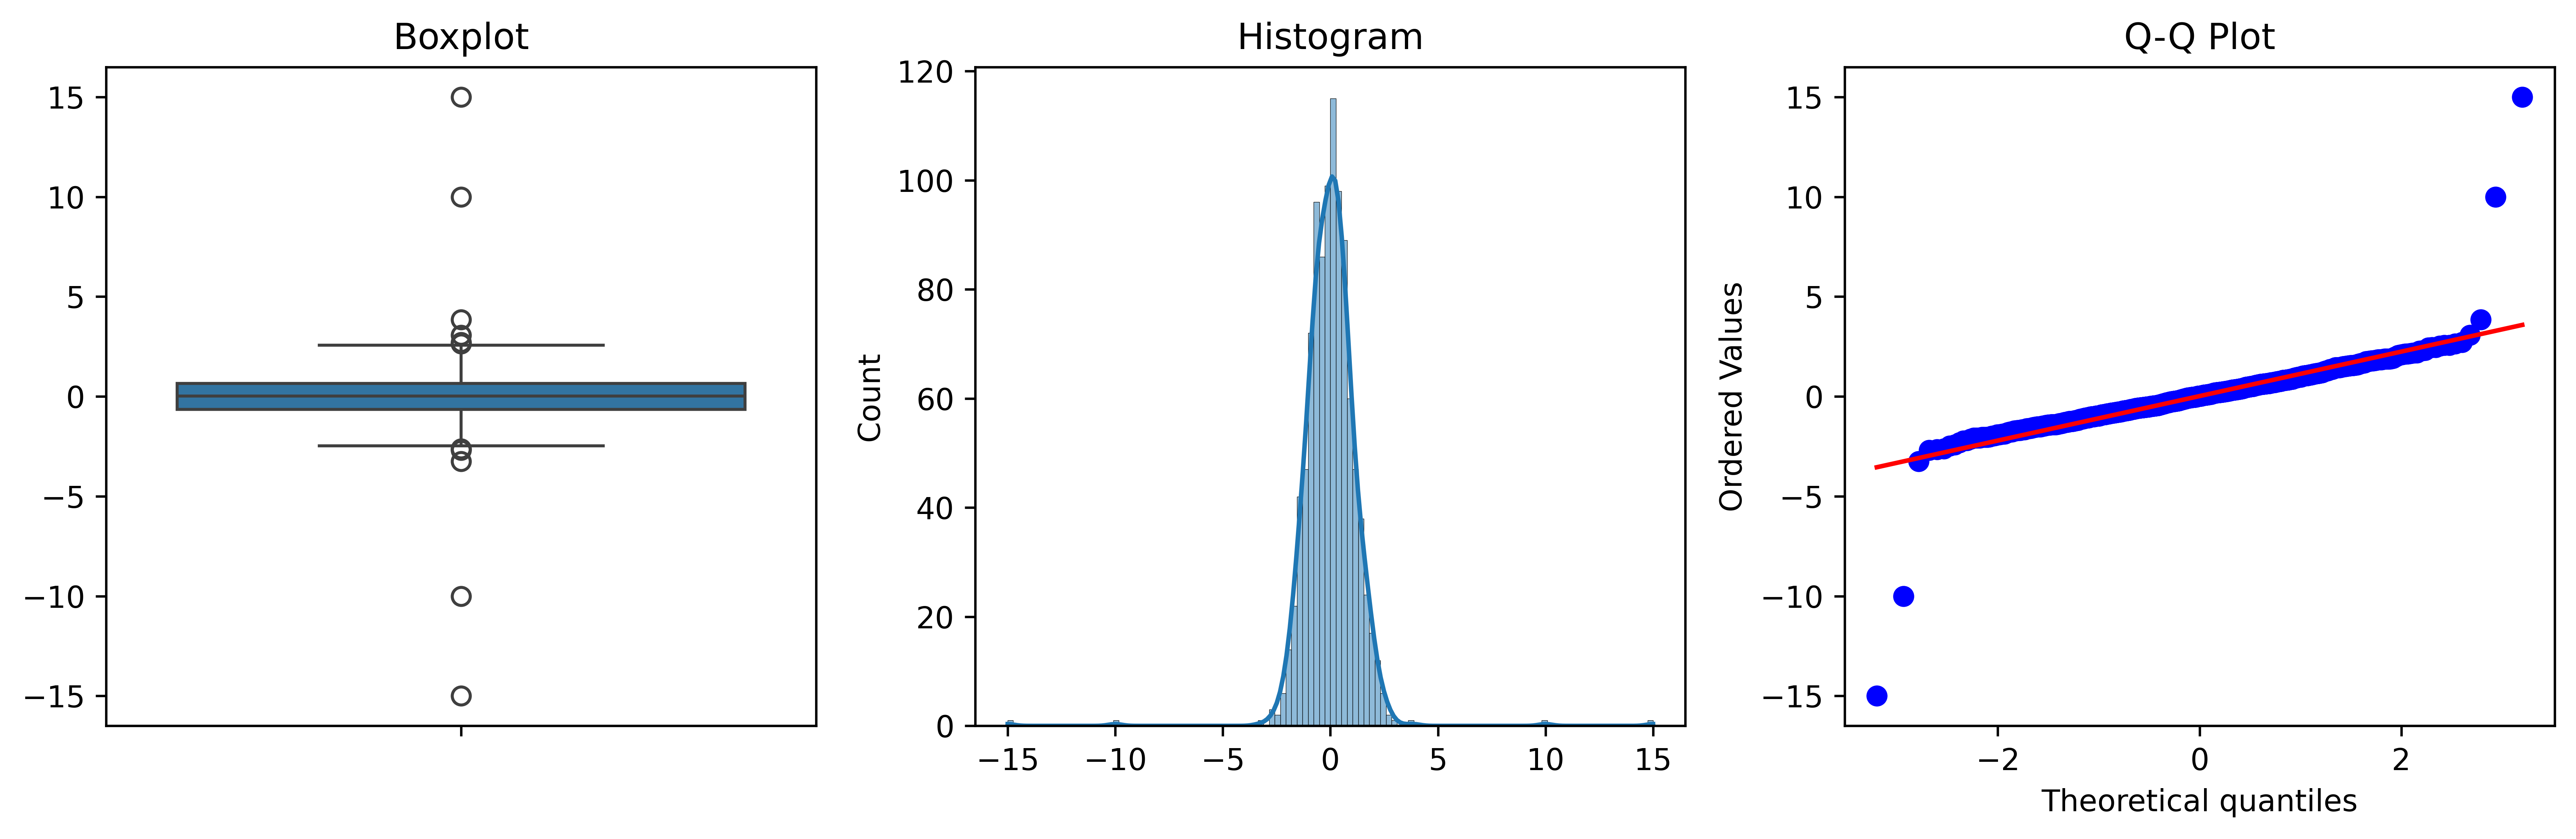
plt.figure(figsize=(12, 4))
plt.subplot(1, 3, 1)
sns.boxplot(y=data_with_outliers)
plt.title('Boxplot')

plt.subplot(1, 3, 2)
sns.histplot(data_with_outliers, kde=True)
plt.title('Histogram')

plt.subplot(1, 3, 3)
stats.probplot(data_with_outliers, dist="norm", plot=plt)
plt.title('Q-Q Plot')
plt.tight_layout()
plt.show()

# 3. 异常值处理方法
# 删除异常值
data_cleaned = data_with_outliers[(data_with_outliers >= lower_bound) &
                                 (data_with_outliers <= upper_bound)]

# 缩尾处理(Winsorization)
from scipy.stats.mstats import winsorize
data_winsorized = winsorize(data_with_outliers, limits=[0.05, 0.05])

# 替换为边界值
data_capped = np.copy(data_with_outliers)
data_capped[data_capped < lower_bound] = lower_bound
data_capped[data_capped > upper_bound] = upper_bound
2.3 重复值处理
# 检测重复行
duplicates = data.duplicated()
num_duplicates = duplicates.sum()

# 删除重复行
data_unique = data.drop_duplicates()

# 基于关键列删除重复
data_unique_subset = data.drop_duplicates(subset=['key_column'])
三、特征工程:从原始数据中提取价值
3.1 特征编码:将类别变量转换为数值
from sklearn.preprocessing import LabelEncoder, OneHotEncoder, OrdinalEncoder
from category_encoders import TargetEncoder, CountEncoder
import pandas as pd

# 示例数据
cat_data = pd.DataFrame({
    'color': ['红', '蓝', '绿', '蓝', '红', '绿'],
    'size': ['大', '中', '小', '大', '中', '小'],
    'target': [1, 0, 1, 0, 1, 0]
})

# 1. 标签编码(适用于有序分类)
label_encoder = LabelEncoder()
cat_data['color_label'] = label_encoder.fit_transform(cat_data['color'])

# 2. 独热编码(适用于无序分类,类别较少)
onehot_encoder = OneHotEncoder(sparse_output=False, drop='first')  # 使用drop避免虚拟变量陷阱
onehot_encoded = onehot_encoder.fit_transform(cat_data[['color']])
onehot_df = pd.DataFrame(onehot_encoded,
                        columns=onehot_encoder.get_feature_names_out(['color']))

# 3. 目标编码(考虑目标变量的均值)
target_encoder = TargetEncoder()
cat_data['color_target'] = target_encoder.fit_transform(cat_data['color'],
                                                       cat_data['target'])

# 4. 频率编码(使用类别出现频率)
freq_encoding = cat_data['color'].value_counts(normalize=True)
cat_data['color_freq'] = cat_data['color'].map(freq_encoding)
3.2 特征创建与变换
# 1. 多项式特征(捕获特征交互)
from sklearn.preprocessing import PolynomialFeatures
X = np.array([[1, 2], [3, 4], [5, 6]])
poly = PolynomialFeatures(degree=2, include_bias=False)
X_poly = poly.fit_transform(X)

# 2. 对数/指数变换(处理偏态分布)
data = pd.DataFrame({'income': [20000, 50000, 80000, 150000, 300000]})
data['income_log'] = np.log1p(data['income'])  # log(1+x)避免0值
data['income_sqrt'] = np.sqrt(data['income'])
data['income_boxcox'], _ = stats.boxcox(data['income'] + 1)  # Box-Cox变换

# 3. 分箱/离散化(将连续变量转换为类别)
data['income_bin'] = pd.cut(data['income'],
                           bins=[0, 50000, 100000, np.inf],
                           labels=['低', '中', '高'])

# 等频分箱
data['income_qbin'] = pd.qcut(data['income'], q=4, labels=['Q1', 'Q2', 'Q3', 'Q4'])

# 4. 日期时间特征提取
dates = pd.date_range('2023-01-01', periods=10, freq='D')
date_df = pd.DataFrame({'date': dates})
date_df['year'] = date_df['date'].dt.year
date_df['month'] = date_df['date'].dt.month
date_df['day'] = date_df['date'].dt.day
date_df['dayofweek'] = date_df['date'].dt.dayofweek
date_df['is_weekend'] = date_df['dayofweek'].isin([5, 6]).astype(int)
date_df['quarter'] = date_df['date'].dt.quarter
四、总结与展望
数据预处理是机器学习项目成功的决定性环节,它不仅仅是技术操作,更是一种数据思维的体现。通过本文的系统性梳理,我们可以得出以下关键结论:
- 质量优于算法:高质量的数据往往比复杂的算法更能提升模型性能。投入时间在数据预处理上,通常能获得比调整模型参数更高的回报率。
- 流程决定效率:建立标准化的数据预处理流程(数据清洗 → 特征工程 → 数据变换 → 数据集划分)能显著提高工作效率,确保实验的可复现性。
- 业务驱动技术:每个预处理决策(如缺失值填充策略、特征编码方法)都应基于对业务逻辑的理解,而不仅仅是技术考量。
更多推荐

 5
 0
- 0


 已为社区贡献4条内容

所有评论(0)