
动手学深度学习(李沐)---数据操作
1、数据操作
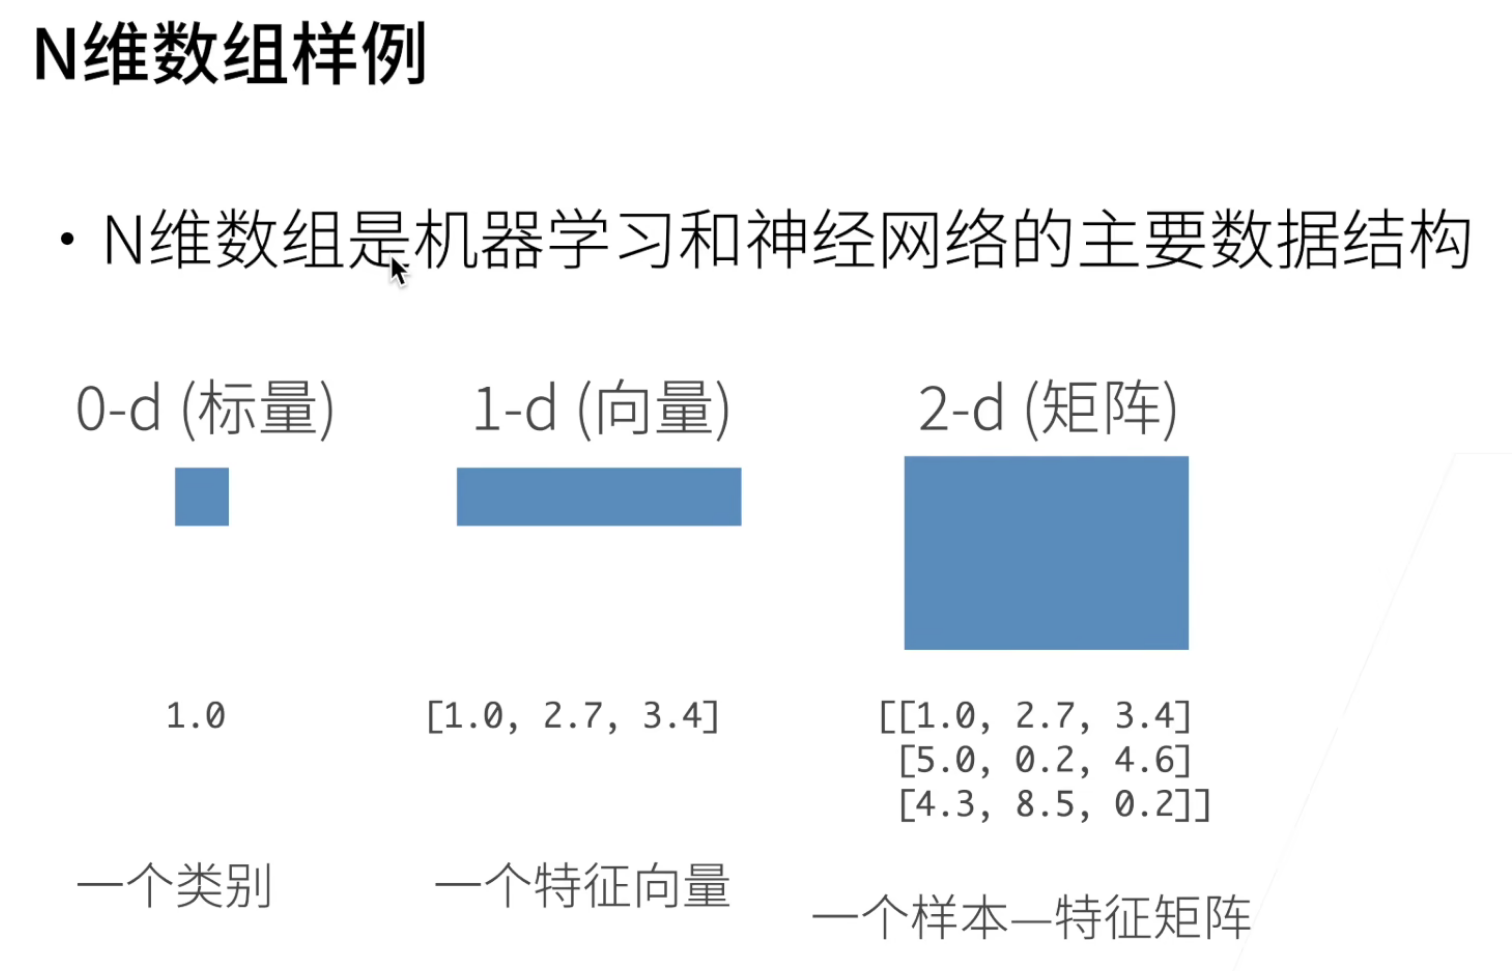
这张图从最基础的概念讲起。N维数组是机器学习和神经网络的核心数据结构,可以理解为"数据的容器"。
0维(标量):就是一个孤零零的数字,比如
1.0。在机器学习里,这可以代表一个类别标签,比如"这是猫"用1表示。1维(向量):一串数字排成一行,比如
[1.0, 2.7, 3.4]。这就像一个特征向量——假设你在描述一个水果,这三个数字可能分别代表重量、甜度和颜色评分。2维(矩阵):数字排成一张表格,有行有列。比如一个3×3的矩阵,每一行是一个样本,每一列是一种特征。这就像是Excel表格,行是记录,列是字段。
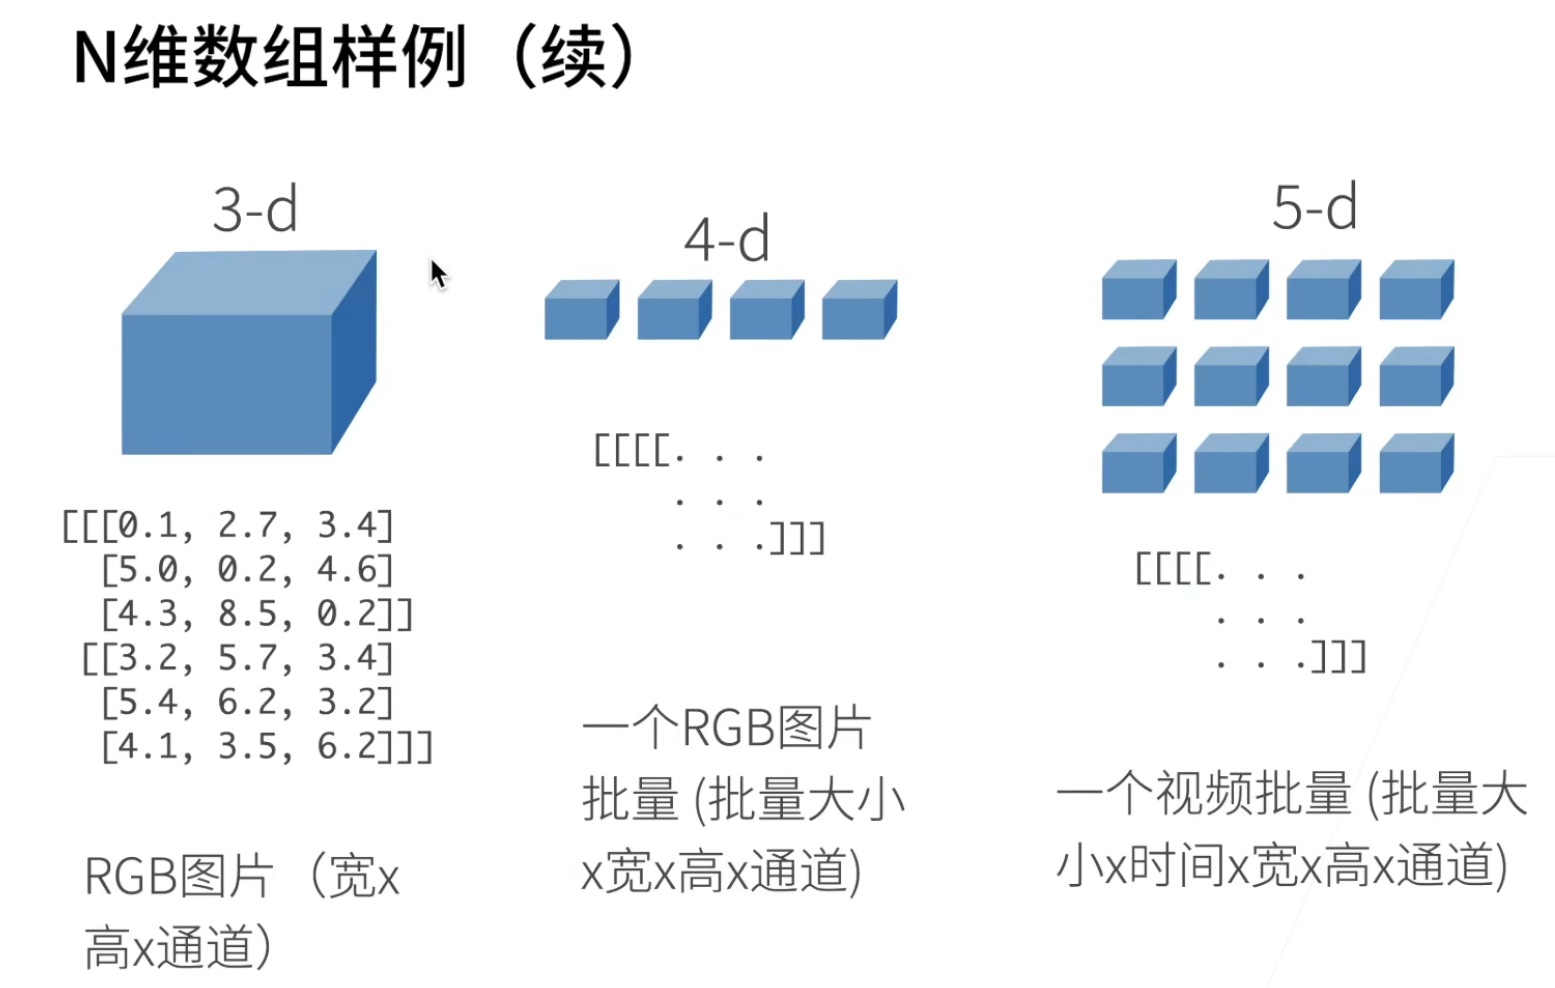
这张图展示了三维及以上的数组,进入了深度学习真正使用的领域。
3维数组:可以把它想象成一个"数据立方体"。最典型的例子是RGB图片——宽×高×通道。一张彩色照片,宽度500像素、高度400像素、3个颜色通道(红绿蓝),就是一个500×400×3的三维数组。
4维数组:一批图片。如果你要训练神经网络,不会只喂一张图,而是一次喂32张或64张。这就变成了批量大小×宽×高×通道。4个小立方体排成一排的图示很形象——每个立方体是一张图,一起组成一个批次。
5维数组:视频数据。视频是连续的图片帧,所以维度变成批量大小×时间×宽×高×通道。比如一次处理8段视频,每段10帧,每帧是标准RGB图片,就是一个8×10×高×宽×3的五维数组。
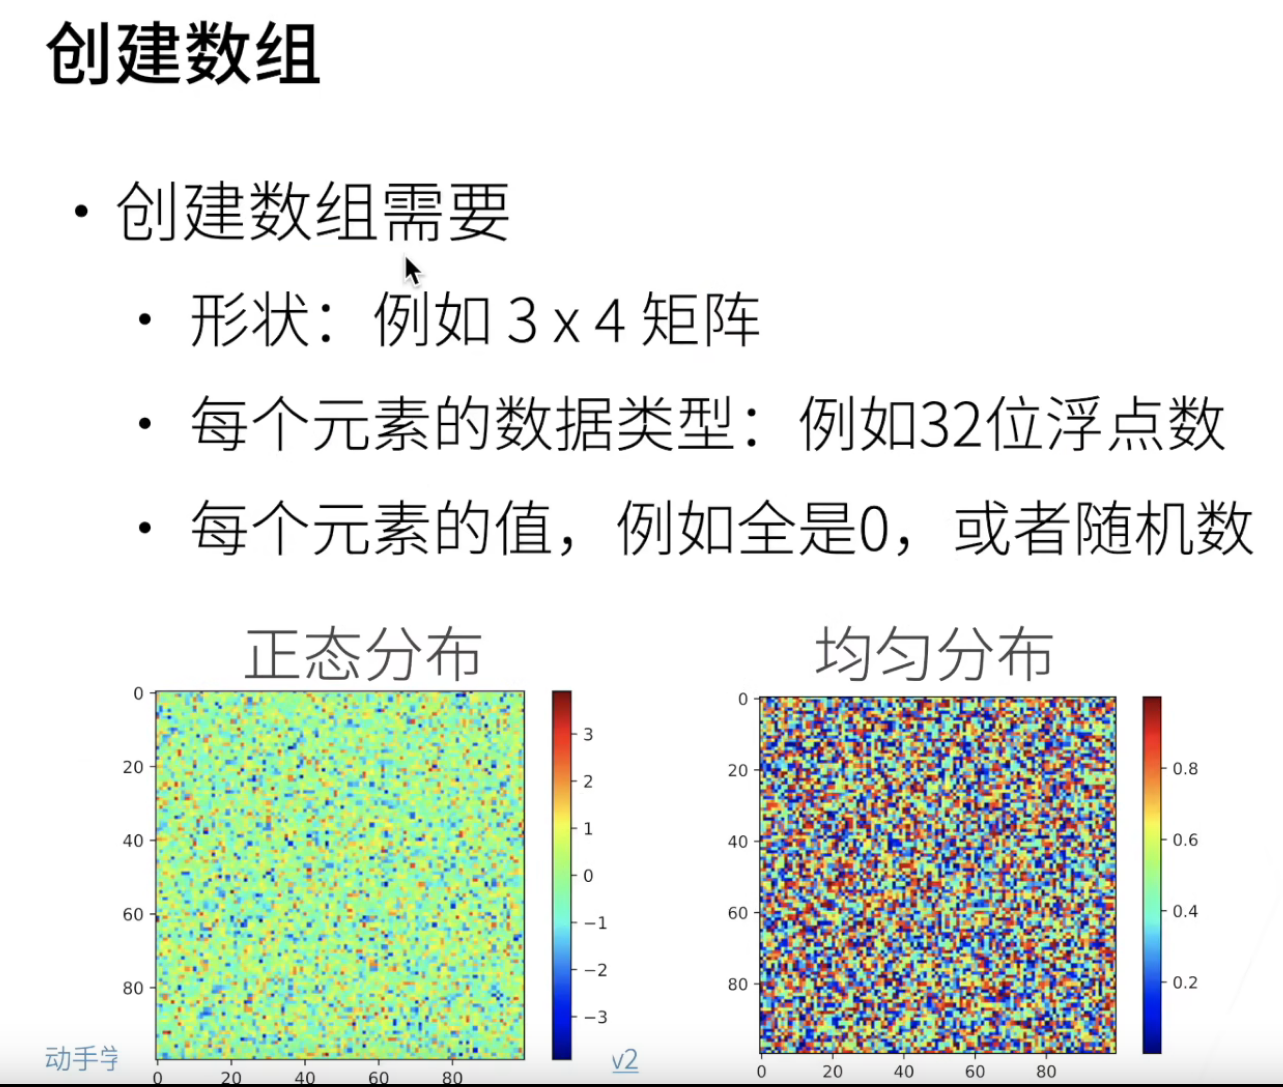
创建数组需要明确三件事:
形状(Shape):数组的"骨架"。比如3×4矩阵,就是3行4列。
数据类型(Dtype):每个格子存什么类型的数。32位浮点数是最常见的,精度足够且省内存。
初始值:可以全填0,也可以填随机数。这里展示了两种重要的随机分布:
正态分布:数值集中在0附近,越远离0越稀少。颜色图中间偏绿(接近0),两端偏红蓝(极端值)。这种分布适合初始化神经网络权重。
均匀分布:所有数值出现的概率一样,图中红蓝黄绿混杂得更均匀。这种分布在某些特定算法中会用到。
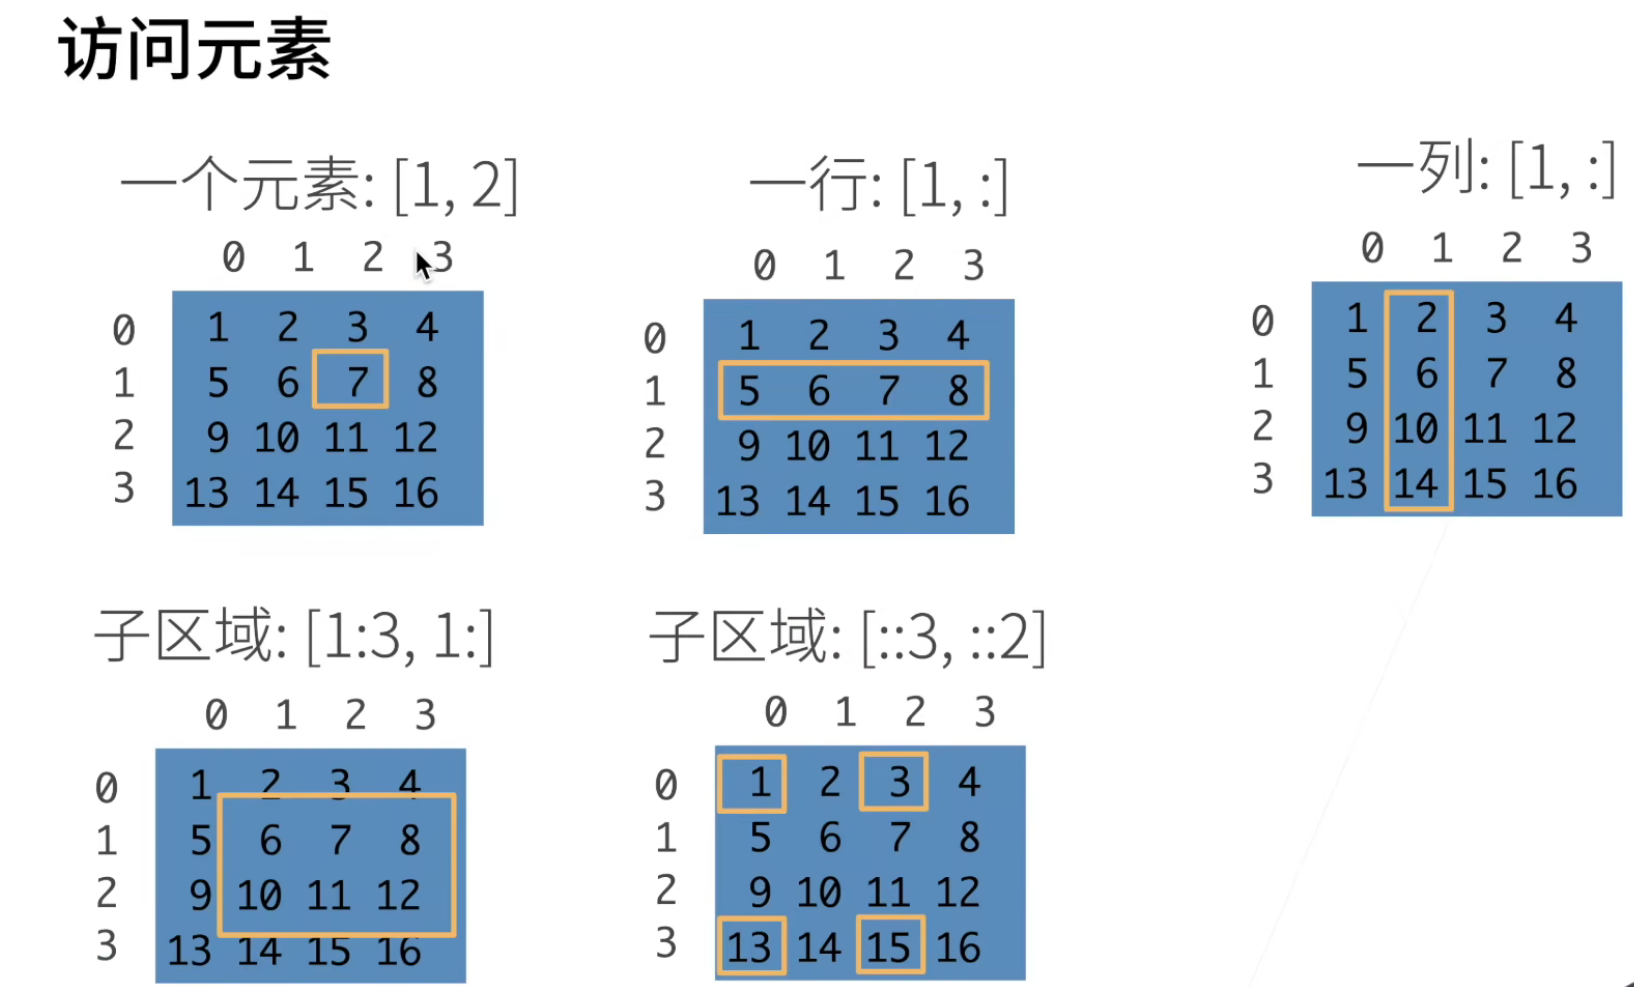
这张图讲的是"怎么取数据",用Python的切片语法。
取单个元素:
[1, 2]表示第1行第2列(从0开始数),对应数字7。就像Excel里点某个单元格。取一行:
[1, :]表示第1行的所有列,得到[5, 6, 7, 8]。冒号代表"全部"。取一列:
[:, 1]表示所有行的第1列,得到[2, 6, 10, 14]。注意这里图上的标注有个小笔误,应该写成[:, 1]而不是[1, :]。取子区域:
[1:3, 1:]表示第1到2行(不含第3行)、第1列到最后一列。框住了6,7,8,10,11,12这个2×3的小矩阵。这在图像处理中很常见——比如裁剪人脸区域。带步长的切片:
[::3, ::2]表示行每隔3个取一个(0,3行),列每隔2个取一个(0,2列)。最终拿到的是1,3,13,15这四个角上的数字。这种"跳着取"在降采样、池化操作中经常用到。
2、数据操作实现
首先,我们导入torch。请注意,虽然它被称为PyTorch,但是代码中使用torch而不是pytorch。
import torch
张量表示一个由数值组成的数组,这个数组可能有多个维度。 具有一个轴的张量对应数学上的向量(vector); 具有两个轴的张量对应数学上的矩阵(matrix); 具有两个轴以上的张量没有特殊的数学名称。
首先,我们可以使用 arange 创建一个行向量 x。这个行向量包含以0开始的前12个整数,它们默认创建为整数。也可指定创建类型为浮点数。张量中的每个值都称为张量的 元素(element)。例如,张量 x 中有 12 个元素。除非额外指定,新的张量将存储在内存中,并采用基于CPU的计算。
x = torch.arange(12)
x
结果:tensor([ 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11])
可以通过张量的shape属性来访问张量(沿每个轴的长度)的形状 。
x.shape
结果:torch.Size([12])
如果只想知道张量中元素的总数,即形状的所有元素乘积,可以检查它的大小(size)。 因为这里在处理的是一个向量,所以它的shape与它的size相同。
x.numel()
结果:12
要想改变一个张量的形状而不改变元素数量和元素值,可以调用reshape函数。 例如,可以把张量x从形状为(12,)的行向量转换为形状为(3,4)的矩阵。 这个新的张量包含与转换前相同的值,但是它被看成一个3行4列的矩阵。 要重点说明一下,虽然张量的形状发生了改变,但其元素值并没有变。 注意,通过改变张量的形状,张量的大小不会改变。
X = x.reshape(3, 4)
X
结果:
tensor([[ 0,  1,  2,  3],
        [ 4,  5,  6,  7],
        [ 8,  9, 10, 11]])
我们不需要通过手动指定每个维度来改变形状。 也就是说,如果我们的目标形状是(高度,宽度), 那么在知道宽度后,高度会被自动计算得出,不必我们自己做除法。 在上面的例子中,为了获得一个3行的矩阵,我们手动指定了它有3行和4列。 幸运的是,我们可以通过-1来调用此自动计算出维度的功能。 即我们可以用x.reshape(-1,4)或x.reshape(3,-1)来取代x.reshape(3,4)。
有时,我们希望使用全0、全1、其他常量,或者从特定分布中随机采样的数字来初始化矩阵。 我们可以创建一个形状为(2,3,4)的张量,其中所有元素都设置为0。代码如下:
torch.zeros((2, 3, 4))
结果:
tensor([[[0., 0., 0., 0.],
         [0., 0., 0., 0.],
         [0., 0., 0., 0.]],

        [[0., 0., 0., 0.],
         [0., 0., 0., 0.],
         [0., 0., 0., 0.]]])
同样,我们可以创建一个形状为(2,3,4)的张量,其中所有元素都设置为1。代码如下:
torch.ones((2, 3, 4))
结果:
tensor([[[1., 1., 1., 1.],
         [1., 1., 1., 1.],
         [1., 1., 1., 1.]],

        [[1., 1., 1., 1.],
         [1., 1., 1., 1.],
         [1., 1., 1., 1.]]])
有时我们想通过从某个特定的概率分布中随机采样来得到张量中每个元素的值。 例如,当我们构造数组来作为神经网络中的参数时,我们通常会随机初始化参数的值。 以下代码创建一个形状为(3,4)的张量。 其中的每个元素都从均值为0、标准差为1的标准高斯分布(正态分布)中随机采样。
torch.randn(3, 4)
结果:
tensor([[-0.0135,  0.0665,  0.0912,  0.3212],
        [ 1.4653,  0.1843, -1.6995, -0.3036],
        [ 1.7646,  1.0450,  0.2457, -0.7732]])
我们还可以通过提供包含数值的Python列表(或嵌套列表),来为所需张量中的每个元素赋予确定值。
torch.tensor([[2, 1, 4, 3], [1, 2, 3, 4], [4, 3, 2, 1]])
结果:
tensor([[2, 1, 4, 3],
        [1, 2, 3, 4],
        [4, 3, 2, 1]])
在这里,最外层的列表对应于轴0,内层的列表对应于轴1。
想象俄罗斯套娃:
最外层的大盒子 → 轴0:里面装了3个小盒子
每个小盒子打开 → 轴1:里面各有4个数字
则上述张量是一个3行4列的二维张量(矩阵),形状为
(3, 4)。
代码串讲
import torch

x = torch.tensor([[2, 1, 4, 3],
                  [1, 2, 3, 4],
                  [4, 3, 2, 1]])

print(x.shape)      # torch.Size([3, 4])
print(x.numel())    # 12(总共12个数字)
3、运算符
对于任意具有相同形状的张量, 常见的标准算术运算符(+、-、*、/和**)都可以被升级为按元素运算。 我们可以在同一形状的任意两个张量上调用按元素操作。 在下面的例子中,我们使用逗号来表示一个具有5个元素的元组,其中每个元素都是按元素操作的结果。
x = torch.tensor([1.0, 2, 4, 8])
y = torch.tensor([2, 2, 2, 2])
x + y, x - y, x * y, x / y, x ** y  # **运算符是求幂运算
结果:
(tensor([ 3.,  4.,  6., 10.]),
 tensor([-1.,  0.,  2.,  6.]),
 tensor([ 2.,  4.,  8., 16.]),
 tensor([0.5000, 1.0000, 2.0000, 4.0000]),
 tensor([ 1.,  4., 16., 64.]))
“按元素”方式可以应用更多的计算,包括像求幂这样的一元运算符。
torch.exp(x)
结果:tensor([2.7183e+00, 7.3891e+00, 5.4598e+01, 2.9810e+03])
除了按元素计算外,我们还可以执行线性代数运算,包括向量点积和矩阵乘法。
我们也可以把多个张量**连结(concatenate)**在一起,把它们端对端地叠起来形成一个更大的张量。我们只需要提供张量列表,并给出沿哪个轴连结。下面的例子分别演示了当我们沿行(轴-0,形状的第一个元素)和按列(轴-1,形状的第二个元素)连结两个矩阵时,会发生什么情况。我们可以看到,第一个输出张量的轴-0长度(6)是两个输入张量轴-0长度的总和(3 + 3);第二个输出张量的轴-1长度(8)是两个输入张量轴-1长度的总和(4 + 4)。
X = torch.arange(12, dtype=torch.float32).reshape((3,4))
Y = torch.tensor([[2.0, 1, 4, 3], [1, 2, 3, 4], [4, 3, 2, 1]])
torch.cat((X, Y), dim=0), torch.cat((X, Y), dim=1)
结果:
(tensor([[ 0.,  1.,  2.,  3.],
         [ 4.,  5.,  6.,  7.],
         [ 8.,  9., 10., 11.],
         [ 2.,  1.,  4.,  3.],
         [ 1.,  2.,  3.,  4.],
         [ 4.,  3.,  2.,  1.]]),
 tensor([[ 0.,  1.,  2.,  3.,  2.,  1.,  4.,  3.],
         [ 4.,  5.,  6.,  7.,  1.,  2.,  3.,  4.],
         [ 8.,  9., 10., 11.,  4.,  3.,  2.,  1.]]))
有时,我们想通过逻辑运算符构建二元张量。 以X == Y为例: 对于每个位置,如果X和Y在该位置相等,则新张量中相应项的值为1。 这意味着逻辑语句X == Y在该位置处为真,否则该位置为0。
X == Y
结果:
tensor([[False,  True, False,  True],
        [False, False, False, False],
        [False, False, False, False]])
对张量中的所有元素进行求和,会产生一个单元素张量。
X.sum()
结果:tensor(66.)
4、广播机制
在上面的部分中,我们看到了如何在相同形状的两个张量上执行按元素操作。 在某些情况下,即使形状不同,我们仍然可以通过调用 广播机制(broadcasting mechanism)来执行按元素操作。 这种机制的工作方式如下:
-
通过适当复制元素来扩展一个或两个数组,以便在转换之后,两个张量具有相同的形状;
-
对生成的数组执行按元素操作。
在大多数情况下,我们将沿着数组中长度为1的轴进行广播,如下例子:
a = torch.arange(3).reshape((3, 1))
b = torch.arange(2).reshape((1, 2))
a, b
结果:
(tensor([[0],
         [1],
         [2]]),
 tensor([[0, 1]]))
由于a和b分别是 3×1 和 1×2 矩阵,如果让它们相加,它们的形状不匹配。我们将两个矩阵广播为一个更大的 3×2 矩阵,如下所示:矩阵a将复制列,矩阵b将复制行,然后再按元素相加。
a + b
结果:
tensor([[0, 1],
        [1, 2],
        [2, 3]])
广播过程:
①广播后的a(复制列,把[0],[1],[2]各变成两列)
②广播后的b(复制行,把[0,1]变成三行)
③按元素相加
[[0, 0] + [[0, 1] = [[0, 1]
[1, 1] [0, 1] [1, 2]
[2, 2]] [0, 1]] [2, 3]]
5、索引和切片
就像在任何其他Python数组中一样,张量中的元素可以通过索引访问。 与任何Python数组一样:第一个元素的索引是0,最后一个元素索引是-1; 可以指定范围以包含第一个元素和最后一个之前的元素。
如下所示,我们可以用[-1]选择最后一个元素,可以用[1:3]选择第二个和第三个元素:
X[-1], X[1:3]
结果:
(tensor([ 8.,  9., 10., 11.]),
 tensor([[ 4.,  5.,  6.,  7.],
         [ 8.,  9., 10., 11.]]))
除读取外,我们还可以通过指定索引来将元素写入矩阵。
X[1, 2] = 9
X
结果:
tensor([[ 0.,  1.,  2.,  3.],
        [ 4.,  5.,  9.,  7.],
        [ 8.,  9., 10., 11.]])
如果我们想为多个元素赋值相同的值,我们只需要索引所有元素,然后为它们赋值。 例如,[0:2, :]访问第1行和第2行,其中“:”代表沿轴1(列)的所有元素。 虽然我们讨论的是矩阵的索引,但这也适用于向量和超过2个维度的张量。
X[0:2, :] = 12
X
结果:
tensor([[12., 12., 12., 12.],
        [12., 12., 12., 12.],
        [ 8.,  9., 10., 11.]])
6、节省内存
运行一些操作可能会导致为新结果分配内存。 例如,如果我们用Y=X+Y,我们将取消引用Y指向的张量,而是指向新分配的内存处的张量。
在下面的例子中,我们用Python的id()函数演示了这一点, 它给我们提供了内存中引用对象的确切地址。 运行Y=Y+X后,我们会发现id(Y)指向另一个位置。 这是因为Python首先计算Y+X,为结果分配新的内存,然后使Y指向内存中的这个新位置。
before = id(Y)
Y = Y + X
id(Y) == before
结果:False
这可能是不可取的,原因有两个:
首先,我们不想总是不必要地分配内存。在机器学习中,我们可能有数百兆的参数,并且在一秒内多次更新所有参数。通常情况下,我们希望原地执行这些更新;
如果我们不原地更新,其他引用仍然会指向旧的内存位置,这样我们的某些代码可能会无意中引用旧的参数。
幸运的是,执行原地操作非常简单。 我们可以使用切片表示法将操作的结果分配给先前分配的数组,例如Y[:]=<expression>。 为了说明这一点,我们首先创建一个新的矩阵Z,其形状与另一个Y相同, 使用zeros_like来分配一个全0的块。
Z = torch.zeros_like(Y)
print('id(Z):', id(Z))
Z[:] = X + Y
print('id(Z):', id(Z))
结果:
id(Z): 140327634811696
id(Z): 140327634811696
如果在后续计算中没有重复使用X, 我们也可以使用X[:]=X+Y或X+=Y来减少操作的内存开销。
before = id(X)
X += Y
id(X) == before
结果:True
7、转换为其他Python对象
将深度学习框架定义的张量转换为NumPy张量(ndarray)很容易,反之也同样容易。 torch张量和numpy数组将共享它们的底层内存,就地操作更改一个张量也会同时更改另一个张量。
A = X.numpy()
B = torch.tensor(A)
type(A), type(B)
结果:(numpy.ndarray, torch.Tensor)
要将大小为1的张量转换为Python标量,我们可以调用item函数或Python的内置函数。
a = torch.tensor([3.5])
a, a.item(), float(a), int(a)
结果:(tensor([3.5000]), 3.5, 3.5, 3)
8、小结
深度学习存储和操作数据的主要接口是张量(n维数组)。它提供了各种功能,包括基本数学运算、广播、索引、切片、内存节省和转换其他Python对象。
更多推荐

 23
 0
- 0


 已为社区贡献3条内容

所有评论(0)