
现代机器学习研究进展 第一部分 数学与概率工具箱 第三章 度量与分布距离
1 概念与分类(度量 vs 发散 vs 统计检验)
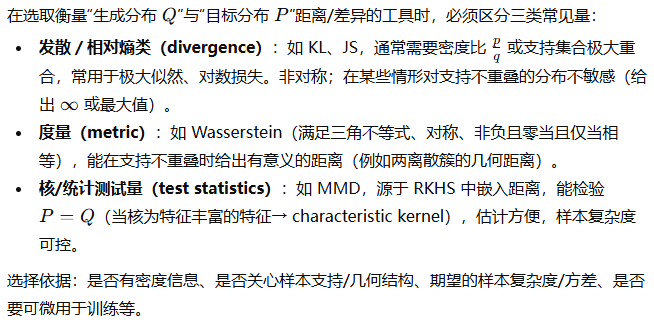
2 KL 与 JS(定义与性质)
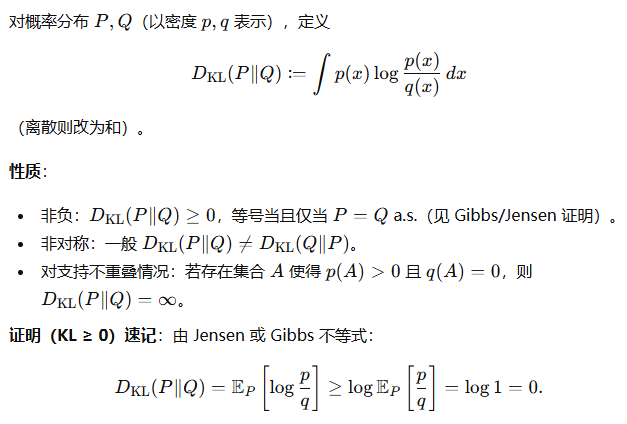
2.1 KL 散度
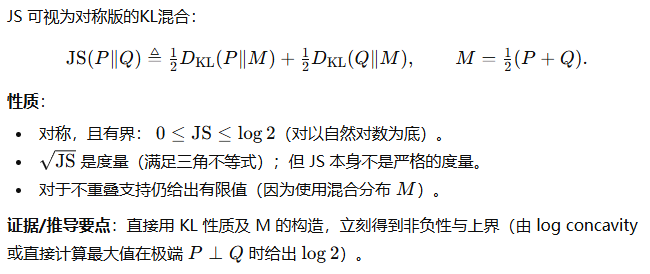
2.2 Jensen–Shannon(JS)散度
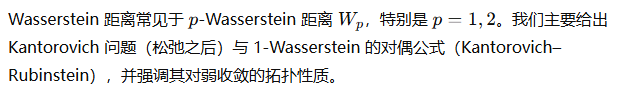
3 Wasserstein 距离(最优传输)
3.1 原始 Monge 问题(直观)
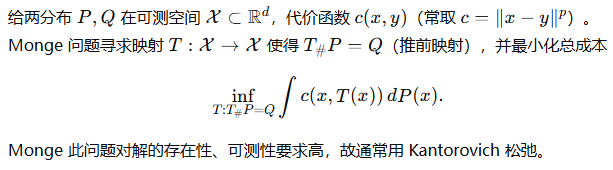
3.2 Kantorovich 问题(合适的松弛)
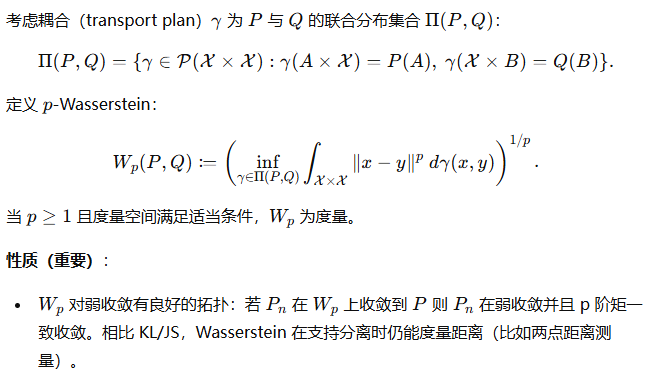
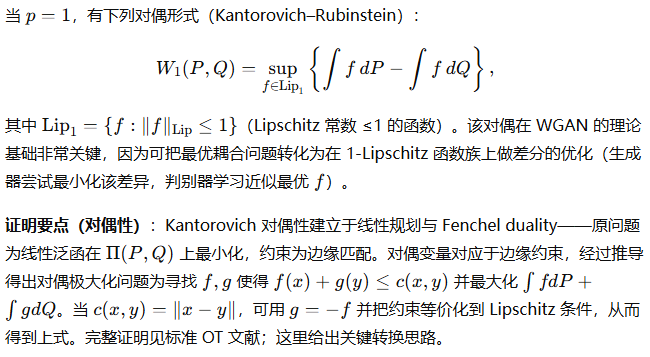
3.3 Kantorovich–Rubinstein 对偶(1-Wasserstein)
4 OT 的数值问题与 Sinkhorn(熵正则化)
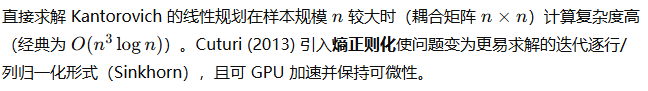
4.1 熵正则化的定义
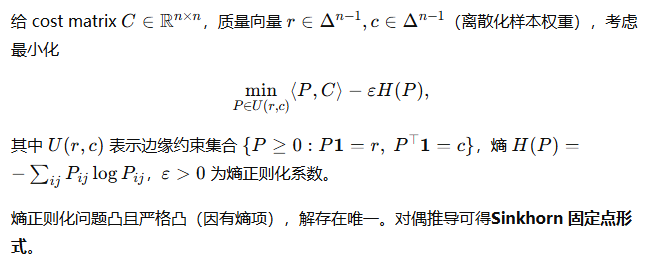
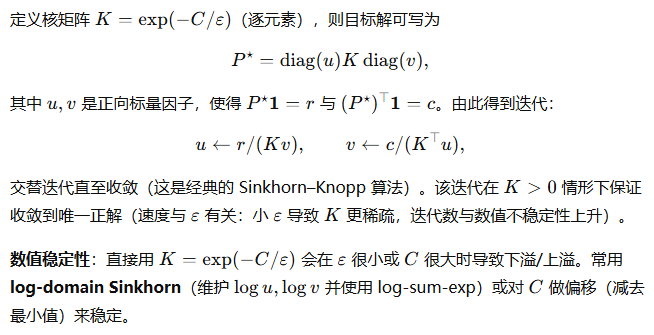
4.2 Sinkhorn 迭代(行列归一化)
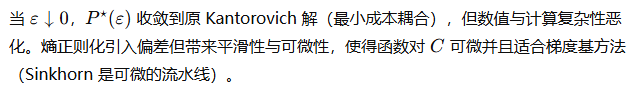
4.3 熵正则化与原问题关系(逼近性)
4.4 对偶解释(信息论视角)
熵正则化的目标等价于在代价和 KL 约束之间权衡(见 Fenchel–Legendre 模)。可理解为在所有耦合中寻找既低成本又高熵(更“扩散”)的耦合。正则化的优势在于数值稳定、易于并行化、可微。
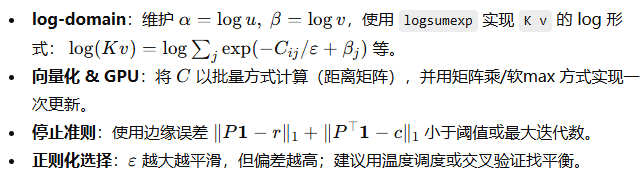
4.5 Sinkhorn 的数值实现注意
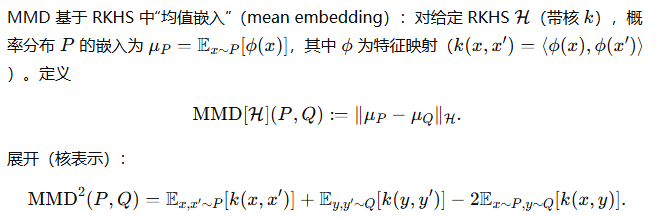
5 MMD(最大均值差异)
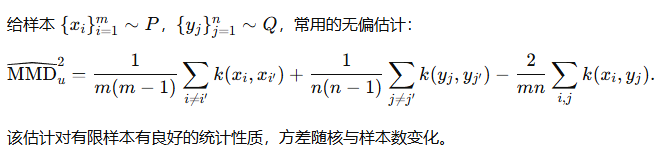
5.1 无偏估计器(样本形式)
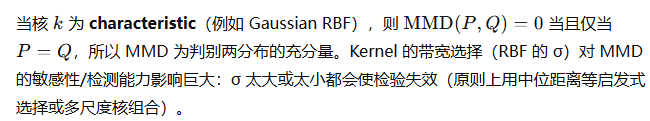
5.2 特征核与检验能力
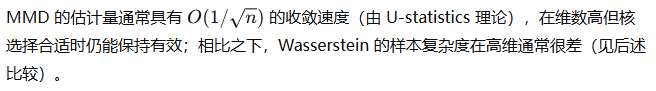
5.3 样本复杂度
6 点云距离:Chamfer 与 Hausdorff

6.1 Directed Chamfer distance(有向)
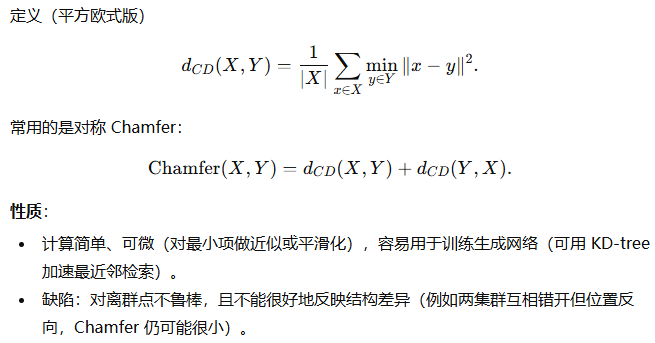
6.2 Hausdorff 距离
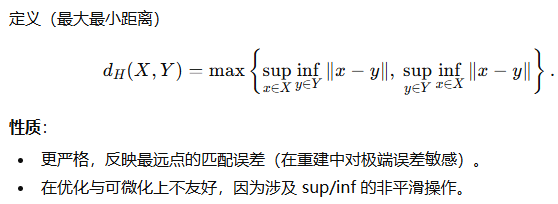
6.3 在 3D/重建中的应用建议
-
若关心全局几何与拓扑一致性:建议结合 Chamfer(局部对齐)与 Hausdorff(极端误差)或使用更结构化度量(如 Earth Mover’s Distance / Wasserstein)与表面距离(如点到三角网格的距离)。
-
为了训练稳定性:常用平滑的 Chamfer 或基于最近邻的可微近似(soft-min、soft-argmin 或带温度的归一化权重)。
7 实现:Sinkhorn 与 MMD(PyTorch 风格伪代码与数值稳定技巧)
下面给出数值实现的关键代码思路(伪码),便于工程实现。重点在数值稳定(log-domain)与 batch 化。
7.1 Sinkhorn(log-domain 稳定版)伪码(离散样本)
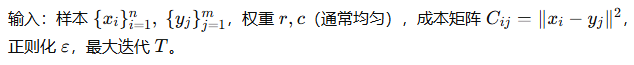
# pseudocode (vectorized)
def sinkhorn_log(C, r, c, eps, max_iter=100, tol=1e-6):
    # C: (n,m) cost matrix
    # r: (n,), c: (m,)
    # work in log domain
    # initialize log u, log v
    n, m = C.shape
    # K = exp(-C/eps) -> use logK = -C/eps
    logK = -C / eps  # shape (n,m)
    log_r = log(r)   # shape (n,)
    log_c = log(c)   # shape (m,)
    log_u = zeros(n)
    log_v = zeros(m)
    for it in range(max_iter):
        # update log_u such that row sums match r:
        # log_u = log_r - logsumexp(logK + log_v[None,:], axis=1)
        log_u = log_r - logsumexp(logK + log_v[None,:], axis=1)
        # update log_v
        log_v = log_c - logsumexp((logK + log_u[:,None]).transpose(1,0), axis=1)
        # check marginal error using current log_u, log_v
        # optional: compute error and break if small
    # reconstruct transport
    logP = log_u[:,None] + logK + log_v[None,:]
    P = exp(logP)
    return P
数值细节:
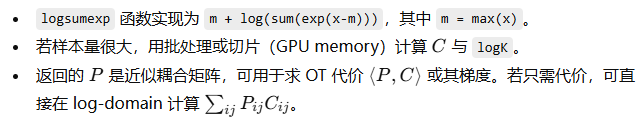
7.2 简单 Sinkhorn 距离计算(标量代价)
计算熵正则化 OT 值(Sinkhorn cost):
def sinkhorn_cost(C, r, c, eps, max_iter=100):
    P = sinkhorn_log(C, r, c, eps, max_iter)
    cost = sum(P * C)  # elementwise
    # 若需无偏估计可加上 -eps * sum(P * log(P))
    return cost
注意:上式返回的是正则化后代价。若要近似无正则化代价,需要做偏差校正或 ε\varepsilonε 退火。
7.3 MMD 实现(RBF kernel,向量化)
无偏估计版本:
def rbf_kernel_matrix(X, Y, sigma):
    # return k(x_i,y_j) jointly
    # use broadcasting to compute pairwise squared distances
    dist2 = pairwise_sq_dists(X, Y)  # shape (n,m)
    return exp(-dist2 / (2*sigma**2))

def mmd2_unbiased(X, Y, sigma):
    n = X.shape[0]
    m = Y.shape[0]
    K_xx = rbf_kernel_matrix(X, X, sigma)
    K_yy = rbf_kernel_matrix(Y, Y, sigma)
    K_xy = rbf_kernel_matrix(X, Y, sigma)
    sum_xx = (K_xx.sum() - K_xx.trace()) / (n*(n-1))
    sum_yy = (K_yy.sum() - K_yy.trace()) / (m*(m-1))
    sum_xy = K_xy.sum() / (n*m)
    return sum_xx + sum_yy - 2*sum_xy
核带宽选择:可用中位距 heuristic(median pairwise distance)或多尺度核(sum of kernels with different σ)提高健壮性。
8 生成模型评价对比(理论与实践)
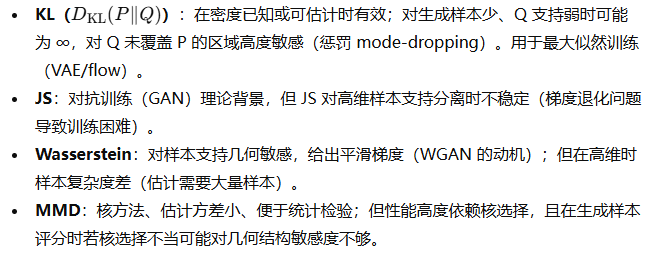
比较 KL/JS、Wasserstein(OT)、MMD 在生成模型评估上常关心的维度:
8.1 概念差异
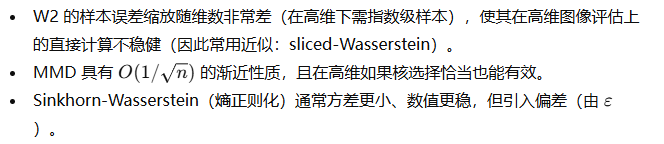
8.2 样本复杂度与估计方差
8.3 实践建议(评估生成图像)
-
对于图像:常用 FID(基于 Inception 特征的 Fréchet Distance,实质上是对嵌入分布用高斯近似的 2-Wasserstein 分析);也可用 MMD(在嵌入空间上)或 sliced-Wasserstein。
-
对于点云/3D:直接用 Chamfer + Hausdorff + Earth Mover’s Distance(EMD,即离散 OT 无正则化)评估更直接,EMD 在点对点匹配上更语义化但计算昂贵(Hungarian 算法或 Sinkhorn 近似)。
-
若评估对样式 vs 结构敏感度:使用多种指标(MMD 表征统计距离、Wasserstein 表征几何位移、Chamfer/EMD 测量点对点对应)。
9 OT 在生成模型与域适配中的现代应用(与可微近似)
9.1 生成模型
-
WGAN:用 W1W_1W1 的 Kantorovich–Rubinstein 对偶来构造判别器(学习 1-Lipschitz 函数);实际实施用权重裁剪 / gradient penalty 来近似 1-Lipschitz。WGAN 改善了 GAN 的训练稳定性与模式崩溃情况。
-
Sinkhorn GAN / OT-GAN:在判别器-生成器架构外直接利用 Sinkhorn 距离(熵正则化 OT)作为训练损失,或把 Sinkhorn 的可微代价嵌入优化中(注意 ε\varepsilonε 的平衡)。
-
Flow / score-based 模型:OT 思想用于设计最短路径 /输运映射(Monge 映射)以把简单分布映射到目标分布(而非基于 KL 的训练)。
9.2 域适配(Domain Adaptation)
-
OT 可用于在源域与目标域之间寻找最优耦合,从而将标签或样本重配以使分布对齐(unsupervised domain adaptation)。方法包括加上结构/标签保留项的 OT(带标签的 cost)、联合 OT(joint OT)或 Gromov-Wasserstein(用来对齐结构不同但内部几何有相似性的分布)。
-
Entropic OT(Sinkhorn)和其可微性使其便于集成到 end-to-end 学习中(可对网络参数求导以最小化 OT 代价)。
9.3 可微近似算法
-
Sinkhorn(熵正则化):可微、GPU 友好、并行加速;但 ε\varepsilonε 需调试。
-
Sliced-Wasserstein(SW):通过将高维分布投影到随机 1D 直线上并计算 1D-Wasserstein(可以用排序快速计算),然后对多个投影取平均。SW 的计算成本低且样本复杂度更好。
-
Gromov-Wasserstein(GW):在结构域匹配(两集合之间内部相似性)时更合适,但数值更复杂,通常也用熵正则化近似并用 Sinkhorn-like 算法。
-
Unbalanced OT / Partial OT:处理分布质量不一致或存在噪声/异常时引入的变体,常用于跟踪/分割场景。
10 工程提示(数值稳定、近似保真度的断言方法)
10.1 选择 ε\varepsilonε(Sinkhorn)
-
起点:用数据对 CCC 的中位数距离 mmm 作为尺度,选择 ε∼λm\varepsilon \sim \lambda mε∼λm(λ\lambdaλ 在 0.01–0.2)。
-
大 ε\varepsilonε → 快速收敛、低方差、高偏差(更平滑);小 ε\varepsilonε → 更接近原 OT,但需更多迭代且数值不稳定。
-
可做退火:训练初期大 ε\varepsilonε ,随后减小。
10.2 log-domain 实现
-
一定要用
logsumexp防止 exp(−C/ε)\exp(-C/\varepsilon)exp(−C/ε) 下溢。当 ε\varepsilonε 很小或 C 很大(例如平方距),提前缩放 C (例如减去 min)也有帮助。 -
当分布权重极度不均衡时,使用基于相对熵正规化或 unbalanced OT。
10.3 批量化与近似
-
对于大样本(nnn 很大),不要构造 n×nn\times nn×n 矩阵;采用 sub-sampling、mini-batch Sinkhorn 或 sliced-Wasserstein(随机投影与排序)替代。
-
对 Chamfer/Hausdorff 用近邻搜索(Approximate Nearest Neighbors, e.g., FAISS)或 KD-tree 来加速最近邻计算。
10.4 近似保真度验证
-
若使用熵正则化,要估计偏差:可在不同 ε\varepsilonε 下计算代价并检查随 ε→0\varepsilon\to0ε→0 的稳定性趋势(但不能真正到 0)。
-
交叉验证:用人工注入变换(平移、旋转、宽度/幅度改变)来验证度量的敏感性/鲁棒性。理想度量应在已知轨迹上呈单调/一致响应。
-
多指标联合:推荐同时报告 MMD、Sinkhorn cost(或 SW)、和 Chamfer/EMD(若适合)以给出全景式评估。
11 练习与实验建议(可直接运行)
实验 A:实现并对比 Sinkhorn(不同 ε\varepsilonε)与 MMD 在两组高维高斯混合分布上的区分能力
步骤:
-
在 d=50d=50d=50 空间生成两种分布 PPP(2 个簇)和 QQQ(相对位移的 2 个簇),不同位移幅度。
-
对每个位移量,采样 nnn 个样本(例如 512),计算(a)MMD (RBF with median σ)、(b)Sinkhorn cost (ε\varepsilonε 取若干倍中位数)、(c)Sliced-Wasserstein (k projections)。
-
绘制距离随位移的曲线;比较噪声稳定性(重复若干次,显示均值±误差条)。
预期:MMD 在核选择合适时分辨性好且方差小;原始 Wasserstein 在高维表现差(需要很多样本),而 Sinkhorn 在适中 ε\varepsilonε 下在样本数受限时更稳。Sliced-Wasserstein 在高维通常表现更好且计算更快。
实验 B:点云场景(3D)
-
生成基准点云(例如球面网格)与受噪声/平移/缺失点云。
-
计算 Chamfer、Hausdorff、EMD(Hungarian for small n / Sinkhorn approx for larger n)。
-
评价指标与视觉化(错误最大的点、高误差的局部结构)。
预期:Chamfer 对小规模缺失点敏感度低;EMD 更能体现整体匹配但计算贵;Hausdorff 捕捉到极端误差。
更多推荐


 19
 0
- 0


 已为社区贡献12条内容

所有评论(0)