
【Python】【机器学习】决策树
·
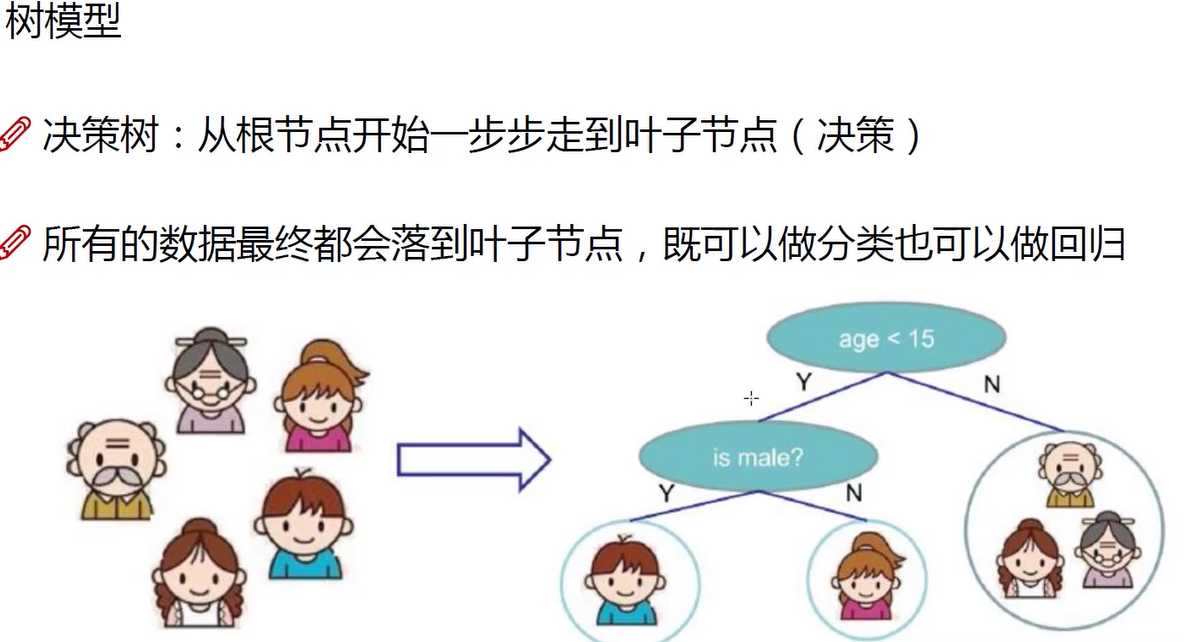
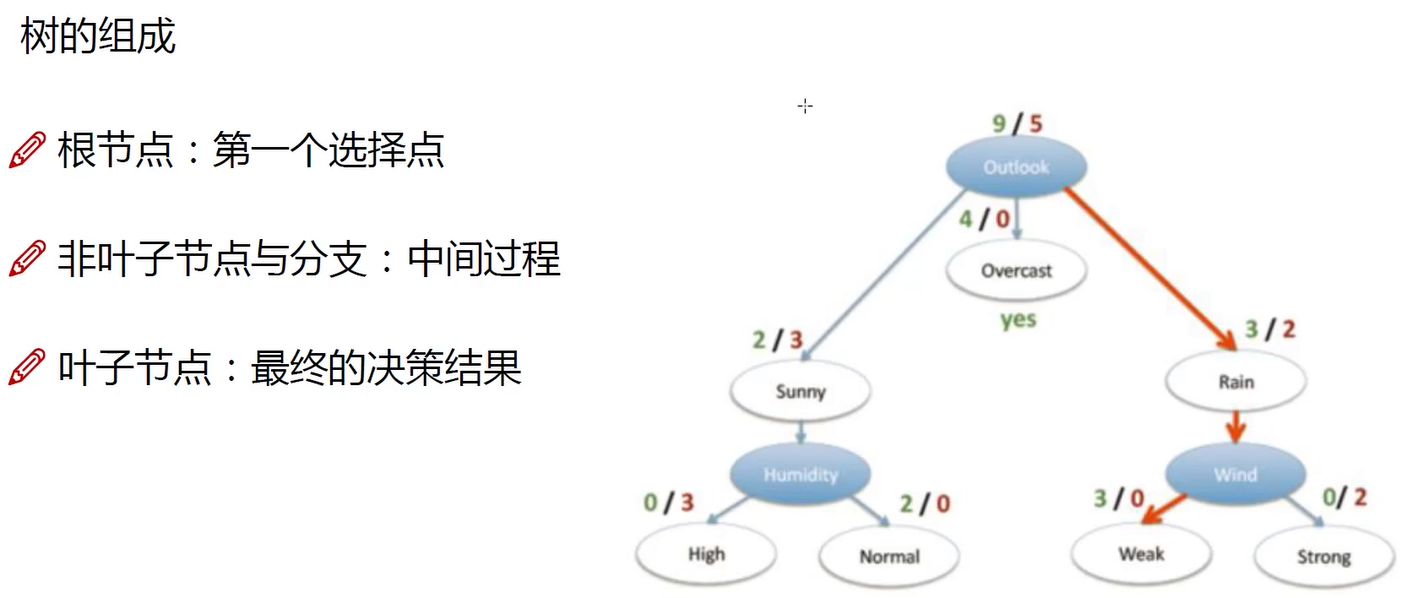
决策树中的条件顺序有严格要求,调换顺序会导致结果差异极大。类似于上场的首发和替补。根节点(首发)必须是分类效果最强、可以筛选大批量的特征,其后的结点(替补)则是细微调控的特征。
决策树做分类问题用熵值;做回归问题用平方差,此时标签y的值为分到这一类的平均值。
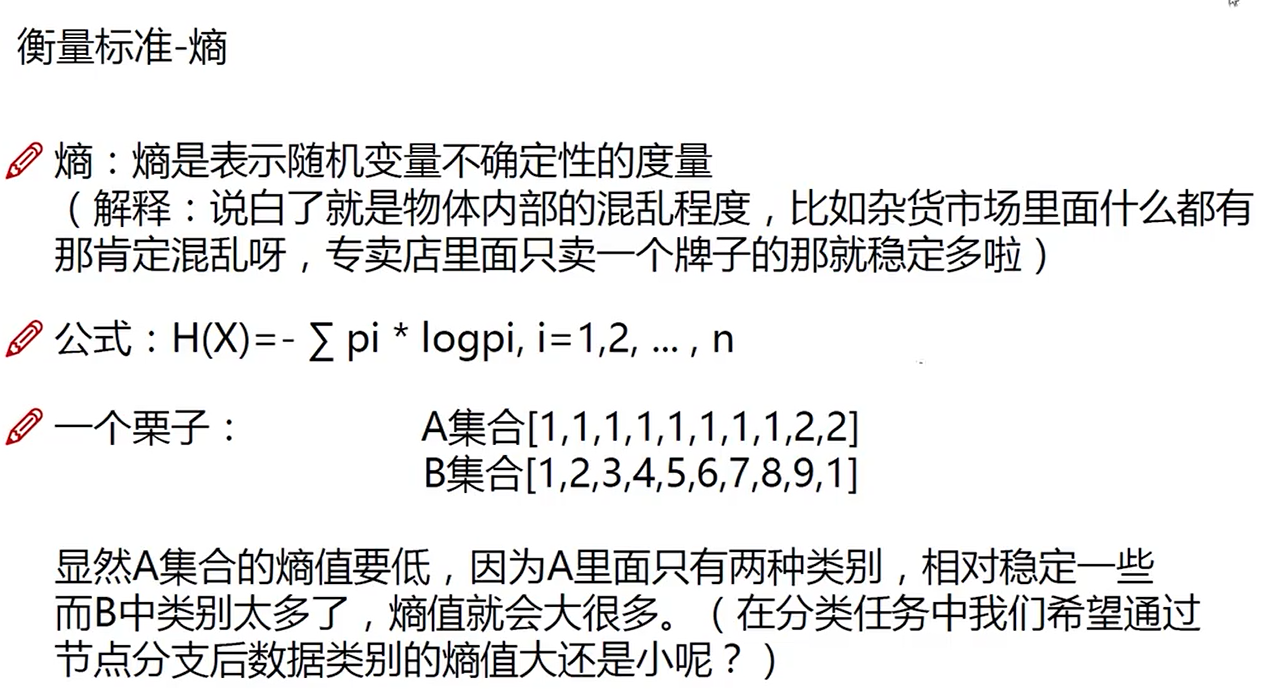
因为概率在0-1之间,所有用对数函数。
log是以2为底,lg是以10为底。
通过分类后,希望熵值下降,即不确定性减少。所以要对比熵值下降的多少来判断特征先后顺序。
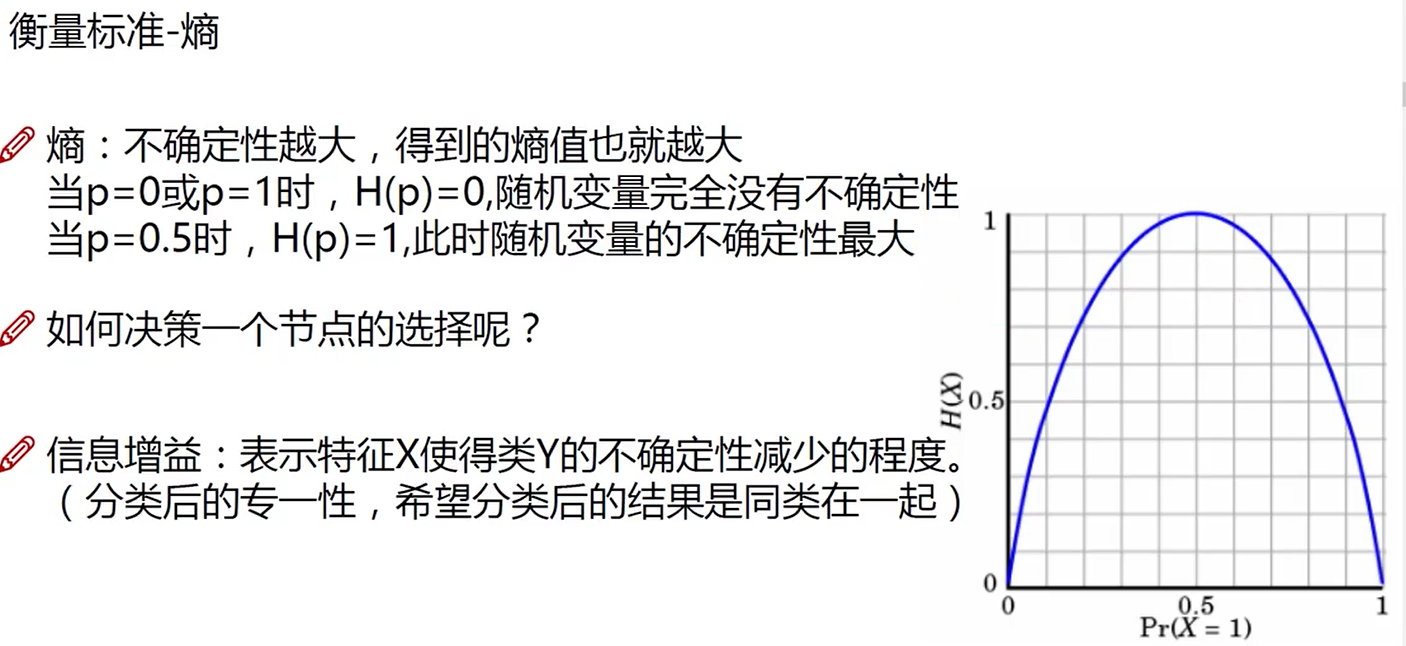
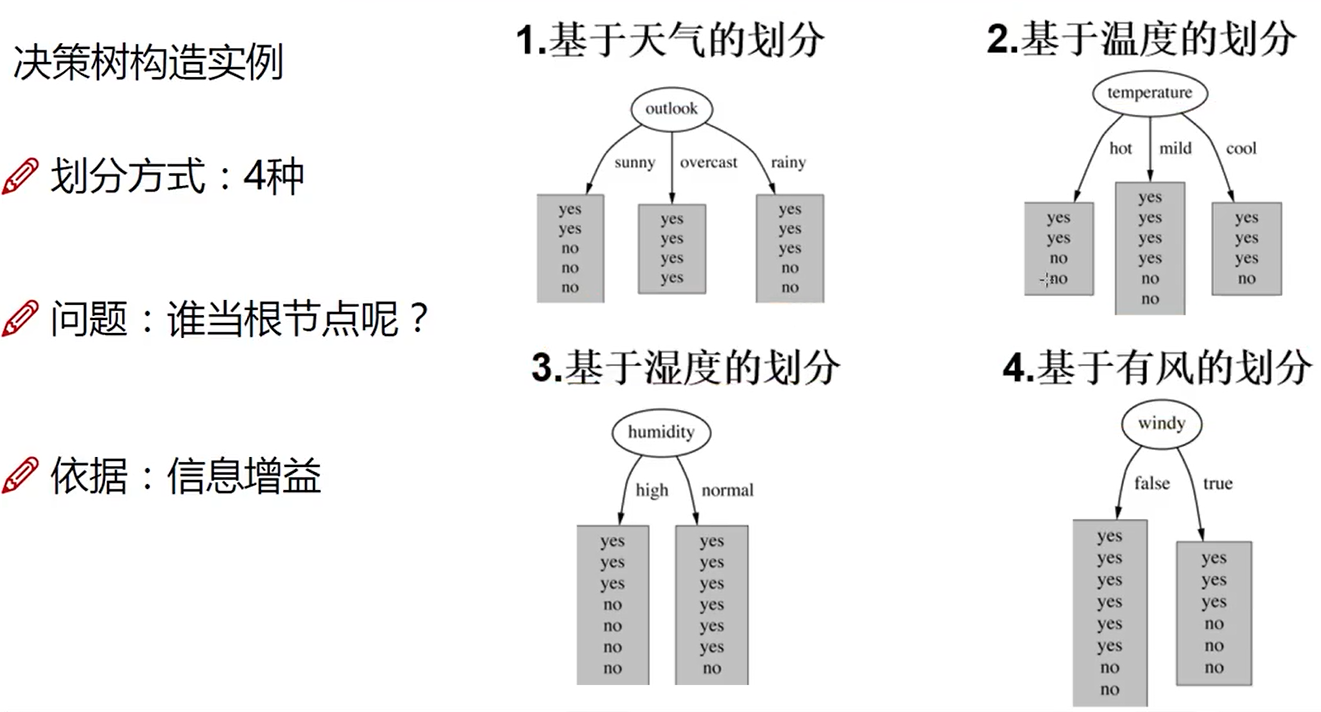
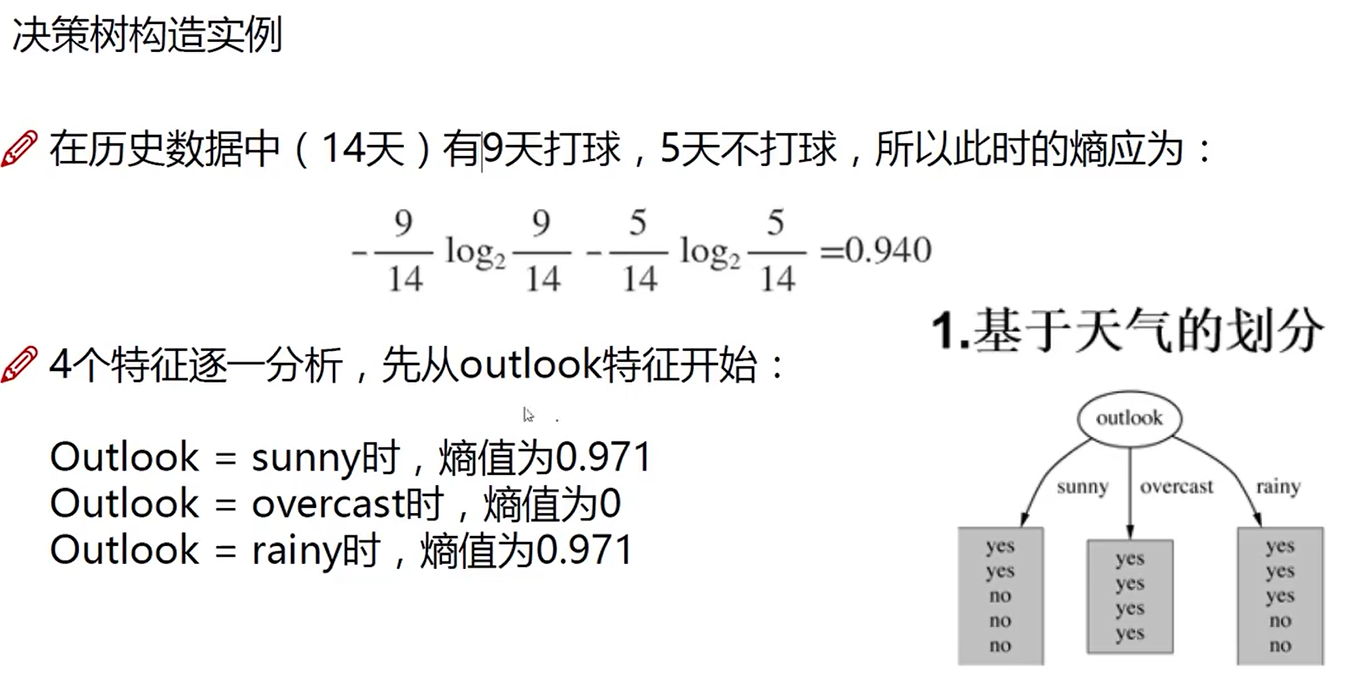
同一特征判决时,不同情况加权重。
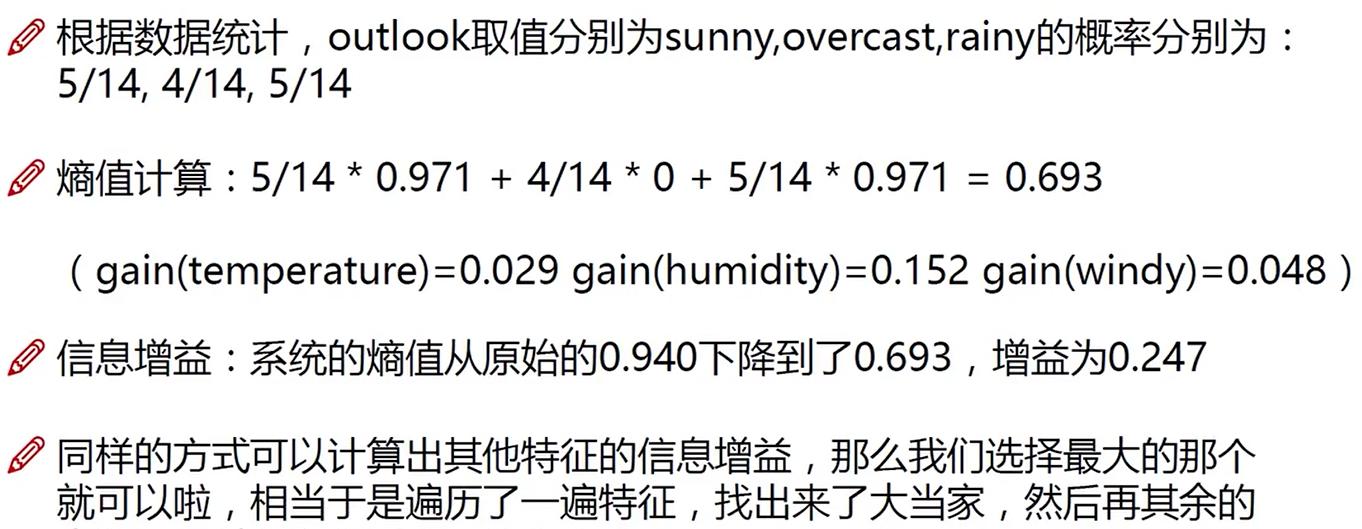
信息增益降序排列,取最大的那个特征作根节点,以此类推。
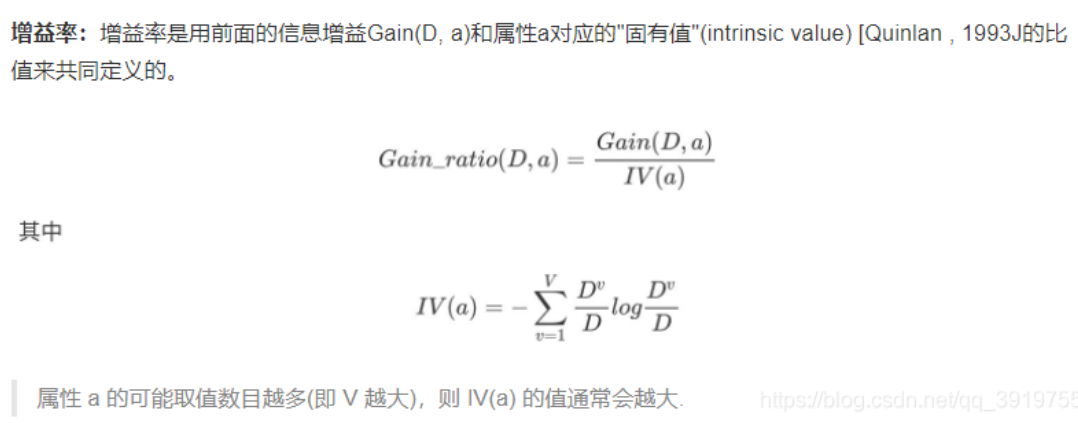
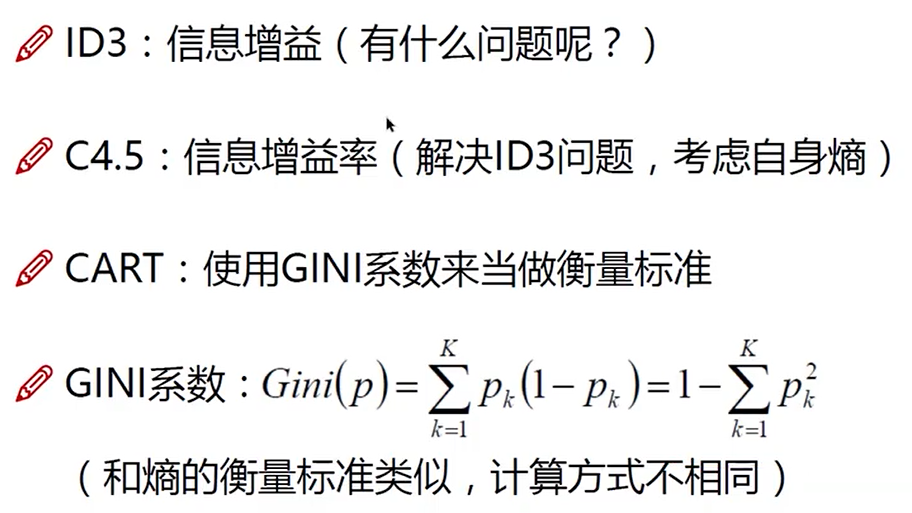 信息增益准则对可取值数目较多的属性有所偏好。对像ID这种只有一个值的属性,熵值为0,信息增益就会很大,但实际上对我们的决策并没有任何意义。所有改用信息增益率。
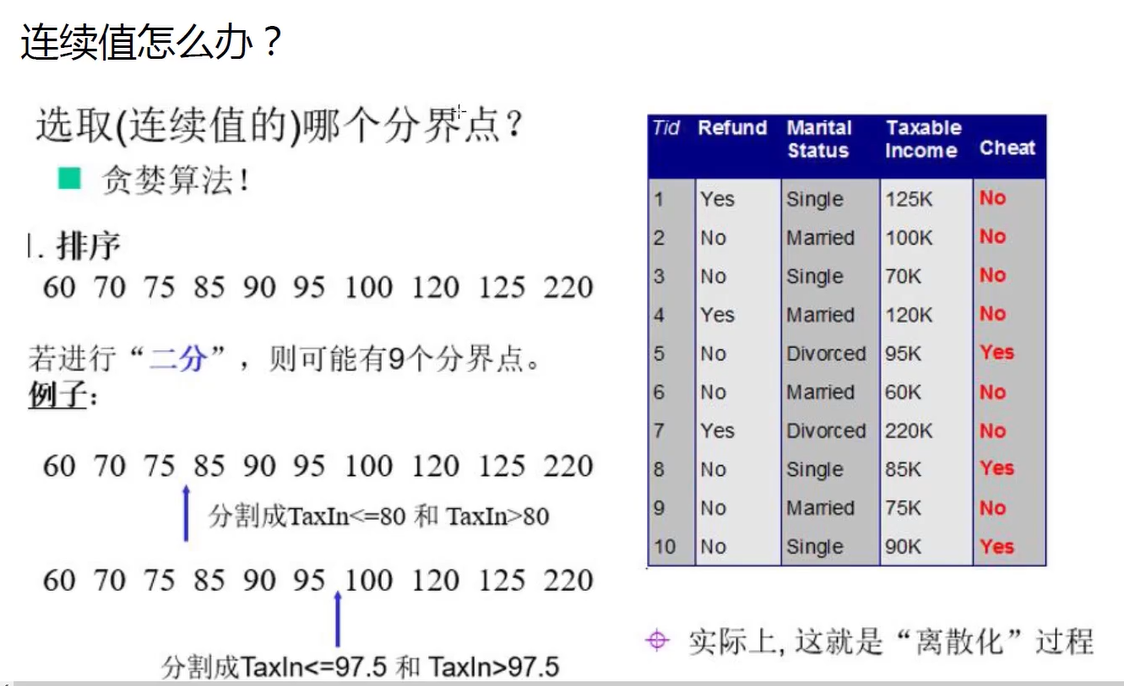
连续值离散化,挨个尝试最佳切分点,使得熵值最小,信息增益最大。
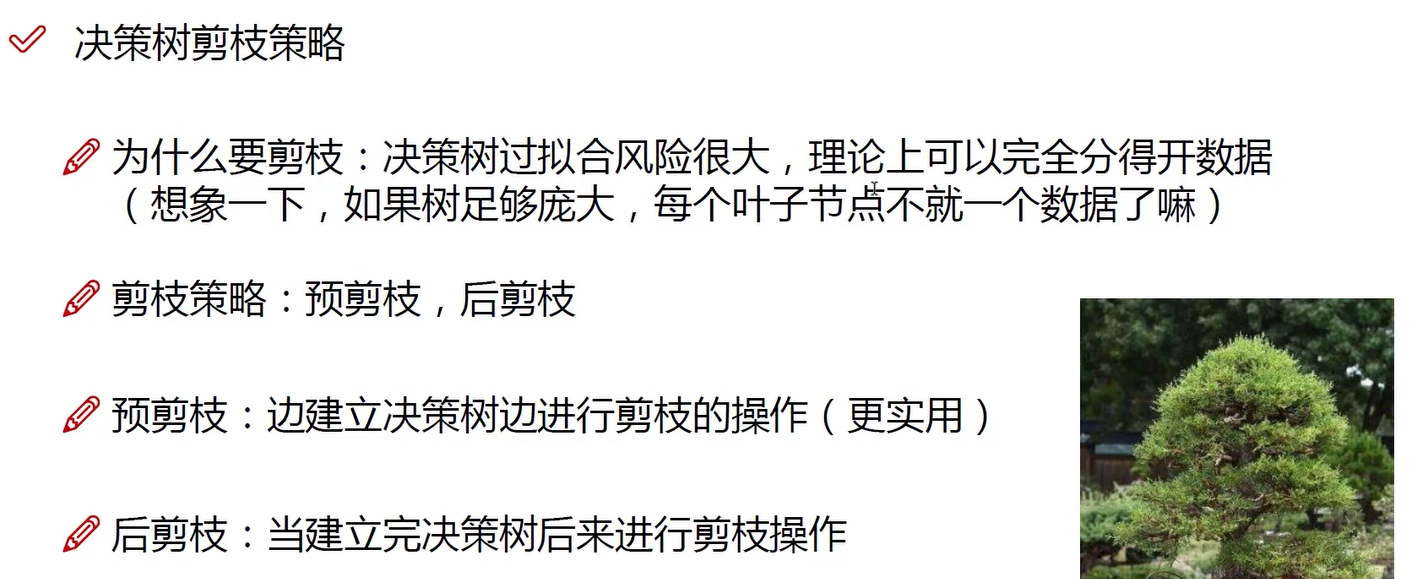
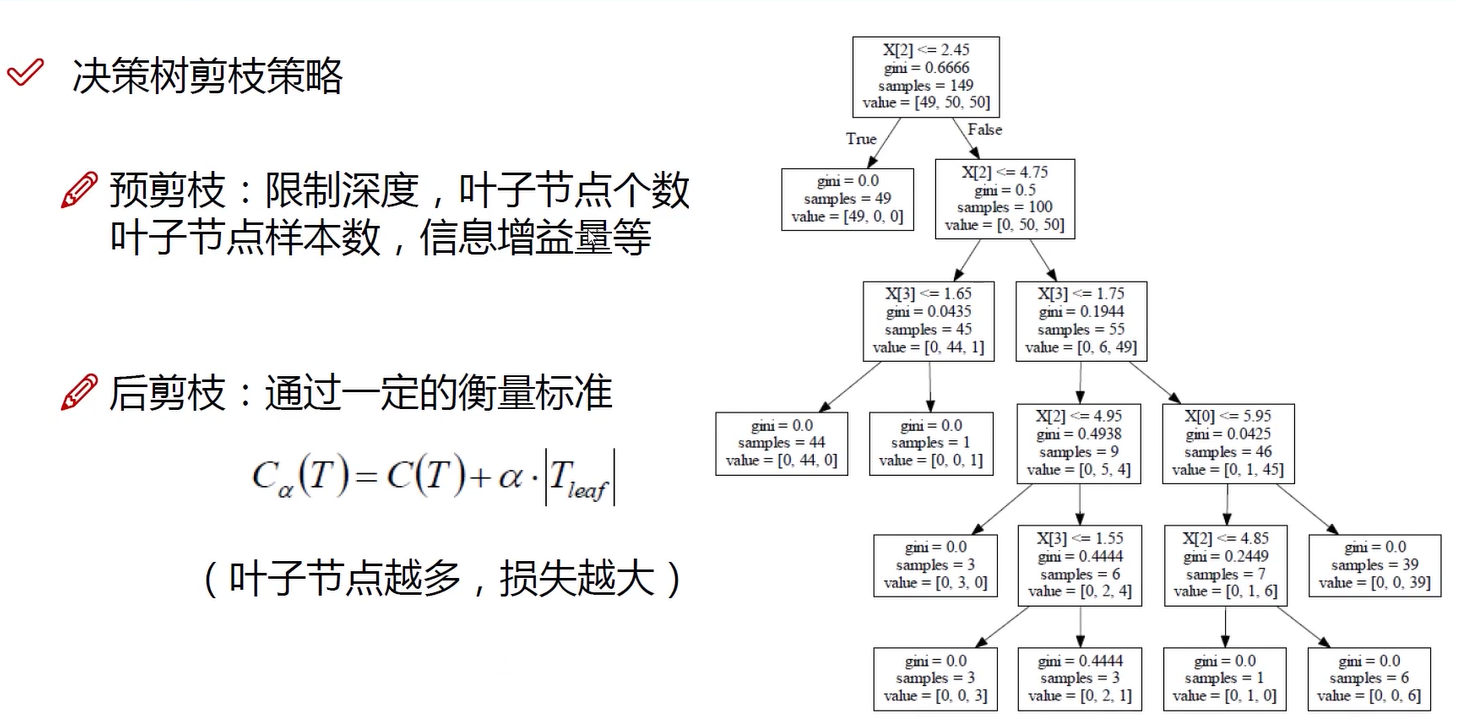
后剪枝:损失=经济系数(熵值)(ginisamples)+平衡项α叶子节点个数
α越大,越不过拟合,效果不会那么好;α越小,越容易过拟合,效果可能会越好。
更多推荐


 0
 0
- 0


 已为社区贡献9条内容

所有评论(0)