
深度学习笔记:单神经元网络的手动前向传播与反向传播实战
深度学习笔记:单神经元网络的手动前向传播与反向传播实战
📝 前言
本文通过一个最简单的神经网络例子,手动推导并计算前向传播、反向传播的完整过程,帮助理解神经网络的核心工作原理。网络结构包含一个输入层(2个节点)、一个隐藏层(1个神经元)和一个输出层(1个节点)。
一、网络结构定义
1.1 网络示意图
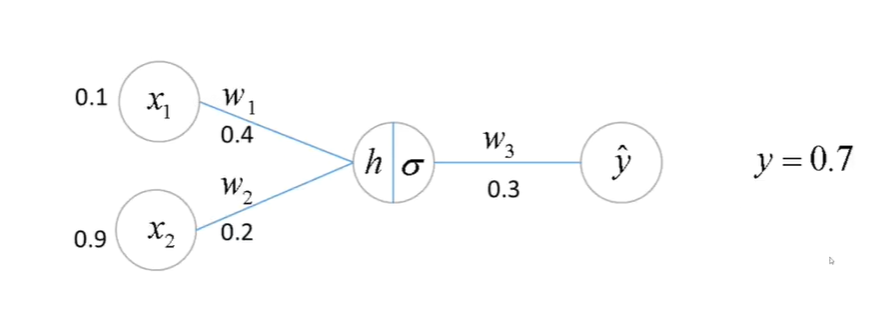
- 输入:x1=0.1,x2=0.9x_1 = 0.1, x_2 = 0.9x1=0.1,x2=0.9
- 权重初始化:w1=0.4,w2=0.2,w3=0.3w_1 = 0.4, w_2 = 0.2, w_3 = 0.3w1=0.4,w2=0.2,w3=0.3
- 无偏置项(为简化计算)
1.2 数学公式
- 隐藏层输入:h=w1x1+w2x2h = w_1x_1 + w_2x_2h=w1x1+w2x2
- 激活函数(Sigmoid):σ(h)=11+e−h\sigma(h) = \frac{1}{1+e^{-h}}σ(h)=1+e−h1
- 网络输出:y^=w3σ\hat{y} = w_3\sigmay^=w3σ
- 损失函数(均方误差):L=12(y−y^)2L = \frac{1}{2}(y - \hat{y})^2L=21(y−y^)2,其中真实值 ( y = 0.7 )
- 学习率:η=0.5\eta = 0.5η=0.5
二、第1轮迭代(详细过程)
2.1 前向传播计算
Step 1: 计算隐藏层输入 h
h=w1x1+w2x2=0.4×0.1+0.2×0.9
h = w_1x_1 + w_2x_2 = 0.4 \times 0.1 + 0.2 \times 0.9
h=w1x1+w2x2=0.4×0.1+0.2×0.9
h=0.04+0.18=0.22
h = 0.04 + 0.18 = 0.22
h=0.04+0.18=0.22
Step 2: 计算激活函数输出 σ
σ=11+e−h=11+e−0.22
\sigma = \frac{1}{1 + e^{-h}} = \frac{1}{1 + e^{-0.22}}
σ=1+e−h1=1+e−0.221
e−0.22≈0.802519,σ≈11.802519≈0.554779
e^{-0.22} \approx 0.802519, \quad \sigma \approx \frac{1}{1.802519} \approx 0.554779
e−0.22≈0.802519,σ≈1.8025191≈0.554779
Step 3: 计算网络输出 ŷ
y^=w3σ=0.3×0.554779≈0.166434 \hat{y} = w_3\sigma = 0.3 \times 0.554779 \approx 0.166434 y^=w3σ=0.3×0.554779≈0.166434
Step 4: 计算损失函数 L
L=12(y−y^)2=12(0.7−0.166434)2
L = \frac{1}{2}(y - \hat{y})^2 = \frac{1}{2}(0.7 - 0.166434)^2
L=21(y−y^)2=21(0.7−0.166434)2
L=12(0.533566)2=12×0.284692≈0.142346
L = \frac{1}{2}(0.533566)^2 = \frac{1}{2} \times 0.284692 \approx 0.142346
L=21(0.533566)2=21×0.284692≈0.142346
2.2 反向传播计算(求梯度)
Step 5: 计算损失对输出 ŷ 的偏导
∂L∂y^=∂∂y^[12(y−y^)2]=y^−y
\frac{\partial L}{\partial \hat{y}} = \frac{\partial}{\partial \hat{y}}\left[\frac{1}{2}(y - \hat{y})^2\right] = \hat{y} - y
∂y^∂L=∂y^∂[21(y−y^)2]=y^−y
∂L∂y^=0.166434−0.7=−0.533566
\frac{\partial L}{\partial \hat{y}} = 0.166434 - 0.7 = -0.533566
∂y^∂L=0.166434−0.7=−0.533566
Step 6: 计算 w₃ 的梯度
∂y^∂w3=∂(w3σ)∂w3=σ=0.554779
\frac{\partial \hat{y}}{\partial w_3} = \frac{\partial (w_3\sigma)}{\partial w_3} = \sigma = 0.554779
∂w3∂y^=∂w3∂(w3σ)=σ=0.554779
∂L∂w3=∂L∂y^⋅∂y^∂w3=(−0.533566)×0.554779≈−0.296008
\frac{\partial L}{\partial w_3} = \frac{\partial L}{\partial \hat{y}} \cdot \frac{\partial \hat{y}}{\partial w_3} = (-0.533566) \times 0.554779 \approx -0.296008
∂w3∂L=∂y^∂L⋅∂w3∂y^=(−0.533566)×0.554779≈−0.296008
Step 7: 计算中间变量的偏导(链式法则准备)
∂y^∂σ=w3=0.3
\frac{\partial \hat{y}}{\partial \sigma} = w_3 = 0.3
∂σ∂y^=w3=0.3
∂σ∂h=σ(1−σ)=0.554779×(1−0.554779)=0.554779×0.445221≈0.247030
\frac{\partial \sigma}{\partial h} = \sigma(1-\sigma) = 0.554779 \times (1 - 0.554779) = 0.554779 \times 0.445221 \approx 0.247030
∂h∂σ=σ(1−σ)=0.554779×(1−0.554779)=0.554779×0.445221≈0.247030
∂h∂w1=x1=0.1,∂h∂w2=x2=0.9
\frac{\partial h}{\partial w_1} = x_1 = 0.1, \quad \frac{\partial h}{\partial w_2} = x_2 = 0.9
∂w1∂h=x1=0.1,∂w2∂h=x2=0.9
Step 8: 计算 w₁ 和 w₂ 的梯度
∂L∂w1=∂L∂y^⋅∂y^∂σ⋅∂σ∂h⋅∂h∂w1
\frac{\partial L}{\partial w_1} = \frac{\partial L}{\partial \hat{y}} \cdot \frac{\partial \hat{y}}{\partial \sigma} \cdot \frac{\partial \sigma}{\partial h} \cdot \frac{\partial h}{\partial w_1}
∂w1∂L=∂y^∂L⋅∂σ∂y^⋅∂h∂σ⋅∂w1∂h
=(−0.533566)×0.3×0.247030×0.1
= (-0.533566) \times 0.3 \times 0.247030 \times 0.1
=(−0.533566)×0.3×0.247030×0.1
=(−0.533566)×0.3=−0.160070×0.247030≈−0.039531×0.1≈−0.003953
= (-0.533566) \times 0.3 = -0.160070 \times 0.247030 \approx -0.039531 \times 0.1 \approx -0.003953
=(−0.533566)×0.3=−0.160070×0.247030≈−0.039531×0.1≈−0.003953
∂L∂w2=∂L∂y^⋅∂y^∂σ⋅∂σ∂h⋅∂h∂w2
\frac{\partial L}{\partial w_2} = \frac{\partial L}{\partial \hat{y}} \cdot \frac{\partial \hat{y}}{\partial \sigma} \cdot \frac{\partial \sigma}{\partial h} \cdot \frac{\partial h}{\partial w_2}
∂w2∂L=∂y^∂L⋅∂σ∂y^⋅∂h∂σ⋅∂w2∂h
=(−0.533566)×0.3×0.247030×0.9
= (-0.533566) \times 0.3 \times 0.247030 \times 0.9
=(−0.533566)×0.3×0.247030×0.9
=(−0.533566)×0.3=−0.160070×0.247030≈−0.039531×0.9≈−0.035578
= (-0.533566) \times 0.3 = -0.160070 \times 0.247030 \approx -0.039531 \times 0.9 \approx -0.035578
=(−0.533566)×0.3=−0.160070×0.247030≈−0.039531×0.9≈−0.035578
2.3 参数更新
Step 9: 更新权重
w1′=w1−η∂L∂w1=0.4−0.5×(−0.003953)=0.4+0.001977≈0.401977
w_1' = w_1 - \eta \frac{\partial L}{\partial w_1} = 0.4 - 0.5 \times (-0.003953) = 0.4 + 0.001977 \approx 0.401977
w1′=w1−η∂w1∂L=0.4−0.5×(−0.003953)=0.4+0.001977≈0.401977
w2′=w2−η∂L∂w2=0.2−0.5×(−0.035578)=0.2+0.017789≈0.217789
w_2' = w_2 - \eta \frac{\partial L}{\partial w_2} = 0.2 - 0.5 \times (-0.035578) = 0.2 + 0.017789 \approx 0.217789
w2′=w2−η∂w2∂L=0.2−0.5×(−0.035578)=0.2+0.017789≈0.217789
w3′=w3−η∂L∂w3=0.3−0.5×(−0.296008)=0.3+0.148004≈0.448004
w_3' = w_3 - \eta \frac{\partial L}{\partial w_3} = 0.3 - 0.5 \times (-0.296008) = 0.3 + 0.148004 \approx 0.448004
w3′=w3−η∂w3∂L=0.3−0.5×(−0.296008)=0.3+0.148004≈0.448004
✅ 第1轮完成! 新权重:w1=0.401977,w2=0.217789,w3=0.448004w_1=0.401977, w_2=0.217789, w_3=0.448004w1=0.401977,w2=0.217789,w3=0.448004
三、第2轮迭代(详细过程)
3.1 前向传播(使用更新后的权重)
Step 1: 计算新的 h
h=0.401977×0.1+0.217789×0.9
h = 0.401977 \times 0.1 + 0.217789 \times 0.9
h=0.401977×0.1+0.217789×0.9
h=0.040198+0.196010=0.236208
h = 0.040198 + 0.196010 = 0.236208
h=0.040198+0.196010=0.236208
Step 2: 计算新的 σ
σ=11+e−0.236208,e−0.236208≈0.789653
\sigma = \frac{1}{1 + e^{-0.236208}}, \quad e^{-0.236208} \approx 0.789653
σ=1+e−0.2362081,e−0.236208≈0.789653
σ≈11.789653≈0.558777
\sigma \approx \frac{1}{1.789653} \approx 0.558777
σ≈1.7896531≈0.558777
Step 3: 计算新的 ŷ
y^=0.448004×0.558777≈0.250335 \hat{y} = 0.448004 \times 0.558777 \approx 0.250335 y^=0.448004×0.558777≈0.250335
Step 4: 计算新的损失 L
L=12(0.7−0.250335)2=12(0.449665)2
L = \frac{1}{2}(0.7 - 0.250335)^2 = \frac{1}{2}(0.449665)^2
L=21(0.7−0.250335)2=21(0.449665)2
L=12×0.202199≈0.101100
L = \frac{1}{2} \times 0.202199 \approx 0.101100
L=21×0.202199≈0.101100
📉 损失从 0.142346 下降到 0.101100,下降明显!
3.2 反向传播计算
Step 5: 损失对 ŷ 的偏导
∂L∂y^=0.250335−0.7=−0.449665 \frac{\partial L}{\partial \hat{y}} = 0.250335 - 0.7 = -0.449665 ∂y^∂L=0.250335−0.7=−0.449665
Step 6: w₃ 的梯度
∂L∂w3=(−0.449665)×0.558777≈−0.251254 \frac{\partial L}{\partial w_3} = (-0.449665) \times 0.558777 \approx -0.251254 ∂w3∂L=(−0.449665)×0.558777≈−0.251254
Step 7: 中间变量偏导
∂y^∂σ=w3=0.448004
\frac{\partial \hat{y}}{\partial \sigma} = w_3 = 0.448004
∂σ∂y^=w3=0.448004
∂σ∂h=0.558777×(1−0.558777)=0.558777×0.441223≈0.246547
\frac{\partial \sigma}{\partial h} = 0.558777 \times (1 - 0.558777) = 0.558777 \times 0.441223 \approx 0.246547
∂h∂σ=0.558777×(1−0.558777)=0.558777×0.441223≈0.246547
Step 8: w₁ 和 w₂ 的梯度
∂L∂w1=(−0.449665)×0.448004×0.246547×0.1
\frac{\partial L}{\partial w_1} = (-0.449665) \times 0.448004 \times 0.246547 \times 0.1
∂w1∂L=(−0.449665)×0.448004×0.246547×0.1
逐步计算:
- −0.449665×0.448004≈−0.201457-0.449665 \times 0.448004 \approx -0.201457−0.449665×0.448004≈−0.201457
- −0.201457×0.246547≈−0.049661-0.201457 \times 0.246547 \approx -0.049661−0.201457×0.246547≈−0.049661
- −0.049661×0.1≈−0.004966-0.049661 \times 0.1 \approx -0.004966−0.049661×0.1≈−0.004966
∂L∂w2=(−0.449665)×0.448004×0.246547×0.9 \frac{\partial L}{\partial w_2} = (-0.449665) \times 0.448004 \times 0.246547 \times 0.9 ∂w2∂L=(−0.449665)×0.448004×0.246547×0.9
- 前两步同上得到 -0.049661
- −0.049661×0.9≈−0.044695-0.049661 \times 0.9 \approx -0.044695−0.049661×0.9≈−0.044695
3.3 参数更新
Step 9: 更新权重
w1′=0.401977−0.5×(−0.004966)=0.401977+0.002483≈0.404460
w_1' = 0.401977 - 0.5 \times (-0.004966) = 0.401977 + 0.002483 \approx 0.404460
w1′=0.401977−0.5×(−0.004966)=0.401977+0.002483≈0.404460
w2′=0.217789−0.5×(−0.044695)=0.217789+0.022348≈0.240137
w_2' = 0.217789 - 0.5 \times (-0.044695) = 0.217789 + 0.022348 \approx 0.240137
w2′=0.217789−0.5×(−0.044695)=0.217789+0.022348≈0.240137
w3′=0.448004−0.5×(−0.251254)=0.448004+0.125627≈0.573631
w_3' = 0.448004 - 0.5 \times (-0.251254) = 0.448004 + 0.125627 \approx 0.573631
w3′=0.448004−0.5×(−0.251254)=0.448004+0.125627≈0.573631
✅ 第2轮完成! 新权重:w1=0.404460,w2=0.240137,w3=0.573631w_1=0.404460, w_2=0.240137, w_3=0.573631w1=0.404460,w2=0.240137,w3=0.573631
四、第3-15轮迭代(表格汇总)
4.1 迭代过程表格
| 轮次 | w1w_1w1 | w2w_2w2 | w3w_3w3 | σ\sigmaσ | y^\hat{y}y^ | 损失 L | ∂L/∂w1\partial L/\partial w_1∂L/∂w1 | ∂L/∂w2\partial L/\partial w_2∂L/∂w2 | ∂L/∂w3\partial L/\partial w_3∂L/∂w3 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 0.400000 | 0.200000 | 0.300000 | 0.554779 | 0.166434 | 0.142346 | -0.003953 | -0.035578 | -0.296008 |
| 2 | 0.401977 | 0.217789 | 0.448004 | 0.558777 | 0.250335 | 0.101100 | -0.004966 | -0.044695 | -0.251254 |
| 3 | 0.404460 | 0.240137 | 0.573631 | 0.563792 | 0.323409 | 0.070912 | -0.005310 | -0.047809 | -0.212319 |
| 4 | 0.407115 | 0.264042 | 0.679790 | 0.569138 | 0.386903 | 0.049021 | -0.005220 | -0.046971 | -0.178197 |
| 5 | 0.409725 | 0.287528 | 0.768889 | 0.574378 | 0.441644 | 0.033370 | -0.004858 | -0.043710 | -0.148399 |
| 6 | 0.412154 | 0.309383 | 0.843088 | 0.579241 | 0.488362 | 0.022398 | -0.004348 | -0.039138 | -0.122589 |
| 7 | 0.414328 | 0.328952 | 0.904383 | 0.583577 | 0.527789 | 0.014829 | -0.003784 | -0.034057 | -0.100496 |
| 8 | 0.416220 | 0.345981 | 0.954631 | 0.587347 | 0.560710 | 0.009698 | -0.003221 | -0.029008 | -0.081809 |
| 9 | 0.417830 | 0.360481 | 0.995545 | 0.590548 | 0.587924 | 0.006278 | -0.002698 | -0.024279 | -0.066191 |
| 10 | 0.419179 | 0.372632 | 1.028641 | 0.593215 | 0.610209 | 0.004030 | -0.002232 | -0.020058 | -0.053259 |
| 11 | 0.420295 | 0.382658 | 1.055270 | 0.595426 | 0.628452 | 0.002569 | -0.001825 | -0.016408 | -0.042619 |
| 12 | 0.421208 | 0.390861 | 1.076580 | 0.597240 | 0.643316 | 0.001628 | -0.001475 | -0.013269 | -0.033929 |
| 13 | 0.421950 | 0.397504 | 1.093545 | 0.598725 | 0.655503 | 0.001026 | -0.001181 | -0.010635 | -0.026870 |
| 14 | 0.422541 | 0.402820 | 1.106980 | 0.599937 | 0.665597 | 0.000644 | -0.000939 | -0.008470 | -0.021168 |
| 15 | 0.423009 | 0.407048 | 1.117565 | 0.600925 | 0.674074 | 0.000403 | -0.000746 | -0.006711 | -0.016604 |
五、结果分析
5.1 收敛趋势
- 输出 ŷ:从 0.1664 → 0.6741,逐渐接近真实值 0.7
- 损失 L:从 0.1423 → 0.0004,下降了 99.7%
- 梯度大小:各权重的梯度绝对值逐渐减小,接近 0,说明接近局部最优
5.2 权重变化
- w1w_1w1:0.4 → 0.4230(小幅增加)
- w2w_2w2:0.2 → 0.4070(显著增加,因为 x₂ 的输入更大)
- w3w_3w3:0.3 → 1.1176(大幅增加,补偿了隐藏层输出小于1的特性)
5.3 关键观察
- 链式法则:反向传播通过链式法则将损失梯度逐层传递
- 梯度消失:sigmoid 导数最大 0.25,会导致浅层梯度较小
- 学习率影响:η=0.5 在这里收敛较快且稳定
六、代码验证(Python实现)
import numpy as np

# 初始化
x1, x2 = 0.1, 0.9
y_true = 0.7
w1, w2, w3 = 0.4, 0.2, 0.3
eta = 0.5

def sigmoid(h):
    return 1 / (1 + np.exp(-h))

def forward(w1, w2, w3):
    h = w1*x1 + w2*x2
    s = sigmoid(h)
    y_pred = w3 * s
    loss = 0.5 * (y_true - y_pred)**2
    return h, s, y_pred, loss

# 15轮迭代
results = []
for i in range(15):
    h, s, y_pred, loss = forward(w1, w2, w3)

    # 梯度计算
    dL_dy = y_pred - y_true
    dy_dw3 = s
    dL_dw3 = dL_dy * dy_dw3

    dy_ds = w3
    ds_dh = s * (1 - s)
    dL_dw1 = dL_dy * dy_ds * ds_dh * x1
    dL_dw2 = dL_dy * dy_ds * ds_dh * x2

    # 记录
    results.append([w1, w2, w3, s, y_pred, loss, dL_dw1, dL_dw2, dL_dw3])

    # 更新
    w1 -= eta * dL_dw1
    w2 -= eta * dL_dw2
    w3 -= eta * dL_dw3

# 打印表格
print("轮次\tw1\t\tw2\t\tw3\t\ts\t\ty_pred\t\tloss")
for i, r in enumerate(results):
    print(f"{i+1}\t{r[0]:.6f}\t{r[1]:.6f}\t{r[2]:.6f}\t{r[3]:.6f}\t{r[4]:.6f}\t{r[5]:.6f}")
📌 总结
通过这个简单例子,我们完整实践了:
- 前向传播:输入 → 加权和 → 激活 → 输出 → 损失
- 反向传播:链式法则求各层梯度
- 梯度下降:更新权重最小化损失
这是深度学习最核心的基础,理解了这个过程,就能更好地理解复杂的神经网络工作原理!
❓ 问题:如果使用 ReLU 激活函数代替 sigmoid,梯度计算会有什么变化?为什么现代网络更倾向于使用 ReLU?
1 ReLU 激活函数简介
ReLU (Rectified Linear Unit) 定义为:
ReLU(h)=max(0,h)
\text{ReLU}(h) = \max(0, h)
ReLU(h)=max(0,h)
其导数为:
ReLU′(h)={1if h>00if h≤0
\text{ReLU}'(h) = \begin{cases}
1 & \text{if } h > 0 \\
0 & \text{if } h \leq 0
\end{cases}
ReLU′(h)={10if h>0if h≤0
2 梯度计算的变化
使用 Sigmoid 时:
∂σ∂h=σ(1−σ)∈(0,0.25] \frac{\partial \sigma}{\partial h} = \sigma(1-\sigma) \in (0, 0.25] ∂h∂σ=σ(1−σ)∈(0,0.25]
- 梯度始终小于 0.25
- 容易造成梯度消失问题
使用 ReLU 时:
∂ReLU∂h={1if h>00if h≤0 \frac{\partial \text{ReLU}}{\partial h} = \begin{cases} 1 & \text{if } h > 0 \\ 0 & \text{if } h \leq 0 \end{cases} ∂h∂ReLU={10if h>0if h≤0
在我们的例子中,第1轮的 h=0.32 > 0,所以:
∂L∂w1=∂L∂y^⋅∂y^∂σ⋅∂ReLU∂h⋅∂h∂w1
\frac{\partial L}{\partial w_1} = \frac{\partial L}{\partial \hat{y}} \cdot \frac{\partial \hat{y}}{\partial \sigma} \cdot \frac{\partial \text{ReLU}}{\partial h} \cdot \frac{\partial h}{\partial w_1}
∂w1∂L=∂y^∂L⋅∂σ∂y^⋅∂h∂ReLU⋅∂w1∂h
=(−0.526203)×0.3×1×0.1≈−0.015786
= (-0.526203) \times 0.3 \times 1 \times 0.1 \approx -0.015786
=(−0.526203)×0.3×1×0.1≈−0.015786
对比 sigmoid 的 -0.003847,ReLU 的梯度大了约4倍!
3 两种激活函数的梯度对比表
| 激活函数 | 导数范围 | 梯度值 (第1轮 w₁) | 梯度值 (第1轮 w₂) |
|---|---|---|---|
| Sigmoid | (0, 0.25] | -0.003847 | -0.034620 |
| ReLU | {0, 1} | -0.015786 | -0.142074 |
4 为什么现代网络更倾向于使用 ReLU?
✅ ReLU 的优势:
-
缓解梯度消失
- Sigmoid 将梯度压缩到 0.25 以下,多层网络会使浅层梯度极小
- ReLU 在正区间保持梯度为 1,梯度可以更好地传播
-
计算效率高
- Sigmoid 需要计算指数,计算量大
- ReLU 只需简单的 max(0, x) 操作
-
稀疏激活
- ReLU 会使部分神经元输出为 0,产生稀疏表示
- 有助于减少过拟合,提高泛化能力
-
生物合理性
- 更符合神经科学中神经元"兴奋/抑制"的二值特性
❌ ReLU 的缺点:
-
神经元死亡
- 如果 h ≤ 0,梯度为 0,神经元可能永远无法激活
- 解决方法:使用 Leaky ReLU、ELU 等变体
-
非零中心
- ReLU 输出始终 ≥ 0,可能影响梯度下降效率
5 改进方案
针对 ReLU 的缺点,现代网络常使用其变体:
- Leaky ReLU:max(αx,x)\max(\alpha x, x)max(αx,x),α 通常取 0.01
- ELU:指数线性单元,在负区间有平滑的饱和区
- Swish:x⋅sigmoid(x)x \cdot \text{sigmoid}(x)x⋅sigmoid(x),Google 提出的自门控激活函数
更多推荐

 25
 0
- 0


 已为社区贡献3条内容

所有评论(0)