
传统ML推理 vs LLM推理:为什么大模型需要专属高性能推理引擎?
大语言模型(LLM)的推理过程,和传统的机器学习模型(如CNN、BERT等)有着本质区别。正因为这些独特挑战,业界才专门开发了vLLM、TensorRT-LLM、SGLang等高性能LLM推理引擎。
今天我们就来逐一拆解这五大核心差异,以及对应的解决方案。看完你就明白,为什么“随便用个框架跑LLM”往往跑不快、跑不稳。
1. 连续批处理(Continuous Batching)
传统ML模型输入输出长度固定(比如一张224×224的图片,输出10个类别概率),批处理非常简单:一批请求一起进来,一起算完,一起走人。
LLM却完全不同——Prompt长度各异,生成长度也随时可能结束。如果你强行把几个请求打包成一个batch,最慢的那个请求会拖累整个batch,GPU只能干等着,空闲时间一大把。
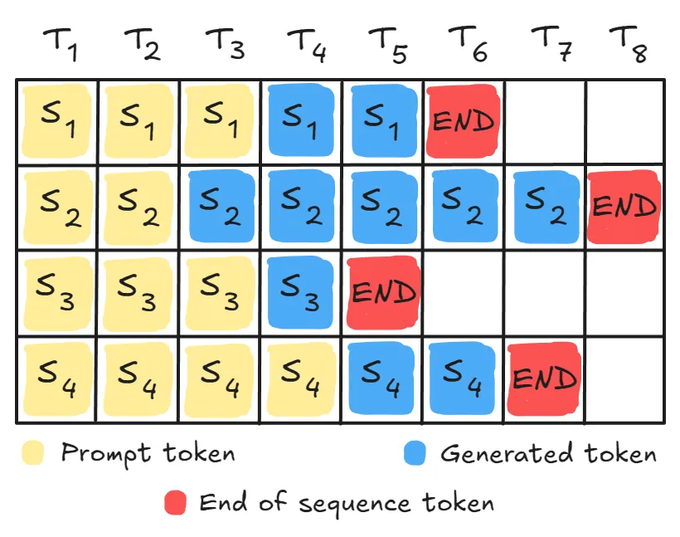
连续批处理就是来终结这个浪费的。
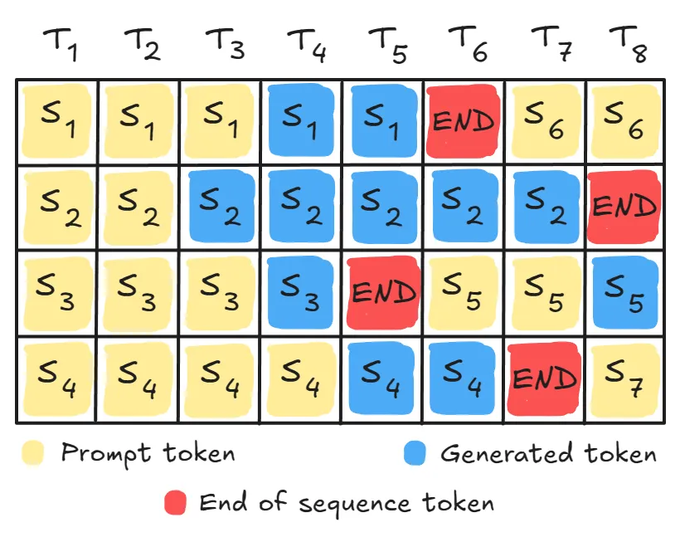
系统不再死等整批完成,而是实时监控每个序列:一旦某个序列输出结束符(),立刻把这个槽位腾出来,塞进新的请求。GPU流水线始终满载,利用率直接拉满。
2. Prefill与Decode阶段分离(Prefill-Decode Disaggregation)
LLM单次推理其实是两个阶段,资源需求天差地别:
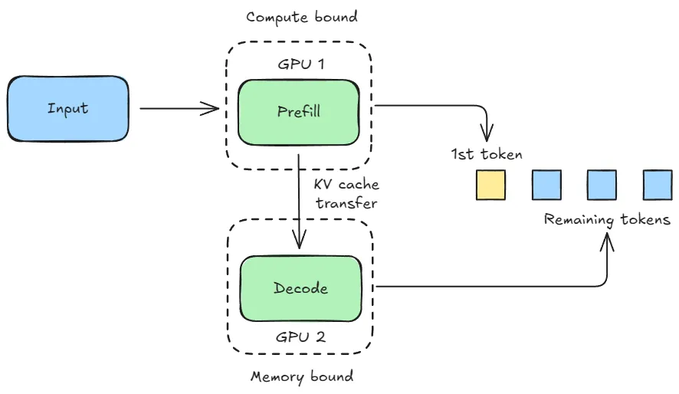
- Prefill阶段:一次性把整个Prompt的所有Token算完,纯计算密集型(Compute-bound)。
- Decode阶段:一个Token一个Token自回归生成,对延迟极其敏感(Latency-sensitive)。
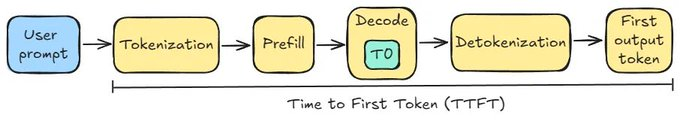
如果两个阶段混在同一批GPU上,算力重的Prefill请求会严重拖慢正在解码的请求,导致整体延迟爆炸。
解决方案:把GPU分成两池——一池专职Prefill,一池专职Decode,完全物理隔离,互不干扰。传统ML模型只有一个统一计算阶段,根本不用操这个心。
3. GPU内存管理与KV缓存(KV Cache + Paged Attention)
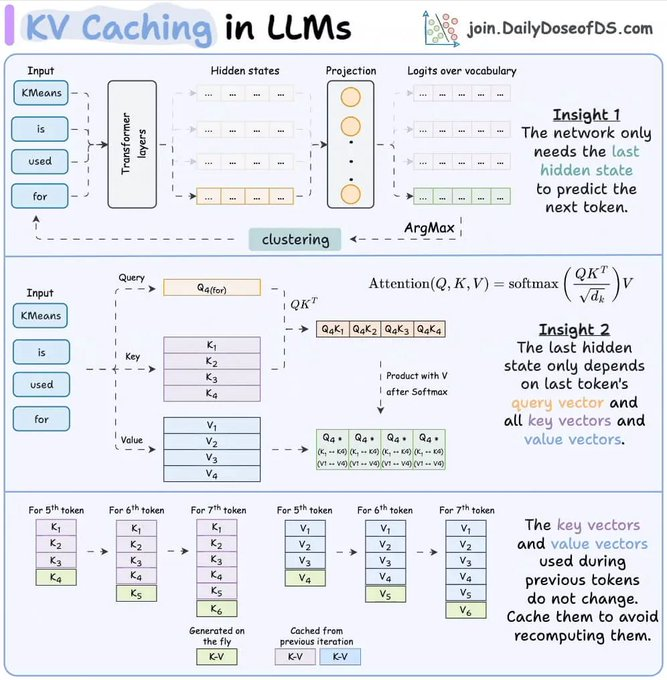
生成下一个新Token时,必须用到前面所有Token的Key和Value向量。如果每次都重算,效率低到离谱。
于是我们引入KV缓存,把算好的Key/Value直接存起来复用。
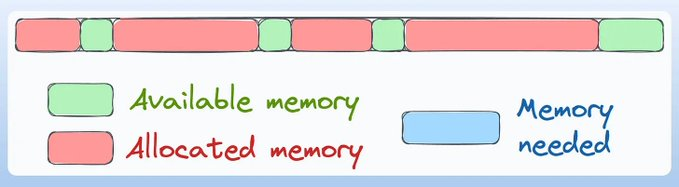
KV Cache会随着对话长度线性膨胀,而且必须占用连续内存块,非常容易造成碎片,浪费大量显存。尤其当系统提示词(System Prompt)被多个请求共享时,更需要高效复用。
Paged Attention(分页注意力) 完美解决了这个问题。它把KV Cache拆成非连续的内存页,像操作系统分页一样管理,只加载当前需要的页,大幅减少碎片,提高显存利用率。
4. 前缀感知路由(Prefix-aware Routing)
扩展传统ML模型很简单:把模型复制多份,用轮询(Round Robin)或最闲服务器路由就行——每个请求完全独立,没毛病。
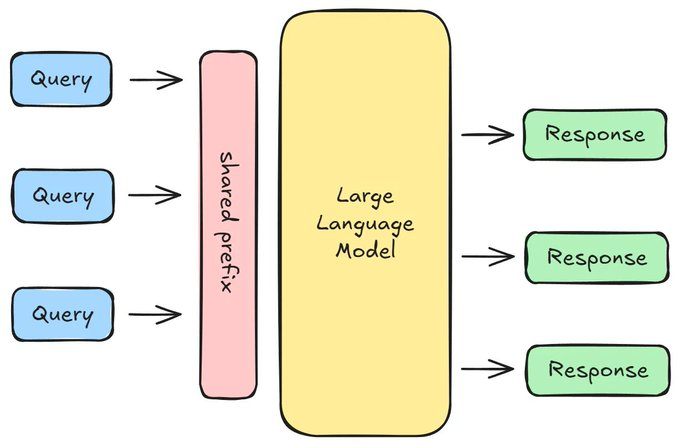
LLM却高度依赖缓存,尤其是共享前缀(长上下文的前半段、系统提示等)。如果路由器把一个带已缓存前缀的请求,错误发到没有缓存的GPU上,那台GPU就得从头重算整个前缀的KV Cache,白白浪费算力。
前缀感知路由直接干掉这个问题。
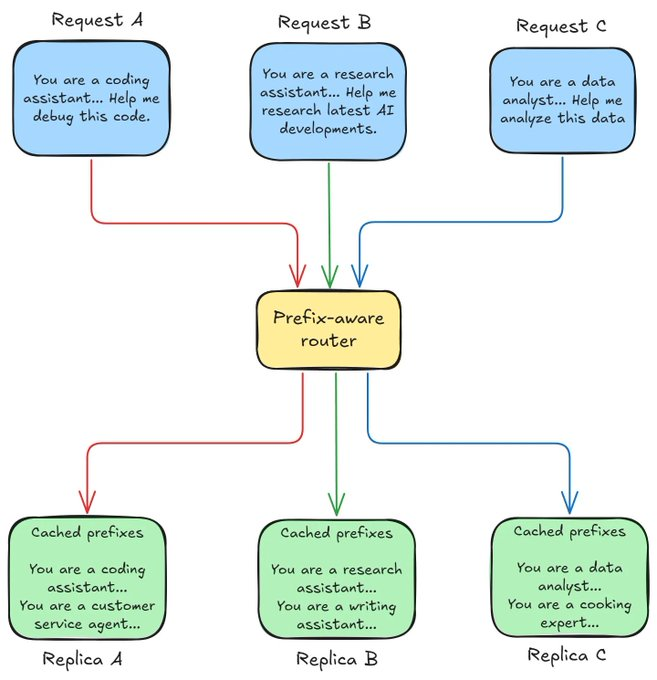
路由器内部维护一张实时映射表(或用预测算法),记录每个GPU副本上当前缓存了哪些前缀。新请求一来,优先路由到已经缓存对应前缀的GPU,最大化缓存命中率。vLLM、TGI等框架都有各自成熟实现。
5. 模型分片策略的复杂性(以MoE为例)
传统稠密模型分片相对直白。
但现在的LLM,尤其是**Mixture of Experts(MoE)**模型,完全是另一个维度。
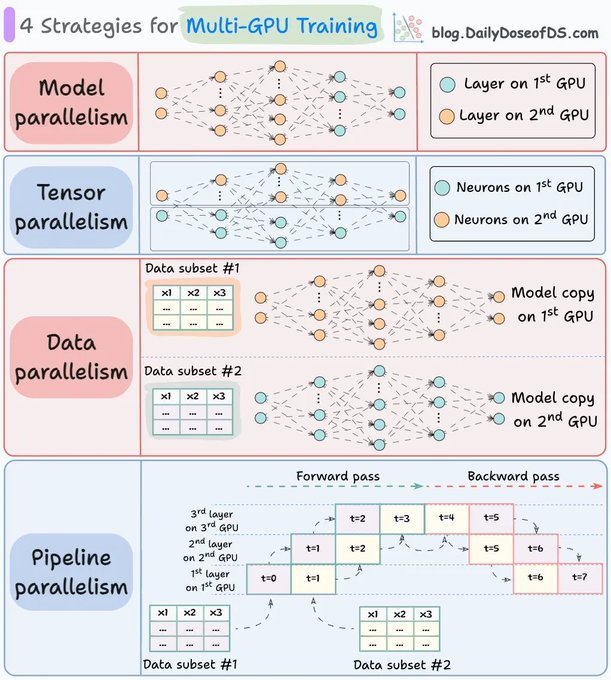
MoE采用专家并行(Expert Parallelism):
- 不同Expert切分到不同GPU
- Attention层在所有GPU上复制
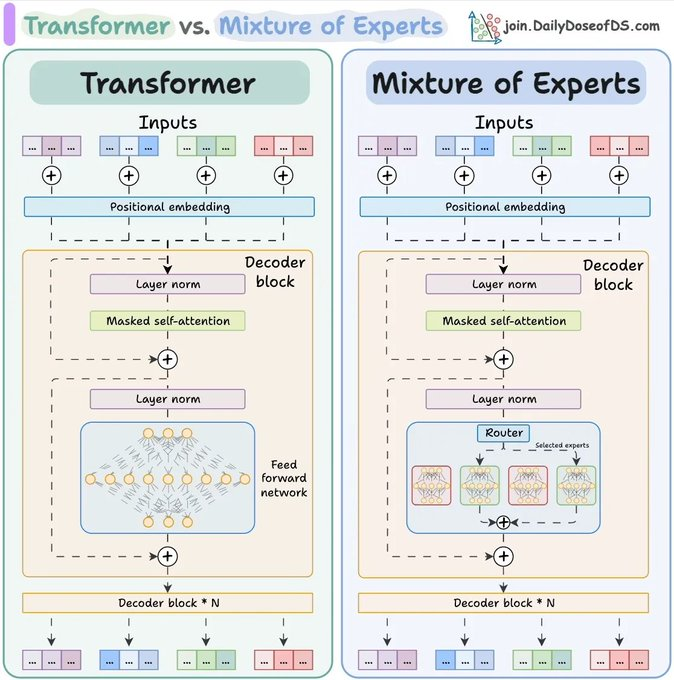
每张GPU只持有部分Expert的权重。当请求到来时,MoE层的门控网络(Gating Network)会动态决定把当前Token路由到哪些Expert所在的GPU。
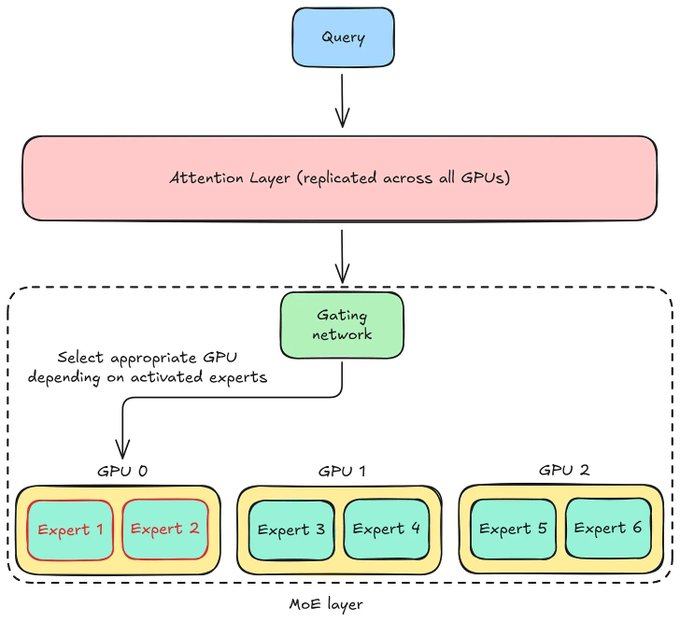
这已经不是简单的“模型复制+负载均衡”了,而是一个极其复杂的动态内部路由问题,必须靠精密的推理引擎来全程协调跨设备计算流。
一句话总结
传统ML推理是“固定输入、固定输出、独立请求”,LLM推理则是“变长输入、变长输出、强依赖缓存、动态路由、两阶段分离”。几乎每个环节都不一样,这也是为什么LLM推理引擎必须从零重构的原因。
👉 你还知道LLM推理和传统推理之间其他重要的区别吗?欢迎在评论区分享你的发现!
感谢阅读!如果这篇文章让你对LLM推理有了更清晰的认知,欢迎点赞、收藏、转发给正在踩坑的朋友~
我们下期继续深挖Paged Attention和更前沿的推理优化技术。
(完)
更多推荐



 23
 0
- 0


 已为社区贡献42条内容

所有评论(0)