
地球科学大数据回忆卷答案
1. 支持向量机 SVM 核心思想与处理方式
核心思想
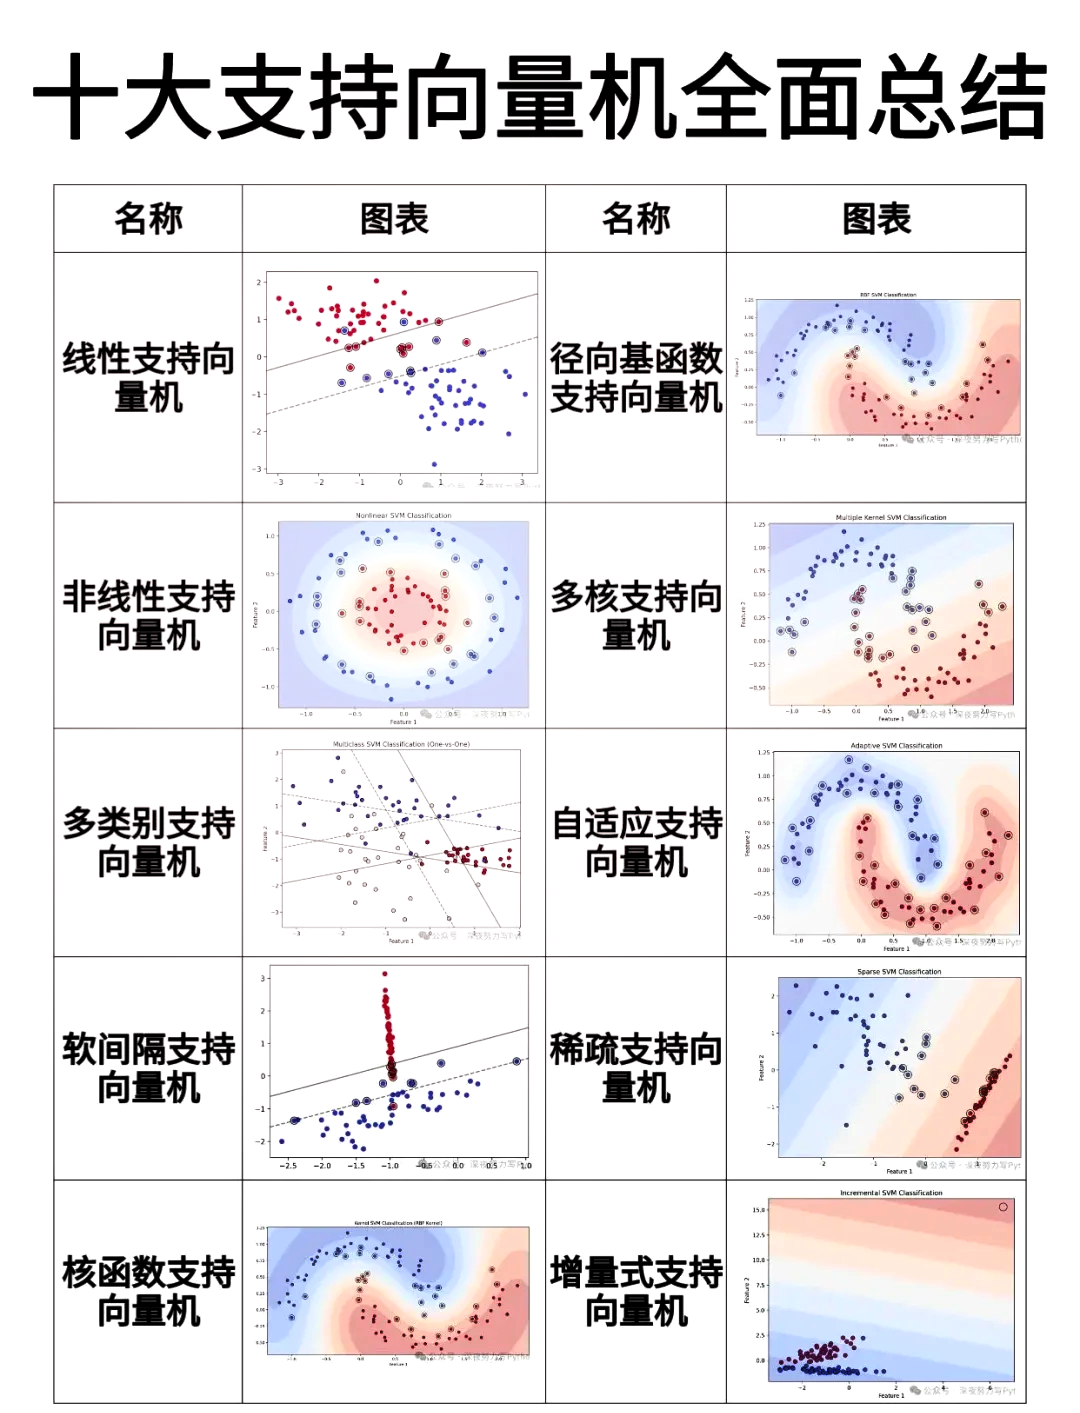
在特征空间中寻找一个最优分类超平面,使得不同类别样本之间的间隔(Margin)最大化,从而提升模型的泛化能力;决策仅由支持向量决定,与其他样本无关。
线性可分情况
直接在原始特征空间中求解最大间隔超平面,使用硬间隔 SVM,要求所有样本都被正确分类。
非线性可分情况
- 引入松弛变量,转为软间隔 SVM,允许少量样本错分,避免过拟合;
- 使用核函数(如线性核、多项式核、RBF 高斯核)将低维非线性不可分数据映射到高维空间,使其在高维空间线性可分,再进行最大间隔分类。
2. 卷积神经网络 CNN:结构、原理、特点 + 地球科学应用
基本结构
- 输入层:图像 / 栅格 / 时序数据
- 卷积层:提取局部特征(边缘、纹理、结构)
- 池化层:下采样,降维、保留关键信息、增强鲁棒性
- 全连接层:将特征映射到输出类别 / 数值
- 输出层:分类 / 回归结果
基本原理
利用局部感受野 + 权值共享,自动学习数据的空间 / 时序层次特征,从浅层简单特征到深层复杂特征。
特点
- 自动提取特征,无需人工设计
- 权值共享大幅减少参数,降低过拟合
- 擅长处理网格型、空间型、图像型数据
- 对平移、缩放、扭曲具有一定鲁棒性
地球科学典型应用(3 个)
- 遥感影像分类与解译土地利用分类、水体 / 植被 / 建设用地提取、变化检测。
- 地震 / 地质灾害识别从地震波形、SAR 影像中识别滑坡、塌陷、断层构造。
- 气象 / 海洋场预测雷达回波外推、降水预报、海表温度 / 洋流场时空预测。
*补充细节知识:局部感受野 + 权值共享 = CNN 核心原理
原句:利用局部感受野 + 权值共享,自动学习数据的空间 / 时序层次特征,从浅层简单特征到深层复杂特征。
下面逐词逐句讲清楚:
1. 局部感受野(Local Receptive Field)
- 卷积核不是一次看整张图 / 整个数据,而是只看一小块区域。
- 比如遥感图像、气象格点、地震剖面:先看边缘、纹理、小结构 → 这就是局部感受野。
- 意义:空间数据(图像、栅格、地质剖面)特征都是局部相关的,远处像素关系很小,没必要全局连接。
2. 权值共享(Weight Sharing)
- 同一个卷积核,一套参数在整张图上滑动提取特征。
- 不是每个位置都单独学一套参数,而是共享同一组权重。
- 意义:极大减少参数数量,防止过拟合,让模型更适合地球科学大数据、高维数据。
3. 自动学习空间 / 时序层次特征
- 空间特征:如遥感影像的边界、形状、纹理、地貌结构。
- 时序特征:如降水时序、海温变化、地震波形随时间变化。
- CNN 不用人工定义特征,自己从数据里学,这叫端到端特征学习。
4. 从浅层简单特征 → 深层复杂特征
这是 CNN 最强大的地方:
- 浅层网络:学低级特征边缘、角点、线条、色块。
- 中层网络:学中级结构地块边界、河流形状、云系轮廓。
- 深层网络:学高级语义特征土地类型、地貌单元、灾害区域、气象系统。
层次化提取,越往上越抽象、越接近任务目标。
最终可直接背诵的完整版(考场满分句)
CNN 的基本原理是:通过局部感受野让卷积核只关注数据局部区域,适应空间 / 时序数据的局部相关性;通过权值共享大幅减少模型参数,降低过拟合风险;让网络自动从数据中学习层次化特征,浅层提取边缘、纹理等简单特征,深层逐步组合出地貌、地物、气象系统等复杂高级特征,从而完成空间 / 时序数据的分类、识别与预测任务。
3. 100 个独立样本的数据驱动建模策略
100 个样本属于小样本场景,重点是充分利用数据 + 防止过拟合。
建模样本使用策略
- 不简单随机切分 7:3(样本太少,波动大)
- 优先使用 K 折交叉验证(K=5 或 K=10)
- 100 个样本分为 5 组,轮流 4 组训练、1 组验证
- 取 5 次结果的平均作为模型性能,更稳定可靠
- 若必须划分训练 / 测试集:
- 建议 80 训练 + 20 测试(80/20)
- 训练集内部再用 交叉验证调参
- 训练集内可使用:
- 特征选择,降低维度
- 正则化(L1、L2)控制复杂度
- 最终模型
- 用全部训练集重新训练
- 在独立测试集上做最终评估
一句话总结
100 个样本优先用 5/10 折交叉验证,训练集调参,独立测试集做最终评估,严控过拟合。
4. 大气是混沌的,为何气候具有可预测性?
一句话核心:大气是混沌 → 天气不可长期预报;气候是统计态 → 气候可预测。
详细可直接背诵:
-
混沌只针对 “瞬时天气”大气运动对初值极其敏感,短期(几天)可预报,超过两周天气状态不可预报。
-
气候≠天气,是统计平均气候是一段时间内气象要素的统计特征(平均、变率、极值、季节循环等),不依赖某一时刻的精确状态。
-
气候受慢变系统强迫气候主要由慢变因子决定:
- 海温(SST)
- 海冰、积雪
- 陆面过程
- 太阳辐射、温室气体这些因子变化慢、记忆长,不混沌、可预测。
-
混沌带来的是内部变率,而非完全不可知虽然逐日天气乱,但统计规律稳定:季节循环、年际变率(如 ENSO)、年代际趋势仍然可预测。
总结(考场金句):大气瞬时状态具有混沌特性,因此天气不可长期预报;但气候是统计平均态,受慢变外源强迫主导,内部变率可被平均掉,因此气候具有可预测性。
5. ConvLSTM 与 LSTM 结构区别 + 优势
结构不同
-
传统 LSTM:状态更新用全连接,只处理时序依赖,不考虑空间结构。
-
ConvLSTM:把 LSTM 里的矩阵乘法换成卷积运算,即:输入门、遗忘门、输出门、细胞状态更新全都用 卷积操作 实现。
公式对比(理解即可):
- LSTM:
*是矩阵乘法 - ConvLSTM:
*是卷积
优势(非常适合地球科学)
-
能同时建模 空间依赖 + 时序依赖对气象格点、遥感影像、雷达回波这类时空数据天生友好。
-
保留空间结构信息不像 LSTM 把图像展平破坏空间结构。
-
权值共享 + 局部感受野参数更少,更不容易过拟合,适合气象、海洋、遥感大数据。
-
更适合做时空预测如:降水临近预报、雷达回波外推、海表温度预测、土壤湿度时空演变。
总结背诵版:ConvLSTM 将 LSTM 中的全连接替换为卷积运算,能够同时捕捉时空依赖,保留空间结构,参数更少、泛化能力更强,特别适合地球科学中的时空序列预测任务。
雷达回波外推(临近降水预报)
—— 这也是 ConvLSTM 论文里原始的经典应用。
一、任务是什么
用过去几帧雷达回波图像(像小动画一样的时空序列)预测未来一段时间的雷达回波强度与位置,从而实现:未来 0–2 小时短时强降雨、暴雨临近预报(Nowcasting)
二、数据长什么样
- 输入:过去 6–10 帧雷达回波图(每帧是二维网格数据)
- 输出:未来 3–12 帧雷达回波图本质:时空序列预测
三、为什么要用 ConvLSTM,不能用普通 LSTM
- 普通 LSTM:要把二维雷达图展平成一维向量,完全丢掉空间结构。
- ConvLSTM:门机制里用卷积代替全连接→ 既能学时间上的演变→ 又能学空间上的移动、强度变化
四、ConvLSTM 在这里做了什么
- 用卷积捕捉雷达回波的空间形态(块状、带状回波)
- 用 LSTM 记忆回波过去的运动趋势(移向、移速、加强 / 减弱)
- 直接输出未来雷达回波图像
五、这个案例的意义(可写进试卷 / 报告)
这是 ConvLSTM 最经典、最具代表性的时空预测任务,证明了 ConvLSTM 能同时建模空间相关性与时间依赖性,非常适合气象、遥感、海洋等地球科学时空数据。
一句话背诵版(考场直接写)
典型案例:雷达回波外推(临近降水预报)。输入多帧历史雷达回波时空序列,利用 ConvLSTM 同时提取空间特征与时间依赖,预测未来雷达回波与降水分布,是 ConvLSTM 在地球科学中最经典的时空预测应用。
更多推荐


 10
 0
- 0


 已为社区贡献13条内容

所有评论(0)