
机器学习-深度学习优化算法
深度学习优化算法
AI
AI-ML(machine learning)
机器学习是AI的一个子集,机器学习是一种专注于能够学习训练数据集的模式,并对新的、未见过的数据做出准确推断的算法。机器学习的这种识别能力,使得模型能够在无需显式硬编码的情况下做出决策或者预测。
在机器学习中,如果你在数据集上优化机器的性能,那么就要充分的模拟现实世界,这个过程就叫模型训练(Model training)。以这样的方式训练模型,那么模型就能对新事物做出准确的预测。
本质上,训练好的模型就是在应用模式,通过训练数据在实际的任务中做出正确推断,然后部署好这个训练好的模型,这就是AI inference(人工智能推理)。这个时候我们将新数据输入到这个训练好的模型中,它就会根据这些数据做出预测。
几类常见的范式:
-
Supervised Learning(监督学习)
- 需要使用带标签的粒子或者真实的标签,给出输出。
- 例如对垃圾邮件的分类,是一种简单是监督学习,因为这常常是由人为因素参与提供标签的
- 回归模型(Regression model):可以预测连续的变量,例如价格的预测,天气的预测。
- 线性回归(linear regression):用于找到穿过数据点的最佳拟合线
- 多项式回归(polynomial regression):用于捕捉非线性关系
- 分类(Classification):用于预测离散的类别。
- 二元分类(Binary Classification):即false or true。
- 多类别分类(multi-class Classification):有多个类别。
- 多标签分类(multi-label Classification):可以使用多个标签。
现代的机器学习中经常使用的则是这些方法的组合来提高准确率,也成为集成学习(Ensemble Supervised Learning)
-
半监督学习(semi-Supervised Learning):使用较小的数据标注并加到一个庞大的没有进行过标注的数据集中,用于改善监督模型。这样利用已经标注的小示例来推广到未标注的数据,所花费的标签成本要少得多。
-
Unsupervised Learning(无监督学习)
- 使用未标记的数据进行学习,能够自发性的发现数据中的结构。
- 这类的任务包括聚类、降维和异常检测
- 聚类(Clustering):将相似的项目分组,或者是行为相似的事物聚集到一起。
- (k均值聚类)k-means Clustering:著名的聚类方式。选择了k个组,重复的将每个项目分配给最接近的组平均值,然后重新计算均值直到稳定为止。
- 例如将消费者分为(k==4)的细分群体:审美主义消费者、实用主义消费者、从众主义消费者、others。然后根据不同的消费群体制定不同的广告或者商品。
- 层级结构(hierarchical):
- 指的是从每个项目开始,不断的合并最相似的组来构建树状图,再对树状图进行修剪。
- 例如对审美主义消费者和实用主义消费者来构建树状图,划分出更细小的区域,这对于发现新的领域(如自动规划路径问题)非常有用。
- 降维(dimensionality reduction):
- 现在的降维算法指的是通过数据点中表示的较少的特征来降低其复杂度(reduce the complexity of data points by representing them with the smaller of features),因为这意味着纬度较低,但是仍然保留所有有意义的特征。
- 常用于数据预处理、数据压缩、数据可视化。
- 常用的降维例子:PCA(主成分分析),encoders.
-
Reinforcement Learning(强化学习)
- 通过反复的试验,以惩罚或者奖励的政策。
- 智能体与环境进行交互,通过观察环境的状态(state)变化,然后采取一个动作(action)。环境会奖励这个动作或者惩罚这个行为。
- 随着时间的推移,这样的互动产生的策略是:最大化长期收益(maximizes long-term rewards),因为收益可能会推迟,所以需要平衡探索新的动作和重复确认有效的行为。
- 例如:考虑一辆自动驾驶的汽车:状态来自于GPS和摄像头,动作来自于驾驶的指令(e.g.转向、刹车、加速、遵守交通信号灯),该模型就会奖励这样安全平稳的动作;而对于急刹车等违规行为这样的行为进行处罚。该奖励与惩罚就有利于模型的学习。
AI-ML-DL(Deep learning)
深度学习是机器学习的子集,它使用神经网络于学习分层表示(learn hierarchical representations)。
深度学习优化算法:综合指南
深度学习优化算法,例如梯度下降、随机梯度下降和 Adam 优化器,对于通过最小化损失函数来训练神经网络至关重要。尽管它们非常重要,但人们常常觉得它们像黑箱一样难以理解。本指南旨在简化这些算法,提供清晰的解释和实用的见解。
梯度下降是最流行的优化算法之一,也是优化神经网络的事实标准方法。几乎所有先进的深度学习库都包含各种改进梯度下降算法的实现。然而,这些算法通常被用作黑盒优化器,因为很难提供实际的解释。
本文旨在为读者提供关于不同梯度下降优化算法行为的直观理解。
退一步讲:梯度下降法是一种通过沿目标函数梯度方向(即参数梯度方向)更新模型参数(即目标函数) J ( θ ) J(\theta) J(θ) 来最小化目标函数 J ( θ ) J(\theta) J(θ) 的方法。学习率 η \eta η 决定了我们达到(局部)最小值所需的步长。换句话说,我们沿着目标函数所构成的曲面的斜率方向向下移动,直到到达谷底。本文将探讨改进这种“盲目”的逐步下降方法的各种途径。
本文将介绍以下几种优化器:
| Name | Description(中文) | TensorFlow Function | PyTorch Function |
|---|---|---|---|
| SGD | 随机梯度下降 | tf.keras.optimizers.SGD | torch.optim.SGD |
| Momentum | 带动量的随机梯度下降 | tf.keras.optimizers.SGD | torch.optim.SGD |
| Nesterov | Nesterov 加速梯度法 | tf.keras.optimizers.SGD | torch.optim.SGD |
| Adam | 自适应矩估计 | tf.keras.optimizers.Adam | torch.optim.Adam |
| RMSprop | 均方根传播算法 | tf.keras.optimizers.RMSprop | torch.optim.RMSprop |
| Adagrad | 自适应梯度算法 | tf.keras.optimizers.Adagrad | torch.optim.Adagrad |
| Adadelta | 自适应 Delta 学习率方法 | tf.keras.optimizers.Adadelta | torch.optim.Adadelta |
| Adamax | 基于无穷范数的 Adam | tf.keras.optimizers.Adamax | torch.optim.Adamax |
| Nadam | Adam 与 Nesterov 动量的结合 | tf.keras.optimizers.Nadam | torch.optim.Nadam |
| AdamW | 带权重衰减的 Adam | tf.keras.optimizers.AdamW | torch.optim.AdamW |
随机梯度下降(SGD)是一种广泛应用于机器学习和一般优化问题的优化算法。它通过迭代更新模型参数来最小化(或极少数情况下最大化)目标函数。在每次迭代中,SGD 计算目标函数相对于参数的梯度,从而确定最速下降的方向。数学上,这可以表示为:
g
r
a
d
i
e
n
t
t
=
∇
f
(
p
a
r
a
m
e
t
e
r
s
t
)
gradient_t = \nabla f(parameters_t)
gradientt=∇f(parameterst)
梯度下降的参数更新规则如下:
p a r a m e t e r s t + 1 = p a r a m e t e r s t − η ⋅ g r a d i e n t t parameters_{t+1} = parameters_t - \eta \cdot gradient_t parameterst+1=parameterst−η⋅gradientt
其中:
- g r a d i e n t t = ∇ f ( p a r a m e t e r s t ) gradient_t = \nabla f(parameters_t) gradientt=∇f(parameterst) 表示第 t t t 次迭代计算得到的梯度
- f f f 表示目标函数(objective function)
- p a r a m e t e r s t parameters_t parameterst 表示第 t t t 次迭代时的模型参数
- η \eta η 表示学习率(learning rate),用于控制每次参数更新的步长
然后使用梯度和学习率 η \eta η 更新参数,其中学习率控制更新幅度。
我们将符号统一成机器学习论文常见写法,以便读者阅读:
θ
t
+
1
=
θ
t
−
η
∇
f
(
θ
t
)
\theta_{t+1} = \theta_t - \eta \nabla f(\theta_t)
θt+1=θt−η∇f(θt)
为了确保优化方法之间的公平比较,我们使用具有三个不同初始位置的比尔函数(Beale Function)。该函数定义如下:
f ( x , y ) = ( 1.5 − x + x y ) 2 + ( 2.25 − x + x y 2 ) 2 + ( 2.625 − x + x y 3 ) 2 f(x,y) = (1.5 - x + xy)^2 + (2.25 - x + xy^2)^2 + (2.625 - x + xy^3)^2 f(x,y)=(1.5−x+xy)2+(2.25−x+xy2)2+(2.625−x+xy3)2
关于
x
x
x 的偏导数
∂
f
∂
x
=
2
(
1.5
−
x
+
x
y
)
(
−
1
+
y
)
+
2
(
2.25
−
x
+
x
y
2
)
(
−
1
+
y
2
)
+
2
(
2.625
−
x
+
x
y
3
)
(
−
1
+
y
3
)
\frac{\partial f}{\partial x} =2(1.5 - x + xy)(-1 + y) + 2(2.25 - x + xy^2)(-1 + y^2) + 2(2.625 - x + xy^3)(-1 + y^3)
∂x∂f=2(1.5−x+xy)(−1+y)+2(2.25−x+xy2)(−1+y2)+2(2.625−x+xy3)(−1+y3)
关于
y
y
y 的偏导数
∂
f
∂
y
=
2
(
1.5
−
x
+
x
y
)
x
+
2
(
2.25
−
x
+
x
y
2
)
(
2
x
y
)
+
2
(
2.625
−
x
+
x
y
3
)
(
3
x
y
2
)
\frac{\partial f}{\partial y} =2(1.5 - x + xy)x + 2(2.25 - x + xy^2)(2xy) + 2(2.625 - x + xy^3)(3xy^2)
∂y∂f=2(1.5−x+xy)x+2(2.25−x+xy2)(2xy)+2(2.625−x+xy3)(3xy2)
梯度向量
∇
f
\nabla f
∇f 定义为:
∇
f
=
[
∂
f
∂
x
,
∂
f
∂
y
]
\nabla f = \left[ \frac{\partial f}{\partial x}, \frac{\partial f}{\partial y} \right]
∇f=[∂x∂f,∂y∂f]
以下是该函数及其在 Python 中的梯度:
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.colors import LogNorm

# Define the Beale function
def beale(x, y):
    return (1.5 - x + x * y)**2 + (2.25 - x + x * y**2)**2 + (2.625 - x + x * y**3)**2

# Define the gradient of the Beale function
def beale_gradient(x, y):
    df_dx = 2 * (1.5 - x + x * y) * (-1 + y) + 2 * (2.25 - x + x * y**2) * (-1 + y**2) + 2 * (2.625 - x + x * y**3) * (-1 + y**3)
    df_dy = 2 * (1.5 - x + x * y) * x + 4 * (2.25 - x + x * y**2) * x * y + 6 * (2.625 - x + x * y**3) * x * y**2
    return np.array([df_dx, df_dy])
SGD with Momentum
当 SGD 算法在峡谷中导航时会遇到挑战,峡谷是地形向某一方向倾斜角度远大于其他方向的区域,通常出现在局部最优解附近。在这样的地形中,SGD 算法往往会在峡谷的陡坡上振荡,缓慢地沿着谷底向局部最优解推进。
动量法是一种旨在改进随机梯度下降法(SGD)的技术,它通过加速相关方向上的优化过程并减轻振荡来解决这些问题。其实现方式是将前一时间步的更新向量的一部分 γ \gamma γ 融入到当前的更新向量中。
本质上,动量(Momentum)的作用正如其名称所暗示的。可以将其类比为一个从山坡上滚下来的球。随着球向下滚动,它会不断积累动量,因此速度会逐渐增加(直到达到终端速度)。在优化算法中,如果考虑类似空气阻力的衰减效应,则通常用动量衰减系数 γ < 1 \gamma < 1 γ<1 来表示。
参数更新过程正是对这种物理过程的模拟:
- 对于梯度方向保持一致的维度,动量项会不断累积,从而放大更新步长,加快收敛速度。
- 对于梯度方向频繁变化的维度,动量项会起到平滑作用,从而抑制更新幅度,减少震荡。
因此,引入动量不仅可以加快优化过程的收敛速度,还能够有效减少参数更新过程中的振荡行为。
SGDM的数学描述
从数学角度来看,在动量随机梯度下降法 (SGDM) 的每次迭代中,参数更新速度的计算方法是将先前速度的一部分
γ
\gamma
γ 加到当前梯度乘以学习率上:
v
t
+
1
=
γ
v
t
−
η
∇
f
(
θ
t
)
θ
t
+
1
=
θ
t
+
v
t
+
1
v_{t+1} = \gamma v_t - \eta \nabla f(\theta_t) \\[4pt] \theta_{t+1} = \theta_t + v_{t+1}
vt+1=γvt−η∇f(θt)θt+1=θt+vt+1
其中:
- v t + 1 v_{t+1} vt+1 是第 t + 1 t+1 t+1 次迭代的速度;
- γ \gamma γ 是动量参数(Momentum parameter),通常取值在 [ 0 , 1 ] [0, 1] [0,1] 之间;
- η \eta η 是学习率(Learning rate);
- ∇ f ( θ t ) \nabla f(\theta_t) ∇f(θt) 是在 θ t \theta_t θt 处的梯度。
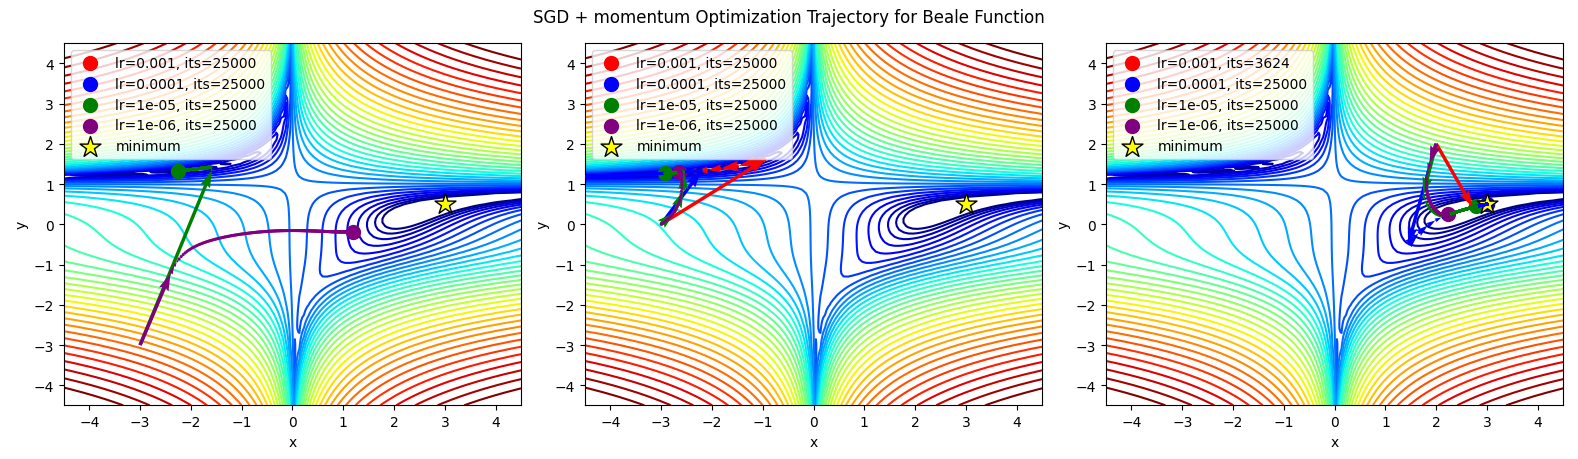
SGDM与SGD相比的优势和劣势
与原始的 SGD 算法相比,SGDM 具有以下几个优点
- 更快的收敛速度:SGDM 的收敛速度比 SGD 更快,尤其对于非凸优化问题。
- 对局部最小值的鲁棒性:动量项有助于跳出局部最小值,使其对优化过程更具鲁棒性。
- 处理非凸优化问题:动量算法非常适合处理非凸优化问题,而非凸优化问题在深度学习中很常见。
然而,SGDM 也存在一些缺点:
- 计算复杂度:SGDM 与 SGD 相比需要额外的计算,因此计算成本更高。
- 对超参数的敏感性:动量系数 γγ 可能需要仔细调整才能达到最佳性能。
- 内存需求:SGDM 需要存储速度向量 vtv**t ,这会增加内存需求。
基于 Python 的 SGD with Momentum
# SGD with momentum optimizer implementation
def sgd_with_momentum_optimizer(func, grad_func, initial_params, learning_rate=0.01, momentum=0.9, max_iter=25000, tol=1e-6):
    params = initial_params
    velocity = np.zeros_like(params)
    t = 0

    # Store parameters every 100 steps
    params_history = [params.copy()]

    while t < max_iter:
        t += 1
        gradient = grad_func(*params)
        velocity = momentum * velocity - learning_rate * gradient
        params += velocity

        if t % 100 == 0:
            params_history.append(params.copy())

        if np.linalg.norm(gradient) < tol:
            break

    if t % 100 != 0:
        params_history.append(params.copy())

    print("Converged after", t, "iterations")
    return params, params_history, t
SGD with Nesterov accelerated gradient (NAG)
在上面的动量例子中,我们设想了一个球毫无预知地沿着地形滚动。而我们希望开发一种更直观的方法:一个“更智能”的球,它能够预测自己的轨迹,并在遇到斜坡之前预先调整速度。
NAG 通过动量项赋予了算法前瞻性(Anticipatory update)。在普通的动量法中,我们直接在当前位置计算梯度;而在 NAG 中,我们先利用动量项
γ
v
t
\gamma v_t
γvt 进行一次“虚拟更新”,得到参数在未来的近似位置:
θ
a
p
p
r
o
x
=
θ
t
+
γ
v
t
\theta_{approx} = \theta_t + \gamma v_t
θapprox=θt+γvt
随后,我们在这一“展望”位置计算梯度。完整的更新方程如下:
v
t
+
1
=
γ
v
t
−
η
∇
f
(
θ
t
+
γ
v
t
)
v_{t+1} = \gamma v_t - \eta \nabla f(\theta_t + \gamma v_t)
vt+1=γvt−η∇f(θt+γvt)
θ t + 1 = θ t + v t + 1 \theta_{t+1} = \theta_t + v_{t+1} θt+1=θt+vt+1
这种方法类似于在下坡时提前“眺望”前方,计算的梯度并非针对当前的 θ t \theta_t θt,而是针对预估的未来位置,从而能更早地做出修正(例如在接近谷底时提前减速)。
我们可以将其拆解为两步走:
- 预瞄 (Look-ahead):先顺着之前的惯性走一段距离,到达临时位置 θ l o o k a h e a d = θ t + γ v t \theta_{lookahead} = \theta_t + \gamma v_t θlookahead=θt+γvt。
- 修正 (Correction):在那个“未来位置”观察坡度(计算梯度 ∇ f \nabla f ∇f),并根据那里的地形来决定最终的运动方向。
这种“先看路、再迈脚”的机制,使得 NAG 能够有效抑制过度震荡,在接近局部最优解时表现得更加稳健。
数学公式
在机器学习中,为了提高收敛效率,我们通常不仅要考虑“动量”,还要考虑对“学习率”进行动态调整。以下是 Nesterov 加速梯度 (NAG) 的一种数学表述形式:
1. 核心更新方程
NAG 的参数更新可以表示为:
θ
k
+
1
=
y
k
−
η
∇
f
(
y
k
)
\theta_{k+1} = y_k - \eta \nabla f(y_k)
θk+1=yk−η∇f(yk)
其中:
- y k y_k yk 是一个中间点(Intermediate point)。
- η \eta η 是预设的学习率。
- ∇ f ( y k ) \nabla f(y_k) ∇f(yk) 表示损失函数在中间点 y k y_k yk 处的梯度。
2.中间点 y k y_k yk 的计算
中间点
y
k
y_k
yk 实际上是对参数
θ
\theta
θ 的一次“预判”,其计算公式如下:
y
k
=
θ
k
+
η
m
(
θ
k
−
θ
k
−
1
)
⏞
当前
θ
与前一时刻
θ
之差
⏟
加权后的前一次参数估计项
y_k = \theta_k + \underbrace{\frac{\eta}{\sqrt{m}} \overbrace{(\theta_k - \theta_{k-1})}^{\text{当前 } \theta \text{ 与前一时刻 } \theta \text{ 之差}}}_{\text{加权后的前一次参数估计项}}
yk=θk+加权后的前一次参数估计项
mη(θk−θk−1)
当前 θ 与前一时刻 θ 之差
这里的关键在于引入了参数
m
m
m,它控制着加速的幅度。通过将学习率
η
\eta
η 除以
m
\sqrt{m}
m,我们可以根据历史梯度的量级来微调步长。
3.自适应缩放因子 m m m
m
m
m 的本质是梯度平方累积和:
m
=
∑
i
k
+
1
∇
f
(
y
i
)
2
m = \sum_{i}^{k+1} \nabla f(y_i)^2
m=i∑k+1∇f(yi)2
- 当历史梯度较大时: m m m 迅速增长,导致有效学习率 η / m \eta / \sqrt{m} η/m 缩小。这能防止优化器在陡峭区域迈出过大的步子导致震荡。
- 当历史梯度较小时:学习率相对增加,使得优化器在平坦区域能够保持足够的进展。
这里的 m m m 是一个与 θ \theta θ 维度相同的向量。这意味着它会对 θ \theta θ 中的每一个参数进行**逐维度(Per-parameter)**的缩放。例如,在处理 Beale 函数 f ( x , y ) f(x, y) f(x,y) 时, θ \theta θ 和 m m m 都是二维向量 ( m ∈ R 2 m \in \mathbb{R}^2 m∈R2),分别对应 x x x 和 y y y 两个维度的更新步长。
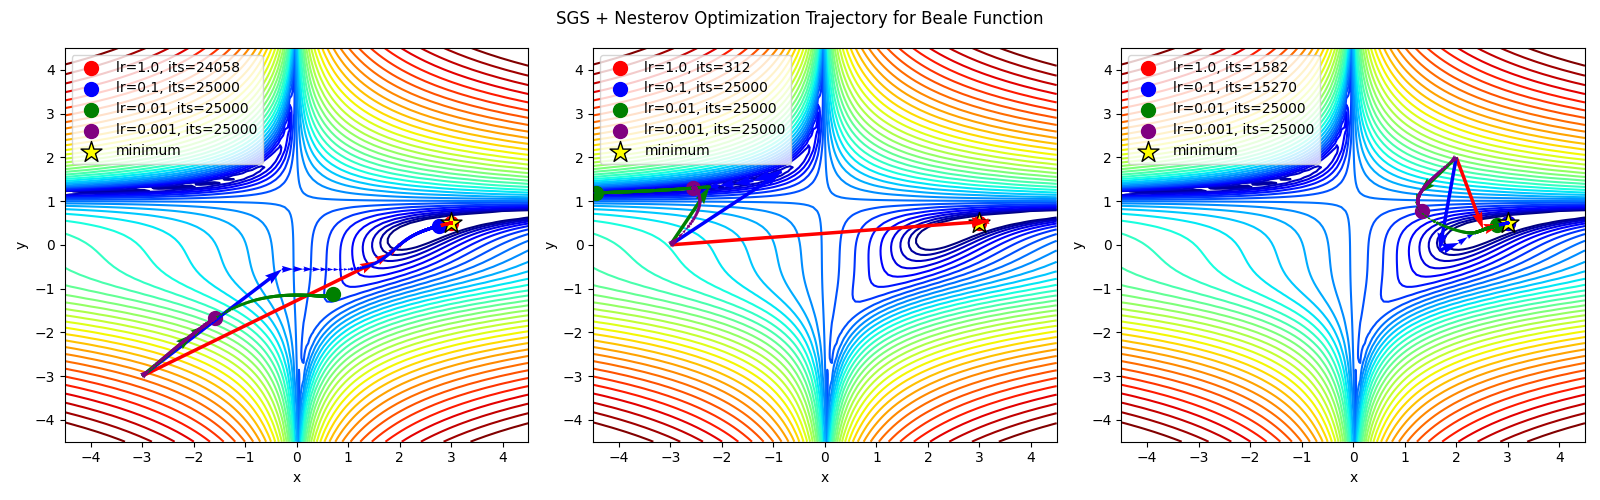
Nesterov 优化器与SGD相比的优势和劣势
与随机梯度下降法 (SGD) 相比,Nesterov 优化器具有以下几个优点:
-
收敛速度:Nesterov 优化器的收敛速度比 SGD 快,尤其对于非凸优化问题。
-
对局部最小值的鲁棒性:Nesterov 优化器比 SGD 更能抵抗局部最小值,而 SGD 可能会陷入较差的局部最优解。
然而,Nesterov 优化器也存在一些缺点:
- 计算复杂度: Nesterov 优化器比 SGD 需要更多的计算资源,尤其是在处理大型数据集时。NAG 需要存储中间点 y k y_k yk 和先前的估计值 θ k − 1 \theta_{k-1} θk−1 ,这对于大型模型来说可能非常消耗内存。
- 对超参数的敏感性:Nesterov 优化器对学习率和步长等超参数非常敏感,这些参数难以调整。NAG 对学习率和加速参数 mm 的选择也很敏感,这会影响其性能。
基于 Python 的 Nesterov 加速梯度的随机梯度下降 (SGD)
# Nesterov optimizer implementation
def nesterov_optimizer(func, grad_func, initial_params, learning_rate=0.01, momentum=0.9, eps=1e-8, max_iter=25000, tol=1e-6):
    params = initial_params
    velocity = np.zeros_like(params)
    m = np.zeros_like(params) # Historical gradient sum
    t = 0

    # Store parameters every 100 steps
    params_history = [params.copy()]

    while t < max_iter:
        t += 1
        lookahead_params = params - momentum * velocity
        gradient = grad_func(*lookahead_params)
        m += gradient ** 2
        adjusted_learning_rate = learning_rate / np.sqrt(m + eps)
        velocity = momentum * velocity + adjusted_learning_rate * gradient
        params -= velocity

        if t % 100 == 0:
            params_history.append(params.copy())

        if np.linalg.norm(gradient) < tol:
            break

    print("Converged after", t, "iterations")
    # print(t, 'm', m)
    return params, params_history, t
自适应矩估计优化器(Adam)
Adam 是一种高效的优化方法,它在训练过程中能够为每个参数动态调整学习率。
1. 核心机制:双重矩估计
Adam 通过维护两个指数衰减的平均值来捕捉梯度的动态特征:
- 一阶矩 m t m_t mt:梯度的期望(均值),起到动量作用。
- 二阶矩 v t v_t vt:梯度的非中心化方差,衡量梯度的波动幅度。
这种方法使得 Adam 能够根据梯度的幅值和方差自适应地调整学习率,这也是其名称 “Adaptive Moment Estimation” 的由来。
2. 偏差修正 (Bias Correction)
在训练初期,由于
m
t
m_t
mt 和
v
t
v_t
vt 通常初始化为零,其估计值会表现出向零偏置的倾向,尤其是在衰减率
β
1
\beta_1
β1 和
β
2
\beta_2
β2 接近 1 时。为了消除这种影响,算法引入了偏差校正估计值
m
^
t
\hat{m}_t
m^t 和
v
^
t
\hat{v}_t
v^t:
m
^
t
=
m
t
1
−
β
1
t
\hat{m}_t = \frac{m_t}{1 - \beta_1^t}
m^t=1−β1tmt
v ^ t = v t 1 − β 2 t \hat{v}_t = \frac{v_t}{1 - \beta_2^t} v^t=1−β2tvt
其中 t t t 为当前迭代的步数。通过除以 ( 1 − β t ) (1 - \beta^t) (1−βt),算法有效地放大了初期的估计值,使之更接近真实的矩。
3. 参数更新与超参数建议
Adam 的更新规则结合了上述校正后的估计值。为了保证数值稳定性(防止除以 0),通常会引入一个极小值 ϵ \epsilon ϵ。
根据 Adam 算法原作者的建议,默认超参数设置如下,这些配置在绝大多数实践场景中都表现优异: β 1 = 0.9 \beta_1 = 0.9 β1=0.9、 β 2 = 0.999 \beta_2 = 0.999 β2=0.999、 ϵ = 10 − 8 \epsilon = 10^{-8} ϵ=10−8
实证研究表明,Adam 算法在处理非平稳目标和嘈杂梯度时表现非常稳健,通常优于其他自适应学习率算法。
总的来说,Adam融合了两个主要思想:
-
自适应学习率:Adam 根据其先前的更新调整每个参数的学习率,使其能够适应损失函数的不同区域。
-
动量项:Adam 引入了一个类似动量的项,帮助优化器跳出局部最小值,提高收敛速度。
数学公式
Adam 的数学表达式可以写成如下形式:
m
t
=
β
1
m
t
−
1
+
(
1
−
β
1
)
∇
f
(
θ
t
)
v
t
=
β
2
v
t
−
1
+
(
1
−
β
2
)
(
∇
f
(
θ
t
)
)
2
θ
t
=
θ
t
−
1
−
η
m
t
v
t
+
ϵ
m_t = \beta_1 m_{t-1} + (1 - \beta_1) \nabla f(\theta_t) \\[4pt] v_t = \beta_2 v_{t-1} + (1 - \beta_2) (\nabla f(\theta_t))^2\\[4pt] \theta_t = \theta_{t-1} - \eta \frac{m_t}{\sqrt{v_t} + \epsilon}
mt=β1mt−1+(1−β1)∇f(θt)vt=β2vt−1+(1−β2)(∇f(θt))2θt=θt−1−ηvt+ϵmt
where:
- m t m_t mt 和 v t v_t vt 分别表示梯度的一阶矩和二阶矩。
- β 1 \beta_1 β1 和 β 2 \beta_2 β2 是控制矩的指数衰减率的超参数(通常设置为 0.9 和 0.999)。
- ϵ \epsilon ϵ 是一个为数值稳定性而添加的小值。
基于 Python 实现 Adam
# Adam optimizer implementation
def adam_optimizer(func, grad_func, initial_params, learning_rate=0.01, beta1=0.9, beta2=0.999, epsilon=1e-8, max_iter=25000, tol=1e-6):
    params = initial_params
    m = np.zeros_like(params)
    v = np.zeros_like(params)
    t = 0

    # Store parameters every 100 steps
    params_history = [params.copy()]

    while t < max_iter:
        t += 1
        gradient = grad_func(*params)
        m = beta1 * m + (1 - beta1) * gradient
        v = beta2 * v + (1 - beta2) * (gradient ** 2)
        m_hat = m / (1 - beta1**t)
        v_hat = v / (1 - beta2**t)
        params -= learning_rate * m_hat / (np.sqrt(v_hat) + epsilon)

        if t % 100 == 0:
            params_history.append(params.copy())

        if np.linalg.norm(gradient) < tol:
            break

    if t % 100 != 0:
        params_history.append(params.copy())

    print("Converged after", t, "iterations")
    return params, params_history, t
RMSprop
RMSprop 和 Adadelta 是在同一时期独立开发的,其开发目的都是为了解决 Adagrad 学习率随时间急剧下降的问题。事实上,RMSprop 的初始更新向量与 Adadelta 的初始更新向量完全相同。
RMSprop 和 Adadelta 都是为了解决 Adagrad 学习率过度衰减的问题而提出的。尽管它们是独立开发的,但它们有着共同的目标:在训练过程中有效地调整学习率,以确保收敛,同时避免 Adagrad 累积梯度带来的限制。
数学公式
RMSprop 的更新规则如下:
v
t
=
β
v
t
−
1
+
(
1
−
β
)
(
∇
f
(
θ
t
)
)
2
θ
t
=
θ
t
−
1
−
η
∇
f
(
θ
t
)
v
t
+
ϵ
v_t = \beta v_{t-1} + (1 - \beta)(\nabla f(\theta_t))^2 \\ \theta_t = \theta_{t-1} - \eta \frac{\nabla f(\theta_t)}{\sqrt{v_t} + \epsilon}
vt=βvt−1+(1−β)(∇f(θt))2θt=θt−1−ηvt+ϵ∇f(θt)
其中:
- v t v_t vt:表示 RMSprop 对梯度平方的“移动”平均值。 它使用梯度的指数加权移动平均进行更新。
- β \beta β:是一个超参数,用于控制移动平均的衰减率。 通常设置为接近 1 的值(例如 0.9 或 0.99)。
- ϵ \epsilon ϵ:是一个添加到分母中的微小常数,用于保证数值稳定性,防止除以零。
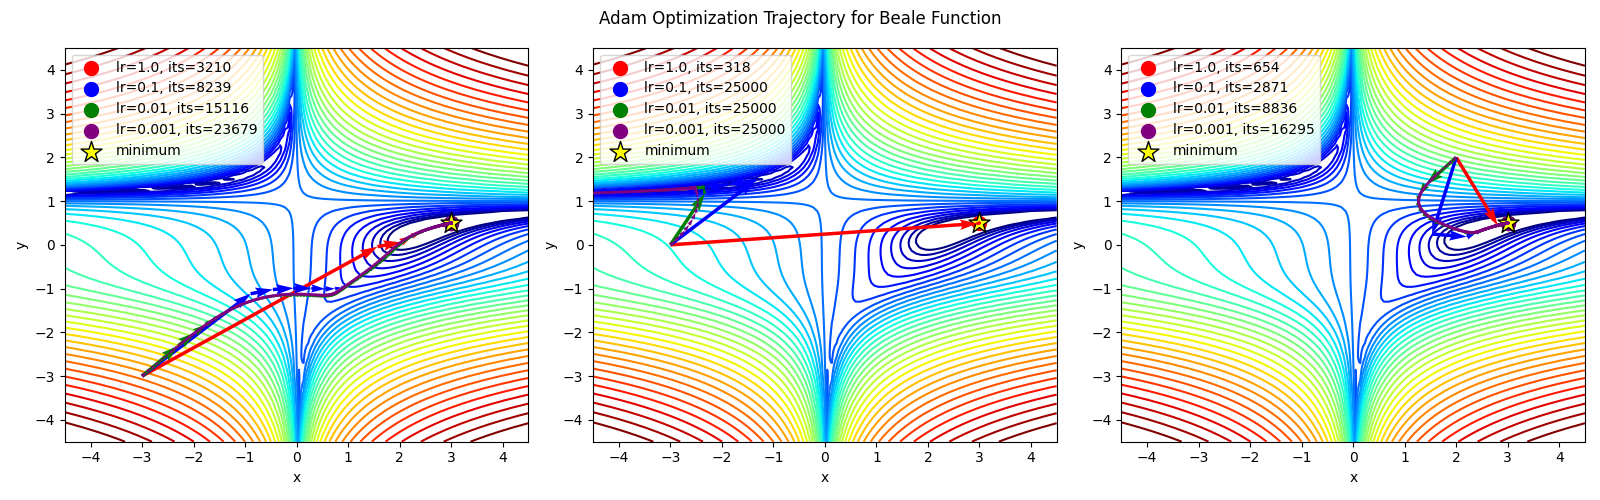
基于 Python 实现 RMSprop
# RMSprop optimizer implementation with momentum
def rmsprop_optimizer(func, grad_func, initial_params, learning_rate=0.01, decay_rate=0.9, momentum=0.9, eps=1e-8, max_iter=25000, tol=1e-6):
    params = initial_params
    velocity = np.zeros_like(params)
    rmsprop_cache = np.zeros_like(params)  # Cache for squared gradients
    t = 0

    # Store parameters every 100 steps
    params_history = [params.copy()]

    while t < max_iter:
        t += 1
        gradient = grad_func(*params)
        rmsprop_cache = decay_rate * rmsprop_cache + (1 - decay_rate) * gradient ** 2
        adjusted_learning_rate = learning_rate / (np.sqrt(rmsprop_cache) + eps)
        velocity = momentum * velocity - adjusted_learning_rate * gradient
        params += velocity

        if t % 100 == 0:
            params_history.append(params.copy())

        if np.linalg.norm(gradient) < tol:
            break

    print("Converged after", t, "iterations")
    return params, params_history, t
AdaGrad
Adagrad 是一种优化算法,它根据训练过程中观察到的历史梯度,为每个参数单独调整学习率。与传统的固定学习率优化方法不同,Adagrad 会动态调整学习率,对不常用的参数进行较大的更新,对常用的参数进行较小的更新。这种适应性使得 Adagrad 非常适合处理稀疏数据,因为在稀疏数据中,某些参数的影响可能比其他参数更大。
Adagrad 背后的核心思想是为每个参数维护一个单独的学习率,该学习率的缩放比例与随时间积累的梯度平方和的平方根成反比。让我们将
m
t
m_t
mt 定义为直到时间步
t
t
t 为止,参数
θ
\theta
θ 的梯度平方和:
m
t
=
m
t
−
1
+
(
∇
f
(
θ
t
)
)
2
m_t = m_{t-1} + (\nabla f(\theta_t))^2
mt=mt−1+(∇f(θt))2
Adagrad 的更新规则可以表示为:
θ
t
+
1
=
θ
t
−
η
m
t
+
ϵ
∇
f
(
θ
t
)
\theta_{t+1} = \theta_t - \frac{\eta}{\sqrt{m_t} + \epsilon} \nabla f(\theta_t)
θt+1=θt−mt+ϵη∇f(θt)
在该方程中, ϵ \epsilon ϵ 是一个添加到分母中的微小常数,用于防止除以零。通过将学习率与累积梯度平方和的平方根成反比进行缩放,Adagrad 有效地降低了过去经历过大梯度的参数的学习率,从而减轻了冲过(overshooting)最优解的风险。
然而,Adagrad 的一个缺点是它倾向于在分母中累积梯度平方,导致学习率随时间单调递减。这种逐渐减小的学习率最终可能变得太小,从而阻碍进一步的学习进展。为了解决这个问题,随后开发了 RMSprop、Adadelta 和 Adam 等优化算法,以提供更强大和稳定的学习率自适应机制。
数学公式
Adagrad 的数学表述如下:
θ
t
=
θ
t
−
1
−
η
t
∇
θ
J
(
θ
)
\theta_t = \theta_{t-1} - \eta_t \nabla_{\theta} J(\theta)
θt=θt−1−ηt∇θJ(θ)
在第
t
t
t 次迭代时,学习率
η
t
\eta_t
ηt 的计算方式为:
η
t
=
η
0
∑
i
=
1
t
g
i
2
\eta_t = \frac{\eta_0}{\sqrt{\sum_{i=1}^{t} g_i^2}}
ηt=∑i=1tgi2η0
其中
g
i
g_i
gi 代表第
i
i
i 次迭代时的梯度大小,而
η
0
\eta_0
η0 是初始学习率。
公式中的第二项强调了 Adagrad 的主要缺点:分母中梯度平方的累积。由于添加到总和中的每一项都是正数,因此累积总量在训练期间会持续增长。结果是,学习率随时间不断减小,最终达到微不足道的数值,导致算法进一步提升的能力受到严重限制。
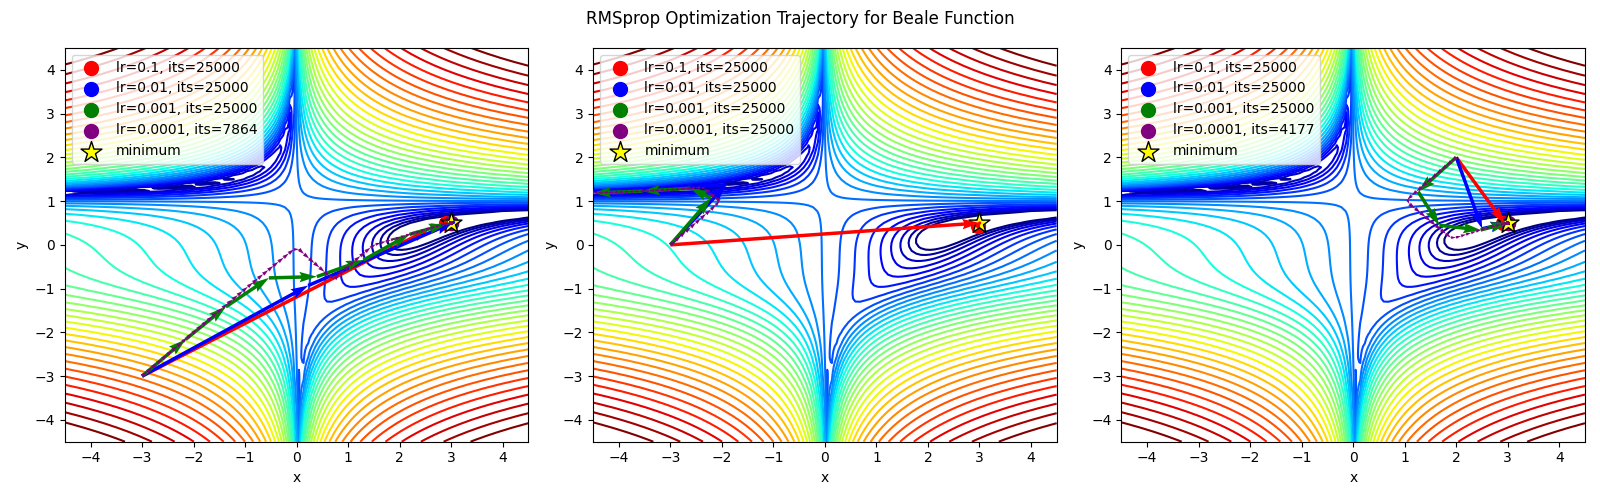
基于 Python 实现 AdaGrad
def adagrad_optimizer(func, grad_func, initial_params, learning_rate=0.01, epsilon=1e-8, max_iter=20000, tol=1e-6):
    params = initial_params
    grad_squared_sum = np.zeros_like(params)
    t = 0

    # Store parameters every 100 steps
    params_history = [params.copy()]

    while t < max_iter:
        t += 1
        gradient = grad_func(*params)
        grad_squared_sum += gradient ** 2
        adjusted_learning_rate = learning_rate / (np.sqrt(grad_squared_sum) + epsilon)
        params -= adjusted_learning_rate * gradient

        if t % 100 == 0:
            params_history.append(params.copy())

        if np.linalg.norm(gradient) < tol:
            break

    if t % 100 != 0:
        params_history.append(params.copy())

    print("Converged after", t, "iterations")
    return params, params_history, t
Adadelta
Adadelta 是一种旨在解决 Adagrad 局限性的优化算法,特别是针对其由于分母中梯度平方累积而导致学习率随时间减小的倾向。Adadelta 通过将过去梯度的累积限制在一个固定大小的窗口内,从而改进了 Adagrad,防止学习率单调递减。
Adadelta 不存储所有过去的梯度平方,而是维护一个随时间变化的梯度平方的衰减平均值。这个运行平均值在时间步
t
t
t 记为
E
[
g
2
]
t
E[g^2]_t
E[g2]t,它被递归地定义为当前梯度
g
t
g_t
gt 与之前平均值的一个分数。
E
[
g
2
]
t
E[g^2]_t
E[g2]t 的更新规则为:
E
[
g
2
]
t
=
γ
E
[
g
2
]
t
−
1
+
(
1
−
γ
)
g
t
2
E[g^2]_t = \gamma E[g^2]_{t-1} + (1 - \gamma)g_t^2
E[g2]t=γE[g2]t−1+(1−γ)gt2
这里,
γ
\gamma
γ 是一个衰减因子,用于控制忘记过去梯度的速率。通过基于衰减平均值更新
E
[
g
2
]
t
E[g^2]_t
E[g2]t,Adadelta 有效地使学习率适应优化过程的动态变化。
然后,使用参数更新值的均方根 (RMS) 来更新参数,记为
Δ
θ
t
\Delta \theta_t
Δθt。该 RMS 值计算为参数更新平方的运行平均值
E
[
Δ
θ
2
]
t
E[\Delta \theta^2]_t
E[Δθ2]t 的平方根加上一个微小常数
ϵ
\epsilon
ϵ 以确保数值稳定性:
Δ
θ
t
=
−
E
[
Δ
θ
2
]
t
−
1
+
ϵ
E
[
g
2
]
t
+
ϵ
g
t
\Delta \theta_t = - \frac{\sqrt{E[\Delta \theta^2]_{t-1} + \epsilon}}{\sqrt{E[g^2]_t + \epsilon}} g_t
Δθt=−E[g2]t+ϵE[Δθ2]t−1+ϵgt
使用参数更新的 RMS 有助于缓解 Adagrad 中观察到的学习率逐渐减小的问题。此外,Adadelta 不需要手动设置全局学习率,使其在实践中使用更加方便。
总的来说,与 Adagrad 相比,Adadelta 提供了一种更鲁棒和稳定的优化方法,使其非常适合训练深度神经网络和处理稀疏数据。
数学公式
Adadelta 的数学公式可以表述如下:
θ
t
=
θ
t
−
1
−
η
∇
f
(
θ
t
−
1
)
E
[
g
2
]
t
+
ϵ
\theta_t = \theta_{t-1} - \eta \frac{\nabla f(\theta_{t-1})}{\sqrt{E[g^2]_t} + \epsilon}
θt=θt−1−ηE[g2]t+ϵ∇f(θt−1)
其中
θ
t
\theta_t
θt 是在时间步
t
t
t 的模型参数,
∇
f
(
θ
)
\nabla f(\theta)
∇f(θ) 是损失函数的梯度,
η
\eta
η 是学习率,
g
t
=
∇
f
(
θ
t
−
1
)
g_t = \nabla f(\theta_{t-1})
gt=∇f(θt−1) 是在时间步
t
t
t 的梯度,而
E
[
g
2
]
t
E[g^2]_t
E[g2]t 是梯度平方的指数衰减平均值。
Adadelta 的更新规则可以进一步分解为两个部分:
Δ
θ
t
=
−
η
∇
f
(
θ
t
−
1
)
E
[
g
2
]
t
+
ϵ
\Delta \theta_t = -\eta \frac{\nabla f(\theta_{t-1})}{\sqrt{E[g^2]_t} + \epsilon}
Δθt=−ηE[g2]t+ϵ∇f(θt−1)
以及
E
[
g
2
]
t
=
γ
E
[
g
2
]
t
−
1
+
(
1
−
γ
)
g
t
2
E[g^2]_t = \gamma E[g^2]_{t-1} + (1 - \gamma)g_t^2
E[g2]t=γE[g2]t−1+(1−γ)gt2
其中
γ
\gamma
γ 是衰减率,通常设置为 0.9。
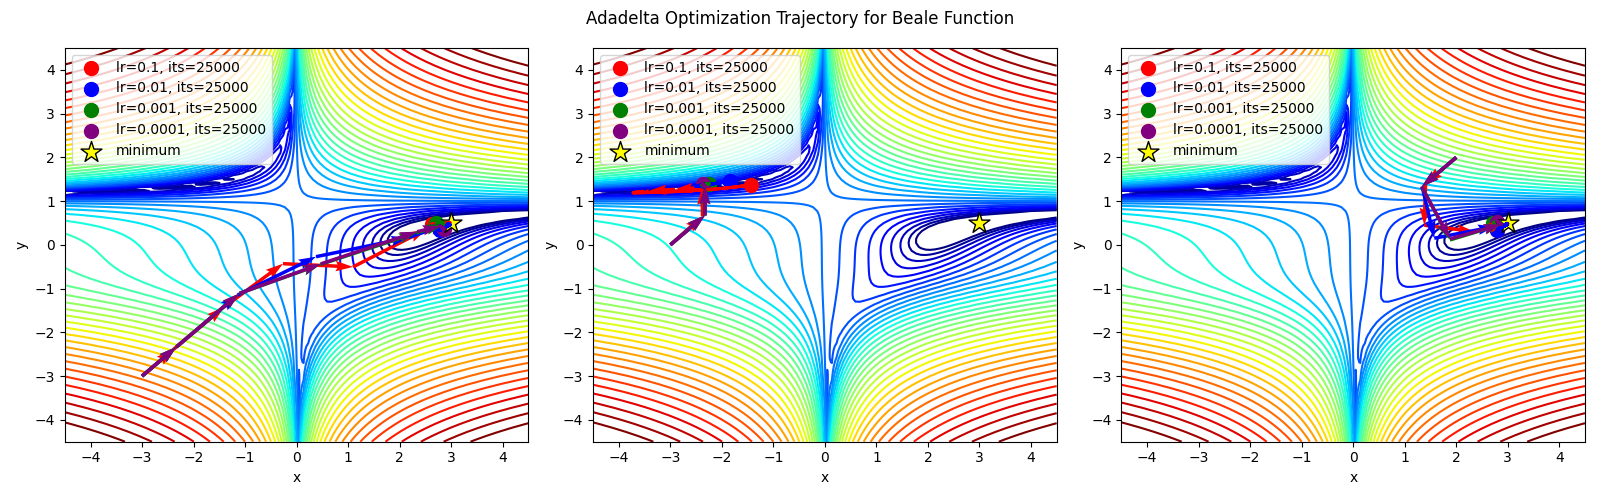
基于 Python 实现 Adadelta
# Adadelta optimizer implementation
def adadelta_optimizer(func, grad_func, initial_params, rho=0.95, eps=1e-6, max_iter=25000, tol=1e-6):
    params = initial_params
    accumulated_gradient = np.zeros_like(params)
    accumulated_delta = np.zeros_like(params)
    t = 0

    # Store parameters every 100 steps
    params_history = [params.copy()]

    while t < max_iter:
        t += 1
        gradient = grad_func(*params)
        accumulated_gradient = rho * accumulated_gradient + (1 - rho) * gradient ** 2
        delta_params = -np.sqrt(accumulated_delta + eps) / np.sqrt(accumulated_gradient + eps) * gradient
        params += delta_params
        accumulated_delta = rho * accumulated_delta + (1 - rho) * delta_params ** 2

        if t % 100 == 0:
            params_history.append(params.copy())

        if np.linalg.norm(gradient) < tol:
            break

    print("Converged after", t, "iterations")
    return params, params_history, t
Adamax
AdaMax 是 Adam 优化算法的一种变体,它在更新规则中引入了一个新因子 v t v_t vt。该因子根据过去梯度的 L p L^p Lp 范数(通过 v t − 1 v_{t-1} vt−1 项)和当前梯度 ∣ g t ∣ 2 |g_t|^2 ∣gt∣2 的比例来反向缩放梯度。虽然原始的 Adam 算法使用的是 L 2 L^2 L2 范数,但 AdaMax 将这一概念泛化以适应由 β p 2 \beta_p^2 βp2 参数化的不同范数。
在实践中,具有较大 p p p 值的范数往往在数值上变得不稳定。然而, L 1 L^1 L1 和 L 2 L^2 L2 范数由于其稳定性而常用。有趣的是, L ∞ L^\infty L∞ 范数(代表向量元素中的最大绝对值)也表现出稳定的行为。利用这种稳定性,作者提出了 AdaMax,它使用 L ∞ L^\infty L∞ 范数来约束 v t v_t vt,以确保收敛到更稳定的值。
为了区分 AdaMax 与 Adam,并表示受无穷范数约束的 v t v_t vt,我们使用 u t u_t ut。这个 u t u_t ut 的计算方式是 β ∞ 2 ⋅ v t − 1 \beta_\infty^2 \cdot v_{t-1} β∞2⋅vt−1 与 ∣ g t ∣ |g_t| ∣gt∣ 之间的最大值。与 Adam 需要对 m t m_t mt 和 v t v_t vt 进行偏置修正不同,AdaMax 由于依赖最大值操作,不需要对 u t u_t ut 进行此类修正。
AdaMax 的更新规则将 Adam 更新方程中的 v ^ t + ϵ \sqrt{\hat{v}_t + \epsilon} v^t+ϵ 替换为 u t u_t ut,从而实现了更稳健的优化过程。对于 AdaMax,通常建议使用超参数的默认值,例如 η = 0.002 \eta = 0.002 η=0.002、 β 1 = 0.9 \beta_1 = 0.9 β1=0.9 和 β 2 = 0.999 \beta_2 = 0.999 β2=0.999。
数学公式
AdaMax 的数学公式可以写成如下形式:
m
t
=
β
1
m
t
−
1
+
(
1
−
β
1
)
∇
f
(
θ
t
)
m_t = \beta_1 m_{t-1} + (1 - \beta_1)\nabla f(\theta_t)
mt=β1mt−1+(1−β1)∇f(θt)
v t = β 2 v t − 1 + ( 1 − β 2 ) ( ∇ f ( θ t ) ) 2 v_t = \beta_2 v_{t-1} + (1 - \beta_2)(\nabla f(\theta_t))^2 vt=β2vt−1+(1−β2)(∇f(θt))2
θ t = θ t − 1 − η t m t v t + ϵ \theta_t = \theta_{t-1} - \frac{\eta_t m_t}{\sqrt{v_t} + \epsilon} θt=θt−1−vt+ϵηtmt
其中:
- m t m_t mt 是梯度的一阶矩估计
- v t v_t vt 是梯度的二阶矩估计
- β 1 \beta_1 β1 和 β 2 \beta_2 β2 是控制矩衰减率的超参数
- η t \eta_t ηt 是在时间步 t t t 的自适应学习率
- ϵ \epsilon ϵ 是用于维持数值稳定性的微小值
AdaMax 的更新规则通过迭代调整模型参数来最小化损失函数。一阶矩估计 m t m_t mt 捕捉平均梯度方向,而二阶矩估计 v t v_t vt 跟踪梯度的幅度。自适应学习率 η t \eta_t ηt 计算如下:
η t = η v t + ϵ \eta_t = \frac{\eta}{\sqrt{v_t} + \epsilon} ηt=vt+ϵη
正如我们目前看到的其他优化器一样,动量项 m t m_t mt 通过结合过去的梯度信息,帮助 AdaMax 逃离局部极小值。
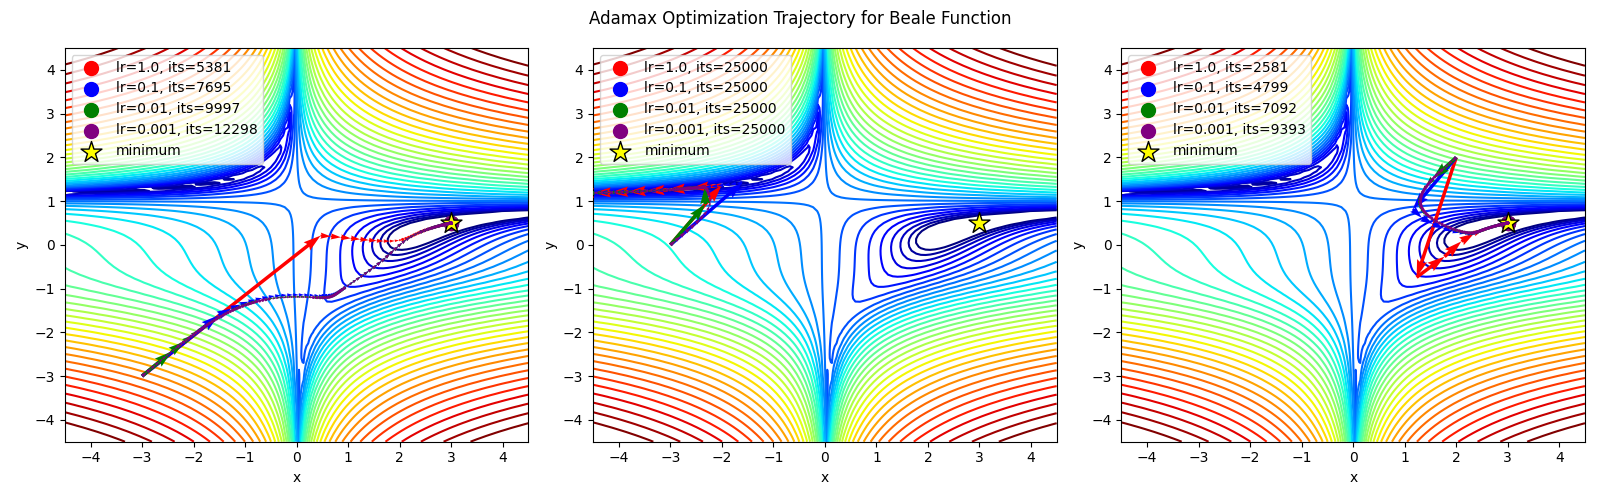
基于 Python 实现 Adamax
# Adamax optimizer implementation
def adamax_optimizer(func, grad_func, initial_params, learning_rate=0.01, beta1=0.9, beta2=0.999, eps=1e-8, max_iter=25000, tol=1e-6):
    params = initial_params
    m = np.zeros_like(params)  # Exponential moving average of gradient
    u = np.zeros_like(params)  # Exponential moving average of squared gradient with infinite norm
    t = 0

    # Store parameters every 100 steps
    params_history = [params.copy()]

    while t < max_iter:
        t += 1
        gradient = grad_func(*params)
        m = beta1 * m + (1 - beta1) * gradient
        u = np.maximum(beta2 * u, np.abs(gradient))
        params -= learning_rate / (1 - beta1**t) * m / (u + eps)

        if t % 100 == 0:
            params_history.append(params.copy())

        if np.linalg.norm(gradient) < tol:
            break

    print("Converged after", t, "iterations")
    return params, params_history, t
Nadam:Nesterov 加速自适应矩估计
Adam 算法结合了 RMSprop 和动量的属性:RMSprop 贡献了过去梯度平方的指数衰减平均值 v t v_t vt,而动量则计入了过去梯度的指数衰减平均值 m t m_t mt。通常情况下,Nesterov 加速梯度 (NAG) 的表现优于普通动量。
Nadam (Nesterov-accelerated Adaptive Moment Estimation) 是 Adam 的一种增强版本,它融合了 Adam 和 NAG 的概念。为了将 NAG 集成到 Adam 中,我们需要调整其动量项
m
t
m_t
mt。让我们使用当前的符号重新审视动量更新规则:
g
t
=
∇
θ
t
J
(
θ
t
)
m
t
=
γ
m
t
−
1
+
η
g
t
θ
t
+
1
=
θ
t
−
m
t
g_t = \nabla_{\theta_t} J(\theta_t) \\[4pt] m_t = \gamma m_{t-1} + \eta g_t \\[4pt] \theta_{t+1} = \theta_t - m_t
gt=∇θtJ(θt)mt=γmt−1+ηgtθt+1=θt−mt
该公式说明,动量涉及向先前动量向量的方向迈出一步,并向当前梯度的方向迈出另一步。NAG 通过在梯度方向上允许更精确的步进来增强这一过程。这是通过在计算梯度之前使用动量步骤更新参数来实现的。我们可以通过如下方式修改梯度
g
t
g_t
gt 来实现 NAG:
g
t
=
∇
θ
t
J
(
θ
t
−
γ
m
t
−
1
)
m
t
=
γ
m
t
−
1
+
η
g
t
θ
t
+
1
=
θ
t
−
m
t
g_t = \nabla_{\theta_t} J(\theta_t - \gamma m_{t-1}) \\[4pt] m_t = \gamma m_{t-1} + \eta g_t \\[4pt] \theta_{t+1} = \theta_t - m_t
gt=∇θtJ(θt−γmt−1)mt=γmt−1+ηgtθt+1=θt−mt
为了将 Nesterov 动量整合进 Adam,我们将之前的动量向量替换为当前的动量向量。回顾 Adam 更新规则:
m
t
=
β
1
m
t
−
1
+
(
1
−
β
1
)
g
t
m
^
t
=
m
t
1
−
β
1
t
θ
t
+
1
=
θ
t
−
η
v
^
t
+
ϵ
m
^
t
m_t = \beta_1 m_{t-1} + (1 - \beta_1)g_t \\[4pt] \hat{m}_t = \frac{m_t}{1 - \beta_1^t} \\[4pt] \theta_{t+1} = \theta_t - \frac{\eta}{\sqrt{\hat{v}_t} + \epsilon} \hat{m}_t
mt=β1mt−1+(1−β1)gtm^t=1−β1tmtθt+1=θt−v^t+ϵηm^t
展开第二个方程中
m
^
t
\hat{m}_t
m^t 和
m
t
m_t
mt 的定义可得:
θ
t
+
1
=
θ
t
−
η
v
^
t
+
ϵ
(
β
1
m
t
−
1
1
−
β
1
t
+
(
1
−
β
1
)
g
t
1
−
β
1
t
)
\theta_{t+1} = \theta_t - \frac{\eta}{\sqrt{\hat{v}_t} + \epsilon} \left( \frac{\beta_1 m_{t-1}}{1 - \beta_1^t} + \frac{(1 - \beta_1)g_t}{1 - \beta_1^t} \right)
θt+1=θt−v^t+ϵη(1−β1tβ1mt−1+1−β1t(1−β1)gt)
注意到
β
1
m
t
−
1
1
−
β
1
t
\frac{\beta_1 m_{t-1}}{1 - \beta_1^t}
1−β1tβ1mt−1 是前一时间步动量向量的偏置修正估计。我们可以将其替换为
m
^
t
−
1
\hat{m}_{t-1}
m^t−1:
θ
t
+
1
=
θ
t
−
η
v
^
t
+
ϵ
(
m
^
t
−
1
+
(
1
−
β
1
)
g
t
1
−
β
1
t
)
\theta_{t+1} = \theta_t - \frac{\eta}{\sqrt{\hat{v}_t} + \epsilon} \left( \hat{m}_{t-1} + \frac{(1 - \beta_1)g_t}{1 - \beta_1^t} \right)
θt+1=θt−v^t+ϵη(m^t−1+1−β1t(1−β1)gt)
该方程与 NAG 公式中展开的动量项非常相似。我们只需将前一时间步动量向量的偏置修正估计
m
^
t
−
1
\hat{m}_{t-1}
m^t−1 替换为当前动量向量的偏置修正估计
m
^
t
\hat{m}_t
m^t,即可将 Nesterov 动量添加到 Adam 中,从而得出 Nadam 更新规则:
θ
t
+
1
=
θ
t
−
η
v
^
t
+
ϵ
(
β
1
m
^
t
+
(
1
−
β
1
)
g
t
1
−
β
1
t
)
\theta_{t+1} = \theta_t - \frac{\eta}{\sqrt{\hat{v}_t} + \epsilon} \left( \beta_1 \hat{m}_t + \frac{(1 - \beta_1)g_t}{1 - \beta_1^t} \right)
θt+1=θt−v^t+ϵη(β1m^t+1−β1t(1−β1)gt)
数学表述
Nadam 的数学表述基于以下方程:
m
t
=
β
1
m
t
−
1
+
(
1
−
β
1
)
∇
f
(
θ
t
)
v
t
=
β
2
v
t
−
1
+
(
1
−
β
2
)
(
∇
f
(
θ
t
)
)
2
θ
t
+
1
=
θ
t
−
η
m
t
v
t
+
ϵ
m_t = \beta_1 m_{t-1} + (1 - \beta_1)\nabla f(\theta_t) \\[4pt] v_t = \beta_2 v_{t-1} + (1 - \beta_2)(\nabla f(\theta_t))^2\\[4pt] \theta_{t+1} = \theta_t - \eta \frac{m_t}{\sqrt{v_t} + \epsilon}
mt=β1mt−1+(1−β1)∇f(θt)vt=β2vt−1+(1−β2)(∇f(θt))2θt+1=θt−ηvt+ϵmt
其中:
- β 1 \beta_1 β1 和 β 2 \beta_2 β2 是控制指数移动平均衰减率的超参数
- η \eta η 是学习率
- θ t \theta_t θt 是在迭代 t t t 时的模型参数
- ϵ \epsilon ϵ 是用于防止除以零的微小值
Nadam 优化器使用上述方程迭代更新模型参数,这些方程根据梯度的幅度和梯度的二阶矩自适应地调整步长。
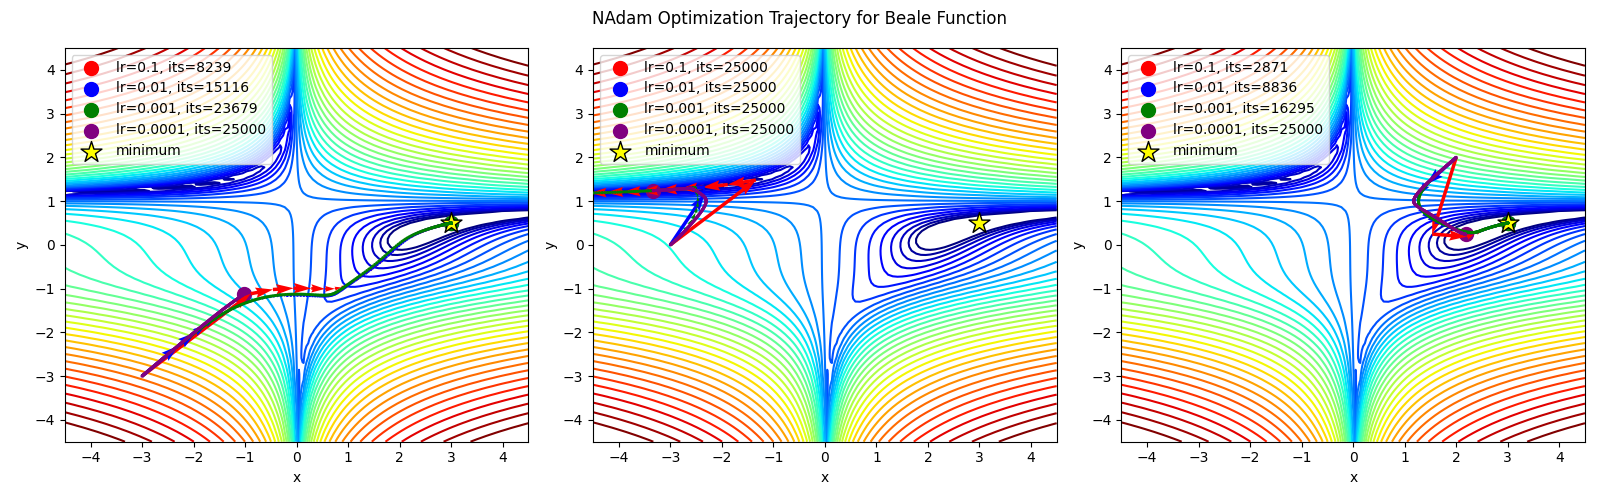
基于 Python 实现 NAdam
# NAdam optimizer implementation
def nadam_optimizer(func, grad_func, initial_params, learning_rate=0.01, beta1=0.9, beta2=0.999, epsilon=1e-8, max_iter=25000, tol=1e-6):
    params = initial_params
    m = np.zeros_like(params)  # Exponential moving average of gradient
    v = np.zeros_like(params)  # Exponential moving average of squared gradient
    t = 0
    beta1_product = beta1
    beta2_product = beta2

    # Store parameters every 100 steps
    params_history = [params.copy()]

    while t < max_iter:
        t += 1
        gradient = grad_func(*params)
        m = beta1 * m + (1 - beta1) * gradient
        v = beta2 * v + (1 - beta2) * (gradient ** 2)

        # Bias correction
        m_hat = m / (1 - beta1_product)
        v_hat = v / (1 - beta2_product)

        # Update parameters
        params -= learning_rate * m_hat / (np.sqrt(v_hat) + epsilon)

        # Update beta1 and beta2 products
        beta1_product *= beta1
        beta2_product *= beta2

        if t % 100 == 0:
            params_history.append(params.copy())

        if np.linalg.norm(gradient) < tol:
            break

    print("Converged after", t, "iterations")
    return params, params_history, t
AdamW
AdamW 与 Adam 类似,通过维护过去梯度的指数衰减平均值 m t m_t mt 和平方梯度的指数衰减平均值 v t v_t vt,为每个参数计算自适应学习率。然而,AdamW 引入了**权重衰减(Weight Decay)**来解决训练过程中参数量级增长的问题。权重衰减(也称为 L 2 L2 L2 正则化)通过向损失函数添加一个与参数平方幅度成正比的项,来惩罚较大的参数值。
AdamW 的更新规则通过将权重衰减直接合并到参数更新中,对原始 Adam 更新规则进行了修改。让我们重新审视 Adam 更新规则:
m
t
=
β
1
m
t
−
1
+
(
1
−
β
1
)
g
t
v
t
=
β
2
v
t
−
1
+
(
1
−
β
2
)
g
t
2
m
^
t
=
m
t
1
−
β
1
t
v
^
t
=
v
t
1
−
β
2
t
θ
t
+
1
=
θ
t
−
η
v
^
t
+
ϵ
m
^
t
m_t = \beta_1 m_{t-1} + (1 - \beta_1)g_t \\[4pt] v_t = \beta_2 v_{t-1} + (1 - \beta_2)g_t^2 \\[4pt] \hat{m}_t = \frac{m_t}{1 - \beta_1^t} \ \ \ \hat{v}_t = \frac{v_t}{1 - \beta_2^t} \\[4pt] \theta_{t+1} = \theta_t - \frac{\eta}{\sqrt{\hat{v}_t} + \epsilon}\hat{m}_t \\[4pt]
mt=β1mt−1+(1−β1)gtvt=β2vt−1+(1−β2)gt2m^t=1−β1tmt v^t=1−β2tvtθt+1=θt−v^t+ϵηm^t
为了在 Adam 更新规则中引入权重衰减(记为
λ
\lambda
λ),我们调整参数更新步骤如下:
θ
t
+
1
=
θ
t
−
η
v
^
t
+
ϵ
m
^
t
−
λ
θ
t
\theta_{t+1} = \theta_t - \frac{\eta}{\sqrt{\hat{v}_t} + \epsilon}\hat{m}_t - \lambda\theta_t
θt+1=θt−v^t+ϵηm^t−λθt
该方程包含一个额外的项
−
λ
θ
t
-\lambda\theta_t
−λθt,用于惩罚较大的参数值。通过将权重衰减直接应用于参数更新,AdamW 防止了参数量级的无控增长,而这种增长可能导致过拟合。这一改进使得 AdamW 在训练深度神经网络时特别有效,并有助于提高其泛化性能。
数学公式
AdamW 优化器可以从数学上表示如下:
m
t
=
β
1
m
t
−
1
+
(
1
−
β
1
)
∇
f
(
θ
t
)
v
t
=
β
2
v
t
−
1
+
(
1
−
β
2
)
(
∇
f
(
θ
t
)
)
2
θ
t
+
1
=
θ
t
−
η
m
t
v
t
+
ϵ
m_t = \beta_1 m_{t-1} + (1 - \beta_1)\nabla f(\theta_t) \\[4pt] v_t = \beta_2 v_{t-1} + (1 - \beta_2)(\nabla f(\theta_t))^2 \\[4pt] \theta_{t+1} = \theta_t - \eta \frac{m_t}{\sqrt{v_t} + \epsilon}
mt=β1mt−1+(1−β1)∇f(θt)vt=β2vt−1+(1−β2)(∇f(θt))2θt+1=θt−ηvt+ϵmt
其中:
- β 1 \beta_1 β1 和 β 2 \beta_2 β2 分别是控制一阶矩和二阶矩指数衰减率的超参数。
- η \eta η 是学习率。
- ϵ \epsilon ϵ 是为了防止除以零而添加的微小值。
AdamW 的更新规则涉及计算梯度的一阶矩(均值)和二阶矩(方差),随后使用这些矩来更新模型参数。
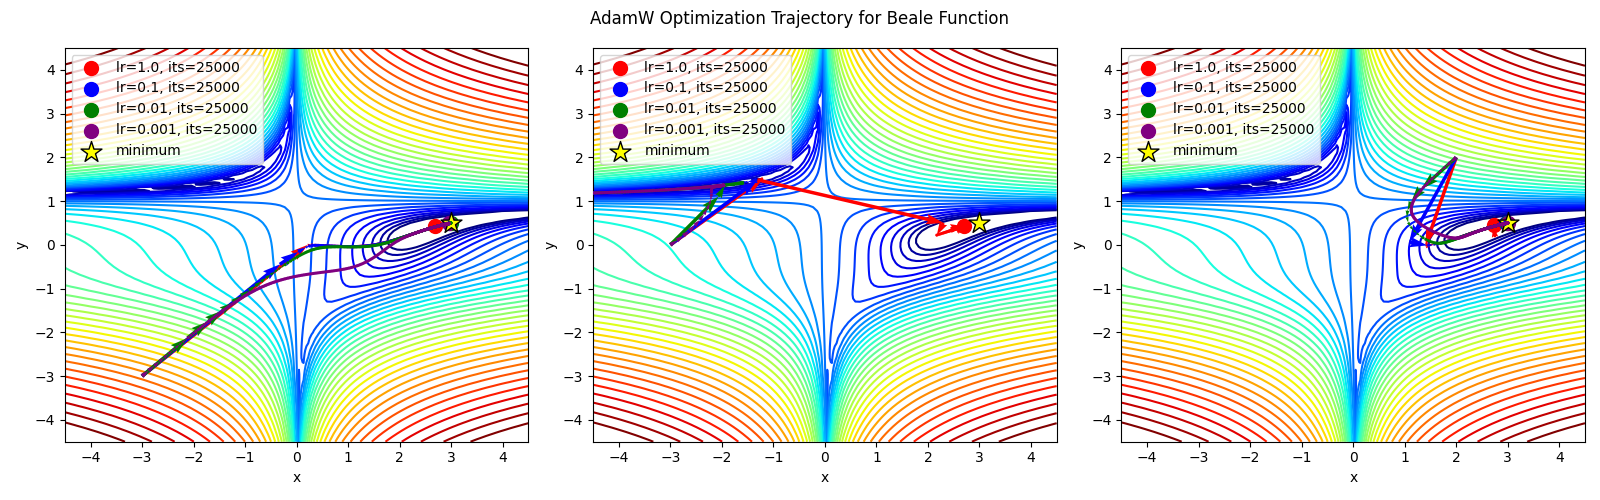
基于 Python 实现 AdamW
# AdamW optimizer implementation
def adamw_optimizer(func, grad_func, initial_params, learning_rate=0.01, beta1=0.9, beta2=0.999, epsilon=1e-8, weight_decay=0.01, max_iter=25000, tol=1e-6):
    params = initial_params
    m = np.zeros_like(params)
    v = np.zeros_like(params)
    t = 0

    # Store parameters every 100 steps
    params_history = [params.copy()]

    while t < max_iter:
        t += 1
        gradient = grad_func(*params)
        m = beta1 * m + (1 - beta1) * gradient
        v = beta2 * v + (1 - beta2) * (gradient ** 2)
        m_hat = m / (1 - beta1**t)
        v_hat = v / (1 - beta2**t)
        params -= learning_rate * (m_hat / (np.sqrt(v_hat) + epsilon) + weight_decay * params)

        if t % 100 == 0:
            params_history.append(params.copy())

        if np.linalg.norm(gradient) < tol:
            break

    if t % 100 != 0:
        params_history.append(params.copy())

    print("Converged after", t, "iterations")
    return params, params_history, t
总结
在本文中,我们探索了旨在增强随机梯度下降(SGD)的各种优化算法。从经典的动量法(Momentum)和 Nesterov 法,到更现代的方法,如 Adam、RMSprop、Adagrad、Adadelta、Adamax、Nadam 和 AdamW。尽管它们存在差异,但这些优化技术之间有着共同的主线。
例如,动量的引入通过引入过去梯度的移动平均,解决了 SGD 的许多缺陷,提供了稳定性并实现了更快的收敛。Nesterov 动量则更进一步,通过调整动量项来预测梯度的未来方向。
Adam 系列算法(包括 Adam、Nadam 和 AdamW)通过动态调整每个参数的学习率,并维持梯度的一阶矩和二阶矩估计,引入了自适应性。类似地,RMSprop 和 Adadelta 通过使用梯度平方的指数衰减平均值来归一化梯度,解决了学习率不断减小的问题,确保了更平滑的收敛,尤其是在处理稀疏数据时。
Adagrad 采取了不同的方法,根据累积梯度平方的反比来缩放学习率。这种自适应学习率方案对出现频率较低的参数非常有利,使其非常适合稀疏数据场景。Adagrad 的继任者 Adadelta 进一步完善了这一方法,通过限制累积过去梯度的窗口,实现了更稳定和高效的优化。
Adamax 通过利用 ℓ ∞ \ell^\infty ℓ∞ 范数来缩放梯度,扩展了 Adam 算法,在某些情况下提供了稳定性并提升了性能,特别是在高维空间中。同时,AdamW 引入了权重衰减,以防止模型参数在训练期间无限增长。
总之,虽然这些优化算法在方法和细节上各不相同,但它们都有一个共同的目标,即增强 SGD,以实现更高效、更有效的模型训练。
Acknowledgments AND References:
本文主要是对梯度下降及其相关优化算法的一次系统性整理与学习笔记。
在撰写过程中参考了大量优秀的技术博客、论文以及官方文档,并在理解的基础上进行了重新组织与表达。
由于相关内容仍在持续学习和探索之中,这篇文章也会随着时间不断补充与修订。
Acknowledgments
Machine Learning Explained: A Guide to ML, AI, & Deep Learning
Machine Learning vs Deep Learning
Marcus D. R. Klarqvist:
Deep Learning Optimization Algorithms: A Comprehensive Guide
Interesting Functions for Testing Optimization Methods
Sebastian Ruder:
An overview of gradient descent optimization algorithms
References
Kingma, D. P., & Ba, J. L. (2015). Adam: a Method for Stochastic Optimization. International Conference on Learning Representations, 1–13.
Reddi, Sashank J., Kale, Satyen, & Kumar, Sanjiv. On the Convergence of Adam and Beyond. Proceedings of ICLR 2018.
Loshchilov, I., & Hutter, F. (2019). Decoupled Weight Decay Regularization. In Proceedings of ICLR 2019.
Ma, J., & Yarats, D. (2019). Quasi-hyperbolic momentum and Adam for deep learning. In Proceedings of ICLR 2019.
互联网技术社区的开放与共享,使得复杂的知识能够被不断传播与重构。
如果本文能够在某些细节上帮助读者更快理解这些优化算法,那么这篇文章的目的也就达到了。
由于个人理解和经验有限,文中难免存在疏漏或理解偏差之处,欢迎读者指出并交流讨论。
更多推荐


 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)