
【JchatMind智能体 | 第一天】从最原始的大模型调用开始
前言:
本项目非原创,我也是作为一名初学者跟着一起学习。项目来源于:代码随想录-知识星球。
代码随想录-知识星球 https://wx.zsxq.com/group/88511825151142
在知识星球里看到卡哥分享这个项目 ,感觉还不错,于是想要学习一下这个项目怎么写。项目日记也会同步更新。(本人不分享本项目源码,支持项目付费)
本文由我学习该项目并结合AI整理总结而来,分享出来学习过程中的心得体会,由浅入深,用于日后的回顾,同时也希望能给你带来帮助。
目录
Agent 开发框架,究竟替我做了哪些事?
在进入 Agent 系统设计之前,非常有必要先回到最底层,用最原始的 API 调用方式,完整地走一遍模型交互流程。只有当我们真正看过 messages 是如何被拼接的、工具调用信息是如何在网络中往返的、上下文是如何一步步增长和裁剪的,再回头看 Agent、Tool Calling、RAG 这些概念时,很多原本抽象的设计都会突然变得具体起来。
本章不会引入任何框架,而是通过三个逐步递进的小实验,亲手跑完一条“最小可理解”的模型交互链路:
-
先完成一次最基本的单轮对话
-
再实现一个手动维护上下文的多轮对话
-
最后跑通一次完整的工具调用流程
示例代码统一使用 JavaScript,这样我们可以直接在浏览器开发者工具中,看到真实的请求与响应数据。
一、最基本的单轮对话
我们从最简单的情况开始:如何向模型发送一次请求,并拿到一次回答。
在这个阶段,我们只关心一件事:模型 API 在网络中,究竟长什么样子。
下面是一段最基础的大模型调用示例,用于演示一次完整的请求与响应流程(请注意,示例中的 API Key 仅用于结构演示,真实项目中不要写在前端):
const apiKey = "YOUR_API_KEY";
const baseUrl = "https://api.deepseek.com";
const model = "deepseek-chat";

const response = await fetch(`${baseUrl}/v1/chat/completions`, {
  method: "POST",
  headers: {
    "Content-Type": "application/json",
    "Authorization": `Bearer ${apiKey}`
  },
  body: JSON.stringify({
    model,
    messages: [
      { role: "user", content: "生命的意义是什么?" }
    ]
  })
});

const data = await response.json();
console.log(data.choices[0].message.content);
为了更直观地观察请求过程,我们使用 example1.html 页面进行测试,访问地址为 127.0.0.1:5500/EXAMPLES/EXAMPLE1.HTML。
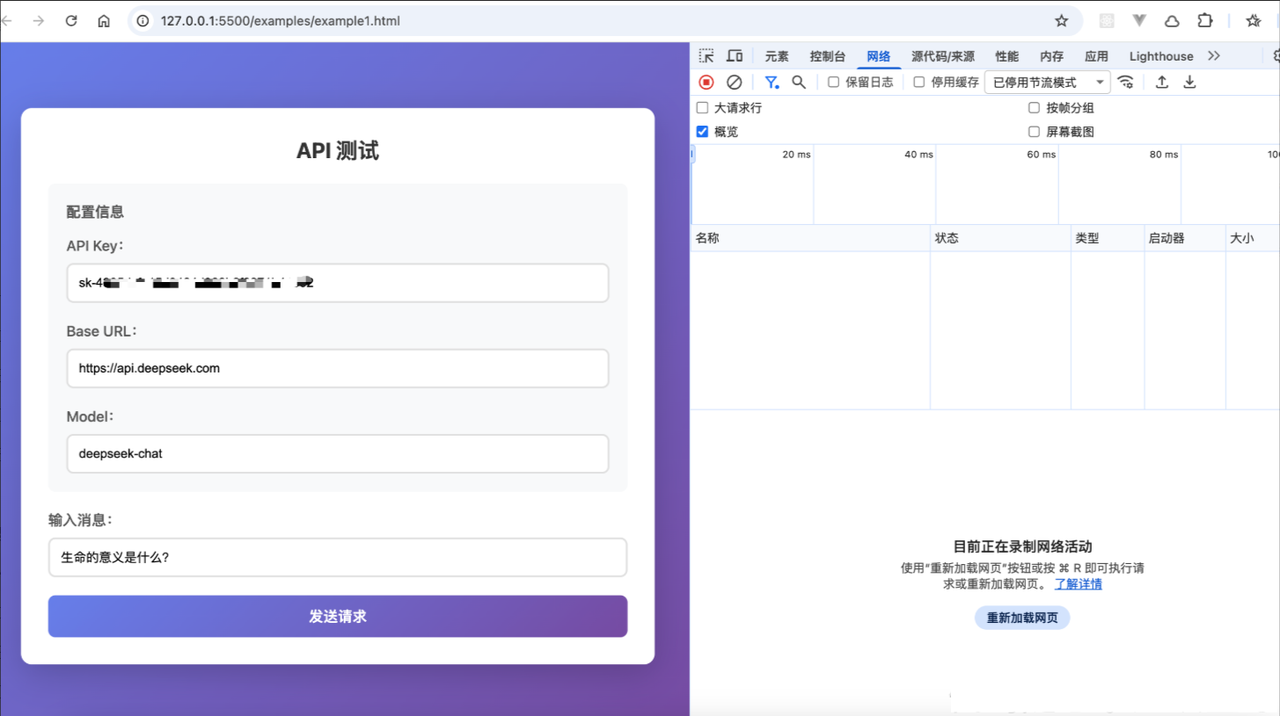
打开浏览器开发者工具,切换到 Network 面板,我们会看到请求体大致如下:


{
  "model": "deepseek-chat",
  "messages": [
    {
      "role": "user",
      "content": "生命的意义是什么?"
    }
  ]
}
这里有一个非常重要的认知点:
模型看到的,从来不是“当前这一句话”,而是你发送给它的整个 messages。
在这个示例中,我们只有一条 user 消息,所以 messages 很短。但在真实聊天产品中,之所以能够“记住上下文”,并不是模型在记忆,而是系统在每一轮请求中,把历史对话完整地重新发给了模型
对应的响应体结构如下:
{
  "ID": "E6CA0FC0-A7D0-4504-8D40-0C7EBF2724A7",
  "OBJECT": "CHAT.COMPLETION",
  "CREATED": 1765955019,
  "MODEL": "DEEPSEEK-CHAT",
  "CHOICES": [
    {
      "INDEX": 0,
      "MESSAGE": {
        "ROLE": "ASSISTANT",
        "CONTENT": "这是一个古老而深刻的问题,无数哲学家、科学家都曾探讨……"
      },
      "LOGPROBS": null,
      "FINISH_REASON": "STOP"
    }
  ],
  "USAGE": {
    "PROMPT_TOKENS": 8,
    "COMPLETION_TOKENS": 507,
    "TOTAL_TOKENS": 515,
    "PROMPT_TOKENS_DETAILS": {
      "CACHED_TOKENS": 0,
      "PROMPT_CACHE_HIT_TOKENS": 0,
      "PROMPT_CACHE_MISS_TOKENS": 8
    }
  },
  "SYSTEM_FINGERPRINT": "FP_EAAB8D114B_PROD0820_FP8_KVCACHE"
}
再来看响应体。模型返回的内容并不是一个简单字符串,而是被包装在一个标准的 message 结构中:这里的 role 是 assistant,content 才是真正的生成文本。这一点非常关键,因为它意味着:模型的输出,本身就可以被直接追加回 messages,作为下一轮对话的上下文。
另外两个在工程上非常常用的字段是:
-
finish_reason:模型为什么结束生成
-
usage:本次调用消耗的 token 数量
它们在后续的流式输出、工具调用和计费控制中,都会频繁出现。
到这里,我们已经完成了第一步:亲眼看清了一次“输入 → 模型 → 输出”的真实数据结构。
choices 是什么?为什么是个数组?
在当前这个示例中,我们的请求结果被放到了一个被称之为 choices 的数组内。
如果你用过 AI 聊天产品,你可能会碰到,有时候你问 AI 一个问题,它有时候会同时返回两个结果,然后在回复的结尾,问你更喜欢哪个回复。
所以模型其实会输出一个候选集合,不过我们简单起见,每次我们默认选择数组的第一个结果就可以。
二、多轮对话
如果现在再向模型发送一个新的问题,但不携带任何历史消息,模型并不会知道之前问过什么。这是最容易产生误解的地方。
聊天产品里的“上下文记忆”,并不是模型在记忆,而是系统在做一件非常朴素的事情:把历史对话整理好,再一次性发给模型。
下面是一个最常见的多轮对话实现方式,通过一个数组手动维护上下文。
let conversationHistory = [];

function addMessage(role, content) {
  conversationHistory.push({ role, content });
}

async function sendMessage(message) {
  addMessage("user", message);

  const response = await fetch(`${baseUrl}/v1/chat/completions`, {
    method: "POST",
    headers: {
      "Content-Type": "application/json",
      "Authorization": `Bearer ${apiKey}`
    },
    body: JSON.stringify({
      model,
      messages: conversationHistory
    })
  });

  const data = await response.json();
  const assistantMessage = data.choices[0].message.content;
  addMessage("assistant", assistantMessage);
}
在 example2.html 页面中,你可以直观地看到 messages 随着对话不断增长。访问地址为 127.0.0.1:5500/EXAMPLES/EXAMPLE2.HTML。
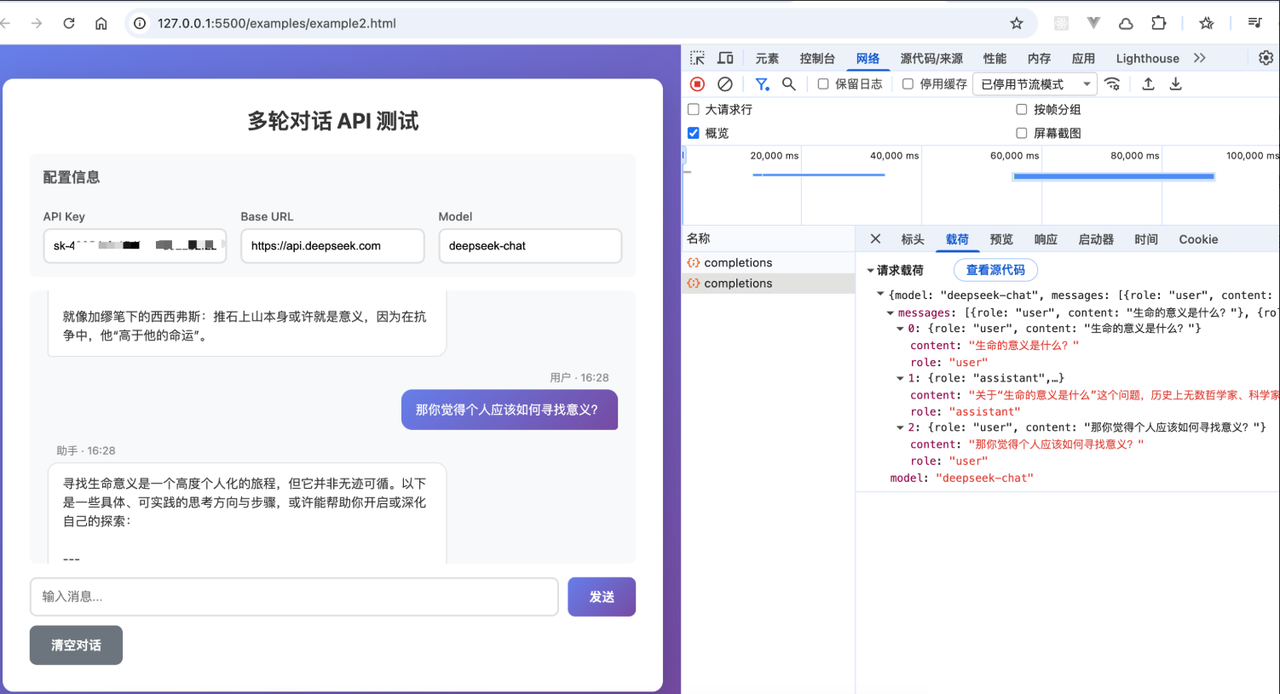
当用户先发送“生命的意义是什么?”,模型返回对应回答后,messages 数组内容为:
[
  {
    "role": "user",
    "content": "生命的意义是什么?"
  },
  {
    "role": "assistant",
    "content": "关于‘生命的意义是什么’这个问题,历史上无数哲学家、科学家……就像加缪笔下的西西弗斯:推石上山本身或许就是意义,因为在抗争中,他‘高于他的命运’。"
  }
]
当用户继续发送“那你觉得个人应该如何寻找意义?”,系统会将这条新的 user 消息追加到 messages 数组,再发送给模型,此时 messages 数组内容为:
[
  {
    "role": "user",
    "content": "生命的意义是什么?"
  },
  {
    "role": "assistant",
    "content": "关于‘生命的意义是什么’这个问题,历史上无数哲学家、科学家……就像加缪笔下的西西弗斯:推石上山本身或许就是意义,因为在抗争中,他‘高于他的命运’。"
  },
  {
    "role": "user",
    "content": "那你觉得个人应该如何寻找意义?"
  }
]
此时我们应该能够得出一个非常重要的结论:
多轮对话的“记忆感”,完全来自系统对 messages 的管理,而不是模型本身的能力。
理解了这一点,我们就已经在为后面的 Agent、Tool Calling 打基础了。因为所有更复杂的行为,本质上都是在 messages 之上演进的。
三、role 的意义
每一条 message 看起来都很简单,但 role 并不是一个展示标签,而是模型理解上下文时最关键的信号。
常见的 role 包括 user、assistant、system 和 tool。
-
user 表示用户输入,assistant 表示模型输出,它们共同构成对话历史。
-
system 用来描述全局规则、角色设定或行为约束,它更像是一段背景说明,而不是一次发言。
-
tool 则是工具执行结果的专用角色,用来告诉模型:“这段内容不是用户说的,而是某个工具的真实执行结果。”
这一点非常重要。如果把工具执行结果当作 user 消息发回模型,模型很可能会直接理解错上下文,甚至报错。
理解 role 的真正用途之后,会发现:多轮对话、工具调用、Agent Loop,其实都是围绕 messages 和 role 在不断升级。
四、工具调用
接下来,我们通过一个查询天气的示例,跑通一次完整的工具调用链路。
当用户问“今天我这里的天气怎么样”时,模型本身并不知道你的城市、不知道今天的日期,也无法访问真实天气接口。这种问题,不可能通过一次生成直接完成。
因此,我们需要为系统定义一组“工具”,并把这些能力告诉模型。
const tools = [
  {
    type: "function",
    function: {
      name: "get_current_date",
      description: "查询今天的日期",
      parameters: { type: "object", properties: {}, required: [] }
    }
  },
  {
    type: "function",
    function: {
      name: "get_current_city",
      description: "查询当前所在的城市",
      parameters: { type: "object", properties: {}, required: [] }
    }
  },
  {
    type: "function",
    function: {
      name: "get_weather",
      description: "根据日期和城市查询天气信息",
      parameters: {
        type: "object",
        properties: {
          date: { type: "string" },
          city: { type: "string" }
        },
        required: ["date", "city"]
      }
    }
  }
];
在请求中,将 tools 一并发送给模型,并允许模型自动决定是否调用工具。
body: JSON.stringify({
  model,
  messages,
  tools,
  tool_choice: "auto"
})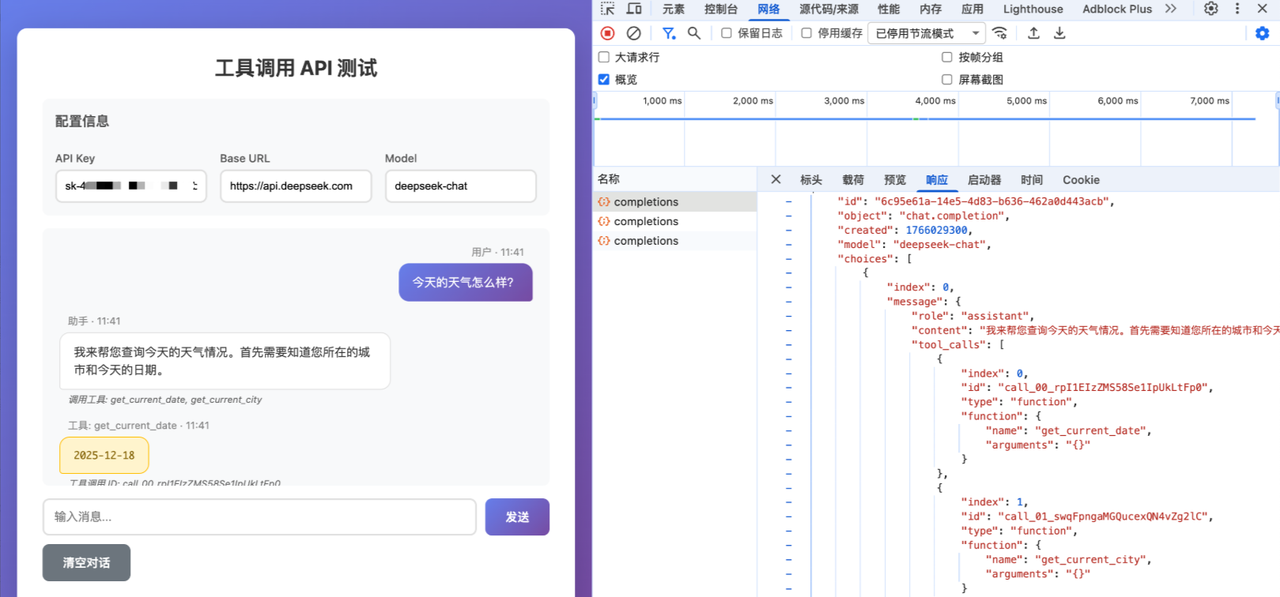
模型在第一次响应中,并不会直接回答天气,而是返回它“希望调用的工具”。
系统解析这些 tool_calls,执行对应的真实代码(比如获取当前日期为 2025-12-18,获取当前城市为深圳),并把执行结果以 tool message 的形式追加到 messages 中,再次发送给模型。
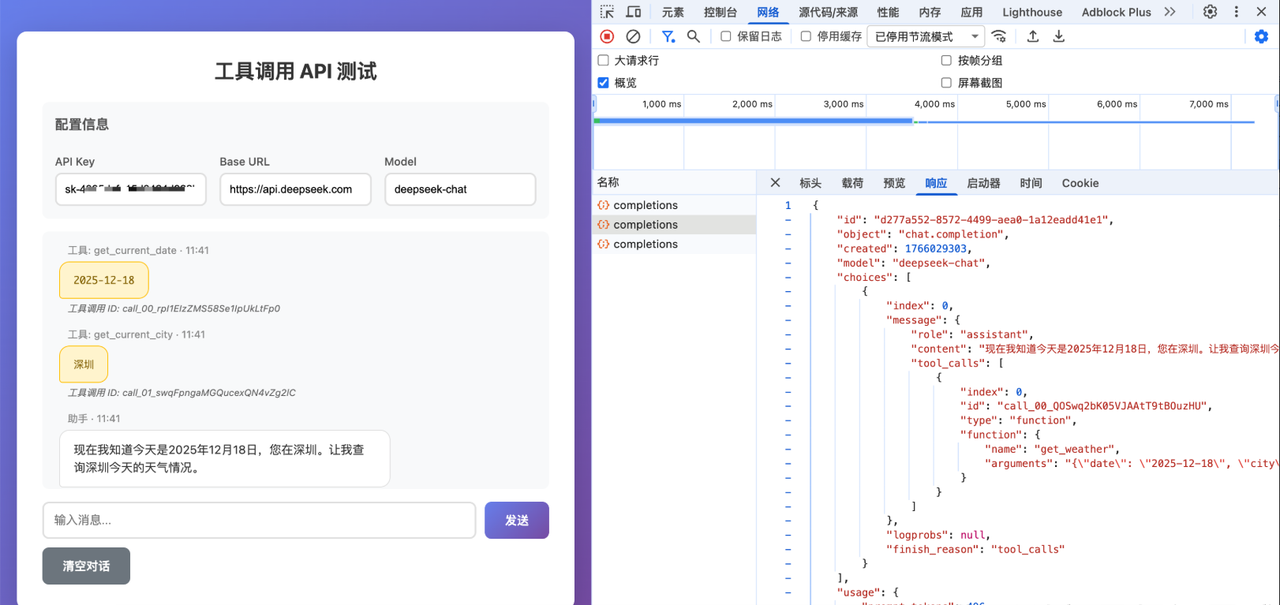
模型拿到新的信息后,继续判断下一步需要什么工具。
这个过程往往会发生多次,直到信息足够,模型才会生成最终的自然语言回答。
在 example3.html 中,你可以完整看到这一往返过程。
如果回头看整个流程,会发现一件非常关键的事情:
-
模型从头到尾都没有“直接做事”
-
它只是不断判断:现在还缺什么信息
-
每一步缺失的信息,都由系统通过工具补齐
这正是工具调用的本质协作方式:
模型负责决策,系统负责执行,而 messages 记录全过程。
五、最小 Agent
虽然我们还没有定义 Agent 类,也没有引入任何框架,但你已经亲手跑完了一条具备以下特征的流程:
-
有明确目标
-
有中间状态
-
能根据结果继续推进
-
能与真实系统交互
这已经不再是一次简单的问答,而是一个最小可运行的 Agent 行为闭环。
当理解了这一点,再回头看 Spring AI 这类框架时,就会发现它们并不是在“让模型更聪明”,而是在帮你把这些步骤系统化、标准化、可观测化。
六、总结
在这一章中,刻意绕开了所有框架,只用最原始的 API,走完了一次模型交互的完整链路。
清楚地看到:
-
上下文不是模型记住的,而是系统拼接的
-
工具不是模型执行的,而是系统代劳的
-
多次请求的往返,本身就构成了任务推进的最小循环
当这些认知真正建立起来之后,Agent 系统就不再神秘了。
接下来要做的事情也非常自然:当任务更复杂、工具更多、对话更长时,我们该如何控制这个循环,避免失控,并让它在工程上可维护?
上述内容也同步在我的飞书,欢迎访问
https://my.feishu.cn/wiki/QLauws6lWif1pnkhB8IcAvkhncc?from=from_copylink
如果我的内容对你有帮助,请点赞,评论,收藏。创作不易,你们的支持就是我坚持下去的动力!
更多推荐


 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)