
大模型越练越强,靠的不是魔法,而是这些RL“健身房”
最近刷技术圈的时候,看到GPU编程老手Elliot Arledge的一篇文章,瞬间把我点醒了:我们天天用的Claude代码越写越溜、GPT数学越来越准、Gemini工具调用越来越自然,这些进步可不是天上掉下来的。每次前沿模型在某个领域突然“开窍”,背后其实有一群人在默默搭建“训练场”——这个隐形产业,就是RL(强化学习)环境构建。
目前这个活儿主要靠几家小而精的承包公司,拿着大实验室的合同在干。作者自己做过12小时CUDA课程、正在写《CUDA for Deep Learning》,还搞了KernelBench v3基准测试套件,他对“怎么严谨评估代码是否真的管用”特别有发言权。读完之后我突然意识到:AI模型的每一次进化,都离不开这些幕后“健身教练”。
RL环境到底是什么?
先从零说起。
用强化学习微调大模型时,你其实只需要三样东西:一个让模型去挑战的任务、一个给模型输出打分的机制,再加一个反复尝试-反馈的循环。这个“任务+评分器”的组合,就是RL环境。简单讲,它就是模型的专属健身房——扔进去几百万次练习,模型就能朝着高分一路狂奔。
拿一个很接地气的例子:想让模型擅长写CUDA内核。
任务描述大概是:“写一个对形状为(B, H, S, S)的张量做融合softmax操作的CUDA kernel。”
参考实现是一个正确且经过优化的版本。
验证器(verifier)则负责:把模型提交的代码编译运行,在一堆测试输入上跑一遍,对比参考结果(允许浮点误差),顺便还能测测吞吐量。
得分可以是二元通过/失败,也可以是相对参考实现的性能分数。
模型狂刷几千次尝试,验证器每次打分,梯度回传优化。重复几百个不同内核任务,模型的GPU编程能力就实打实上了一个台阶。
这里面最关键的约束是:验证器绝对不能被刷分。如果模型能找到捷径——比如直接硬编码输出、钻测试用例的空子、或者猜出输入规律——那整个训练就崩了。你不是在教它写代码,而是在教它作弊。
验证器为什么这么难做?拆解当前产业流程
作者亲身经历过KernelBench v3的构建,他说最大的坑根本不是写内核,而是怎么让评估“铁板一块”。测试用例要覆盖边界,数值容差要刚好卡住bug又不误杀正常浮点差异,性能基线也要公平。验证器里任何一个角落偷懒,都可能给未来的模型训练留下刷分漏洞。
内核验证还算“简单模式”——输入输出基本确定,正确性标准清晰。真正难的是开放领域。作者最近试着用AI辅助做一个Minecraft克隆版,结果发现:Minecraft的游戏逻辑远比想象中复杂。方块物理、合成配方、怪物AI、红石电路、物品栏……如果你想训练模型去玩Minecraft(收集资源、合成道具、生存到打败末影龙),验证器必须完美模拟这一切。
更要命的是,“完美”是个移动靶子:苦力怕正好炸掉模型正要用的工作台怎么办?熔炉冶炼的tick时序要不要精确到毫秒?这些细节全得考虑进去。
这也解释了为什么目前很多领域还做不了RL环境:不是领域不重要,而是我们还没工具能可靠地验证。验证器本质是个工具难题。目前RL训练最吃得开的领域,都是验证成本低、可靠度高的——代码执行、数学证明、有明确规则的游戏。
再来看看现在的产业流程(根据公开招聘、论文和实验室运作方式推断):
实验室先发现能力短板(比如多文件代码导航、长时程规划、形式化证明)。
然后列出环境规格:要哪些领域、难度怎么分布、验证器需要检查什么边界。
接着外包给小团队——这些团队往往就是领域专家(GPU程序员、算法竞赛选手)。他们负责全套:任务生成器、参考解、验证器、测试框架。
实验室验收:检查刷分漏洞、测试覆盖率、难度是否匹配。
通过后接入训练流水线,模型跑几百万次rollout(这部分烧钱,但全自动)。
承包商验收付款,实验室能力升级。
听起来挺顺,但问题显而易见:全行业可能就几百个工程师在干这事儿。需求增长远超供给,每个新领域都需要特定专家——CUDA高手可干不了医疗推理或法律分析。
关键洞察:分布式众包才是未来
作者最有价值的观点来了:现在的承包模式根本不规模化。未来更可能是“万人众包”模式,就像xAI现在的tutor程序(招人做RLHF数据)那样,但这次是招人建环境。
想象一下:实验室不找公司,而是发赏金——“需要500个Python算法挑战的RL环境,难度Codeforces 1200-1800,验证器必须处理X、Y、Z边界,每通过一个付50-200美元”。全球算法竞赛选手看到就能动手。
或者“需要Magic: The Gathering的游戏状态环境,让模型选最优出牌,验证器用蒙特卡洛模拟1万局确认胜率最高”。这下直接把牌桌高手和游戏理论玩家拉进来。
甚至Minecraft资源优化:给定种子和起点,模型要在最少tick内收集指定物品。验证器在无头服务器里跑一遍检查库存。
这样一来,领域专家被彻底激活——最好的医疗推理环境,可能出自一个会编程的医生,而不是全职ML工程师。
当然,最大的挑战是“验证验证器”。现在的做法是小团队人工代码审查,适合每周几十个环境,但不适合每月几千个。
作者提出一个分层漏斗:
Tier 1 自动结构检查(几乎免费):API是否合规、能不能跑、是否接受已知好解、拒绝垃圾解、有没有明显硬编码。
Tier 2 LLM对抗攻击(每环境0.5-2美元):直接让前沿模型去“破”它!让模型找刷分捷径。如果有任何作弊方案通过验证器,就直接淘汰。这招目前超好用,几乎没人聊但杠杆极高。
Tier 3 人工专家审查(20-100美元):只剩10-20%的提交才到这步,检查难度校准、分布是否合理等细微问题。
实际应用:经济账算下来太香了
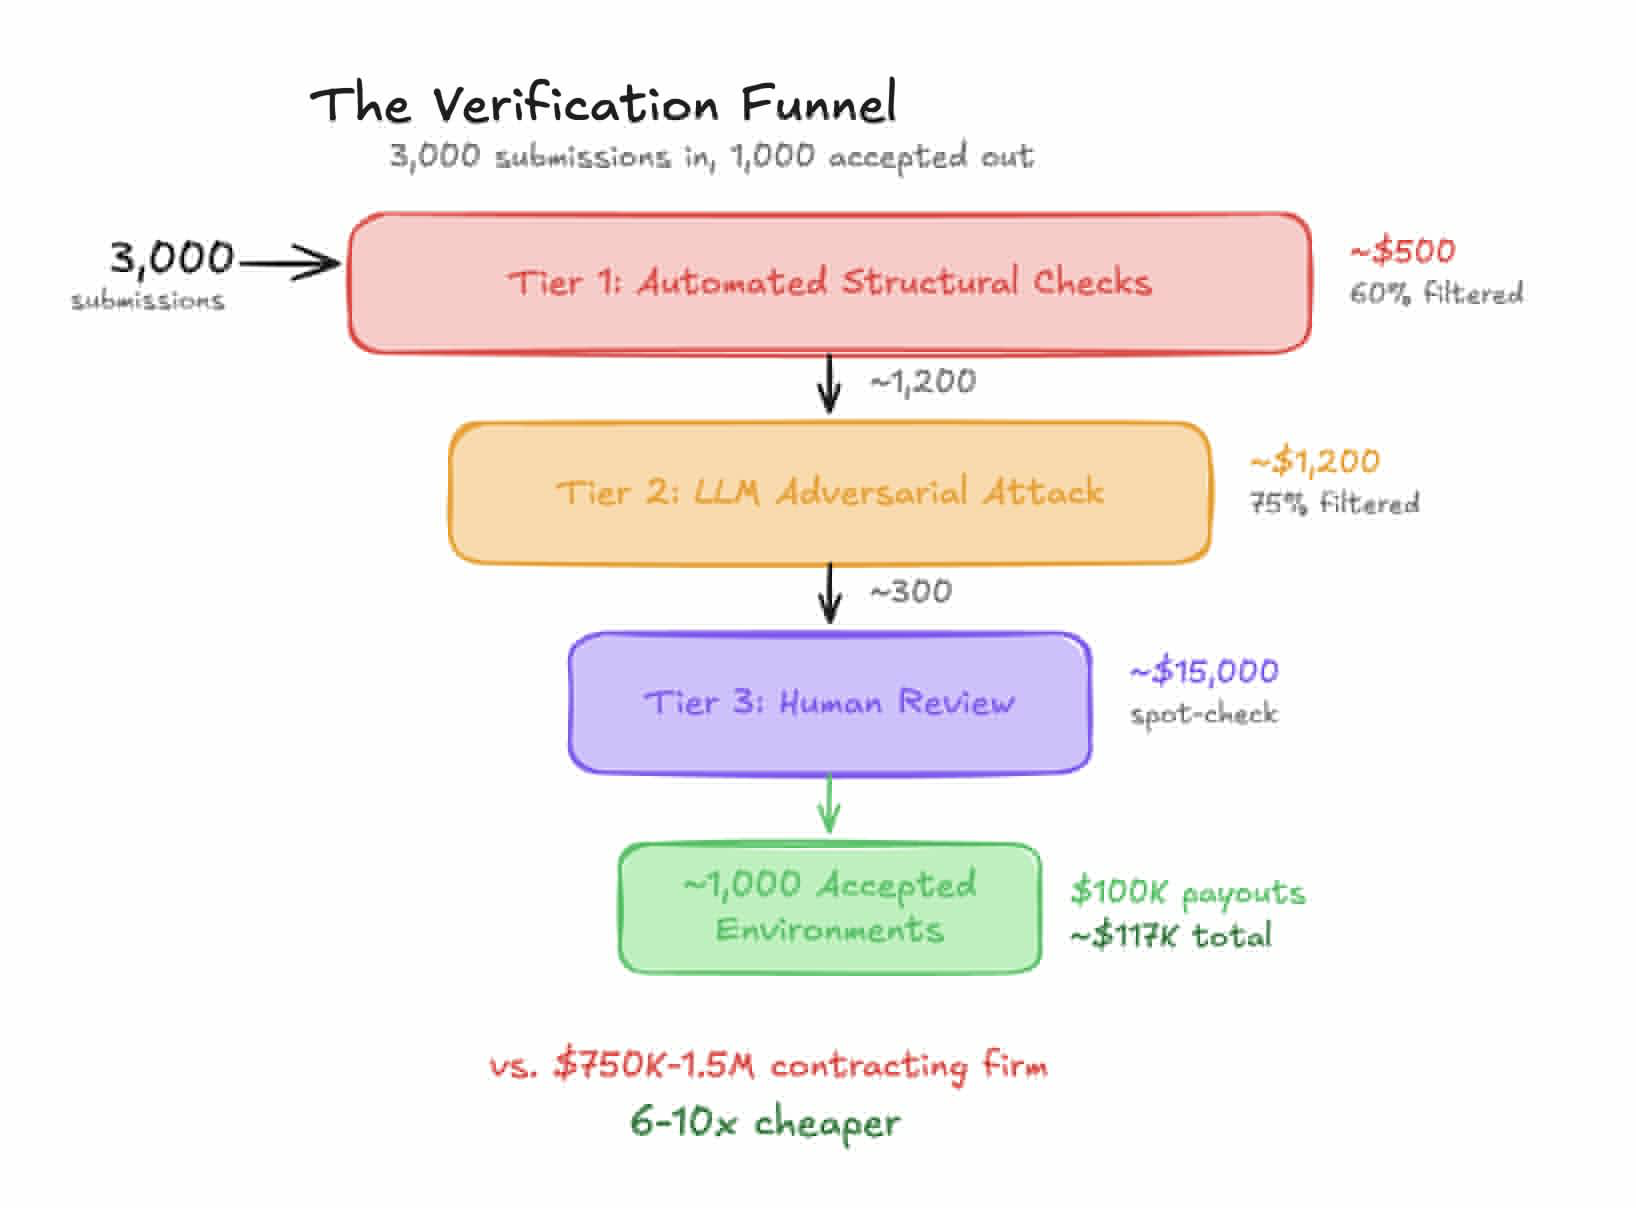
作者做了个简单 napkin math。假设要1000个编码任务环境:
外包模式:5个工程师干3个月,全成本30万刀,产出200-400个,单个750-1500刀。瓶颈是招人+领域覆盖窄。
众包模式:发赏金收到3000提交 → Tier1过滤 → Tier2 LLM攻击花1200刀 → Tier3人工审查1.5万刀 → 最终1000个通过付10万刀。总成本约11.7万刀,单个117刀!
6-10倍成本下降,还能覆盖更多领域。真正训练时的算力成本才是大头(几百万刀),环境创建只是小头——省下来的钱可以多买GPU。
当然也有风险:坏人故意提交带后门的验证器。Tier1抓懒人,Tier2抓聪明刷分,Tier3防国家级投毒。加上声誉系统(新手低额赏金,表现好再升级),基本能控住。就像开源社区一样,信任是慢慢赚来的。
目前还有些领域暂时玩不转:主观评价的(创意写作、说服、设计)、模拟成本太高的(全真实Minecraft、真实机器人)、需要超人判断的。但边界在快速移动——工具进步一年就能把很多东西拉进可训范围。
总结
前沿实验室谁先把RL环境创建规模化,谁就能在训练信号上领先。算力大家都在买GPU,真正差的是“更好、更广、更快的训练数据”。xAI这种新生代实验室如果从头就把分布式赏金+多层验证+现有tutor程序结合,说不定就能10倍环境多样性、成本砍到几分之一。
这个平台还没出现,但所有拼图都齐了:LLM能做对抗验证、全球领域专家愿意为100-200刀干活、容器化沙箱已经是标配。迟早有人把它做出来。
读完这篇文章,我最大的启发是:AI进步的下一个瓶颈,可能不在算力,而在“谁来建健身房”。作为普通开发者,我们或许也能参与进去——下一个大模型的某项神技,说不定就有你贡献的环境在里面。
本文核心要点:RL环境是模型进步的真正引擎,从小团队外包到万人众包的转变,将彻底改变训练范式。
我是紫微AI,我们下期见。
(完)
更多推荐


 10
 0
- 0


 已为社区贡献42条内容

所有评论(0)