
DSpark/MTP在大模型中的两种含义:Multi-Tensor Packing/Multi Token Prediction
首先最近在看GLM-5模型的时候发现模型本身有Quantized version without MTP quant 这种选项,MTP这个缩写很熟悉,但是实际看下来原来是两个含义?
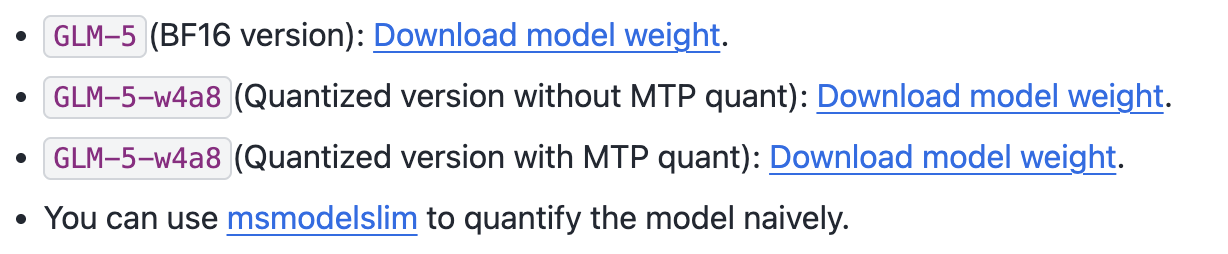
1、 Multi-Tensor Packing
MTP(Multi-Tensor Packing)量化是一种针对大模型推理的优化型量化策略,核心逻辑是:
将多个张量(Tensor)打包到同一个低精度数据块中(如 INT4/INT8),在保证精度损失可控的前提下,最大化显存利用率、减少内存读写开销,从而提升推理速度(尤其是 TPOT, Time Per Output Token 指标)。
简单说:MTP 是「量化之上的二次优化」,不是基础量化(如 INT8/INT4),而是让量化后的模型跑得更快、更省显存。
- 「without MTP quant」是基础量化版本:
比如常见的 INT8/INT4 对称 / 非对称量化,仅把模型权重从 FP16/FP32 转成低精度,是量化的「基础操作」,兼容性最好,精度损失易评估。 - 「with MTP quant」是进阶优化版本:
不是替换基础量化,而是「叠加」在基础量化之上 —— 只有先做了 INT8/INT4 量化,才能用 MTP 打包优化;如果基础量化都没做,谈 MTP 无意义。
精度损失的边界:
MTP 带来的精度损失通常远小于「基础量化 vs 非量化」的差异,在对话 / 推理场景中几乎感知不到;仅在高精度要求的任务(如数值计算、代码生成)中,「without MTP」会略占优。因此也带来不同的适用场景选择:
选「with MTP quant」:
- 推理场景(如大模型对话、长文本生成)、硬件为高带宽 GPU(A100/H100/A10)、追求极致显存利用率和推理速度,对微小精度损失不敏感。
- 选「without MTP quant」:
高精度要求场景(如代码生成、数学推理)、硬件为低带宽 GPU(T4/RTX3090)、追求部署兼容性(如通用框架 / 老版本推理引擎)、需要精准评估量化精度损失。
2、 Multi Token Prediction
MTP自身在工业界也存在广义和狭义之分,广义的MTP是指所有涉及多token预测的技术,个人理解广义的MTP和广义的投机解码(Speculative Decoding)含义相近,并投机解码的目的就是达到多token预测。狭义的mtp指的是deepseek-v3论文中提出的MTP技术,广义MTP/投机解码的核心愿景是彻底打破传统自回归(Autoregressive)模型"一次前向传播只能憋出一个 Token"的底层桎梏。
在目前的学术界与工业界,实现广义 MTP 主要有以下四种核心技术手段。它们在如何兼顾“上下文因果律(准确率)”与“计算并行度(速度)”上各自展现了不同的工程切入点:
2.1、独立多头联合训练(狭义原生 MTP)
这是最直观、也是由 Meta 论文和 DeepSeek-V3/R1 发扬光大的原生路线。
- 技术原理:
在大模型主干网络的最后几层(如 Transformer 最后一层),除了原生的输出头(LM Head 0)外,在旁边并联串起多个额外的预测头(LM Head 1, LM Head 2…)。
在训练时,通过特殊的深度融合或顺序监督损失(Loss),强行让主模型在吐出当前词 t + 1 t+1 t+1 的同时,副脑 1 预测 t + 2 t+2 t+2,副脑 2 预测 t + 3 t+3 t+3。MTP 必须在模型诞生(预训练)阶段就参与进去。DeepSeek 在提出 MTP 时,最初的目的不仅仅是为了推理加速,更是为了提升大模型的规划能力和代码、数学的推理智商。让模型在训练时同时预测未来两三个词,能逼着模型学会高瞻远瞩。 - 代表方案: DeepSeek-V3 原生 MTP 架构、Meta Multi-Token Prediction 论文。
尤其推荐这篇文章,流程图很清晰的说明了大模型网络中的tensor走向,简洁明了 十分钟读懂 Deepseek MTP(Multi-Token Prediction)
2.1.1. DeepSeek-V3 训练阶段:直接采用(Teacher Forcing)
在训练大模型时,有一种经典的训练方法叫 Teacher Forcing(导师强迫教学)。
- 过程: 模型在训练时,输入“今天天气真”,主脑预测“好”,副脑 1 预测“哇”。但不管副脑猜得对不对,在计算完这一次的 Loss 之后,下一发训练数据依然是真实文本(比如“今天天气真好,我们去…”)。
- 逻辑: 训练时,副脑输出的词不作为下一个位置的真实输入。主脑和副脑是并行各自计算自己的 Loss。在这个阶段,副脑的结果确实是“直接计算并采纳进 Loss”的,不需要互相验证。它的唯一目的是给模型提供更密集的学习信号(Densified Training Signals),让模型在生长时学会规划未来。
2.1.2. 推理生成阶段(Inference Time):必须进行投机解码验证!
副脑(MTP Modules)是非常轻量的(通常只有 1 层 Transformer)。如果让它盲猜 t + 2 t+2 t+2 的词,且不经过主脑验证就直接作为下一步的上下文输入,犯错的概率极高。一旦它错一个词,这个错误就会像滚雪球一样无限放大,导致模型智商瞬间崩塌。
因此,在实际线上部署 DeepSeek-V3 或 R1 时(比如使用 vLLM, SGLang 或 LMDeploy 框架),原生 MTP 头是这样被使用的:
-
主脑+副脑协同“盲猜”: Draft Phase.
主脑前向传播吐出 Token t + 1 t+1 t+1。与此同时,轻量的 MTP 副脑 1 顺着这个趋势,盲猜出下一个 Token t + 2 t+2 t+2。它们在一次计算中组合成一个“草稿串”: [ t + 1 , t + 2 ] [t+1, t+2] [t+1,t+2]。 -
主脑并行“大审判”: Verify Phase.
系统不会直接把 t + 2 t+2 t+2 喂给用户。相反,系统会将 [ t + 1 , t + 2 ] [t+1, t+2] [t+1,t+2] 作为一个整体,重新打包砸进主脑(671B 的全量网络)进行一次大批量的并行验证。 -
拒绝采样与纠偏: Rejection Sampling.
主脑通过高层特征计算出,在 t + 1 t+1 t+1 后面,真正的概率最高词确实是 t + 2 t+2 t+2。对上了则验证通过,用户在这一次循环中无损地同时得到了 2 个 Token(提速)。没对上则主脑会动用一票否决权,当场无情拒绝掉副脑猜的 t + 2 t+2 t+2,并由主脑现场吐出一个它认为真正正确的词(纠偏)。
2.2、非自回归 / 纯并行特征投影(Non-Autoregressive / Parallel Heads)
为了摆脱“串行”带来的延迟,这一流派主张“彻底的暴力并行”。
- 技术原理:
主模型完全冻结。在推理阶段,外挂一个由 1~2 层 Transformer 构成的并行网络。它接收主模型的頂层特征,并引入未来 K 个位置的位置编码(Positional Embeddings),利用一次矩阵乘法,同时、并排把未来 K K K 个位置的特征和 Logits 砸出来。 - 代表方案: DFlash、早期的 Medusa(美杜莎)基础版本。
- 优缺点:
优点:速度到了物理极限,因为预测未来 10 个词和预测 1 个词的延迟完全一样(只有一次前向传播)。
缺点:接受率严重衰减。因为各个位置是并排独立算出来的,位置 t + 3 t+3 t+3 根本不知道位置 t + 2 t+2 t+2 最终选了什么词。一旦前面猜错一个标点符号,后面一整排的预测全部脱节报废。这也是半自回归这种折衷技术路线提出的出发点。
2.3、半自回归特征循环(Semi-Autoregressive Hidden State Recurrence)
为了解决手段二“并排猜不准”的塌方问题,目前最前沿的路线衍生出了“半自回归”手段。这也是 DSpark 和 Eagle 系列的底层精髓。从大模型“边训练边多看几步”的MTP(多 Token 预测),到如今“外挂模块动态调度”的 DSpark(投机解码框架),DeepSeek 展现了其在打破大模型推理訪存受限(Memory-Bound)这一底层痛点上的技术演进。
- 技术原理:
它把预测分成了两步:
- 特征空间(并行): 用一个浅层骨干网络,一次性并行提取出未来多个位置的“隐藏特征底胚”,解决了网络层面的计算延迟。
- 词表空间(串行自回归): 在特征层之上,外挂极轻量的马尔可夫头(Markov Head)。在采样出 Token 时拉起一个微型的串行循环,让后一个位置的预测头能够“瞥一眼”前一个位置刚刚选了什么离散词,并将该词的 Embedding 动态注入到当前位置的特征中。
- 代表方案: DeepSeek DSpark (DeepSpec)、Eagle 3、SpecForge。
- 优缺点:
优点:完美融合了并行的高速度与自回归的高准确率。在长文本和代码场景下,能一口气盲猜 5~16 个词且保持极高的接受率。
缺点: 需要为不同的主模型单独训练这套轻量的外挂网络。
2.3.1、 技术底座的演进:从 MTP 到 DSpark
大语言模型推理之所以慢,是因为它是自回归(Autoregressive)的:每生成一个 token,GPU 都要把几百 GB 甚至上万亿参数的权重从显存全部刷一遍。
为了打破这个限制,DeepSeek 在技术路线上经历了两次重大的范式转变:
【第一阶段:MTP(联合训练)】
主干网络 ──────► [MTP头1] ──► [MTP头2]  (固定预测未来2~3步,训练成本高,强耦合)

【第二阶段:DSpark(框架化/半自回归外挂)】
主模型(完全冻结) ───► [DFlash 并行骨干] ──► [马尔可夫串行头] ──► [置信度调度验证]
                   (支持5~16步动态预测,不改主模型权重,解耦且更鲁棒)
发布于 2026 年 6 月底的 DSpark(依托于开源的 DeepSpec 仓),彻底将“大模型”与“加速模块”进行了解耦。
- 做法: 主模型(如 1.6 万亿参数的 DeepSeek-V4-Pro)权重完全冻结(Freeze)。DSpark 作为一个外挂式的轻量推理模块组合上去。
- 优势: 它可以利用 DSpark 的算法和训练代码,为任何现成的模型(包括 Qwen3、Gemma 等)在几天内低成本训练出一个专属的“手速极快”的草稿头。
2.3.2、 DSpark 的三大核心技术原理
投机解码并不是新概念,但过去的方案(例如传统的“大模型 + 小模型”或纯并行 DFlash)在线上高并发服务中往往会遇到两个灾难:草稿模型越往后猜越不准(后缀衰减),以及高并发下无效验证导致服务器卡死。
DSpark 通过以下三个环环相扣的技术原理解决了这些工程顽疾:
- 半自回归生成(Semi-Autoregressive Generation)
这是 DSpark 最核心的数学与算法创新。传统的草稿模型生成有两种思路:
- 并行路线(如 DFlash): 一次性把未来 6 个位置的词全部并排打出来。快是极快(只需一次前向传播),但因为 token 之间缺乏前后条件概率约束,一旦第 1 个词选歪了,后面 5 个词会瞬间塌方(接受率急剧下降)。
- 自回归路线(如 Eagle 3): 串行生成。每猜一个词都要走一遍轻量循环,延迟随着你想猜测的长度呈线性增加。
DSpark 的解法(取两者之长):
它先利用一个并行的骨干网络,一次性提取出未来多个位置的“候选隐藏特征(Hidden Features)”,这一步解决了计算延迟。接着,它在特征层之上叠加了一个极轻量、仅 1~2 层的马尔可夫串行头(Markov Head)。后一个位置的预测头能够“瞥一眼”前一个位置刚刚选了什么词。
- 置信度预测头(Confidence Head)
如果草稿模型对后面几个字的把握非常低,大模型在验证时就会直接把它们拒绝掉,造成大模型算力的浪费。
DSpark 在草稿网络中引入了置信度评估。在生成草稿的瞬间,会为每一个预测出的 token 实时计算一个“生存概率(Survival Probability)”(例如:Token 1 预测信心 95%,Token 4 信心 10%)。这个评分会直接传给底层的调度引擎。
- 异步、硬件感知的置信度调度验证(Confidence-Scheduled Verification)
大模型线上服务最怕“突发大流量”。如果服务器快满载了,框架还在盲目让大模型去验证长达 10 个 token 的草稿,一旦验证失败,服务器会雪上加霜。DSpark 在 vLLM / SGLang 等引擎中实现了异步的、根据系统负载(Server Load)动态截断验证长度的调度器:
- 低负载 / 单用户时: 算力充裕。调度器会放宽限制,即使置信度只有 40% 的草稿也送去给大模型验证。赌对了就是赚,最大化降低用户的单次响应延迟。
- 高负载 / 高并发时: 显存带宽和算力极度紧张。调度器会立刻收紧策略,只允许置信度极高(如 >90%)的草稿 token 进入大模型验证队列。对于低置信度的部分直接在线上砍掉,从而维持系统整体的超高吞吐量(Throughput),防止服务卡死。
2.3.3、 DSpark 的实际生产成效与产业意义
在 DeepSeek-V4 系列模型中,DSpark 的加入让用户端到端的生成速度(Per-user Generation Speed)直接无损提升了 60% 到 85%。
更重要的是,DeepSeek 在硬件供应受限的大环境下,证明了纯软件和算法架构的重构,可以产生不亚于甚至超越购买更贵、更多 GPU 所带来的推理性能红利。这种不改动主模型智商、全栈开源(MIT 协议)且支持多模型生态(DeepSpec 仓)的打法,正在极大地重塑当前大模型工业界落地与部署的成本结构。
2.4、自投机与层级跳跃(Self-Speculative / Layer Skip)
这一路线坚信“解铃还须系铃人”,不外挂任何额外的网络头,而是压榨大模型自身的冗余度。当然广义上说早起的引入外挂大模型的手段也属于这个范畴,也是依靠外部或残血自回归来生成草稿”的思路,只是它用的是一个独立的小模型(例如用 Llama-7B 给 Llama-70B 做草稿)。
- 技术原理:
一个 80 层的超大模型,在推理时被动态拆成了两个状态:
- 残血状态(草稿阶段): 比如直接跳过中间的 70 层,只跑第 1 到第 5 层,再直接连到最后一层。用这个极其粗糙、但跑得极快的“残血大模型”去自回归盲猜后面的多个 Token。
- 满血状态(验证阶段): 把盲猜出的序列送入完整的 80 层网络进行一次性并行验证。
- 代表方案: Draft-and-Verify、Self-Speculative Decoding。
- 优缺点:
优点:极其纯粹,不需要训练任何额外的模型或外挂头,显存里只需要存一份模型权重。
缺点:浅层网络提炼出的草稿质量相对不稳定,提速比上限通常不如专门训练过外挂模块的 DSpark 方案。
2.5、广义 MTP 的技术光谱
如果我们将这四种技术手段放在一个光谱上:
◄───────────────────────────────────────────────────────────────────────────►
 纯训练期融合                                                     纯推理期外挂
 (手段一: 原生MTP) ──► (手段四: 自投机) ──► (手段三: 半自回归/DSpark) ──► (手段二: 纯并行DFlash)
 智商加持/规划力强                                                纯粹工程压榨/弹性调度
 改造昂贵、长度固定                                               低成本适配、高并发鲁棒
当前工业界落地的最前沿共识是:手段一(原生 MTP 联合训练) 适合拥有顶级算力的大厂在预训练阶段用来提升模型的“原生智商与规划能力”;而 手段三(以 DSpark 为代表的半自回归投机解码) 则因为其极高的解耦部署灵活性和惊人的无损提速比,成为了目前全行业在推理落地时的绝对主流手段。
更多推荐


 12
 0
- 0


 已为社区贡献1条内容

所有评论(0)