
数据仓库有没有前途?先看看我们这代人是靠什么扛过来的
大家好,我是小马哥,一个沪漂十余年的数据从业者,一个愿意分享的普通人 ,下面是我的简介:
从DB2到AI时代,什么变了,什么没变?

后台常收到这样的问题:"小马哥,数仓开发面试造航母,入职拧螺丝,这落差怎么破?"
说实话,这个问题我十年前就想问。那时候刚从Oracle切到Hadoop,看着满屏的MapReduce报错,我也怀疑过这行是不是在"过度包装"。
现在回头看,那些年被问烂的八股文、踩过的坑、熬过的夜,恰恰构成了我们这代人的护城河。

面试为什么爱"造航母"?
面试官不是在炫技。数据仓库连接的是从 raw data 到 business value 的完整链路,任何一个环节崩了,你都得知道是螺丝松了还是引擎炸了。
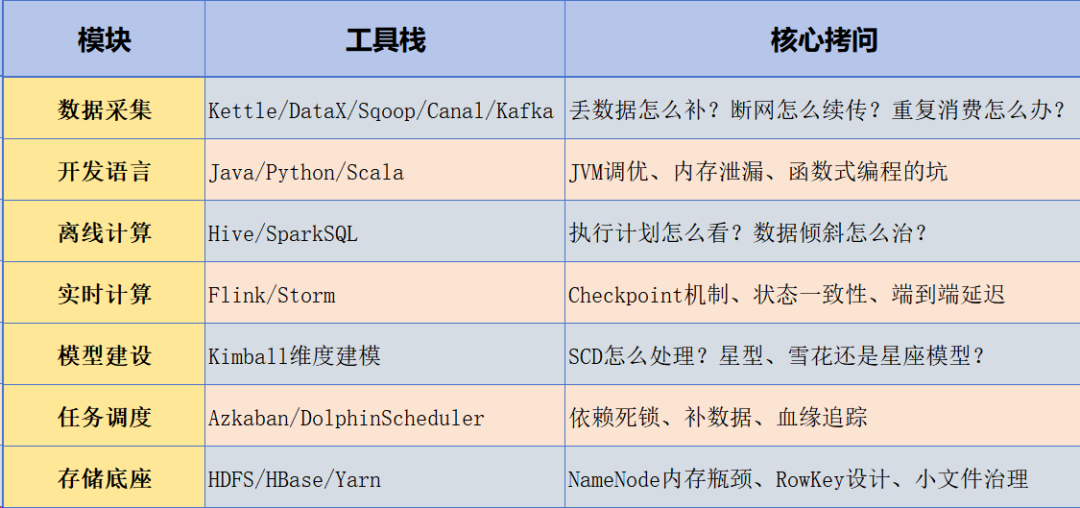
我把这套体系拆成当年面试必考的七个模块——

"拧螺丝"的两种境界
入职后你会发现,日常确实是写SQL、调任务、做Excel。但同样是拧螺丝——
新手:报错→百度→改代码→再报错→喊人救火。把搜索引擎当IDE用,离开网络就抓瞎。
老手:慢SQL先看执行计划,确认是数据倾斜还是Join顺序问题;任务挂了先看血缘,判断是重跑还是修数;设计表的时候就想好,下游分析师会不会骂娘。
区别在哪?前者知道"怎么让它跑起来",后者知道"为什么它能跑起来"。
那个凌晨三点被叫起来修HBase Region分裂的人,那个能一眼看出Spark UI里哪个Stage卡了80%时间的人,那个能在业务改需求前就预判到数据回溯范围的人——这些都是"懂航母"的螺丝工。

我们这代人坐过的"船"
2008-2012:关系型数据库时代
DB2、Oracle统治一切。几千万行的表就要考虑分区策略,存储过程跑一天是常态。印象最深的是某次核心库挂了,DBA大哥一边恢复一边骂娘,我在旁边递咖啡。那时候明白一个道理:数据这行,不出事是本分,出了事能兜底才是本事。
2012-2016:MPP与OLAP崛起
Greenplum、Doris进场。几十个节点并行计算确实爽,但"数据倾斜"成了新噩梦——100个节点里99个在看戏,1个在拼命。那时候调优的核心技能是:怎么让数据均匀分布,以及怎么在节点挂掉时不丢数据。
2016-2020:Hadoop生态黄金期
HDFS+Hive+Yarn+HBase成为标准组合。数据量从TB到PB,集群规模从几台到几百台。Hive跑批、HBase扛实时、HDFS统一存储——这套架构支撑了移动互联网的数据爆炸。
也是这个时期,"大数据工程师"成为热门岗位,我们这代人完成了从DBA到大数据开发的转型。
2020至今:AI重构一切
ChatGPT、大模型、AIGC轮番轰炸。大家问得最多的变成:"小马哥,这行会不会被AI取代?"
我的答案一直没变:工具会迭代,但"用数据解决问题"的内核不会死。
以前数据脏,我们写清洗规则;现在数据还是脏,只是多了AI生成的"更脏的数据"。以前业务逻辑复杂,我们啃需求文档;现在业务逻辑更复杂,因为AI又创造了一堆新场景。
能搞定脏数据和复杂业务的人,永远有饭吃。

AI普及前,数仓人的三条出路
回头看,2015-2020年那批人的选择,基本决定了今天的位置:
纵深:成为"兜底"的人
深耕性能调优、稳定性保障、架构设计。别人搞不定的数据倾斜、内存溢出、集群扩容,最后都到你这儿。这条路孤独,但不可替代性极强。
横向:从"取数"到"解数"
转数据分析、商业智能。不再问"你要什么数",而是问"你要解决什么问题"。离业务越近,价值越显性,但也意味着要背业务指标。
跨界:算法工程化
转推荐系统、用户画像、风控模型。数仓背景的优势是懂数据分布和清洗,模型上线后不容易出现"训练集AUC 0.95,线上效果崩盘"的尴尬。
关于"ETL会不会被自动化取代"
十年前就在讨论,现在还在讨论。结论是:简单的ETL确实在被工具化,但"设计数据流转规则、处理异常、为数据质量负责"这部分,机器干不了。

写在最后
那个AI还没普及的年代,我们操心的事很具体:凌晨的批任务有没有跑完、HBase的Region是不是又分裂了、业务方今天又要什么新指标。
现在AI来了,操心的事变了,但底层逻辑没变——数据还是那么脏,业务还是那么复杂,能搞定这些的人,依然稀缺。
变的只是工具链。以前靠经验、手熟、踩坑的血泪史;以后还得学会让AI干重复的活儿,自己腾出手来做更有价值的事。
从DB2到Oracle,从Greenplum到Doris,从Hadoop生态到现在,我数据我快乐——这句话的含金量,还在上升。
👇点个关注,咱们不走散,下期见 👋

更多推荐

 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)