
阿里最新开源的FunASR如何可以做到区分说话人并且知道对应是谁说的 | 通话录音质检中如何确定客服和客户 | 通话录音转写 | FunASR的docker版本中是否支持区分说话人
1. 研究背景
在做单声道通话录音质检的时候,我们往往需要知道哪些是客服讲的哪些是客户讲的。如果单纯使用阿里开源的FunASR可以做到区分说话人,但是不能知道这个说话人是谁,这是一个比较棘手的问题。
我们做外呼系统开发的时候,有一个叫做话术的功能模块,客服可以做后台设置一些话术,然后机器人根据用户的问题,回复不同的话术,或者是真人客服回复话术。那么我们就可以结合当前流行的大模型来实现分析谁是客服谁是客户,这里全部采用本地化部署方案,并非调用云端的API接口。并且该技术方案,不需要提前注册客服的声纹到系统,这套系统主要利用向量大模型做语义理解,让大模型分析谁是客服谁是客户,不需要提前注册客服声音。
2. 技术规划
ASR --> 转写生成带时间戳和区分讲话人的文字内容 --> 合并相同相邻讲话人,减少计算量 --> 每个spk对应的每句内容传递给LLM大模型,进行文本分析 --> 得出客服和客户对应的spk
3. 代码实现
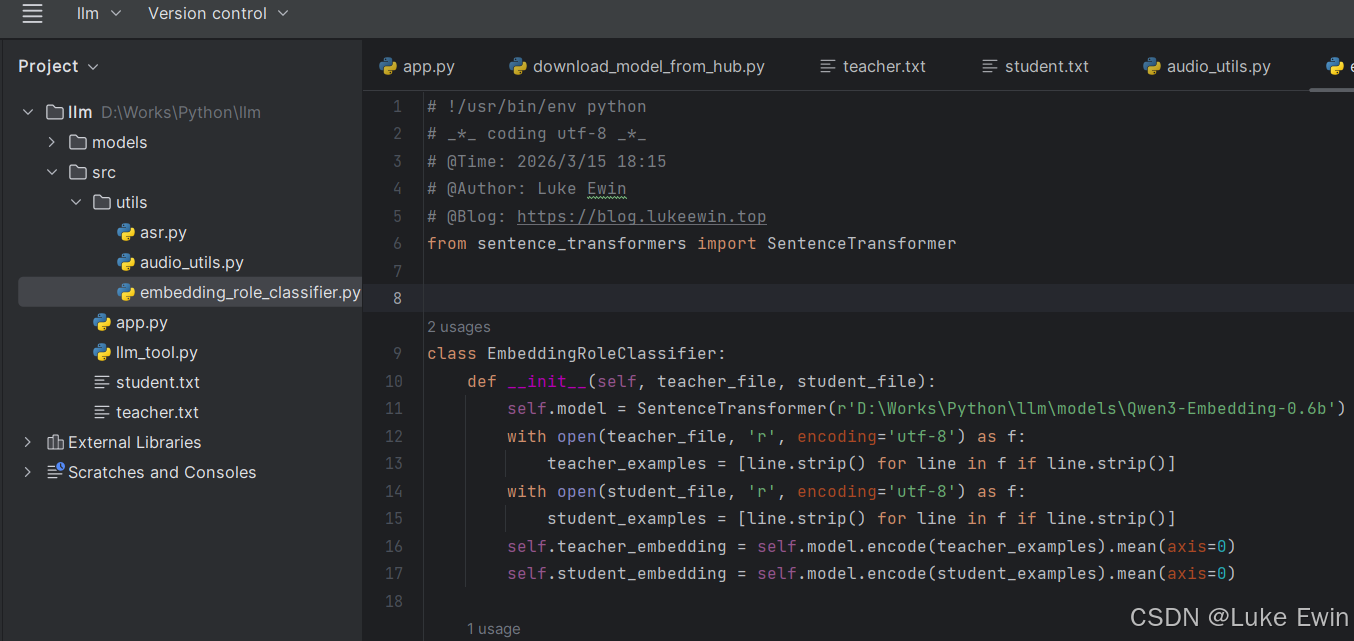
这是之前写区分老师和学生的,所以你看到图片中是teacher和student,你可以修改为其它的,这里认为teacher就是客服,student就是客户。上面的是定义这个大模型,并且加载客服话术和客户常用语,并且计算文本向量,用于后续就行向量对比。
整体代码如下:
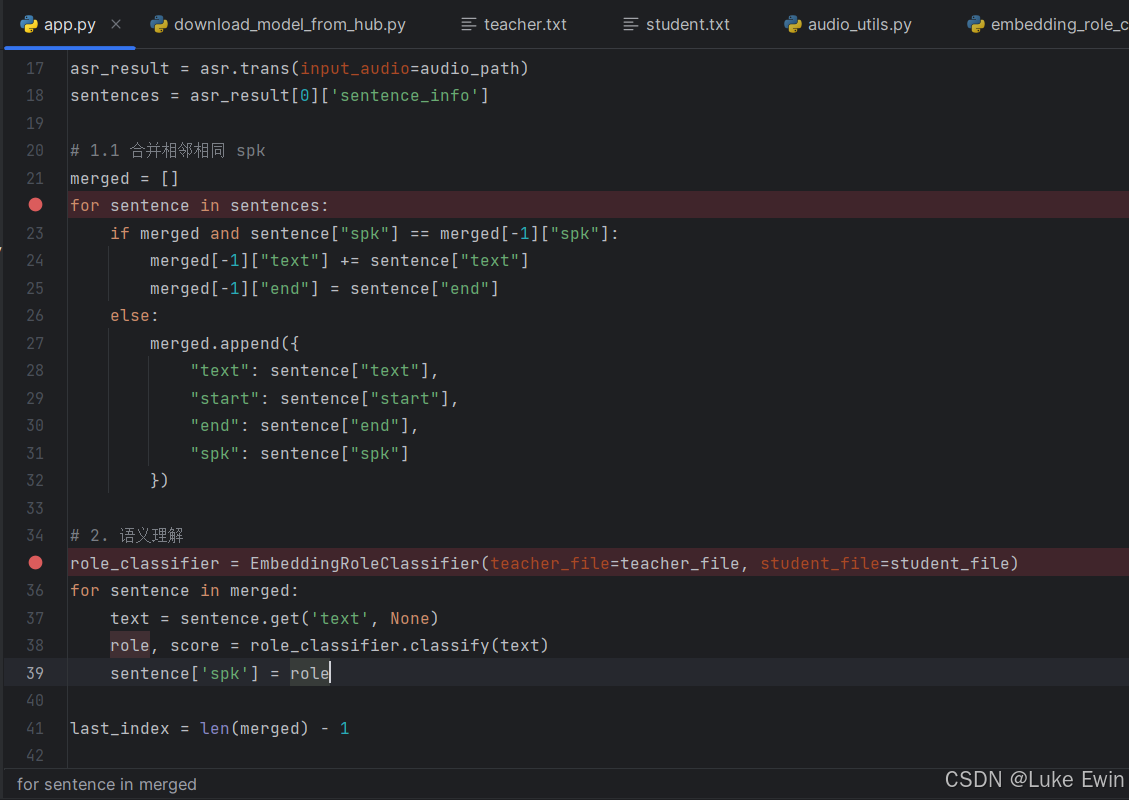
这里先对ASR输出的结果进行合并相同相邻讲话人的操作,这里可以减少后面计算文本向量的次数,提升系统的整体执行速度。
4. 问题答案
问题1:为啥我用的FunASR不能区分说话人?
答案1:你可能没有加入cam++模型,可以使用spk_model="cam++"来加入这个区分说话人模型。
问题2:FunASR代码仓库里提供的docker版本如何支持区分说话人?
答案2:如需支持区分说话人,可以用Python版本的,docker版本是C++开发的,FunASR的C++版本不支持区分说话人,你也可以自己修改代码集成进去。
问题3:为啥我用的FunASR内存一直在增加?
答案3:如果你用的docker版本,并且是很久之前的版本,那是存在内存泄露问题,你可以更新到最新的镜像。如果你使用的是python版本,那就不清楚了,目前我这边还没出现这情况,已经在生产环境中运行了很长时间,内存并没有一直增加。
5. 其它
点击这里观看视频教程
博客
公众号:编程分享录
更多内容欢迎关注我的博客
更多推荐


 8
 0
- 0


 已为社区贡献4条内容

所有评论(0)