
大数据运维 | 项目一:大数据分布式集群搭建全攻略
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。
前言
作为一名大数据运维工程师,你是否遇到过这样的问题:
| 问题 | 场景描述 |
|---|---|
| 1 | 机器A可正常上网,但机器B无法连接网络? |
| 2 | 机器A能访问机器B,但机器B无法访问机器A? |
| 3 | 如何批量修改100台设备的相同配置参数? |
| 4 | 使用IP地址可正常访问,但通过主机名无法访问? |
| 5 | 机器A发送数据至机器B,但机器B未收到? |
这些都是大数据集群运维中经常遇到的网络与通信问题。而"大数据运维师"的职责,就是在集群出现无数问题的情况下,保证业务不停机、正常运转。
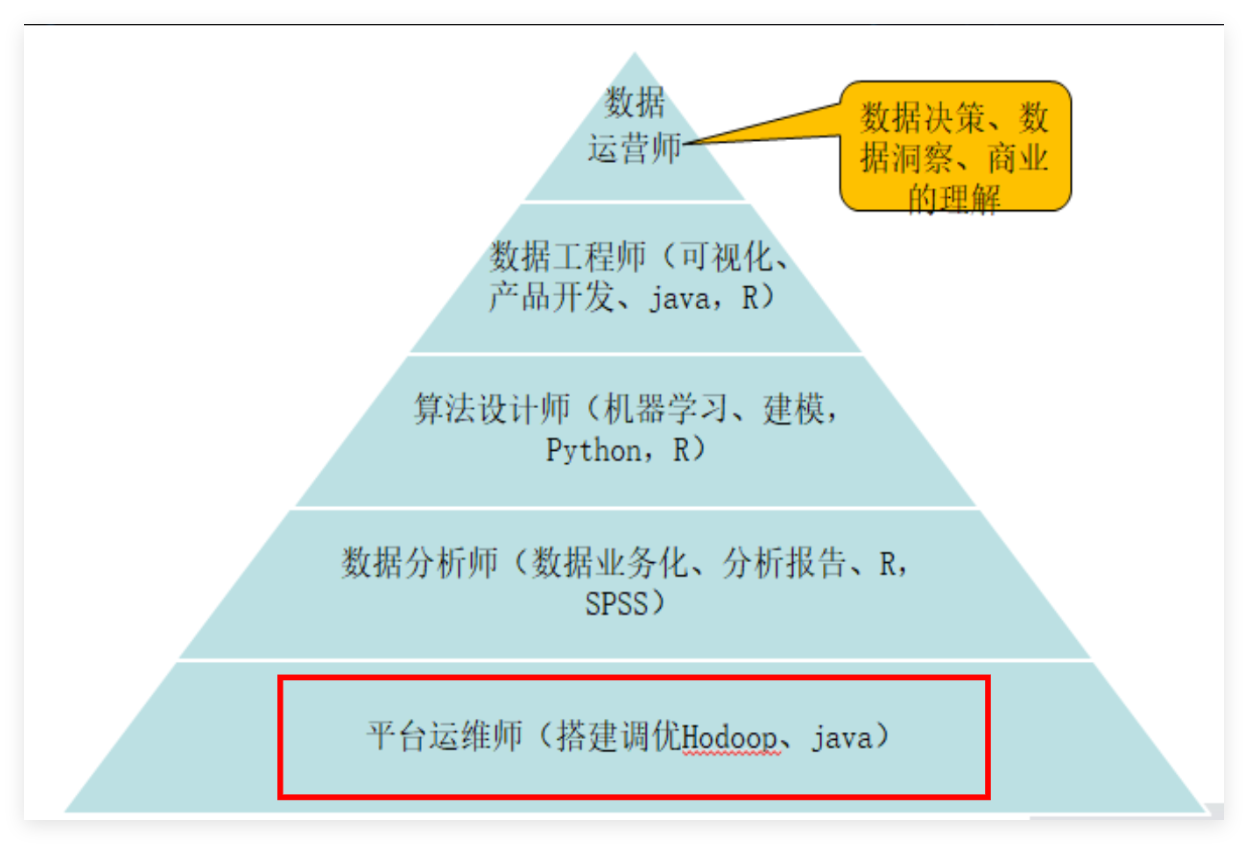
图1 运维师职责
本文将带你系统学习大数据分布式集群的搭建全过程,从技术回顾到环境规划,再到Windows环境下Linux仿真工具的使用,一步步帮你建立完整的集群部署知识体系。
一、大数据技术回顾
1. 谷歌三驾马车
谷歌在大数据领域的三大核心技术,奠定了现代大数据技术的基础:
-
GFS(Google File System) → HDFS:分布式文件系统
-
MapReduce:分布式计算框架
-
BigTable → HBase:分布式数据库
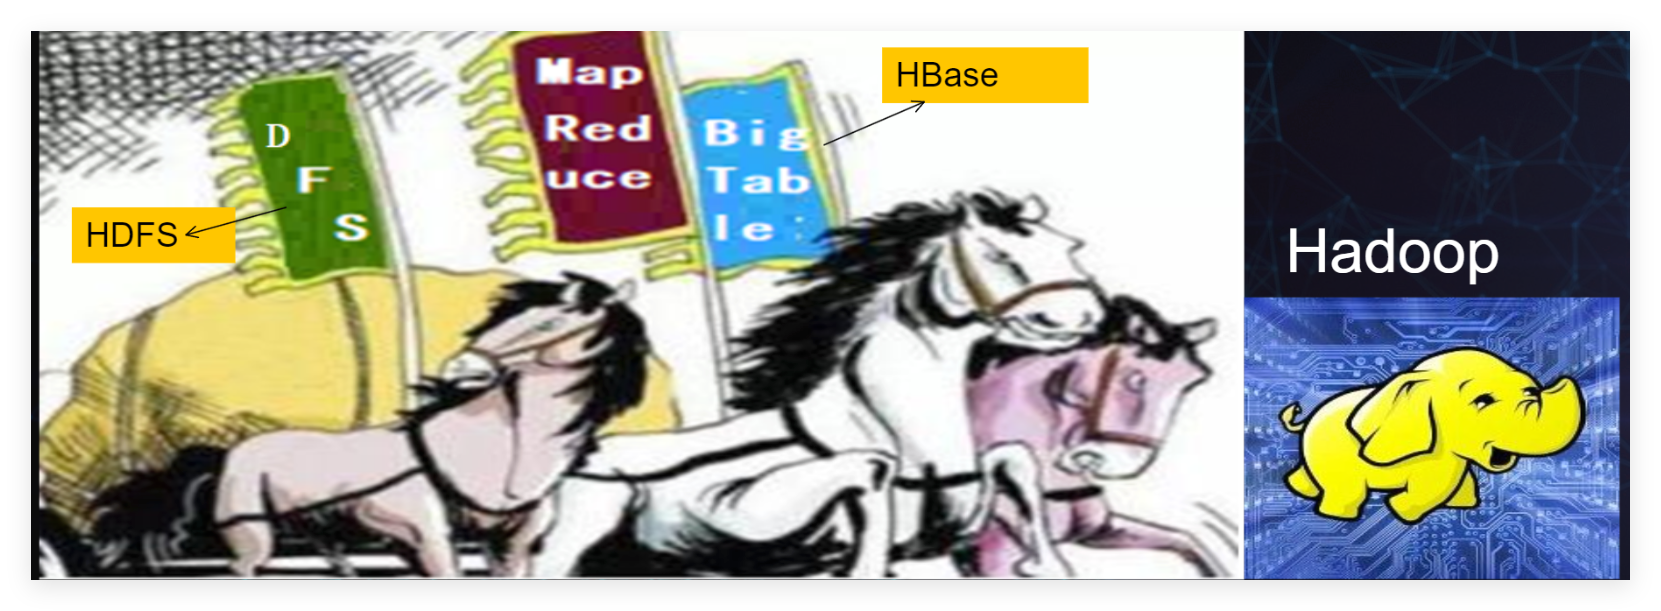
图2 谷歌三驾马车
2. 什么是Hadoop
Hadoop是由Apache基金会开发的分布式系统基础架构,由Doug Cutting创建。它主要包含两大核心模块:
| 模块 | 全称 | 功能描述 |
|---|---|---|
| HDFS | Hadoop分布式文件系统 | 提供分布式存储服务 |
| MapReduce | - | 实现分布式计算处理 |
3. Hadoop生态系统
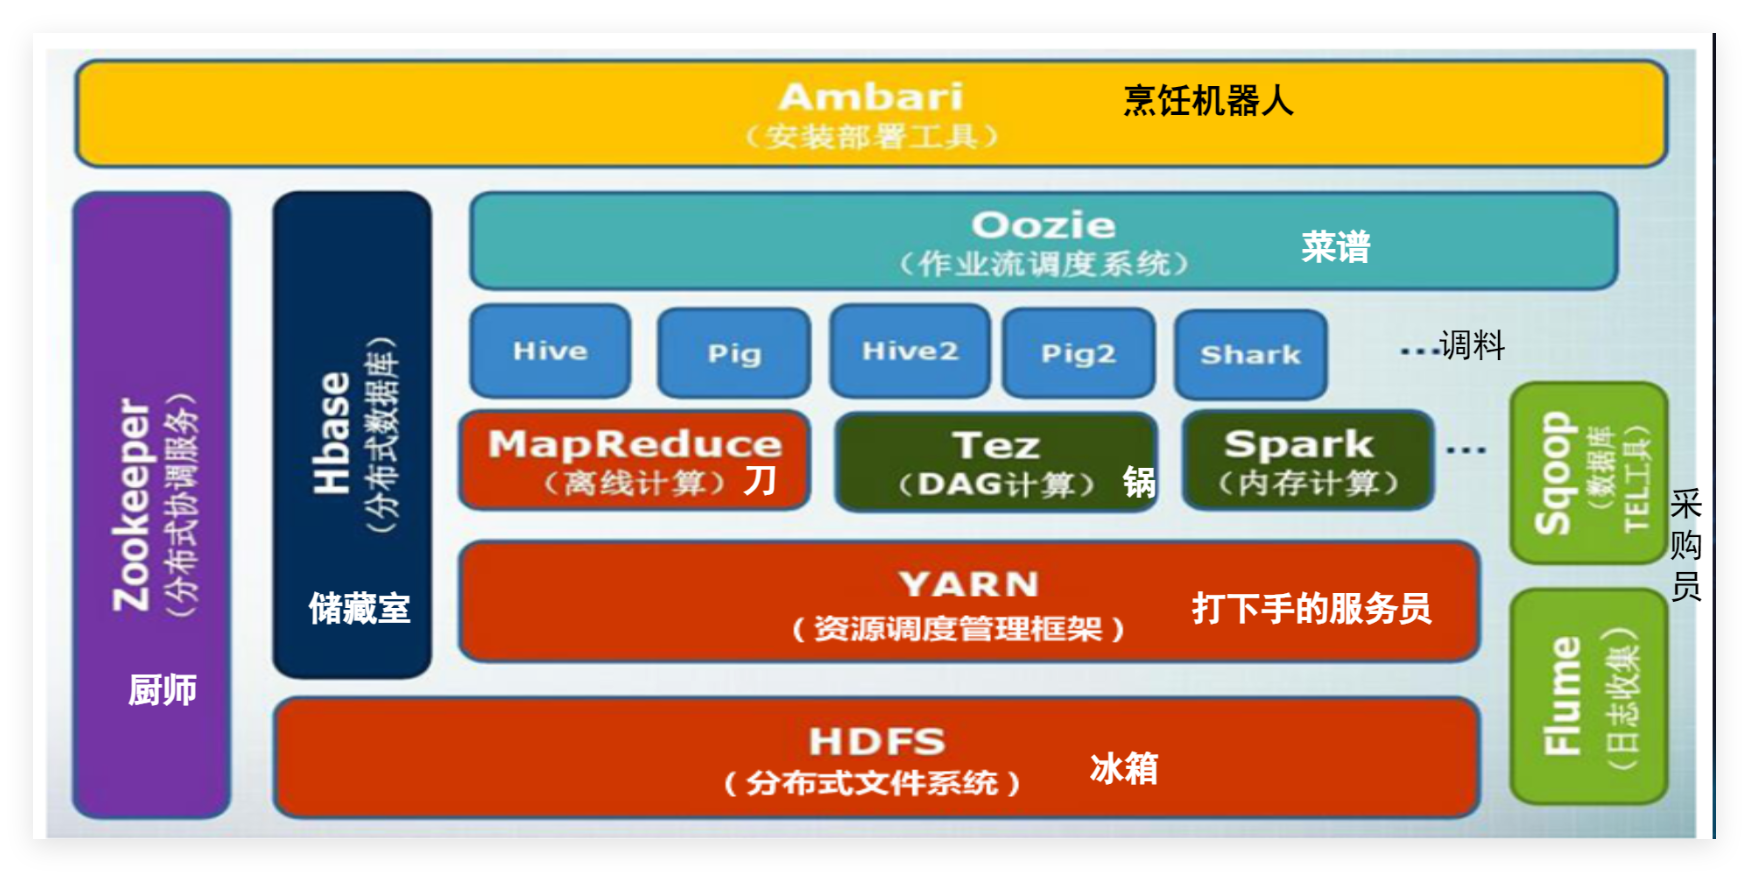
图3 Hadoop生态系统
围绕Hadoop,衍生出了丰富的生态组件:
| 组件 | 版本(参考) | 说明 |
|---|---|---|
| JDK | 1.8 | 基础运行环境,Hadoop基于Java开发 |
| Hadoop | 2.7.2 | 分布式计算框架核心组件 |
| Flume | 1.7.0 | 日志数据采集与传输工具 |
| Hive | 2.2.0 | 数据仓库解决方案 |
| HBase | 1.2.6 | 分布式列式数据库 |
| Sqoop | 1.4.6 | 结构化数据迁移工具 |
| ZooKeeper | 3.4.6 | 分布式系统协调服务 |
| MySQL | 5.7.12 | 关系型数据库存储 |
⚠️ 注意:SQL Server等关系型数据库不是Hadoop集群必需的软件。
4. Hadoop应用场景
-
海量数据存储与处理
-
日志分析
-
推荐系统
-
用户行为分析
-
数据仓库建设
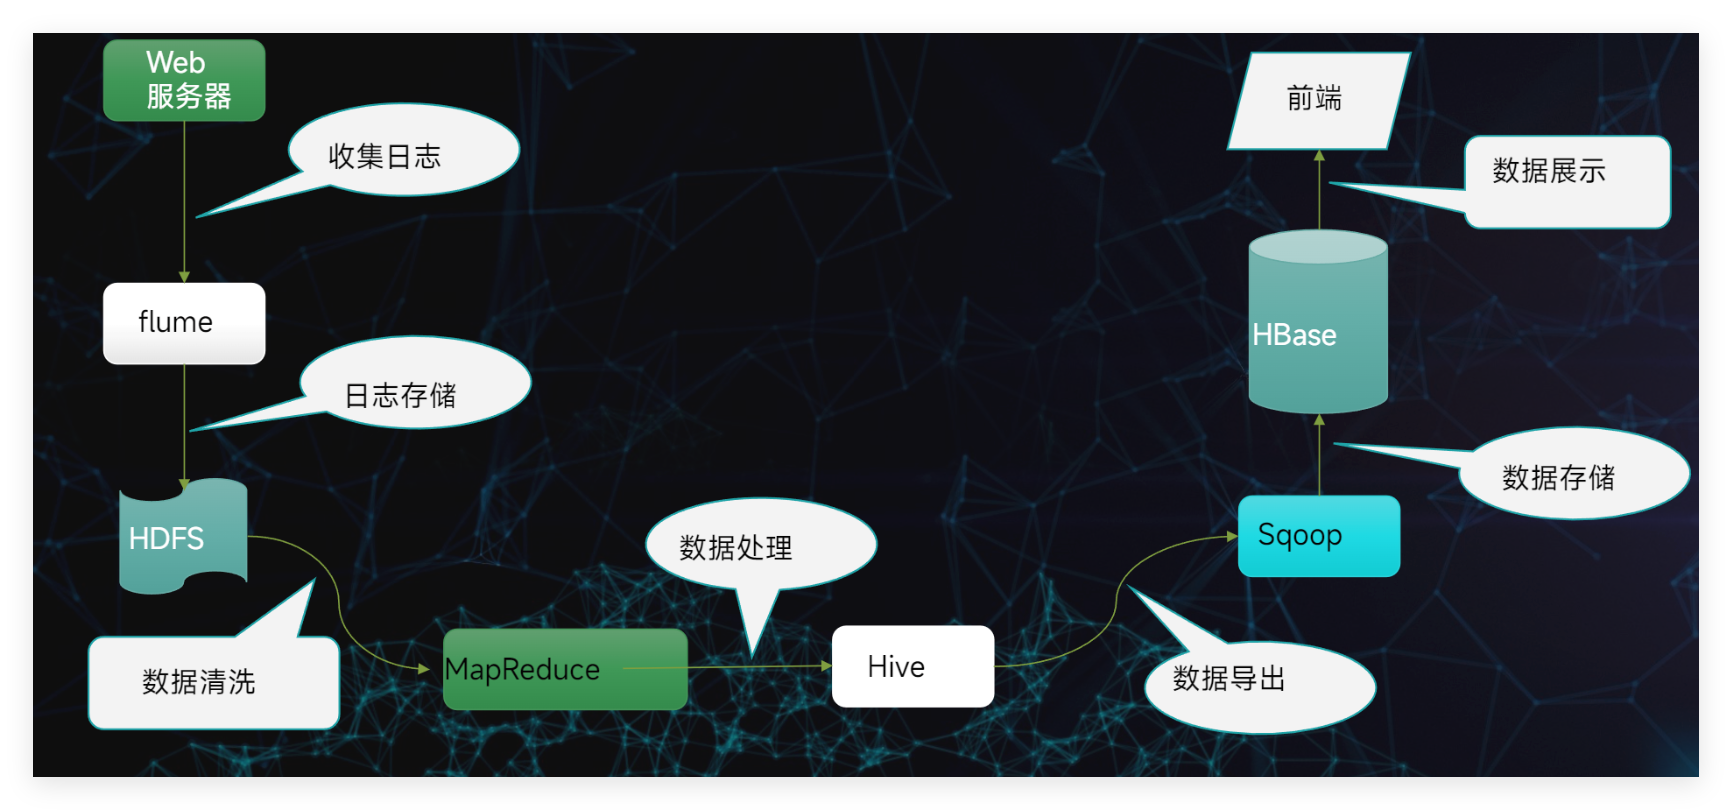
图4 Hadoop应用场景
二、分布式大数据集群规划
1. 为什么要做集群规划?
Hadoop分布式集群环境搭建是每个入门级新手都非常头疼的事情。你可能花费很久的时间搭建运行环境,最终却因某个小问题无法创建成功。
因此,在正式开始搭建集群前做好集群规划是很有必要的。
2. 集群规划内容
(1)集群拓扑规划
采用经典的 master/slave 架构模式: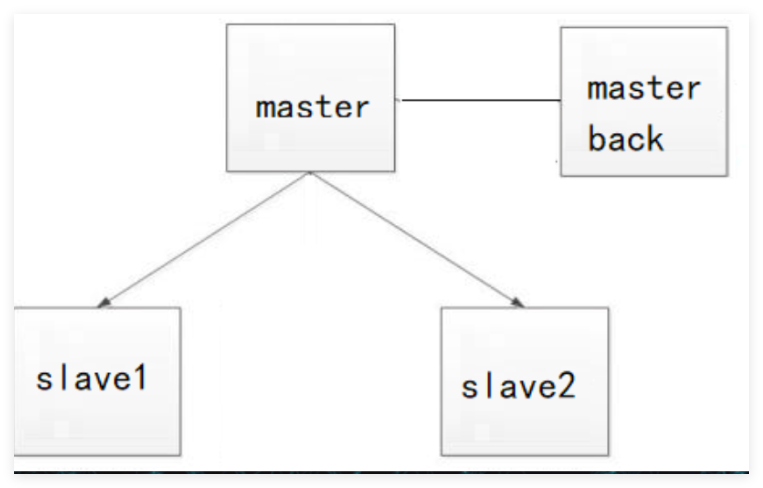
图5 集群拓扑规划
任务示例:用4台主机搭建Hadoop 2.0集群
表格
| 主机名 | 角色 | IP地址 |
|---|---|---|
| master | Master节点 | 172.16.206.16 |
| masterback | 备用Master | 172.16.206.26 |
| slave1 | Slave节点 | 172.16.206.27 |
| slave2 | Slave节点 | 172.16.206.29 |
(2)主机规划
-
确定集群规模(节点数量)
-
确定各节点硬件配置(CPU、内存、磁盘)
-
确定操作系统版本(如CentOS 6.6/7.x)
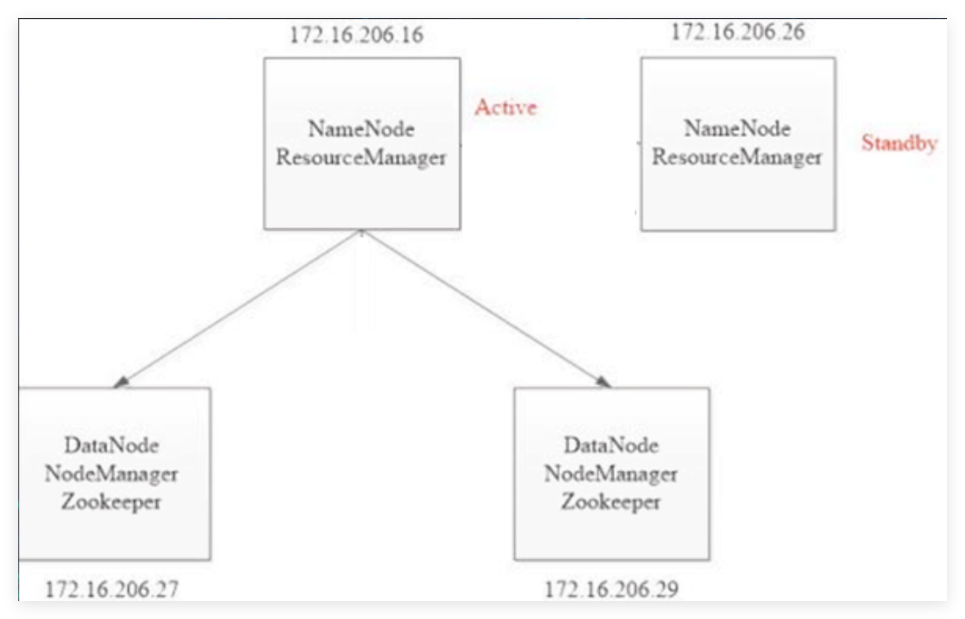
图6 主机规划
(3)软件规划
表格
| 软件 | 版本建议 | 作用 |
|---|---|---|
| JDK | 1.8+ | Java运行环境 |
| Hadoop | 2.7.x / 3.x | 分布式计算框架 |
| ZooKeeper | 3.4.x | 分布式协调服务(可选) |
(4)数据目录规划
建议统一规划数据存储目录:
bash
复制
/opt/modules/          # 软件安装目录
/opt/data/             # 数据存储目录
/opt/logs/             # 日志目录
/opt/scripts/          # 脚本目录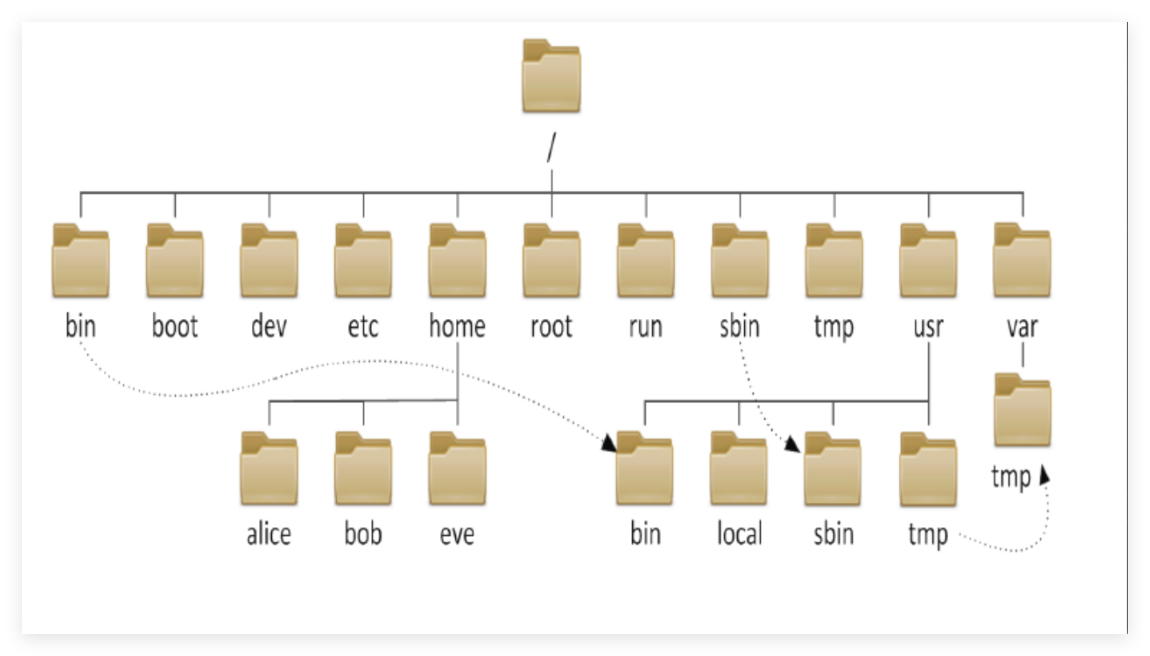
图7 数据目录规划
(5)Hosts文件配置
位置:/etc/hosts
作用:建立IP地址与主机名之间的映射,实现快速方便的访问。
配置方法:
bash
复制
[root@hadoop1 ~]# vi /etc/hosts添加如下内容:
bash
复制
172.16.206.16   master
172.16.206.26   masterback
172.16.206.27   slave1
172.16.206.29   slave2
三、Windows环境下Linux仿真工具
在Windows环境下搭建大数据集群,需要用到以下三个核心工具:
1. VMware Workstation Pro
功能:桌面虚拟计算机软件,可在一台实体机器上模拟完整的网络环境,同时运行多个不同的操作系统。
主要特点:
-
✅ 支持虚拟网络配置
-
✅ 实时快照功能
-
✅ 拖曳共享文件夹
-
✅ 支持PXE网络引导
下载与安装:
-
官方试用版:http://www.vmware.com/cn/products/workstation/workstation-evaluation.htm
-
许可证密钥示例:
5A02H-AU243-TZJ49-GTC7K-3C61N
创建虚拟机步骤:
-
打开VMware Workstation,点击"创建新的虚拟机"
-
选择"典型"或"自定义"配置
-
选择"稍后安装操作系统"
-
选择操作系统类型(Linux → CentOS 6/7)
-
设置虚拟机名称和存储位置
-
分配磁盘容量(建议20GB以上)
-
完成创建
安装Linux操作系统:
-
选中创建的虚拟机,双击光驱设备
-
选择"使用ISO映像文件",加载CentOS镜像
-
开启虚拟机,迅速勾选"已连接"和"启动时连接"
-
进入Linux图形安装界面
-
设置root密码(如:123456)
-
完成安装并重启
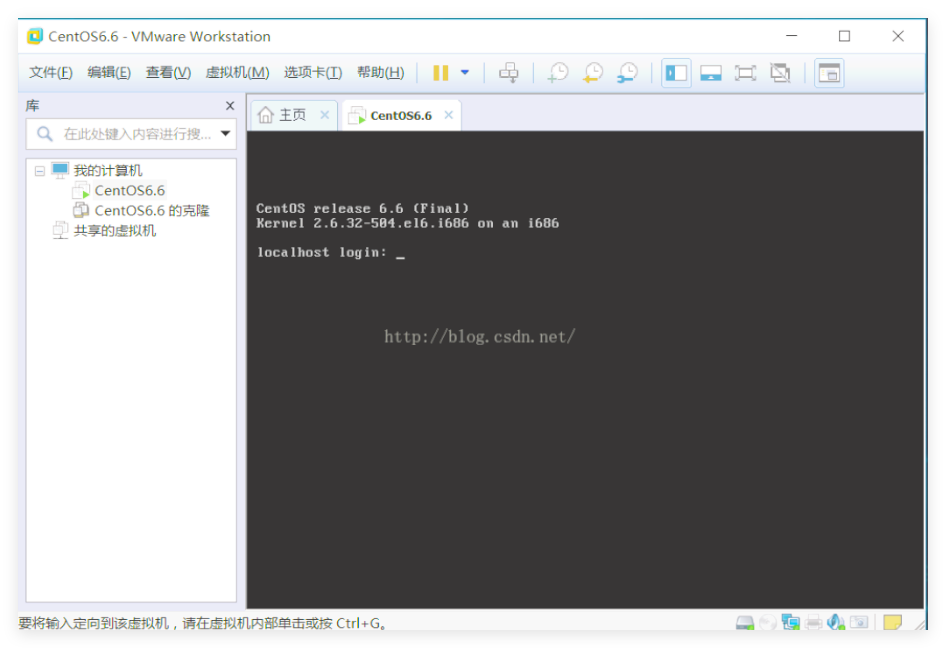
图8 安装Linux操作系统
2. SecureCRT
功能:支持SSH2、SSH1、Telnet、Serial等多种协议的终端仿真程序,用于Windows下登录Linux服务器。
核心特性:
-
标签化SSH对话,方便管理多个连接
-
丰富的设置选项
-
美化终端主题
创建Session步骤:
-
点击
File → Connect -
在Connect窗口中创建Sessions目录(如:linux)
-
新建Session,输入服务器IP和用户名
-
保存配置,双击连接
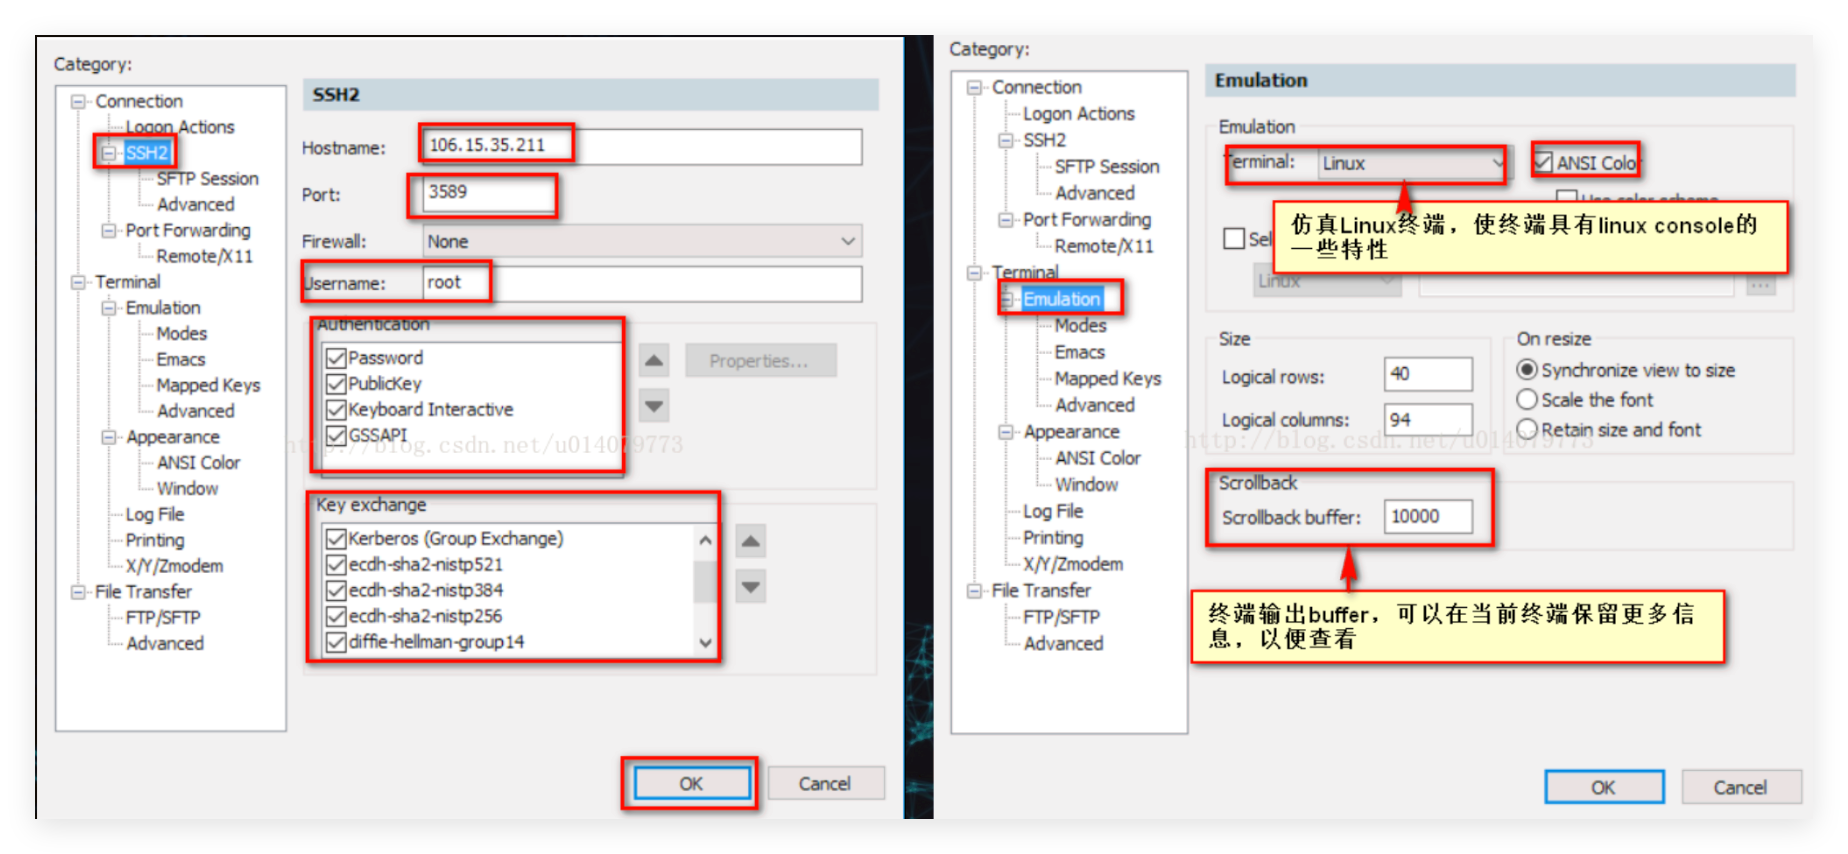
图9 创建Session
常用快捷键:
表格
| 快捷键 | 功能 |
|---|---|
| 鼠标左键选中 | 复制选中内容 |
| 鼠标右键 | 粘贴剪贴板内容 |
Alt + Enter | 全屏 |
Alt + P | 调出sftp窗口 |
Ctrl + F4 | 关闭当前session |
Alt + F4 | 关闭SecureCRT软件 |
Alt + C | 打开连接标签 |
3. SecureFX
功能:安全的文件传输工具,支持拖拽操作,实现Windows与Linux之间的文件传输。
使用方法:
-
打开SecureFX,在Session Manager中选择要连接的服务器
-
点击"Connect File Transfer"
-
输入用户名和密码
-
连接成功后,即可进行文件拖拽传输
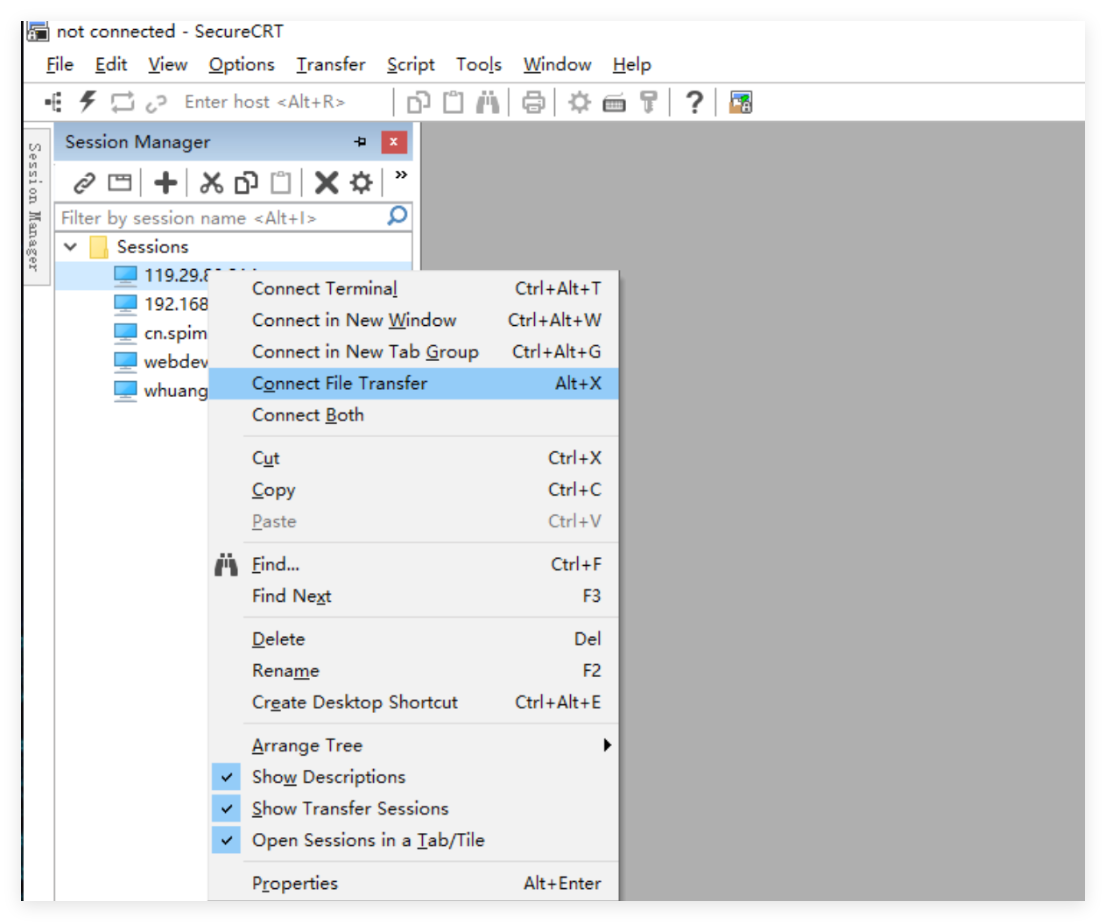
图10 SecureFX
四、常见问题速查
表格
| 问题现象 | 可能原因 | 解决方法 |
|---|---|---|
| A能上网,B不能上网 | 网络配置不一致 | 检查B的网络适配器设置和IP配置 |
| A能访问B,反之不行 | 防火墙或网络策略限制 | 检查防火墙规则,关闭或配置允许访问 |
| 100台机器修改同一参数 | 批量管理需求 | 使用脚本工具(如ansible、pssh)批量操作 |
| IP可访问,主机名不可访问 | hosts文件未配置 | 检查/etc/hosts文件,添加IP-主机名映射 |
| A发信息B未收到 | 网络不通或服务未启动 | 检查网络连通性、防火墙、服务状态 |
结语
大数据分布式集群的搭建是一个系统性工程,从环境规划到工具使用,每一步都需要细心和耐心。本文从理论到实践,从规划到操作,全面介绍了集群搭建的核心知识点。
更多推荐


 9
 0
- 0


 已为社区贡献4条内容

所有评论(0)