
【AI大模型入门】A02:BERT——让机器真正“读懂“语言的里程碑
【AI大模型入门】A02:BERT——让机器真正"读懂"语言的里程碑
📖 阅读时长:约8分钟
🎯 适合人群:想了解AI如何理解语言的入门者
💡 你将学到:BERT是什么、它和GPT有什么本质区别、它在现实中用在哪里
一、BERT 出现之前,AI"读"语言是什么样的?
2018年之前,AI处理语言的方式有个致命问题:它只看单方向。
比如要理解"苹果"这个词,AI只看它左边的词,或者只看它右边的词,但不能同时考虑两侧的上下文。
这就好比:你遮住一本书的右半页,只看左半页来理解故事,效果可想而知。
二、BERT 是什么?
BERT = Bidirectional Encoder Representations from Transformers
(来自Transformer的双向编码器表示)
2018年10月,Google 发布了BERT,核心创新就在那个词:Bidirectional(双向)。
📄 原始论文:BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding(Devlin et al., 2018)
📄 论文解读专栏:敬请期待 《BERT原论文解读》
单向理解(以前):
← 从左到右:我 喜欢 [吃] 苹果和 ...
→ 从右到左:... 香蕉 还有 苹果 [吃] 喜欢

双向理解(BERT):
← 我 喜欢 [吃] 苹果 和 香蕉 →
    ↑       ↑           ↑
  同时看到左边上下文和右边上下文
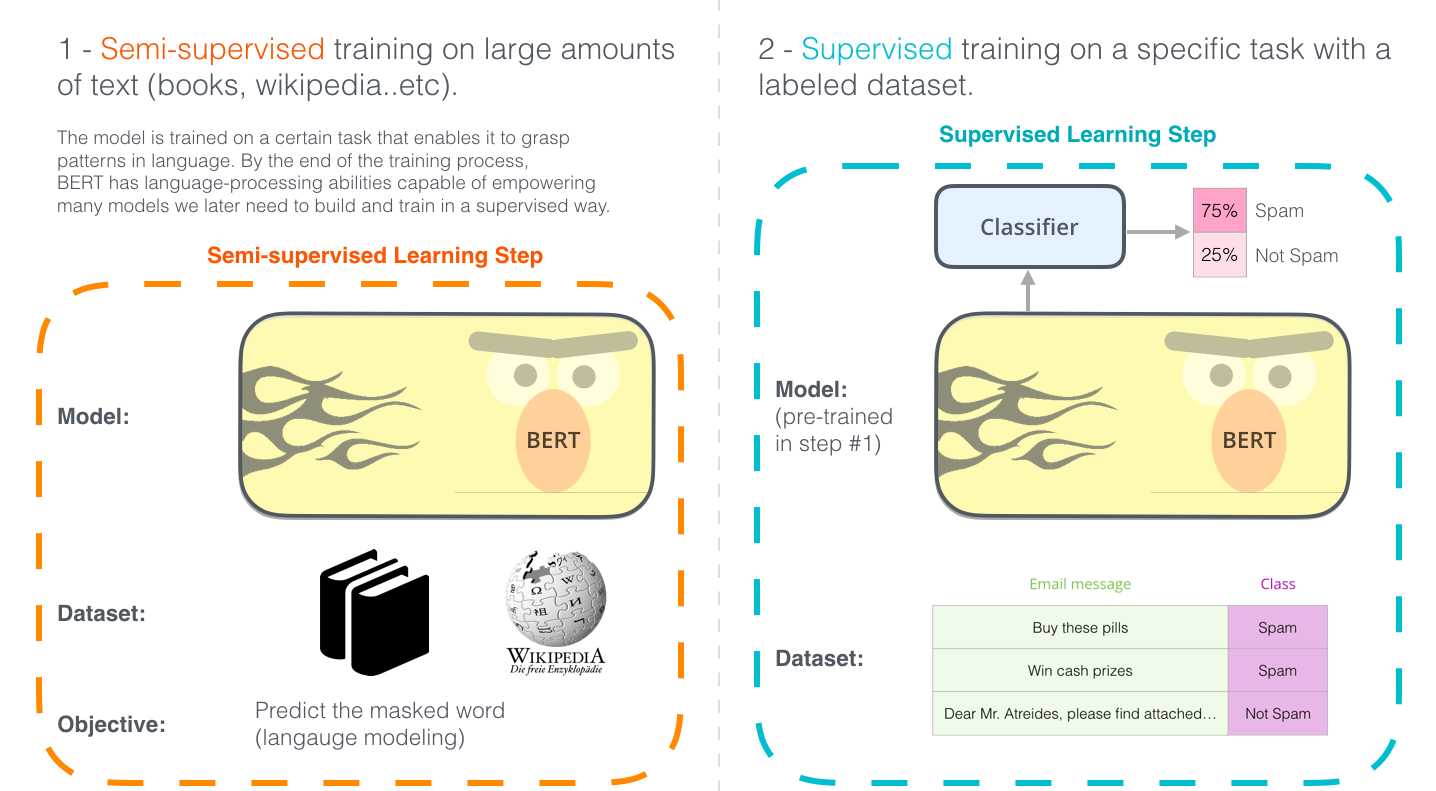
▲ 图1:BERT 的预训练(Pre-training)与微调(Fine-tuning)流程。左侧为预训练阶段(用海量无标注文本),右侧为针对不同任务的微调阶段。来源:论文图示
三、BERT 是怎么训练的?(类比解释)
BERT 用了一种聪明的训练方法,叫 “完形填空”:
训练数据:随机遮住15%的词
原句:  "我 喜欢 在 周末 去 公园 散步"
变成:  "我 [?] 在 周末 去 公园 散步"

任务:让AI猜出被遮住的词是什么
答案:"喜欢"

通过海量这样的训练,AI学会了深度理解上下文
这种方法叫 Masked Language Model(MLM,掩码语言模型),比强迫AI按顺序预测下一个词,理解语言的方式要深刻得多。
四、BERT 的历史地位
BERT 发布时,在当时几乎所有的NLP(自然语言处理)标准测试上,一次性刷新了11项世界纪录。
这在AI领域是非常罕见的大事件。
BERT发布前(2018年10月以前):
  各类NLP任务的最好成绩,都是各种精心调优的专用模型

BERT发布后:
  微调一个BERT,就能在几乎所有任务上超越以前的专用模型
  相当于:一个通才,打败了一群专才
五、BERT 和 GPT 有什么区别?
这是最常见的问题。两者都是基于Transformer,但设计哲学完全不同:
                  BERT                           GPT
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
方向性             双向(同时看左右)         单向(只看左边,从左到右)
擅长               理解(读)                生成(写)
Transformer部分    只用编码器                只用解码器
训练目标           完形填空                   预测下一个词
典型用途           文本分类、问答、实体识别     聊天、写文章、生成代码
比喻               精通阅读理解的"语文高手"    擅长写作续写的"作家"
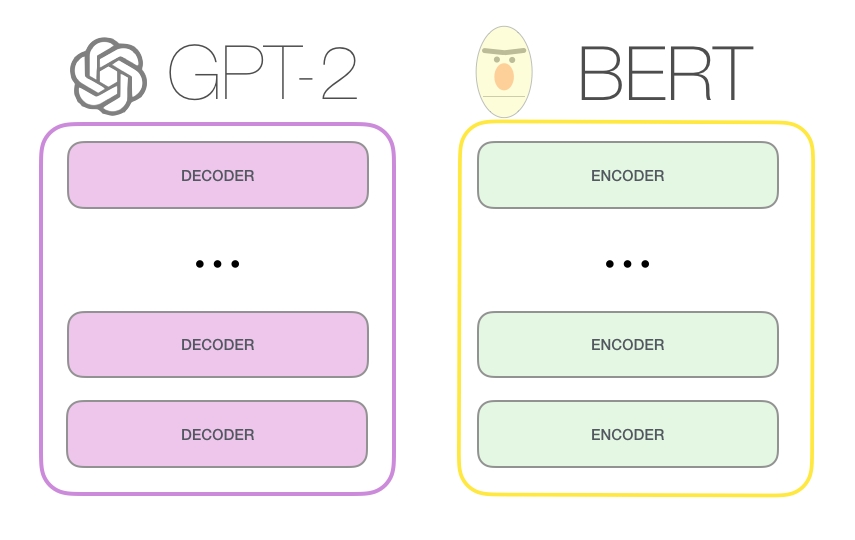
▲ 图2:BERT(仅编码器,双向)vs GPT(仅解码器,单向)的架构对比。两者都基于 Transformer,但用的是不同的模块。图片来源:Jay Alammar Blog
一句话区别:
- BERT 是为了"读懂"而生的,擅长理解语言
- GPT 是为了"写出"而生的,擅长生成语言
六、BERT 在现实中用在哪里?
虽然普通用户感知不到BERT的存在,但它默默工作在很多你每天使用的产品里:
🔍 搜索引擎
Google在2019年把BERT应用到搜索中,让搜索引擎更能理解自然语言查询:
以前的搜索:
  "2019 brazil traveler to usa visa"
  搜索引擎:把这串关键词逐个匹配

用了BERT之后:
  同样的查询,搜索引擎理解到:
  这是一个巴西人想去美国旅行,在问签证问题
  而不是美国人去巴西的签证
💬 智能客服
客服系统中的意图理解,很多用的是BERT变体。
📧 邮件过滤
垃圾邮件检测、邮件分类。
🏥 医疗文本分析
从大量医学文献中提取关键信息。
七、BERT 的"后代"们
BERT 开创了一种范式:先在大量数据上预训练,再针对具体任务微调(Pre-train + Fine-tune)。这个思路被无数后续模型继承:
BERT 家族树:
BERT (2018, Google)
  ├── RoBERTa (2019, Facebook) ── 训练更彻底,效果更好
  ├── ALBERT (2019, Google) ── 更小更快的BERT
  ├── DistilBERT (2019, HuggingFace) ── 速度更快的精简版
  ├── ERNIE (百度) ── 引入知识图谱的中文版
  ├── MacBERT (哈工大) ── 中文BERT优化版
  └── 数百个其他变体……
八、BERT 的局限
BERT不是万能的,它有明显的短板:
- 不擅长生成:BERT是个"读者",不是"作者",你没法用原始BERT来写文章
- 速度较慢:双向注意力计算量大,实时推理有延迟
- 序列长度有限:原始BERT最多处理512个token(约800中文字)
- 被GPT系列超越:在对话和生成任务上,GPT3之后的模型已经全面占优
九、为什么今天还要了解BERT?
也许你会问:既然GPT那么厉害,为什么还要了解BERT?
原因有三:
- 理解AI历史:BERT是AI从"专才"到"通才"转变的关键节点
- 理解"理解"和"生成"的区别:这是整个NLP领域最基本的分类
- 在某些场景BERT变体仍是最佳选择:文本分类、信息抽取等任务,小型BERT模型更快更便宜
十、总结
BERT 是AI历史上的一个里程碑:
- 🔄 双向理解:第一次让AI同时看上下文
- 📊 刷新11项记录:2018年的震撼性表现
- 🔍 改变搜索:Google搜索质量的重要推手
- 🌱 奠定范式:预训练+微调成为后来大模型的标配
虽然今天的BERT已经被更强大的模型超越,但它开创的"预训练语言模型"时代,正是GPT、Claude、Gemini这些大模型得以诞生的土壤。
🔔 下一篇预告
【AI大模型入门】A03:GPT-1/2/3——从"能写字"到"像人一样写"
OpenAI如何用三代GPT,一步步走向了改变世界的ChatGPT?
本文为【AI大模型百科专栏】第A02篇 · 奠基时代
作者:[孤岛站岗]
更新时间:2026年3月
更多推荐

 9
 0
- 0


 已为社区贡献33条内容

所有评论(0)