
机器学习进阶(9):决策树
第九篇:决策树——像人在一步步做判断的机器学习算法
KNN 很直观,我们是靠“看邻居”来判断样本属于哪类。
决策树(Decision Tree)则是另一种思路,它更像人在做判断:
“如果这个条件成立,就走左边;如果不成立,就走右边。最后判断结果是什么?”
直觉上,你可以把决策树想成一个二叉分支的问答流程。
每个节点都是一个问题,每条分支都是可能的答案,最后到达叶子节点得到预测结果。
1. 决策树的直观例子
假设你要预测一个学生这次考试是否通过,你手里有三个特征:
- 每天学习时长(小时)
- 作业完成率(百分比)
- 是否参加辅导班(0=不参加,1=参加)
一个简单的决策树可能是这样的逻辑:
-
第一个问题:每天学习时长 >= 5 小时?
- 是 → 下一个问题
- 否 → 预测不通过
-
第二个问题:作业完成率 >= 70%?
- 是 → 预测通过
- 否 → 预测不通过
这样一棵树就可以把样本分类了。
你可以看到,这和我们人自己判断很像:一步步问条件,然后根据答案走不同分支。
2. 决策树是如何决定“问哪个问题”的
树的每个节点都要问一个特征问题,但问题怎么选呢?
核心原则是:信息增益最大,也就是每一步尽量让数据分得更干净。
假设某个节点有 10 个样本,其中 7 个通过,3 个没通过。
如果某个特征可以把这 10 个样本分成:
- 左边:6 个通过,1 个没通过
- 右边:1 个通过,2 个没通过
那么这次分裂之后,左右两边的数据纯度提高了很多。
这就是选择这个特征作为分裂条件的原因。
信息增益、Gini 系数或者熵都是用来衡量“分裂效果”的数学方法。
你不用一开始记公式,先抓住核心概念就好:
选择最能让数据“干净分开”的特征做分裂。
3. 决策树的优势
- 直观可解释
你可以把树画出来,清楚看到模型的决策路径。 - 无需标准化
不像 KNN 或逻辑回归,决策树对特征尺度不敏感。 - 处理数值和类别特征都方便
对于类别型特征,直接按类别分裂即可。 - 可以捕捉非线性关系
决策树天然适合非线性边界,不需要你事先手工构造多项式或特征交互。
4. 决策树的劣势
- 容易过拟合
如果树长得太深,会把训练数据完全记住,但泛化能力差。 - 对小波动敏感
数据中一个样本的变化可能导致整个树结构改变。 - 高维数据表现一般
当特征很多时,决策树容易变得复杂而不稳。
这也解释了为什么实际应用中,我们会用随机森林或梯度提升树来改进:
它们本质上是用多个树做组合,让模型更稳健。
5. 一个简单 Python 示例
下面用 scikit-learn 建立一棵决策树,延续前面学生考试的数据例子:
import numpy as np
from sklearn.tree import DecisionTreeClassifier, plot_tree
import matplotlib.pyplot as plt

# 特征:每天学习时长、作业完成率、是否参加辅导班
X = np.array([
    [2, 50, 0],
    [3, 60, 0],
    [4, 65, 0],
    [5, 70, 1],
    [6, 75, 1],
    [7, 80, 1]
])

# 标签:0=不通过,1=通过
y = np.array([0, 0, 0, 1, 1, 1])

# 建立决策树
tree = DecisionTreeClassifier(max_depth=3, random_state=42)
tree.fit(X, y)

# 可视化决策树
plt.figure(figsize=(8,6))
plot_tree(tree, feature_names=["学习时长","作业完成率","辅导班"], class_names=["不通过","通过"], filled=True)
plt.show()
你可以看到每个节点的决策条件,以及每条分支的样本分布。这就是决策树的直观魅力。
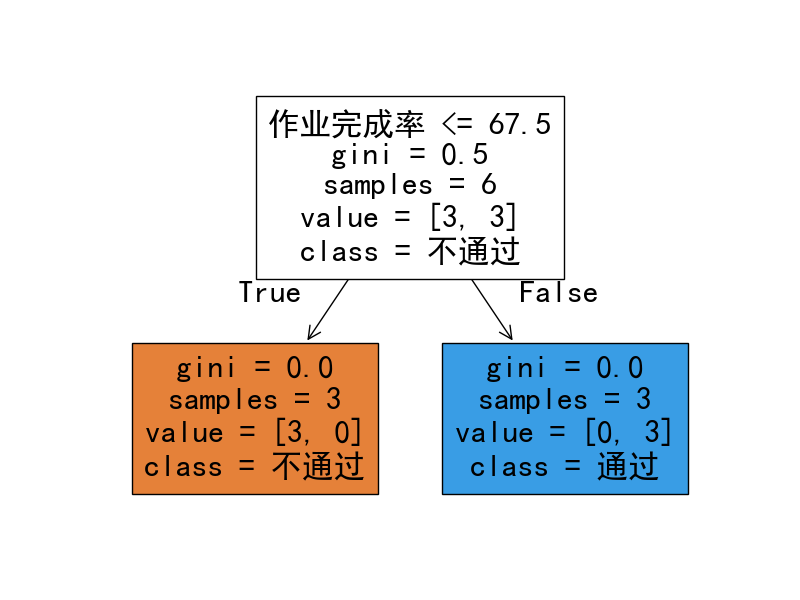
gini:节点纯度,越小越纯
samples:这个节点里有多少样本
value:每个类别各有多少样本
class:这个节点当前预测的类别
这棵决策树学到的规则非常直接:它先看“作业完成率”这个特征。
如果作业完成率不超过 67.5,就预测为“不通过”;如果超过 67.5,就预测为“通过”。从图里也能看出来,左右两个叶子节点的 gini 都已经变成了 0,说明这一步划分之后,两边的数据已经被完全分开了。
这也是决策树最直观的地方:它会不断找一个最合适的问题,把样本一点点分开。
6. 如何防止过拟合
决策树容易过拟合,但有几种常用方法可以控制:
- 限制树的深度(
max_depth)
树太深容易记住噪声 - 限制叶子节点最小样本数(
min_samples_leaf)
避免分裂到只有一个样本 - 随机选择特征
随机森林就是用这个思路,让每棵树只看一部分特征
简单来说,就是不要让树在训练集上“做得太完美”,否则泛化能力会差。
7. 决策树与 KNN 的对比
| 特性 | KNN | 决策树 |
|---|---|---|
| 可解释性 | 中 | 高 |
| 是否需要标准化 | 是 | 否 |
| 训练时间 | 快 | 快(单棵) |
| 预测时间 | 慢(要算距离) | 快 |
| 对噪声敏感 | 高(K 小) | 高(树深) |
| 捕捉非线性 | 可以,但受 K 限制 | 天然支持 |
可以看出,决策树的优势在于解释性强、预测快,适合入门和特征探索。
8. 小结
- 决策树把机器学习流程形象化为一步步判断
- 每个节点问一个问题,分支走不同路径,最后叶子给结果
- 树可以捕捉非线性、混合特征,缺点是容易过拟合
- 控制树深度、叶子最小样本数、随机选择特征是常用防过拟合手段
- 决策树直观,后续的随机森林、梯度提升树都是在它基础上的改进
决策树讲清楚以后,读者就可以自然理解为什么“随机森林”要用多棵树去投票,以及为什么梯度提升树要一步步加树优化损失。
更多推荐


 21
 0
- 0


 已为社区贡献32条内容

所有评论(0)