
deer-flow 2.0部署+调用本地大模型教程(基于vllm)
·
deer-flow部署+调用本地大模型教程(基于vllm)
部署deer-flow执行流程
拉取最新代码
git clone https://github.com/bytedance/deer-flow
切换到代码目录
cd deer-flow
配置环境
make install
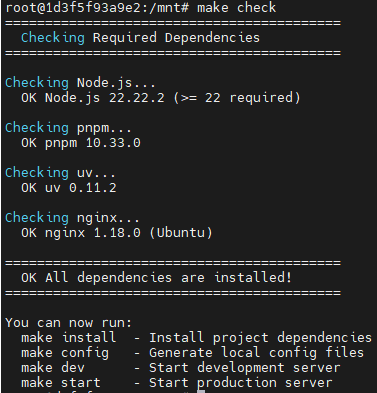
安装完成后执行:
make check
显示如下:
配置启动配置文件
make config
执行完会在根目录生成config.yaml文件
修改配置文件
将config.yaml中models部分替换成自己部署的模型
models:
  - name: local-vllm
    display_name: Local vLLM
    use: langchain_openai:ChatOpenAI
    model: qwen3
    api_key: dummy_key
    base_url: http://<your-vllm-host>:<port>/v1
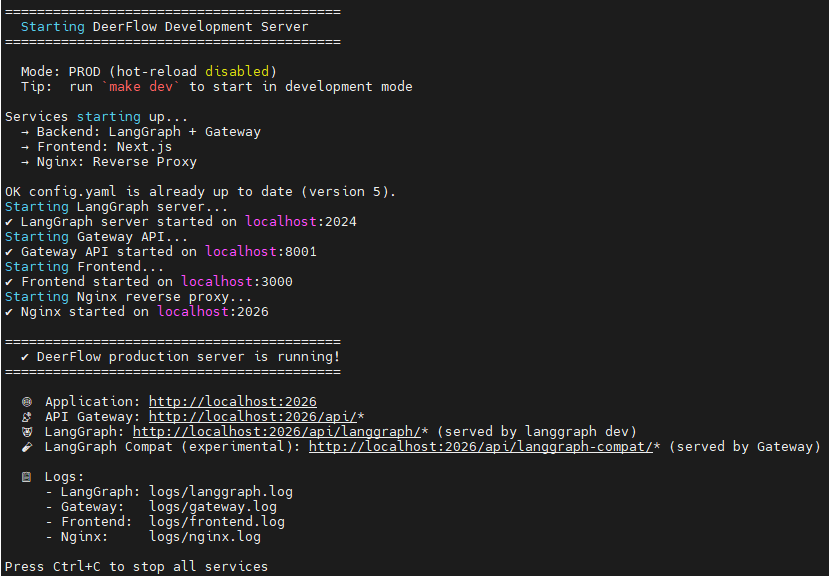
启动服务
make start
启动成功显示如下:
vllm部署本地大模型
以qwen3-8B 为例,显存占用44G
执行流程
安装vllm
pip install -U vllm \
    --pre \
    --extra-index-url https://wheels.vllm.ai/nightly
下载qwen3-8B模型
export HF_ENDPOINT=https://hf-mirror.com
huggingface-cli download --resume-download Qwen/Qwen3-8B --local-dir qwen3
注意–local-dir名字和后面的服务启动,deer-flow配置相关!!!
启动服务
vllm serve qwen3 --port 8866 --max_model_len 16384 --reasoning-parser deepseek_r1 --enable-auto-tool-choice --tool-call-parser hermes
注意–max_model_len 必须设置,否则在deer-flow调用时会报400:bad request
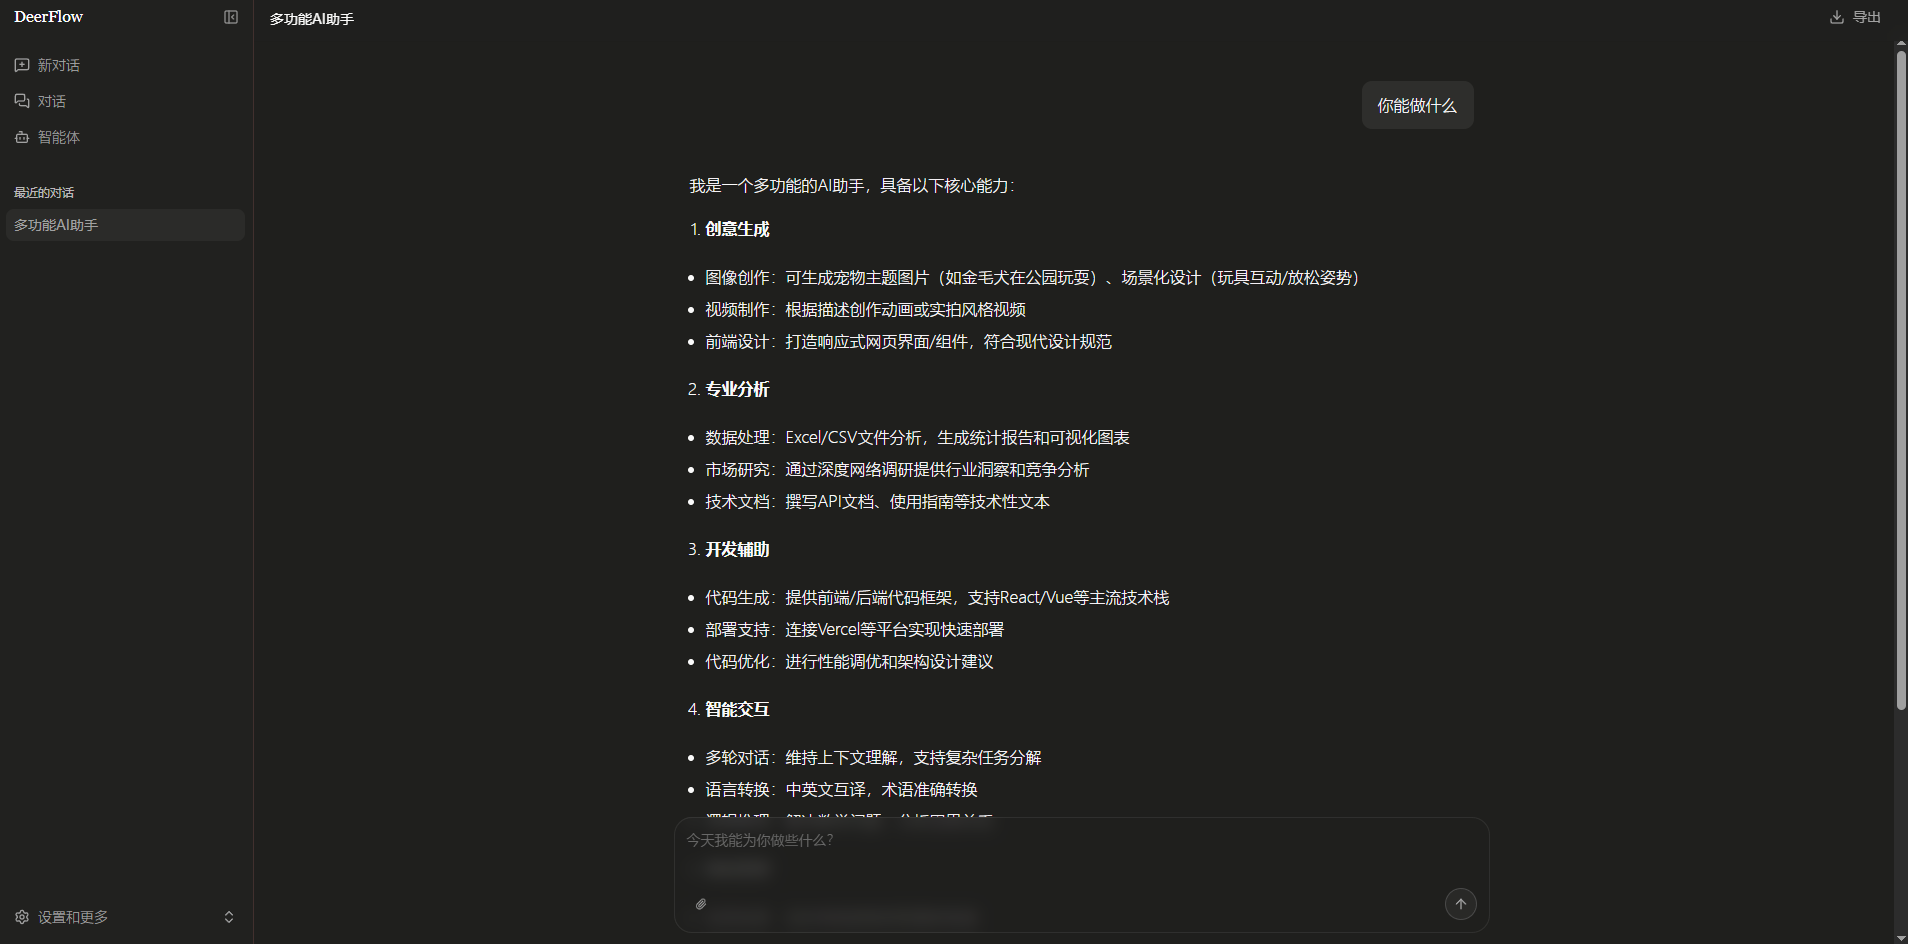
部署完并调用成功界面如下
如有疑问,欢迎评论区交流
更多推荐
 3
 0
- 0


 已为社区贡献2条内容

所有评论(0)