
【AIOPS】新手小白也能掌握的新一代运维神技:K8sSkill
·
背景
平时排查K8s问题,基本就是这套组合拳:
kubectl get pods | grep Error
kubectl describe pod xxx
kubectl logs xxx --previous
kubectl get events --sort-by='.lastTimestamp'
命令敲多了挺烦的,而且输出信息很多,得自己过滤关键内容。就想着能不能用自然语言直接问,让AI帮我跑这些命令、整理结果。
做了什么
写了个叫 K8sSkill 的东西,核心就两部分:
- 21个资源分析器 - 每个K8s资源一个分析器,比如PodAnalyzer、DeploymentAnalyzer
- 意图识别 - 把自然语言映射到对应的分析器
现在在Trae里可以直接这样问:
我:看看集群有什么问题

AI:正在检查...

     发现以下问题:
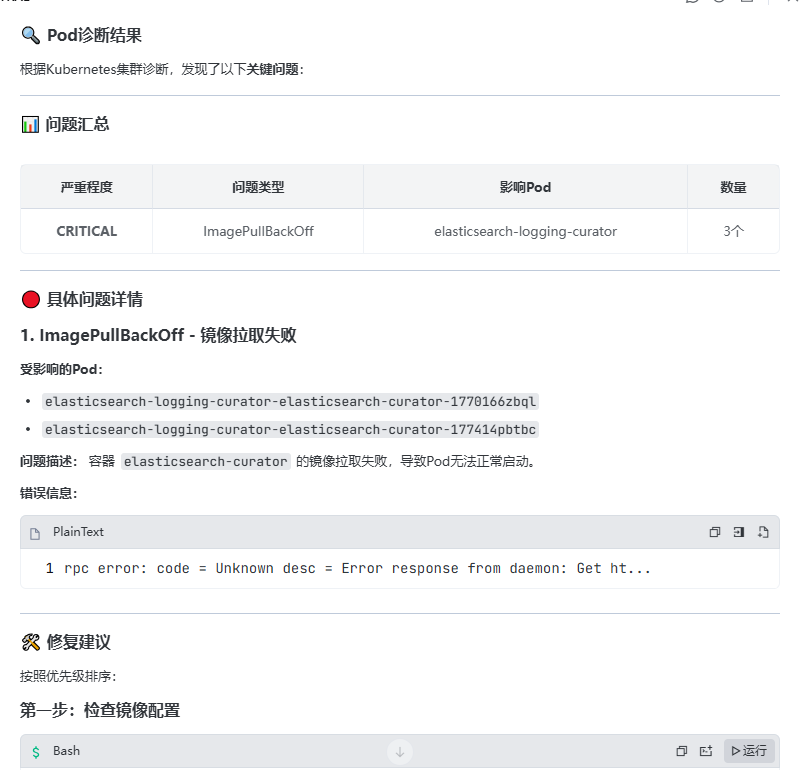
     - Pod nginx-xxx 处于 ImagePullBackOff
     - Node node-3 有 DiskPressure 警告

     建议:
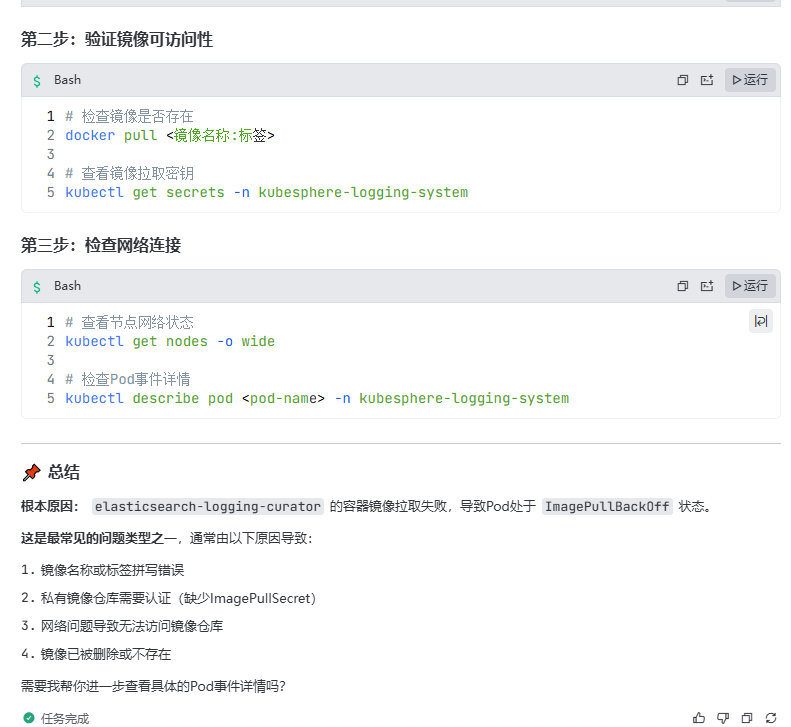
     1. 检查镜像标签是否存在
     2. 清理节点磁盘空间
项目结构
k8sskill/
├── scripts/
│   ├── core/base.py          # 分析器基类
│   ├── analyzers/            # 各资源分析器
│   │   ├── pod.py           # Pod诊断
│   │   ├── deployment.py    # Deployment诊断
│   │   ├── service.py       # Service诊断
│   │   └── ... (共21个)
│   └── orchestrator.py       # 调度中心
├── references/               # 文档
└── requirements.txt
每个分析器都继承 BaseAnalyzer,实现两个方法:
class PodAnalyzer(BaseAnalyzer):
    def analyze(self):
        # 获取Pod列表,检查异常状态
        # 返回问题列表

    def get_remediation(self, finding):
        # 根据问题类型返回修复建议
实际使用效果
场景1:Pod崩溃
之前排查Pod重启问题,要执行好几条命令。现在直接问:
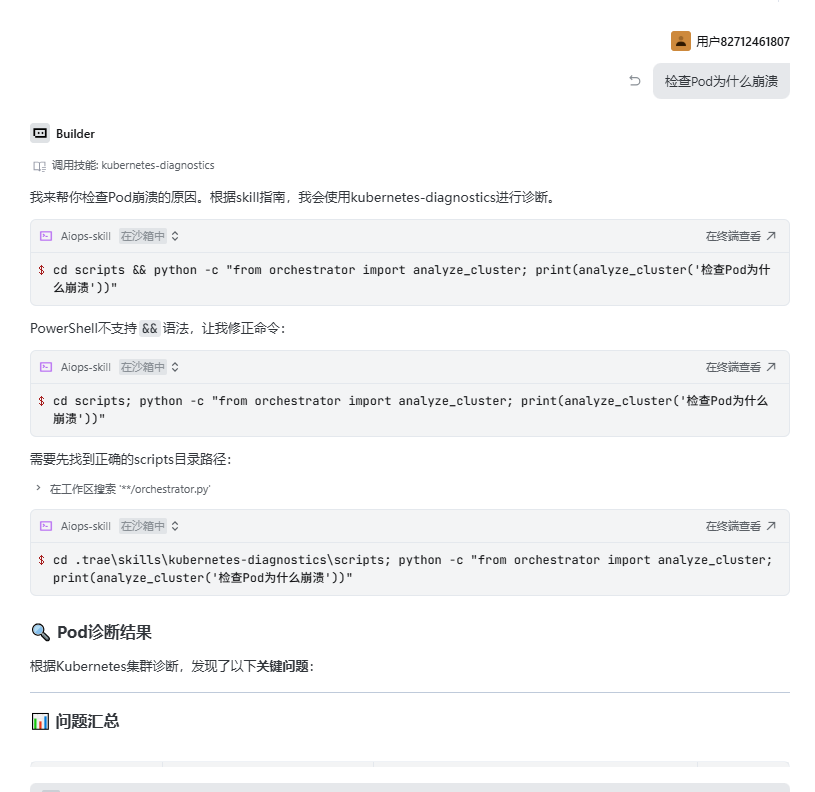
我:检查Pod为什么崩溃
AI:
   Pod: myapp-xxx
   状态: CrashLoopBackOff (重启12次)
   退出码: 137 (OOMKilled)

   建议增加内存限制到512Mi
省了点时间,不用自己翻 kubectl describe 的大段输出了。
场景2:服务访问不了
我:为什么服务访问不了
AI:
   Service myapp-service 没有Endpoints
   选择器 app=myapp 匹配到0个Pod

   可能原因:
   1. Pod标签不对(当前是 app=my-app)
   2. Pod没Ready
这个挺有用的,之前这种标签不匹配的问题,新手经常踩坑,得查半天。
场景3:日常巡检
每天早上花1分钟问一句"集群有什么问题",比手动敲一堆命令方便点。
一些细节
中文支持:所有输出都是中文,包括错误提示和修复建议。毕竟是国内团队用,英文看着累。
只读不修改:工具只负责诊断,不会自动修东西。安全第一,修复命令给出来,你自己决定执不执行。
IDE集成:在Trae里直接对话就行,不用切终端。这是Skill的优势,体验确实比传统CLI工具好一些。
局限
- 大型集群(几千个Pod)分析会慢一些
- 需要有效的kubeconfig
- 不会自动修复,只给建议
怎么用
# 安装依赖
pip install -r requirements.txt

# 配置kubeconfig
export KUBECONFIG=/path/to/config

# 然后在Trae里直接对话使用
效果展示
总结
就是个实用小工具,把平时排查K8s问题的经验代码化了。不是什么高大上的东西,但能省点时间。
如果你也在用Aiops\IDE\openclow(小龙虾),可以试试看。有问题欢迎提issue或者自己改,代码结构挺简单的,加个新分析器也就几十行代码。
项目地址:clowhub:clowhub–k8s-skill github:k8sskill
依赖:Python 3.8+, kubernetes-python
更多推荐


 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)