
Python基础3(容器数据类型)
提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档
容器数据类型
序列
序列(Sequence)是一种基本且核心的数据结构,它允许我们以有序的方式存储和操作数据。序列可以包含不同类型的元素,并且支持通过索引来访问和修改这些元素。
常见的序列类型包括:列表(List)、元组(Tuple)、字符串(String)。
序列的操作
索引:sequence[0]
切片:sequence[1:3]
相加:sequence1 + sequence2
乘法:sequence * 3
检查成员:x in sequence
计算长度:len(sequence)
计算最大值、最小值:max(sequence)、min(sequence)
列表
Python中最喜欢的两个数据类型,一个是列表,一个是字典
列表是一个可变的、有序的元素集合。
列表使用 [] 定义,数据之间使用 , 分隔。
列表中每个元素都有对应的位置值,称为索引或下标,索引从起始从0开始向后逐个递增,并且从末尾从-1开始逐个向前递减。
列表中元素可以是不同的类型。
list1 = [100, 200, 300, 400, 500]
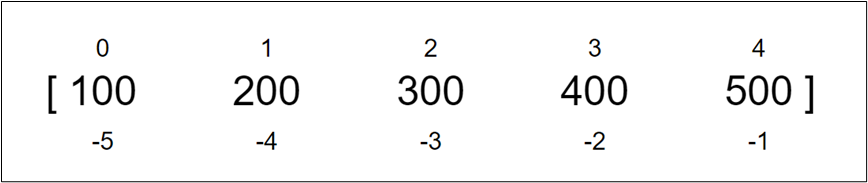
访问列表中元素
通过索引获取列表中元素
list1 = [100, 200, 300, 400, 500]
print(list1[1])  # 200
print(list1[-2])  # 400
列表切片
list1 = [100, 200, 300, 400, 500]
print(list1)  # 取全部元素
print(list1[:])  # 复制整个列表
print(list1[2:4])  # 取索引从2开始到4(不包含)的元素
print(list1[2:])  # 取索引从2开始到末尾的元素
print(list1[:2])  # 取索引从0开始到2(不包含)的元素
print(list1[2:-1])  # 取索引从2开始到-1(不包含)的元素
print(list1[::-1])  # 倒序取元素 这个会用到
列表相加
list1 = [100, 200, 300]
list2 = ["a", "b", "c"]
print(list1 + list2)  # [100, 200, 300, 'a', 'b', 'c']
列表乘法
list1 = [100, 200, 300]
print(list1 * 2)  # [100, 200, 300, 100, 200, 300]
通过下标修改
list1 = [100, 200, 300, 400, 500]
list1[0] = -1
print(list1)#[1, 200, 300, 400, 500]
通过切片修改。使用切片依然是左闭右开,不过和直接替换一个是不同的,如下代码
list1 = [100, 200, 300, 400, 500]
print(f"{list1[2:3]=}")#list1[2:3]=[300]
list1[2]=["a", "b", "c"]
print(f"{list1=}")#[100, 200, ['a', 'b', 'c'], 400, 500]
list1[2:3] = ["a", "b", "c"]#[100, 200, 'a', 'b', 'c', 400, 500]
print(list1)
检查成员是否为列表中元素
list1 = [100, 200, 300]
print(100 in list1)  # True
获取列表长度
list1 = [100, 200, 300]
print(len(list1))  # 3
求列表中那个元素的最大值,最小值,加和
list1 = [100, 200, 300, 400, 500]
print(max(list1))  # 500
print(min(list1))  # 100
print(sum(list1))  # 1500
遍历列表
list1 = [100, 200, 300, 400, 500]
for i in list1:
    print(i)
通过下标遍历列表
list1 = [100, 200, 300, 400, 500]
for i in range(len(list1)):
    print(i, list1[i])
使用enumerate()同时获取列表的下标和元素
list1 = [100, 200, 300, 400, 500]
for i, val in enumerate(list1):
    print(i, val)
删除列表指定位置元素或者切片
list1 = [100, 200, 300, 400, 500]
del list1[2]
print(list1)
列表推导式:列表推导式是 Python 中一种简洁创建列表的方式,它将一个可迭代对象(如列表、元组、集合、字符串等)的元素通过某种运算或条件筛选后生成一个新的列表。
基础的列表推导式
squares = [x**2 for x in range(5)]
print(squares)  # [0, 1, 4, 9, 16]
带条件的列表推导式
squares = [x**2 for x in range(10) if x % 2 == 0]
print(squares) # [0, 4, 16, 36, 64]
使用现有列表的列表推导式
list1 = [1, 2, 3, 4, 5]
squares = [x**2 for x in list1]
print(squares)  # [1, 4, 9, 16, 25]
包含多个循环的列表推导式
list1 = [1, 2, 3]
list2 = ["a", "b", "c"]
tuple_list = [(i, j) for i in list1 for j in list2]
print(tuple_list)#[(1, 'a'), (1, 'b'), (1, 'c'), (2, 'a'), (2, 'b'), (2, 'c'), (3, 'a'), (3, 'b'), (3, 'c')]
zip()函数:zip() 函数可将多个可迭代对象中对应元素打包为一个个元组。看到
list1 = [1, 2, 3]
list2 = ["a", "b", "c"]
zipped = zip(list1, list2)
print(zipped)#<zip object at 0x7fcf5cbfdc00>
print(list(zipped))#[(1, 'a'), (2, 'b'), (3, 'c')]
常用函数
| 函数 | 说明 |
|---|---|
| list.insert(index,x) | 在指定位置插入x |
| list.append(x) | 在列表末尾追加x |
| list1.extend(list2) | 在列表1的末尾追加列表2的数据 |
| del list[index] | 删除指定位置的数据或切片 |
| list.remove(x) | 删除第一次出现的x |
| list.pop([index]) | 删除指定位置的数据,默认为末尾数据 |
| list.clear() | 清空列表中元素 |
| list[index] = x | 修改指定位置的数据 |
| list1[start:end] = list2 | 修改列表切片的数据 |
| sorted(list[,reverse=True]) | 返回排序后的新列表,可选降序 |
| list.sort([reverse=True]) | 对列表就地排序,可选降序 |
| list.reverse() | 反转列表中的元素 |
| list.index(x[,start,[,end]]) | 返回x在列表中首次出现的位置,可指定起始和结束范围 |
| list.count(x) | 返回x的数量 |
| len(list) | 返回列表元素个数 |
| max(list) | 返回列表中最大值 |
| min(list) | 返回列表中最小值 |
| sum(list) | 返回列表中所有元素和 |
| list.copy() | 拷贝列表 |
| list(x) | 将序列转换为列表 |
第一组:“增加元素”家族 —— append vs extend vs insert
这三个都是往列表里加东西,但加的方式完全不同。
append(x)(追加整体): 永远加在最后面。不管你塞给它什么(数字、字符串、甚至另一个列表),它都把x当作**一个独立的整体(一个包裹)**塞进去。extend(list2)(拆包合并): 永远加在最后面。但如果给它一个列表,它会把列表拆开,把里面的元素一个一个拿出来,排在原来列表的后面。insert(index, x)(插队): 可以加在任何位置。把原来那个位置及以后的人全往后挤。
【致命易错点:append 和 extend 加列表的区别】
a = [1, 2]
b = [1, 2]
new_items = [3, 4]

a.append(new_items)
print(a)  # 结果: [1, 2, [3, 4]] -> 把整个列表当作"一个元素"加进去了 (嵌套)

b.extend(new_items)
print(b)  # 结果: [1, 2, 3, 4]   -> 拆开包裹,元素融合了 (平铺)
第二组:“删除元素”家族 —— remove vs pop vs del
你想扔掉列表里的东西,关键在于:你是知道它“叫什么”,还是知道它“在哪儿”?
remove(x)(按“值”删除): “我不知道它在第几个,我只想把列表中第一个叫 ‘张三’ 的踢出去。” 不返回被删的值。如果找不到会报错。pop(index)(按“位置”拔出): “把排在第 2 个的人揪出来给我!” 重点:它会把删掉的元素返回给你,你可以拿个变量接住它。默认拔出最后一个。del list[index](按“位置/切片”狙击): Python 的无情杀手(它是个关键字,不是函数)。可以删单个,更牛的是可以批量删(删切片)。
【对比案例】
my_list = ["苹果", "香蕉", "橘子", "香蕉", "葡萄"]

# 1. remove: 只删第一个碰到的值
my_list.remove("香蕉")
print(my_list) # ["苹果", "橘子", "香蕉", "葡萄"]

# 2. pop: 拔出指定位置的元素,并拿来用
fruit = my_list.pop(-1)
print(f"我吃掉了 {fruit}") # 我吃掉了 葡萄
print(my_list)            # ["苹果", "橘子", "香蕉"]

# 3. del: 无情批量斩杀
del my_list[0:2] # 删掉索引 0 和 1
print(my_list)   # ["香蕉"]
第三组:“排序”家族 —— sort vs sorted
这是面试中最爱考的题目!
list.sort()(就地正法 / 改变原貌): 它是列表的专属方法。它直接在原来的列表上动手脚,排完序后,原来的乱序列表就彻底消失了。返回值是None。sorted(list)(克隆重组 / 保持原貌): 它是 Python 的内置函数。它不敢动原来的列表,而是偷偷克隆一份,排好序后,把全新的列表返回给你。
【对比案例】
# 测试 sort()
nums1 = [3, 1, 2]
res1 = nums1.sort()
print(nums1) # [1, 2, 3] (原来的被改变了)
print(res1)  # None (千万别写 res1 = nums1.sort(),拿不到东西的!)

# 测试 sorted()
nums2 = [3, 1, 2]
res2 = sorted(nums2)
print(nums2) # [3, 1, 2] (原来的毫发无伤!)
print(res2)  # [1, 2, 3] (生成了一个新的排好序的列表)
💡 终极记忆法则(黄金定律)
为了不搞混,你可以记住 Python 设计的一个底层哲学:
- 形如
list.xxx()的(叫做对象的方法):
除了pop和copy,大多数操作(像append,sort,reverse,clear)都是直接修改原列表,并且什么都不返回(返回 None)。 - 形如
xxx(list)的(叫做内置函数):
像sorted(),len(),max(),sum(),它们绝对不会弄脏你的原列表,而是把计算结果当作一个新东西返回给你。
字符串
字符串是不可变的、有序的。(字符串一旦创建,内容就不能被修改。若是使用replace来修改字符串之后,其实这个不再是原来的那个地址了)
字符串中元素不可修改。
字符串使用单引号、双引号或三重引号定义。
字符串中每个值都有对应的位置值,称为索引或下标,索引从起始从0开始向后逐个递增,并且从末尾从-1开始逐个向前递减。
创建字符串
str1 = "hello world"
访问字符串
str1 = "hello world"
print(str1[0])
print(str1[-1])
print(str1[4:-3])
字符串相加
str1 = "hello world"
str2 = "dlrow olleh"
print(str1 + str2)  # hello worlddlrow olleh
字符串乘法
str1 = "hello world"
print(str1 * 2)  # hello worldhello world
检查成员是否为字符串中元素
str1 = "hello world"
print("lo" in str1)  # True
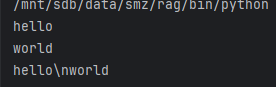
原始字符串:所有的字符串按照字面意思处理,没有转义字符。需在字符串前加上r / R。
print("hello\nworld")
print(r"hello\nworld")
常用函数
| 函数 | 说明 |
|---|---|
| str.replace(old,new[,max]) | 把将字符串中的old替换成new,如果指定max,则替换不超过max次 |
| str.split([x][,n]) | 按x分隔字符串,默认按任何空白字符串分隔并在结果中丢弃空字符串。可指定最大分隔次数 |
| str.rsplit([x][,n]) | 与split()类似,从右边开始分隔 |
| x.join(seq) | 以x作为分隔符,将序列中所有的字符串合并为一个新的字符串 |
| str.strip([x]) | 截掉字符串两边的空格或指定字符 |
| str.lstrip([x]) | 截掉字符串左边的空格或指定字符 |
| str.rstrip([x]) | 截掉字符串右边的空格或指定字符 |
| str.removeprefix() | 截掉字符串指定前缀 |
| str.removesuffix() | 截掉字符串指定后缀 |
| str.upper() | 将所有字符转为大写 |
| str.lower() | 将所有字符转为小写 |
| str.swapcase() | 反转字符串中字母大小写 |
| str.capitalize() | 将字符串第一个字母变为大写,其他字母变为小写 |
| str.title() | 将字符串每个单词首字母大写 |
| str.casefold() | 返回适合无大小写比较的字符串版本 |
| len(str) | 返回字符串长度 |
| max(str) | 返回字符串中最大值 |
| min(str) | 返回字符串中最小值 |
| str.find(x[,start][,end]) | 返回字符串中第一个x的索引值,不存在则返回-1,可指定字符串开始结束范围 |
| str.rfind(x[,start][,end]) | 与find()类似,从右边开始查找 |
| str.index(x[,start][,end]) | 返回字符串中第一个x的索引值,不存在则报错,可指定字符串开始结束范围 |
| str.rindex(x[,start][,end]) | 与index()类似,从右边开始查找 |
| str.count(x[,start][,end]) | 返回字符串中x的个数,可指定字符串开始结束范围 |
| str.startswith(x[,start][,end]) | 检查字符串是否以x开头,可指定字符串开始结束范围 |
| str.endswith(x[,start][,end]) | 检查字符串是否以x结尾,可指定字符串开始结束范围 |
| str.isspace() | 检查字符串是否非空且只包含空白 |
| str.isalnum() | 检查字符串是否非空且只包含字母(英文字母+汉字)和数字 |
| str.isalpha() | 检查字符串是否非空且只包含字母(英文字母+汉字) |
| str.isascii() | 检查字符串是否只包含ASCII字符,空字符串也是ASCII |
| str.isdecimal() | 检查字符串是否非空且只包含十进制字符 |
| str.isdigit() | 检查字符串是否非空且只包含数字 |
| str.isidentifier() | 检查字符串是否是有效的标识符 |
| str.isupper() | 检查字符串中是否包含至少一个区分大小写的字符,且所有这些(区分大小写的)字符都是大写 |
⚠️ 暗坑 1:千万别被 strip() 骗了!(全网最容易踩的坑)
很多人以为 strip("abc") 是删掉两边的 "abc" 这个词。大错特错!
strip 里面传入的参数,是一个**“字符集合”**。只要首尾的字符在这个集合里,就会被无情削掉,直到遇到不在集合里的字符为止。
【致命代码】:
url = "www.taobao.com"
# 本意是想去掉 ".com",你以为会变成 "www.taobao"
print(url.strip(".com"))
# 实际输出: "www.taoba" !!! (连最后的 'o' 也被当做目标删掉了!)
【正确解法】:
如果你只想精确去掉某个特定的前缀或后缀,请务必使用 Python 3.9 新增的两个函数:
print(url.removesuffix(".com"))  # 输出: www.taobao (极其精准)
print(url.removeprefix("www."))  # 输出: taobao.com
⚠️ 暗坑 2:split() 不带参数 vs 带空格参数,天壤之别!
在处理不规范的文本(比如用户多敲了几个空格)时,这两个写法的结局完全不同。
split()(什么都不传): 极度智能。它把任何空白(空格、换行符\n、制表符\t)都当成分隔符,而且会自动把连续的空白合并,并丢弃前后的空字符串。split(" ")(传一个空格): 极度死板。只认单独的空格,遇到两个连续空格,就会劈出一个空字符串""。
【代码演示】:
text = "hello    world \n python"

# 智能模式(推荐):干干净净的单词列表
print(text.split())
# 输出: ['hello', 'world', 'python']

# 呆板模式:会产生一堆垃圾空字符串
print(text.split(" "))
# 输出: ['hello', '', '', '', 'world', '\n', 'python']
⚠️ 暗坑 3:反人类语法的 join()
join() 的作用是把列表重新拼成字符串(相当于 split 的逆操作)。
很多人都会凭直觉写出这样的代码:list.join("-")。这一定会报错!
【牢记语法】:
join 是字符串的方法,不是列表的方法。所以必须是**“胶水”在前面调用,列表放在括号里**。
words = ["I", "love", "Python"]

# 正确写法:以 "-" 为胶水,把 words 粘起来
result = "-".join(words)
print(result) # 输出: I-love-Python
⚠️ 暗坑 4:find() 和 index() 到底选哪个?
这俩功能一模一样,都是找“某个字在哪个位置”。唯一的区别在于**“找不到时的脾气”**。
find()脾气温和: 找不到就默默返回-1。程序继续运行。index()脾气暴躁: 找不到直接抛出ValueError异常,让你的程序当场崩溃。
【最佳实践】:
如果你只是想配合 if 判断它在不在,其实更推荐用 in 关键字。
s = "hello"

# 如果非要知道位置,且不确定它在不在,用 find 更安全:
if s.find("x") != -1:
    print("找到了")

# 只有当你 100% 确定它在里面,且找不到就算严重错误时,才用 index()。
🌟 进阶亮点:lower() vs casefold()
你可能会疑惑,既然有了把字母变小写的 lower(),为什么还要搞个 casefold()?
lower()只能处理标准的英文字母 (A-Z)。casefold()是加强版,专门用来做**“无视大小写的终极字符串比对”**。它能把德语、俄语等小语种里的特殊大写字母也强制转换掉。
s = "weiß" # 德语单词
print(s.lower())    # 输出: weiß  (没变化)
print(s.casefold()) # 输出: weiss (彻底降级为基础小写字母,方便比对)
📌 终极铁律(一定要记住)
回到你前面问过的概念:字符串是不可变的。
所以上面表格里这 20 多个函数,绝对没有任何一个能够修改原来的字符串!
它们全都是在内存里另外造了一个新字符串。
s = "  hello  "
s.strip() # 这行代码等于白写!s 依然是 "  hello  "

s = s.strip() # 必须重新赋值,把新造出来的 "hello" 贴上 s 的标签
元组
元组是一个不可变的、有序的元素集合。
不能对元组中的元素进行修改操作。
元组使用 () 定义,数据之间使用,分隔。
元组中每个元素都有对应的位置值,称为索引或下标,索引从起始从0开始向后逐个递增,并且从末尾从-1开始逐个向前递减。
元组中元素可以是不同的类型。
元组的使用方式与列表类似。
创建元组
tuple1 = (100, 200, 300, 400, 500)
元组中只包含一个元素时,需要在元素后面添加逗号,否则括号会被当作运算符使用。
tuple1 = (100,)
也可以通过元组推导式创建元组。
tuple_generator = (x for x in range(10))  # 获取生成器对象
print(tuple_generator)#<generator object <genexpr> at 0x7f2a8c45f3e0>
#tuple1 = list(tuple_generator) # 转换为列表[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

tuple1 = tuple(tuple_generator)  # 转换为元组(0, 1, 2, 3, 4, 5, 6, 7, 8, 9)

print(tuple1)
非常好的问题!这是 Python 中非常重要但容易混淆的概念。我详细给你讲解。
1. 核心概念定义
可迭代对象(Iterable)
定义: 实现了 __iter__() 方法的对象,可以被 for 循环遍历。
常见的可迭代对象:
- 列表
list - 元组
tuple - 字符串
str - 字典
dict - 集合
set range对象- 文件对象
- 生成器
迭代器(Iterator)
定义: 同时实现了 __iter__() 和 __next__() 方法的对象。
特点:
- 可以用
next()逐个取值 - 取完后会抛出
StopIteration异常 - 只能遍历一次
生成器(Generator)
定义: 一种特殊的迭代器,使用 yield 关键字定义。
特点:
- 是迭代器的一种
- 惰性计算(需要时才生成值)
- 节省内存
tuple() 的底层逻辑相当于做了一个隐藏的 for 循环。它对生成器下达命令:“开机!把你能造出来的东西,一个不剩地全给我吐出来!”于是生成器开始疯狂运转:吐出 0,tuple() 拿个小本本记下。吐出 1,tuple() 记下。… 直到吐出 9。当机器想造第 11 个数时,发现 range(10) 的图纸用完了,机器宣告停工(抛出 StopIteration 信号)。此时,tuple() 把小本本上记下的 0, 1, 2… 9 打包塞进一块固定大小的内存里,彻底封死(因为元组不可变)。
访问元组
tuple1 = (100, 200, 300, 400, 500)
print(tuple1[2])
print(tuple1[-1])
print(tuple1[2:4])
元组相加
tuple1 = (100, 200, 300)
tuple2 = ("a", "b", "c")
print(tuple1 + tuple2)  # (100, 200, 300, 'a', 'b', 'c')
元组乘法
tuple1 = (100, 200, 300)
print(tuple1 * 2)  # (100, 200, 300, 100, 200, 300)
检查成员是否为元组中元素
tuple1 = (100, 200, 300, 400, 500)
print(300 in tuple1)  # True
获取元组长度
tuple1 = (100, 200, 300, 400, 500)
print(len(tuple1))  # 5
求元组中元素的最大值、最小值、加和
tuple1 = (100, 200, 300, 400, 500)
print(max(tuple1))  # 500
print(min(tuple1))  # 100
print(sum(tuple1))  # 1500
遍历元组
tuple1 = (100, 200, 300, 400, 500)

for i in tuple1:
    print(i)

for i in range(len(tuple1)):
    print(i, tuple1[i])

for i, val in enumerate(tuple1):
    print(i, val)
元组的不可变:元组的不可变指的是元组所指向的内存中的内容不可变,但可以重新赋值。
tuple1 = (100, 200, 300)
print(id(tuple1), tuple1)#140437256067072 (100, 200, 300)
tuple1 = tuple1 + (1, 2, 3)
print(id(tuple1), tuple1)#140437255241344 (100, 200, 300, 1, 2, 3)
如果元组中元素是可变数据类型,其嵌套项可以被修改。
tuple1 = (100, 200, 300, [1, 2, 3])
print(id(tuple1), tuple1)#140542577391584 (100, 200, 300, [1, 2, 3])
tuple1[3].append(4)
print(id(tuple1), tuple1)#140542577391584 (100, 200, 300, [1, 2, 3, 4]) 所以以我目前浅显的理解就是只要元组中存放的数据的位置不变,那么它也就认为是不变的,某种程度上就可以被修改
集合Set
集合是无序的,且不包含重复元素。
集合使用 {} 定义,数据之间使用 , 分隔,也可以使用set()定义。
集合没有索引,所以不能通过切片方式访问集合元素。
集合中元素可以是不同的类型。
集合可以进行数学上的集合操作,如并集、交集和差集。
集合适用于需要快速成员检查、消除重复项和集合运算的场景。
创建集合:可以通过{}或set()创建集合,但创建空集合需要使用set()而非{},因为{}会创建空字典。
set1 = {1, 2, 3}
set2 = set([1, 2, 3])  # 使用set()函数从列表创建集合
set3 = set(1,2,3)# 这种方式不对
set4 = set()
print(set1, set2, set3,set4)
也可以通过集合推导式创建集合
set1 = {x for x in range(10) if x % 2 == 0}
print(set1)  # {0, 2, 4, 6, 8}
向集合中添加元素
set1 = {1, 2, 3}
set1.add(4)
set1.add(5)
print(set1)
从集合中删除元素
set1 = {1, 2, 3}
set1.remove(2)
print(set1)
检查成员是否为集合中元素
set1 = {1, 2, 3, 4, 5}
print(2 in set1)  # True
获取集合长度
set1 = {1, 2, 3, 4, 5}
print(len(set1))  # 5
求集合中元素的最大值、最小值、加和
set1 = {1, 2, 3, 4, 5}
print(max(set1))  # 5
print(min(set1))  # 1
print(sum(set1))  # 15
遍历集合
my_set = {1, 2, 3, 4, 5}
for item in my_set:
    print(item)
| 函数 | 说明 |
|---|---|
| set.add(x) | 添加元素 |
| set.update(x) | 添加元素,x可以为列表、元组、字符串、字典等可迭代对象 |
| set.union(x) | 添加元素后返回一个新的集合,x可以为列表、元组、字符串、字典等可迭代对象 |
| set.remove(x) | 从集合中移除x,x不存在则报错 |
| set.discard(x) | 从集合中移除x,x不存在也不报错 |
| set.pop() | 随机取出集合中的一个元素,如果集合为空则报错 |
| set.clear() | 清空集合 |
| set.difference(x1,…) | 求set1和x1的差集,返回一个新的集合 |
| set.difference_update(x1,…) | 求set1和x1的差集 |
| set.intersection(x1,…) | 求set1和x1的交集,返回一个新的集合 |
| set.intersection_update(x1,…) | 求set1和x1的交集 |
| set1 & set2 | 两集合求交集 |
| set1 1 set2 | 两集合求并集 |
| set1 - set2 | 两集合求差集 |
| set1.isdisjoint(set2) | 判断两集合是否没有交集 |
| set1.issubset(set2) | 判断set1是否为set2的子集 |
| set1.issuperset(set2) | 判断set2是否为set1的子集 |
| set1.symmetric_difference(set2) | 求两集合中不重复的元素,返回一个新的集合 |
| set1.symmetric_difference_update(set2) | 求两集合中不重复的元素 |
| set.copy() | 拷贝集合 |
| len(set) | 返回集合元素个数 |
| max(set) | 求集合中元素的最大值 |
| min(set) | 求集合中元素的最小值 |
| sum(set) | 求集合中元素的加和 |
字典
一个无序的键值对集合,键是唯一的,而值可以重复。
字典使用 {} 定义,键(key)和值(value)使用 : 连接,每个键值对之间使用 , 分隔。如{key1 : value1, key2 : value2}
字典没有索引。
字典可以通过键来获取对应的值。
值可以取任何数据类型,但键必须是不可变的,如字符串、数字、元组。
(不可变对象(如字符串、数字):因为它们的值永远不变,所以它们算出来的“指纹(哈希值)”永远不变,随时都能精准找到。
可变对象(如列表、集合):因为你随时可以往列表里 append 东西,它的内容变了,算出来的“指纹”也会跟着变。指纹一变,底层的寻址系统就彻底崩溃了。)
创建字典
可以通过{}或dict()创建字典。
dict1 = {}
dict2 = dict()
dict3 = {"name": "Alice", "age": 18, "gender": "male"}
dict4 = dict(name="Bob", age=20, gender="female")
dict5 = dict([("name", "Tom"), ("age", 22), ("gender", "male")])
print(dict1)
print(dict2)
print(dict3)
print(dict4)
print(dict5)
也可以通过字典推导式创建字典。
squares = {x: x**2 for x in range(4)}
print(squares)  # {0: 0, 1: 1, 2: 4, 3: 9}
访问字典:可通过 [] 访问字典中的元素。key不存在时会报错。
dict1 = {"name": "Alice", "age": 18, "gender": "male"}
print(dict1["name"])  # Alice
print(dict1["age"])  # 18
print(dict1["gender"])  # male
print(dict1["address"])  # 报错
也可以通过get()获取字典中的元素。key不存在时会返回None,也可以指定默认值。
dict1 = {"name": "Alice", "age": 18, "gender": "male"}
print(dict1.get("name"))  # Alice
print(dict1.get("age"))  # 18
print(dict1.get("gender"))  # male
print(dict1.get("address"))  # None
print(dict1.get("address", "earth"))  # ear
向字典中添加元素
dict1 = {"name": "Alice", "age": 18, "gender": "male"}
dict1["address"] = "earth"
print(dict1)
修改字典中元素:通过key修改对应的value。
dict1 = {"name": "Alice", "age": 18, "gender": "male"}
dict1["name"] = "Bob"
print(dict1)
检查成员是否为字典中的key
dict1 = {"name": "Alice", "age": 81, "gender": "male"}
print("name" in dict1)  # 检查key是否存在
print("Alice" in dict1)  # 无法直接检查value是否存在
获取字典长度
dict1 = {"name": "Alice", "age": 81, "gender": "male"}
print(len(dict1))  # 3
遍历字典
my_dict = {‘Name’: ‘Tom’, ‘Age’: 17}
# 遍历出所有k
keys = my_dict.keys()
print(f'keys: {keys}')#keys: dict_keys(['Name', 'Age'])
for k in keys:
    print (k)#Name Age
print("-" *20)
# 遍历出所有v
vals = my_dict.values()
print(f'vals: {vals}')#vals: dict_values(['Tom', 17])
print(vals)#Tom 17
for v in vals:
    print (v)
print("-" *20)
# k-v遍历
keys = my_dict.keys()
for k in keys:
    print (k + "---" + str(my_dict[k]))
print("-" *20)
kv = my_dict.items()
print(kv)#dict_items([('Name', 'Tom'), ('Age', 17)])
for i in kv:
    print(i)
删除字典元素
my_dict = {'Name': 'Tom', 'Age': 17}
del my_dict['Name'] # 删除键 'Name'
# my_dict.clear()     # 清空字典
# del my_dict         # 删除字典

print (my_dict)
常用函数
| 函数 | 说明 |
|---|---|
| del dict[key] | 根据key删除键值对 |
| dict.pop(key[,default]) | 获取key所对应的value,同时删除该键值对,可设置默认值 |
| dict.popitem() | 取出字典中的最后插入的键值对,字典为空则报错 |
| dict.clear() | 清空字典 |
| dict1.update(dict2) | 将dict2中的键值对更新到dict1中 |
| dict.get(key[,default]) | 获取字典中key对应value,可设置默认值 |
| dict.setdefault(key[,default]) | 获取字典中key对应value,可设置默认值。若key不存在于字典中,将会添加key并将value设为默认值 |
| dict.keys() | 获取字典所有的key,返回一个视图对象。字典改变,视图也会跟着变化 |
| dict.values() | 获取字典所有的value,返回一个视图对象 |
| dict.items() | 获取字典所有的(key,value),返回一个视图对象 |
| dict.copy() | 拷贝字典 |
| dict.fromkeys(seq[,default]) | 以序列seq中元素做字典的key创建一个新字典,可设置value的默认值 |
总结
1. 核心对比表格
| 特性 | 列表(list) | 元组(tuple) | 集合(set) | 字典(dict) |
|---|---|---|---|---|
| 定义符号 | [] | () | {} | {key: value} |
| 是否有序 | ✅ 有序 | ✅ 有序 | ❌ 无序 | ❌ 无序(Python 3.7+ 保持插入顺序) |
| 是否可变 | ✅ 可变 | ❌ 不可变(元素地址不可变) | ✅ 可变 | ✅ 可变 |
| 元素是否唯一 | ❌ 可重复 | ❌ 可重复 | ✅ 必须唯一 | 键唯一,值可重复 |
| 是否支持索引 | ✅ 支持 | ✅ 支持 | ❌ 不支持 | ❌ 不支持(通过键访问) |
| 元素类型要求 | 任意类型 | 任意类型 | 必须可哈希(不可变) | 键必须可哈希,值任意 |
| 常用场景 | 动态数据、需要修改 | 固定数据、函数返回多值 | 去重、集合运算 | 键值对映射 |
2. 定义方式对比
# 列表 - 方括号 []
list1 = [1, 2, 3, 2, 1]
list2 = list([1, 2, 3])
list3 = list("abc")  # ['a', 'b', 'c']

# 元组 - 圆括号 ()
tuple1 = (1, 2, 3, 2, 1)
tuple2 = tuple([1, 2, 3])
tuple3 = 1, 2, 3  # 可以省略括号
tuple4 = (1,)  # 单元素元组必须有逗号

# 集合 - 花括号 {} 或 set()
set1 = {1, 2, 3}
set2 = set([1, 2, 3, 2, 1])  # {1, 2, 3} 自动去重
# set3 = {}  # ❌ 这是空字典,不是空集合
set3 = set()  # ✅ 空集合

# 字典 - 花括号 {} + 键值对
dict1 = {'name': 'Tom', 'age': 17}
dict2 = dict(name='Tom', age=17)
dict3 = dict([('name', 'Tom'), ('age', 17)])
3. 有序性对比
# 列表 - 有序
list1 = [3, 1, 2]
print(list1)      # [3, 1, 2]
print(list1[0])   # 3 - 可以通过索引访问

# 元组 - 有序
tuple1 = (3, 1, 2)
print(tuple1)     # (3, 1, 2)
print(tuple1[0])  # 3 - 可以通过索引访问

# 集合 - 无序
set1 = {3, 1, 2}
print(set1)       # {1, 2, 3} - 顺序可能不同
# print(set1[0])  # ❌ TypeError - 不支持索引

# 字典 - Python 3.7+ 保持插入顺序
dict1 = {'c': 3, 'a': 1, 'b': 2}
print(dict1)      # {'c': 3, 'a': 1, 'b': 2} - 保持顺序
# print(dict1[0]) # ❌ KeyError - 不支持索引
print(dict1['c']) # 3 - 通过键访问
4. 可变性对比
# 列表 - 可变
list1 = [1, 2, 3]
list1[0] = 99      # ✅ 可以修改
list1.append(4)    # ✅ 可以添加
print(list1)       # [99, 2, 3, 4]

# 元组 - 不可变
tuple1 = (1, 2, 3)
# tuple1[0] = 99   # ❌ TypeError
# tuple1.append(4) # ❌ AttributeError
print(tuple1)      # (1, 2, 3)

# 集合 - 可变
set1 = {1, 2, 3}
set1.add(4)        # ✅ 可以添加
set1.remove(1)     # ✅ 可以删除
print(set1)        # {2, 3, 4}

# 字典 - 可变
dict1 = {'a': 1, 'b': 2}
dict1['a'] = 99    # ✅ 可以修改值
dict1['c'] = 3     # ✅ 可以添加键值对
print(dict1)       # {'a': 99, 'b': 2, 'c': 3}
5. 元素唯一性对比
# 列表 - 允许重复
list1 = [1, 2, 2, 3, 3, 3]
print(list1)  # [1, 2, 2, 3, 3, 3]

# 元组 - 允许重复
tuple1 = (1, 2, 2, 3, 3, 3)
print(tuple1)  # (1, 2, 2, 3, 3, 3)

# 集合 - 自动去重
set1 = {1, 2, 2, 3, 3, 3}
print(set1)  # {1, 2, 3}

# 字典 - 键唯一,值可重复
dict1 = {'a': 1, 'b': 2, 'a': 3}  # 键 'a' 重复
print(dict1)  # {'a': 3, 'b': 2} - 后面的覆盖前面的

dict2 = {'a': 1, 'b': 1, 'c': 1}  # 值可以重复
print(dict2)  # {'a': 1, 'b': 1, 'c': 1}
6. 索引和访问方式对比
# 列表 - 通过索引访问
list1 = ['a', 'b', 'c']
print(list1[0])   # 'a'
print(list1[-1])  # 'c'
print(list1[0:2]) # ['a', 'b'] - 支持切片

# 元组 - 通过索引访问
tuple1 = ('a', 'b', 'c')
print(tuple1[0])   # 'a'
print(tuple1[-1])  # 'c'
print(tuple1[0:2]) # ('a', 'b') - 支持切片

# 集合 - 不支持索引
set1 = {'a', 'b', 'c'}
# print(set1[0])   # ❌ TypeError
# 只能遍历
for item in set1:
    print(item)

# 字典 - 通过键访问
dict1 = {'name': 'Tom', 'age': 17}
print(dict1['name'])  # 'Tom'
print(dict1.get('age'))  # 17
# print(dict1[0])  # ❌ KeyError
7. 元素类型要求对比
# 列表 - 任意类型
list1 = [1, 'a', [2, 3], {'x': 4}]  # ✅ 可以混合类型
print(list1)

# 元组 - 任意类型
tuple1 = (1, 'a', [2, 3], {'x': 4})  # ✅ 可以混合类型
print(tuple1)

# 集合 - 元素必须可哈希(不可变)
set1 = {1, 'a', (2, 3)}  # ✅ 数字、字符串、元组可以
print(set1)
# set2 = {1, [2, 3]}  # ❌ TypeError - 列表不可哈希
# set3 = {1, {'x': 4}}  # ❌ TypeError - 字典不可哈希

# 字典 - 键必须可哈希,值任意
dict1 = {1: 'a', 'x': [1, 2], (1, 2): {'y': 3}}  # ✅
print(dict1)
# dict2 = {[1, 2]: 'a'}  # ❌ TypeError - 列表不能做键
8. 常用操作对比
添加元素
# 列表
list1 = [1, 2, 3]
list1.append(4)      # 末尾添加
list1.insert(0, 0)   # 指定位置插入
list1.extend([5, 6]) # 批量添加
print(list1)  # [0, 1, 2, 3, 4, 5, 6]

# 元组 - 不可修改
# tuple1.append(4)  # ❌ AttributeError

# 集合
set1 = {1, 2, 3}
set1.add(4)          # 添加单个元素
set1.update([5, 6])  # 批量添加
print(set1)  # {1, 2, 3, 4, 5, 6}

# 字典
dict1 = {'a': 1}
dict1['b'] = 2       # 添加键值对
dict1.update({'c': 3, 'd': 4})  # 批量添加
print(dict1)  # {'a': 1, 'b': 2, 'c': 3, 'd': 4}
删除元素
# 列表
list1 = [1, 2, 3, 4]
list1.remove(2)    # 删除指定值
del list1[0]       # 删除指定索引
x = list1.pop()    # 删除并返回末尾元素
print(list1)       # [3]

# 元组 - 不可修改
# 只能删除整个元组
# del tuple1

# 集合
set1 = {1, 2, 3, 4}
set1.remove(2)     # 删除指定值(不存在会报错)
set1.discard(5)    # 删除指定值(不存在不报错)
print(set1)        # {1, 3, 4}

# 字典
dict1 = {'a': 1, 'b': 2, 'c': 3}
del dict1['a']     # 删除指定键
x = dict1.pop('b') # 删除并返回值
print(dict1)       # {'c': 3}
9. 遍历方式对比
# 列表
list1 = [1, 2, 3]
for item in list1:
    print(item)
for i, item in enumerate(list1):  # 带索引
    print(i, item)

# 元组
tuple1 = (1, 2, 3)
for item in tuple1:
    print(item)

# 集合
set1 = {1, 2, 3}
for item in set1:
    print(item)

# 字典
dict1 = {'a': 1, 'b': 2}
for key in dict1:              # 遍历键
    print(key)
for value in dict1.values():   # 遍历值
    print(value)
for k, v in dict1.items():     # 遍历键值对
    print(k, v)
10. 特有操作对比
列表特有
list1 = [3, 1, 4, 1, 5]
list1.sort()         # 原地排序
print(list1)         # [1, 1, 3, 4, 5]
list1.reverse()      # 反转
print(list1)         # [5, 4, 3, 1, 1]
print(list1.count(1))  # 2 - 统计某值出现次数
print(list1.index(4))  # 2 - 查找某值的索引
集合特有(集合运算)
set1 = {1, 2, 3, 4}
set2 = {3, 4, 5, 6}

print(set1 & set2)   # {3, 4} - 交集
print(set1 | set2)   # {1, 2, 3, 4, 5, 6} - 并集
print(set1 - set2)   # {1, 2} - 差集
print(set1 ^ set2)   # {1, 2, 5, 6} - 对称差集
字典特有
dict1 = {'a': 1, 'b': 2, 'c': 3}

print(dict1.keys())    # dict_keys(['a', 'b', 'c'])
print(dict1.values())  # dict_values([1, 2, 3])
print(dict1.items())   # dict_items([('a', 1), ('b', 2), ('c', 3)])

print(dict1.get('a'))       # 1 - 安全获取值
print(dict1.get('x', 0))    # 0 - 不存在返回默认值

dict1.setdefault('d', 4)    # 键不存在时设置默认值
print(dict1)  # {'a': 1, 'b': 2, 'c': 3, 'd': 4}
11. 性能对比
| 操作 | 列表 | 元组 | 集合 | 字典 |
|---|---|---|---|---|
| 查找元素 | O(n) | O(n) | O(1) | O(1) |
| 插入元素 | O(1)~O(n) | ❌ | O(1) | O(1) |
| 删除元素 | O(n) | ❌ | O(1) | O(1) |
| 内存占用 | 中等 | 最小 | 较大 | 最大 |
12. 使用场景建议
列表
# ✅ 适合:
# - 需要保持顺序
# - 需要频繁修改
# - 允许重复元素

students = ['Tom', 'Jerry', 'Alice']
scores = [85, 92, 78]
元组
# ✅ 适合:
# - 数据不会改变
# - 函数返回多个值
# - 作为字典的键

point = (10, 20)  # 坐标
rgb = (255, 128, 0)  # 颜色

def get_user():
    return ('Tom', 17)  # 返回多个值
集合
# ✅ 适合:
# - 去重
# - 集合运算(交集、并集等)
# - 快速查找

# 去重
numbers = [1, 2, 2, 3, 3, 3]
unique = list(set(numbers))  # [1, 2, 3]

# 快速查找
allowed_users = {'Tom', 'Jerry', 'Alice'}
if 'Tom' in allowed_users:  # O(1) 时间
    print("允许访问")
字典
# ✅ 适合:
# - 键值对映射
# - 配置信息
# - 快速查找

# 用户信息
user = {
    'name': 'Tom',
    'age': 17,
    'email': 'tom@example.com'
}

# 计数
words = ['apple', 'banana', 'apple']
count = {}
for word in words:
    count[word] = count.get(word, 0) + 1
print(count)  # {'apple': 2, 'banana': 1}
13. 类型转换
# 互相转换
list1 = [1, 2, 3, 2, 1]

# 转元组
tuple1 = tuple(list1)
print(tuple1)  # (1, 2, 3, 2, 1)

# 转集合(自动去重)
set1 = set(list1)
print(set1)  # {1, 2, 3}

# 集合转列表
list2 = list(set1)
print(list2)  # [1, 2, 3]

# 字典相关
dict1 = {'a': 1, 'b': 2}
print(list(dict1))        # ['a', 'b'] - 键的列表
print(list(dict1.values()))  # [1, 2] - 值的列表
print(list(dict1.items()))   # [('a', 1), ('b', 2)] - 键值对列表
14. 记忆口诀
列表方括号,有序可改能重复
元组圆括号,有序不变能重复
集合花括号,无序可改必唯一
字典键值对,无序可改键唯一
15. 快速选择指南
需要修改数据?
  ├─ 是 → 列表/集合/字典
  └─ 否 → 元组

需要保持顺序?
  ├─ 是 → 列表/元组
  └─ 否 → 集合/字典

需要去重?
  ├─ 是 → 集合
  └─ 否 → 列表/元组

需要键值对映射?
  ├─ 是 → 字典
  └─ 否 → 列表/元组/集合
希望这个对比能帮助你理解这四种数据类型的区别!如果有任何疑问,随时问我。
更多推荐
 13
 0
- 0


 已为社区贡献7条内容

所有评论(0)