
基于深度学习的行人车辆检测与计数系统
·
基于深度学习的行人车辆检测与计数系统
以下文字及代码仅供参考。
文章目录
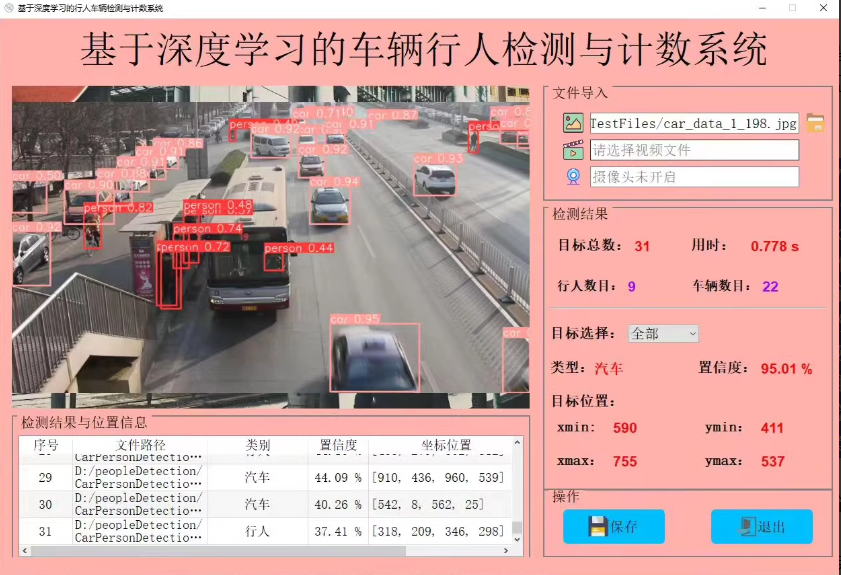
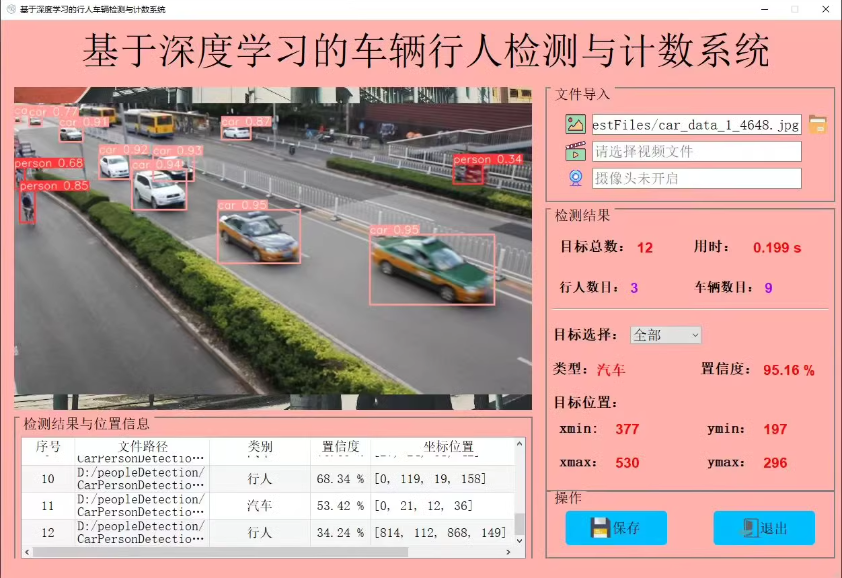
网络:深度学习网络 yoloV8
软件:Pycharm+Anaconda
环境:python=3.9 opencv PyQt5 torch1.9
1
基于 YOLOv8 和 PyQt5 的行人车辆检测与计数系统的关键代码
1. 数据准备
1.1 数据集格式
- 使用 COCO 格式的数据集,包含:
- 图片文件夹:
images/train和images/val - 标注文件夹:
labels/train和labels/val - 每个标注文件是
.txt文件,每一行表示一个目标,格式为:<class_id> <x_center> <y_center> <width> <height>
- 图片文件夹:
1.2 数据集配置文件
创建一个 YAML 文件(如 data.yaml),用于定义数据集路径和类别名称:
train: ./images/train
val: ./images/val

nc: 2  # 类别数量
names: ['person', 'car']  # 类别名称
2. 训练代码
使用 YOLOv8 的训练功能进行模型训练。
from ultralytics import YOLO

def train_model():
    # 加载预训练模型
    model = YOLO('yolov8n.pt')  # 使用 YOLOv8 Nano 预训练模型

    # 开始训练
    model.train(
        data='data.yaml',       # 数据集配置文件
        epochs=50,              # 训练轮数
        imgsz=640,              # 输入图片尺寸
        batch=16,               # 批次大小
        device='cuda',          # 使用 GPU
        workers=8,              # 数据加载线程数
        project='runs/train',   # 训练结果保存路径
        name='exp'              # 实验名称
    )

if __name__ == "__main__":
    train_model()
3. 推理代码
编写推理代码,用于检测行人和车辆。
from ultralytics import YOLO
import cv2

def detect_image(model_path, image_path):
    # 加载训练好的模型
    model = YOLO(model_path)

    # 读取图片
    image = cv2.imread(image_path)

    # 进行推理
    results = model(image)

    # 显示结果
    for result in results:
        boxes = result.boxes.xyxy.cpu().numpy()
        classes = result.boxes.cls.cpu().numpy()
        confidences = result.boxes.conf.cpu().numpy()

        for box, cls, conf in zip(boxes, classes, confidences):
            x1, y1, x2, y2 = map(int, box)
            label = f"{model.names[int(cls)]} {conf:.2f}"
            cv2.rectangle(image, (x1, y1), (x2, y2), (0, 255, 0), 2)
            cv2.putText(image, label, (x1, y1 - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.9, (0, 255, 0), 2)

    # 显示图片
    cv2.imshow("Detection", image)
    cv2.waitKey(0)
    cv2.destroyAllWindows()

if __name__ == "__main__":
    detect_image("runs/train/exp/weights/best.pt", "test.jpg")
4. 主函数与 PyQt5 界面
4.1 PyQt5 界面设计
完整界面代码如下:
from PyQt5.QtWidgets import QApplication, QMainWindow, QPushButton, QLabel, QVBoxLayout, QWidget, QFileDialog, QMessageBox, QComboBox
from PyQt5.QtGui import QImage, QPixmap
from PyQt5.QtCore import QTimer
from ultralytics import YOLO
import cv2
import pandas as pd
import os

class PedestrianVehicleDetector(QMainWindow):
    def __init__(self):
        super().__init__()
        self.setWindowTitle("行人车辆检测与计数系统")
        self.setGeometry(100, 100, 800, 600)

        # 初始化模型
        self.model = YOLO("runs/train/exp/weights/best.pt")  # 加载训练好的模型
        self.class_names = ['person', 'car']  # 类别名称
        self.current_class = None  # 当前选择的目标类别

        # UI 元素
        self.label = QLabel(self)
        self.label.setGeometry(50, 50, 700, 400)

        self.btn_image = QPushButton("选择图片", self)
        self.btn_video = QPushButton("选择视频", self)
        self.btn_camera = QPushButton("打开摄像头", self)
        self.btn_export = QPushButton("导出结果", self)
        self.combo_classes = QComboBox(self)

        self.btn_image.setGeometry(50, 500, 150, 40)
        self.btn_video.setGeometry(220, 500, 150, 40)
        self.btn_camera.setGeometry(390, 500, 150, 40)
        self.btn_export.setGeometry(560, 500, 150, 40)
        self.combo_classes.setGeometry(320, 550, 150, 40)

        # 绑定按钮事件
        self.btn_image.clicked.connect(self.detect_single_image)
        self.btn_video.clicked.connect(self.detect_video)
        self.btn_camera.clicked.connect(self.open_camera)
        self.btn_export.clicked.connect(self.export_results)
        self.combo_classes.addItems(["All"] + self.class_names)
        self.combo_classes.currentTextChanged.connect(self.switch_class)

        # 视频捕获相关
        self.cap = None
        self.timer = QTimer()
        self.timer.timeout.connect(self.update_frame)

        # 存储检测结果
        self.results_data = []

    def detect_single_image(self):
        """检测单张图片"""
        file_path, _ = QFileDialog.getOpenFileName(self, "选择图片", "", "Images (*.jpg *.png)")
        if file_path:
            self.process_image(file_path)

    def detect_video(self):
        """检测视频文件"""
        file_path, _ = QFileDialog.getOpenFileName(self, "选择视频", "", "Videos (*.mp4 *.avi)")
        if file_path:
            self.cap = cv2.VideoCapture(file_path)
            self.timer.start(30)

    def open_camera(self):
        """打开摄像头进行实时检测"""
        self.cap = cv2.VideoCapture(0)
        self.timer.start(30)

    def update_frame(self):
        """更新视频帧或摄像头捕获的画面"""
        ret, frame = self.cap.read()
        if ret:
            self.process_image(frame=frame, is_video=True)

    def process_image(self, file_path=None, frame=None, is_video=False):
        """处理图片并显示结果"""
        if not is_video:
            frame = cv2.imread(file_path)

        # 使用 YOLOv8 进行检测
        results = self.model(frame)

        # 统计目标数量
        counts = {cls: 0 for cls in self.class_names}
        for result in results:
            boxes = result.boxes.xyxy.cpu().numpy()
            classes = result.boxes.cls.cpu().numpy()
            confidences = result.boxes.conf.cpu().numpy()

            for box, cls, conf in zip(boxes, classes, confidences):
                class_name = self.model.names[int(cls)]
                counts[class_name] += 1

                # 如果当前类别匹配,则绘制边界框
                if self.current_class == "All" or class_name == self.current_class:
                    x1, y1, x2, y2 = map(int, box)
                    label = f"{class_name} {conf:.2f}"
                    cv2.rectangle(frame, (x1, y1), (x2, y2), (0, 255, 0), 2)
                    cv2.putText(frame, label, (x1, y1 - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.9, (0, 255, 0), 2)

            # 保存检测结果
            if not is_video:
                self.results_data.append({
                    "file": file_path,
                    **counts,
                    "detection_time": pd.Timestamp.now()
                })

        # 显示结果
        if is_video:
            self.display_frame(frame)
        else:
            self.display_image(frame)

    def display_image(self, frame):
        """显示图片"""
        frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
        height, width, channel = frame.shape
        bytes_per_line = 3 * width
        q_img = QImage(frame.data, width, height, bytes_per_line, QImage.Format_RGB888)
        self.label.setPixmap(QPixmap.fromImage(q_img))

    def display_frame(self, frame):
        """显示视频帧"""
        frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
        height, width, channel = frame.shape
        bytes_per_line = 3 * width
        q_img = QImage(frame.data, width, height, bytes_per_line, QImage.Format_RGB888)
        self.label.setPixmap(QPixmap.fromImage(q_img))

    def switch_class(self, class_name):
        """切换目标类别"""
        self.current_class = class_name if class_name != "All" else None

    def export_results(self):
        """导出检测结果为 Excel 或 CSV 文件"""
        if not self.results_data:
            QMessageBox.warning(self, "警告", "没有检测结果可导出!")
            return

        file_path, _ = QFileDialog.getSaveFileName(self, "保存结果", "", "Excel Files (*.xlsx);;CSV Files (*.csv)")
        if file_path:
            df = pd.DataFrame(self.results_data)
            if file_path.endswith(".xlsx"):
                df.to_excel(file_path, index=False)
            elif file_path.endswith(".csv"):
                df.to_csv(file_path, index=False)
            QMessageBox.information(self, "成功", "结果已导出!")

if __name__ == "__main__":
    app = QApplication([])
    window = PedestrianVehicleDetector()
    window.show()
    app.exec_()
5. 功能总结
- 训练:通过
train_model()函数训练模型。 - 推理:支持图片、视频和摄像头的检测。
- 界面:PyQt5 提供了友好的用户界面。
- 导出:结果可以导出为 Excel 或 CSV 文件。
希望这个详细的实现能满足你的需求!如果有进一步的问题,请随时提问。
1. 安装依赖
确保安装了必要的库:
pip install ultralytics opencv-python pyqt5 pandas torch torchvision
3. 代码实现
3.1 主程序逻辑
from ultralytics import YOLO
import cv2
import os
import pandas as pd
from PyQt5.QtWidgets import QApplication, QMainWindow, QPushButton, QLabel, QVBoxLayout, QWidget, QFileDialog, QMessageBox, QComboBox
from PyQt5.QtGui import QImage, QPixmap
from PyQt5.QtCore import QTimer

class PedestrianVehicleDetector(QMainWindow):
    def __init__(self):
        super().__init__()
        self.setWindowTitle("行人车辆检测与计数系统")
        self.setGeometry(100, 100, 800, 600)

        # 初始化模型
        self.model = YOLO("best.pt")  # 加载训练好的模型
        self.class_names = ['person', 'car']  # 类别名称
        self.current_class = None  # 当前选择的目标类别

        # UI 元素
        self.label = QLabel(self)
        self.label.setGeometry(50, 50, 700, 400)

        self.btn_image = QPushButton("选择图片", self)
        self.btn_video = QPushButton("选择视频", self)
        self.btn_camera = QPushButton("打开摄像头", self)
        self.btn_export = QPushButton("导出结果", self)
        self.combo_classes = QComboBox(self)

        self.btn_image.setGeometry(50, 500, 150, 40)
        self.btn_video.setGeometry(220, 500, 150, 40)
        self.btn_camera.setGeometry(390, 500, 150, 40)
        self.btn_export.setGeometry(560, 500, 150, 40)
        self.combo_classes.setGeometry(320, 550, 150, 40)

        # 绑定按钮事件
        self.btn_image.clicked.connect(self.detect_single_image)
        self.btn_video.clicked.connect(self.detect_video)
        self.btn_camera.clicked.connect(self.open_camera)
        self.btn_export.clicked.connect(self.export_results)
        self.combo_classes.addItems(["All"] + self.class_names)
        self.combo_classes.currentTextChanged.connect(self.switch_class)

        # 视频捕获相关
        self.cap = None
        self.timer = QTimer()
        self.timer.timeout.connect(self.update_frame)

        # 存储检测结果
        self.results_data = []

    def detect_single_image(self):
        """检测单张图片"""
        file_path, _ = QFileDialog.getOpenFileName(self, "选择图片", "", "Images (*.jpg *.png)")
        if file_path:
            self.process_image(file_path)

    def detect_video(self):
        """检测视频文件"""
        file_path, _ = QFileDialog.getOpenFileName(self, "选择视频", "", "Videos (*.mp4 *.avi)")
        if file_path:
            self.cap = cv2.VideoCapture(file_path)
            self.timer.start(30)

    def open_camera(self):
        """打开摄像头进行实时检测"""
        self.cap = cv2.VideoCapture(0)
        self.timer.start(30)

    def update_frame(self):
        """更新视频帧或摄像头捕获的画面"""
        ret, frame = self.cap.read()
        if ret:
            self.process_image(frame=frame, is_video=True)

    def process_image(self, file_path=None, frame=None, is_video=False):
        """处理图片并显示结果"""
        if not is_video:
            frame = cv2.imread(file_path)

        # 使用 YOLOv8 进行检测
        results = self.model(frame)

        # 统计目标数量
        counts = {cls: 0 for cls in self.class_names}
        for result in results:
            boxes = result.boxes.xyxy.cpu().numpy()
            classes = result.boxes.cls.cpu().numpy()
            confidences = result.boxes.conf.cpu().numpy()

            for box, cls, conf in zip(boxes, classes, confidences):
                class_name = self.model.names[int(cls)]
                counts[class_name] += 1

                # 如果当前类别匹配,则绘制边界框
                if self.current_class == "All" or class_name == self.current_class:
                    x1, y1, x2, y2 = map(int, box)
                    label = f"{class_name} {conf:.2f}"
                    cv2.rectangle(frame, (x1, y1), (x2, y2), (0, 255, 0), 2)
                    cv2.putText(frame, label, (x1, y1 - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.9, (0, 255, 0), 2)

            # 保存检测结果
            if not is_video:
                self.results_data.append({
                    "file": file_path,
                    **counts,
                    "detection_time": pd.Timestamp.now()
                })

        # 显示结果
        if is_video:
            self.display_frame(frame)
        else:
            self.display_image(frame)

    def display_image(self, frame):
        """显示图片"""
        frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
        height, width, channel = frame.shape
        bytes_per_line = 3 * width
        q_img = QImage(frame.data, width, height, bytes_per_line, QImage.Format_RGB888)
        self.label.setPixmap(QPixmap.fromImage(q_img))

    def display_frame(self, frame):
        """显示视频帧"""
        frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
        height, width, channel = frame.shape
        bytes_per_line = 3 * width
        q_img = QImage(frame.data, width, height, bytes_per_line, QImage.Format_RGB888)
        self.label.setPixmap(QPixmap.fromImage(q_img))

    def switch_class(self, class_name):
        """切换目标类别"""
        self.current_class = class_name if class_name != "All" else None

    def export_results(self):
        """导出检测结果为 Excel 或 CSV 文件"""
        if not self.results_data:
            QMessageBox.warning(self, "警告", "没有检测结果可导出!")
            return

        file_path, _ = QFileDialog.getSaveFileName(self, "保存结果", "", "Excel Files (*.xlsx);;CSV Files (*.csv)")
        if file_path:
            df = pd.DataFrame(self.results_data)
            if file_path.endswith(".xlsx"):
                df.to_excel(file_path, index=False)
            elif file_path.endswith(".csv"):
                df.to_csv(file_path, index=False)
            QMessageBox.information(self, "成功", "结果已导出!")

if __name__ == "__main__":
    app = QApplication([])
    window = PedestrianVehicleDetector()
    window.show()
    app.exec_()
更多推荐


 7
 0
- 0


 已为社区贡献82条内容

所有评论(0)