
微服务—初入茅庐
目录
1、微服务拆分
什么时候拆分?
-
创业型项目:采用单体架构开发、试错,随着规模扩大逐渐拆分
-
大型项目:直接选择微服务架构,避免后续拆分麻烦
怎么拆分?
-
高内聚:每个微服务的职责要尽量单一,包含的业务相互关联度高、完整度高
-
低耦合:每个微服务的功能要相对独立,减少对其它微服务的依赖
1、纵向拆分:按照业务模块拆分
2、横向拆分:抽取公共服务,提高复用性
工程结构为两种:
——独立Project
——Maven聚合(常见)
远程调用
Spring提供了一个RestTemplate工具,方便实现Http请求的发送
使用步骤:
1、注入RestTemplate到Spring容器
@Bean
public RestTemplate restTemplate() {
    return new RestTemlate();
}
2、发起远程调用
public <T> ResponseEntity<T> exchange(
String url //请求路径
HttpMethod method, //请求方式
@Nullable HttpEntity<?> requstEntity, //请求实体,可以为空
Class<T> responseType, //返回值类型
Map<String,?> uriVariables //请求参数
)2、服务治理
注册中心
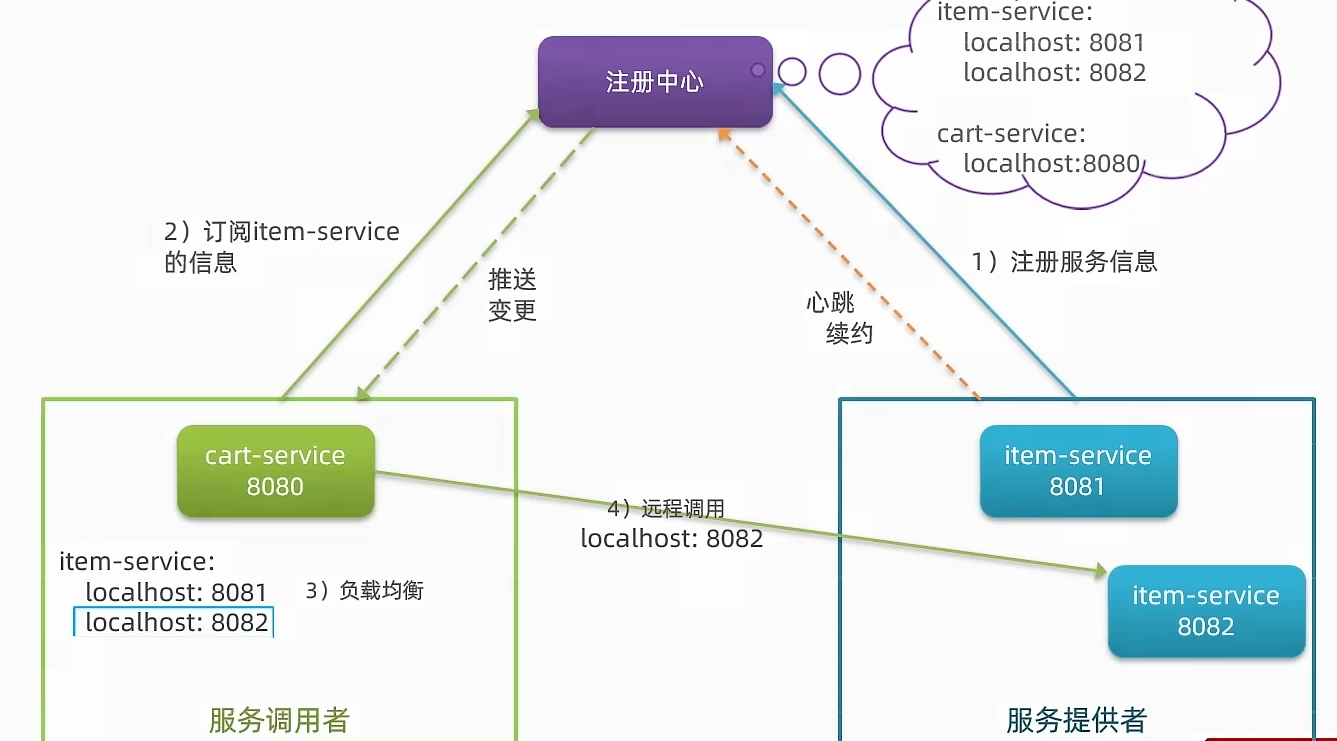
服务治理的三个角色:
-
服务提供者:暴露服务接口,供其他服务调用
-
服务消费者:调用其它服务提供的接口
-
注册中心:记录并监控微服务各实例状态,推送服务变更信息
服务提供者会在启动时注册自己信息到注册中心,消费者可以从注册中心订阅和拉取服务信息
服务提供者通过心跳机制向注册中心报告自己的健康状态
当心跳异常时注册中心会将异常服务剔除,并通知订阅该服务的消费者
😁当服务提供者有多个实例,消费者可以通过负载均衡算法,从多个实例选择
服务注册
服务注册步骤
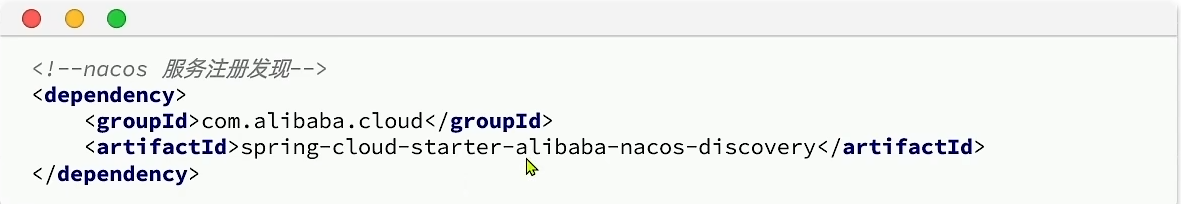
1、引入nacos discovery依赖:
<!--nacos 服务注册发现-->
<dependency>
    <groupId>com.alibaba.cloud</groupId>
    <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId>
</dependency>
2、配置Nacos地址
spring:
  application:
    name: item-service # 服务名称
  cloud:
    nacos:
      server-addr: 192.168.150.101:8848 # nacos地址
服务发现
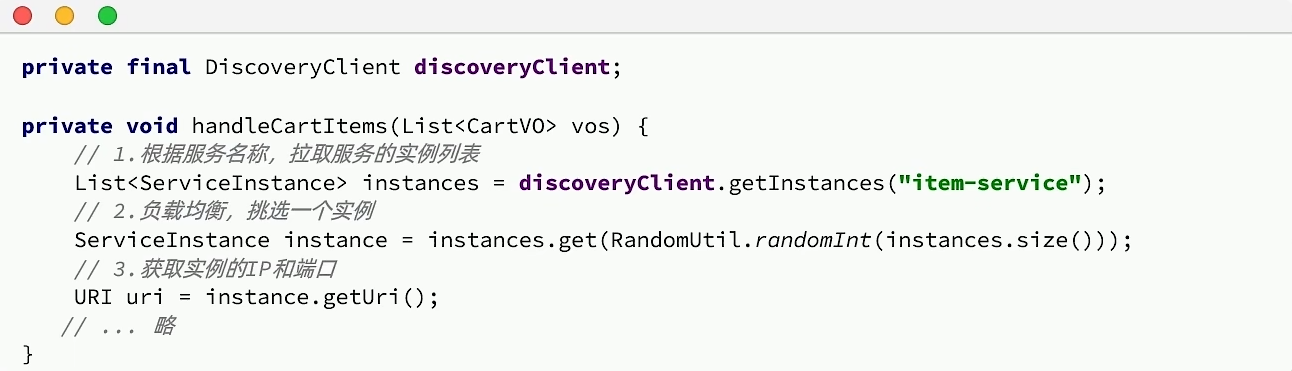
消费者需要连接nacos以拉取和订阅服务,因此服务发现的前两步与服务注册一样,后面加上服务调用即可:
1、引入nacos discovery依赖
2、配置nacos地址
3、服务发现
3、OpenFeign
快速入门
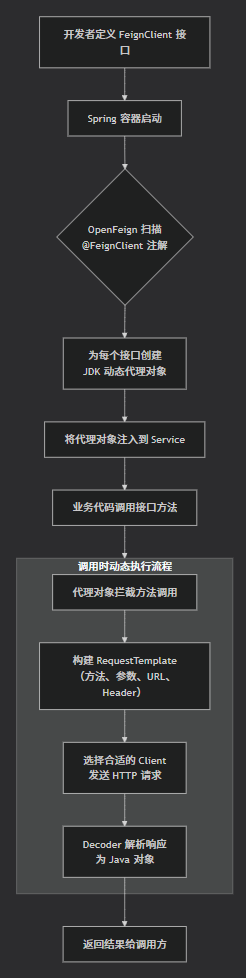
OpenFeign是一个声明式的http客户端,其作用是基于SpringMVC的常见注解,帮我们实现http请求的发送
OpenFeign已经被SpringCloud自动装配,实现简单
1、引入依赖,包括OpenFeign和负载均衡组件SpringCloudLoadBalancer
  <!--openFeign-->
  <dependency>
      <groupId>org.springframework.cloud</groupId>
      <artifactId>spring-cloud-starter-openfeign</artifactId>
  </dependency>
  <!--负载均衡器-->
  <dependency>
      <groupId>org.springframework.cloud</groupId>
      <artifactId>spring-cloud-starter-loadbalancer</artifactId>
  </dependency>
2、通过@EnableFeignClients注解,启用OpenFeign功能
@EnableFeignClients
@SpringBootApplication
public class CartApplication{ ....}
3、编写FeignClient
这里只需要声明接口,无需实现方法。接口中的几个关键信息:
-
@FeignClient("item-service"):声明服务名称 -
@GetMapping:声明请求方式 -
@GetMapping("/items"):声明请求路径 -
@RequestParam("ids") Collection<Long> ids:声明请求参数 -
List<ItemDTO>:返回值类型
@FeignClient("item-service")
public interface ItemClient {
@GetMapping("/items")
List<ItemDTO> queryItemByIds(@RequestParam("ids") Collection<Long> ids);
}4、使用FeignClient,实现远程调用
List<ItemDTO> items = itemClient.queryItemByIds(List.of(1,2,3));有上述信息,OpenFeign就可以利用动态代理帮我们实现这个方法
| 特性 | 原生方式(RestTemplate) | OpenFeign |
|---|---|---|
| 代码风格 | 命令式、模板代码多 | 声明式、简洁优雅 |
| 集成度 | 需要手动集成负载均衡等 | 与 Spring Cloud 生态无缝集成 |
| 可维护性 | 接口变更需修改多处调用代码 | 接口即契约,修改一处即可 |
| 可读性 | 业务逻辑与 HTTP 调用混杂 | 远程调用透明化,更关注业务 |
| 配置能力 | 分散、不易管理 | 集中配置,支持超时、重试、拦截器等 |
连接池
OpenFeign对Http请求做了优雅的伪装,不过其底层发起http请求,依赖于其他的框架.
三种框架:
-
HttpURLConnection:默认实现,不支持连接池
-
Apache HttpClient:支持连接池
-
OKHttp:支持连接池
使用带连接池可以减少创建连接的销毁连接的开销
OpenFeign整合OKHttp的步骤如下:
1、引入依赖:
<!--OK http 的依赖 -->
<dependency>
  <groupId>io.github.openfeign</groupId>
  <artifactId>feign-okhttp</artifactId>
</dependency>
2、开启连接池功能
feign:
  okhttp:
    enabled: true # 开启OKHttp功能
最佳实践
为了避免重复编码,有两种思路解决
方案1抽取相对简单,工程结构清晰,缺点是整个项目耦合度偏高
日志
OpenFeign默认只会在FeignClient所在包的日志级别为debug时输出日志
其日志分为四级:
-
none:不记录任何日志信息,默认值
-
basic:仅记录请求的方法,URL以及响应状态码和执行时间
-
headers:在basic的基础上,额外记录了请求和响应的头信息
-
pull:记录素有请求和响应的明细,包括头信息、请求体、元数据
日志配置:
1、定义日志级别:
public class DefaultFeignConfig {
    @Bean
    public Logger.Level feignLogLevel(){
        return Logger.Level.FULL;
    }
}
2、启动日志级别,需要配置类,有两种方式:
-
局部生效:在某个FeignClient中配置,只对当前FeignClient生效
@FeignClient(value = "item-service", configuration = DefaultFeignConfig.class)-
全局生效:在@EnableFeignClients中配置,针对所有FeignCLient生效
@EnableFeignClients(defaultConfiguration = DefaultFeignConfig.class)4、网关
网关(Gateway):就是网络的关口,负责请求的路由、转发、身份校验
顾名思义,网关就是网络的关口。数据在网络间传输,从一个网络传输到另一个网络就需要过网关来做数据的路由和转发以及安全校验
在SpringCloud中网关实现包括两种:
1、Spring Cloud Gateway(常用)
-
Spring官方出品
-
基于WebFlux响应式编程
-
无需调优即可获得优异性能
2、Netfilx Zuul
-
基于Servlet的阻塞时编程
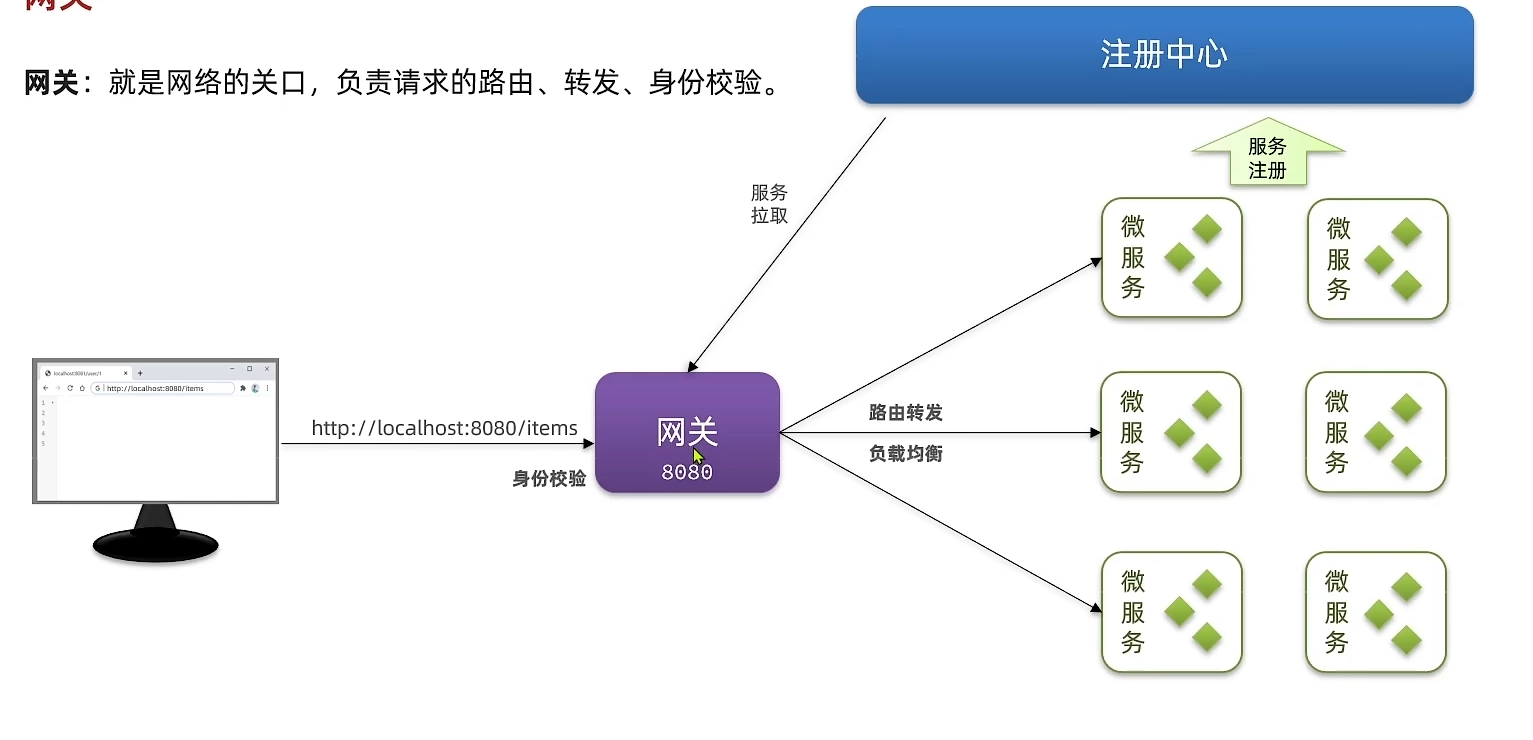
网关路由
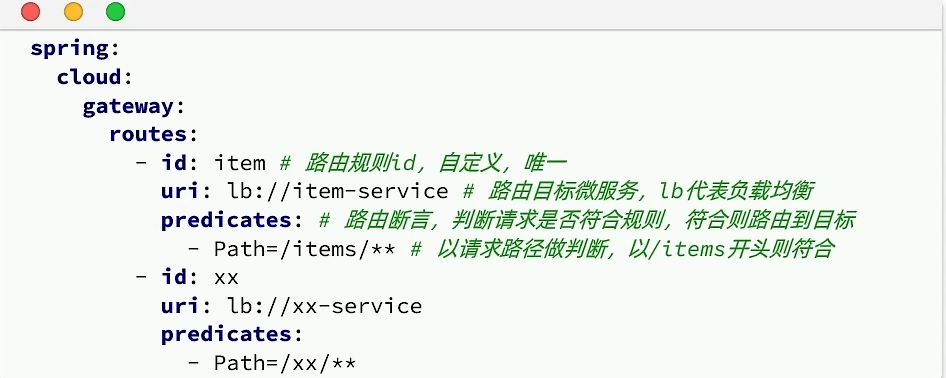
网关路由对应的java类型是RouteDefinition,常见的属性有:
-
id:路由唯一表示
-
uri:路由目标地址
-
predicates:路由断言,判断请求是否符合当前路由
-
filters:路由过滤器,对请求或响应做特殊处理
网关本身也是一个独立的微服务,因此也需要一个模块开发功能。
大概步骤如下:
-
创建网关微服务
-
引入SPringCloudGateway、NacosDiscovery依赖
-
编写启动类
-
配置网关路由
配置路由规则:
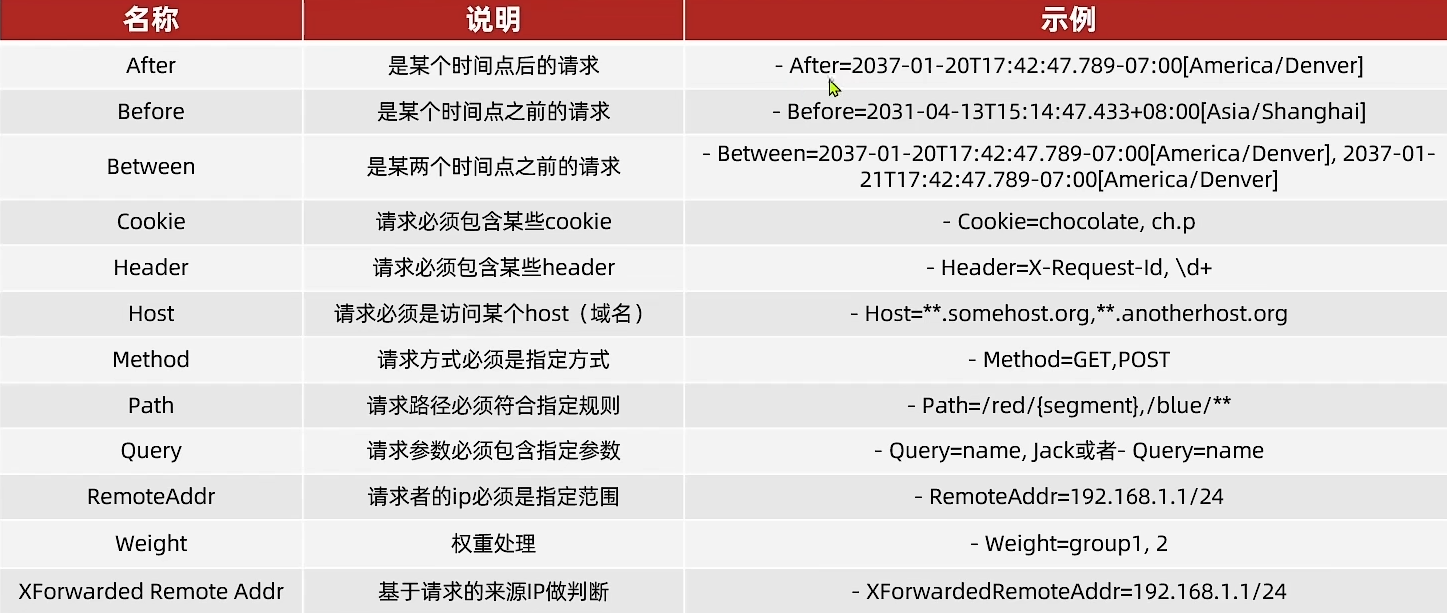
路由断言:
Spign提供了12种基本的RoutePredicateFactory实现:
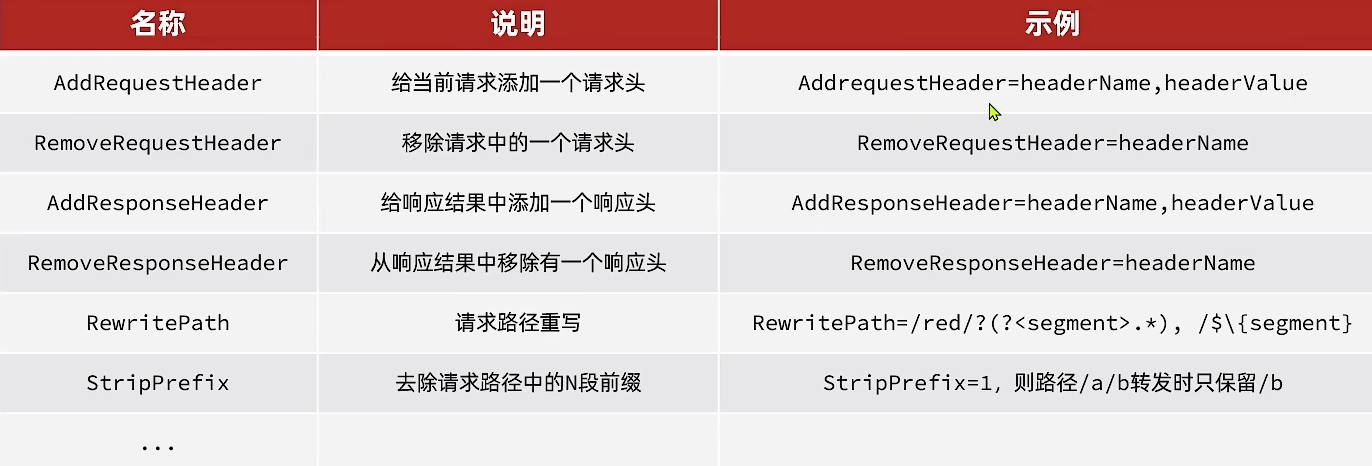
路由过滤器:
网关中提供了33种路由过滤器,每种过滤器都有独特的作用:
网关登录校验
单体架构时我们只需要完成一次用户登录、身份校验,就可以在所有业务中获取到用户信息。
而微服务拆分后,每个微服务都独立部署,不再共享数据。也就意味着每个微服务都需要做登录校验,显然不可取
JWT算法复杂,而且需要密钥,如果每个微服务都做登录检验,存在两大问题:
-
每个微服务都需要知道JWT的密钥,不安全
-
每个微服务重复编写登录校验代码、权限校验代码
网关是所有微服务的入口,一切请求都需要经过网关,所有我们可把登录校验的工作放到网关
-
只需要在网关和用户服务保存密钥
-
只需要在网关开发登录校验功能
网关过滤器
登录校验必须在请求转发到微服务之前做,否则失去意义。
网关的请求转发是Gateway内部代码实现的,要想在请求转发之前做登录校验,就必须了解Gateway内部工作的基本原理
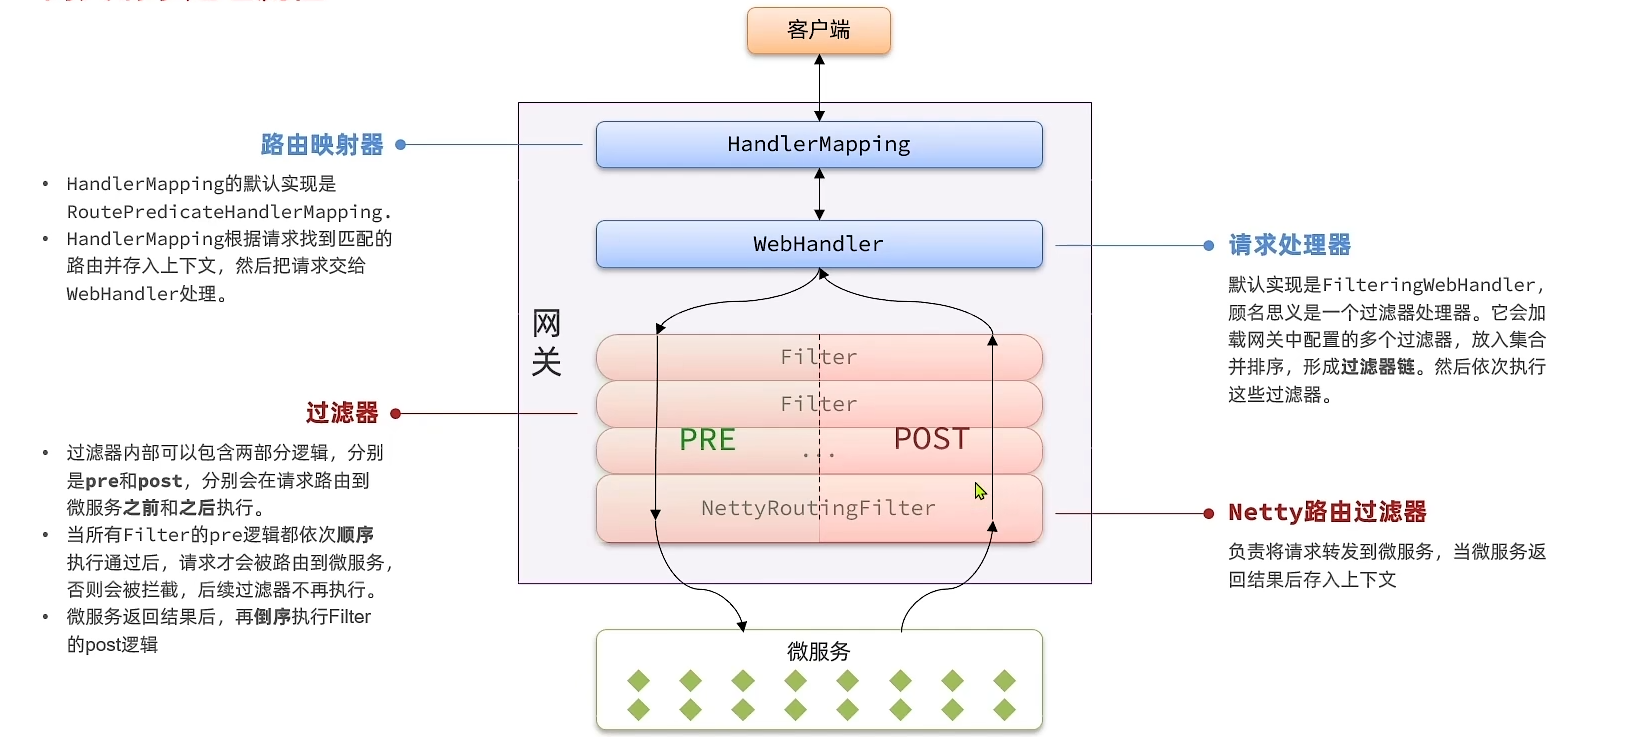
如图所示:
-
客户端请求进入网关后由
HandlerMapping对请求做判断,找到与当前请求匹配的路由规则(Route),然后将请求交给WebHandler去处理。 -
WebHandler则会加载当前路由下需要执行的过滤器链(Filter chain),然后按照顺序逐一执行过滤器(后面称为Filter)。 -
图中
Filter被虚线分为左右两部分,是因为Filter内部的逻辑分为pre和post两部分,分别会在请求路由到微服务之前和之后被执行。 -
只有所有
Filter的pre逻辑都依次顺序执行通过后,请求才会被路由到微服务。 -
微服务返回结果后,再倒序执行
Filter的post逻辑。 -
最终把响应结果返回。
如图中所示,最终请求转发是有一个名为NettyRoutingFilter的过滤器来执行的,而且这个过滤器是整个过滤器链中顺序最靠后的一个。如果我们能够定义一个过滤器,在其中实现登录校验逻辑,并且将过滤器执行顺序定义到NettyRoutingFilter之前,这就符合我们的需求了
网关过滤器链中的过滤器有两种:
-
GatewayFilter:路由过滤器,作用范围比较灵活,可以任意指定的路由由Route
-
GlobalFilter:全局过滤器,作用范围是所在路由,不可配置
实现自定义过滤器:
1、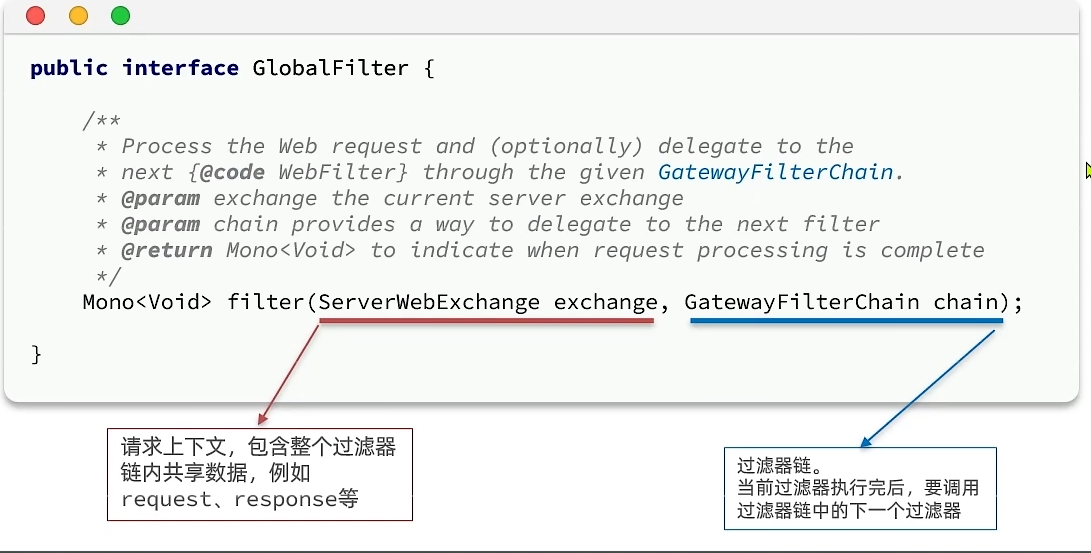
2、自定义GlobalFilter比较简单,直接实现GlobalFilter接口即可:
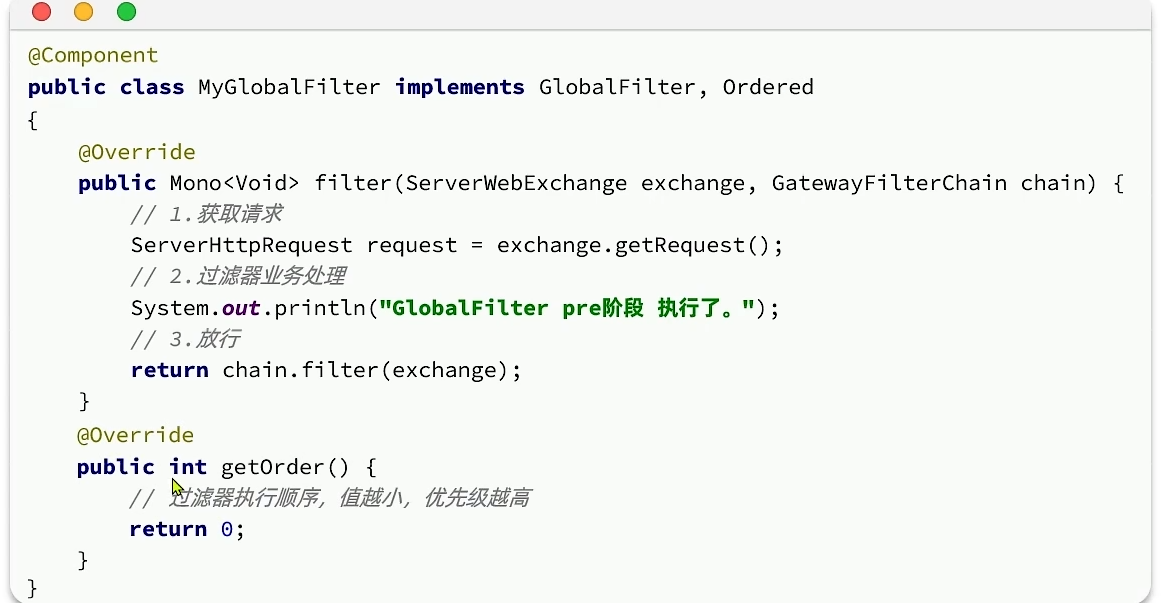
Ordered保证了自定义过滤器在NettyRoutingFilter之前执行
登录校验
-
AuthProperties:配置登录校验需要拦截的路径,因为不是所有的路径都需要登录才能访问 -
JwtProperties:定义与JWT工具有关的属性,比如秘钥文件位置 -
SecurityConfig:工具的自动装配 -
JwtTool:JWT工具,其中包含了校验和解析token的功能 -
hmall.jks:秘钥文件
其中AuthProperties和JwtProperties所需的属性要在application.yaml中配置:
hm:
  jwt:
    location: classpath:hmall.jks # 秘钥地址
    alias: hmall # 秘钥别名
    password: hmall123 # 秘钥文件密码
    tokenTTL: 30m # 登录有效期
  auth:
    excludePaths: # 无需登录校验的路径
      - /search/**
      - /users/login
      - /items/**
package com.hmall.gateway.filter;
import com.hmall.common.exception.UnauthorizedException;
import com.hmall.common.utils.CollUtils;
import com.hmall.gateway.config.AuthProperties;
import com.hmall.gateway.util.JwtTool;
import lombok.RequiredArgsConstructor;
import org.springframework.boot.context.properties.EnableConfigurationProperties;
import org.springframework.cloud.gateway.filter.GatewayFilterChain;
import org.springframework.cloud.gateway.filter.GlobalFilter;
import org.springframework.core.Ordered;
import org.springframework.http.server.reactive.ServerHttpRequest;
import org.springframework.http.server.reactive.ServerHttpResponse;
import org.springframework.stereotype.Component;
import org.springframework.util.AntPathMatcher;
import org.springframework.web.server.ServerWebExchange;
import reactor.core.publisher.Mono;
import java.util.List;
@Component
@RequiredArgsConstructor
@EnableConfigurationProperties(AuthProperties.class)
public class AuthGlobalFilter implements GlobalFilter, Ordered {
private final JwtTool jwtTool;
private final AuthProperties authProperties;
private final AntPathMatcher antPathMatcher = new AntPathMatcher();
@Override
public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) {
// 1.获取Request
ServerHttpRequest request = exchange.getRequest();
// 2.判断是否不需要拦截
if(isExclude(request.getPath().toString())){
// 无需拦截,直接放行
return chain.filter(exchange);
}
// 3.获取请求头中的token
String token = null;
List<String> headers = request.getHeaders().get("authorization");
if (!CollUtils.isEmpty(headers)) {
token = headers.get(0);
}
// 4.校验并解析token
Long userId = null;
try {
userId = jwtTool.parseToken(token);
} catch (UnauthorizedException e) {
// 如果无效,拦截
ServerHttpResponse response = exchange.getResponse();
response.setRawStatusCode(401);
return response.setComplete();
}
// TODO 5.如果有效,传递用户信息
System.out.println("userId = " + userId);
// 6.放行
return chain.filter(exchange);
}
private boolean isExclude(String antPath) {
for (String pathPattern : authProperties.getExcludePaths()) {
if(antPathMatcher.match(pathPattern, antPath)){
return true;
}
}
return false;
}
@Override
public int getOrder() {
return 0;
}
}微服务获取用户
现在,网关已经可以完成登录校验并获取登录用户身份信息。但是当网关将请求转发到微服务时,微服务又该如何获取用户身份呢?
由于网关发送请求到微服务依然采用的是Http请求,因此我们可以将用户信息以请求头的方式传递到下游微服务。然后微服务可以从请求头中获取登录用户信息。考虑到微服务内部可能很多地方都需要用到登录用户信息,因此我们可以利用SpringMVC的拦截器来实现登录用户信息获取,并存入ThreadLocal,方便后续使用。
据图流程图如下:
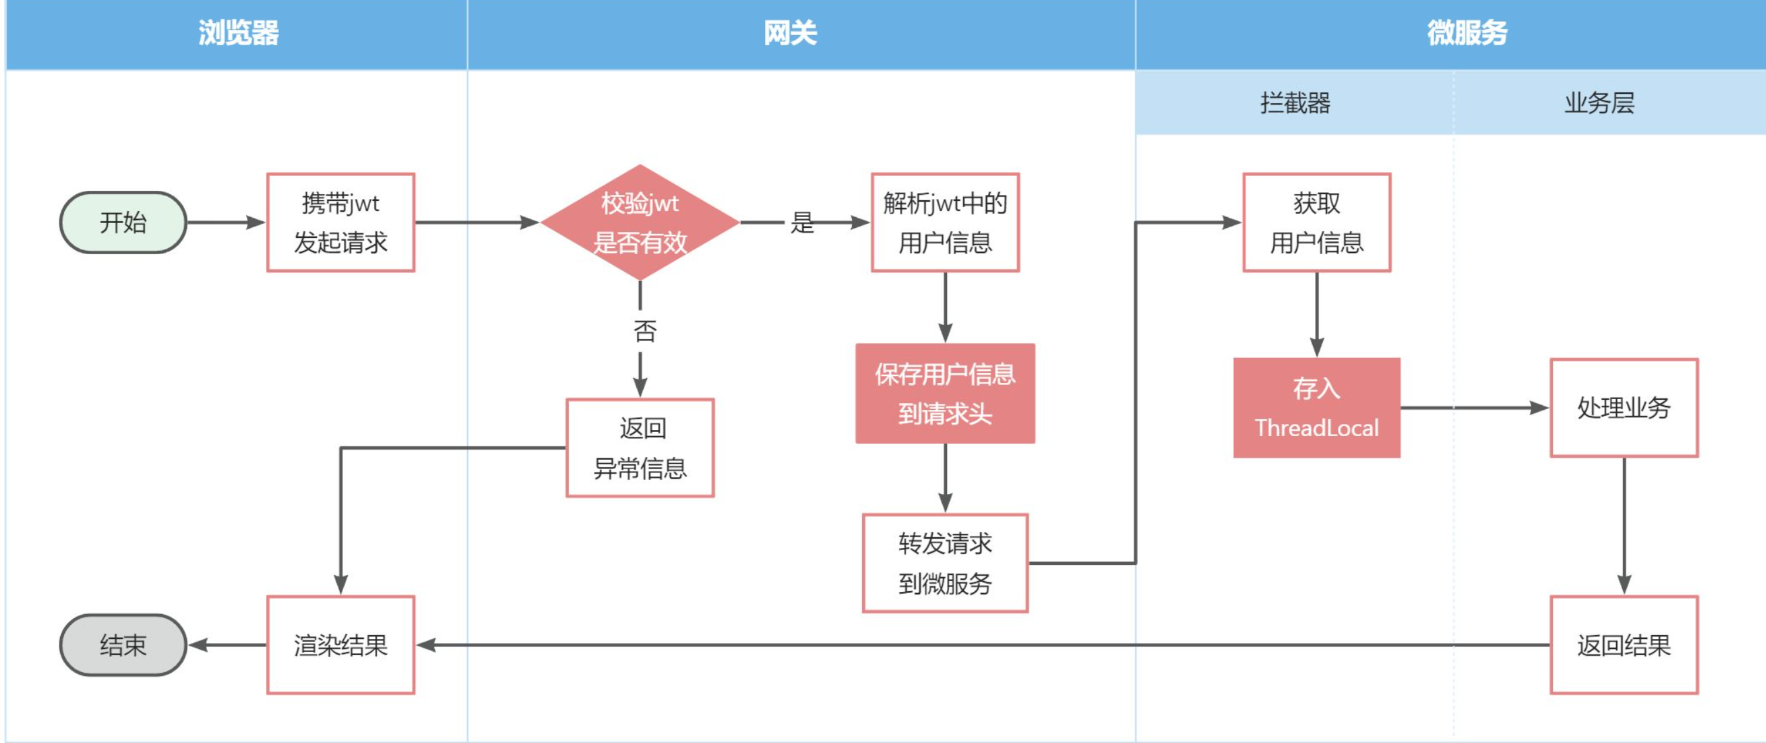
因此,接下来我们要做的事情有:
-
改造网关过滤器,在获取用户信息后保存到请求头,转发到下游微服务
-
编写微服务拦截器,拦截请求获取用户信息,保存到ThreadLocal后放行
修改网关过滤器步骤:
1、保存用户到请求头
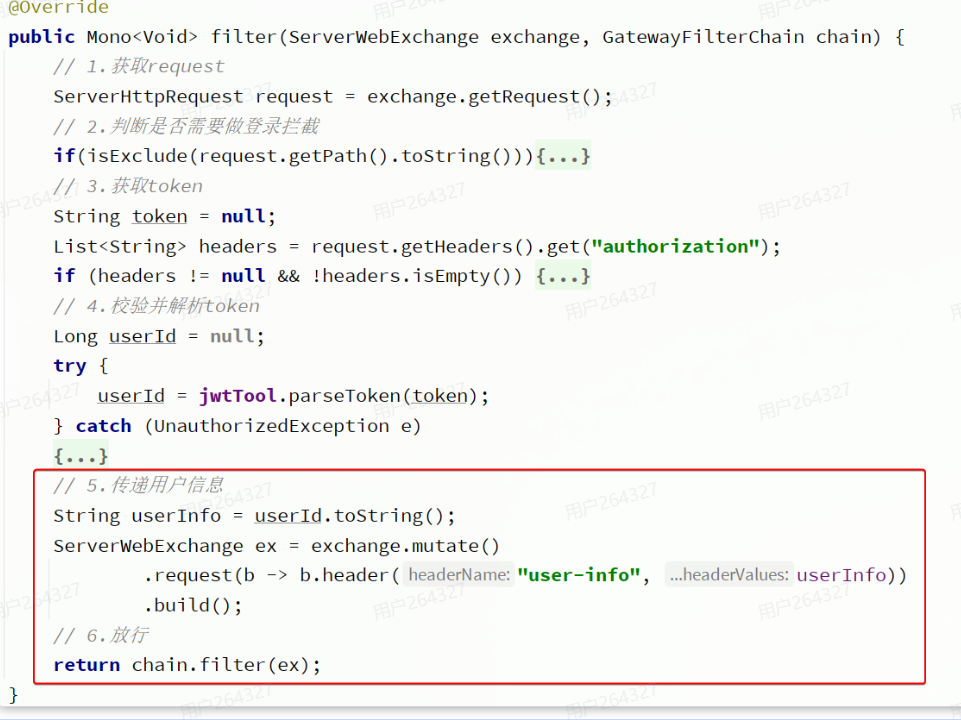
接下来,我们只需要编写拦截器,获取用户信息并保存到UserContext,然后放行即可。
由于每个微服务都有获取登录用户的需求,因此拦截器我们直接写在hm-common中,并写好自动装配。这样微服务只需要引入hm-common就可以直接具备拦截器功能,无需重复编写。
2、编写拦截器:
package com.hmall.common.interceptor;
import cn.hutool.core.util.StrUtil;
import com.hmall.common.utils.UserContext;
import org.springframework.web.servlet.HandlerInterceptor;
import javax.servlet.http.HttpServletRequest;
import javax.servlet.http.HttpServletResponse;
public class UserInfoInterceptor implements HandlerInterceptor {
@Override
public boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler) throws Exception {
// 1.获取请求头中的用户信息
String userInfo = request.getHeader("user-info");
// 2.判断是否为空
if (StrUtil.isNotBlank(userInfo)) {
// 不为空,保存到ThreadLocal
UserContext.setUser(Long.valueOf(userInfo));
}
// 3.放行
return true;
}
@Override
public void afterCompletion(HttpServletRequest request, HttpServletResponse response, Object handler, Exception ex) throws Exception {
// 移除用户
UserContext.removeUser();
}
}3、接着编写SpringMVC的配置类,配置登录拦截器
package com.hmall.common.config;
import com.hmall.common.interceptors.UserInfoInterceptor;
import org.springframework.boot.autoconfigure.condition.ConditionalOnClass;
import org.springframework.context.annotation.Configuration;
import org.springframework.web.servlet.DispatcherServlet;
import org.springframework.web.servlet.config.annotation.InterceptorRegistry;
import org.springframework.web.servlet.config.annotation.WebMvcConfigurer;
@Configuration
@ConditionalOnClass(DispatcherServlet.class)
public class MvcConfig implements WebMvcConfigurer {
@Override
public void addInterceptors(InterceptorRegistry registry) {
registry.addInterceptor(new UserInfoInterceptor());
}
}
不过,需要注意的是,这个配置类默认是不会生效的,因为它所在的包是com.hmall.common.config,与其它微服务的扫描包不一致,无法被扫描到,因此无法生效。
基于SpringBoot的自动装配原理,我们要将其添加到resources目录下的META-INF/spring.factories文件中:
org.springframework.boot.autoconfigure.EnableAutoConfiguration=\
com.hmall.common.config.MyBatisConfig,\
com.hmall.common.config.MvcConfigOpenFeign传递用户
前端发起的请求都会经过网关再到微服务,由于我们之前编写的过滤器和拦截器功能,微服务可以轻松获取登录用户信息。
但有些业务是比较复杂的,请求到达微服务后还需要调用其它多个微服务。比如下单业务,流程如下:
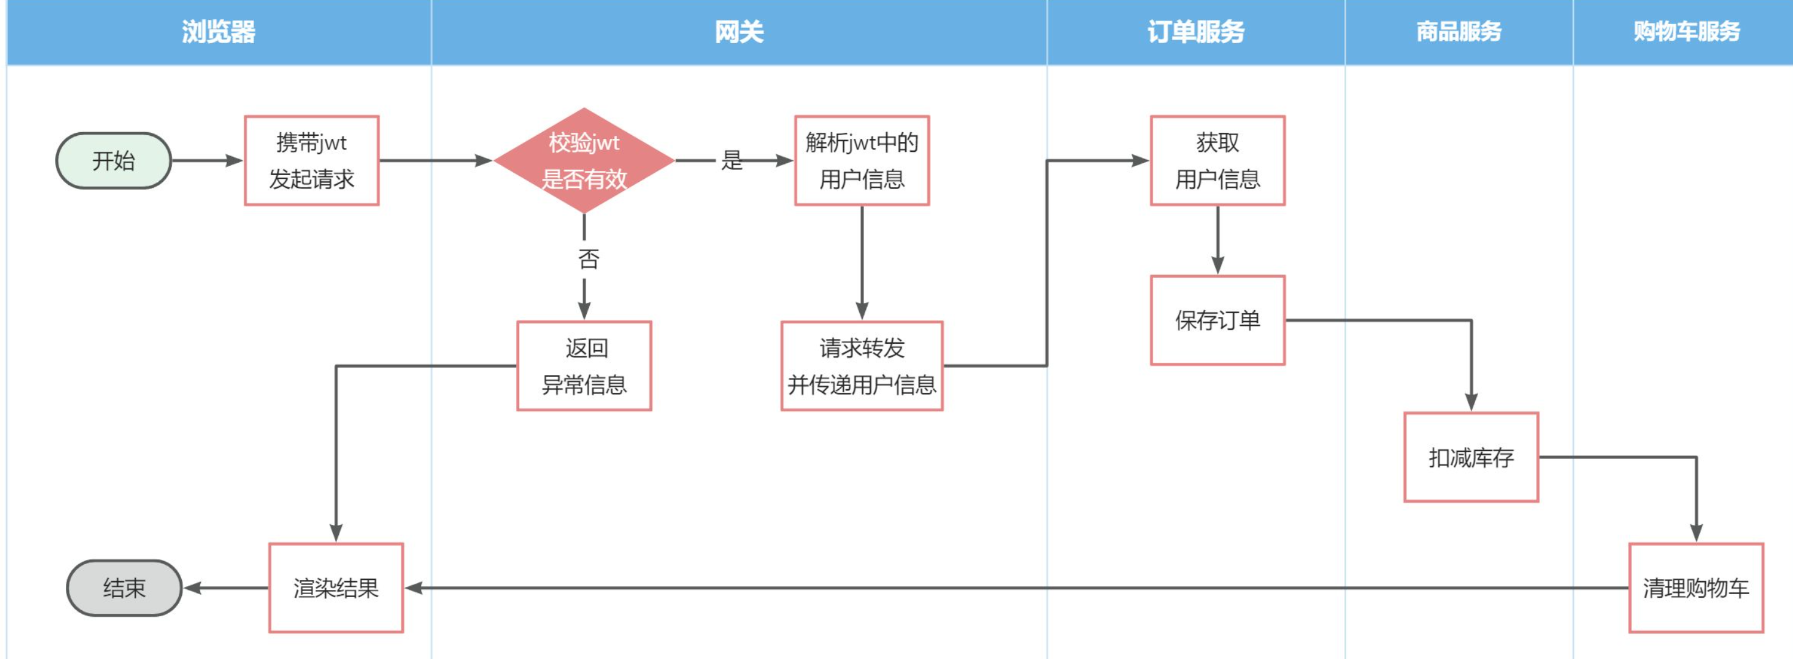
下单的过程中,需要调用商品服务扣减库存,调用购物车服务清理用户购物车。而清理购物车时必须知道当前登录的用户身份。但是,订单服务调用购物车时并没有传递用户信息,购物车服务无法知道当前用户是谁
由于微服务获取用户信息是通过拦截器在请求头中读取,因此要想实现微服务之间的用户信息传递,就必须在微服务发起调用时把用户信息存入请求头。
微服务之间调用是基于OpenFeign来实现的,并不是我们自己发送的请求。我们如何才能让每一个由OpenFeign发起的请求自动携带登录用户信息呢?
这里要借助Feign中提供的一个拦截器接口:feign.RequestInterceptor
public interface RequestInterceptor {
/**
* Called for every request.
* Add data using methods on the supplied {@link RequestTemplate}.
*/
void apply(RequestTemplate template);
}
我们只需要实现这个接口,然后实现apply方法,利用RequestTemplate类来添加请求头,将用户信息保存到请求头中。这样以来,每次OpenFeign发起请求的时候都会调用该方法,传递用户信息
@Bean
public RequestInterceptor userInfoRequestInterceptor(){
    return new RequestInterceptor() {
        @Override
        public void apply(RequestTemplate template) {
            // 获取登录用户
            Long userId = UserContext.getUser();
            if(userId == null) {
                // 如果为空则直接跳过
                return;
            }
            // 如果不为空则放入请求头中,传递给下游微服务
            template.header("user-info", userId.toString());
        }
    };
}
现在微服务之间通过OpenFeign调用也会传递登录用户信息了
5、配置管理
-
微服务重复配置过多,维护成本高
-
业务配置经常变动,每次修改都要重启服务
-
网关路由配置写死,如果变更要重启网关
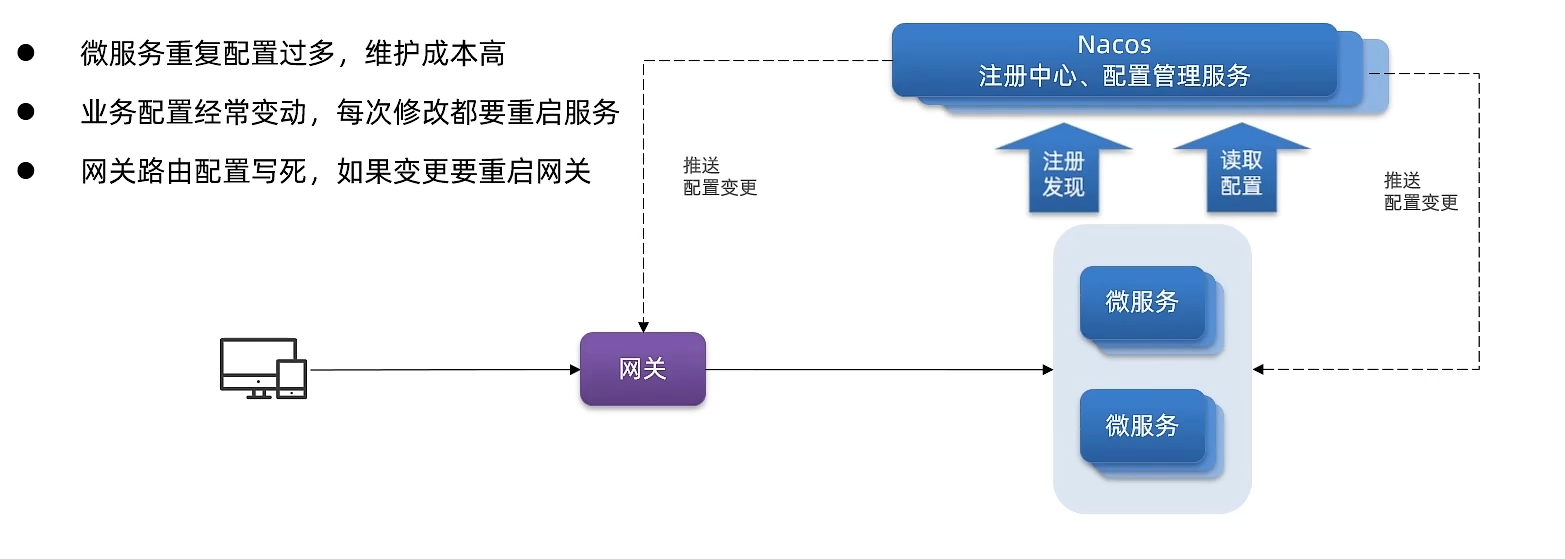
配置共享
我们可以把微服务共享的配置抽取到Nacos中统一管理,这样就不需要每个微服务都重新配置了
1、在Nacos中添加共享配置
2、微服务拉取配置
第一步:
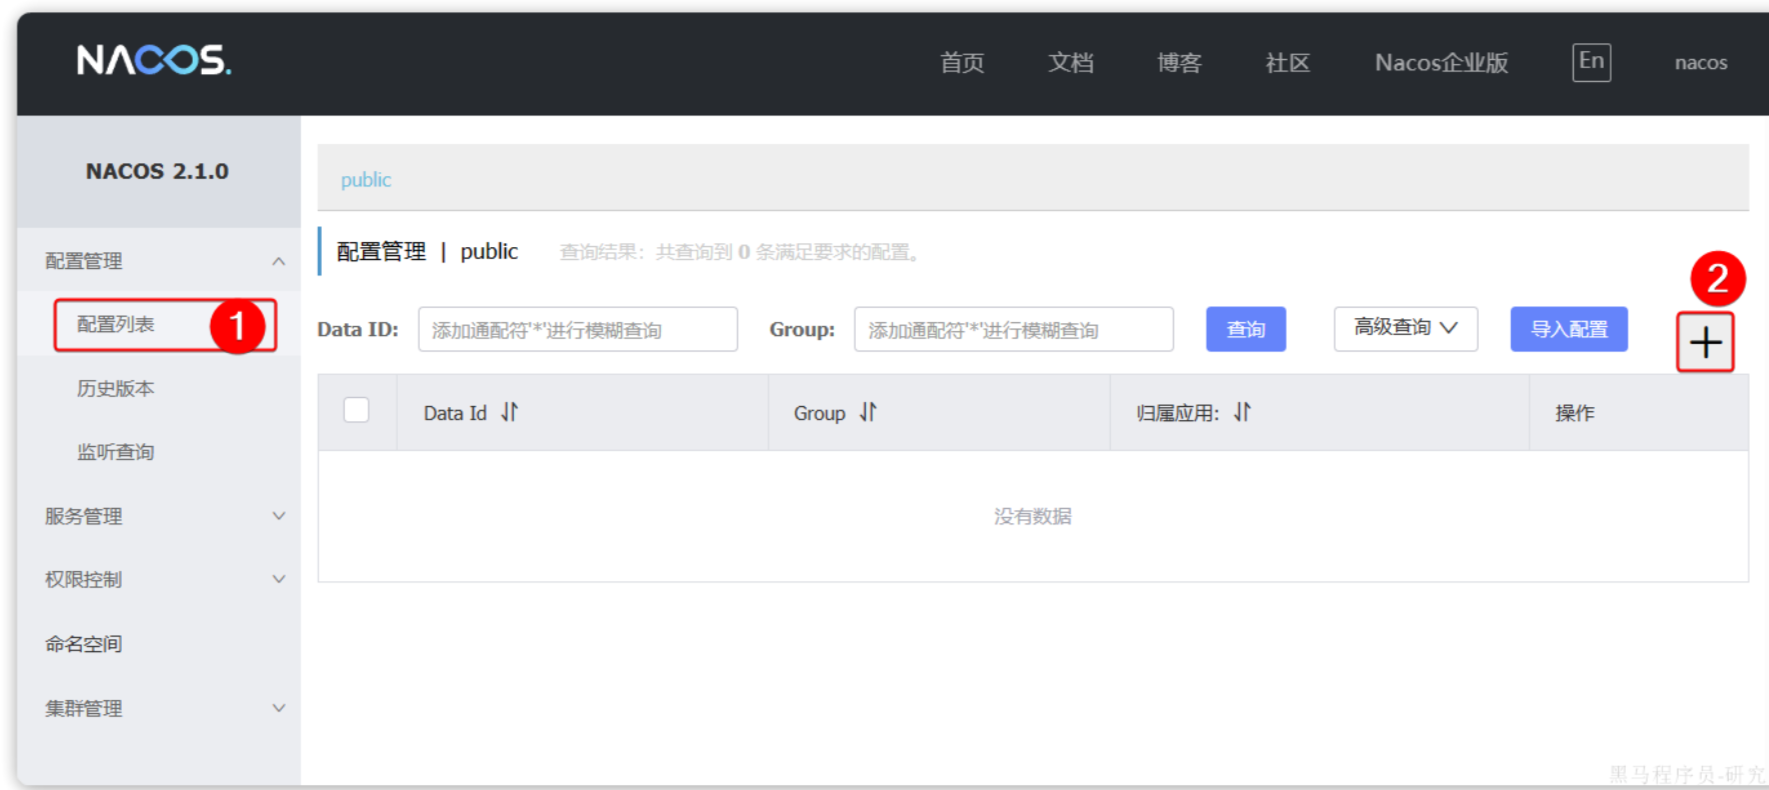
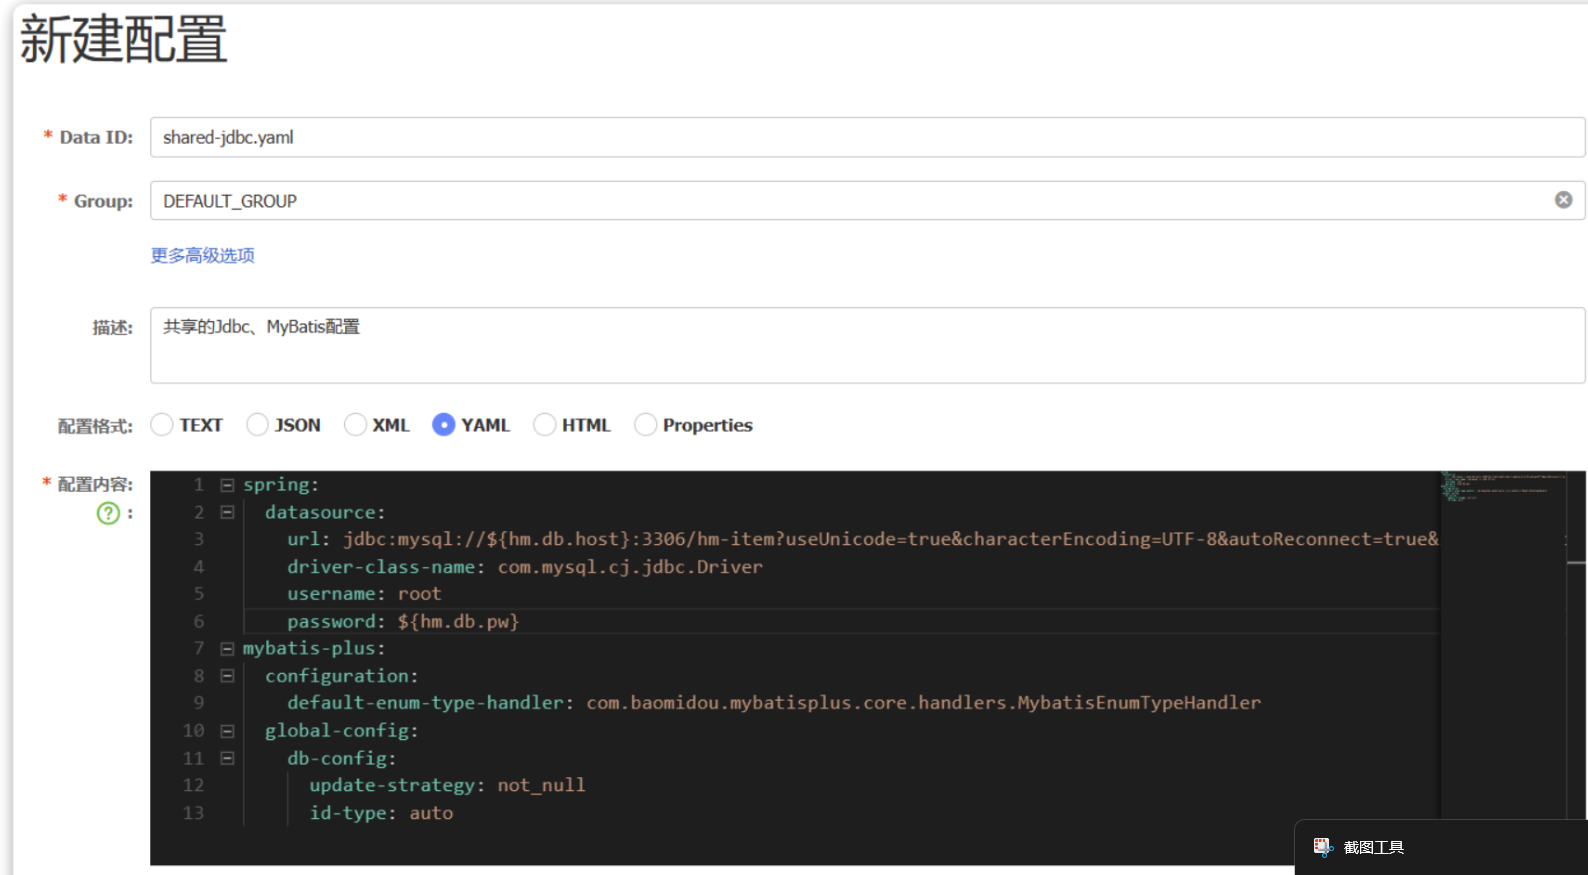
注意这里的jdbc的相关参数并没有写死,例如:
-
数据库ip:通过${hm.db.host:192.168.150.101}配置了默认值为192.168.150.101,同时允许通过${hm.db.host}来覆盖默认值 -
数据库端口:通过${hm.db.port:3306}配置了默认值为3306,同时允许通过${hm.db.port}来覆盖默认值 -
数据库database:可以通过${hm.db.database}来设定,无默认值
第二步:拉取共享配置
接下来,我们要在微服务拉取共享配置。将拉取到的共享配置与本地的application.yaml配置合并,完成项目上下文的初始化。
不过,需要注意的是,读取Nacos配置是SpringCloud上下文(ApplicationContext)初始化时处理的,发生在项目的引导阶段。然后才会初始化SpringBoot上下文,去读取application.yaml。
也就是说引导阶段,application.yaml文件尚未读取,根本不知道nacos 地址,该如何去加载nacos中的配置文件呢?
SpringCloud在初始化上下文的时候会先读取一个名为bootstrap.yaml(或者bootstrap.properties)的文件,如果我们将nacos地址配置到bootstrap.yaml中,那么在项目引导阶段就可以读取nacos中的配置了。
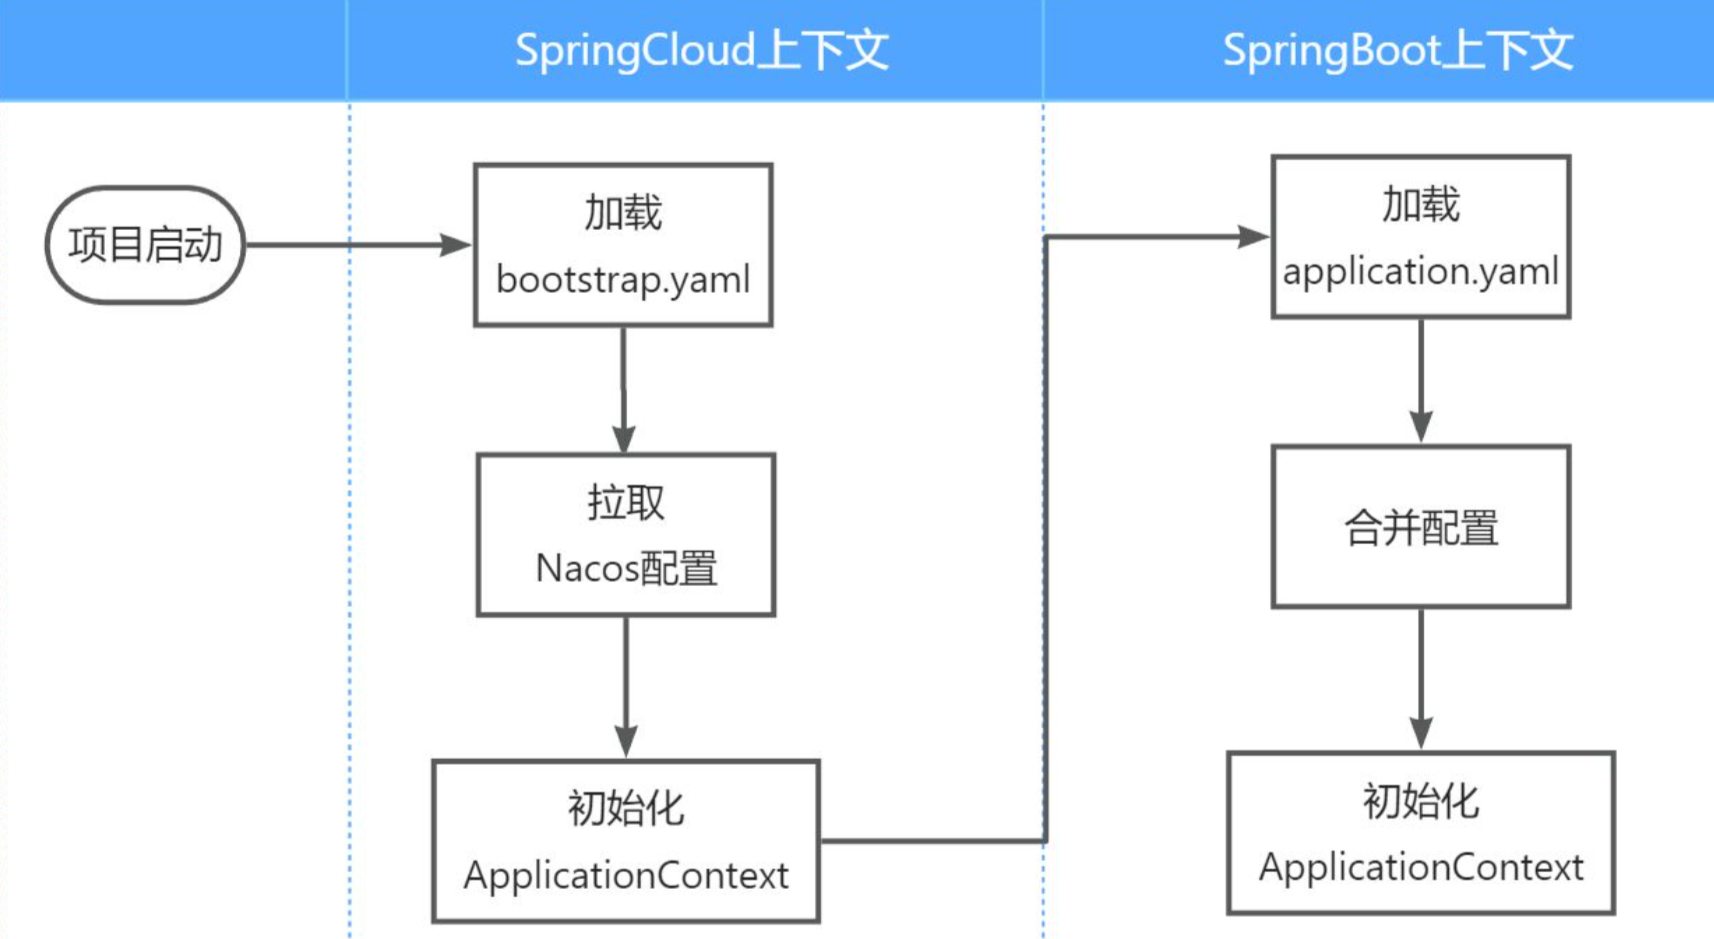
微服务整合Nacos配置管理步骤如下:
1、引入依赖
  <!--nacos配置管理-->
  <dependency>
      <groupId>com.alibaba.cloud</groupId>
      <artifactId>spring-cloud-starter-alibaba-nacos-config</artifactId>
  </dependency>
  <!--读取bootstrap文件-->
  <dependency>
      <groupId>org.springframework.cloud</groupId>
      <artifactId>spring-cloud-starter-bootstrap</artifactId>
  </dependency>
2、新建bootstrap.ymal
spring:
  application:
    name: cart-service # 服务名称
  profiles:
    active: dev
  cloud:
    nacos:
      server-addr: 192.168.150.101 # nacos地址
      config:
        file-extension: yaml # 文件后缀名
        shared-configs: # 共享配置
          - dataId: shared-jdbc.yaml # 共享mybatis配置
          - dataId: shared-log.yaml # 共享日志配置
          - dataId: shared-swagger.yaml # 共享日志配置
记得修改yaml不必要的配置
配置热更新
当修改配置文件中的配置时,微服务无需重启即可配置生效
前提条件:
1、nacos中要有一个与微服务名有关的配置文件
配置yaml文件
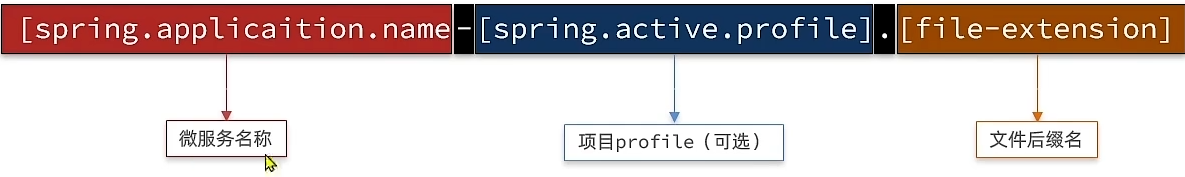
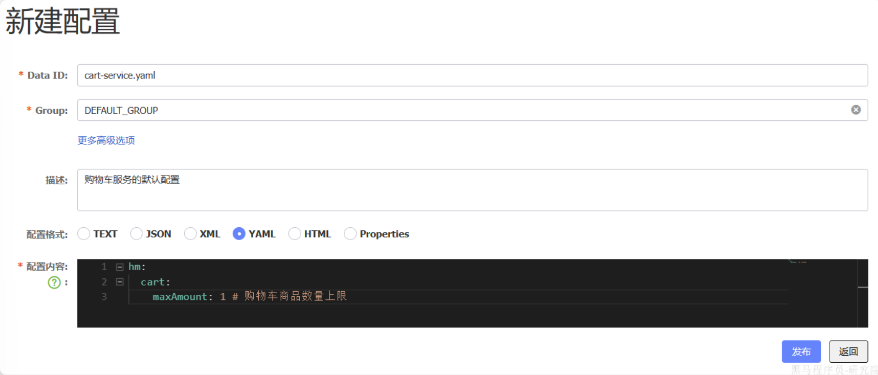
2、微服务中要以特定方式读取需要热更新的配置属性
6、微服务保护和分布式事务
雪崩问题:
微服务调用链路中的某个服务故障,引起整个链路中的所有微服务都不可用,这就是雪崩
雪崩产生的原因:
-
微服务相互调用,服务提供者出现故障或阻塞
-
服务调用者没有做好异常处理,导致自身故障
-
调用链中的所有服务级联失败,导致整个集群故障
解决雪崩思路:
-
避免服务出现故障或阻塞
-
能应对高并发请求
服务保护方案—请求限流
请求限流:限制访问微服务的请求的并发量,避免服务因流量激增出现故障
服务保护方案—线程隔离
线程隔离:也叫舱壁模式,模拟船舱隔板防水原理。通过限定每个业务能使用的线程数量而将故障业务隔离。避免故障扩散
服务保护方案—服务熔断
服务熔断:由断路器统计请求的异常比例或慢调用比例,如果超出阈值则会熔断该业务,则拦截该接口的请求。
熔断期间,所有请求快速失败,全都走fallback逻辑
服务保护方案—失败处理
失败处理: 定义fallback逻辑,让业务失败时不再抛出异常,而是返回默认数据或友好提示
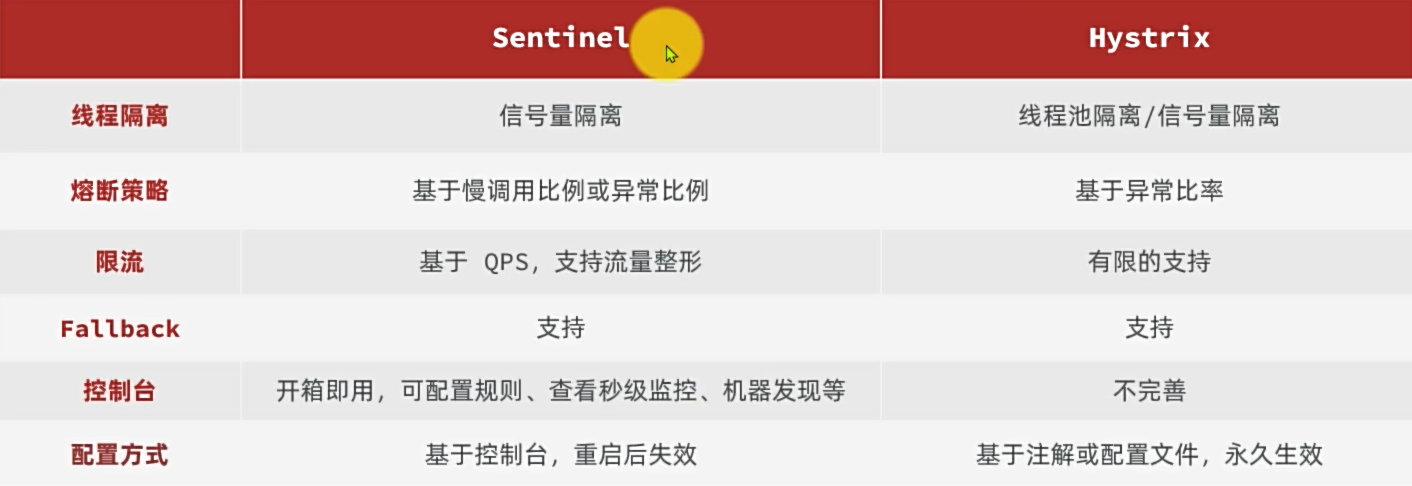
7、Sentinel
Sentinel是阿里巴巴开源的一款微服务流量控制组件
簇点链路
就是单机调用链路,是一次请求进入服务后经过的每一个Sentinel监控的资源链。默认Sentinel会监控SpringMVC的每一个HTTP接口
限流、熔断等都是针对簇点链路中的资源设置
Sentinel—Fallback
实现步骤:
1、将FeignClient作为Sentinel的簇点资源
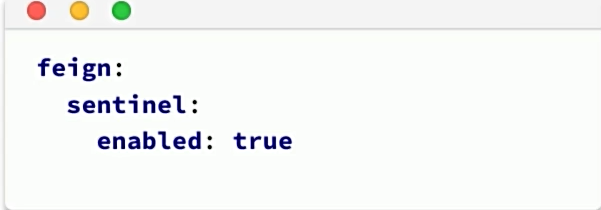
2、FeignClient的Fallback有两种配置方式:
-
FallbackClass,无法对远程调用的异常做处理
-
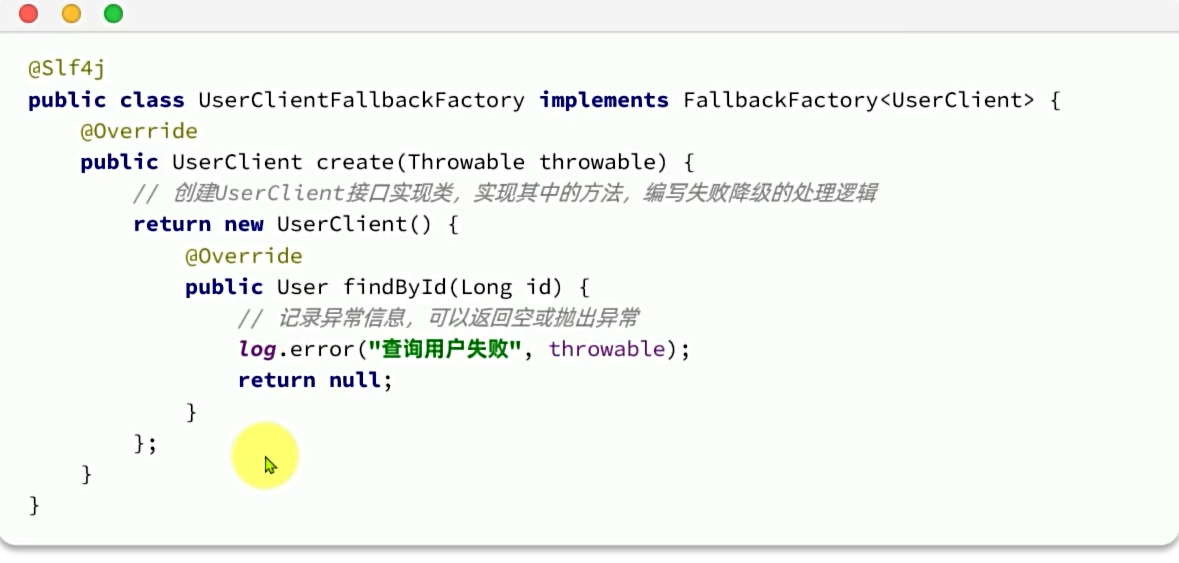
FallbackFactory,可以对远程调用的异常做处理,通常都会选择这种
3、自定义类,实现FallbackFactory,编写对某个FeignClient的fallback逻辑:
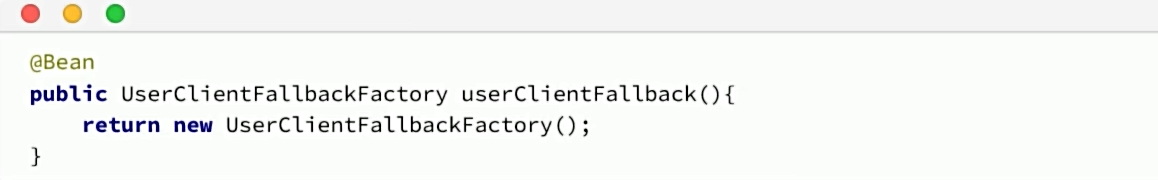
4、将刚刚定义的UserClientFallbackFactory注册为一个Bean:
5、在UserClient接口中使用UserClientFallbackFactory: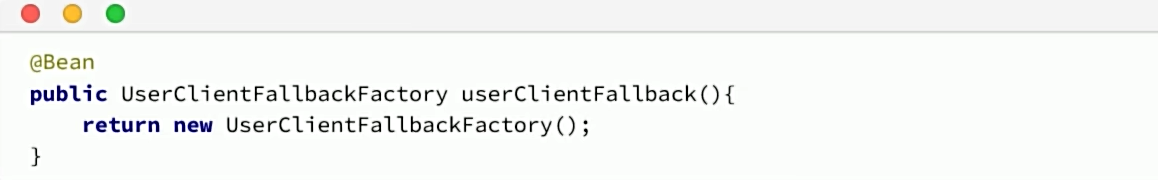
Sentinel—服务熔断
熔断是解决雪崩问题的重要手段,思路是由断路器统计服务调用的异常比例、慢请求比例,如果超出阈值则会熔断该服务。
即拦截访问该服务的一切请求,当服务恢复时,断路器会放行访问该服务的请求
断路器的三个状态:
-
Closed
-
Open
-
Half-Open
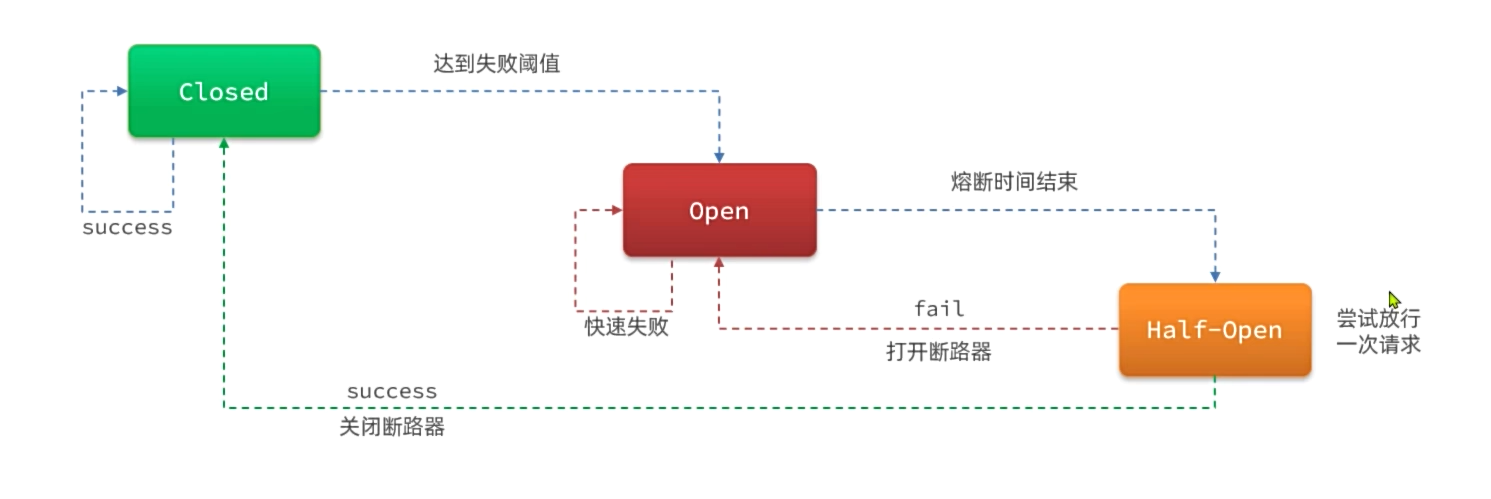
8、分布式事务
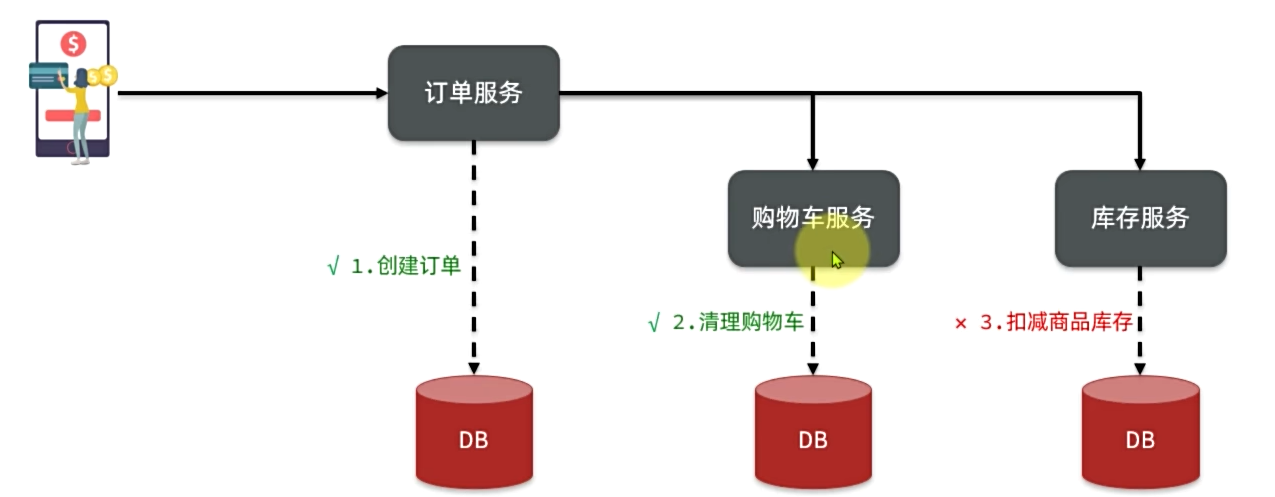
在分布式系统中,如果一个业务需要多个服务合作完成,而且每一个服务都有事务,多个事务必须同时成功或失败,这样的事务就是分布式事务
其中每个服务的事务就是一个分支事务,整个业务称为全局事务
Seata
Seata是19年开源的分布式事务解决方案,致力于提供高性能和简单易用的分布式事务服务,为用户打造一站式的分布式解决方案
Seata架构
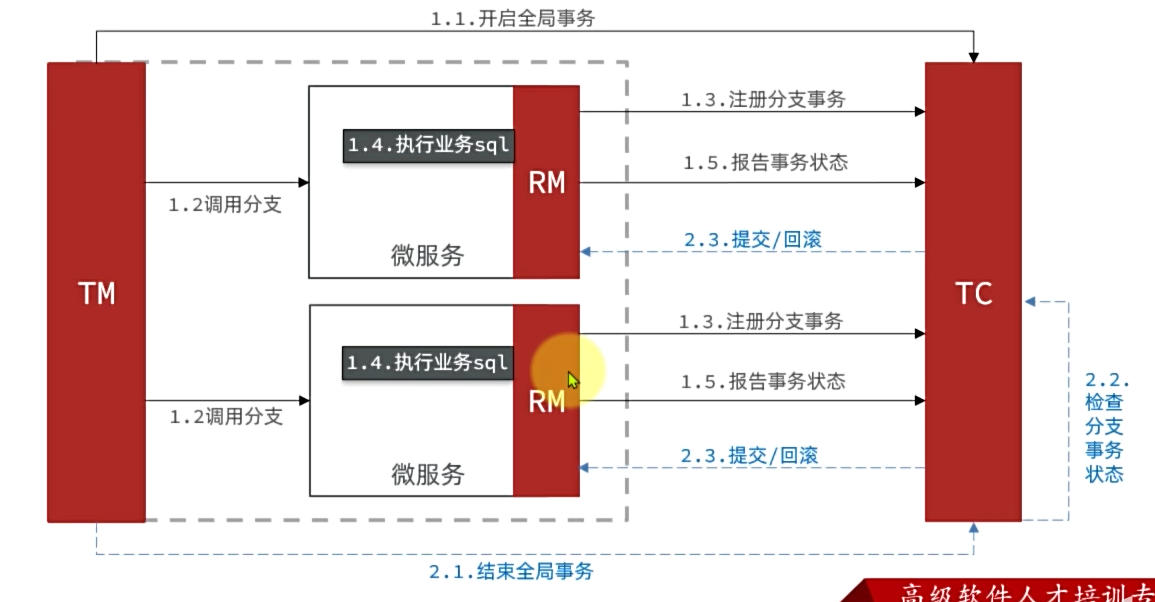
Seata事务管理中有三个重要角色:
-
TC—事务协调者:维护全局和分支事务的状态,协调全局事务提交或回滚
-
TM—事务管理器:定义全局事务的范围、开机全局事务、提交或回滚全局事务
-
RM—资源管理器:管理分支事务,与TC交谈以注册分支事务和报告分支事务的状态
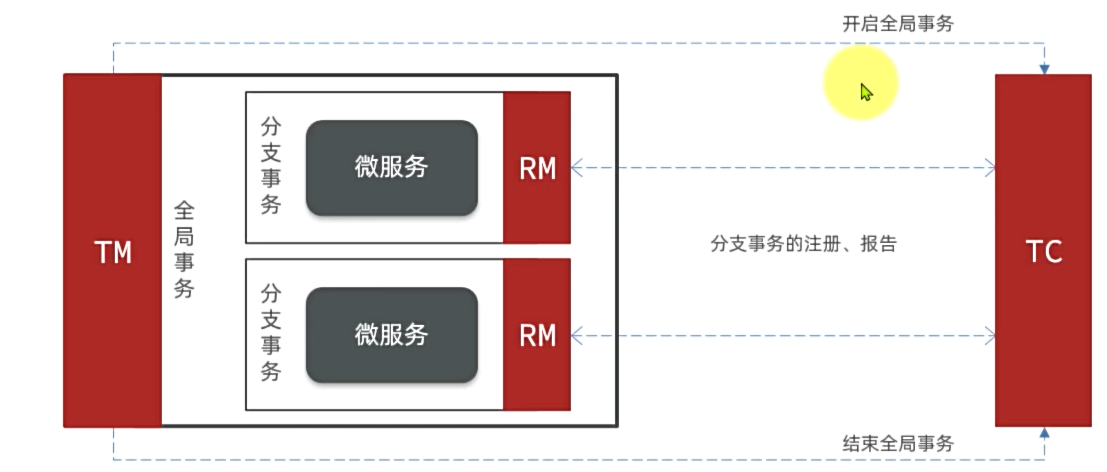
XA模式
XA规模是X/Open组织定义的分布式事务处理标准,XA规范描述了全局TM与局部的RM之间的接口,几乎所有主流的关系型数据库都对XA规范提供了支持
一阶段工作:
-
RM注册分支事务到TC
-
RM执行分支业务SQL但不提交
-
RM报告执行状态到TC
二阶段工作:
-
TC检测各分支事务执行状态
1、成功,通知所有RM提交事务
2、失败,通知所有RM回滚事务
-
RM接收TC指令,提交或回滚事务
实现XA模式:
Seata的starter已经完成了XA模式的自动装配,实现简单
1、修改application.yma文件(每个参与事务的微服务),开启XA模式:

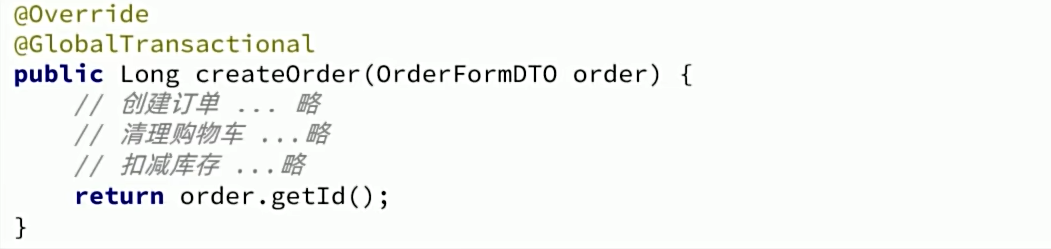
2、给发起全局事务的入口方法添加@GlobalTransactional注解
3、重启测试
AT模式
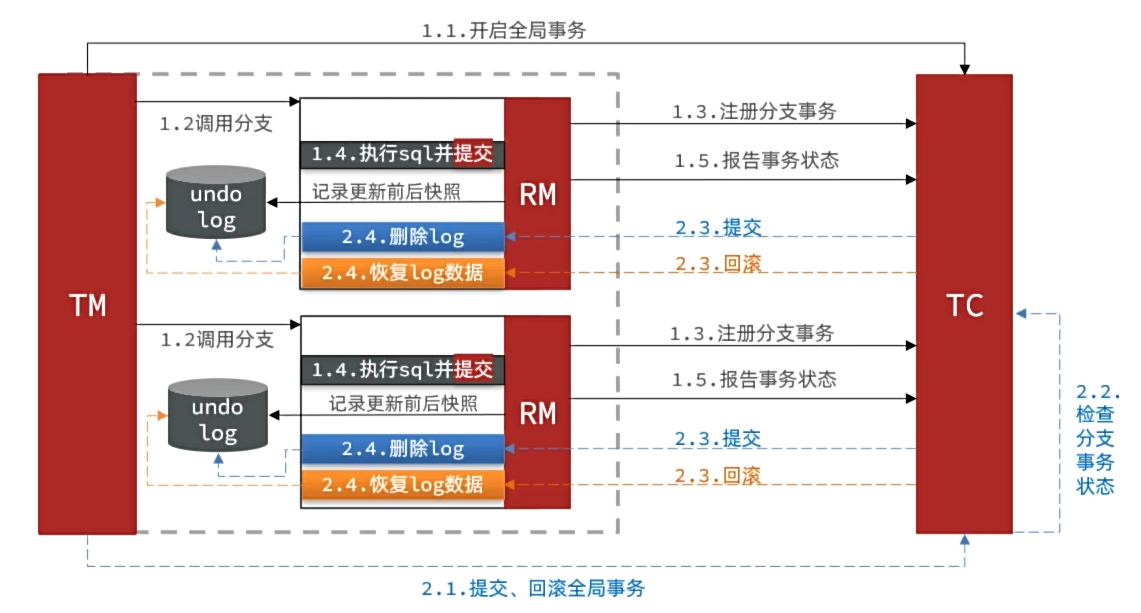
Seata主推的是AT模式,AT模式同样是分阶段提交的事务模型,不过弥补了XA模型中资源锁定周期过长的缺陷
阶段一RM的工作:
-
注册分支事务
-
记录undo-log(数据快照)
-
执行业务SQL并提交
-
报告事务状态
阶段二提交时RM的工作:
-
删除undo-log即可
阶段二回滚时RM的工作:
-
根据undo-log恢复数据到更新前
AT模式与XA模式的区别
-
XA模式一阶段不提交事务,锁定资源;AT模式一阶段直接提交,不锁定资源
-
XA模式依赖数据库机制实现回滚;AT模式利用数据快照实现数据回滚
可见,AT模式使用更加简单,无业务侵入,性能更好
更多推荐

 12
 0
- 0


 已为社区贡献1条内容

所有评论(0)