
hadoop
1.1 Hadoop是什么
1.2 Hadoop发展历史
1.3 Hadoop三大发行版本(了解)
1.4 Hadoop优势(4高)
(1)高可靠性:Hadoop底层维护多个数据副本,所以即使Hadoop某个计算元素或存储出现故障,也不会导致数据的丢失。
(2) 高扩展性:在集群间分配任务数据,可方便的扩展数以干计的节点。
(3) 高效性:在MapReduce的思想下,Hadoop是并行工作的,以加快任务处理速度。
(4) 高容错性:能够自动将失败的任务重新分配。
1.5 Hadoop组成
1.5.1 HDFS架构概述
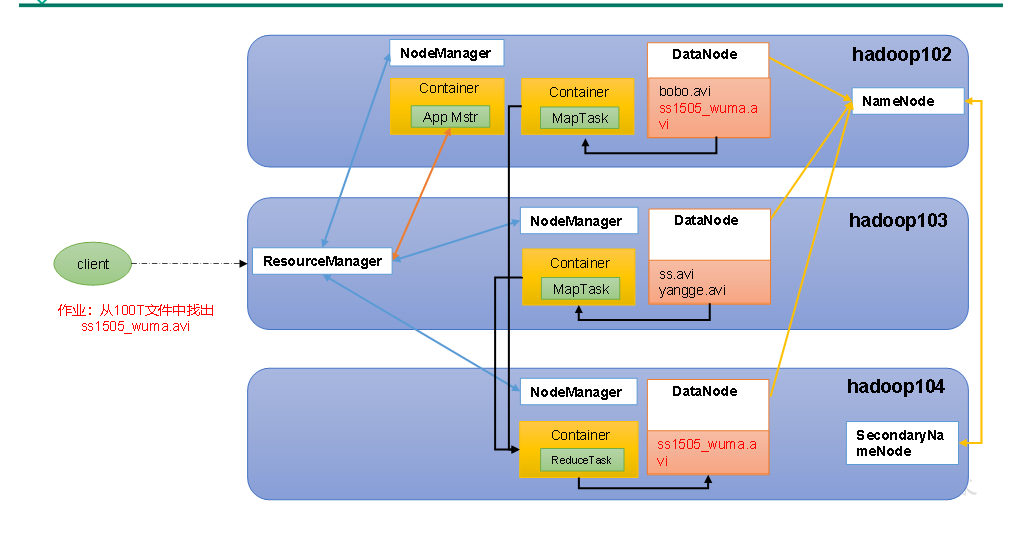
1) NameNode:存储文件的元数据,如文件名、文件目录结构、文件属性(生成时间、副本数、文件权限),以及每个文件的块列表和块所在的DataNode等。
(2) DataNode:在本地文件系统存储文件块数据,以及块数据的校验和。
(3) Secondary NameNode:#隔一段时间对NameNode元数据备份。
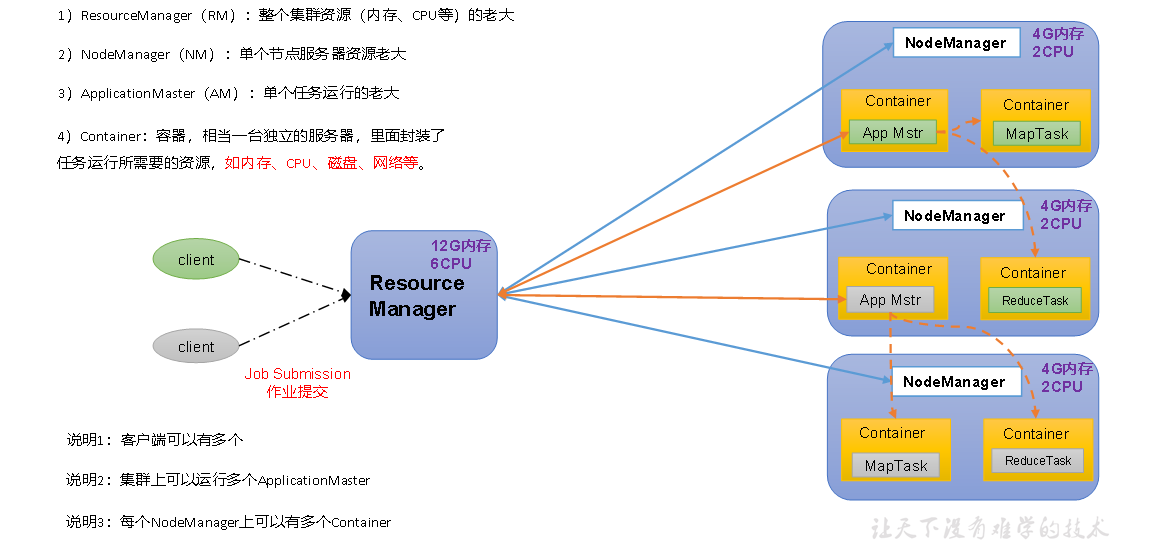
1.5.2 YARN架构概述
1.5.3 MapReduce架构概述
MapReduce将计算过程分为两个阶段:Map和Reduce
1)Map阶段并行处理输入数据
2)Reduce阶段对Map结果进行汇总
1.5.4 HDFS、YARN、MapReduce三者关系
测试集群环境
启动hdfs start-dfs.sh 关闭stop-dfs.sh
yarn同理。
启动顺序:start-dfs.sh 和start-yarn.sh
关闭顺序:stop-dfs.sh和stop-yarn.sh
实验一:测试hdfs上传文件
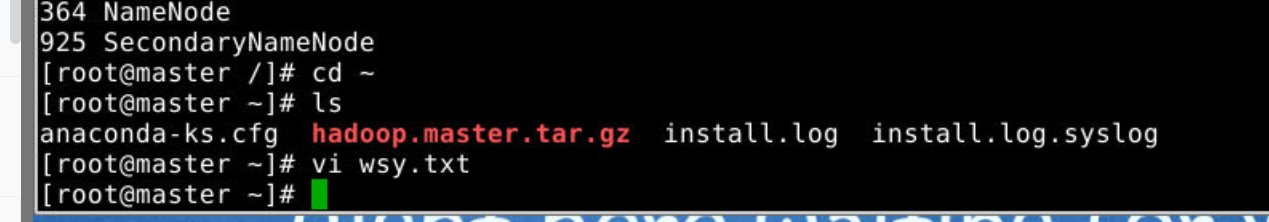
1.在一台机器上创建一个wsy.txt
2.创建一个hdfs的文件夹
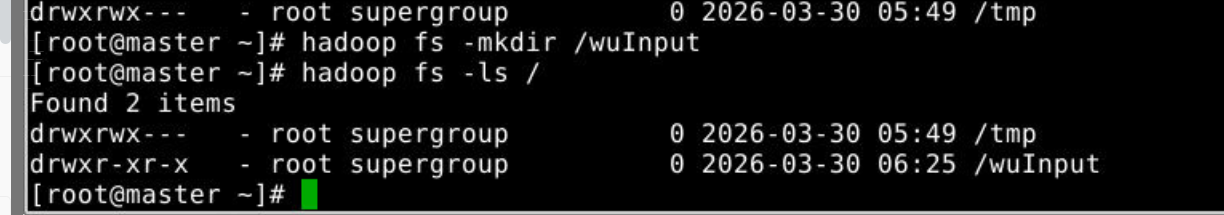
3.将本地文件上传到hdfs系统
Hadoop fs -put本地文件地址和名字 上传到hdfs的地址
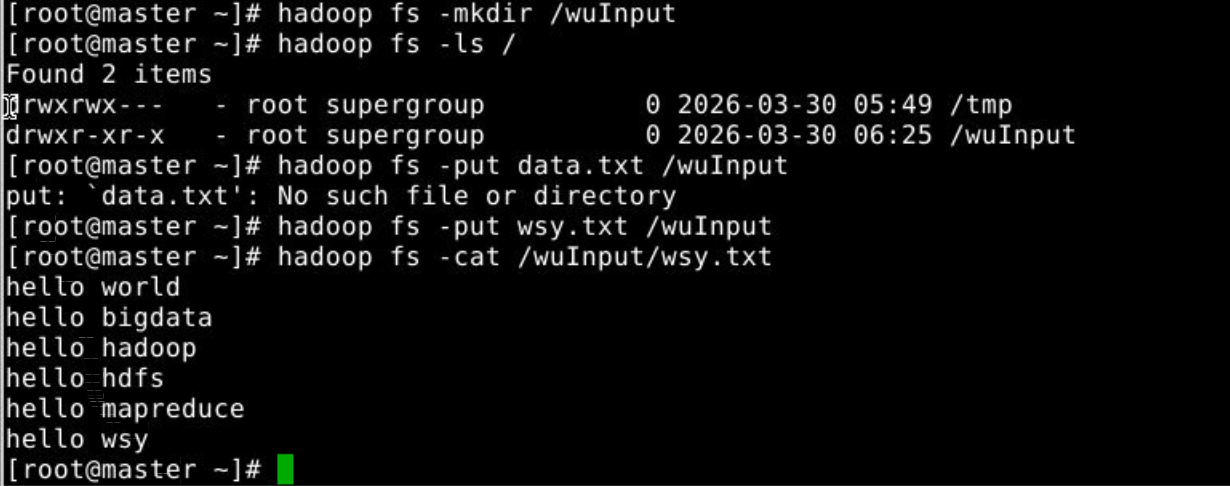
4.查看文件上传成功
hadoop fs -cat文件地址和文件名
查看hdfs系统里面的文件内容
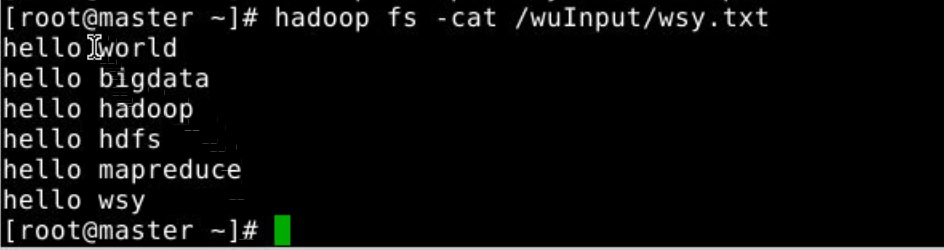
逻辑地址:(例如qq邮箱)(hdfs系统/wuInput/wsy.txt)hdfs默认存3份 slave1,slave2,slave3,master(分配机制只存储了3台,其中一台没有)
怎么去看存在那几台?
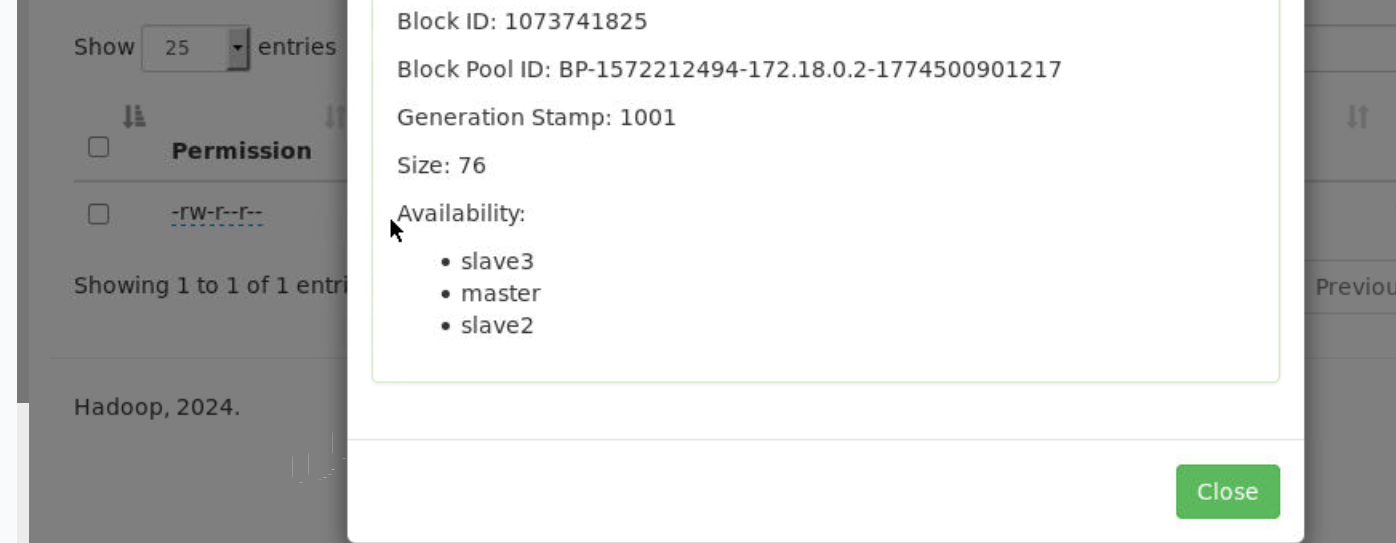
存在了slave3,master,slave2
在排在第一个的slave3里面执行以下代码:

最后的地址:/usr/local/hadoop/tmp/dfs/data/current/BP-1572212494-172.18.0.2-1774500901217(自己的块id名字)/current/finalized/subdir0/subdir0
物理地址:(例如c盘里的文件)//// hdfs-site.xml里面记录了实际的物理地址:
/usr/local/hadoop/tmp/dfs/data
实验二:测试上传大文件
1.在hdfs系统创建一个文件夹存放大文件
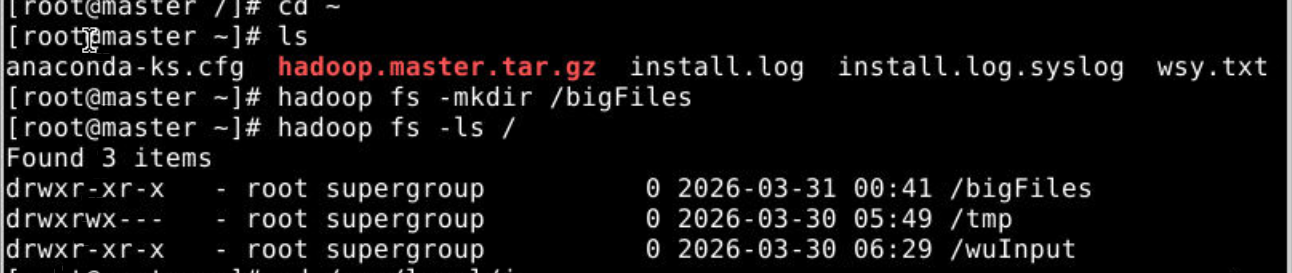
2.本地大文件上传到hdfs系统
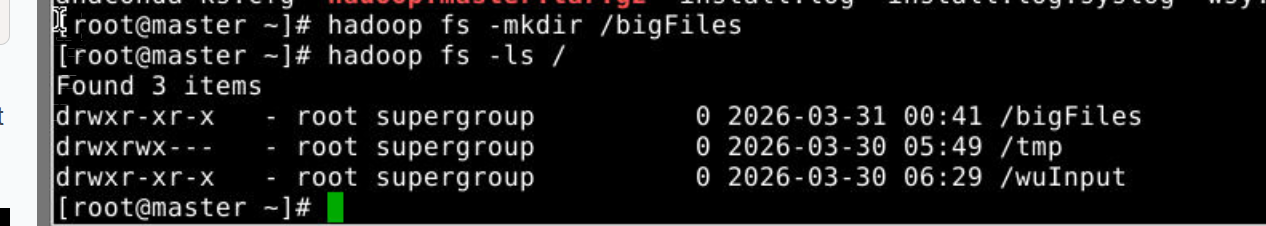
3.需要知道大文件在hdfs系统怎么存放的

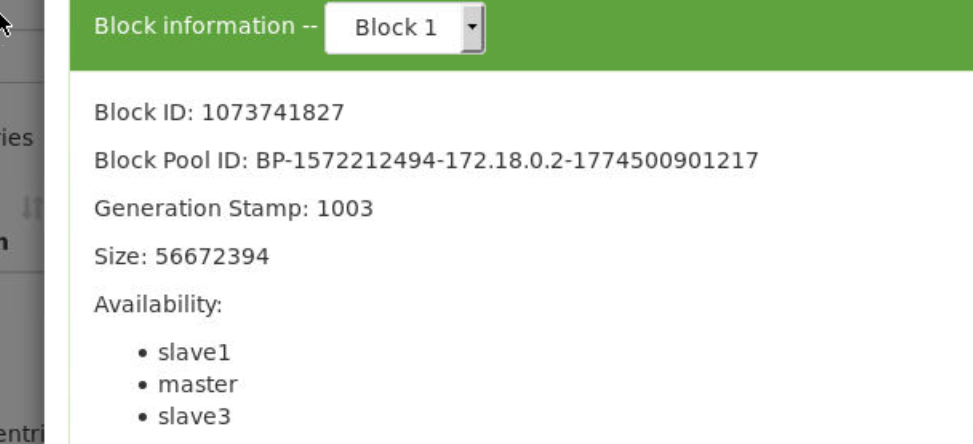
所有的文件都是按照块存储,大文件可能会分为多个块进行存储(例如上图,分了两个块分别进行存放)
hdfs系统里面的bigFiles/jdk-8u171-linux-x64.tar.gz是逻辑地址
物理地址,真正存放的路径是/usr/local/hadoop/tmp/dfa/data
通过物理地址查看文件(去两个块都存在的机器,例如master/slave3)
cd /usr/local/hadoop/tmp/dfs/data/current/BP-1572212494-172.18.0.2-1774500901217(自己的块id名字)/current/finalized/subdir0/subdir0
先到这个路径,可以看到有两个新的块
将两个块文件合并
cat blk_1073741826 >> tmp.tar.gz
cat blk_1073741827 >> tmp.tar.gz
解压:tar -zxvf tmp.tar.gz再ls查看
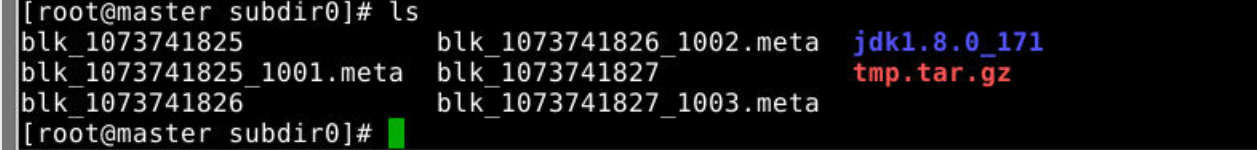
压缩:tar -zcvf tmp.tar.gz
测试wordcount
1.
2.hadoop jar hadoop-mapreduce-example-3.4.0.jar wordcount /wuInput/wsy.txt /wOutput1
hadoop jar jar包的位置jar里面的那个方法输入路径 输出路径(一定是之前不存在的)

3.
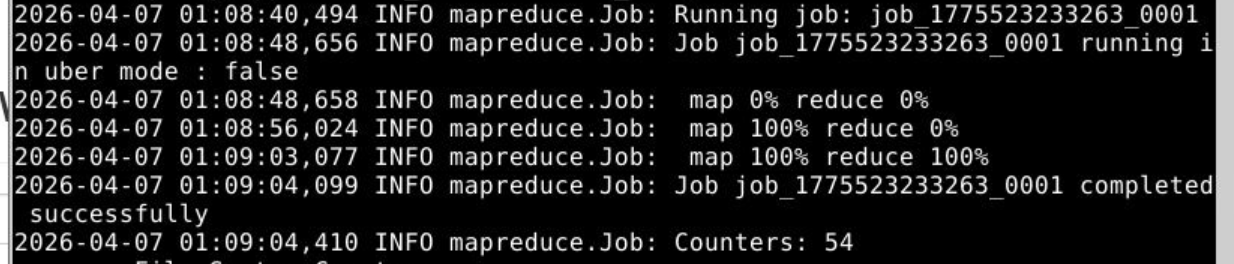
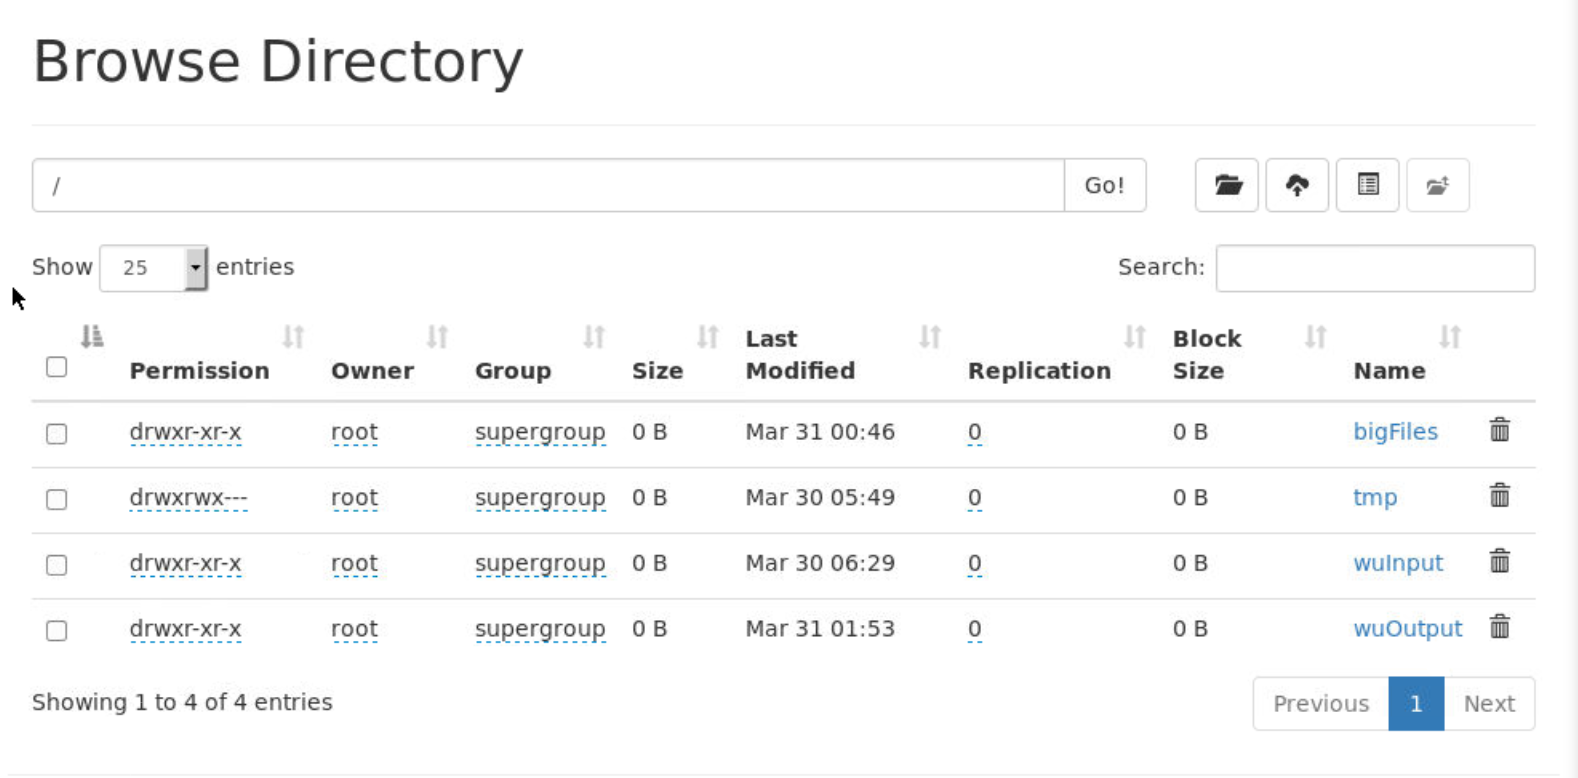
多了一个wuOutput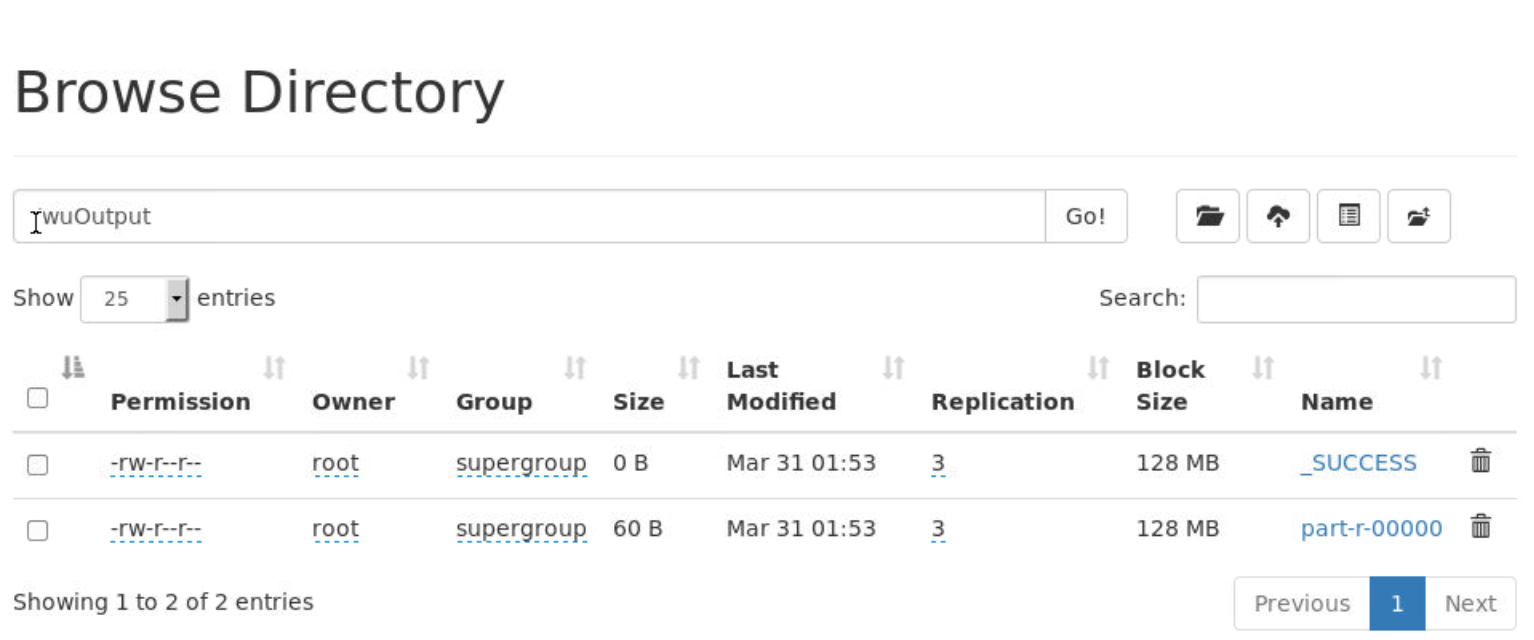
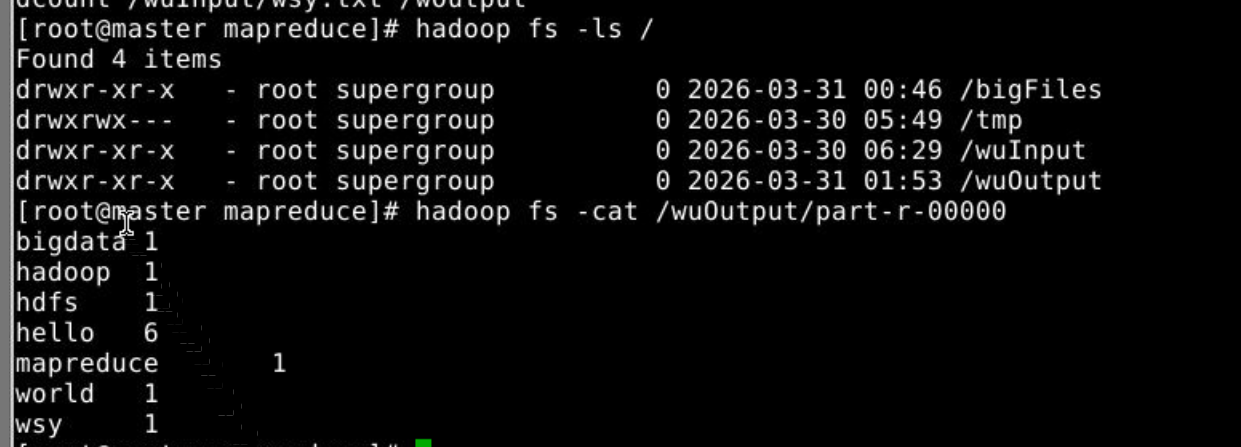
如下图:可以看到统计了单词出现的频率
第二章面试重点
1.常用端口号:
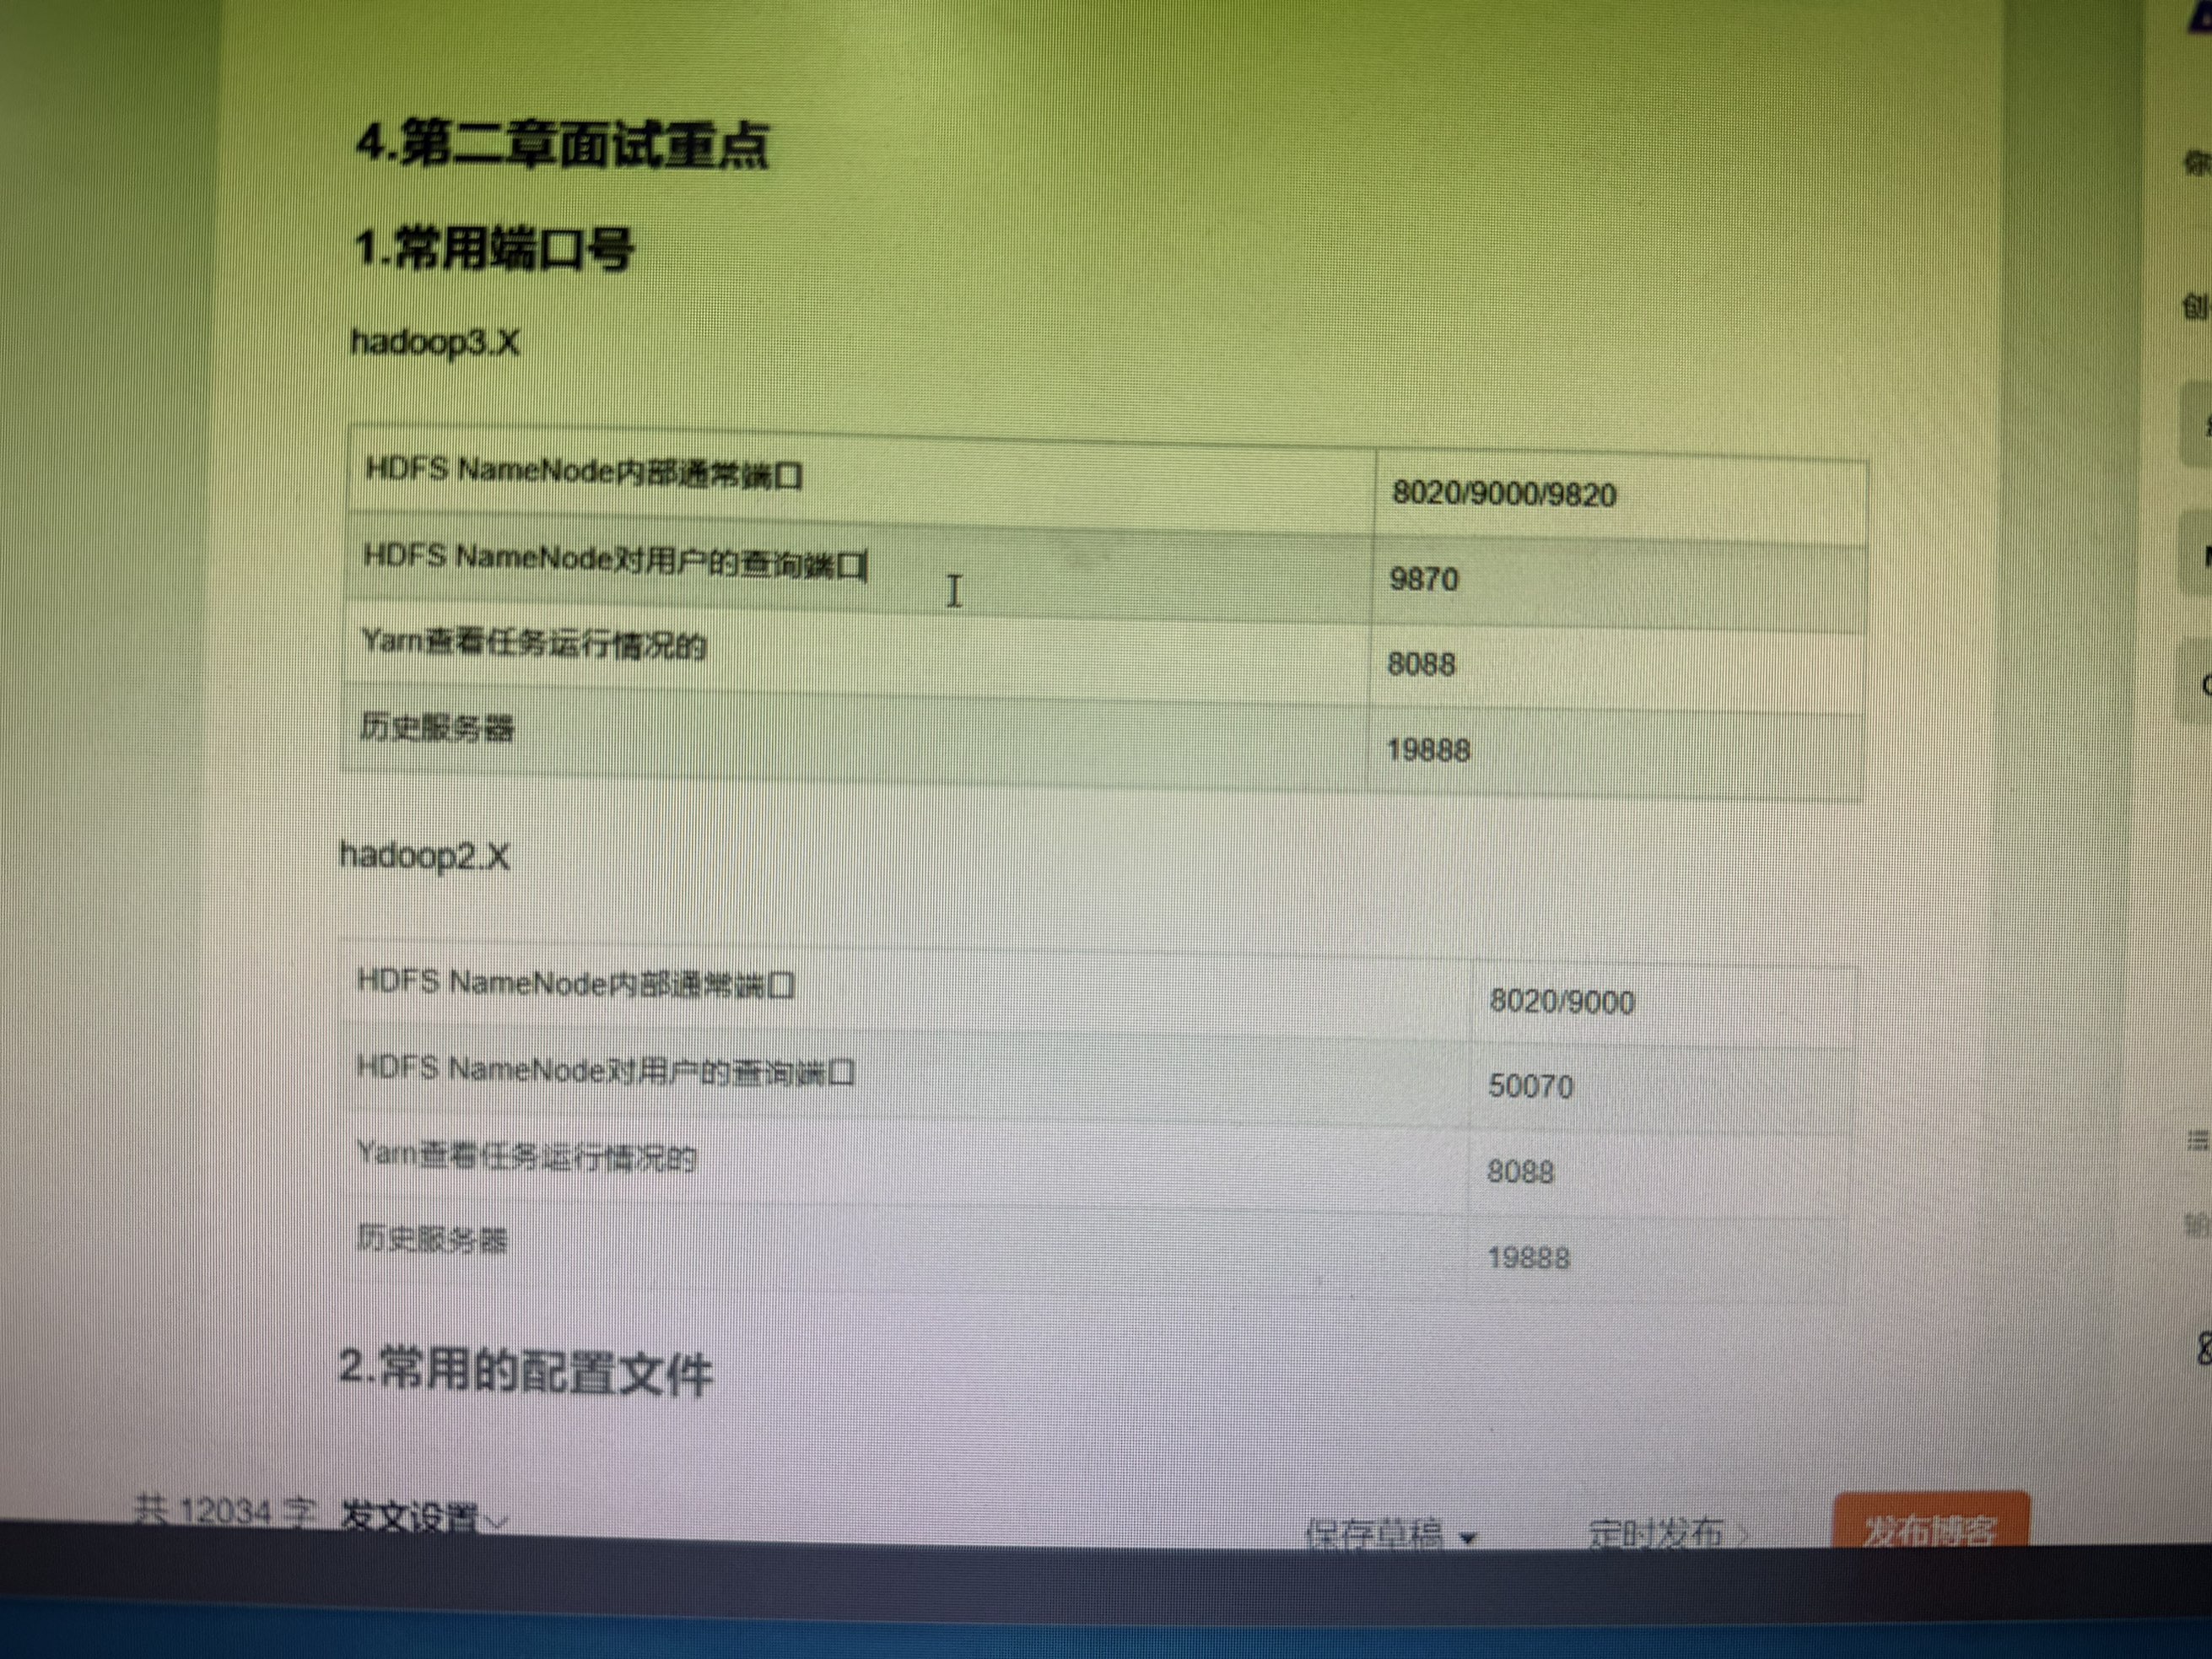
常用的配置文件:
hadoop3.x core-site.xml hdfs-site.xml yarn-site.xml mapred-site.xml workers /hadoop/etc/hadoop
2.x core-site.xml hdfs-site.xml yarn-site.xml mapred-site.xml slave3
HDFS
一、概述
1.1HDFS产生背景
随着数据量越来越大,在一个操作系统存不下的数据,那么就分配到更多的操作系统管理的磁盘中,但是不方便管理和维护,迫切需要一种系统来管理多台机器上的文件,这就是分布式文件管理系统。HDFS只是分布式文件管理系统中的一种。
1.2HDFS定义
HDFS(Hadoop Distributed File System),它是一个文件系统,用于存储文件,通过目录树来定位文件;其次,它是分布式的,由很多服务器联合起来实现其功能,集群中的服务器有各自的角色。
HDFS的使用场景:适合一次写入,多次读出的场景,且不支持文件的修改。适合用来做数据分析,并不适合用来做网盘应用。
1.3 HDFS 优缺点
优点:
(1)高容错性
数据自动保存多个副本。它通过增加副本的形式,提高容错性。
某个副本丢失后,它可以自动恢复。
(2)适合处理大数据
数据规模:能够处理数据规模到GB、TB,甚至PB级别的数据。
文件规模:能够处理百万规模以上的文件数量,数量相当之大。
(3)可构建在廉价机器上,通过多副本机制,提高可靠性。
缺点:
(1)不适合低延时数据访问,比如毫秒级的存储数据,是做不到的。
(2)无法高效的对大量小文件进行存储。
存储大量小文件的话,他会占用NameNode大量的内存来存储文件目录和块信息。这样是不可取的,因为NameNode的内存总是有限的;(理解:书包含目录和具体内容)
小文件存储的寻址时间会超过读取时间,他违反了HDFS的设计目标
(3)不支持并发写入,文件随机修改。
一个文件只能有一个写,不允许多个线程同时写;
仅支持数据append(追加),不支持文件的随机修改。
1.4HDFS的架构
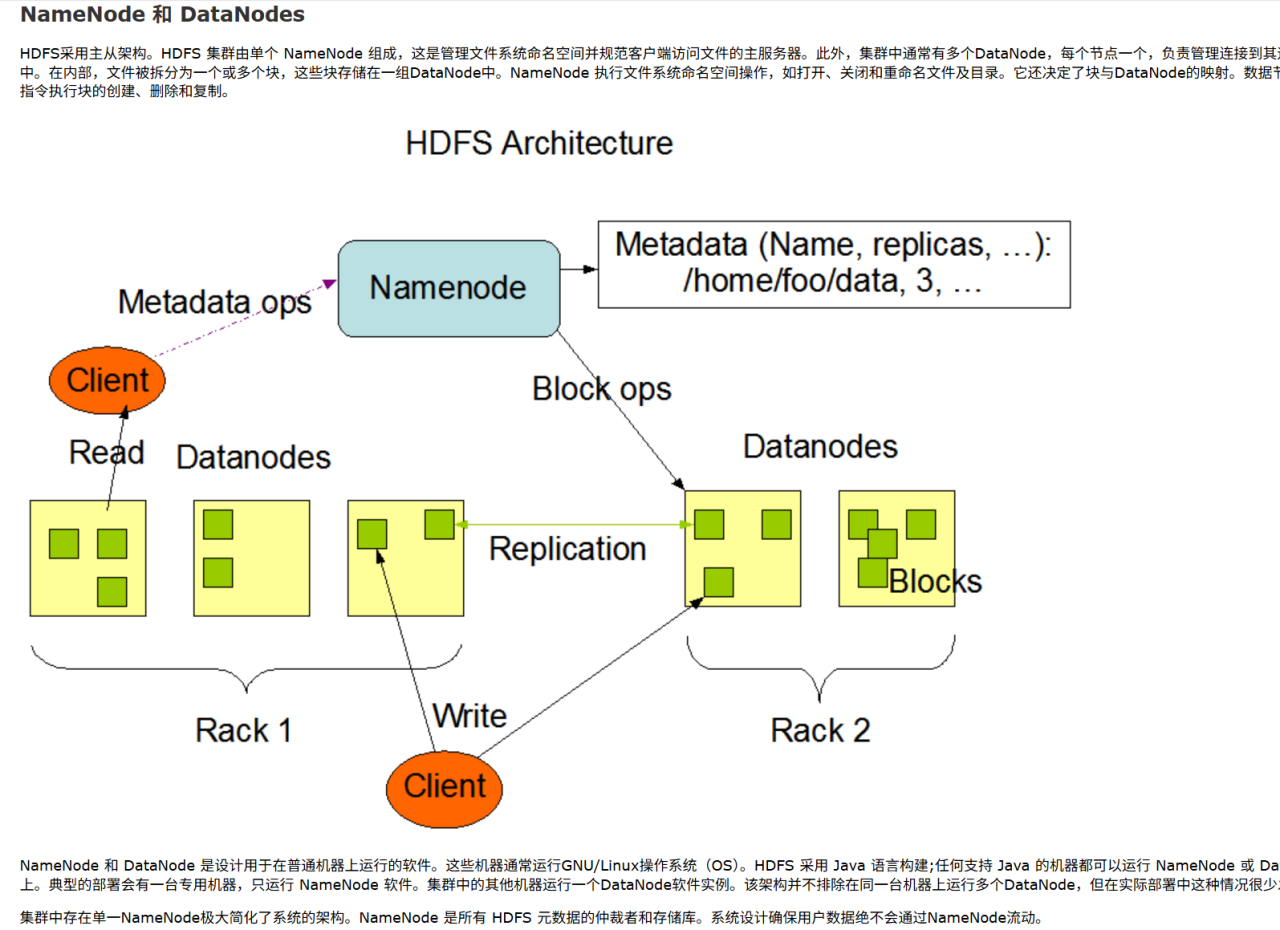
NameNode(nn):就是Master(老板),它是一个主管、管理者。
1.管理HDFS的名称空间;
2.配置副本策略;
3.管理数据块(Block)映射信息;
4.处理客户请求。
DataNode:就是Slave(奴隶).NameNode下达命令,DataNode执行实际操作。
存储实际的数据块;
执行数据块的读/写操作。
Client:就是客户端
1、 文件切分。文件上传HDFS的时候Client将文件切分成一个一个的Block,然后进行上传;
2、 跟NameNode交互,获取文件的位置信息。
3、与DataNode交互,读取或者写入数据;
Client提供一些命令来管理HDFS,比如NameNode格式化;
Client可以通过一些命令来访问HDFS,比如对HDFS增删改查操作。
Secondary NameNode:并非NameNode的热备,当NameNode挂掉的时候,它不能马上替换NameNode并提供服务。
辅助NameNode,分担其工作量,比如定期合并Fsimage和Edits,并推送给NameNode
在紧急情况下,可恢复辅助NameNode。
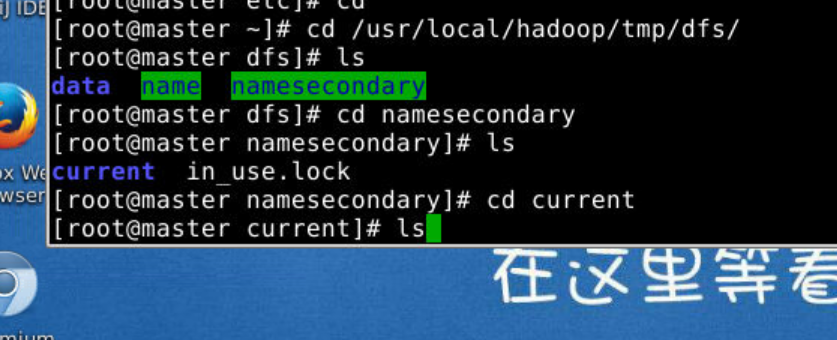
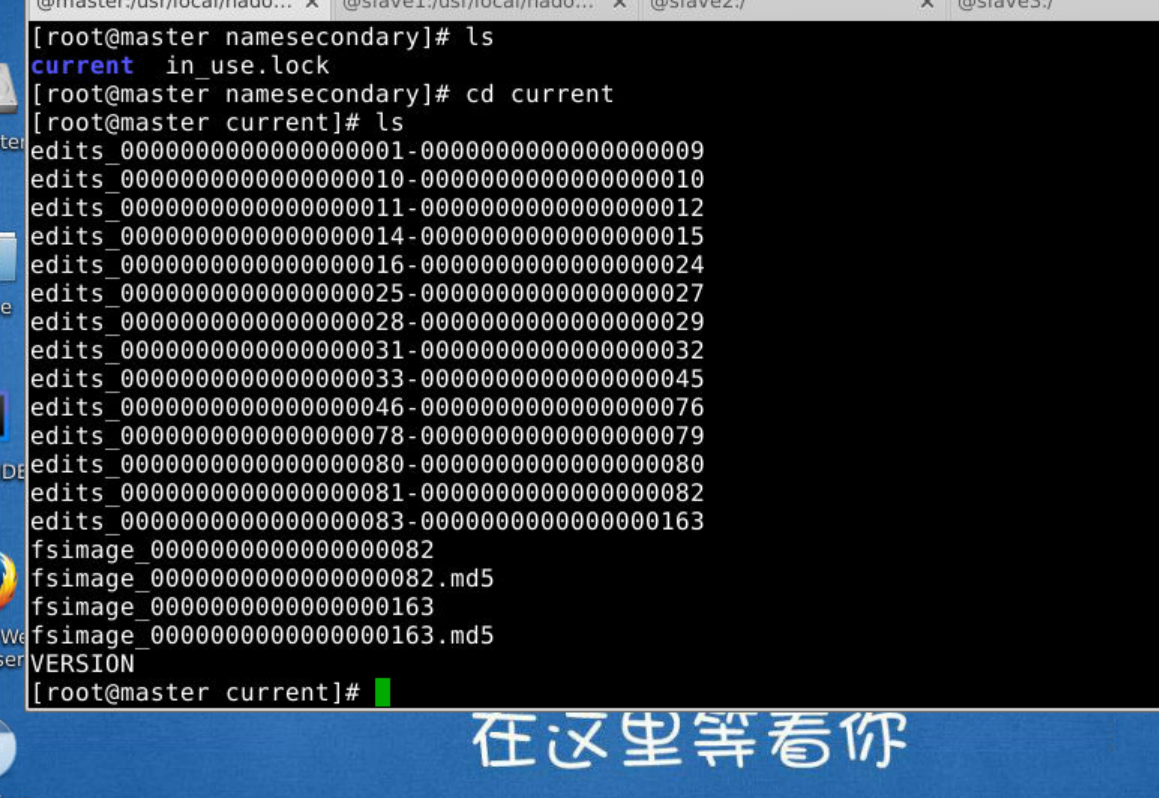
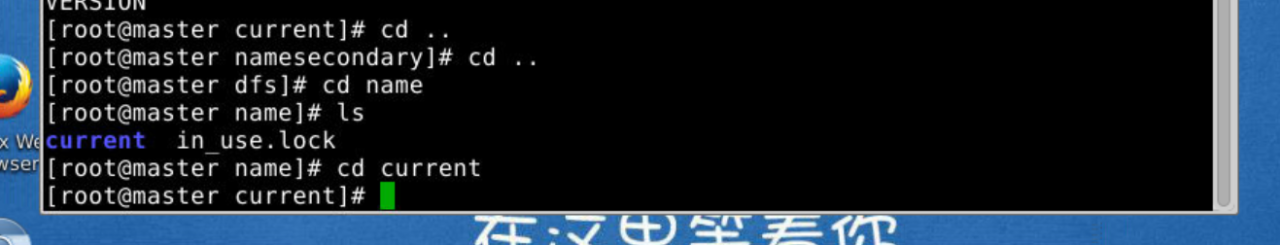
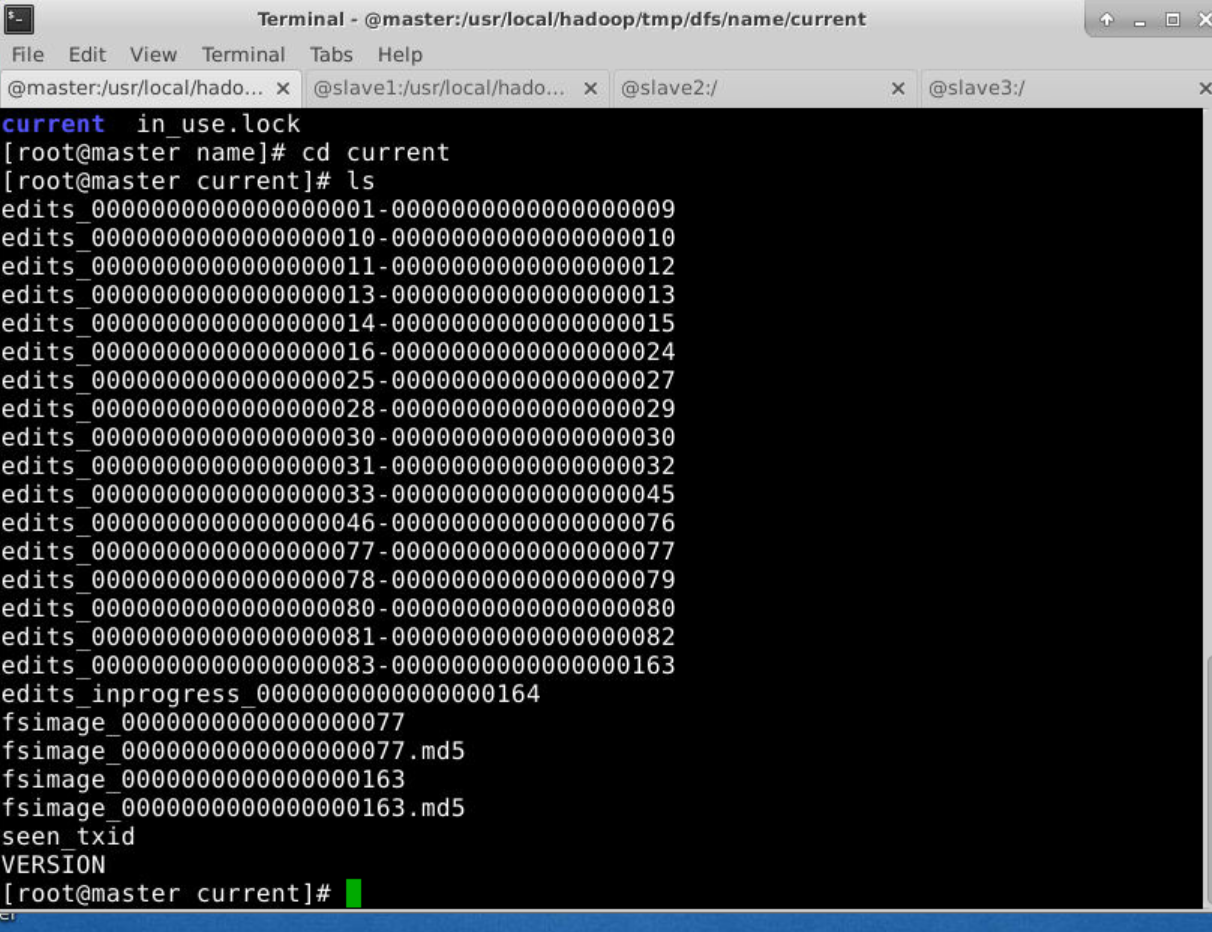
发现namenode多了一个 edits_inprogress_0000000000000000164
内存 硬盘
Fsimage(硬盘):为了防止断电数据丢失
Edits:
1.5HDFS文件块block大小(面试重点)
HDFS中文件在物理上是分块存储(block)块的大小可以通过配合参数(dfs.blocksize)来规定,默认大小在hadoop2.x版本中128M,老版本是64M
例:
block1 block2 block3 block3 .....block66
如果寻址时间约为10ms,即查找到目标block的时间约为10ms。
寻址时间为传输时间的1%时,则为最佳状态。因此,传输时间=10ms/1%=1000ms=1s
目前磁盘的输出速率普遍为100MB/s 块大小:100M/s*1s=100M 所以最后块大小为128M(选与100最接近的2的次方,所以为128M)
普通机械硬盘:80M/s~90M/s 块大小:80M~90M (64M或128M)
固态硬盘:200M/s~300M/s 块大小:200M~300M (256M)
思考:为什么块的大小不能设置太小,也不能设置太大?
1.HDFS的块设置太小,会增加寻址时间,程序一直在找块的位置。
2.如果块设置太大,从磁盘传输数据的时间会明显大于定位这个块开始新的位置所需要的时间(寻址时间),导致程序处理这块数据时,会非常慢。
总结:HDFS块的大小设置主义取决于磁盘传输速率。
1.6HDFS的shell操作(10分)
1.基本语法
bin/hadoop fs 具体的命令
bin/hdfs dfs 具体的命令
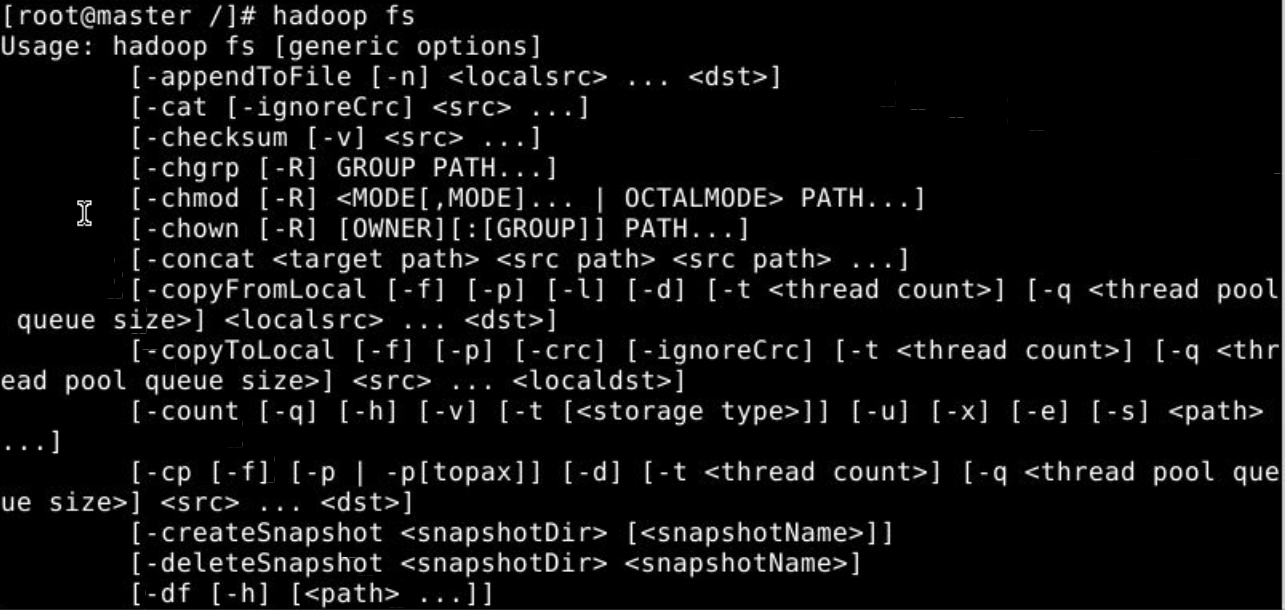
2.常用的操作命令:
1.启动hadoop集群
sbin/start-dfs.sh 启动hdfs
sbin/start-yarn.sh 启动yarn
2.-help :输出这个命令参数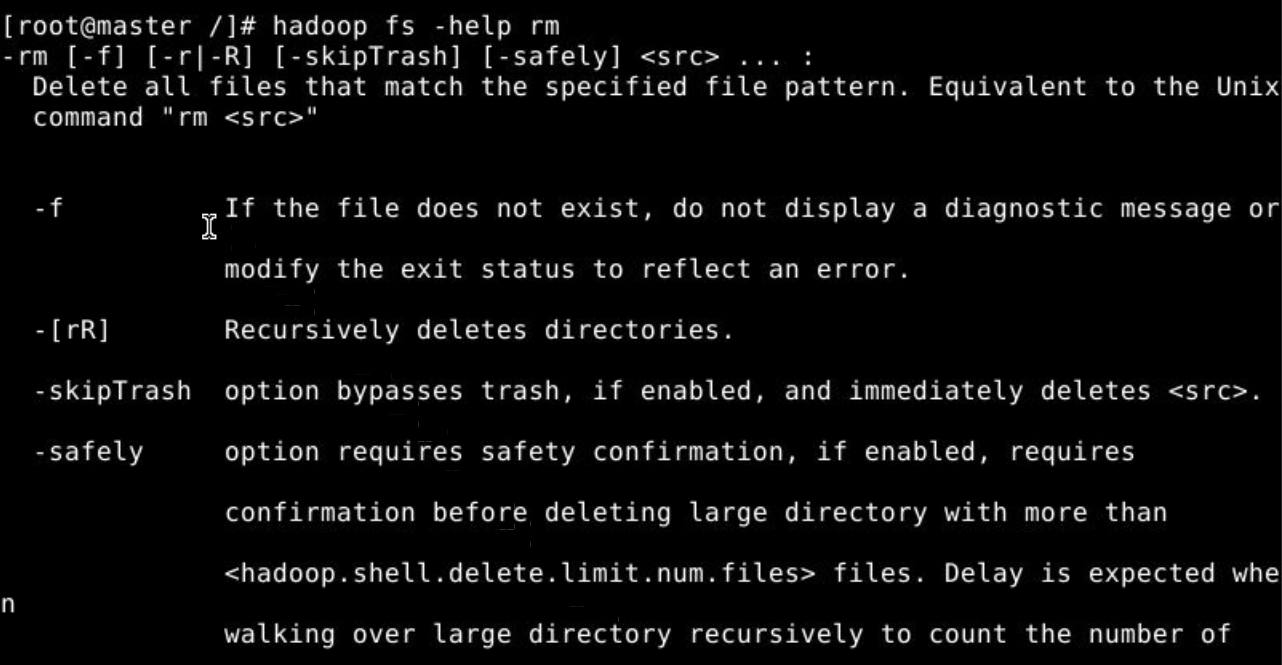
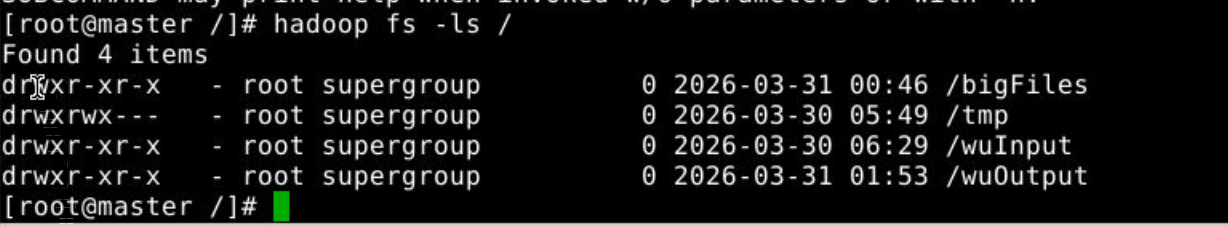
3.-ls:显示目录信息
hadoop fs -ls:显示hadoop的目录信息
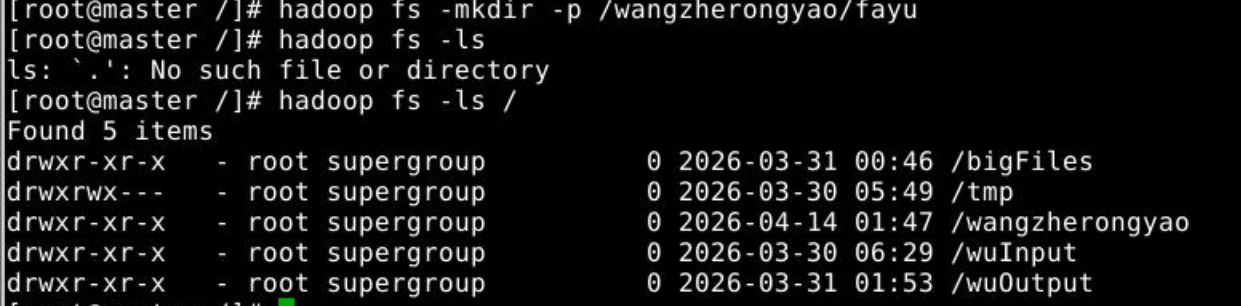
4.-mkdir:在hdfs上创建目录或文件夹
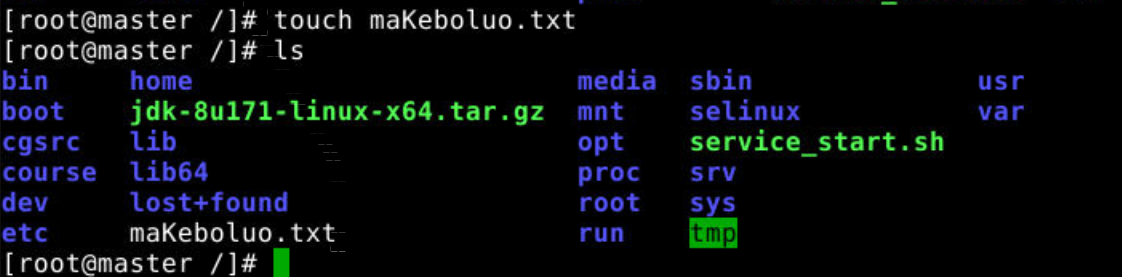
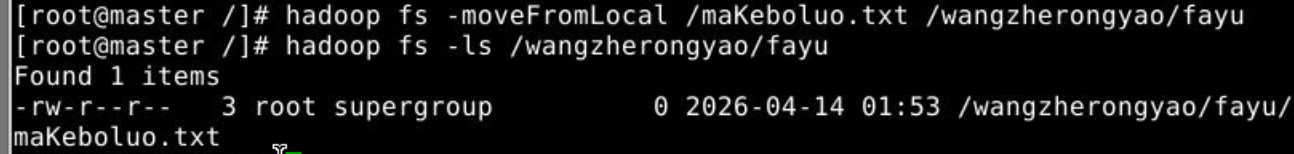
5.moveFromLocal:从本地剪切粘贴到HDFS
touch:创建一个文件
再将此文件剪切复制到HDFS:(剪切后本地没有这个文件了)
6.-appendToFile追加一个文件到已经存在的文件夹末尾
(1)要有一个本地文件
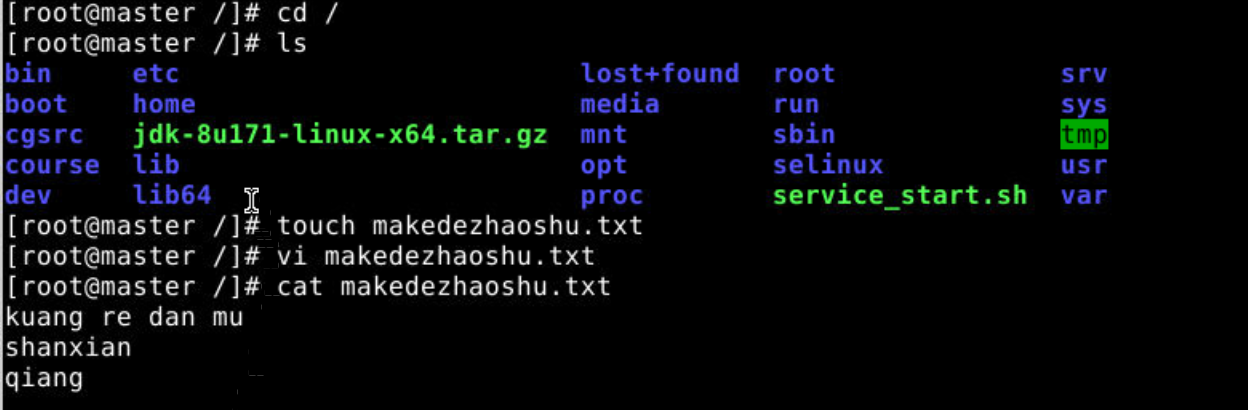
touch文件名(创建一个空文件)
vi文件名(编辑这个文件)
cat文件名(查看这个文件)
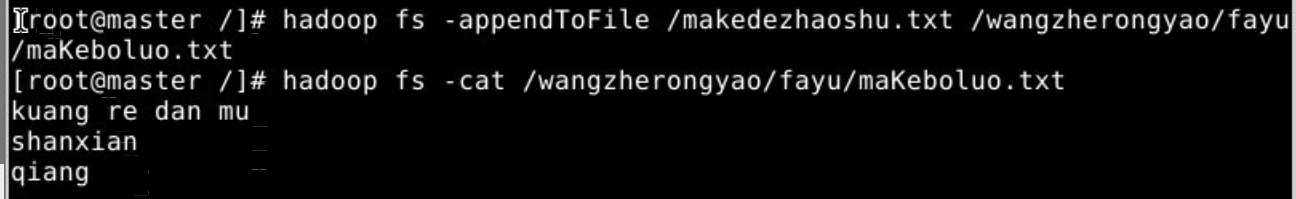
(2)把本地文件追加到(已经存在的HDFS系统里面的)文件的末尾
hadoop fs -appendToFile 本地文件和地址HDFS已经存在的文件路径以及文件名
7.-cat文件名:查看文件
8.-chgrp ,-chmod ,-chown :Linux文件系统中的用法一样,修改文件所属权限(ch代表change,grp代表group,mod代表mode,own代表所有者和组)
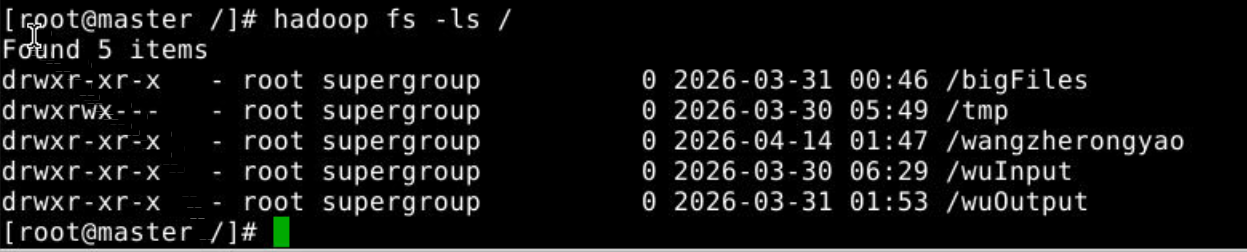
第一列表示权限
第二列表示硬链届数
第三列表示文件所有者
-chgrp [R]组名 文件或目录名:改变文件所属的组别
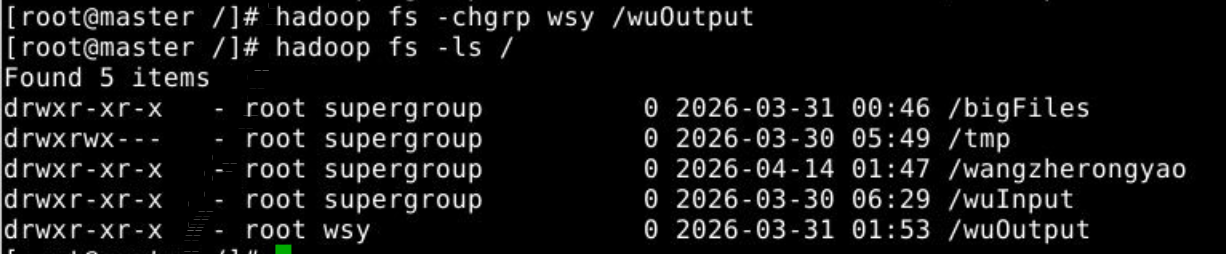
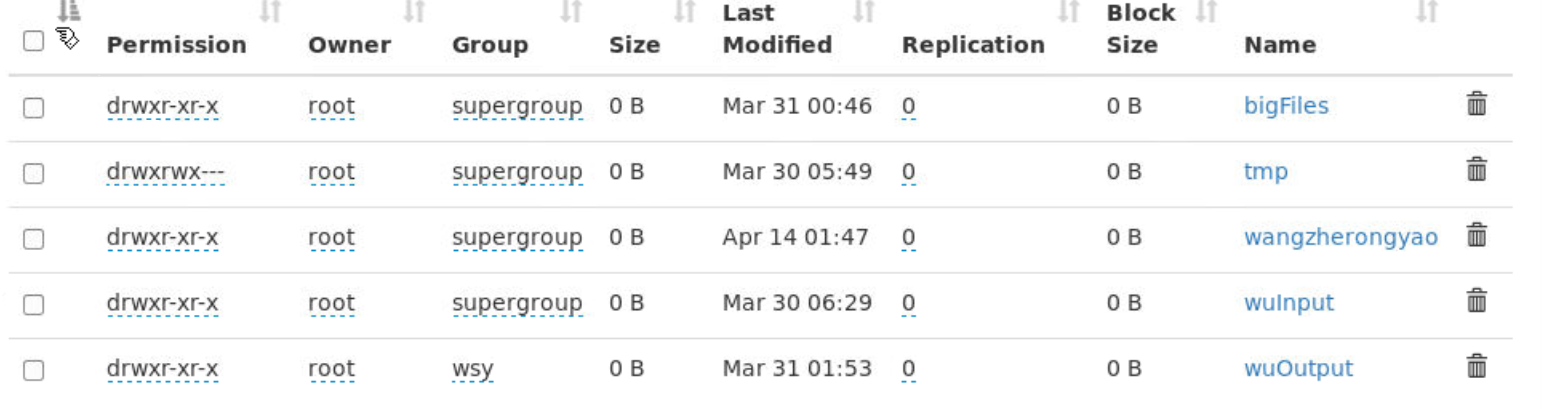
组别变成了wsy。
chown 改变文件文件夹所有者的命令
hadoop fs -chown文件所有者:组别名字hdfs的文件或者文件夹。

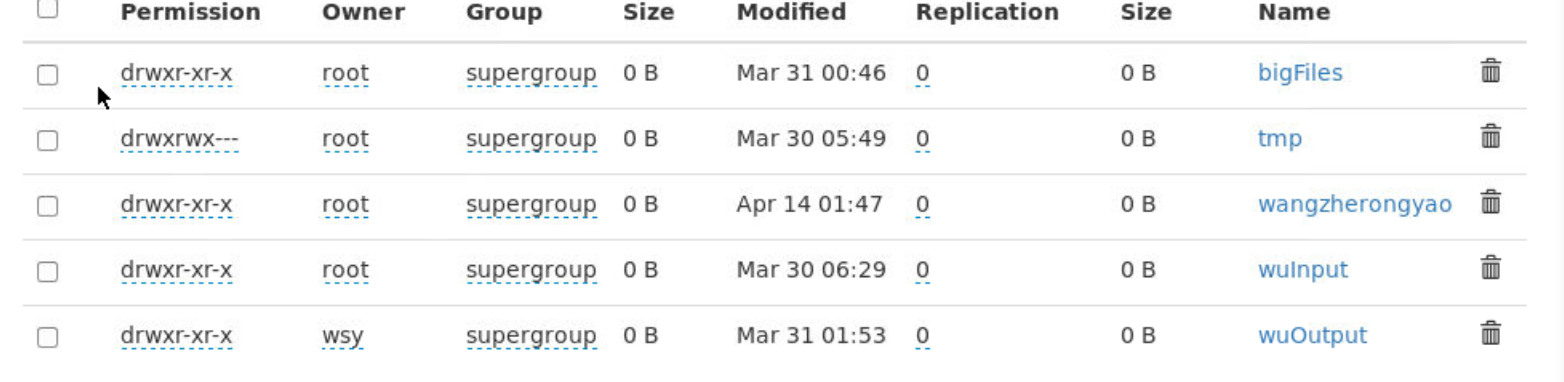
owner那一列变成了wsy。
chmod[用户类别][操作符][权限] 文件/目录
1.用户类别
u:所有者(usr)
g:所属者组(group)
0:其他用户(others)
a:所有用户(all,默认值)
2.操作符
+:添加权限
-:移除权限
=:直接设置权限(覆盖原有权限)
3.权限
r:读
w:写
x:执行
| 原本的权限 | 语句 | 新的权限 |
| rw- | chmod u+x script.sh | rwx |
| rw- | chmod g-w data.txt | r-- |
| rwx | chmod o=r file.txt | r-- |
二数字模式
chmod[数字组合] 文件/目录
1.权限对应数字
r=4
w=2
x=1
-无权限 =0
2.数字组合规则
将三类用户(所有者,组,其他用户)的权限,得到三位数字
第一位:所有者权限
第二位:组权限
第三位:其他用户权限
例1:rwxr-xr--
所有者:rwx 4+2+1=7
组:r-- 4+0+0=4
其他用户:r-- 4+0+0=4
例2:rw-r--r--
所有者:rw- 4+2+0=6
组:r-- 4+0+0=4
其他用户:r-- 4+0+0=4
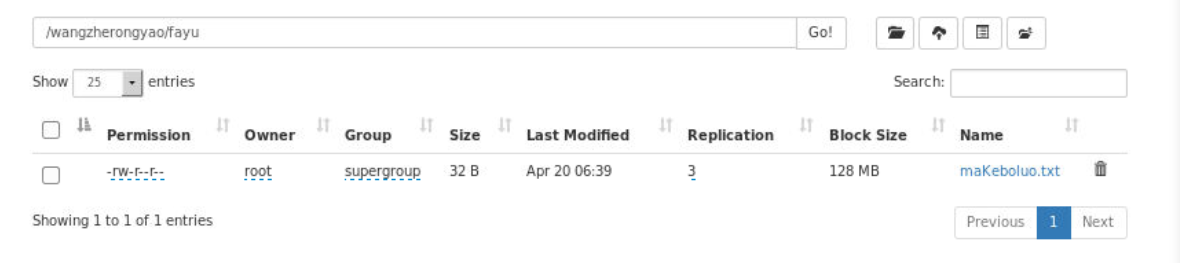
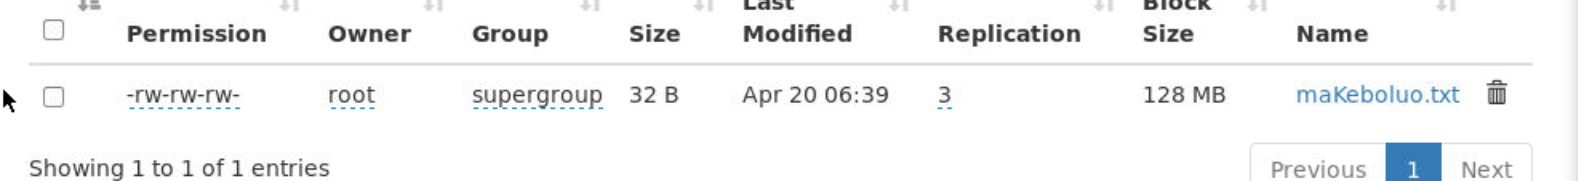
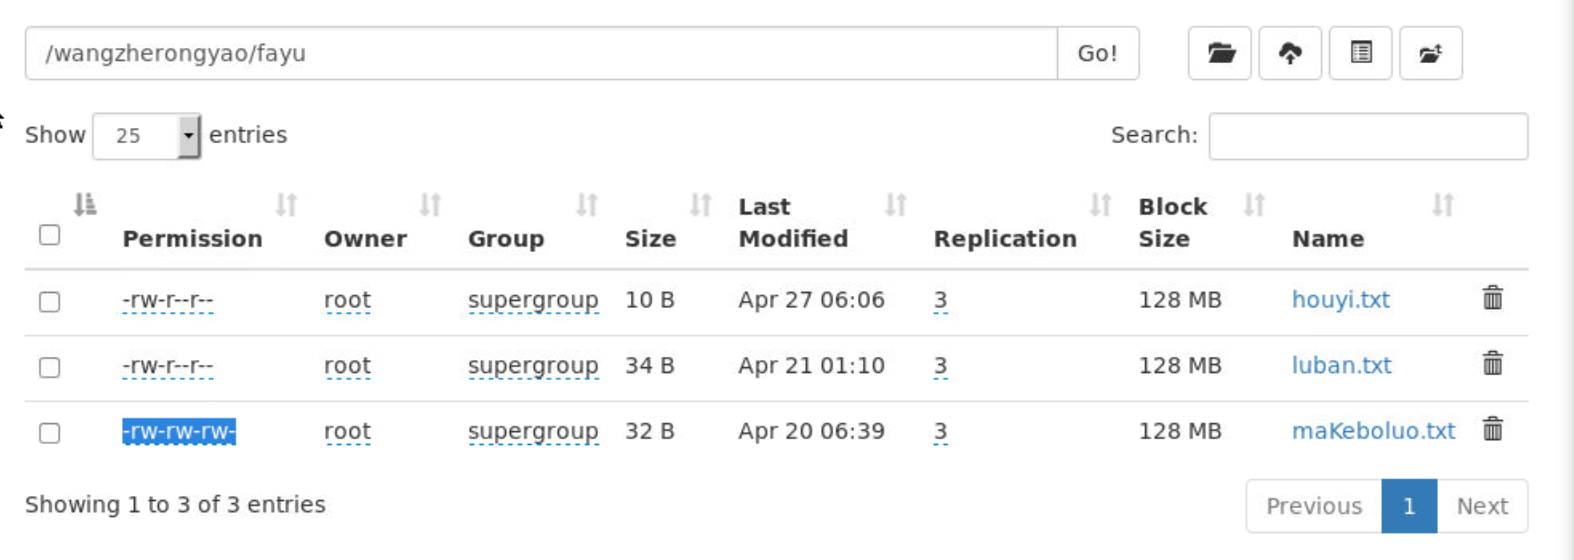
Hadoop fs -chmod 666 文件名:将这个文件的三类用户都给了读,写的权利

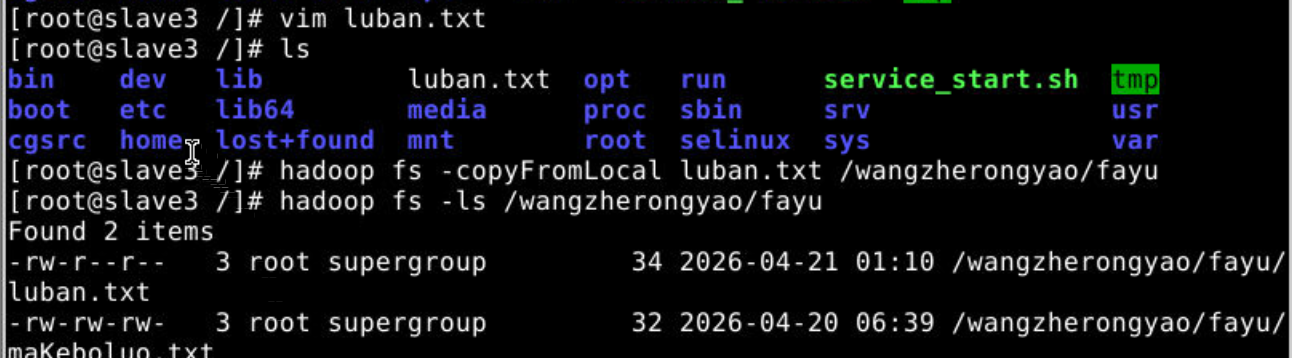
9. -copyFromLocal:从本地文件系统中拷贝到HDFS路径去
hadoop fs -copyFromLocal+本地文件HDFS的路径(要放的路径)
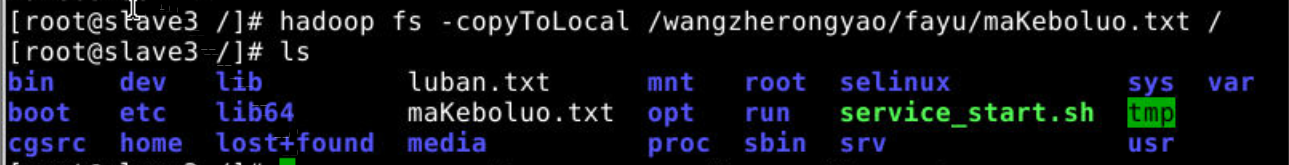
10.-copyToLocal:从HDFS拷贝到本地(下载)
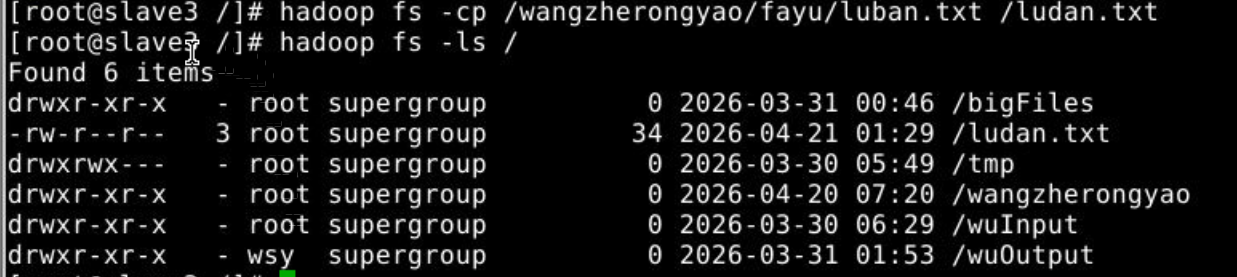
111.-cp:从HDFS的一个路径拷贝到HDFS的另一个路径
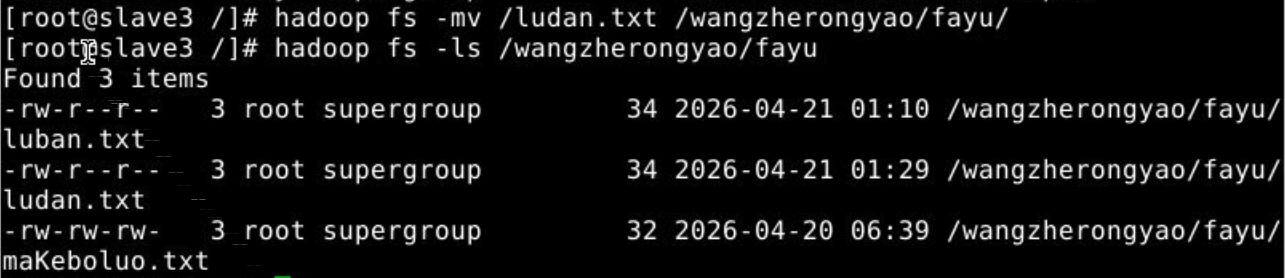
12.-mv:在HDFS目录中移动文件
将ludan从HDFS目录移动到wangzherongyao/fayu中
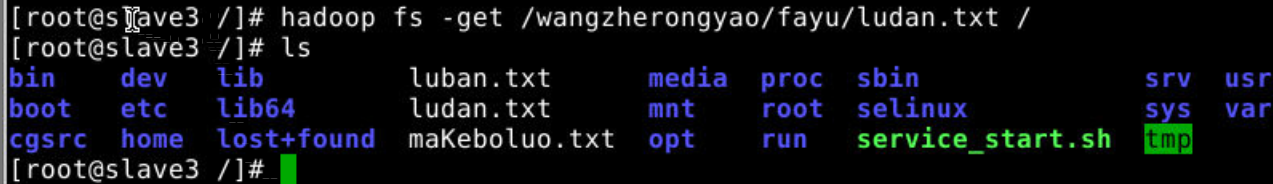
13.-get:等同于copyToLocal就是从HDFS下载文件到本地
将ludan下载到本地
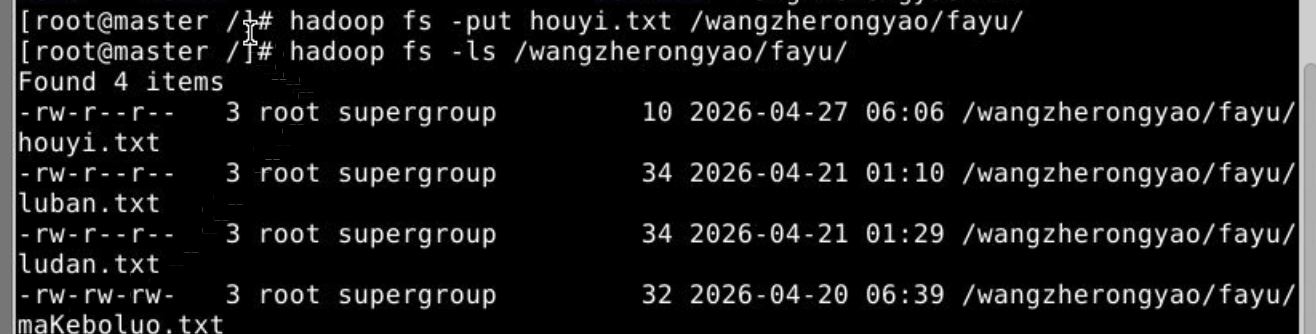
15.-put:等同于copyFromLocal
hadoop fs -put本地文件上传到HDFS的系统位置
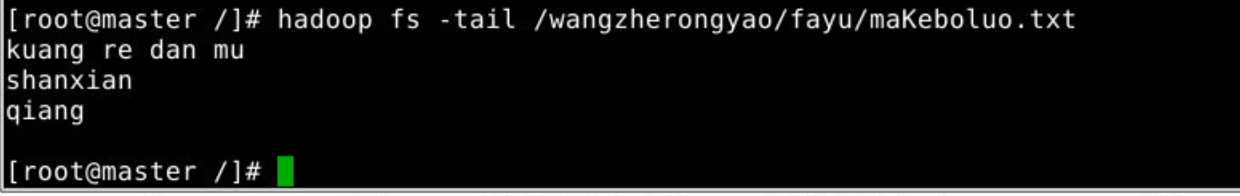
15.-tail:显示一个文件的末尾
16.-rm:删除文件或者文件夹
删文件:hadoop fs -rm HDFS文件路径及名字
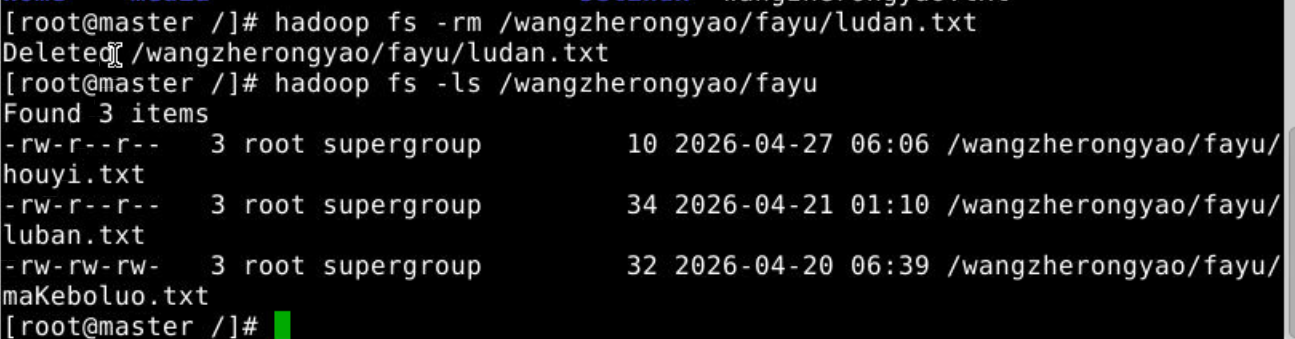
ls查看,少了ludan.txt
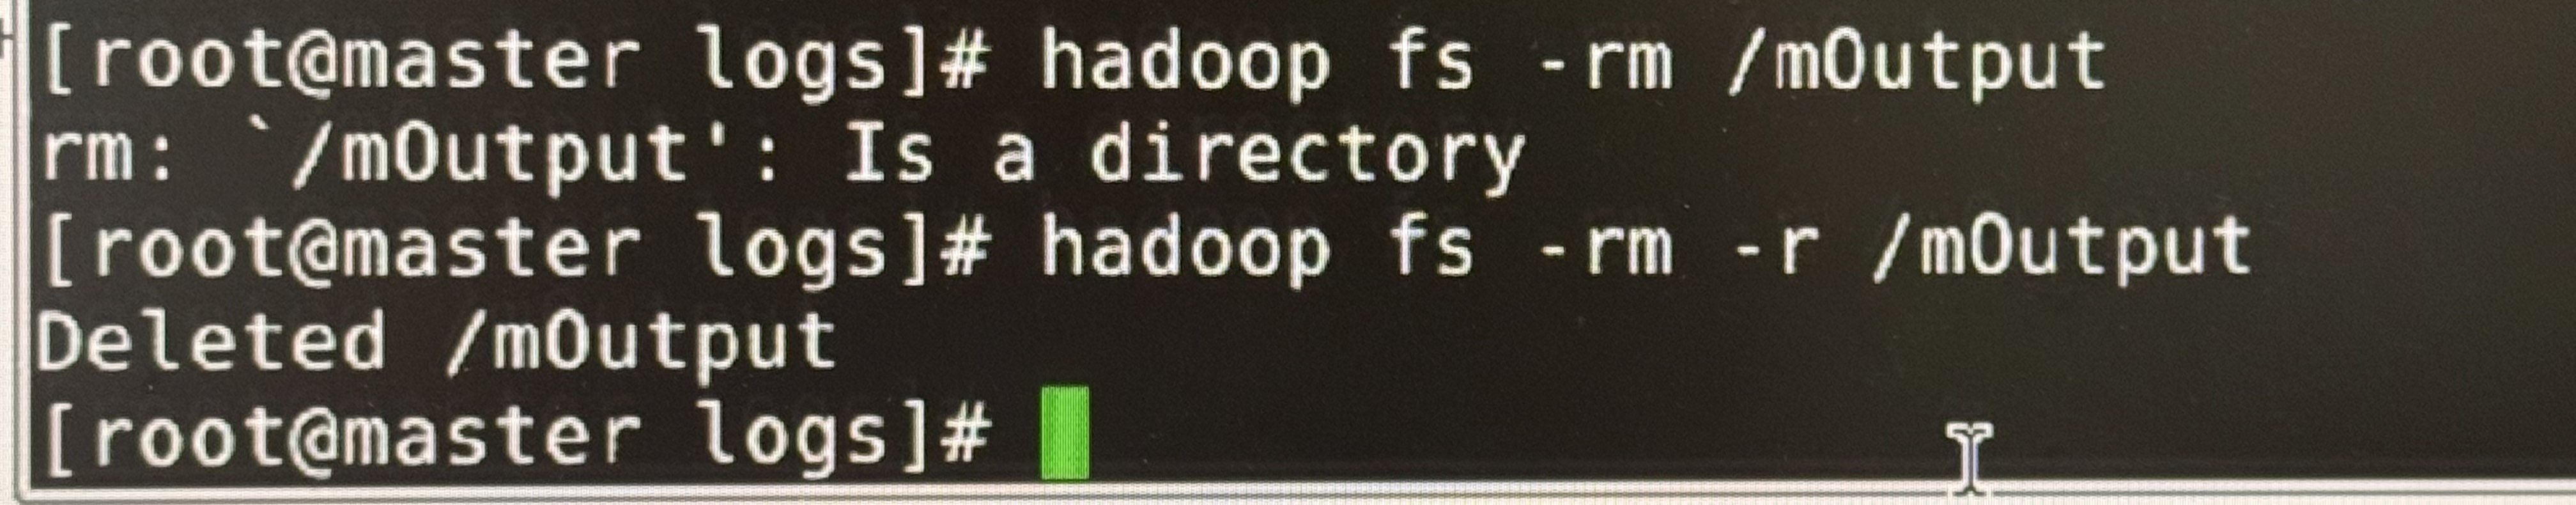
删文件夹:hadoop fs -rm -r HDFS文件夹路径及名字
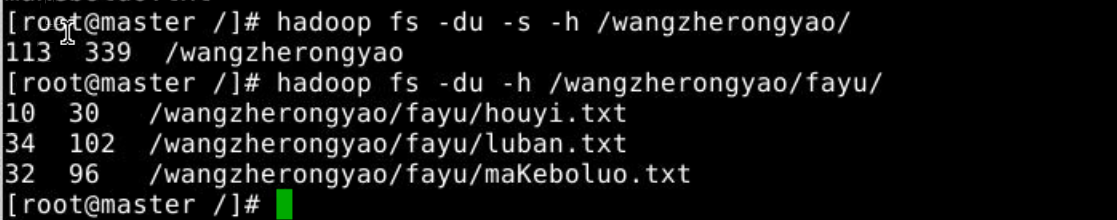
17.-du:统计文件夹的大小信息
1. -s(summary 汇总)
• 作用:只显示指定路径(目录/文件)的总大小,而不列出目录下每个子文件/子目录的单独大小。
• 不加 -s 时,会递归列出目录下所有文件/子目录的大小;
加上 -s 后,只输出一行汇总结果,代表整个目录的总大小。
• 你的命令 hadoop fs -du -s -h /wangzherongyao/ 输出的 113 339 /wangzherongyao,就是该目录的汇总大小。
2. -h(human-readable 人类可读)
• 作用:把文件/目录大小从默认的字节(bytes)单位,转换成更易读的格式(如 KB、MB、GB 等),方便直观查看。
• 不加 -h 时,显示的是纯数字的字节数;
加上 -h 后,会自动换算并加上单位,比如 10、30、34 这些数字,实际是经过换算后的大小值。
18.-setrep:设置文件HDFS文件的副本数量

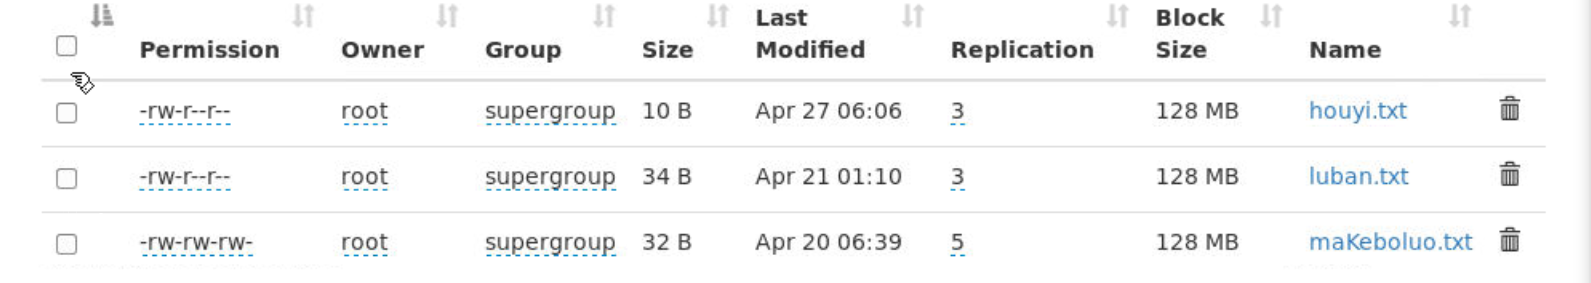
replication从3变成了5。
现在四台机器内都有了maKeboluo.txt
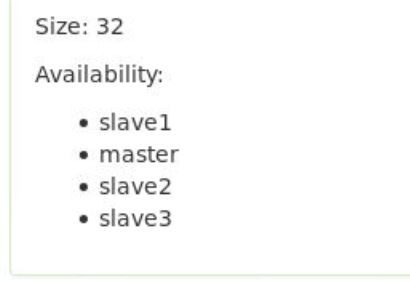
如果想要在web端可以直接修改文件副本数,需要将文件的other给到写的权限

19.创建空文件
hadoop fs -touchz 空文件的名字
更多推荐



 15
 0
- 0


 已为社区贡献1条内容

所有评论(0)