
Hadoop实战初步学习
1.启动Hadoop集群
在完全分布模式下,必须同时启动所有虚拟机和Hadoop服务,集群才能正常工作。
Hadoop是一个“主从架构”的分布式系统,Master节点(NameNode, ResourceManager)本身不存储数据,也不执行计算任务。
-
数据不可见:你的文件实际存储在
Slave1和Slave2的 DataNode 上。如果它们没启动,HDFS 里就是空的。 -
任务跑不动:计算任务(MapReduce)是由
Slave1和Slave2上的 NodeManager 执行的。Master 只负责分配任务,没人干活程序就会报错。 -
缺少数据节点:HDFS 默认通常有副本数(如
dfs.replication=2),如果活着的节点数量少于副本数,系统会认为集群异常。
正确启动与验证方式
请保持三台虚拟机同时运行,然后在 master 节点上执行:
注:不要只看 master,你需要确认三台机器都在正常工作。在 master 上执行以下命令检查所有节点:
# 批量查看三台机器的进程
for host in master slave1 slave2; do
    echo "========== $host =========="
    ssh $host jps
done
健康的输出应该是:
-
master:
NameNode,SecondaryNameNode,ResourceManager -
slave1:
DataNode,NodeManager -
slave2:
DataNode,NodeManager
实际操作输出(先启动Hadoop集群再操作下面的命令):
[root@master /]# for host in master slave1 slave2; do
> echo "-------------- $host ----------------------"
> ssh $host jps
> done
-------------- master ----------------------
4449 Jps
3609 ResourceManager
3309 SecondaryNameNode
3087 NameNode
4015 JobHistoryServer
-------------- slave1 ----------------------
2919 DataNode
3035 NodeManager
3549 Jps
-------------- slave2 ----------------------
2881 DataNode
2997 NodeManager
3511 Jps
| 符号/关键字 | 作用 | 是否必需 |
|---|---|---|
for | 循环开始关键字 | ✅ 必需 |
in | 指定要遍历的列表 | 可选(默认使用位置参数) |
; | 分隔同一行的多个命令 | ❌ 可换行代替 |
do | 标记循环体开始 | ✅ 必需 |
done | 标记循环体结束 | ✅ 必需 |
变量名 | 存储当前迭代的值 | ✅ 必需 |
https://chat.deepseek.com/share/eoycr52eo3t3d2se2z
-
浏览器验证
打开浏览器访问 Web 界面,确认 Live Nodes 数量显示为 2(代表两台从节点都在线)。-
HDFS 界面:
http://master:9870 -
YARN 界面:
http://master:8088
-
-
1的前提要在master中关闭防火墙
[root@master /]# systemctl status firewalld # 查看防火墙状态
● firewalld.service - firewalld - dynamic firewall daemon
   Loaded: loaded (/usr/lib/systemd/system/firewalld.service; enabled; vendor preset: enabled)
   Active: active (running) since Thu 2026-04-23 07:45:12 CST; 48min ago
     Docs: man:firewalld(1)
 Main PID: 685 (firewalld)
   CGroup: /system.slice/firewalld.service
           └─685 /usr/bin/python2 -Es /usr/sbin/firewalld --nofork --nopid

Apr 23 07:45:12 master systemd[1]: Starting firewalld - dynamic firewall daemon...
Apr 23 07:45:12 master systemd[1]: Started firewalld - dynamic firewall daemon.
[root@master /]# # 临时关闭防火墙
[root@master /]# systemctl stop firewalld
好了,下面是在master节点的操作
[root@master ~]# cd /
[root@master /]# cd /opt/hadoop-3.1.4/sbin # 切换到这个目录下。Linux系统执行命令时,会按照PATH环境变量中定义的目录顺序去查找可执行文件,但我没有将Hadoop目录/opt/hadoop-3.1.4/sbin配置到PATH中,所以系统找不到start-dfs.sh等命令
[root@master sbin]# ls
distribute-exclude.sh  hadoop-daemons.sh  mr-jobhistory-daemon.sh  start-all.sh       start-dfs.sh         start-yarn.sh  stop-balancer.sh  stop-secure-dns.sh  workers.sh
FederationStateStore   httpfs.sh          refresh-namenodes.sh     start-balancer.sh  start-secure-dns.sh  stop-all.cmd   stop-dfs.cmd      stop-yarn.cmd       yarn-daemon.sh
hadoop-daemon.sh       kms.sh             start-all.cmd            start-dfs.cmd      start-yarn.cmd       stop-all.sh    stop-dfs.sh       stop-yarn.sh        yarn-daemons.sh
[root@master sbin]# start-dfs.sh # 启动HDFS(存储系统)
WARNING: HADOOP_SECURE_DN_USER has been replaced by HDFS_DATANODE_SECURE_USER. Using value of HADOOP_SECURE_DN_USER.
Starting namenodes on [master]
Last login: Wed Apr 22 23:52:22 CST 2026 from 192.168.128.1 on pts/0
Starting datanodes
Last login: Wed Apr 22 23:55:00 CST 2026 on pts/0
Starting secondary namenodes [master]
Last login: Wed Apr 22 23:55:03 CST 2026 on pts/0
[root@master sbin]# start-yarn.sh # 启动YARN(资源管理器)
Starting resourcemanager
Last login: Wed Apr 22 23:55:07 CST 2026 on pts/0
Starting nodemanagers
Last login: Wed Apr 22 23:56:02 CST 2026 on pts/0
[root@master sbin]# mr-jobhistory-daemon.sh start historyserver # 启动Hadoop的JobHistory Server(历史服务器),它的核心功能是记录和展示已经运行完成的MapReduce作业的历史信息。 mr指的是MapReduce。daemon是魔鬼的意思,也有守护进程,后台程序,虚拟光驱的意思
WARNING: Use of this script to start the MR JobHistory daemon is deprecated.
WARNING: Attempting to execute replacement "mapred --daemon start" instead.
[root@master sbin]# jps # 列出当前用户正在运行的Java进程及其主类名称
3024 Jps
2547 ResourceManager
2965 JobHistoryServer
2262 SecondaryNameNode
1996 NameNode
由于我没有将Hadoop的目录配置到PATH环境变量中,所以我想要启动Hadoop集群的话,必须
- 要么进入该目录(/opt/hadoop-3.1.4/sbin)执行start-dfs.sh等命令
- 要么在任意目录下写完整路径:如/opt/hadoop-3.1.4/sbin/start-dfs.sh
1.配置Hadoop环境变量
如果想配置,可以:
方法一:编辑~/.bashrc(推荐)
# 打开配置文件
vi ~/.bashrc

# 在文件末尾添加以下内容
export HADOOP_HOME=/opt/hadoop-3.1.4
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin

# 保存并生效
source ~/.bashrc
方法二:编辑/etc/profile(对所有用户生效)
# 打开系统配置文件
vi /etc/profile

# 在文件末尾添加
export HADOOP_HOME=/opt/hadoop-3.1.4
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin

# 保存并生效
source /etc/profile
验证配置成功:
# 1. 确认环境变量生效
echo $HADOOP_HOME
# 应输出:/opt/hadoop-3.1.4

# 2. 确认命令可用
which start-dfs.sh
# 应输出:/opt/hadoop-3.1.4/sbin/start-dfs.sh

# 3. 现在可以在任何目录执行
cd ~
start-dfs.sh
2.jps
jps命令是Java Virtual Machine Process Status Tool(Java虚拟机进程状态工具)的命令行工具
核心作用:列出当前用户正在运行的Java进程及其主类名称
1.基本用法:
[root@master sbin]# jps # 最简单的使用
3024 Jps
2547 ResourceManager
2965 JobHistoryServer
2262 SecondaryNameNode
1996 NameNode
输出的含义:
| 列 | 内容 | 说明 |
|---|---|---|
| 第一列 | PID(进程ID) | 操作系统分配给进程的唯一编号 |
| 第二列 | 主类名或Jar包名 | 正在运行的Java程序名称 |
2.输出含义详解:
比如输出:
[root@master ~]# jps
12345 NameNode
12346 SecondaryNameNode
12347 ResourceManager
12348 Jps| 数字(PID) | 进程名称 | 含义 |
|---|---|---|
| 12345 | NameNode | Hadoop 名称节点进程,ID 是 12345 |
| 12346 | SecondaryNameNode | 辅助名称节点,ID 是 12346 |
| 12347 | ResourceManager | 资源管理器,ID 是 12347 |
| 12348 | Jps | jps 命令本身,ID 是 12348 |
PID的作用:
1.查看进程详细信息
# 查看某个进程的详细信息
ps -ef | grep 12345

# 查看进程打开的文件
lsof -p 12345

# 查看进程状态
cat /proc/12345/status
2.终止进程
# 优雅终止
kill 12345

# 强制终止
kill -9 12345
3.查看进程资源占用
# 查看 CPU/内存使用情况
top -p 12345
PID的特点:
| 特性 | 说明 |
|---|---|
| 唯一性 | 同一时间,每个 PID 只对应一个进程 |
| 可重用 | 进程结束后,PID 可以被新进程使用 |
| 从 1 开始 | PID 1 通常是 init/systemd 进程 |
| 上限 | Linux 默认最大 PID 为 32768(可调整) |
注:进程ID(PID)在每次Hadoop启动时可能会不同,PID由系统分配
PID 是操作系统动态分配的:
-
进程启动时,系统从可用的PID池中取一个
-
进程结束时,该PID被释放回池中
-
下次启动时,系统可能分配不同的PID
3.jps的常用参数:
| 参数 | 作用 | 示例输出 |
|---|---|---|
jps -l | 显示完整包名 | org.apache.hadoop.hdfs.server.namenode.NameNode |
jps -v | 显示JVM参数 | -Xmx1000m -Xms500m ... |
jps -m | 显示main方法参数 | -Dfs.namenode.rpc-address=... |
[root@master sbin]# jps -l
4322 sun.tools.jps.Jps
2547 org.apache.hadoop.yarn.server.resourcemanager.ResourceManager
2965 org.apache.hadoop.mapreduce.v2.hs.JobHistoryServer
2262 org.apache.hadoop.hdfs.server.namenode.SecondaryNameNode
1996 org.apache.hadoop.hdfs.server.namenode.NameNode
4.jps的工作原理:
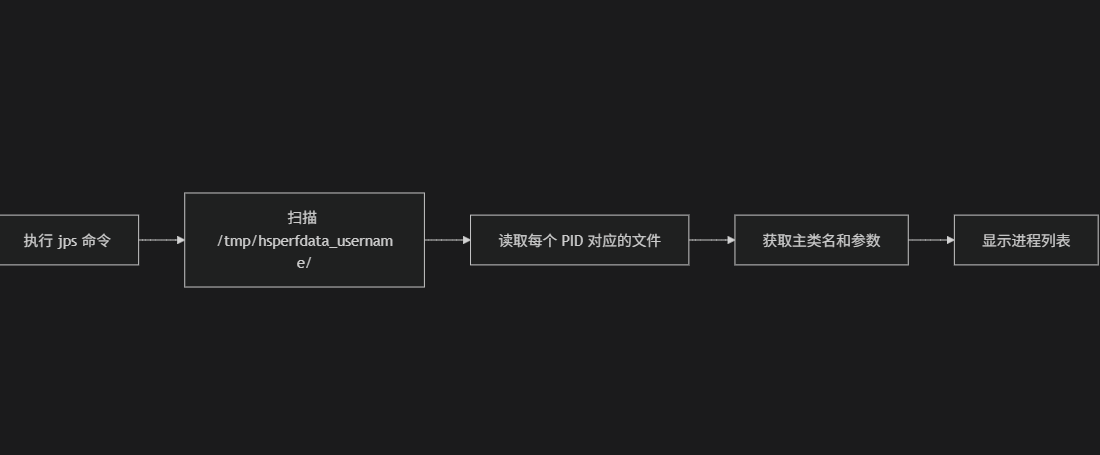
[root@master sbin]# find / -name "jps"
/etc/alternatives/jps
/usr/bin/jps
/usr/java/jdk1.8.0_281-amd64/bin/jps
以上输出说明系统中安装了3个jps命令,它们指向同一个JDK,是正常现象,不是错误。
输出解读:
/etc/alternatives/jps          # 软链接(符号链接)
/usr/bin/jps                   # 软链接(符号链接)
/usr/java/jdk1.8.0_281-amd64/bin/jps  # 真实的 jps 程序文件
这是 Linux alternatives 系统(多版本管理机制)造成的:
| 文件 | 类型 | 作用 |
|---|---|---|
/usr/java/jdk1.8.0_281-amd64/bin/jps | 真实文件 | JDK 实际安装位置 |
/etc/alternatives/jps | 软链接 | alternatives 系统的符号链接 |
/usr/bin/jps | 软链接 | 系统 PATH 中的命令入口 |
查看链接关系:
[root@master sbin]# ls -l /usr/bin/jps
lrwxrwxrwx. 1 root root 21 Mar 26 08:36 /usr/bin/jps -> /etc/alternatives/jps
执行jps命令时到底发生了什么?
# 你输入
[root@master ~]# jps

# 系统执行流程:
1. 在 PATH 中找到 /usr/bin/jps
2. 发现是软链接,读取内容:/etc/alternatives/jps
3. 访问 /etc/alternatives/jps
4. 发现也是软链接,读取内容:/usr/java/jdk1.8.0_281-amd64/bin/jps
5. 访问真实文件
6. 执行该文件(运行 jps 程序)
3.补充知识:软链接
软链接是Linux中的一种特殊文件,它的内容是一个路径,指向另一个文件或目录。
命令输出解读:
lrwxrwxrwx. 1 root root 21 Mar 26 08:36 /usr/bin/jps -> /etc/alternatives/jps| 字段 | 值 | 含义 |
|---|---|---|
| 第一个字符 | l | 这是一个软链接(l = link) |
| 权限 | rwxrwxrwx | 所有用户都有读写执行权限(指向的目标文件决定实际权限) |
| 链接数 | 1 | 只有这一个链接 |
| 所有者 | root | 属于 root 用户 |
| 大小 | 21 | 路径字符串的长度(21个字节) |
| 日期 | Mar 26 08:36 | 创建时间 |
| 文件名 | /usr/bin/jps | 链接文件本身 |
| 箭头 → | /etc/alternatives/jps | 指向的目标路径 |
[root@master sbin]# ls -l /usr/bin/jps
lrwxrwxrwx. 1 root root 21 Mar 26 08:36 /usr/bin/jps -> /etc/alternatives/jps
[root@master sbin]# ls -l /etc/alternatives/jps
lrwxrwxrwx. 1 root root 36 Mar 26 08:36 /etc/alternatives/jps -> /usr/java/jdk1.8.0_281-amd64/bin/jps
[root@master sbin]# ls -l /usr/java/jdk1.8.0_281-amd64/bin/jps
-rwxr-xr-x. 1 root root 8832 Dec  9  2020 /usr/java/jdk1.8.0_281-amd64/bin/jps
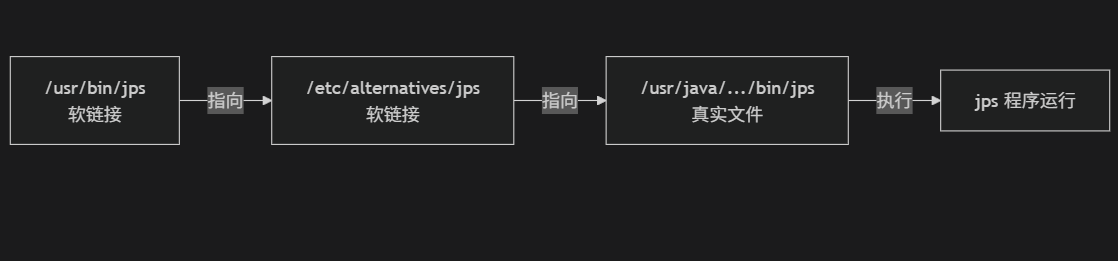
第一层:系统命令入口
/usr/bin/jps -> /etc/alternatives/jps- 类型:软链接(l开头)
- 作用:让你在任何目录都能输入jps命令(系统会在PATH环境变量中找jps命令,而/usr/bin/jps在PATH中)
- 指向:/etc/alternatives/jps
第二层:alternatives管理链接
/etc/alternatives/jps -> /usr/java/jdk1.8.0_281-amd64/bin/jps- 类型:软链接(l开头),就是说/etc/alternatives/jps这个文件是软链接,因为权限符前面的字母是l,l是link的缩写,表示软链接文件
- 作用:实现多版本JDK的切换管理
- 指向:具体的JDK版本中的jps
第三层:真实文件
-rwxr-xr-x. 1 root root 8832 Dec 9 2020 /usr/java/jdk1.8.0_281-amd64/bin/jps- 类型:真实文件(第一个字符是-,不是l)
- 权限:rwxr-xr-x,即755,所有用户可读可执行
- 大小:8832字节(约8.6KB) 注:1字节=8比特,1KB=1024字节
- 本质:这是JDK自带的真正的jps程序
这种设计的优点:
1.灵活切换JDK版本
# 假设你想切换到 JDK 11
# 只需修改一个软链接:
ln -sf /usr/java/jdk11/bin/jps /etc/alternatives/jps

# 所有使用 jps 的地方自动切换,无需修改系统配置
2.统一路径命令
-
不管安装几个 JDK 版本
-
/usr/bin/jps永远指向"当前激活的版本" -
用户无需关心具体版本路径
3.符合Linux标准
-
FHS(文件系统层次结构标准)推荐这种设计
-
许多软件(Java、Python、Node.js)都采用类似方案
4.查看环境变量
[root@master sbin]# echo $PATH
/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/opt/hadoop-3.1.4/bin:/opt/hadoop-3.1.4/sbin:/root/bin
| 符号 | 名称 | 作用 |
|---|---|---|
PATH | 变量名 | 存储一系列目录路径 |
$ | 取值运算符 | 获取变量的值 |
输出结果解读:
/usr/local/sbin
/usr/local/bin
/usr/sbin
/usr/bin
/opt/hadoop-3.1.4/bin      # ✅ Hadoop 普通命令
/opt/hadoop-3.1.4/sbin     # ✅ Hadoop 管理命令
/root/bin
用 : 分隔的 7 个路径,系统会按顺序在这些目录中查找你输入的命令。
这表明其实PATH已配置Hadoop
验证:
[root@master sbin]# which start-dfs.sh
/opt/hadoop-3.1.4/sbin/start-dfs.sh
[root@master sbin]# hadoop version
Hadoop 3.1.4
Source code repository https://github.com/apache/hadoop.git -r 1e877761e8dadd71effef30e592368f7fe66a61b
Compiled by gabota on 2020-07-21T08:05Z
Compiled with protoc 2.5.0
From source with checksum 38405c63945c88fdf7a6fe391494799b
This command was run using /opt/hadoop-3.1.4/share/hadoop/common/hadoop-common-3.1.4.jar
[root@master sbin]# hdfs dfs -ls / # 查看HDFS命令
Found 1 items
drwxrwx---   - root supergroup          0 2026-04-18 02:27 /tmp
5.关闭防火墙的作用
防火墙(Firewall)是一种网络安全系统,主要的作用如下:
- 访问控制:根据预设规则,允许或拒绝网络流量进出计算机或网络;充当“门卫”的角色,决定哪些数据包可以通过。
- 网络隔离:将内部网络(如家庭/公司局域网)与外部网络(如互联网)分隔开;创建安全边界,防止外部威胁直接触及内部资源。
- 威胁防护:防止未授权访问(如阻挡黑客、恶意软件防止它们试图入侵你的设备);过滤恶意流量(识别并拦截可疑的数据传输);防止端口扫描(防止攻击者探测系统漏洞)
- 注:防火墙不能代替杀毒软件,它主要管“门”(网络通道),不管“屋里”(已经进入系统的恶意程序),所以最佳实践是防火墙+杀毒软件+安全意识的配合使用。
核心原因:Hadoop是分布式系统,依赖节点之间的直接通信
简单类比:
想象一下你在一个大办公室工作:
NameNode = 前台接待员:知道每个人的座位在哪(在Hadoop中知道各个节点的信息,但不传递文件)
DataNode = 普通员工:实际干活的(在Hadoop中负责实际存储和处理文件)
客户端(master节点) = 需要文件的人
工作流程:当你问前台“我要存一份文件”,前台告诉你“去找员工A和员工B”(返回DataNode地址),你自己直接走到员工A和员工B的座位,把文件交给他们(客户端直连DataNode)
防火墙的作用:如果员工A和员工B的座位需要门禁卡(防火墙规则),而你没有,那么你就进不去(NoRouteToHostException),自然也就无法存文件。
6.HDFS的通信模式
HDFS(Hadoop Distributed File System)的通信模式主要涉及其客户端-服务器架构和内部节点间通信。核心包括以下几个层面:
1.NameNode <------> DataNode通信
心跳机制:DataNode每三秒向NameNode发送心跳包,表明自身存活状态
块报告:DataNode定期(默认6小时)向NameNode上报其存储的所有数据块列表
命令响应:NameNode通过心跳回复向DataNode发送指令(如复制、删除、恢复块等)
2.Client <------------> NameNode通信
元数据操作:客户端通过RPC(Remote Procedure Call)与NameNode交互。如:获取文件系统命名空间操作(创建、删除、重命名文件/目录)、获取数据块位置信息(getBlockLocations)、不涉及实际数据传输,仅传输元数据
3.Client <-----------> DataNode通信
数据读写:客户端直接与DataNode建立TCP连接进行数据传输。读取流程:客户端从NameNode获取块位置后,选择最近的DataNode直接读取。 写入流程:客户端将数据流式传输给第一个DataNode,该DataNode再级联转发给副本DataNode(Pipeline流水线模式)
7.如何关闭防火墙
1.查看防火墙的当前状态
systemctl status firewalld # 查看防火墙的当前状态- system:系统。表示整个操作系统
- ctl:control控制的缩写。systemctl=控制系统
- status:状态
- firewall:防火墙,d:deamon(守护进程的缩写,表示一直在后台运行的程序)
- firewalld:防火墙后台服务
[root@master ~]# systemctl status firewalld
● firewalld.service - firewalld - dynamic firewall daemon
   Loaded: loaded (/usr/lib/systemd/system/firewalld.service; enabled; vendor preset: enabled)
   Active: active (running) since Thu 2026-04-23 22:51:25 CST; 1h 58min ago
     Docs: man:firewalld(1)
 Main PID: 686 (firewalld)
   CGroup: /system.slice/firewalld.service
           └─686 /usr/bin/python2 -Es /usr/sbin/firewalld --nofork --nopid

Apr 23 22:51:24 master systemd[1]: Starting firewalld - dynamic firewall daemon...
Apr 23 22:51:25 master systemd[1]: Started firewalld - dynamic firewall daemon.
关键信息:
-
Active: active (running)→ 防火墙开启中 -
Active: inactive (dead)→ 防火墙已关闭
2.关闭防火墙(临时)
# 立即关闭
systemctl stop firewalld

# 验证是否关闭
systemctl status firewalld
# 显示 Active: inactive (dead)
[root@master ~]# systemctl stop firewalld
[root@master ~]# systemctl status firewalld
● firewalld.service - firewalld - dynamic firewall daemon
Loaded: loaded (/usr/lib/systemd/system/firewalld.service; enabled; vendor preset: enabled)
Active: inactive (dead) since Fri 2026-04-24 00:52:45 CST; 22s ago
Docs: man:firewalld(1)
Process: 686 ExecStart=/usr/sbin/firewalld --nofork --nopid $FIREWALLD_ARGS (code=exited, status=0/SUCCESS)
Main PID: 686 (code=exited, status=0/SUCCESS)
Apr 23 22:51:24 master systemd[1]: Starting firewalld - dynamic firewall daemon...
Apr 23 22:51:25 master systemd[1]: Started firewalld - dynamic firewall daemon.
Apr 24 00:52:45 master systemd[1]: Stopping firewalld - dynamic firewall daemon...
Apr 24 00:52:45 master systemd[1]: Stopped firewalld - dynamic firewall daemon.3.开启防火墙(临时)
# 立即开启
systemctl start firewalld

# 验证是否开启
systemctl status firewalld
# 显示 Active: active (running)
4.永久关闭防火墙(开机不自启)
# 停止防火墙 + 禁用开机启动
systemctl stop firewalld
systemctl disable firewalld

# 验证
systemctl status firewalld   # 显示 inactive
systemctl is-enabled firewalld   # 显示 disabled
5.永久开启防火墙(开启自启)
# 开启防火墙 + 设置开机启动
systemctl start firewalld
systemctl enable firewalld

# 验证
systemctl status firewalld   # 显示 active
systemctl is-enabled firewalld   # 显示 enabled
2.启动后的基础操作
1.初步试探
[root@master current]# systemctl stop firewalld
[root@slave1 current]# systemctl stop firewalld
[root@slave2 current]# systemctl stop firewalld
[root@master current]# echo "Hello HDFS" > ~/test.txt # 创建一个测试文件
[root@master current]# ls ~
anaconda-ks.cfg  hadoop-3.1.4.tar.gz  test.txt  文件.txt
[root@master current]# cat ~/test.txt
Hello HDFS
[root@master current]# timeout 2 bash -c "echo > /dev/tcp/192.168.128.131/9866" && echo "端口9866可达" || echo "端口9866不可达"
端口9866可达
[root@master current]# hdfs dfs -ls /
Found 1 items
drwxrwx---   - root supergroup          0 2026-04-18 02:27 /tmp
[root@master current]# hdfs dfs -put ~/test.txt /test.txt # 上传到HDFS
[root@master current]# hdfs dfs -ls /
Found 2 items
-rw-r--r--   2 root supergroup         11 2026-04-23 09:38 /test.txt
drwxrwx---   - root supergroup          0 2026-04-18 02:27 /tmp
HDFS命令操作的目录和文件与启动Hadoop之前Linux系统的目录是完全不同的两套系统
- Linux本地文件系统:存储在你每个节点的硬盘上(如/home/,/var/等)
- HDFS分布式文件系统:跨越所有DataNode节点的存储空间,通过NameNode统一管理
HDFS的“目录”实际在哪里?
例如当你执行:hdfs dfs -put /home/test.txt /user/data/
发生的事情如下:
- 源文件/home/test.txt在本地Linux文件系统上(你的NameNode节点的硬盘上)
- 目标路径/user/data/是HDFS的逻辑目录,它并不对应某个节点的具体路径
- 实际数据存储:文件被切分成块(默认128MB),每个块被复制到不同的DataNode节点的dfs.datanode.data.dir配置目录下
查看实际存储位置:
在DataNode节点上,HDFS的数据块实际存储在:hdfs-site.xml中
[root@master ~]# cd /opt # 找hdfs-site.xml文件中......
[root@master opt]# ls
hadoop-3.1.4  jdk-8u281-linux-x64.rpm
[root@master opt]# cd hadoop-3.1.4
[root@master hadoop-3.1.4]# ls
bin  etc  include  lib  libexec  LICENSE.txt  logs  NOTICE.txt  README.txt  sbin  share
[root@master hadoop-3.1.4]# cd sbin
[root@master sbin]# ls # 发现sbin目录下没有
distribute-exclude.sh  hadoop-daemons.sh  mr-jobhistory-daemon.sh  start-all.sh       start-dfs.sh         start-yarn.sh  stop-balancer.sh  stop-secure-dns.sh  workers.sh
FederationStateStore   httpfs.sh          refresh-namenodes.sh     start-balancer.sh  start-secure-dns.sh  stop-all.cmd   stop-dfs.cmd      stop-yarn.cmd       yarn-daemon.sh
hadoop-daemon.sh       kms.sh             start-all.cmd            start-dfs.cmd      start-yarn.cmd       stop-all.sh    stop-dfs.sh       stop-yarn.sh        yarn-daemons.sh
[root@master sbin]# cd ../bin
[root@master bin]# ls # bin目录下也没有
container-executor  hadoop  hadoop.cmd  hdfs  hdfs.cmd  mapred  mapred.cmd  test-container-executor  yarn  yarn.cmd
[root@master bin]# cd ..
[root@master hadoop-3.1.4]# ls
bin  etc  include  lib  libexec  LICENSE.txt  logs  NOTICE.txt  README.txt  sbin  share
[root@master hadoop-3.1.4]# find / -name "hdfs-site.xml" # 只能用find命令来找了,还是从根目录开始找起
/opt/hadoop-3.1.4/etc/hadoop/hdfs-site.xml
[root@master hadoop-3.1.4]# cd /etc # 切换到根目录下的etc目录中去了
[root@master etc]# ls # 自然找不到hdfs-site.xml
adjtime                  cron.monthly             exports      hostname       libnl                     my.cnf.d           popt.d          redhat-release    skel                tmpfiles.d
aliases                  crontab                  favicon.png  hosts          libuser.conf              NetworkManager     postfix         resolv.conf       ssh                 tuned
aliases.db               cron.weekly              filesystems  hosts.allow    locale.conf               networks           ppp             resolv.conf.save  ssl                 udev
alternatives             crypttab                 firewalld    hosts.deny     localtime                 nsswitch.conf      prelink.conf.d  rpc               statetab            vconsole.conf
anacrontab               csh.cshrc                fstab        init.d         login.defs                nsswitch.conf.bak  printcap        rpm               statetab.d          vimrc
asound.conf              csh.login                fuse.conf    inittab        logrotate.conf            ntp                profile         rsyslog.conf      subgid              virc
audisp                   dbus-1                   gcrypt       inputrc        logrotate.d               ntp.conf           profile.d       rsyslog.d         subuid              vmware-tools
audit                    default                  gnupg        iproute2       lvm                       openldap           protocols       rwtab             sudo.conf           wgetrc
bash_completion.d        depmod.d                 GREP_COLORS  issue          machine-id                opt                python          rwtab.d           sudoers             wpa_supplicant
bashrc                   dhcp                     groff        issue.net      magic                     os-release         rc0.d           sasl2             sudoers.d           X11
binfmt.d                 DIR_COLORS               group        kdump.conf     makedumpfile.conf.sample  pam.d              rc1.d           securetty         sudo-ldap.conf      xdg
centos-release           DIR_COLORS.256color      group-       kernel         man_db.conf               passwd             rc2.d           security          sysconfig           xinetd.d
centos-release-upstream  DIR_COLORS.lightbgcolor  grub2.cfg    krb5.conf      mke2fs.conf               passwd-            rc3.d           selinux           sysctl.conf         yum
chkconfig.d              dracut.conf              grub.d       krb5.conf.d    modprobe.d                pkcs11             rc4.d           services          sysctl.d            yum.conf
cron.d                   dracut.conf.d            gshadow      ld.so.cache    modules-load.d            pki                rc5.d           sestatus.conf     systemd             yum.repos.d
cron.daily               e2fsck.conf              gshadow-     ld.so.conf     motd                      plymouth           rc6.d           shadow            system-release
cron.deny                environment              gss          ld.so.conf.d   mtab                      pm                 rc.d            shadow-           system-release-cpe
cron.hourly              ethertypes               host.conf    libaudit.conf  my.cnf                    polkit-1           rc.local        shells            terminfo
[root@master etc]# cd hadoop # 没有这个目录
-bash: cd: hadoop: No such file or directory
[root@master etc]# cd - # 返回上一次所在的目录
/opt/hadoop-3.1.4
[root@master hadoop-3.1.4]# ls
bin  etc  include  lib  libexec  LICENSE.txt  logs  NOTICE.txt  README.txt  sbin  share
[root@master hadoop-3.1.4]# cd ./etc # 切换到当前目录下的etc目录
[root@master etc]# ls
hadoop
[root@master etc]# cd hadoop
[root@master hadoop]# ls
capacity-scheduler.xml  hadoop-env.sh                     httpfs-env.sh            kms-env.sh            mapred-env.sh               ssl-server.xml.example         yarnservice-log4j.properties
configuration.xsl       hadoop-metrics2.properties        httpfs-log4j.properties  kms-log4j.properties  mapred-queues.xml.template  user_ec_policies.xml.template  yarn-site.xml
container-executor.cfg  hadoop-policy.xml                 httpfs-signature.secret  kms-site.xml          mapred-site.xml             workers
core-site.xml           hadoop-user-functions.sh.example  httpfs-site.xml          log4j.properties      shellprofile.d              yarn-env.cmd
hadoop-env.cmd          hdfs-site.xml                     kms-acls.xml             mapred-env.cmd        ssl-client.xml.example      yarn-env.sh
[root@master hadoop]# cat hdfs-site.xml # 找到了!然后cat一下
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<!--
  Licensed under the Apache License, Version 2.0 (the "License");
  you may not use this file except in compliance with the License.
  You may obtain a copy of the License at

    http://www.apache.org/licenses/LICENSE-2.0

  Unless required by applicable law or agreed to in writing, software
  distributed under the License is distributed on an "AS IS" BASIS,
  WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
  See the License for the specific language governing permissions and
  limitations under the License. See accompanying LICENSE file.
-->

<!-- Put site-specific property overrides in this file. -->

<configuration>
	<property>
		 <name>dfs.namenode.name.dir</name>
 		 <value>file:///data/hadoop/hdfs/name</value>
	</property>
	<property>
 		<name>dfs.datanode.data.dir</name>
 		<value>file:///data/hadoop/hdfs/data</value>
	</property>
 	<property>
		 <name>dfs.namenode.secondary.http-address</name>
 		<value>master:50090</value>
 	</property>
 	<property>
 		<name>dfs.replication</name>
 		<value>2</value>
	</property>
</configuration>
下面来分析一下hdfs-site.xml中的内容:
<!-- Put site-specific property overrides in this file. -->

<configuration>
	<property>
		 <name>dfs.namenode.name.dir</name>
 		 <value>file:///data/hadoop/hdfs/name</value>
	</property>
	<property>
 		<name>dfs.datanode.data.dir</name>
 		<value>file:///data/hadoop/hdfs/data</value>
	</property>
 	<property>
		 <name>dfs.namenode.secondary.http-address</name>
 		<value>master:50090</value>
 	</property>
 	<property>
 		<name>dfs.replication</name>
 		<value>2</value>
	</property>
</configuration>
1.
dfs.namenode.name.dir是NameNode元数据存储路径:NameNode节点用来存储文件系统元数据的本地磁盘路径。其存储的内容:fsimage(文件镜像系统,包含完整的目录树结构、文件属性、权限等)、edits log(编辑日志,记录所有对HDFS的写操作)
实际目录结构在:/data/hadoop/hdfs/name/current/
[root@master hadoop]# ls /
bin  boot  data  demo01  dev  etc  home  lib  lib64  media  mnt  opt  parent  proc  Projects  root  run  sbin  srv  sys  Tests  tmp  usr  var
[root@master hadoop]# ls /data
hadoop
[root@master hadoop]# ls /data/hadoop
hdfs  namenode  tmp
[root@master hadoop]# ls /data/hadoop
hdfs  namenode  tmp
[root@master hadoop]# ls /data/hadoop/hdfs
name
[root@master hadoop]# ls /data/hadoop/hdfs/name
current  in_use.lock
[root@master hadoop]# ls /data/hadoop/hdfs/name/current
edits_0000000000000000001-0000000000000000009  edits_0000000000000000015-0000000000000000016  edits_0000000000000000039-0000000000000000040  fsimage_0000000000000000041.md5
edits_0000000000000000010-0000000000000000010  edits_0000000000000000017-0000000000000000017  edits_0000000000000000041-0000000000000000041  fsimage_0000000000000000042
edits_0000000000000000011-0000000000000000011  edits_0000000000000000018-0000000000000000019  edits_0000000000000000042-0000000000000000042  fsimage_0000000000000000042.md5
edits_0000000000000000012-0000000000000000013  edits_0000000000000000020-0000000000000000036  edits_inprogress_0000000000000000043           seen_txid
edits_0000000000000000014-0000000000000000014  edits_0000000000000000037-0000000000000000038  fsimage_0000000000000000041                    VERSION
重要说明:file://这个前缀表明这是本地Linux文件系统路径,不是HDFS路径。
这个目录只存在NameNode节点上(你配置的master节点上)
如果这个目录损坏或丢失,整个HDFS文件系统元数据将丢失(无法恢复文件)
而生产环境中通常会配置多个路径(不同磁盘)来冗余存储
2.
dfs.datanode.data.dir表示DataNode数据块存储路径:DataNode节点用来实际存储数据块的本地磁盘路径。 其存储的内容:数据块文件(blk_*)、数据块的校验文件(blk_*.meta)
[root@master hadoop]# ls /data/hadoop/hdfs
name
[root@master hadoop]# ls /data/hadoop/hdfs/name
current  in_use.lock
[root@master hadoop]# ls /data/hadoop/hdfs/name/current
edits_0000000000000000001-0000000000000000009  edits_0000000000000000015-0000000000000000016  edits_0000000000000000039-0000000000000000040  fsimage_0000000000000000041      VERSION
edits_0000000000000000010-0000000000000000010  edits_0000000000000000017-0000000000000000017  edits_0000000000000000041-0000000000000000041  fsimage_0000000000000000041.md5
edits_0000000000000000011-0000000000000000011  edits_0000000000000000018-0000000000000000019  edits_0000000000000000042-0000000000000000042  fsimage_0000000000000000042
edits_0000000000000000012-0000000000000000013  edits_0000000000000000020-0000000000000000036  edits_0000000000000000043-0000000000000000051  fsimage_0000000000000000042.md5
edits_0000000000000000014-0000000000000000014  edits_0000000000000000037-0000000000000000038  edits_inprogress_0000000000000000052           seen_txid
3.
dfs.namenode.secondeary.http-address是SecondaryNameNode地址:
即辅助名称节点的Web界面和端口
它会定期从NameNode合并fsimage和edits log,生产新的fsimage。会减少NameNode重启时的合并实践。
它的访问方式为:http://master:50090
重要说明:SecondaryNameNode和NameNode通常放在不同的机器上(你配置在同一台master上,仅用于学习环境)。并且它不提供故障转移能力,NameNode挂了它无法自动接管
4.
dfs.replication是默认副本数:HDFS中每个文件默认的副本数量
值为2:每个文件会被存储2份在不同的DataNode上
数据可靠性:运行1台DataNode损坏而不丢失数据
存储空间:上传1GB文件,实际会占用2GB存储空间
| 副本数 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 1 | 节省存储空间 | 任意节点故障即丢数据 | 临时数据、可重新生成的数据 |
| 2 | 节省50%空间,一定可靠性 | 单点故障有风险 | 小规模学习集群 |
| 3(生产默认) | 高可靠性,容忍2节点故障 | 存储成本高 | 生产环境重要数据 |
[root@master hadoop]# ls /data/hadoop/namenode
[root@master hadoop]# hdfs dfs -ls /
Found 2 items
-rw-r--r--   2 root supergroup         11 2026-04-23 09:38 /test.txt
drwxrwx---   - root supergroup          0 2026-04-18 02:27 /tmp
[root@master hadoop]# hdfs dfs -cat /test.txt
2026-04-25 11:52:08,094 WARN impl.BlockReaderFactory: I/O error constructing remote block reader.
java.net.NoRouteToHostException: No route to host
	at sun.nio.ch.SocketChannelImpl.checkConnect(Native Method)
	at sun.nio.ch.SocketChannelImpl.finishConnect(SocketChannelImpl.java:715)
	at org.apache.hadoop.net.SocketIOWithTimeout.connect(SocketIOWithTimeout.java:206)
	at org.apache.hadoop.net.NetUtils.connect(NetUtils.java:531)
只截取了部分输出
没有正确cat出test.txt的内容,这是因为我只关闭了master节点上的防火墙,但这远远还不够。
因为读取文件test.txt时:
- NameNode(master)告诉客户端:“这个文件目前在slave1和slave2上”
- 于是客户端尝试连接slave1:9886,但是被slave1的firewall拦截住
- 客户端尝试连接slave2:9866,但同样被slave2的防火墙拦住
- 导致了最终的失败
我关闭了slave1的防火墙,就能正常输出了。貌似只关闭一台服务器的防火墙就可以吗?因为slave1上也存储了test.txt?
最好还是都关闭
因为HDFS客户端会随机选择或按网络拓扑选择一个DataNode来读取。如果选中的节点防火墙没关,那么就会读取失败。
[root@master hadoop]# hdfs dfs -cat /test.txt
Hello HDFS
[root@master /]# ls
bin  boot  data  demo01  dev  etc  home  lib  lib64  media  mnt  opt  parent  proc  Projects  root  run  sbin  srv  sys  Tests  tmp  usr  var
[root@master /]# cd data
[root@master data]# ls
hadoop
[root@master data]# cd hadoop
[root@master hadoop]# ls
hdfs  namenode  tmp
[root@master hadoop]# cd hdfs
[root@master hdfs]# ls
name
[root@master hdfs]# cd name
[root@master name]# ls
current  in_use.lock
[root@master name]# cd curren
-bash: cd: curren: No such file or directory
[root@master name]# cd current
[root@master current]# ls
edits_0000000000000000001-0000000000000000009  edits_0000000000000000015-0000000000000000016  edits_0000000000000000039-0000000000000000040  fsimage_0000000000000000041      VERSION
edits_0000000000000000010-0000000000000000010  edits_0000000000000000017-0000000000000000017  edits_0000000000000000041-0000000000000000041  fsimage_0000000000000000041.md5
edits_0000000000000000011-0000000000000000011  edits_0000000000000000018-0000000000000000019  edits_0000000000000000042-0000000000000000042  fsimage_0000000000000000042
edits_0000000000000000012-0000000000000000013  edits_0000000000000000020-0000000000000000036  edits_0000000000000000043-0000000000000000051  fsimage_0000000000000000042.md5
edits_0000000000000000014-0000000000000000014  edits_0000000000000000037-0000000000000000038  edits_inprogress_0000000000000000052           seen_txid
[root@master current]# ls -l
total 8244
-rw-r--r--. 1 root root     672 Apr 18 02:28 edits_0000000000000000001-0000000000000000009
-rw-r--r--. 1 root root 1048576 Apr 18 02:28 edits_0000000000000000010-0000000000000000010
-rw-r--r--. 1 root root 1048576 Apr 19 12:10 edits_0000000000000000011-0000000000000000011
-rw-r--r--. 1 root root      42 Apr 19 12:50 edits_0000000000000000012-0000000000000000013
-rw-r--r--. 1 root root 1048576 Apr 19 12:50 edits_0000000000000000014-0000000000000000014
-rw-r--r--. 1 root root      42 Apr 23 00:51 edits_0000000000000000015-0000000000000000016
-rw-r--r--. 1 root root 1048576 Apr 23 00:51 edits_0000000000000000017-0000000000000000017
-rw-r--r--. 1 root root      42 Apr 23 08:46 edits_0000000000000000018-0000000000000000019
-rw-r--r--. 1 root root 1048576 Apr 23 09:38 edits_0000000000000000020-0000000000000000036
-rw-r--r--. 1 root root      42 Apr 23 23:51 edits_0000000000000000037-0000000000000000038
-rw-r--r--. 1 root root      42 Apr 24 00:52 edits_0000000000000000039-0000000000000000040
-rw-r--r--. 1 root root 1048576 Apr 24 00:52 edits_0000000000000000041-0000000000000000041
-rw-r--r--. 1 root root 1048576 Apr 25 00:49 edits_0000000000000000042-0000000000000000042
-rw-r--r--. 1 root root     656 Apr 25 11:21 edits_0000000000000000043-0000000000000000051
-rw-r--r--. 1 root root 1048576 Apr 25 11:52 edits_inprogress_0000000000000000052
-rw-r--r--. 1 root root     870 Apr 25 00:49 fsimage_0000000000000000041
-rw-r--r--. 1 root root      62 Apr 25 00:49 fsimage_0000000000000000041.md5
-rw-r--r--. 1 root root     870 Apr 25 10:34 fsimage_0000000000000000042
-rw-r--r--. 1 root root      62 Apr 25 10:34 fsimage_0000000000000000042.md5
-rw-r--r--. 1 root root       3 Apr 25 11:21 seen_txid
-rw-r--r--. 1 root root     219 Apr 25 10:34 VERSION
master节点的/data/hadoop/hdfs/name/:存储目录树和文件列表(元数据),不存储文件
slave的/data/hadoop/hdfs/data/:存储真正的文件数据块(二进制数据)
上面的/data/hadoop/hdfs/name/current目录中:
1.fsimage_*文件是文件系统镜像文件
这是HDFS文件系统的完整快照,记录了所有目录和文件的树形结构、每个文件的属性(名称、权限、所有者、大小)、每个文件由哪些数据块组成(块ID列表)
-rw-r--r--. 1 root root     870 Apr 25 00:49 fsimage_0000000000000000041
-rw-r--r--. 1 root root      62 Apr 25 00:49 fsimage_0000000000000000041.md5
-rw-r--r--. 1 root root     870 Apr 25 10:34 fsimage_0000000000000000042
-rw-r--r--. 1 root root      62 Apr 25 10:34 fsimage_0000000000000000042.md5
-rw-r--r--. 1 root root       3 Apr 25 11:21 seen_txid
-rw-r--r--. 1 root root     219 Apr 25 10:34 VERSION
root root后面是文件大小(字节数),如第一个fsimage文件大小为870字节
2.edit_*是编辑日志文件
作用:记录自上次fsimage之后所有写操作(创建文件、删除文件、修改权限)
命名规则:
- edits_开始事物-结束事物ID:以封存的日志段
- edits_inprogress_当前事物ID:正在写入的日志(活跃状态)
3.seen_txid是最后提交事务的Id
作用:记录NameNode最近一次启动时看到的最大事务ID
重要性:NameNode重启时会读取这个文件,知道从哪个事务开始恢复
[root@master current]# cat seen_txid
55
4.VERSION是集群元数据信息
[root@master current]# cat VERSION
#Sat Apr 25 10:34:10 CST 2026
namespaceID=1061011551
clusterID=CID-30fb5b2b-e186-4e04-be58-61f90a309985
cTime=1776450313876
storageType=NAME_NODE
blockpoolID=BP-447229057-192.168.128.130-1776450313876
layoutVersion=-64
作用:记录NameNode的版本、集群ID等元信息
[root@slave1 current]# clear
[root@slave1 current]# cd /
[root@slave1 /]# clear
[root@slave1 /]# ls
bin  boot  data  demo01  dev  etc  home  lib  lib64  media  mnt  opt  proc  root  run  sbin  srv  sys  tmp  usr  var
[root@slave1 /]# cd data
[root@slave1 data]# ls
hadoop
[root@slave1 data]# cd hadoop
[root@slave1 hadoop]# ls
datanode  hdfs  tmp  yarn
[root@slave1 hadoop]# cd hdfs
[root@slave1 hdfs]# ls
data
[root@slave1 hdfs]# cd data
[root@slave1 data]# ls
current  in_use.lock
[root@slave1 data]# cd current
[root@slave1 current]# ls
BP-447229057-192.168.128.130-1776450313876  VERSION
[root@slave1 current]# cd BP-447229057-192.168.128.130-1776450313876/
[root@slave1 BP-447229057-192.168.128.130-1776450313876]# ls
current  scanner.cursor  tmp
[root@slave1 BP-447229057-192.168.128.130-1776450313876]# cd current
[root@slave1 current]# ls
dfsUsed  finalized  rbw  VERSION
[root@slave1 current]# cd finalized/
[root@slave1 finalized]# ls
subdir0
[root@slave1 finalized]# cd subdir0/
[root@slave1 subdir0]# ls
subdir0
[root@slave1 subdir0]# cd subdir0
[root@slave1 subdir0]# ls
blk_1073741827  blk_1073741827_1003.meta
[root@slave1 subdir0]# cat blk_1073741827
Hello HDFS
[root@slave1 subdir0]# cat blk_1073741827_1003.meta
1.BP-447229057-192.168.128.130-1776450313876
这是块池目录。BP=Block Pool
447229057 = 块池ID
192.168.128.130 = NameNode的IP地址
1776450313876 = 创建时间戳
cat blk_1073741827
# 输出: Hello HDFS
数据块是可读的,因为在默认情况下,HDFS的数据块没有加密
| 主要目录 | 存储内容 | 文件大小特点 | ||
|---|---|---|---|---|
| master | NameNode | /data/hadoop/hdfs/name/current/ | 元数据(fsimage + edits) | 通常只有几MB到几百MB |
| slave1 | DataNode | /data/hadoop/hdfs/data/current/ | 实际数据块(blk_*) | 与上传文件大小相关 |
| slave2 | DataNode | /data/hadoop/hdfs/data/current/ | 实际数据块(blk_*) | 与上传文件大小相关 |
2.HDFS的常用命令
核心命令格式:
hdfs dfs -[命令] [参数]小技巧:很多地方也支持使用hdfs fs,但官方更推荐使用hdfs dfs,因为后者更专属于HDFS
1.目录操作(最常用)
这些命令和Linux几乎一模一样,很容易上手。
| 命令 | 功能 | 示例 |
|---|---|---|
-ls | 列出目录内容 | hdfs dfs -ls / (查看根目录)hdfs dfs -ls -R / (递归查看所有子目录) |
-mkdir | 创建目录 | hdfs dfs -mkdir /userhdfs dfs -mkdir -p /user/hadoop/data (创建多级目录) |
-rmdir | 删除空目录 | hdfs dfs -rmdir /empty_dir |
2.文件操作(上传/下载/查看)
这是将本地数据和HDFS打通的关键。
| 命令 | 功能 | 示例 |
|---|---|---|
-put | 将本地文件上传到HDFS | hdfs dfs -put /home/test.txt /user/data/ |
-copyFromLocal | 功能同-put(更语义化) | hdfs dfs -copyFromLocal ./a.txt / |
-get | 将HDFS上的文件下载到本地 | hdfs dfs -get /user/data/test.txt /home/ |
-copyToLocal | 功能同-get | hdfs dfs -copyToLocal /data.txt ./ |
-cat | 查看HDFS文件内容 | hdfs dfs -cat /user/data/word.txt |
-tail | 查看文件末尾1KB(适合看日志) | hdfs dfs -tail /logs/hadoop.log |
-head | 查看文件开头 | hdfs dfs -head /user/data/bigfile.txt |
3.文件管理(删除/移动/复制/修改)
| 命令 | 功能 | 示例 |
|---|---|---|
-rm | 删除文件或目录 | hdfs dfs -rm /user/data/temp.txthdfs dfs -rm -r /user/old_dir (递归删除目录) |
-mv | 移动或重命名 | hdfs dfs -mv /data/a.txt /backup/b.txt |
-cp | 复制文件 | hdfs dfs -cp /data/input.txt /data/output/ |
-chmod | 修改权限(同Linux) | hdfs dfs -chmod 755 /user/script.sh |
-chown | 修改所有者 | hdfs dfs -chown hadoop:hadoop /user/data |
4.系统信息与统计(运维常用)
| 命令 | 功能 | 示例 |
|---|---|---|
-df | 查看HDFS整体容量 | hdfs dfs -df -h / (人类可读格式) |
-du | 查看指定目录的大小 | hdfs dfs -du -s -h /user/data (显示总大小)hdfs dfs -du -h /user/* (逐项显示) |
-setrep | 修改文件的副本数 | hdfs dfs -setrep -w 3 /important/file (设置为3副本) |
-stat | 显示文件统计信息 | hdfs dfs -stat "%n (size %b)" /data.txt |
-count | 统计目录下的文件/目录数量 | hdfs dfs -count /user |
6.常见问题
-
路径区分:不带前缀的路径(如
/home/a.txt)是HDFS路径;带file://或直接写本地路径(如~/a.txt)才是本地路径。-put的第一个参数是本地,第二个是HDFS。 -
删除不经过回收站:
-rm默认直接删除(除非配置了Trash)。删除前建议先用-ls确认。 -
权限错误:如果你用非root用户操作,遇到
Permission denied,可以先用-chmod或-chown调整,或联系管理员。 -
安全模式:刚启动集群时,HDFS会进入安全模式(只读)。这时只能执行
-ls、-cat等读操作,写入操作会报错,等几分钟自动退出即可。
3.练习一
[root@master current]# hdfs dfs -mkidr /Tests
[root@master current]# hdfs dfs -touchz /Tests/input.txt # Linux中创建空文件的命令是touch,而在HDFS中创建空文件的命令是-touchz,z表示zero,-touchz表示创建一个零字节的空文件。在Linux中,touch命令创建空文件时如果文件不存在则创建空文件,如果文件存在则会更新时间戳。HDFS中-touchz遇到文件已经存在时会报错(只会创建0字节的空文件,只创建不更新)
[root@master current]# hdfs dfs -ls /Tests
Found 1 items
-rw-r--r--   2 root supergroup          0 2026-04-26 23:42 /Tests/input.txt
[root@master current]# hdfs dfs -ls /Tests/input.txt # 0字节空文件
-rw-r--r--   2 root supergroup          0 2026-04-26 23:42 /Tests/input.txt
[root@master current]# hdfs dfs -touchz /Tests/input.txt # 其实不会报错,会更新时间戳。Hadoop版本是3.1.4,老版本中估计会报错
[root@master current]# hdfs dfs -ls /Tests/input.txt
-rw-r--r--   2 root supergroup          0 2026-04-26 23:51 /Tests/input.txt
[root@master current]# echo "送你一朵小红花,开在你昨天新长的枝桠" > ~/ data1.txt
-bash: /root/: Is a directory
[root@master current]# echo "送你一朵小红花,开在你昨天新长的枝桠" > ~/data1.txt
[root@master current]# ls ~/
anaconda-ks.cfg  data1.txt  hadoop-3.1.4.tar.gz  test.txt
[root@master current]# cat ~/data1.txt
送你一朵小红花,开在你昨天新长的枝桠
[root@master current]# echo "奖励你有勇气,主动来和我说话" >> ~/data1.txt
[root@master current]# echo "送你一朵小红花,遮住你今天新添的伤疤" >> ~/data1.txt
[root@master current]# echo "会有美好的未来!" >> ~/data1.txt
[root@master current]# cat ~/data1.txt
送你一朵小红花,开在你昨天新长的枝桠
奖励你有勇气,主动来和我说话
送你一朵小红花,遮住你今天新添的伤疤
会有美好的未来!
[root@master current]# hdfs dfs -put ~/data1.txt /Tests
[root@master current]# hdfs dfs -ls /Tests
Found 2 items
-rw-r--r--   2 root supergroup        178 2026-04-27 00:01 /Tests/data1.txt
-rw-r--r--   2 root supergroup          0 2026-04-26 23:51 /Tests/input.txt
[root@master current]# hdfs dfs -cat /Tests/data1.txt
送你一朵小红花,开在你昨天新长的枝桠
奖励你有勇气,主动来和我说话
送你一朵小红花,遮住你今天新添的伤疤
会有美好的未来!
[root@master current]# echo "这是电影《送你一朵小红花主题曲》。用/"送你一朵小红花/"的意向。温柔记录抗癌家庭的日常,把苦难熬成糖,把绝望写成诗。歌中/"遮住新添的伤疤/"/"战胜苦难的日子/"等句子,成 了许多人面对困境时的精神锚点。" > ~/data2.txt
[root@master current]# ls ~/data2.txt
/root/data2.txt
[root@master current]# ls ~
anaconda-ks.cfg  data1.txt  data2.txt  hadoop-3.1.4.tar.gz  test.txt
[root@master current]# cat ~/data2.txt
这是电影《送你一朵小红花主题曲》。用/送你一朵小红花/的意向。温柔记录抗癌家庭的日常,把苦难熬成糖,把绝望写成诗。歌中/遮住新添的伤疤//战胜苦难的日子/等句子,成了许多人面对困境时的精神锚点。
[root@master current]# vim ~/data2.txt
[root@master current]# cat ~/data2.txt
这是电影《送你一朵小红花主题曲》。用“送你一朵小红花”的意向。温柔记录抗癌家庭的日常,把苦难熬成糖,把绝望写成诗。
歌中“遮住新添的伤疤”“战胜苦难的日子”等句子,成了许多人面对困境时的精神锚点。
[root@master current]# hdfs dfs -moveFromLocal ~/data2.txt /Tests # 将本地文件移动到HDFS
[root@master current]# ls ~/
anaconda-ks.cfg  data1.txt  data3.txt  hadoop-3.1.4.tar.gz  test.txt
[root@master current]# hdfs dfs -ls /Tests
Found 3 items
-rw-r--r--   2 root supergroup        178 2026-04-27 00:01 /Tests/data1.txt
-rw-r--r--   2 root supergroup        293 2026-04-27 00:30 /Tests/data2.txt
-rw-r--r--   2 root supergroup          0 2026-04-26 23:51 /Tests/input.txt
[root@master current]# hdfs dfs -cat /Tests/data2.txt
这是电影《送你一朵小红花主题曲》。用“送你一朵小红花”的意向。温柔记录抗癌家庭的日常,把苦难熬成糖,把绝望写成诗。
歌中“遮住新添的伤疤”“战胜苦难的日子”等句子,成了许多人面对困境时的精神锚点。
注意:
HDFS中没有隐藏文件这个概念,所以用-ls -a这个命令会报错
| 命令 | 作用范围 | 操作对象 |
|---|---|---|
hdfs dfs -mv | HDFS 内部 | HDFS 文件 → HDFS 文件 |
hdfs dfs -put | 本地 → HDFS | 本地文件 → HDFS |
hdfs dfs -get | HDFS → 本地 | HDFS 文件 → 本地 |
mv (不带 hdfs) | 本地内部 | 本地文件 → 本地文件 |
要将本地文件移动到HDFS,要用-moveFromLocal命令
[root@master current]# hdfs dfs -get /Tests/data2.txt ~/file1.txt # 把data2.txt文件从分布式系统下载到本地并改名为file1.txt
[root@master current]# ls ~/
anaconda-ks.cfg  data1.txt  data3.txt  file1.txt  hadoop-3.1.4.tar.gz  test.txt
[root@master current]# cat ~/file1.txt
这是电影《送你一朵小红花主题曲》。用“送你一朵小红花”的意向。温柔记录抗癌家庭的日常,把苦难熬成糖,把绝望写成诗。
歌中“遮住新添的伤疤”“战胜苦难的日子”等句子,成了许多人面对困境时的精神锚点。
[root@master current]# hdfs dfs -ls /Tests/
Found 3 items
-rw-r--r--   2 root supergroup        178 2026-04-27 00:01 /Tests/data1.txt
-rw-r--r--   2 root supergroup        293 2026-04-27 00:30 /Tests/data2.txt
-rw-r--r--   2 root supergroup          0 2026-04-26 23:51 /Tests/input.txt
3.关闭Hadoop集群
推荐的关闭顺序:
注:这是在/opt/hadoop-3.1.4/sbin目录下的操作命令
# 1. 先关闭 YARN(资源管理器)
./stop-yarn.sh

# 2. 再关闭 HDFS(存储系统)
./stop-dfs.sh

# 3. 最后关闭历史服务器(可选)
./mr-jobhistory-daemon.sh stop historyserver| 关闭顺序 | 结果 | 说明 |
|---|---|---|
| 先关 YARN,后关 HDFS | ✅ 正常 | YARN 上的任务先结束,然后 HDFS 安全关闭 |
| 先关 HDFS,后关 YARN | ⚠️ 可能有问题 | HDFS 关闭时,YARN 上的任务还在读写数据,会报错 |
具体原因:
-
YARN 依赖 HDFS
-
YARN 上的 MapReduce 任务需要从 HDFS 读取数据
-
任务执行结果也要写入 HDFS
-
如果先关 HDFS,YARN 任务会立即报错:
java.io.IOException: No FileSystem for scheme: hdfs
-
-
优雅关闭 vs 强制中断
-
先关 YARN:YARN 会等待当前任务完成,或优雅地终止它们
-
先关 HDFS:正在读写数据的任务会突然断开连接,可能造成数据不一致
-
检查是否关闭成功:
关闭后,用 jps 验证所有节点上都没有 Hadoop 进程了:
如:
[root@master sbin]# cd ..
[root@master hadoop-3.1.4]# cd /
[root@master /]# stop-yarn.sh
Stopping nodemanagers
Last login: Wed Apr 22 23:56:04 CST 2026 on pts/0
Stopping resourcemanager
Last login: Thu Apr 23 01:14:42 CST 2026 on pts/0
[root@master /]# stop-dfs.sh
WARNING: HADOOP_SECURE_DN_USER has been replaced by HDFS_DATANODE_SECURE_USER. Using value of HADOOP_SECURE_DN_USER.
Stopping namenodes on [master]
Last login: Thu Apr 23 01:14:43 CST 2026 on pts/0
Stopping datanodes
Last login: Thu Apr 23 01:15:01 CST 2026 on pts/0
Stopping secondary namenodes [master]
Last login: Thu Apr 23 01:15:02 CST 2026 on pts/0
[root@master /]# mr-jobhistory-daemon.sh stop historyserver
WARNING: Use of this script to stop the MR JobHistory daemon is deprecated.
WARNING: Attempting to execute replacement "mapred --daemon stop" instead.
[root@master /]# jps
8092 Jps
更多推荐


 9
 0
- 0


 已为社区贡献3条内容

所有评论(0)