
云计算Linux——正则表达式(四)
一、正则表达式核心概念复盘
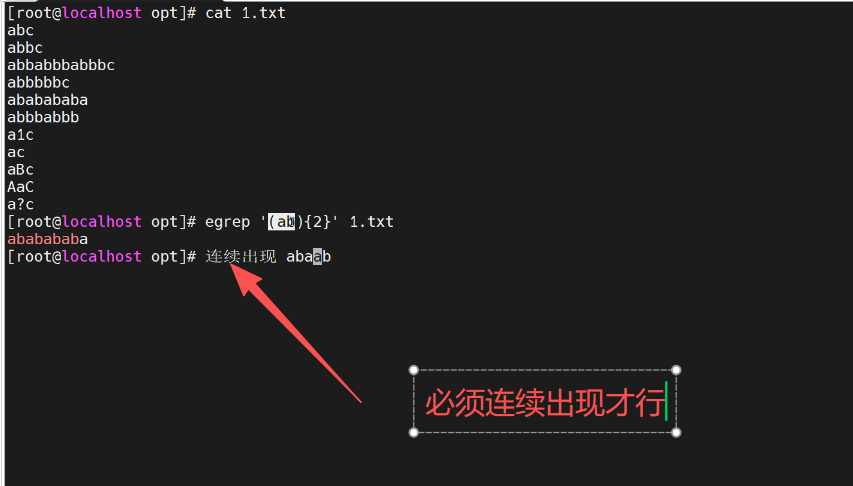
1. 连续出现(Quantifier)的逻辑解析括号的常见用法:
概念定义:量词(如 `{n}`)表示的是其前面紧邻的字符或组必须“连续”出现指定次数,中间不能插入任何其他字符。
错误案例纠正:针对 `(AB){2}` 的匹配,必须连续出现两个 `AB` 才能匹配成功,若中间被其他字符隔开(如 `ABaAB`)则无法匹配。
实战验证:通过 `grep` 命令验证了 `oo` 在 `logging` 中的匹配情况,确认了量词仅作用于连续出现的字符。
2. IP 地址的正则表达式深度解析
针对 IP 地址的匹配需求,拆解了正则表达式的构建逻辑,分组与边界控制的重要性:
2.1. 数字区间与分组构建
数字区间精确匹配:利用中括号和花括号构建数字范围,例如 `[1-9][0-9]{0,1}` 用于匹配 0-99 的区间,`1[0-9]{2}` 用于匹配 100-199 的区间。
分组整体匹配:为防止单独匹配个位数或十位数导致误匹配,必须使用小括号将每段数字(如 `([1-9][0-9]{0,1}|1[0-9]{2}|2[0-4][0-9]|25[0-5])`)作为一个整体进行匹配。
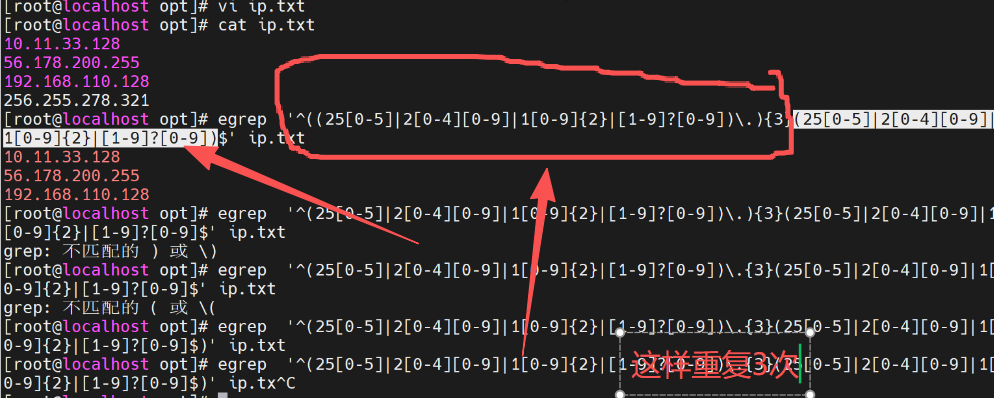
(补充)
括号的常见用法
(): 用于分组表达式[]: 匹配字符集合中的任意单个字符{}: 限定前面模式出现的次数范围
二、grep 高级选项与日志分析
2.1 上下文查看(Context Control)
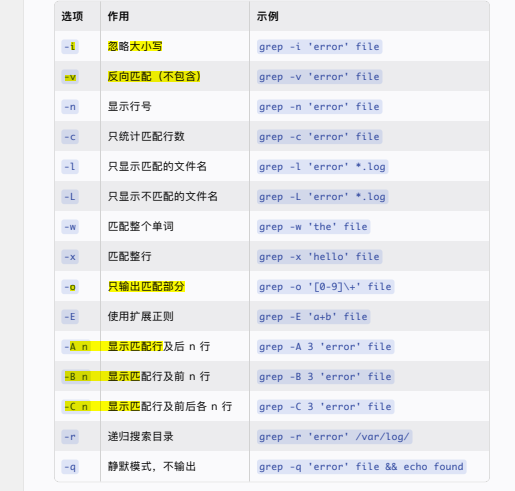
前后行输出:利用 `-A` (After)、`-B` (Before)、`-C` (Context) 选项查看匹配行的前后内容,适用于排查日志报错前后的关联信息。
2.2 精确匹配与特殊符号
单词边界匹配:使用 `\b` 锚定符(如 `\bnet\b`)确保只匹配独立的单词,避免匹配包含该字符串的其他单词(如 network)。 词边界 、\b \b 效果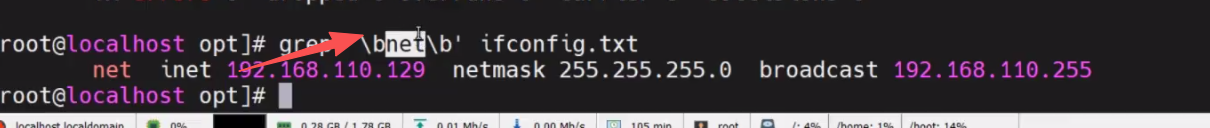
反向匹配:利用 `-v` 选项排除特定内容,例如过滤掉空行或特定 IP 段。
(补充:详情看上一篇文章关于grep用法)
三、sed 流编辑器基础与工作机制
3.1 核心功能定位
非交互式编辑:sed 主要用于脚本中的文本修改,支持增删改查操作,无需进入 vi 等交互式编辑器即可完成文件内容变更。
流处理机制:sed 逐行读取文本到模式空间,执行指定规则后输出结果,属于流式处理工具。
3.2 基础语法与选项
语法结构:基础语法为 `sed [options] 'action' file`,其中 action 包括增 (a/i)、删 (d)、改 (s)、查 (p) 等操作。
原地修改选项:默认 sed 不修改原文件,仅输出到屏幕;使用 `-i` 选项可将修改直接同步到原文件。
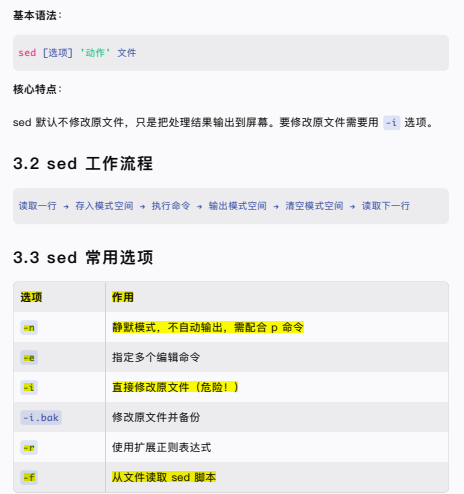
3.3 sed命令结构
sed [选项] '处理动作' 文件
常用选项:
-i: 直接修改源文件-n: 禁止默认输出(常与p动作配合)
处理动作类型:
- 查询:
p打印匹配内容 - 删除:
/pattern/d删除匹配行 - 替换:
s/old/new/[flags]替换文本 - 新增:
Ni text在第N行前插入Na text在第N行后插入/pattern/a text在匹配行后追加/pattern/c text替换整行内容
3.3.1 静默模式(-n)的必要性
解决重复输出问题:Sed 默认会将模式空间的内容输出一遍,若使用 `p` 命令(Print)则会再输出一遍,导致文本内容显示两次。
基础操作:
- 打印全文:
sed -n 'p' sed_test.txt
- 打印特定行:
sed -n '3p' sed_test.txt  # 第3行
sed -n '2,5p' sed_test.txt  # 2-5行
sed -n '2,+1p' sed_test.txt  # 第2行及后1行
sed -n '$p' sed_test.txt  # 最后一行
标准操作规范:在使用 `p` 命令打印文本内容时,必须配合 `-n` 选项(静默模式)来禁止 Sed 的默认输出,从而确保只输出一次预期的内容。
3.3.2 基础打印与行号定位 (查)
全量打印:`sed -n 'p' filename` 用于打印文件所有内容,必须配合 `-n` 避免重复。
单行定位:`sed -n 'Np' filename` 用于打印第 N 行的内容,其中 N 为具体行号。
区间打印:`sed -n 'N,Mp' filename` 用于打印从第 N 行到第 M 行的内容。
1. 特殊符号与范围界定
末尾行表示:使用 `$` 符号代表最后一行,例如 `sed -n 'N,$p'` 表示打印从第 N 行到最后一行的内容。
相对行定位:`sed -n 'N,+Mp'` 表示打印第 N 行及其后面的 M 行内容。
2. 奇偶行筛选逻辑
奇数行筛选:`sed -n '1~2p'` 表示从第 1 行开始,步进为 2(即 1,3,5...),用于打印所有奇数行。
偶数行筛选:`sed -n '2~2p'` 表示从第 2 行开始,步进为 2(即 2,4,6...),用于打印所有偶数行。
奇偶行处理:
sed -n '1~2p' sed_test.txt  # 奇数行
sed -n '2~2p' sed_test.txt  # 偶数行
3.3.3 关键词匹配与删除 (删)
匹配打印:`sed -n '/keyword/p'` 用于打印包含指定关键词(keyword)的所有行。
匹配删除:`sed '/keyword/d'` 用于删除包含指定关键词的所有行。
2. 多条件与正则删除
多条件删除:利用分号 `;` 连接多个条件,例如 `sed '/^#/d; /^$/d'` 可同时删除以 `#` 开头的行和空行。
1. 空格与空白行处理
删除行首空格:使用 `s/^ *//` 或 `s/^[[:space:]]*//` 匹配并删除行首的任意数量空格。
删除行尾空格:使用 `s/ *$//` 删除行尾空格,或使用分号连接多个操作同时删除行首和行尾空格。
压缩连续空格:使用 `s/ */ /g` 将连续的多个空格替换为单个空格。
行号与关键词结合:结合 `grep -n` 获取关键词行号,再利用 Sed 进行行号范围的删除,例如删除从某关键词行开始到末尾的内容。
3.3.4 替换(Substitute)语法详解 (改)
基础替换:`sed 's/old/new/'` 用于将每行中第一个匹配的 `old` 替换为 `new`。
全局替换:添加 `g` 标志位(Global),即 `sed 's/old/new/g'` 表示替换行内所有匹配项。
指定替换次数:使用数字标志位,如 `sed 's/old/new/2'` 表示只替换每行中第二个匹配项。
添加行注释:使用 `s/^/# /` 在行首添加 `#` 符号进行注释,支持指定行号范围(如 `2,5s/^/# /`)。
分组匹配替换:利用括号 `()` 进行分组,配合 `\1`、`\2` 等引用分组内容,实现复杂的匹配与替换逻辑。
补充: 定界符与脚本化实战
定界符替换:当替换内容包含斜杠 `/` 时,可使用其他符号(如 `#`)作为定界符,避免转义混乱,例如 `sed 's#old#new#'`。
脚本化批量修改:演示了通过编写包含 Sed 命令的脚本,实现批量修改网卡配置(如将 `static` 改为 `dhcp`)的自动化流程。
3.3.5 高级插入与多行操作
1. 基于关键词的插入
关键词匹配插入:通过 `/keyword/a\` 或 `/keyword/i\` 在匹配到关键词的行后或行前插入新内容,适用于非连续行的批量操作。
整行替换:使用 `c` 动作(Change)替换整行内容,格式为 `行号c\新内容` 或 `/keyword/c\新内容`。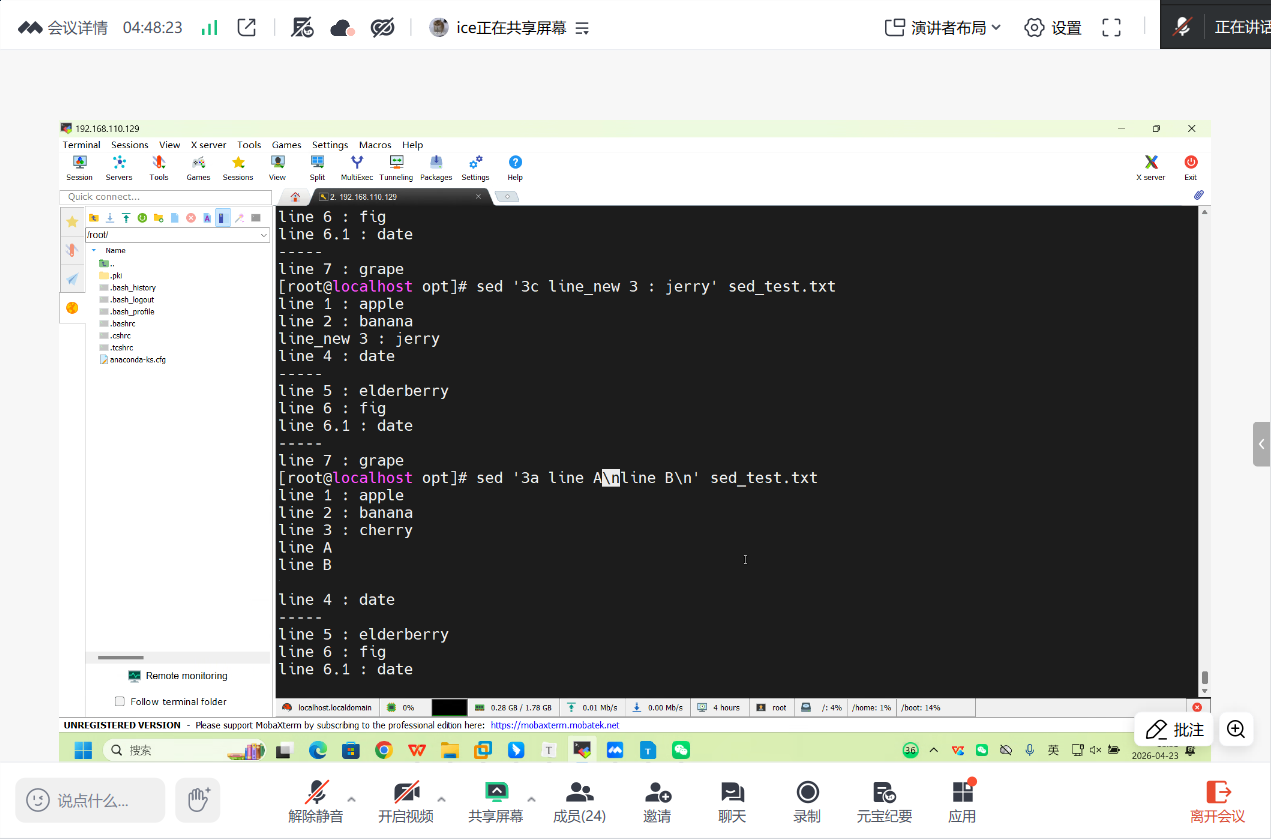
2. 多行内容追加 (增)
换行符使用:在追加多行内容时,使用 `\n` 作为换行符,配合 `a\` 或 `i\` 一次性插入多行文本。
特殊字符转义:当插入内容包含特殊字符时,需使用反斜杠 `\` 进行转义,避免语法错误。
四、awk 文本列处理工具入门
awk基础
文本列处理工具,格式:
awk [选项] 'pattern {action}' 文件
常用参数:
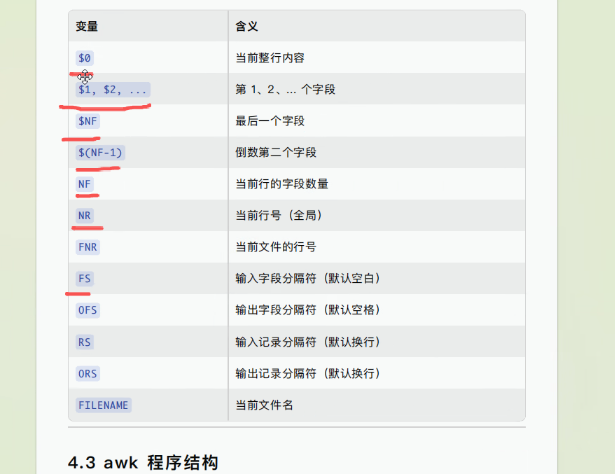
-F: 指定字段分隔符- 内置变量:
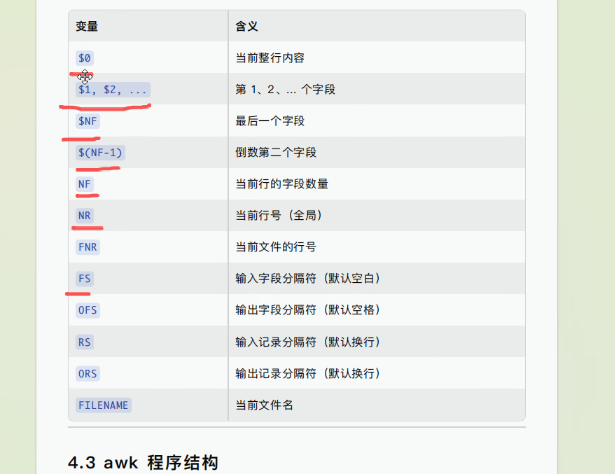
$0: 整行内容$1~$n: 第n列NF: 字段总数$NF: 最后一列
4.1 基础语法与字段概念
awk 作为“三剑客”中最强大的列处理工具
核心概念定义:明确记录(Record)为一行内容,字段(Field)为一列内容,默认分隔符为空格或制表符。
内置变量解析:详细讲解了 `$0`(整行内容)、`$1`(第一列)、`NF`(字段数量)及 `$NF`(最后一列)的含义与用法。
4.2 自定义分隔符与日志分析
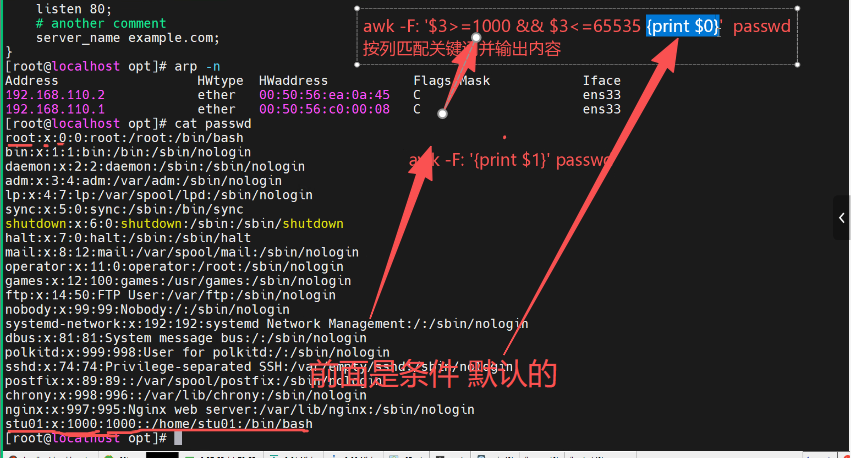
指定分隔符:通过 `-F` 选项指定分隔符(如 `-F:` 或 `-F" "`),以处理非标准格式的文本(如 `/etc/passwd` 文件)。
日志分析实战:演示了从 Nginx 访问日志(access.log)中提取客户端 IP 地址(第一列)并进行去重统计的完整命令链。
4.3 多分隔符与复杂匹配
多分隔符匹配:介绍了使用中括号 `[]` 指定多个分隔符(如 `-F"[\]"`),用于处理包含特殊字符(如方括号)的复杂文本。
字段组合输出:演示了通过 `print $1, $5` 或 `print $1, $NF` 的组合方式,灵活输出特定列的数据。
总结 :
1. 命令格式与核心选项
标准命令结构:Sed 命令由 `sed` + `选项` + `处理动作` + `文本` 三部分组成。
选项功能解析:`-i` 选项用于将处理结果同步至原文件;`-n` 选项用于静默模式,取消 Sed 默认的打印功能,避免重复输出。
2. 增删改查核心动作
查询(p):使用 `p` 动作进行查看,可配合行号或范围(如 `3,5p`)进行精确查询。
删除(d):使用 `d` 动作进行删除,支持基于行号(如 `3d`)、行区间(如 `3,$d`)及关键词匹配(如 `/keyword/d`)三种方式。
替换(s):使用 `s` 动作进行替换,格式为 `s/旧词/新词/`,支持全局替换(`g`)或指定替换第几个匹配项(数字)。
新增(a/i):使用 `a` 在指定行后追加内容,使用 `i` 在指定行前插入内容。
相关指令
() : 分组

[] : 匹配任意一个字符

{} :匹配出现的指定次数/次数区间

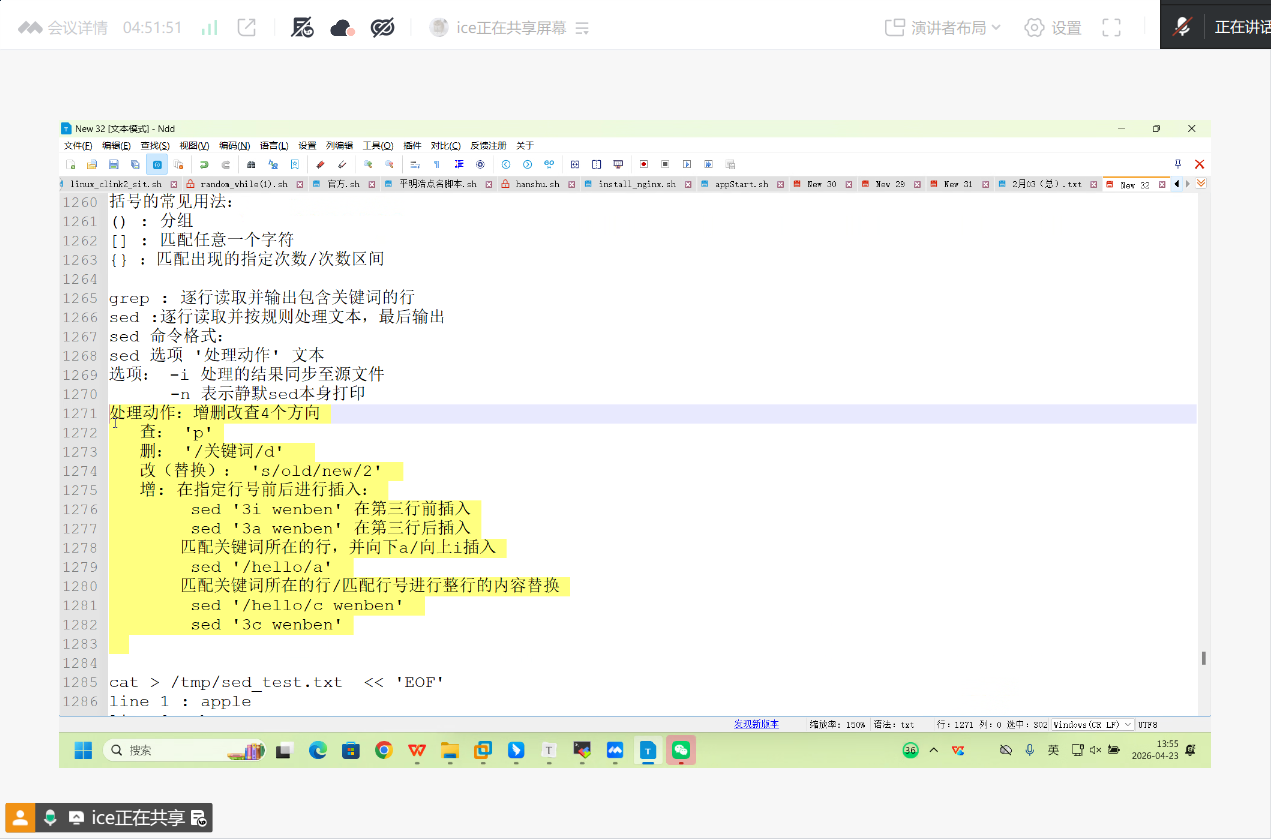
grep : 逐行读取并输出包含关键词的行
sed :逐行读取并按规则处理文本,最后输出
sed 命令格式:
sed 选项 '处理动作' 文本
选项: -i 处理的结果同步至源文件
      -n 表示静默sed本身打印
处理动作:增删改查4个方向
   查: 'p'
   删: '/关键词/d'
   改(替换): 's/old/new/2'
   增: 在指定行号前后进行插入:
        sed '3i wenben' 在第三行前插入
        sed '3a wenben' 在第三行后插入
       匹配关键词所在的行,并向下a/向上i插入
        sed '/hello/a'
       匹配关键词所在的行/匹配行号进行整行的内容替换
        sed '/hello/c wenben'
        sed '3c wenben'


cat > /tmp/sed_test.txt  << 'EOF'
line 1 : apple
line 2 : banana
line 3 : cherry
line 4 : date
line 5 : elderberry
line 6 : fig
line 7 : grape
EOF

① 打印(输出)文本所有内容:
sed -n 'p' sed_test.txt
ps: 一定要加 -n 选项表示静默输出(禁止sed 输出文本,因为 'p'就会输出文本内容,不加-n 会打印2次)

[root@localhost opt]# sed -n 'p' sed_test.txt 案例:
line 1 : apple
line 2 : banana
line 3 : cherry
line 4 : date
line 5 : elderberry
line 6 : fig
line 7 : grape

打印 指定第几行的内容:
sed -n 'np' sed_test.txt ('np'中,n表示第几行,写数字) 案例:
[root@localhost opt]# sed -n '3p' sed_test.txt
line 3 : cherry

打印 指定范围的行
sed -n 'n,mp'  (n m 都代表行号)
sed -n 'n,+n1p'  (n 表示行号,+n1表示第n行及后n1行)
sed -n '$p'  (表示打印最后一行)
sed -n 'n,$p' (表示打印从第n行开始到最后一行)
案例:
[root@localhost opt]# sed -n '2,5p' sed_test.txt
line 2 : banana
line 3 : cherry
line 4 : date
line 5 : elderberry
[root@localhost opt]# sed -n '2,+1p' sed_test.txt
line 2 : banana
line 3 : cherry
[root@localhost opt]# sed -n '$p' sed_test.txt
line 7 : grape
[root@localhost opt]# sed -n '2,$p' sed_test.txt
line 2 : banana
line 3 : cherry
line 4 : date
line 5 : elderberry
line 6 : fig
line 7 : grape

打印奇偶行:
sed -n 'n~2p'
如n是奇数,则先打印第n行,然后打印n+2的行内容--》都是奇数行
如n是偶数,则先打印第n行,然后打印n+2的行内容--》都是偶数行
[root@localhost opt]# sed -n '1~2p' sed_test.txt
line 1 : apple
line 3 : cherry
line 5 : elderberry
line 7 : grape
[root@localhost opt]# sed -n '2~2p' sed_test.txt
line 2 : banana
line 4 : date
line 6 : fig
[root@localhost opt]# sed -n '3~2p' sed_test.txt
line 3 : cherry
line 5 : elderberry
line 7 : grape

匹配关键词所在的行并打印:
sed -n '/关键词/p' sed_test.txt
[root@localhost opt]# sed -n '/date/p' sed_test.txt
line 4 : date
实例演示
1、删除以空格开头空格部分、以#开头、空行
sed -r '/^$|^#/d;s/^ *//' -i ifcfg-ens33
2、把每行第一个no的部分修改为yes(PS 不包括PROXY_METHOD="none") 附加题
sed 's/\bno\b/yes/' ifcfg-ens33
3、把IP地址和网关改为你们自己的IP,把dhcp 改成static
sed 's/dhcp/static/' ifcfg-ens330
sed 's/192.168.110.129/192.168.10.10/' ifcfg-ens33
sed 's/dhcp/static/' ifcfg-ens33
4、把UUID整行替换为UUID=AUTO
[root@localhost opt]# grep -n 'UUID' ifcfg-ens33 |
15:UUID="d974539c-def3-4a28-b0a6-660425b1fa56"
[root@localhost opt]# sed '15c UUID=AUTO' ifcfg-ens3
sed -n '/date/p' sed_test.txt # 含"date"的行
更多推荐

 8
 0
- 0


 已为社区贡献31条内容

所有评论(0)