
大模型显示优化之ZeRO-1/ZeRO-2/ZeRO-3
1. 简介
zero-1、zero-2、zero-3 本质是一种通过通信换显存的方法,通过增加通信代价来让更大的模型能放入显存。是deepspeed的配置方法,对应megatron也有相应的方法,Megatron-LM 的实现方式:Distributed Optimizer(分布式优化器)。等效于 ZeRO-1,Megatron 的 Distributed Optimizer 默认行为就是将优化器状态(Optimizer States)均匀地切分并分布在数据并行(DP)组的所有 GPU 上。等效于 ZeRO-2,由于 Megatron 通常结合混合精度训练,它在计算完梯度后,会通过 Reduce-Scatter 操作直接将梯度同步并切分到各卡上,不再保留全量梯度。这在效果上完全等同于 ZeRO-2。zero-3 将参数也拆分卡来存,但后续实际反向梯度更新时操作时还是需要all-gather,参数显存还是会全量缓存,再一个Megatron针对参数拆分,更多使用的是TP/PP拆分,所以业界megatron架构使用zero-3不多, 所以本文不做重点分析。
Zero架构说的是DP并行域GPU之间。
| 阶段 | 优化对象 | 核心原理 | 效果 | 对应FBW阶段 |
| ZeRO-1 | 优化器状态 (OS) | 将优化器状态切分并分布到各个 GPU 上,每个 GPU 只负责更新自己那一块。 | 显存占用降低约为原来的 1/4(以 Adam 为例)。 | optimizer.step()之后(与F/B/W都不直接相关) |
| ZeRO-2 | OS + 梯度 (G) | 在 ZeRO-1 基础上,进一步将梯度也进行切分。每个 GPU 只保留对应参数的梯度。 | 进一步降低显存占用,是目前最常用的平衡配置。 | W阶段(dW计算完之后可分片保存,不需要全量保存) |
| ZeRO-3 | OS + G + 参数 (W) | 最彻底的切分。模型参数在平时也分布在不同 GPU 上,只有在正向/反向传播需要时才临时同步。 | 显存占用理论上随 GPU 数量线性下降,支持训练超大规模模型。 | F阶段(前向用到W时才allgather,用完就丢掉) |
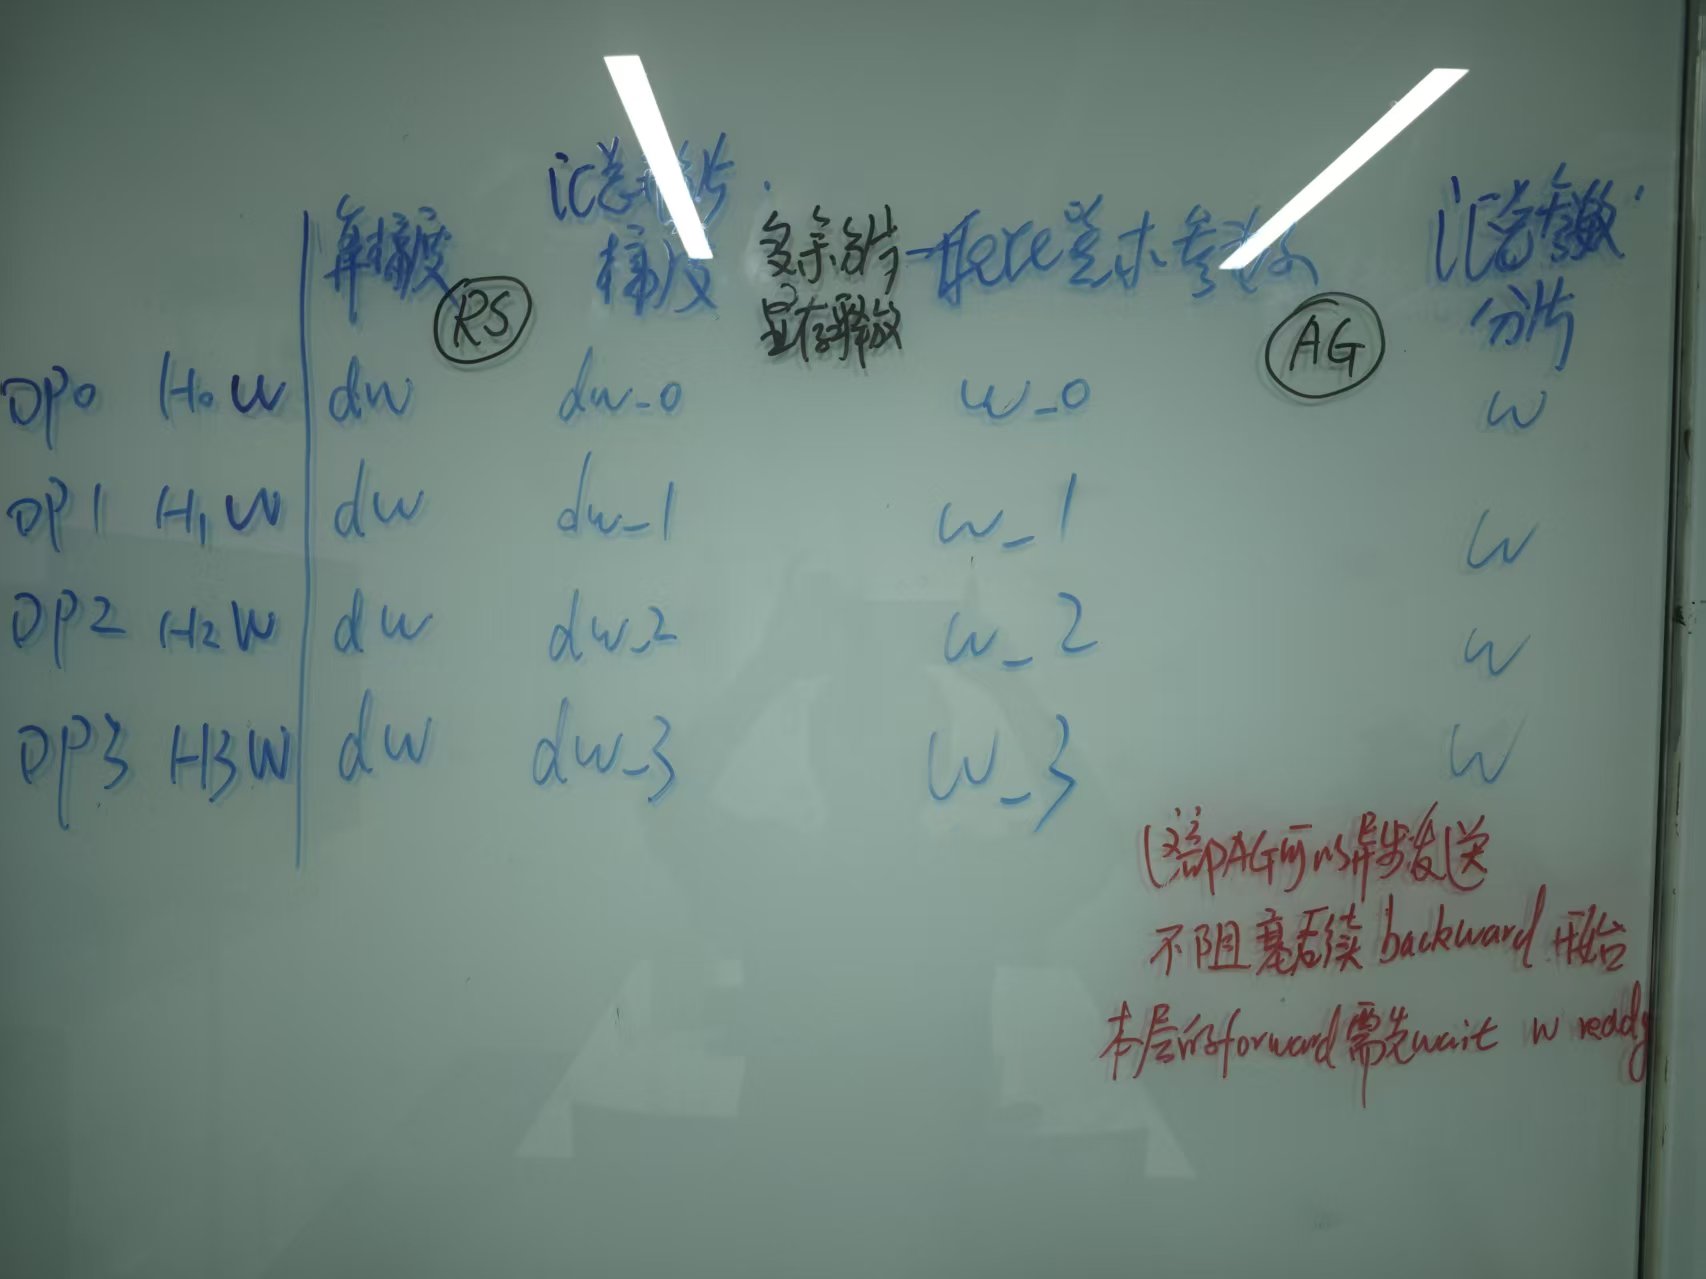
实际官方Megatron实现中,ZeRO-2 反向不只是对梯度进行切分,还对参数在back阶段进行了小段时间的切分,后面AllGather回收,是一个技术操作。这样好处:
1. 节省显存
2. 避免冗余计算
3. 最后的AllGather可以和后续的layer forward 做overlap
| 纯 DP | ZeRO-2 | |
|---|---|---|
| Forward | 各 rank 用完整 W | 各 rank 用完整 W(相同) |
| Backward 后通信 | AllReduce 梯度(每人拿完整梯度) | ReduceScatter 梯度(每人只拿 1/DP 梯度,显存也只存1/DP属于自己的梯度) |
| Optimizer step | 各自完整更新 W(结果一致,冗余计算) | 各自只更新 W 的 1/DP 段(此更新过程比较复杂) |
| Step 后 | 无需额外通信(W 天然一致) | 需要 AllGather W 恢复完整参数 |
| 显存节省 | 无 | 梯度 + 优化器状态各节省 1/DP |
注意:
AdamW全局grad_norm
| 路径 | 通信方式 | 时机 |
|---|---|---|
| 标准路径 | all_reduce on model parallel group(TP × DP) | optimizer.step() 内,clip grad 前 |
| PP bypass 路径 | TP 内 all_reduce + PP 间 send/recv 逐 stage 累加 | pre_step 阶段,流水线化减少同步 barrier |
AdamW 的 step() 中确实有一次全局 grad norm 的 all_reduce 通信,用于计算全局 L2 norm 以确定 clip_coeff(梯度裁剪系数)。这是每一步更新都必须做的集合通信,会引入跨所有 model parallel rank 的同步点。
2. 显存与通信量分析
为了让 ZeRO-1 和 ZeRO-2 的区别更加直观,我把之前流程图里的抽象内容,具体化成了 4 张 GPU 卡在不同阶段的显存状态。
这样你可以像看“快照”一样,清晰地看到每张卡上到底存了什么。
设定:假设模型有
4个参数块:[P0, P1, P2, P3]。4 张 GPU 卡训练。 FP16 训练的模型为例,参数量为:
参数 (Weights):
字节。
梯度 (Grads):
优化器Adam 状态:
FP32 权重副本(为了精度):
。
Momentum(动量):
Variance(方差):
场景一:ZeRO-1 (只切分优化器状态)
核心特征:每张卡都有完整的参数和完整的梯度,但只负责更新1/4的优化器状态。
| GPU 卡 | 前向/反向计算时 | 梯度通信后 (All-Reduce) | 参数更新后 |
|---|---|---|---|
| GPU 0 | 参数: [P0, P1, P2, P3]梯度: [G0, G1, G2, G3]优化器状态: [O0] (只负责P0) | 梯度: [G_avg0, G_avg1, G_avg2, G_avg3](已同步为平均梯度) | *用 G_avg0 更新 O0, 计算出 P0_new然后拼出完整参数 [P0_new, P1_new, P2_new....] |
| GPU 1 | 参数: [P0, P1, P2, P3]梯度: [G0, G1, G2, G3]优化器状态: [O1] (只负责P1) | 梯度: [G_avg0, G_avg1, G_avg2, G_avg3] | *用 G_avg1 更新 O1, 计算出 P1_new然后拼出完整参数 [P0_new, P1_new, P2_new....] |
显存占用:
-
高。因为每张卡都要存下
4份参数 + 4份梯度。 -
冗余度高。
P0被同时存在了 4 张卡上。
场景二:ZeRO-2 (切分梯度 + 优化器状态)
核心特征:每张卡有完整的参数,但只保留1/4的梯度,并只更新对应的1/4优化器状态。
| GPU 卡 | 前向/反向计算时 (初始) | 梯度通信后 (Reduce-Scatter) | 参数更新后 |
|---|---|---|---|
| GPU 0 | 参数: [P0, P1, P2, P3]梯度(原始): [G0, G1, G2, G3]优化器状态: [O0] | 梯度(保留): [G_avg0]梯度(丢弃): [G_avg1, G_avg2, G_avg3] ✔️ 丢弃 | 用 G_avg0 更新 O0, 计算出 P0_new。然后通过 All-Gather 从其他卡获取 P1~P3 的更新。 |
| GPU 1 | 参数: [P0, P1, P2, P3]梯度(原始): [G0, G1, G2, G3]优化器状态: [O1] | 梯度(保留): [G_avg1]梯度(丢弃): [G_avg0, G_avg2, G_avg3] ✔️ 丢弃 | 用 G_avg1 更新 O1, 计算出 P1_new。然后通过 All-Gather 从其他卡获取 P0, P2, P3 的更新。 |
显存占用:
中等。每张卡存
4份参数 + 1份梯度。显存优化:相比 ZeRO-1,节省了 3 份梯度的存储空间。
两张图的对比总结
| 特征 | ZeRO-1 (图里场景) | ZeRO-2 (图里场景) |
|---|---|---|
| 每张卡上的参数 | 全部 [P0, P1, P2, P3] | 全部 [P0, P1, P2, P3] |
| 每张卡上的梯度 | 全部 [G_avg0...G_avg3] (All-Reduce后) | 只有1块 [G_avg0] (Reduce-Scatter后) |
| 优化器状态 | 分片 [O0] | 分片 [O0] |
| 参数更新方式 | 各卡独立计算出完整参数 | 各卡计算部分参数,再互相广播合并 |
| 主要节省 | 不节省梯度 | 节省了3/4的梯度显存 |
通过这两张“快照”,你应该能清晰地看到:ZeRO-2 的本质,就是用梯度通信后的一个“丢弃”动作,换来了大量的显存空间。
通信量总结
| 维度 | ZeRO-1 | ZeRO-2 | ZeRO-3 |
|---|---|---|---|
| 参数存储 | 完整 (每卡都有) | 完整 (每卡都有) | 切分 (每卡1/DP) |
| 梯度存储 | 完整 (每卡都有) | 切分 (每卡1/DP) | 切分 (每卡1/DP) |
| 优化器状态 | 切分 (每卡1/DP) | 切分 (每卡1/DP) | 切分 (每卡1/DP) |
| 单卡模型状态显存 | 2Ψ + 2Ψ + 12Ψ/DP | 2Ψ + 2Ψ/DP + 12Ψ/DP | (2Ψ+2Ψ+12Ψ)/DP |
| 主要通信 | All-Reduce (梯度) | Reduce-Scatter + All-Gather | All-Gather ×2 + Reduce-Scatter |
| 通信量 | 2×Ψ (最小) | 2×Ψ | 3×Ψ (最大) |
| 显存节省 | 仅优化器状态 | 优化器+梯度 | 全部 |
3. Megatron ZeRO配置
| Stage | 分片内容 | Megatron对应参数 |
| ZeRO-1 | 优化器状态分片(m,v) | --user-distributed-optimizer |
| ZeRO-2 | 优化器分片+梯度分片 |
--user-distributed-optimizer+ --overlap-grad-reduce |
| ZeRO-3 | 优化器分片+梯度+参数 | 需要单独搞 |
4. ZeRO2架构 backward过程
计算梯度和更新参数的过程
更多推荐


 7
 0
- 0


 已为社区贡献3条内容

所有评论(0)