
K8S学习之路CKA认证--《etcd 修复》
Context
kubeadm 配置的集群已迁移到新机器。它需要更改配置才能成功运行。
Task
修复在机器迁移过程中损坏的单节点集群。
首先,确定损坏的集群组件,并调查导致其损坏的原因。
注意:已停用的集群使用外部 etcd 服务器。
接下来,修复所有损坏的集群组件的配置。
注意:确保重新启动所有必要的服务和组件,以使更改生效。否则可能导致分数降低。
最后,确保集群运行正常。确保:
每个节点 和 所有 Pod 都处于 Ready 状态。
执行题目里要求的初始化脚本
注意仅模拟环境里需要执行这个脚本。考试时,你 ssh 到这个节点的集群,这个集群本身就是这样异常的
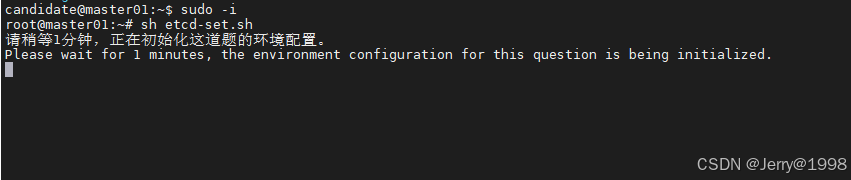
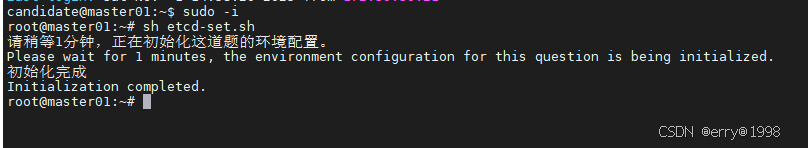

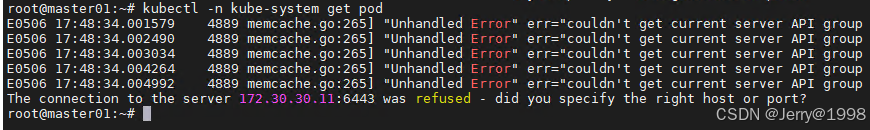
修复 etcd
文档最后有这道题的排错方法
编辑 kube-apiserver 的静态 Pod 清单文件,修正 --etcd-servers 参数。
vim /etc/kubernetes/manifests/kube-apiserver.yaml
找到 --etcd-servers 参数,确保其指向本地 etcd 服务器地址
--etcd-servers=https://127.0.0.1:2379
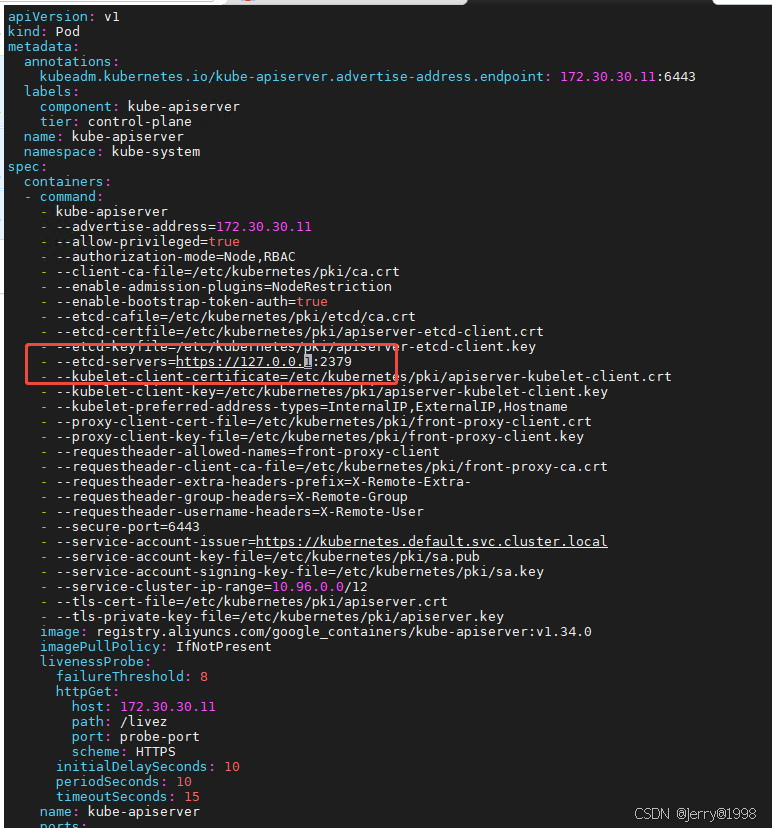
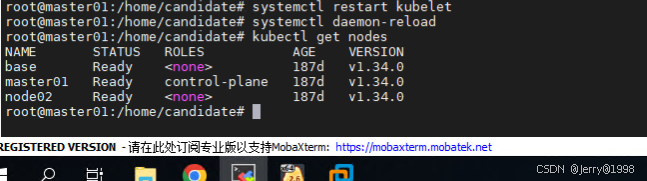
修改完成后,重启一下 kubelet 服务
systemctl daemon-reload
systemctl restart kubelet
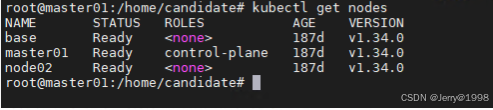
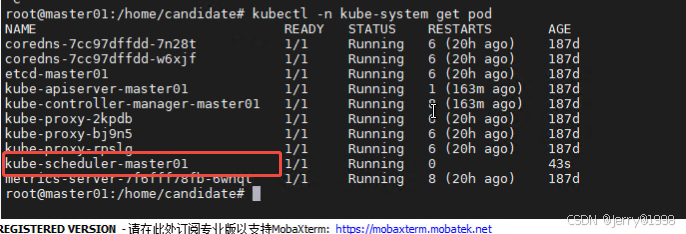
等 1~3 分钟,此时虽然显示 Ready 了,但是 kube-scheduler-master01 还是有异常的,需要继续操作。
kubectl get nodes
kubectl -n kube-system get pod
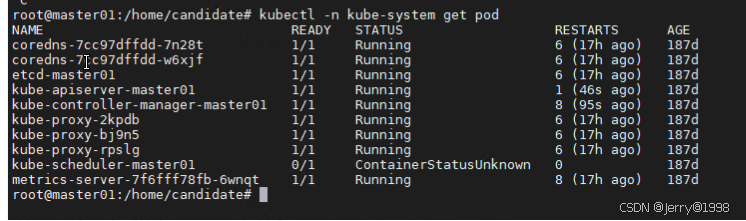
修复 kube-scheduler-master01
通过 lscpu,先检查这个机器系统的 CPU 核数,因为下面编辑 kube-scheduler.yaml 文件时,里面会提示你设置为系统的 10%。
lscpu |grep CPU
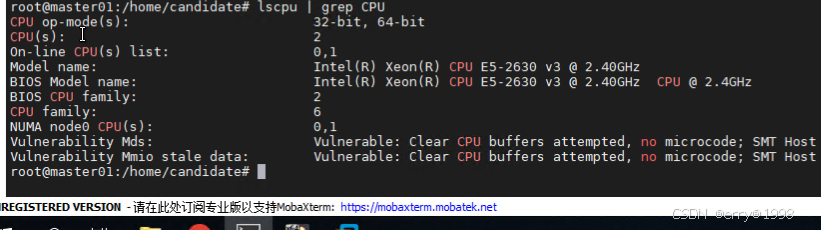
显示这个机器是 2 个 CPU,1CPU=1000m,所以 2CPU 就是 2000m,然后 10%就是 200m
另外,真正考试时,那台机器的 CPU 也是 2 个。
(因为不是说 K8S Node 可用的 10%,而是说 SYSTEM,所以指虚拟机 CPU 核心的 10%,出题者的本意是这个,不要想复杂了。
修复 scheduler 文件
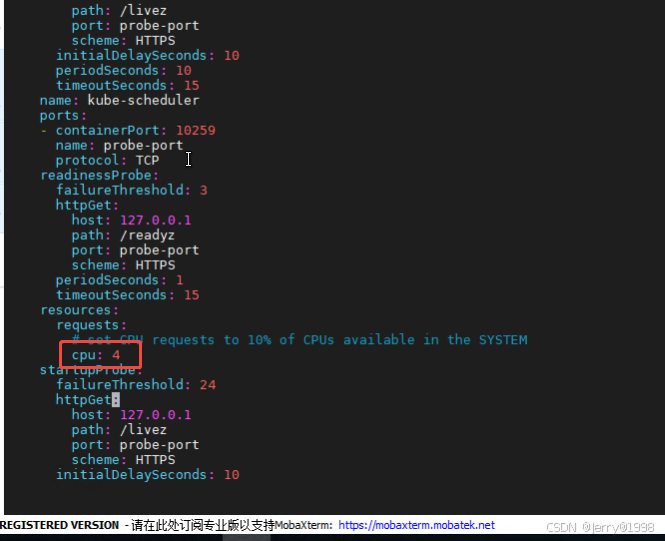
vim /etc/kubernetes/manifests/kube-scheduler.yaml
将改 requests cpu 成 200m
cpu: 200m
验证集群状态
修改完成后,可以重启一下 kubelet 服务
systemctl daemon-reload
systemctl restart kubelet
等 1~3 分钟,检查状态
kubectl get nodes
kubectl -n kube-system get pod
更多推荐

 7
 0
- 0


 已为社区贡献3条内容

所有评论(0)