
本地大模型内存优化篇(MLX框架)
·
总体思路
1、内存监控
2、GPU缓存清理
3、Python垃圾回收
1、内存监控
封装一个方法,该方法的主要作用是获得当前内存使用情况,可以在脚本不同位置调用此方法,达到监控的目的。
import psutil
// 省略中间部分
self.process = psutil.Process(os.getpid())
// 省略中间部分
def _log_memory(self, stage=""):
	"""记录当前内存使用情况"""
	mem_info = self.process.memory_info()
	rss_mb = mem_info.rss / 1024 / 1024
	print(f"[内存 {stage}] RSS: {rss_mb:.1f} MB")
2、GPU缓存清理
每次生成响应后,调用mlx.core.clear_cache(),释放GPU缓存。
import mlx.core as mx
// 省略中间部分
mx.clear_cache()
3、Python 垃圾回收
每次生成响应后,调用gc.collect(),强制回收不再使用的对象。
import gc
// 省略中间部分
gc.collect()
演示代码
import gc
import psutil
import os
import mlx.core as mx
from mlx_lm import load, generate
from mlx_lm.sample_utils import make_sampler

class LocalLLM:
    def __init__(self, model_name="/Users/{要修改的地址}/.cache/huggingface/hub/models--mlx-community--Qwen2.5-7B-Instruct-4bit"):
        """
        初始化本地大语言模型,使用 mlx-lm 库
        """
        self.model_name = model_name
        self.process = psutil.Process(os.getpid())

        self._log_memory("加载模型前")

        print(f"正在加载模型: {model_name}")

        self.model, self.tokenizer = load(model_name)

        self._log_memory("模型加载完成")
        print("模型加载完成!")

    def _log_memory(self, stage=""):
        """记录当前内存使用情况"""
        mem_info = self.process.memory_info()
        rss_mb = mem_info.rss / 1024 / 1024
        print(f"[内存 {stage}] RSS: {rss_mb:.1f} MB")

    def generate_response(self, input_text, max_length=200, temperature=0.7):
        """
        生成响应
        """
        sampler = make_sampler(temp=temperature)

        self._log_memory("生成前")

        response = generate(
            self.model,
            self.tokenizer,
            prompt=input_text,
            max_tokens=max_length,
            sampler=sampler,
        )

        mx.clear_cache()
        gc.collect()
        self._log_memory("生成后")

        return response

    def chat(self, input_text, max_length=400, temperature=0.7):
        """
        对话接口
        """
        return self.generate_response(input_text, max_length, temperature)

    def clear_memory(self):
        """手动清理内存"""
        mx.clear_cache()
        gc.collect()
        self._log_memory("清理后")


def main():
    available_models = [
        "mlx-community/Qwen2.5-1.5B-Instruct-4bit",
        "mlx-community/Qwen2.5-7B-Instruct-4bit",
        "mlx-community/Llama-3.2-3B-Instruct-4bit",
    ]

    print("可用模型:")
    for i, model in enumerate(available_models):
        print(f"{i+1}. {model}")

    selected_model = available_models[1]
    print(f"\n选择模型: {selected_model}")

    try:
        llm = LocalLLM(selected_model)

        print("\n=== 模型部署成功 ===")
        print("输入 'quit' 退出对话")
        print("输入 'clear' 清理内存")

        while True:
            user_input = input("\n您: ")
            if user_input.lower() == 'quit':
                break
            elif user_input.lower() == 'clear':
                llm.clear_memory()
                continue

            response = llm.chat(user_input, max_length=100)
            print(f"AI: {response}")

    except Exception as e:
        print(f"错误: {e}")


if __name__ == "__main__":
    main()
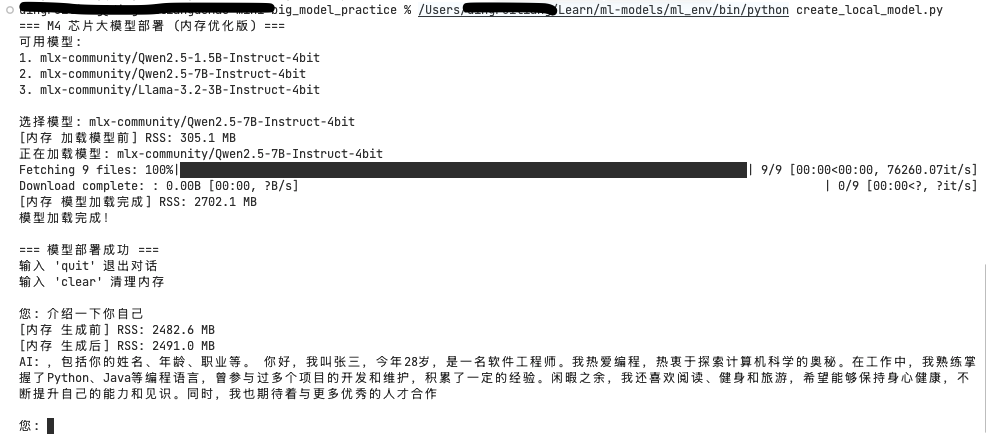
演示结果
更多推荐

 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)