
本地大模型接口篇(MLX框架)
·
开头
本篇主要是介绍通过接口的方式,接收问题以及相关参数,调用本地大模型的方法。
环境
1、flask框架
代码
import json
import gc
import psutil
import os
import mlx.core as mx
from mlx_lm import load, generate
from mlx_lm.sample_utils import make_sampler
from flask import Flask, request, Response

app = Flask(__name__)

def json_response(data, status=200):
    return Response(
        json.dumps(data, ensure_ascii=False),
        status=status,
        mimetype='application/json; charset=utf-8'
    )

@app.after_request
def after_request(response):
    response.headers['Content-Type'] = 'application/json; charset=utf-8'
    return response

class LocalLLM:
    def __init__(self, model_name="/Users/{需要更改的内容}/.cache/huggingface/hub/models--mlx-community--Qwen2.5-7B-Instruct-4bit"):
        """
        初始化本地大语言模型,使用 mlx-lm 库
        """
        self.model_name = model_name
        self.process = psutil.Process(os.getpid())

        self._log_memory("加载模型前")

        print(f"正在加载模型: {model_name}")

        self.model, self.tokenizer = load(model_name)

        self._log_memory("模型加载完成")
        print("模型加载完成!")

    def _log_memory(self, stage=""):
        """记录当前内存使用情况"""
        mem_info = self.process.memory_info()
        rss_mb = mem_info.rss / 1024 / 1024
        print(f"[内存 {stage}] RSS: {rss_mb:.1f} MB")

    def generate_response(self, input_text, max_length=400, temperature=0.7):
        """
        生成响应
        """
        sampler = make_sampler(temp=temperature)

        response = generate(
            self.model,
            self.tokenizer,
            prompt=input_text,
            max_tokens=max_length,
            sampler=sampler,
        )

        mx.clear_cache()
        gc.collect()

        return response

    def chat(self, input_text, max_length=400, temperature=0.7):
        """
        对话接口
        """
        return self.generate_response(input_text, max_length, temperature)

    def clear_memory(self):
        """手动清理内存"""
        mx.clear_cache()
        gc.collect()
        self._log_memory("清理后")

# 全局模型实例
llm = None

@app.route('/chat', methods=['GET'])
def chat():
    """
    GET 请求接口:/chat?prompt=你的问题
    参数:
    - prompt: 输入的文本
    - max_length: 最大生成长度(可选,默认200)
    - temperature: 温度参数(可选,默认0.7)
    """
    global llm

    prompt = request.args.get('prompt', '')
    max_length = int(request.args.get('max_length', 400))
    temperature = float(request.args.get('temperature', 0.7))

    if not prompt:
        return json_response({'error': '缺少 prompt 参数'}, 400)

    try:
        response = llm.chat(prompt, max_length=max_length, temperature=temperature)
        return json_response({
            'prompt': prompt,
            'response': response,
            'max_length': max_length,
            'temperature': temperature
        })
    except Exception as e:
        return json_response({'error': str(e)}, 500)

@app.route('/status', methods=['GET'])
def status():
    """
    获取服务状态
    """
    global llm

    if llm:
        mem_info = llm.process.memory_info()
        rss_mb = mem_info.rss / 1024 / 1024
        return json_response({
            'status': 'running',
            'model': llm.model_name,
            'memory_usage_mb': round(rss_mb, 1)
        })
    else:
        return json_response({'status': 'not_ready', 'model': None}, 503)

@app.route('/clear', methods=['POST'])
def clear():
    """
    清理内存
    """
    global llm

    if llm:
        llm.clear_memory()
        return json_response({'status': 'success', 'message': '内存已清理'})
    else:
        return json_response({'error': '模型未加载'}, 503)

if __name__ == '__main__':

    available_models = [
        "mlx-community/Qwen2.5-1.5B-Instruct-4bit",
        "mlx-community/Qwen2.5-7B-Instruct-4bit",
        "mlx-community/Llama-3.2-3B-Instruct-4bit",
    ]

    print("可用模型:")
    for i, model in enumerate(available_models):
        print(f"{i+1}. {model}")

    # 使用最小的模型进行测试
    selected_model = available_models[1]
    print(f"\n选择模型: {selected_model}")

    try:
        llm = LocalLLM(selected_model)

        print("\n=== Flask 服务启动 ===")
        print("访问地址: http://localhost:5001")
        print("API 接口:")
        print("  GET  /chat?prompt=你的问题")
        print("  GET  /status")
        print("  POST /clear")

        app.run(host='0.0.0.0', port=5001, debug=False)

    except Exception as e:
        print(f"错误: {e}")
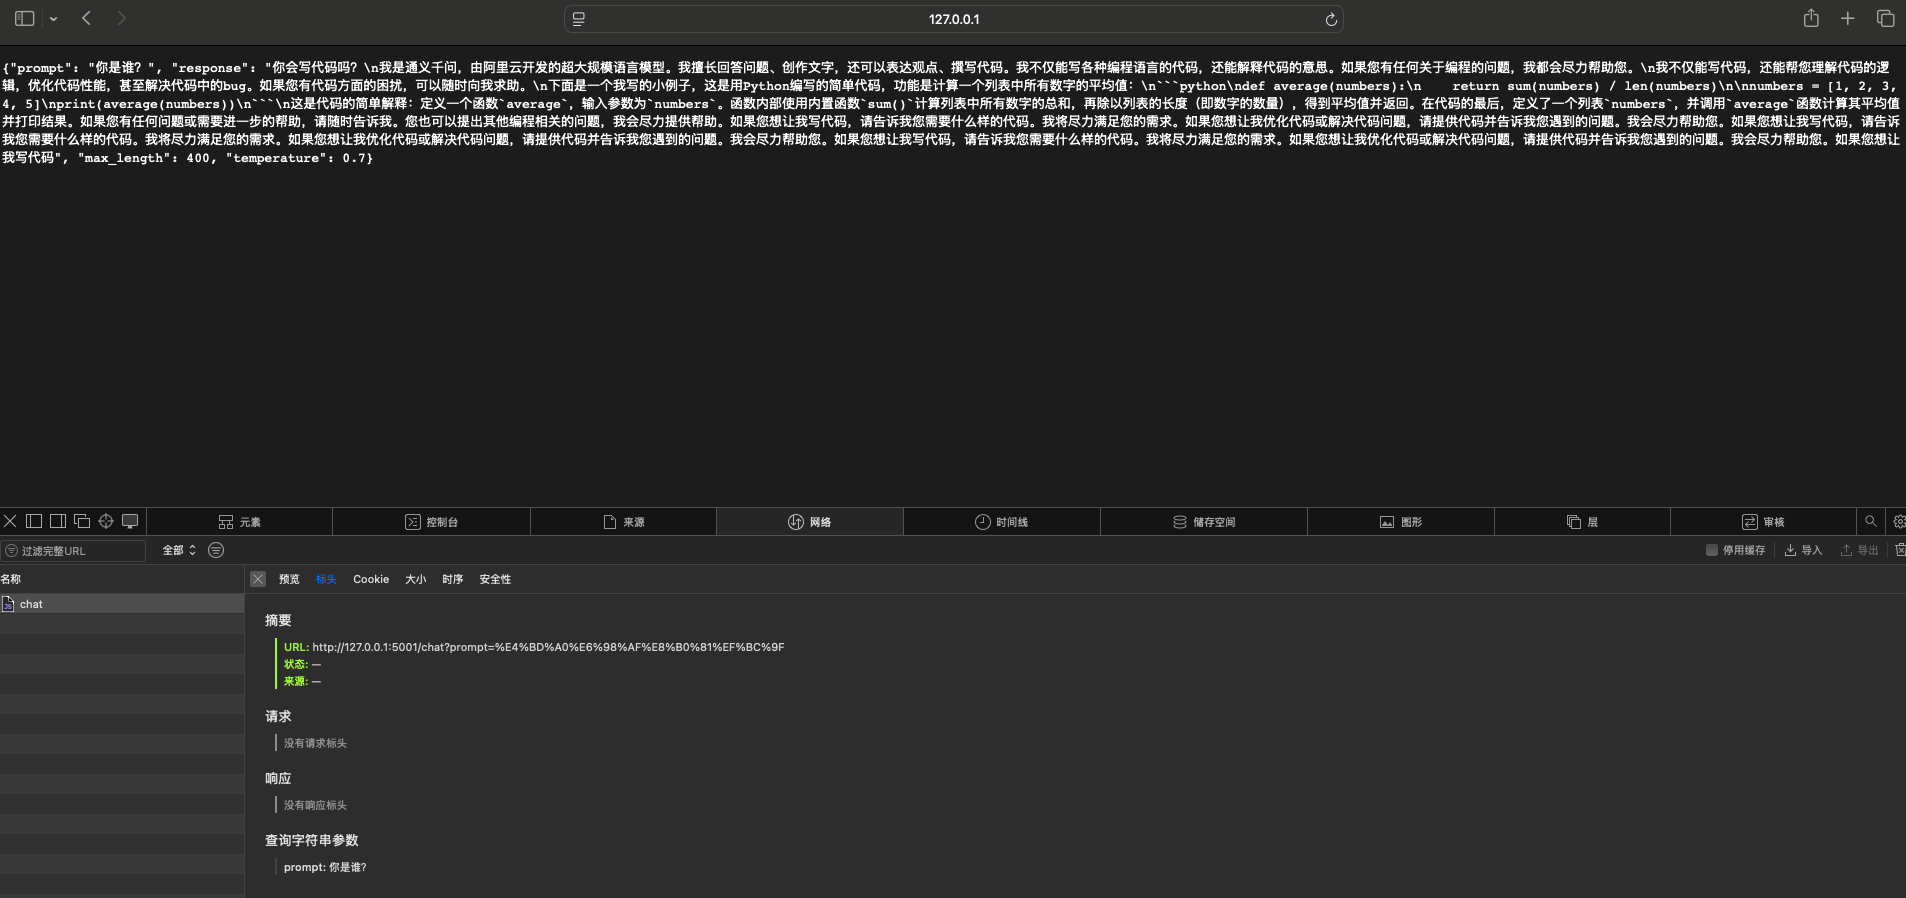
效果
更多推荐

 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)