
Kubernetes 集群中 Prometheus 监控体系部署与使用全指南
在 Kubernetes(K8s)集群运维中,监控是保障集群稳定运行的核心环节,而 Prometheus 作为开源监控领域的标杆工具,凭借其强大的数据采集、存储与查询能力,成为 K8s 集群监控的首选方案。本文基于 Kubernetes v1.26.5 集群环境,从 Prometheus 手动部署入手,逐步讲解如何通过 Exporter、kube-state-metrics、cAdvisor 等工具实现集群节点、容器、应用及 K8s 核心组件的全面监控,同时结合 Grafana 实现监控可视化、Pushgateway 处理临时任务指标、Alertmanager 配置告警通知,形成一套完整的 K8s 集群监控闭环,适合具备 K8s 基础操作能力的运维人员学习实践。
1、在 Kubernetes 上部署 Prometheus
Prometheus 的基本使用方式,主要是使用的二进制方式进行部署的,但在实际生产环境来说,要实现对k8的监控,Prometheus 更适合部署在 Kubernetes 集群中。本节我将介绍如何用手动方式在 Kubernetes 集群上部署 Prometheus,学习本节课程,需要你熟悉Kubernetes 集群的各种操作。
由于我这里是要在 Kubernetes 集群中部署Prometheus,所以需要提前部署好一套k8s集群环境,我这里用的实验环境是基于 Kubernetes v1.26.5 版本,一共 3 个节点:
[root@k8smaster ~]# kubectl  get nodes
NAME        STATUS   ROLES           AGE   VERSION
k8smaster   Ready    control-plane   20d   v1.26.5
k8swork1    Ready    <none>          20d   v1.26.5
k8swork2    Ready    <none>          20d   v1.26.5
(1)、创建Prometheus基础配置文件
为了方便管理,我将监控相关的所有资源对象都安装在 kube-pm 这个 namespace 下面,创建命令如下:
[root@k8smaster ~]# kubectl create ns kube-pm接着,首先创建一个Prometheus基础配置文件prometheus.yml,配置文件用 ConfigMap 的形式进行管理,编写好的prometheus-cm.yml文件内容如下:
apiVersion: v1
kind: ConfigMap
metadata:
  name: prometheus-config
  namespace: kube-pm
data:
  prometheus.yml: |
    global:
      scrape_interval: 15s
      scrape_timeout: 15s
    scrape_configs:
    - job_name: 'prometheus'
      static_configs:
      - targets: ['localhost:9090']
这里暂时只配置了对 prometheus 本身的监控,直接创建该资源对象:
[root@k8smaster ~]# kubectl apply -f prometheus-cm.yml
configmap "prometheus-config" created
配置文件创建完成了,以后如果有新的资源需要被监控,只需要将上面的 ConfigMap 对象更新即可。
(2)、使用本次磁盘持久化prometheus数据
为了 prometheus 的性能和数据持久化,我这里是直接将通过一个 LocalPV 来进行数据持久化的,注意一定不能使用 nfs 来持久化数据,通过 --storage.tsdb.path=/prometheus 指定数据目录,创建如下所示的一个 PVC 资源对象,注意这是一个 LocalPV,和 k8swork2节点具有亲和性,local-pv.yml内容如下:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: local-storage
provisioner: kubernetes.io/no-provisioner
volumeBindingMode: WaitForFirstConsumer
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: prometheus-local
  labels:
    app: prometheus
spec:
  accessModes:
    - ReadWriteOnce
  capacity:
    storage: 20Gi
  storageClassName: local-storage
  local:
    path: /data/k8s/prometheus
  persistentVolumeReclaimPolicy: Retain
  nodeAffinity:
    required:
      nodeSelectorTerms:
        - matchExpressions:
            - key: kubernetes.io/hostname
              operator: In
              values:
                - k8swork2
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: prometheus-data
  namespace: kube-pm
spec:
  selector:
    matchLabels:
      app: prometheus
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 20Gi
  storageClassName: local-storage
(3)、创建 prometheus 的 Pod 资源
接着,来创建 prometheus 的 Pod 资源,编写好的prometheus-deploy.yml文件内容如下:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: prometheus
  namespace: kube-pm
  labels:
    app: prometheus
spec:
  selector:
    matchLabels:
      app: prometheus
  template:
    metadata:
      labels:
        app: prometheus
    spec:
      serviceAccountName: prometheus
      volumes:
        - name: data
          persistentVolumeClaim:
            claimName: prometheus-data
        - name: config-volume
          configMap:
            name: prometheus-config
      initContainers:
        - name: fix-permissions
          image: busybox
          command: [chown, -R, "nobody:nobody", /prometheus]
          volumeMounts:
            - name: data
              mountPath: /prometheus
      containers:
        - image: prom/prometheus:v2.37.8
          name: prometheus
          args:
            - "--config.file=/etc/prometheus/prometheus.yml"
            - "--storage.tsdb.path=/prometheus"
            - "--storage.tsdb.retention.time=24h"
            - "--web.enable-admin-api"
            - "--web.enable-lifecycle"
          ports:
            - containerPort: 9090
              name: http
          volumeMounts:
            - mountPath: "/etc/prometheus"
              name: config-volume
            - mountPath: "/prometheus"
              name: data
          resources:
            requests:
              cpu: 200m
              memory: 1024Mi
            limits:
              cpu: 200m
              memory: 1024Mi
(4)、配置 rbac 相关认证
由于 prometheus 可以访问 Kubernetes 的一些资源对象,所以需要配置 rbac 相关认证,这里我使用了一个名为 prometheus 的 serviceAccount 对象,rbac.yaml文件内容如下:
apiVersion: v1
kind: ServiceAccount
metadata:
  name: prometheus
  namespace: kube-pm
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: prometheus
rules:
  - apiGroups:
      - ""
    resources:
      - nodes
      - services
      - endpoints
      - pods
      - nodes/proxy
    verbs:
      - get
      - list
      - watch
  - apiGroups:
      - "extensions"
    resources:
      - ingresses
    verbs:
      - get
      - list
      - watch
  - apiGroups:
      - ""
    resources:
      - configmaps
      - nodes/metrics
    verbs:
      - get
  - nonResourceURLs:
      - /metrics
    verbs:
      - get
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  name: prometheus
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: ClusterRole
  name: prometheus
subjects:
  - kind: ServiceAccount
    name: prometheus
    namespace: kube-pm
(5)、开始部署
执行如下命令,进行授权、pvc创建以及pod部署:
[root@k8smaster k8syml]# kubectl apply -f  rbac.yaml
[root@k8smaster k8syml]# kubectl apply -f  local-pv.yml
[root@k8smaster k8syml]# kubectl apply -f  prometheus-deploy.yml
(6)、给prometheus创建 Service 对象
为了方便测试,我们这里创建一个 NodePort 类型的服务,prometheus-svc.yaml文件内容如下:
apiVersion: v1
kind: Service
metadata:
  name: prometheus
  namespace: kube-pm
  labels:
    app: prometheus
spec:
  selector:
    app: prometheus
  type: NodePort
  ports:
    - name: web
      port: 9090
      targetPort: http
接着,部署此服务:
[root@k8smaster k8syml]# kubectl apply -f prometheus-svc.yaml
[root@k8smaster k8syml]# kubectl get svc -n kube-pm
NAME         TYPE        CLUSTER-IP       EXTERNAL-IP   PORT(S)             AGE
prometheus   NodePort    10.100.215.50    <none>        9090:32388/TCP      27h
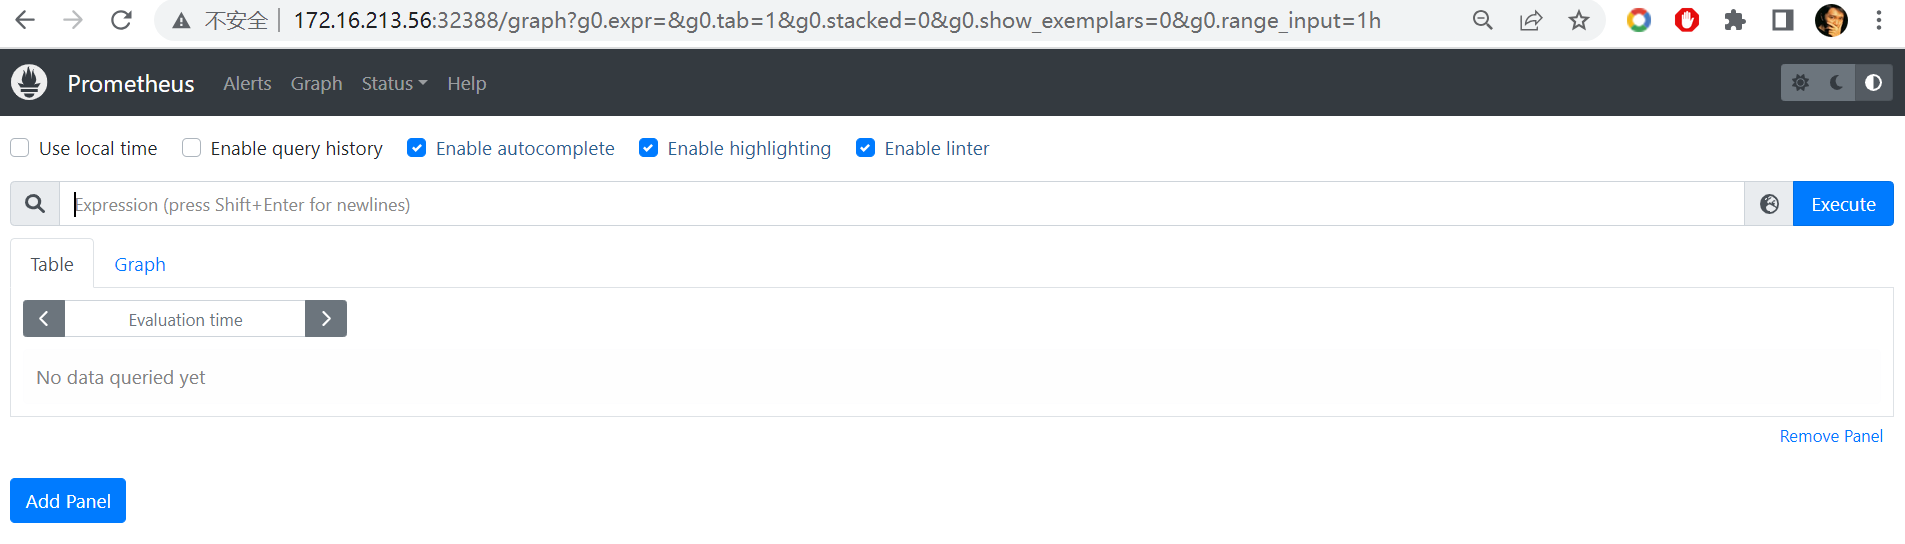
现在就可以通过 http://任意节点IP:32388 访问 prometheus 的 webui 服务了。
2、在Kubernetes上用Prometheus的exporter实现应用监控
Prometheus 的数据指标是通过一个公开的 HTTP(S) 数据接口获取到的,对于一些普通的 HTTP 服务,我们添加一个 /metrics 接口暴露给 Prometheus即可,现在很多服务从一开始就内置了一个 /metrics 接口,比如 Kubernetes 的各个组件都直接提供了数据指标接口,有一些服务即使没有原生集成该接口,也完全可以使用一些 exporter 来获取到指标数据,比如 mysqld_exporter、node_exporter等。
(1)、添加CoreDNS 插件的监控
Kubernetes 集群中非常重要的 CoreDNS 插件,默认情况下就开启了 /metrics 接口:
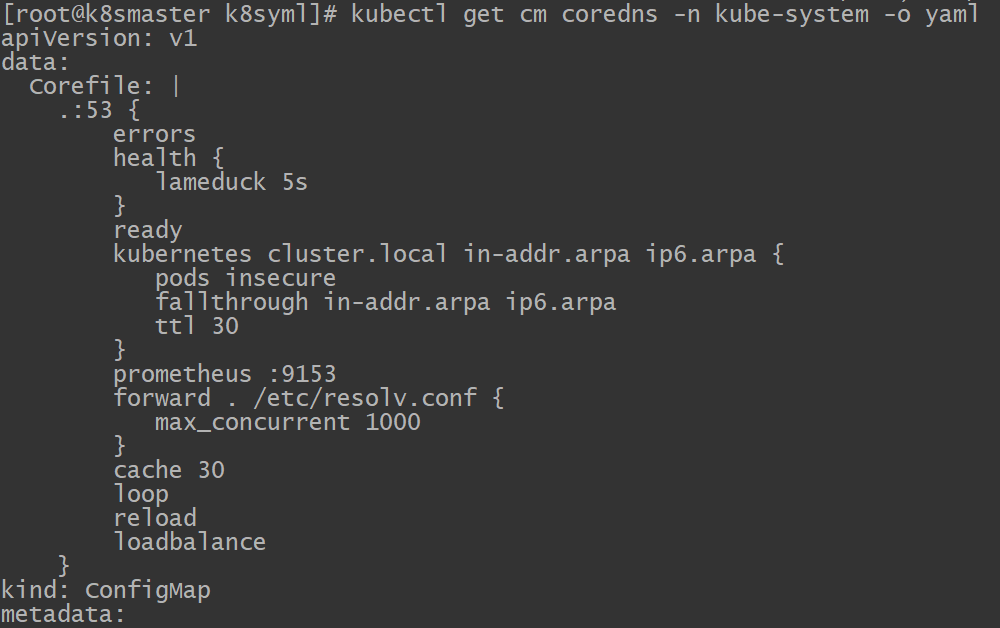
上面 ConfigMap 中 prometheus :9153 就是开启 prometheus 的插件:
[root@k8smaster k8syml]# kubectl get pods -n kube-system -l k8s-app=kube-dns -o wide
NAME                       READY   STATUS    RESTARTS       AGE   IP             NODE        NOMINATED NODE   READINESS GATES
coredns-5bbd96d687-5crkm   1/1     Running   4 (140m ago)   19d   10.244.66.11   k8smaster   <none>           <none>
coredns-5bbd96d687-w6frw   1/1     Running   4 (140m ago)   19d   10.244.66.12   k8smaster   <none>           <none>
可以先尝试手动访问下 /metrics 接口,如果能够手动访问到,那证明接口是没问题的:
[root@k8smaster k8syml]# curl http://10.244.66.11:9153/metrics现在,我们就可以将这个 /metrics 接口配置到 prometheus.yml 中去了,这里我在prometheus.yml中新增了一个名为coredns的 job ,修改上面的prometheus-cm.yml文件,增加最后这部分内容:
apiVersion: v1
kind: ConfigMap
metadata:
  name: prometheus-config
  namespace: kube-pm
data:
  prometheus.yml: |
    global:
      scrape_interval: 15s
      scrape_timeout: 15s
    scrape_configs:
    - job_name: 'prometheus'
      static_configs:
      - targets: ['localhost:9090']
    - job_name: 'coredns'
      static_configs:
- targets: ['10.244.66.11:9153', '10.244.66.12:9153']这里仍然是一个静态配置,但scrape_configs下面可以支持很多参数,例如:
basic_auth和bearer_token:比如我们提供的/metrics接口需要 basic 认证的时候,通过传统的用户名/密码或者在请求的 header 中添加对应的 token 都可以支持kubernetes_sd_configs或consul_sd_configs:可以用来自动发现一些应用的监控数据
修改完成prometheus-cm.yml文件后,重新更新这个 ConfigMap 资源对象:
[root@k8smaster k8syml]# kubectl apply -f prometheus-cm.yml配置文件内容变更后,稍等一会,被挂载到 Pod 中的 prometheus.yml 文件也会更新。
配置文件虽然更新了,但是要让新增配置生效,还需要重载prometheus服务,之前我在Prometheus 启动参数中,添加了 --web.enable-lifecycle 参数,所以现在我们只需要执行一个 reload 命令即可让配置生效:
[root@k8smaster k8syml]# kubectl get pods -n kube-pm -o wide
NAME READY   STATUS    RESTARTS       AGE   IP    NODE  NOMINATED NODE   READINESS GATES
prometheus-786b5dd895-jd6w6 1/1   Running   1 (156m ago)   28h   10.244.43.82    k8swork2    <none>           <none>
[root@k8smaster k8syml]# curl -X POST "http://10.244.43.82:9090/-/reload"
由于 ConfigMap 通过 Volume 的形式挂载到 Pod 中,所以,需要一定的间隔时间才会生效,因此,热更新执行后不一定能马上生效,要等 Pod 中的 prometheus.yml 文件更新后,执行热更新才能生效。
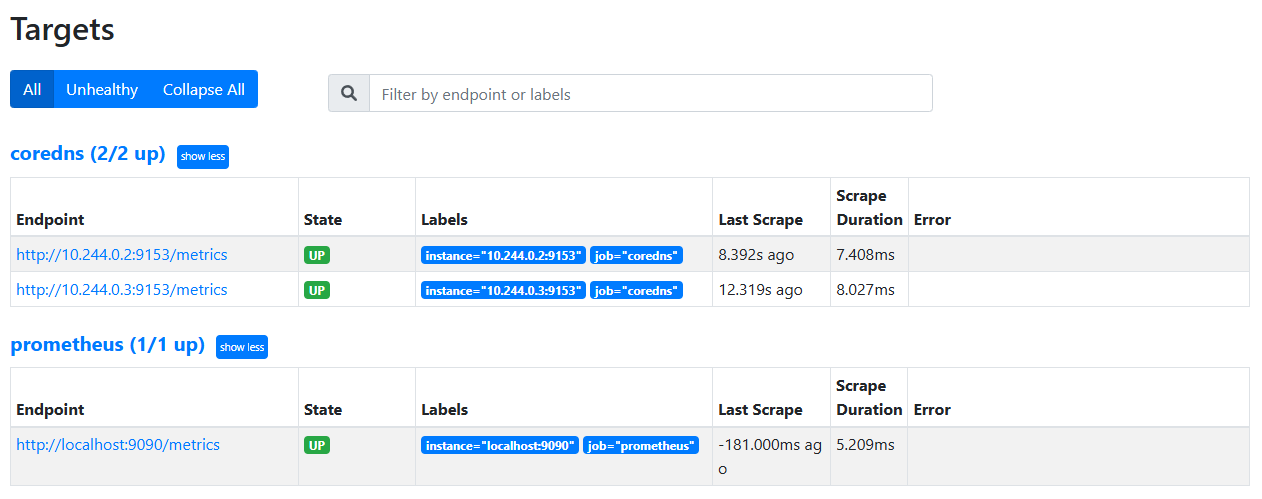
这个时候我们再去看 Prometheus 的 Dashboard 中查看采集的目标数据:
(2)、部署exporter来监控应用系统
这里通过redis-exporter的服务来监控 redis,对于这类应用,我们一般会将主应用部署在同一个 Pod 中,比如我这里部署一个 redis 应用,并用 redis-exporter 的方式来采集监控数据供 Prometheus 使用,资源清单文件redis-exporter.yml内容如下:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: redis
  namespace: kube-pm
spec:
  selector:
    matchLabels:
      app: redis
  template:
    metadata:
      labels:
        app: redis
    spec:
      containers:
        - name: redis
          image: redis:6
          resources:
            requests:
              cpu: 100m
              memory: 100Mi
          ports:
            - containerPort: 6379
        - name: redis-exporter
          image: oliver006/redis_exporter:latest
          resources:
            requests:
              cpu: 100m
              memory: 100Mi
          ports:
            - containerPort: 9121
---
kind: Service
apiVersion: v1
metadata:
  name: redis
  namespace: kube-pm
spec:
  selector:
    app: redis
  ports:
    - name: redis
      port: 6379
      targetPort: 6379
    - name: prom
      port: 9121
      targetPort: 9121
上面我们在 redis 这个 Pod 中包含了两个容器,一个就是 redis 本身的主应用,另外一个容器就是 redis_exporter。
要创建上面的应用,执行如下部署:
[root@k8smaster k8syml]# kubectl apply -f redis-exporter.yml创建完成后,我们可以看到 redis 的 Pod 里面包含有两个容器:
[root@k8smaster k8syml]#  kubectl get pods -n kube-pm
NAME                          READY   STATUS    RESTARTS        AGE
redis-58964f546b-4vbgl        2/2     Running   2 (3h10m ago)   27h
[root@k8smaster k8syml]# kubectl get svc -n kube-pm
redis        ClusterIP   10.110.126.101   <none>        6379/TCP,9121/TCP   27h
我们可以通过 9121 端口来校验是否能够采集到数据:
[root@k8smaster k8syml]# curl 10.110.126.101:9121/metrics接着,只需要更新 Prometheus.yml 配置文件即可,在prometheus-cm.yml文件中新增如下内容:
- job_name: "redis"
      static_configs:
        - targets: ["redis:9121"]
这里我是通过 Service 去配置的 redis 服务,当然直接配置 Pod IP 也是可以的,但Pod IP是会变化的,所以配置 service name最好, 因为service name和 Prometheus处于同一个 namespace,所以可以直接使用 service name 即可。
最后,重新加载prometheus-cm.yml文件,执行如下:
[root@k8smaster k8syml]# kubectl apply -f  prometheus-cm.yml
[root@k8smaster k8syml]# curl -X POST "http://10.244.43.82:9090/-/reload"
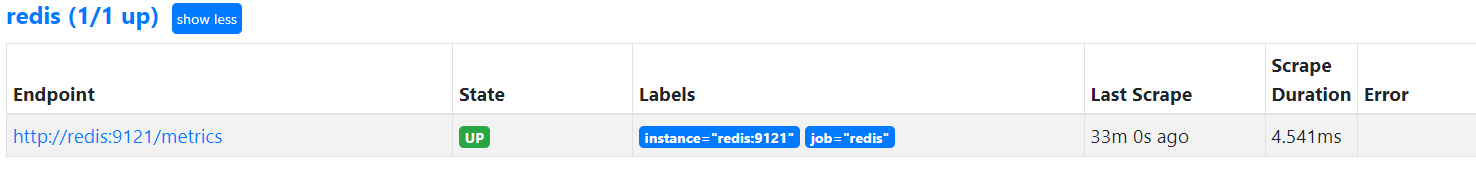
此时,去看 Prometheus 的 Dashboard 中查看采集的目标数据:
3、使用Prometheus实现Kubernetes 集群节点的监控
(1) Kubernetes 集群监控方案
对于 Kubernetes 集群本身的监控,需要考虑以下几个方面:
- Kubernetes 节点的监控:比如节点的 cpu、load、disk、memory 等指标
- 内部系统组件的状态:比如 kube-scheduler、kube-controller-manager、kubedns/coredns 等组件的详细运行状态
- 编排级的 metrics:比如 Deployment 的状态、资源请求、调度和 API 延迟等数据指标
Kubernetes 集群的监控方案目前主要有以下几种方案:
cAdvisor:cAdvisor 是 Google 开源的容器资源监控和性能分析工具,它是专门为容器而生,本身也支持 Docker 容器。kube-state-metrics:kube-state-metrics 通过监听 API Server 生成有关资源对象的状态指标,比如 Deployment、Node、Pod,需要注意的是 kube-state-metrics 只是简单提供一个 metrics 数据,并不会存储这些指标数据,所以需要使用 Prometheus 来抓取这些数据然后存储。metrics-server:metrics-server 也是一个集群范围内的资源数据聚合工具,metrics-server 也只是显示数据,并不提供数据存储服务。
不过 kube-state-metrics 和 metrics-server 之间还是有很大不同的,二者的主要区别如下:
- kube-state-metrics 主要关注的是业务相关的一些元数据,比如 Deployment、Pod、副本状态等
- metrics-server 主要关注的是资源度量 API 的实现,比如 CPU、文件描述符、内存、请求延时等指标。
(2)、使用node_exporter监控集群节点
由于每个集群节点都需要获取到监控指标数据,所以我们可以通过 DaemonSet 控制器来部署该服务,这样每一个节点都会自动运行一个 node-exporter 的 Pod,如果从集群中删除或者添加节点后,也会进行自动扩展。
部署 node-exporter的资源清单文件node-exporter.yml 内容如下:
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: node-exporter
  namespace: kube-pm
  labels:
    app: node-exporter
spec:
  selector:
    matchLabels:
      app: node-exporter
  template:
    metadata:
      labels:
        app: node-exporter
    spec:
      hostPID: true
      hostIPC: true
      hostNetwork: true
      nodeSelector:
        kubernetes.io/os: linux
      containers:
        - name: node-exporter
          image: prom/node-exporter:v1.6.0
          args:
            - --web.listen-address=$(HOSTIP):9100
            - --path.procfs=/host/proc
            - --path.sysfs=/host/sys
            - --path.rootfs=/host/root
            - --no-collector.hwmon
            - --no-collector.nfs
            - --no-collector.nfsd
            - --no-collector.nvme
            - --no-collector.dmi
            - --no-collector.arp
            - --collector.filesystem.ignored-mount-points=^/(dev|proc|sys|var/lib/containerd/.+|/var/lib/docker/.+|var/lib/kubelet/p
ods/.+)($|/)
            - --collector.filesystem.ignored-fs-types=^(autofs|binfmt_misc|cgroup|configfs|debugfs|devpts|devtmpfs|fusectl|hugetlbfs
|mqueue|overlay|proc|procfs|pstore|rpc_pipefs|securityfs|sysfs|tracefs)$
          ports:
            - containerPort: 9100
          env:
            - name: HOSTIP
              valueFrom:
                fieldRef:
                  fieldPath: status.hostIP
          resources:
            requests:
              cpu: 150m
              memory: 180Mi
            limits:
              cpu: 150m
              memory: 180Mi
          securityContext:
            runAsNonRoot: true
            runAsUser: 65534
          volumeMounts:
            - name: proc
              mountPath: /host/proc
            - name: sys
              mountPath: /host/sys
            - name: root
              mountPath: /host/root
              mountPropagation: HostToContainer
              readOnly: true
      tolerations:
        - operator: "Exists"
      volumes:
        - name: proc
          hostPath:
            path: /proc
        - name: dev
          hostPath:
            path: /dev
        - name: sys
          hostPath:
            path: /sys
        - name: root
          hostPath:
            path: /
要获取到的数据是主机的监控指标数据,而我们的 node-exporter 是运行在容器中的,所以我们在 Pod 中需要配置一些 Pod 的安全策略,这里我们就添加了 hostPID: true、hostIPC: true、hostNetwork: true 3 个策略,用来使用主机的 PID namespace、IPC namespace 以及主机网络。
另外我们还将主机的 /dev、/proc、/sys这些目录挂载到容器中,这些因为我们采集的很多节点数据都是通过这些文件夹下面的文件来获取到的,比如我们在使用 top 命令可以查看当前 cpu 使用情况,数据就来源于文件 /proc/stat,使用 free 命令可以查看当前内存使用情况,其数据来源是来自 /proc/meminfo 文件。
由于集群使用的是 kubeadm 搭建的,所以如果希望 master 节点也一起被监控,则需要添加相应的容忍(tolerations)。
最后,在k8s每个集群节点部署node-exporter,执行如下命令:
[root@k8smaster k8syml]# kubectl apply -f node-exporter.yml
[root@k8smaster k8syml]# kubectl get pods -n kube-pm -l app=node-exporter -o wide
NAME                  READY   STATUS    RESTARTS        AGE   IP              NODE        NOMINATED NODE   READINESS GATES
node-exporter-449bx   1/1     Running   1 (3h53m ago)   28h   172.16.213.56   k8smaster   <none>           <none>
node-exporter-b5xjz   1/1     Running   1 (3h54m ago)   28h   172.16.213.58   k8swork2    <none>           <none>
node-exporter-q9rsg   1/1     Running   1 (3h54m ago)   28h   172.16.213.57   k8swork1    <none>           <none>
部署完成后,我们可以看到在 3 个节点上都运行了一个 Pod,由于我们指定了 hostNetwork=true,所以在每个节点上就会绑定一个端口 9100,我们可以通过这个节点IP和端口去获取到监控指标数据。
访问http://172.16.213.56:9100/metrics,即可看到对应的输出指标。或者执行如下命令:
[root@k8smaster k8syml]# curl 172.16.213.56:9100/metrics4、Prometheus中基于K8s的服务发现机制
通过静态配置的方式添加节点到 Prometheus 的方法,简单、明了,但是,以后要新增或者去掉节点的时候就还得手动去配置,那么有没有一种方式可以让 Prometheus 去自动发现节点的 node-exporter 程序,并且按节点进行分组呢?这就是 Prometheus 里面非常重要的服务发现功能了。
(1)、K8S下的节点发现
在 Kubernetes 下,Promethues 通过与 Kubernetes API 集成,主要支持 5 中服务发现模式,分别是:Node、Service、Pod、Endpoints、Ingress。
要让 Prometheus 能够获取到当前集群中的所有节点信息,需要在prometheus.yml 文件中配置如下 job 任务即可:
- job_name: "nodes"
      kubernetes_sd_configs:
       - role: node
通过指定 kubernetes_sd_configs 的模式为node,Prometheus 就会自动从 Kubernetes 中发现所有的 node 节点并作为当前 job 监控的目标实例,发现的节点 /metrics 接口是默认的 kubelet 的 HTTP 接口。
接着,就是更新prometheus的 ConfigMap,完成后,执行 reload 操作,让配置生效。
[root@k8smaster k8syml]# kubectl apply -f  prometheus-cm.yml
[root@k8smaster k8syml]# curl -X POST "http://10.244.43.82:9090/-/reload"
配置生效后,我们再去 prometheus 的 dashboard 中查看 Targets 是否能够正常抓取数据:
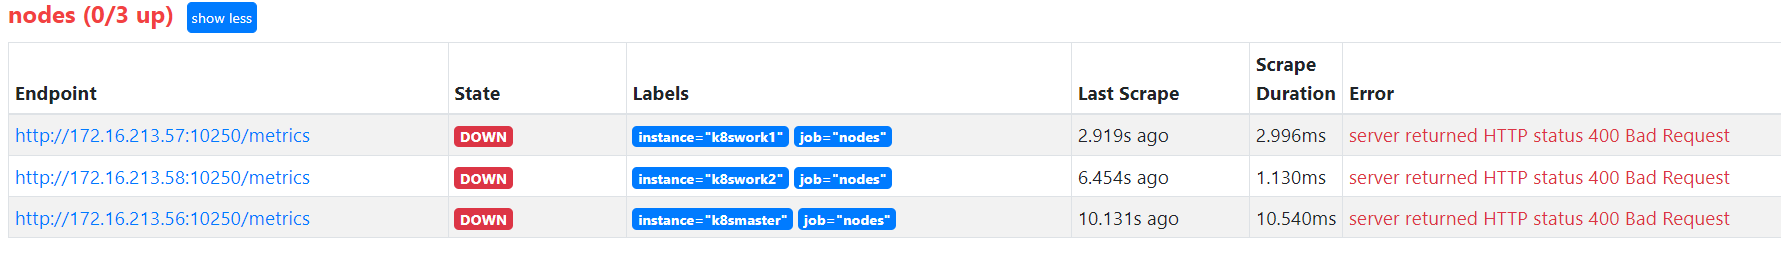
通过上图发现,nodes 这个 job 任务已经自动发现了我们 3 个 node 节点,但是在获取数据的时候失败了,出现了类似于下面的错误信息:
server returned HTTP status 400 Bad Request这个是因为 prometheus 去发现 Node 模式的服务时,默认的访问端口是 10250,而默认是需要认证的 https 协议才有权访问的,但实际上我们并不希望访问10250 端口的 /metrics 接口,而是 node-exporter 绑定到节点的 9100 端口,因此,就需要将这里的 10250 替换成 9100,要实现这个功能,就要用到我们之前讲过的标签重新功能。
Prometheus 提供的 relabel_configs 中的 replace 能力,relabel 可以在 Prometheus 采集数据之前,通过 Target 实例的 Metadata 信息,动态重新写入 Label 的值,这里我们需要去匹配 __address__ 这个内置的 Label 标签,然后替换掉其中的端口即可。
重新修改prometheus.yml 文件中配置的job,修改后的内容如下:
- job_name: "nodes"
      kubernetes_sd_configs:
       - role: node
      relabel_configs:
       - source_labels: [__address__]
         regex: "(.*):10250"
         replacement: "${1}:9100"
         target_label: __address__
         action: replace
这是一个正则表达式去匹配 __address__ 这个标签,然后将 host 部分保留下来,port 替换成了 9100,接着,再次更新prometheus.yml 文件,去查看nodes 这个 job 任务是否正常:
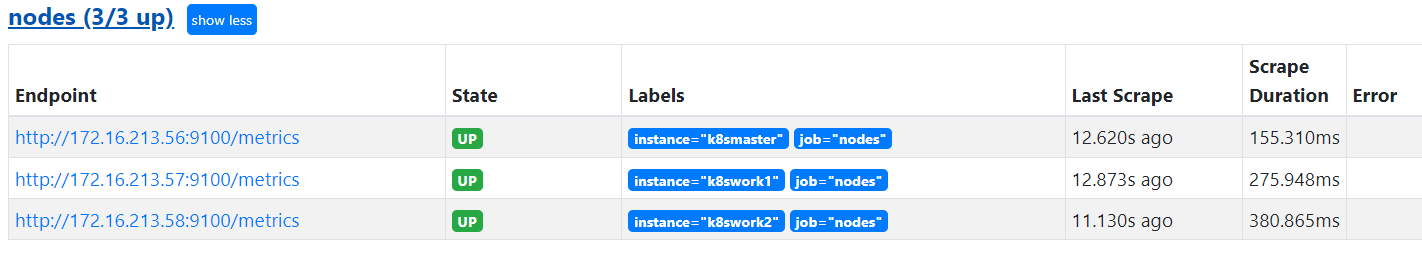
现在采集正常了,但是发现标签指标太少,这对于进行监控分组分类查询的时候,会带来了很多不方便的地方,因此,我们可以将Node 节点中内置的一些Label标签,通过标签重写,加到对应的Target 实例上。这就要用到标签重新的另一个参数labelmap,重新修改prometheus.yml 文件中配置的job,修改后的内容如下:
- job_name: "nodes"
      kubernetes_sd_configs:
       - role: node
      relabel_configs:
       - source_labels: [__address__]
         regex: "(.*):10250"
         replacement: "${1}:9100"
         target_label: __address__
         action: replace
       - action: labelmap
         regex: __meta_kubernetes_node_label_(.+)
这里添加了一个 action 为 labelmap,正则表达式是 __meta_kubernetes_node_label_(.+) 的配置,这里的意思就是表达式中匹配到的内容,就添加到指标数据的Label 标签中去。
kubernetes_sd_configs 下面有很多可用的元信息标签(内置标签),如下图:
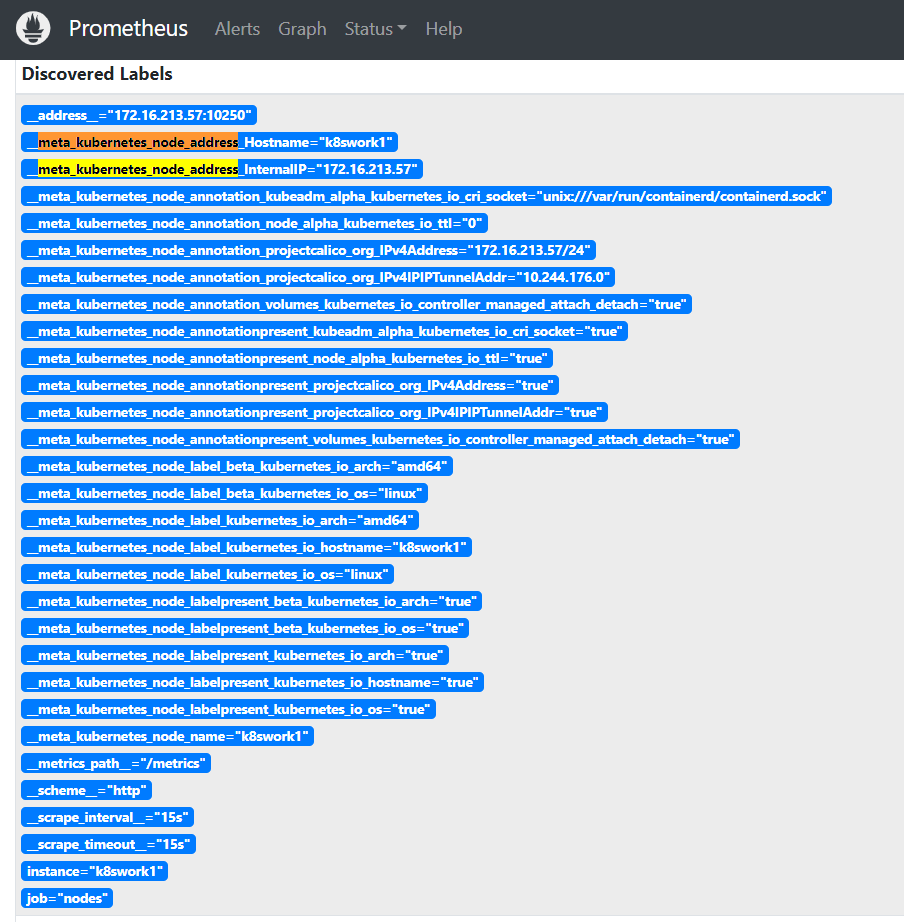
例如:
__meta_kubernetes_node_name:节点对象的主机名_meta_kubernetes_node_label:节点对象中的每个标签_meta_kubernetes_node_annotation:来自节点对象的每个注释_meta_kubernetes_node_address:每个节点的主机名或内部IP地址
(2)、kubelet监控指标
kubelet 默认也自带了一些监控指标数据,就上面我们看到的10250端口,所以这里也把 kubelet 的监控任务一并配置上,重新修改prometheus.yml文件,添加一个名为kubelet的job,内容如下:
- job_name: "kubelet"
      kubernetes_sd_configs:
        - role: node
      scheme: https
      tls_config:
        ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
        insecure_skip_verify: true
      bearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/token
      relabel_configs:
       - action: labelmap
         regex: __meta_kubernetes_node_label_(.+)
上面配置中,由于使用了 https 协议访问,这样就必然需要提供证书,我这里是通过配置 insecure_skip_verify: true 来跳过了证书校验。之外,要访问集群的资源,还必须要有对应的权限才可以,也就是对应的 ServiceAccount 权限允许才可以,这里只需要将 Pod 中自动注入的 /var/run/secrets/kubernetes.io/serviceaccount/ca.crt 和 /var/run/secrets/kubernetes.io/serviceaccount/token 文件配置上,就可以获取到对应的权限了。
再次更新prometheus.yml 文件,去查看kubelet这个 job 任务是否正常:
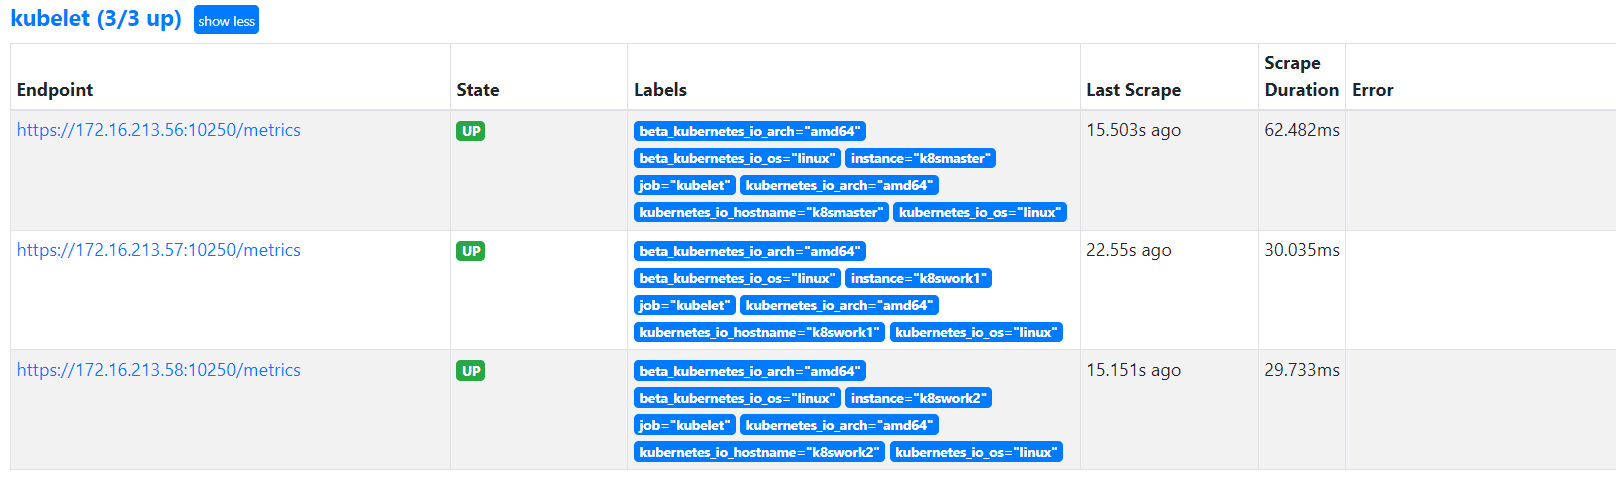
以看到我们上面添加的 kubelet 和 nodes 这两个 job 任务都已经配置成功了,而且二者的 Labels 标签都和集群的 node 节点标签保持一致了。
5、使用cAdvisor实现对K8s中容器状态的监控
对容器的监控是cAdvisor, 但cAdvisor 已经内置在了 kubelet 组件之中,所以我们不需要单独去安装,cAdvisor 的数据路径为 /api/v1/nodes/<node>/proxy/metrics,但是我们不推荐使用这种方式,因为这种方式是通过 APIServer 去代理访问的,对于大规模的集群会对 APIServer 造成很大的压力,所以我们可以直接通过访问 kubelet 的 /metrics/cadvisor 这个端点来获取 cAdvisor 的数据。
重新修改prometheus.yml 文件,添加一个名为cadvisor的job,内容如下:
- job_name: "cadvisor"
      kubernetes_sd_configs:
        - role: node
      scheme: https
      tls_config:
        ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
        insecure_skip_verify: true
      bearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/token
      relabel_configs:
       - action: labelmap
         regex: __meta_kubernetes_node_label_(.+)
         replacement: $1
       - replacement: /metrics/cadvisor
         target_label: __metrics_path__
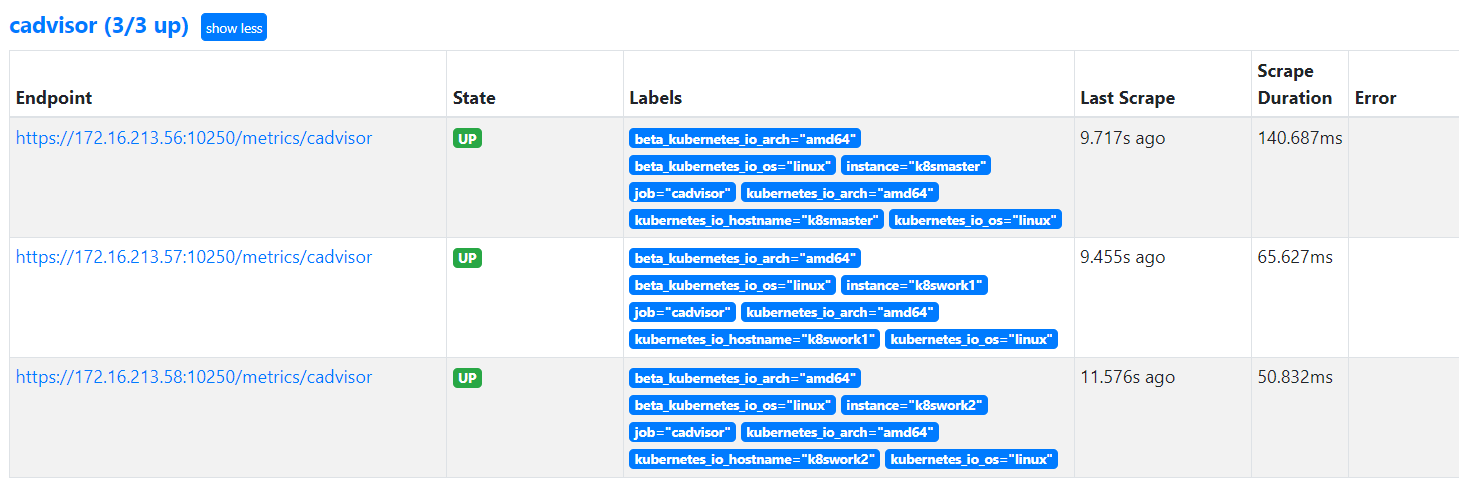
需要注意的是配置了 ca.cart 和 token 这两个文件,这两个文件是 Prometheus 的 Pod 启动后自动注入进来的,另外,就是加上重写了__metrics_path__ 的访问路径为 /metrics/cadvisor:
再次更新prometheus.yml 文件,去查看cadvisor这个 job 任务是否正常:
例子1:下面说明下容器的 CPU 使用率如何计算:
container_cpu_usage_seconds_total 是容器累计使用的 CPU 时间,用它除以 CPU 的总时间,就可以得到容器的 CPU 使用率了。
容器累计使用的 CPU 时间:
sum(rate(container_cpu_usage_seconds_total{image!="",pod!=""}[1m])) by (namespace, pod)CPU 的总时间:Pod 的 CPU 核数 * 1s
sum(container_spec_cpu_quota{image!="", pod!=""}) by(namespace, pod) / 100000要计算容器cpu使用率,那就是上面这两个语句的结果相除即可:
(sum(rate(container_cpu_usage_seconds_total{image!="",pod!=""}[1m])) by (namespace, pod))
/
(sum(container_spec_cpu_quota{image!="", pod!=""}) by(namespace, pod) / 100000) * 100
例子2:在计算下Pod的内存使用率:
推荐使用 container_memory_working_set_bytes来评估pod内存的使用率,因为 kubelet 也是根据该指标来判断是否 OOM 的,所以用此指标来评估内存使用率更加科学,对应的 PromQL 语句如下所示:
sum(container_memory_working_set_bytes{image!=""}) by(namespace, pod) / sum(container_spec_memory_limit_bytes{image!=""}) by(namespace, pod) * 100 != +inf6、使用Prometheus监控 k8s的API Server
APIServer 作为 Kubernetes 最核心的组件,必须要监控起来,对于 APIServer 的监控可以直接通过 Kubernetes 的 Service 来获取:
[root@k8smaster k8syml]# kubectl  get svc
NAME         TYPE        CLUSTER-IP   EXTERNAL-IP   PORT(S)   AGE
kubernetes   ClusterIP   10.96.0.1    <none>        443/TCP   21d
[root@k8smaster k8syml]#
上面这个 Service 就是集群的 apiserver 在集群内部的 Service 地址,要自动发现 Service 类型的服务,我们就需要用到 role 为 Endpoints 的 kubernetes_sd_configs,因此,可以在 ConfigMap 对象中添加上一个 Endpoints 类型的服务监控任务,重新修改prometheus.yml 文件,添加一个名为apiservers的job,内容如下:
- job_name: "apiservers"
      kubernetes_sd_configs:
       - role: endpoints
上面定义的类型为 endpoints 的 kubernetes_sd_configs,再次更新prometheus.yml 文件,去查看apiservers这个 job 任务是否正常,如下图:
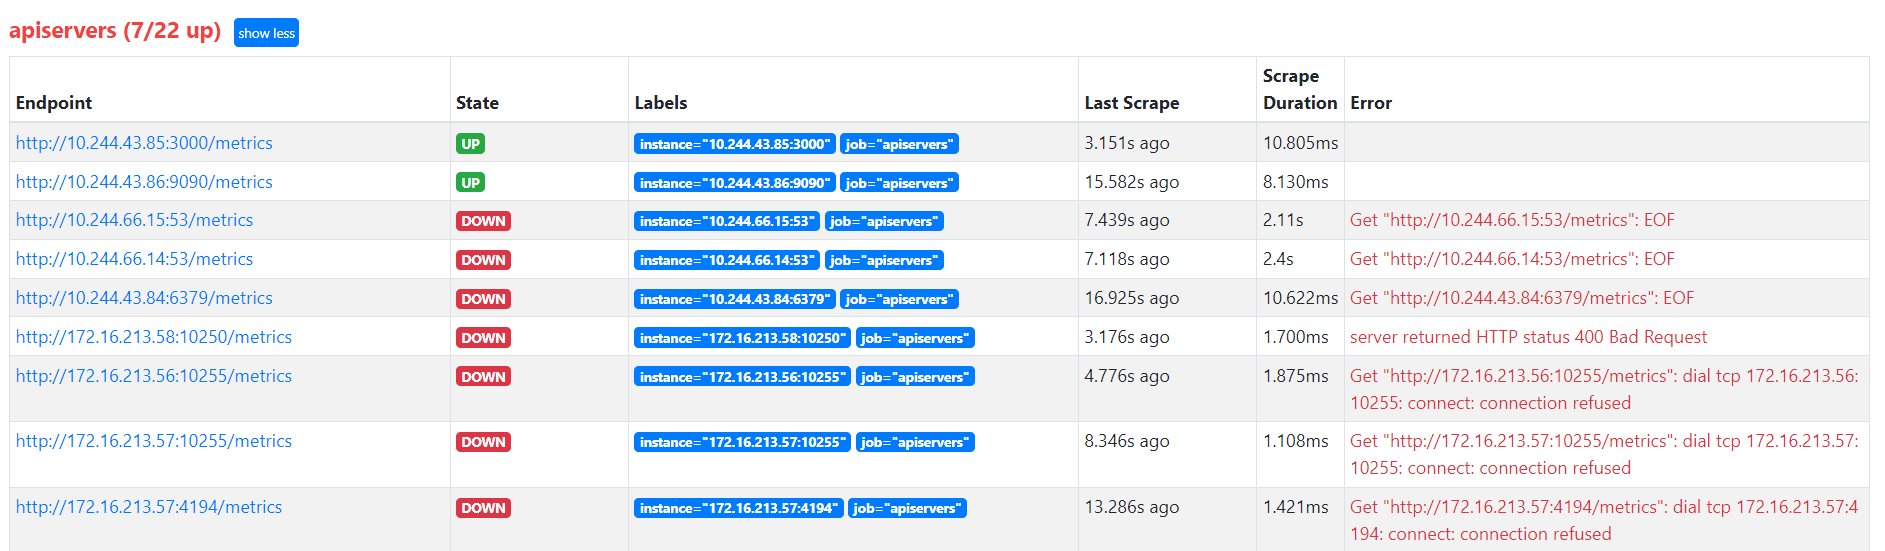
可以看到 apiservers 任务下面出现了很多实例, Prometheus 把所有的 Endpoints 服务都抓取过来了,当中也包含服务名为 kubernetes 这个 apiserver服务,应该怎样来过滤出这个服务来呢?同样还是需要使用relabel_configs 这个配置。
我们要过滤的服务是 default 这个 namespace 下面,服务名为 kubernetes 的元数据,所以这里我们就可以根据对应的 __meta_kubernetes_namespace 和 __meta_kubernetes_service_name 这两个内置标签来进行过滤,另外由于 kubernetes 这个服务对应的端口是 443,需要使用 https 协议,所以这里还需要使用 https 协议,对应的就需要将 ca 证书配置上。
重新修改prometheus.yml 文件中配置的job,内容如下:
- job_name: "apiservers"
      kubernetes_sd_configs:
       - role: endpoints
      scheme: https
      tls_config:
        ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
      bearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/token
      relabel_configs:
       - source_labels:
          [
           __meta_kubernetes_namespace,
           __meta_kubernetes_service_name,
           __meta_kubernetes_endpoint_port_name,
          ]
         action: keep
regex: default;kubernetes;https再次更新prometheus.yml 文件,去查看apiservers这个 job 任务是否正常,如下图:
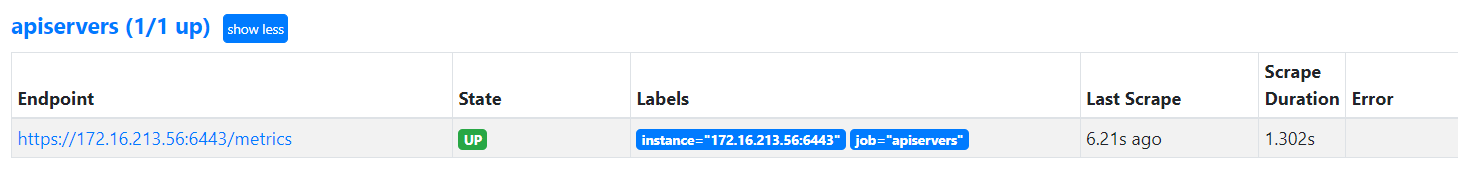
可以看到 apiserver 这个任务下面只有 apiserver 这一个实例了。
7、使用Prometheus监控 k8s的Pod
上面介绍的apiserver, 实际上是一种特殊的 Endpoints,现在,我来配置一个任务,用来专门发现普通类型的 Endpoint,其实就是 Service 关联的 Pod 列表,由于并不是所有的 Endpoints 都会提供 metrics 接口,所以需要主动告诉 Prometheus 去发现哪些 Endpoints,当然告诉的方式有很多,不过常用的一种方式是通过 annotations 注解进行通知。
重新修改prometheus.yml 文件,添加一个名为endpoints的job,内容如下:
- job_name: "endpoints"
      kubernetes_sd_configs:
        - role: endpoints
      relabel_configs:
        - source_labels: [__meta_kubernetes_service_annotation_prometheus_io_scrape]
          action: keep
          regex: true
        - source_labels: [__meta_kubernetes_service_annotation_prometheus_io_scheme]
          action: replace
          target_label: __scheme__
          regex: (https?)
        - source_labels: [__meta_kubernetes_service_annotation_prometheus_io_path]
          action: replace
          target_label: __metrics_path__
          regex: (.+)
        - source_labels:
            [__address__, __meta_kubernetes_service_annotation_prometheus_io_port]
          action: replace
          target_label: __address__
          regex: ([^:]+)(?::\d+)?;(\d+)
          replacement: $1:$2
        - action: labelmap
          regex: __meta_kubernetes_service_label_(.+)
        - source_labels: [__meta_kubernetes_namespace]
          action: replace
          target_label: kubernetes_namespace
        - source_labels: [__meta_kubernetes_service_name]
          action: replace
          target_label: kubernetes_name
        - source_labels: [__meta_kubernetes_pod_name]
          action: replace
          target_label: kubernetes_pod_name
上面配置比较复杂,在 relabel_configs 区域,做了大量的配置,特别是第一个__meta_kubernetes_service_annotation_prometheus_io_scrape 为 true 的才保留下来,这就是说要想自动发现集群中的 Endpoint,就需要在 Service 的 annotations 区域添加 prometheus.io/scrape=true 的注解,这里推荐一个网址, https://relabeler.promlabs.com/ 通过这个工具来帮助我们配置 Relabel。
再次更新prometheus.yml 文件,去查看endpoints这个 job 任务状态,如下图:
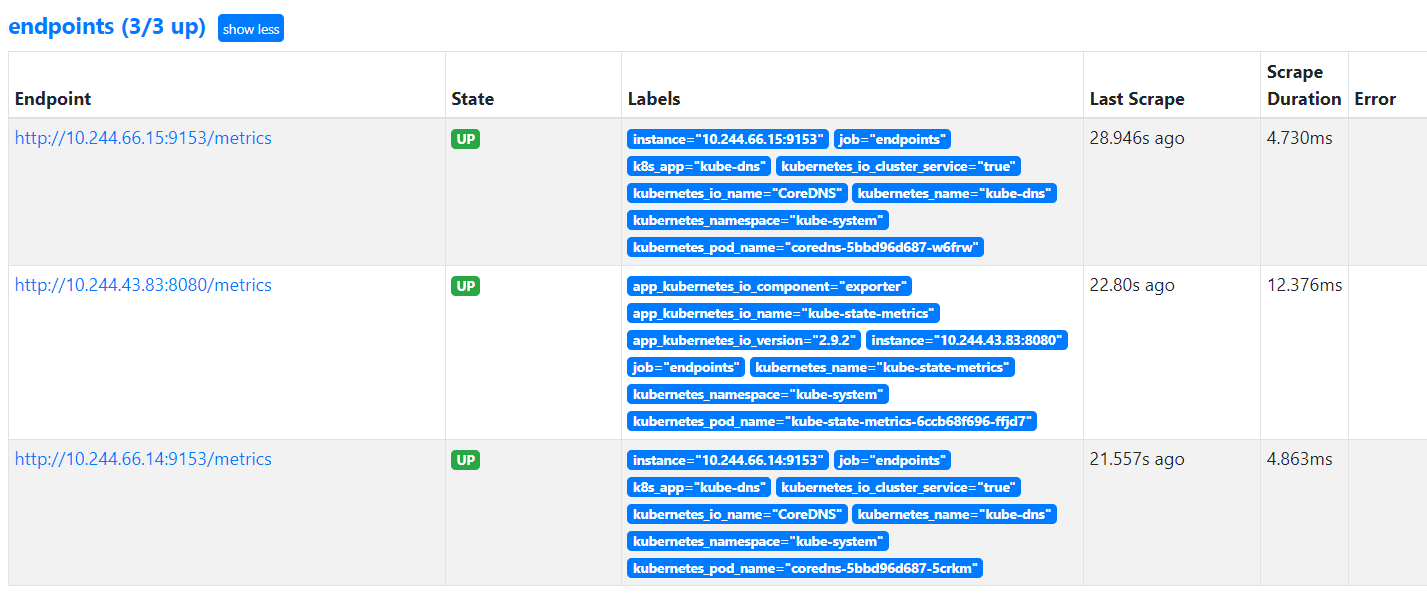
可以看到 endpoints 这一个任务下面只发现了 3 个任务。其中,relabel_configs 中过滤了 annotations 有 prometheus.io/scrape=true 的 Service,其中,kube-dns的两个pod满足了这个要求,可以通过如下命令查看:
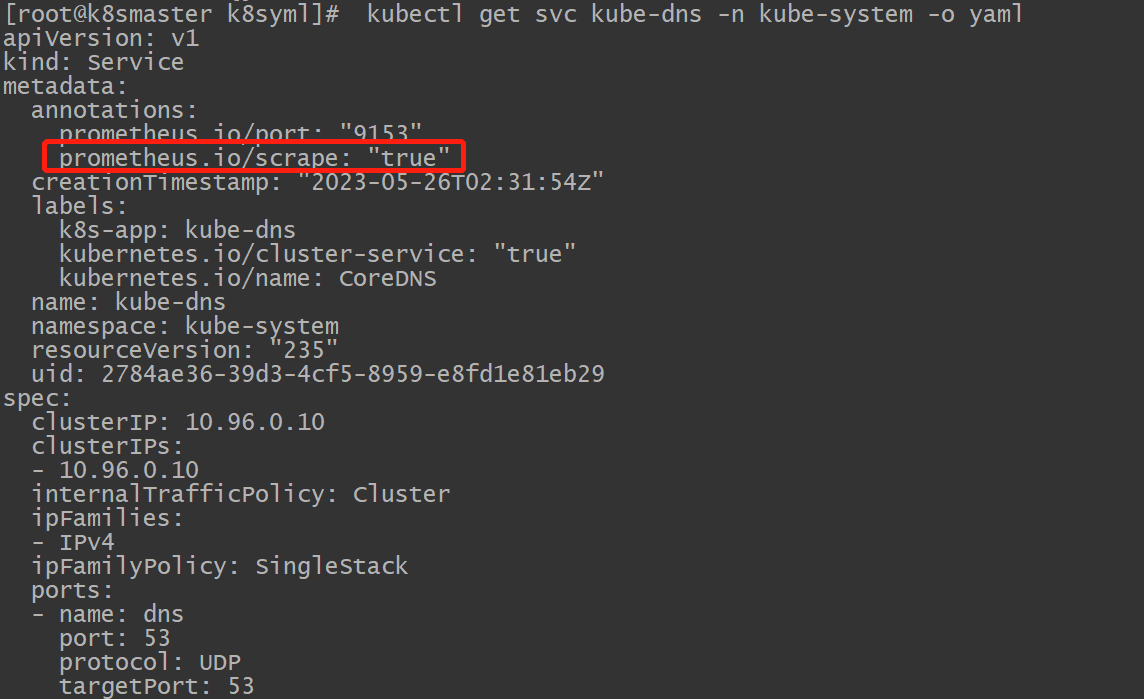
现在我们来测试下,之前创建的redis服务,通过上面的方法实现自动发现对redis服务对应pod的监控。
首先,修改 redis 部署文件redis-exporter.yml ,在Service 中添加上 prometheus.io/scrape=true 这个注解,下面列出添加后的redis-exporter.yml完整内容:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: redis
  namespace: kube-pm
spec:
  selector:
    matchLabels:
      app: redis
  template:
    metadata:
      labels:
        app: redis
    spec:
      containers:
        - name: redis
          image: redis:6
          resources:
            requests:
              cpu: 100m
              memory: 100Mi
          ports:
            - containerPort: 6379
        - name: redis-exporter
          image: oliver006/redis_exporter:latest
          resources:
            requests:
              cpu: 100m
              memory: 100Mi
          ports:
            - containerPort: 9121
---
kind: Service
apiVersion: v1
metadata:
  name: redis
  namespace: kube-pm
  annotations:
    prometheus.io/scrape: "true"
    prometheus.io/port: "9121"
spec:
  selector:
    app: redis
  ports:
    - name: redis
      port: 6379
      targetPort: 6379
    - name: prom
      port: 9121
      targetPort: 9121
然后去更新配置:
[root@k8smaster k8syml]# kubectl apply -f redis-exporter.yml更新完成后,去 Prometheus 查看 Targets 路径,可以看到 redis 服务自动出现在了 endpoints 这个任务下面:
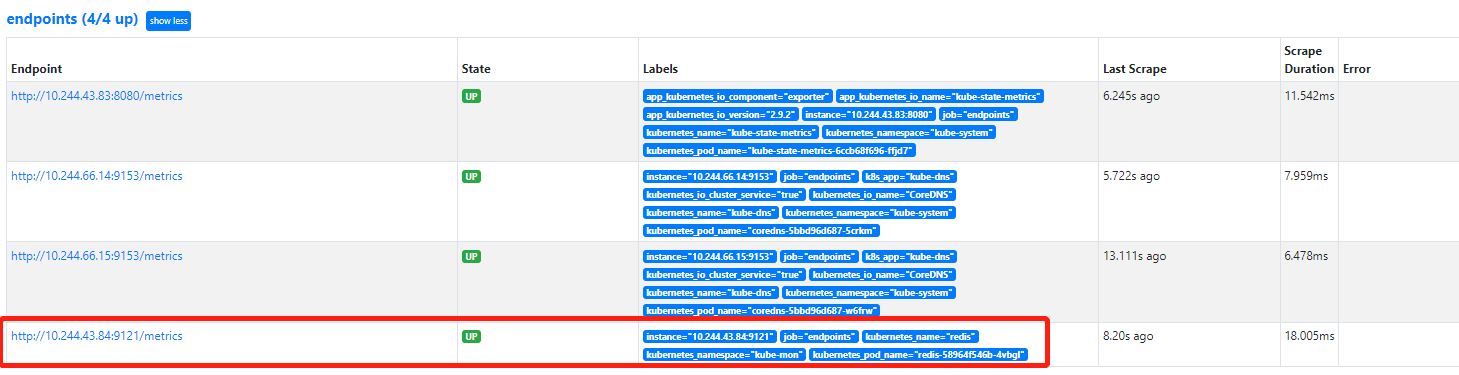
这样以后有了新的服务,如果服务本身提供了 /metrics 接口,就完全不需要用静态的方式去配置了,现在就可以将之前配置的 redis 静态配置去掉了。
8、使用kube-state-metrics实现Kubernetes 集群资源状态监控
上面我们配置了自动发现 Endpoints 的监控,这些监控数据都是应用内部的监控,需要应用本身提供一个 /metrics 接口,或者对应的 exporter 来暴露对应的指标数据,但是在 Kubernetes 集群上 Pod、DaemonSet、Deployment、Job、CronJob 等各种资源对象的状态也需要监控,比如:
- 我调度了多少个副本?现在可用的有几个?
- 多少个 Pod 是
running/stopped/terminated状态? - Pod 重启了多少次?
- 我有多少 job 在运行中等等
但是,apiserver监控 和 kubelet 中集成的 cAdvisor监控,这些监控指标并没有具体的各种资源对象的状态指标,此时,可以使用Kubernetes 提供的一个kube-state-metrics 插件。kube-state-metrics 关注于获取 Kubernetes 各种资源的最新状态,如 deployment 或者 daemonset。
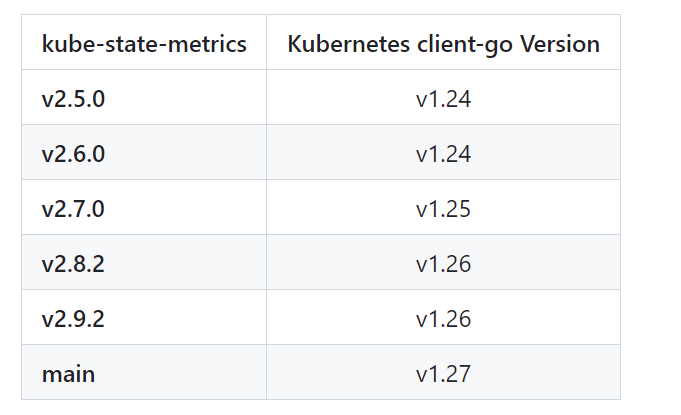
要安装 kube-state-metrics 非常简单,直接将代码 Clone 到集群节点上(能用 kubectl 工具操作就行),不过需要注意兼容的版本,如下图:
下载kube-state-metrics代码如下:
[root@k8smaster k8syml]# git clone https://github.com/kubernetes/kube-state-metrics.git
[root@k8smaster k8syml]# cd kube-state-metrics/examples/standard然后,需要修改2个文件,分别是deployment.yaml和service.yaml,打开deployment.yaml文件,找到下载kube-state-metrics镜像的地址,默认地址是registry.k8s.io,这个地址国内无法访问,将此地址修改为"cnych/kube-state-metrics:v2.9.2",这里我使用的是v2.9.2版本,你可以修改为其他版本。
接着,修改第二个文件service.yaml,配置对应的 annotations 来自动被发现,修改好的内容如下:
apiVersion: v1
kind: Service
metadata:
  labels:
    app.kubernetes.io/component: exporter
    app.kubernetes.io/name: kube-state-metrics
    app.kubernetes.io/version: 2.9.2
  name: kube-state-metrics
  namespace: kube-system
  annotations:
    prometheus.io/scrape: "true"
    prometheus.io/port: "8080"
spec:
  clusterIP: None
  ports:
  - name: http-metrics
    port: 8080
    targetPort: http-metrics
  - name: telemetry
    port: 8081
    targetPort: telemetry
  selector:
    app.kubernetes.io/name: kube-state-metrics
最后,执行部署操作:
[root@k8smaster k8syml]# cd kube-state-metrics/examples
[root@k8smaster k8syml]# kubectl  apply  -f standard/
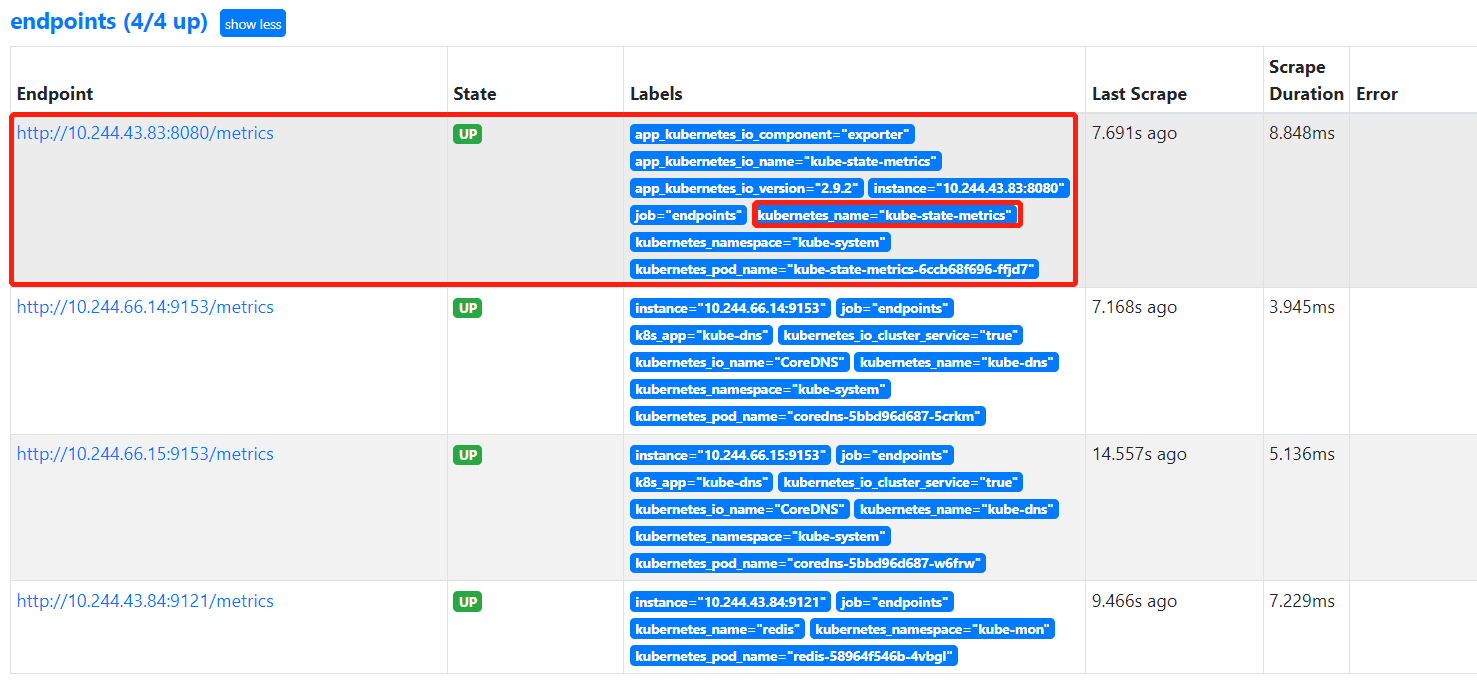
部署完成后, Prometheus 就可以自动采集到指标了。如下图:
kube-state-metrics常见监控指标含义:
POD:
kube_pod_info # 有关pod的信息。
kube_pod_start_time # pod的unix时间戳记中的开始时间。
kube_pod_completion_time #pod的unix时间戳记中的完成时间。
kube_pod_owner # 有关Pod所有者的信息。
kube_pod_labels # Kubernetes标签转换为Prometheus标签。
kube_pod_status_phase # Pod当前阶段。
kube_pod_status_ready # 描述容器是否准备好处理请求。
kube_pod_status_scheduled # 描述pod的调度过程的状态。
kube_pod_container_info # 有关容器中container的信息。
kube_pod_container_status_waiting # 描述容器当前是否处于等待状态。
kube_pod_container_status_waiting_reason # 描述容器当前处于等待状态的原因。
kube_pod_container_status_running # 描述容器当前是否处于运行状态。
kube_pod_container_status_terminated # 描述容器当前是否处于终止状态。
kube_pod_container_status_terminated_reason # 描述容器当前处于终止状态的原因。
kube_pod_container_status_last_terminated_reason # 描述容器处于终止状态的最后原因。
kube_pod_container_status_ready # Describes whether the containers readiness check succeeded.
kube_pod_container_status_restarts_total # 每个容器的容器重新启动次数。
kube_pod_container_resource_requests # 容器请求的请求资源数。
kube_pod_container_resource_limits # 容器请求的限制资源数量。
kube_pod_overhead
kube_pod_created # Unix创建时间戳。
kube_pod_deletion_timestamp # Unix删除时间戳
kube_pod_restart_policy # 描述此pod使用的重新启动策略。
kube_pod_init_container_info # 有关Pod中init容器的信息。
kube_pod_init_container_status_waiting # ,描述初始化容器当前是否处于等待状态。
kube_pod_init_container_status_waiting_reason # Describes the reason the init container is currently in waiting state.
kube_pod_init_container_status_running # 描述初始化容器当前是否处于运行状态。
kube_pod_init_container_status_terminated # 描述初始化容器当前是否处于终止状态。
kube_pod_init_container_status_terminated_reason # 描述初始化容器当前处于终止状态的原因。
kube_pod_init_container_status_last_terminated_reason # 描述初始化容器处于终止状态的最后原因。
kube_pod_init_container_status_ready # 描述初始化容器准备情况检查是否成功。
kube_pod_init_container_status_restarts_total  #Counter类型,初始化容器的重新启动次数。
kube_pod_init_container_resource_limits # 初始化容器请求的限制资源数。
kube_pod_spec_volumes_persistentvolumeclaims_info # 有关Pod中持久卷声明卷的信息。
kube_pod_spec_volumes_persistentvolumeclaims_readonly # 描述是否以只读方式安装了持久卷声明。
kube_pod_status_reason # pod状态原因
kube_pod_status_scheduled_time # Pod移至计划状态时的Unix时间戳
kube_pod_status_unschedulable # 描述pod的unschedulable状态。
Deployment
kube_deployment_status_replicas  #deployment包含的副本个数
kube_deployment_status_replicas_available  #deployment的可用副本数
kube_deployment_status_replicas_unavailable  #deployment中不可用副本的数量
kube_deployment_status_replicas_updated  #deployment的更新副本数
kube_deployment_status_observed_generation  #deployment控制器观察到的生成
kube_deployment_status_condition  #部署的当前状态condition
kube_deployment_spec_replicas  #deployment所需的Pod数
kube_deployment_spec_paused  #deployment是否暂停,并且deployment控制器不会处理。
kube_deployment_spec_strategy_rollingupdate_max_surge  #滚动更新deployment期间的最大不可用副本数。
kube_deployment_metadata_generation  #代表期望状态的特定生成的序列号
kube_deployment_labels  #Kubernetes标签转换为Prometheus标签
kube_deployment_created  #Unix创建时间戳
StatefulSet
kube_statefulset_status_replicas # StatefulSet的副本数。
kube_statefulset_status_replicas_current # StatefulSet的当前副本数。
kube_statefulset_status_replicas_ready #StatefulSet的就绪副本数。
kube_statefulset_status_replicas_updated #StatefulSet的更新副本数。
kube_statefulset_status_observed_generation #StatefulSet控制器观察到的生成。
kube_statefulset_replicas #StatefulSet所需的pod数。
kube_statefulset_metadata_generation #表示StatefulSet所需状态的特定生成的序列号。
kube_statefulset_created #Unix创建时间戳。
kube_statefulset_labels #Kubernetes标签转换为Prometheus标签。
kube_statefulset_status_current_revision #指示用于按顺序[0,currentReplicas)生成Pod的StatefulSet的版本。
kube_statefulset_status_update_revision #指示用于按顺序[replicas-updatedReplicas,replicas]生成Pod的StatefulSet的版本
Endpoint
kube_endpoint_address_not_ready  #endpoint中not ready的addresses数
kube_endpoint_address_available  #endpoint中可用的addresses数
kube_endpoint_info  #有关endpoint的信息
kube_endpoint_labels  #Kubernetes标签转换为Prometheus标签
kube_endpoint_created  #Unix创建时间戳
Node
kube_node_info # 有关群集节点的信息。
kube_node_labels # Kubernetes标签转换为Prometheus标签。
kube_node_role # 集群节点的角色。
kube_node_spec_unschedulable # 节点是否可以调度新的Pod。
kube_node_spec_taint # 群集节点的污点。
kube_node_status_capacity # 节点不同资源的容量。
kube_node_status_allocatable # 可用于调度的节点的不同资源的可分配资源。
kube_node_status_condition # 群集节点的状况。
kube_node_created # Unix创建时间戳。
Service
kube_service_info # 有关service的信息。
kube_service_labels # Kubernetes标签转换为Prometheus标签。
kube_service_created # Unix创建时间戳。
kube_service_spec_type # Type about service.
kube_service_spec_external_ip # 服务外部IP。 每个IP一个组。
kube_service_status_load_balancer_ingress # 服务负载均衡器入口状态
Secret
kube_secret_info # 有关secret的信息。
kube_secret_type # Type about secret.
kube_secret_labels # Kubernetes标签转换为Prometheus标签。
kube_secret_created # Unix创建时间戳。
kube_secret_metadata_resource_version # 代表secret特定版本的资源版本。
DaemonSet
kube_daemonset_created  # Unix创建时间戳
kube_daemonset_status_current_number_scheduled  # 运行至少一个且应该运行的守护程序容器的节点数。
kube_daemonset_status_desired_number_scheduled  # 应该运行守护程序容器的节点数。
kube_daemonset_status_number_available  # 应该运行守护程序容器并具有一个或多个守护程序容器正在运行并且可用的节点数
kube_daemonset_status_number_misscheduled  # 运行守护程序容器但不应该运行的节点数。
kube_daemonset_status_number_ready  # 应该运行守护程序容器并已运行一个或多个守护程序容器并准备就绪的节点数。
kube_daemonset_status_number_unavailable  # 应该运行守护程序容器且没有任何守护程序容器正在运行并且可用的节点数
kube_daemonset_updated_number_scheduled  # 正在运行更新的守护程序pod的节点总数
kube_daemonset_metadata_generation  # 代表所需状态的特定生成的序列号。
kube_daemonset_labels  # Kubernetes标签转换为Prometheus标签。
实际应用中,重点关注使用 kube-state-metrics 的一些典型场景:
- 集群节点状态错误:
kube_node_status_condition{condition="Ready", status!="true"}==1 - 集群中存在启动失败的 Pod:
kube_pod_status_phase{phase=~"Failed|Unknown"}==1 - 最近 30 分钟内有 Pod 容器重启:
changes(kube_pod_container_status_restarts_total[30m])>0
9、Kubernetes中使用Grafana对监控实现可视化
Grafana可以单独部署,也可以和Kubernetes一起部署到集群中,这里我们将Grafana安装到k8s集群中,第一步,编写好的grafana.yml资源文件内容如下:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: grafana
  namespace: kube-pm
spec:
  selector:
    matchLabels:
      app: grafana
  template:
    metadata:
      labels:
        app: grafana
    spec:
      volumes:
        - name: storage
          persistentVolumeClaim:
            claimName: grafana-data
      initContainers:
        - name: fix-permissions
          image: busybox
          command: [chown, -R, "472:472", "/var/lib/grafana"]
          volumeMounts:
            - mountPath: /var/lib/grafana
              name: storage
      containers:
        - name: grafana
          image: grafana/grafana:9.5.3
          imagePullPolicy: IfNotPresent
          ports:
            - containerPort: 3000
              name: grafana
          env:
            - name: GF_SECURITY_ADMIN_USER
              value: admin
            - name: GF_SECURITY_ADMIN_PASSWORD
              value: admin123
          readinessProbe:
            failureThreshold: 10
            httpGet:
              path: /api/health
              port: 3000
              scheme: HTTP
            initialDelaySeconds: 60
            periodSeconds: 10
            successThreshold: 1
            timeoutSeconds: 30
          livenessProbe:
            failureThreshold: 3
            httpGet:
              path: /api/health
              port: 3000
              scheme: HTTP
            periodSeconds: 10
            successThreshold: 1
            timeoutSeconds: 1
          resources:
            limits:
              cpu: 150m
              memory: 512Mi
            requests:
              cpu: 150m
              memory: 512Mi
          volumeMounts:
            - mountPath: /var/lib/grafana
              name: storage
---
apiVersion: v1
kind: Service
metadata:
  name: grafana
  namespace: kube-pm
spec:
  type: NodePort
  ports:
    - port: 3000
  selector:
    app: grafana
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: grafana-local
  labels:
    app: grafana
spec:
  accessModes:
    - ReadWriteOnce
  capacity:
    storage: 1Gi
  storageClassName: local-storage
  local:
    path: /data/k8s/grafana
  persistentVolumeReclaimPolicy: Retain
  nodeAffinity:
    required:
      nodeSelectorTerms:
        - matchExpressions:
            - key: kubernetes.io/hostname
              operator: In
              values:
                - k8swork2
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: grafana-data
  namespace: kube-pm
spec:
  selector:
    matchLabels:
      app: grafana
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 1Gi
storageClassName: local-storage这个资源文件,将deploy、service、pv/pvc整个资源的构建都放到一起了,其中,deploy部分,grafana镜像选择的是grafana/grafana:9.3.5,然后添加了健康检查、资源声明,此外,还有两个比较重要的环境变量GF_SECURITY_ADMIN_USER和GF_SECURITY_ADMIN_PASSWORD,用来配置 grafana 的管理员用户和密码的。
由于 grafana 将 dashboard、插件这些数据保存在 /var/lib/grafana 这个目录下面的,所以如果需要做数据持久化的话,就需要针对这个目录进行 volume 挂载声明。另外,这里增加一个 initContainers 来修改数据卷的权限,保证grafana 可以将数据写入对应的宿主机本地磁盘中,最后,还需要对外暴露 grafana 这个服务,所以我们需要创建一个对应的 Service 对象,这里用NodePort 方式实现对外访问。
执行这个资源文件,过程如下:
[root@k8smaster k8syml]#  kubectl apply -f grafana.yml
[root@k8smaster k8syml]#  kubectl get pods -n kube-pm -l app=grafana
NAME                       READY   STATUS    RESTARTS      AGE
grafana-5bf86fffbd-w5lhh   1/1     Running   9 (10m ago)   2d20h
然后再查看service资源,操作如下:
[root@k8smaster k8syml]#  kubectl get svc -n kube-pm
NAME         TYPE        CLUSTER-IP       EXTERNAL-IP   PORT(S)             AGE
grafana      NodePort    10.104.131.66    <none>        3000:31474/TCP      2d20h
现在我们就可以在浏览器中使用 http://<任意节点IP:31474> 来访问 grafana 这个服务了。
10、Kubernetes中使用pushgateway推送数据
Pushgateway的存在是为了允许临时和批处理作业向 Prometheus 暴露其指标。由于这些类型的任务可能存在的时间不够长而无法被抓取,因此可以将指标推送到 Pushgateway,然后 Pushgateway 将这些指标暴露给 Prometheus,但有一点需要注意,Pushgateway 不是将指标主动 push 给 Prometheus,而是通过脚本将指标数据主动 push 给 Pushgateway 后,Prometheus 仍然通过 pull 模式去Pushgateway 抓取指标。
Pushgateway 可以单独部署,也可以部署到k8s集群中,前面已经介绍过Pushgateway独立部署方式,这里我将在k8s中部署Pushgateway 服务。
k8s中部署Pushgateway,对应的资源清单文件内容如下所示:
apiVersion: v1
kind: PersistentVolume
metadata:
  name: pushgateway-local
  labels:
    app: pushgateway
spec:
  accessModes:
    - ReadWriteOnce
  capacity:
    storage: 1Gi
  storageClassName: local-path
  local:
    path: /data/k8s/pushgateway
  persistentVolumeReclaimPolicy: Retain
  nodeAffinity:
    required:
      nodeSelectorTerms:
        - matchExpressions:
            - key: kubernetes.io/hostname
              operator: In
              values:
                - k8swork2
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pushgateway-data
  namespace: kube-pm
spec:
  selector:
    matchLabels:
      app: pushgateway
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 1Gi
  storageClassName: local-path
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: pushgateway
  namespace: kube-pm
  labels:
    app: pushgateway
spec:
  selector:
    matchLabels:
      app: pushgateway
  template:
    metadata:
      labels:
        app: pushgateway
    spec:
      volumes:
        - name: data
          persistentVolumeClaim:
            claimName: pushgateway-data
      containers:
        - name: pushgateway
          image: registry.cn-beijing.aliyuncs.com/iivey/pushgateway:v1.6.0
          imagePullPolicy: IfNotPresent
          args:
            - "--persistence.file=/data"
          ports:
            - containerPort: 9091
              name: http
          volumeMounts:
            - mountPath: "/data"
              name: data
          resources:
            requests:
              cpu: 100m
              memory: 500Mi
            limits:
              cpu: 100m
              memory: 500Mi
---
apiVersion: v1
kind: Service
metadata:
  name: pushgateway
  namespace: kube-pm
  labels:
    app: pushgateway
spec:
  selector:
    app: pushgateway
  type: NodePort
  ports:
    - name: http
      port: 9091
      targetPort: http
这里我用 --persistence.file 指定了持久化的文件,然后通过一个 Service 来暴露了服务,部署此资源文件,执行如下:
[root@k8smaster k8syml]# kubectl  apply   -f pushgateway.yml
[root@k8smaster k8syml]# kubectl  get svc -n kube-pm
NAME          TYPE        CLUSTER-IP       EXTERNAL-IP   PORT(S)             AGE
grafana       NodePort    10.104.131.66    <none>        3000:31474/TCP      2d23h
prometheus    NodePort    10.100.215.50    <none>        9090:32388/TCP      3d9h
pushgateway   NodePort    10.110.174.100   <none>        9091:31787/TCP      114m
redis         ClusterIP   10.110.126.101   <none>        6379/TCP,9121/TCP   3d8h
最后,我们就可以在浏览器中使用 http://<任意节点IP:31787> 来访问 pushgateway这个服务了。
关于pushgateway的使用,前面章节我们已经做了详细介绍,这里就不再展开了。
11、Kubernetes中使用Alertmanager实现告警通知
Alertmanager 主要用于接收 Prometheus 发送的告警信息,它支持丰富的告警通知渠道,而且很容易做到告警信息进行去重,降噪,分组等.
在安装Alertmanager 之前,先做一个ConfigMap 资源对象,构造一个Alertmanager 配置文件,文件alertmanager-cm.yml内容如下:
apiVersion: v1
kind: ConfigMap
metadata:
  name: alert-config
  namespace: kube-pm
data:
  config.yml: |-
    global:
      resolve_timeout: 5m
      smtp_smarthost: 'smtp.163.com:25'
      smtp_from: 'xxxxx@163.com'
      smtp_auth_username: 'xxxxx@163.com'
      smtp_auth_password: 'xxxxx'
      smtp_hello: '163.com'
      smtp_require_tls: false
    route:
      group_by: ['alertname', 'cluster']
      group_wait: 30s
      group_interval: 30s
      repeat_interval: 1h
      receiver: default

      routes:
      - receiver: email
        group_wait: 10s
        match:
          team: node
    receivers:
    - name: 'default'
      email_configs:
      - to: '97824870@qq.com'
        send_resolved: true
    - name: 'email'
      email_configs:
      - to: '97824870@qq.com'
        send_resolved: true
上面的内容,主要是Alertmanager 配置文件的编写,这个内容前面章节已经做过介绍,所以这里省略。
下面部署这个资源对象:
[root@k8smaster k8syml]# kubectl apply -f alertmanager-cm.yml这样,就创建了一个名为 alert-config 的 ConfigMap 资源对象。
接着,是配置 AlertManager 的容器和service服务,资源文件alertmanager-svc.yml内容如下:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: alertmanager
  namespace: kube-pm
  labels:
    app: alertmanager
spec:
  selector:
    matchLabels:
      app: alertmanager
  template:
    metadata:
      labels:
        app: alertmanager
    spec:
      volumes:
        - name: alertcfg
          configMap:
            name: alert-config
      containers:
        - name: alertmanager
          image: prom/alertmanager:v0.25.0
          imagePullPolicy: IfNotPresent
          args:
            - "--config.file=/etc/alertmanager/config.yml"
          ports:
            - containerPort: 9093
              name: http
          volumeMounts:
            - mountPath: "/etc/alertmanager"
              name: alertcfg
          resources:
            requests:
              cpu: 100m
              memory: 256Mi
            limits:
              cpu: 100m
              memory: 256Mi
---
apiVersion: v1
kind: Service
metadata:
  name: alertmanager
  namespace: kube-pm
  labels:
    app: alertmanager
spec:
  selector:
    app: alertmanager
  type: NodePort
  ports:
    - name: web
      port: 9093
      targetPort: http
上面将创建的 alert-config 这个 ConfigMap 资源对象以 Volume 的形式挂载到 /etc/alertmanager 目录下,然后在启动参数中指定了配置文件 --config.file=/etc/alertmanager/config.yml,最后,使用 NodePort 类型,创建了一个 Service资源对象。
接着,就是部署资源对象,执行如下操作:
[root@k8smaster k8syml]# kubectl  apply  -f alertmanager-svc.yml
[root@k8smaster k8syml]# kubectl  get svc -n kube-pm
NAME           TYPE        CLUSTER-IP       EXTERNAL-IP   PORT(S)             AGE
alertmanager   NodePort    10.108.159.30    <none>        9093:32169/TCP      11m
grafana        NodePort    10.104.131.66    <none>        3000:31474/TCP      2d23h
prometheus     NodePort    10.100.215.50    <none>        9090:32388/TCP      3d10h
pushgateway    NodePort    10.110.174.100   <none>        9091:31787/TCP      146m
redis          ClusterIP   10.110.126.101   <none>        6379/TCP,9121/TCP   3d8h
最后,我们就可以在浏览器中使用 http://<任意节点IP:32169> 来访问 alertmanager这个服务了。
其实,还有一步,那就是要在 Prometheus 中配置下 AlertManager 的地址,让 Prometheus 能够访问到 AlertManager,在 Prometheus 的 ConfigMap 资源清单文件prometheus-cm.yml中添加如下配置:
alerting:
      alertmanagers:
        - static_configs:
           - targets: ["alertmanager:9093"]
接着,重新更新这个资源对象,稍等一会儿,再执行 reload 操作,即可看到相关配置。
最后,就是添加告警规则,同样在 Prometheus 的配置文件中添加如下报警规则配置:
apiVersion: v1
kind: ConfigMap
metadata:
  name: prometheus-config
  namespace: kube-pm
data:
  prometheus.yml: |
    global:
      scrape_interval: 15s
      scrape_timeout: 15s
    alerting:
      alertmanagers:
        - static_configs:
           - targets: ["alertmanager:9093"]
    rule_files:
      - /etc/prometheus/rules.yml
    scrape_configs:
    ...........省略部分内容
  rules.yml: |
    groups:
    - name: 实例存活告警规则
      rules:
       - alert: 实例存活告警
         expr: up == 0
         for: 1m
         labels:
           user: prometheus
           severity: warning
         annotations:
           summary: "主机宕机 !!!"
           description: "该实例主机已经宕机超过一分钟了。"
    - name: 内存报警规则
      rules:
       - alert: 内存使用率告警
         expr: (1 - (node_memory_MemAvailable_bytes / (node_memory_MemTotal_bytes))) * 100 > 80
         for: 1m
         labels:
           severity: warning
         annotations:
           summary: "服务器可用内存不足。"
           value: "触发阈值为80"
           description: "当前值:{{ $value }}%"
这里,添加了实例存活告警和内存使用率告警两个告警规则,注意告警文件的写法。
告警规则配置完成,重新更新这个资源对象,稍等一会儿,再执行 reload 操作,即可在ui页面看到设置的告警规则:
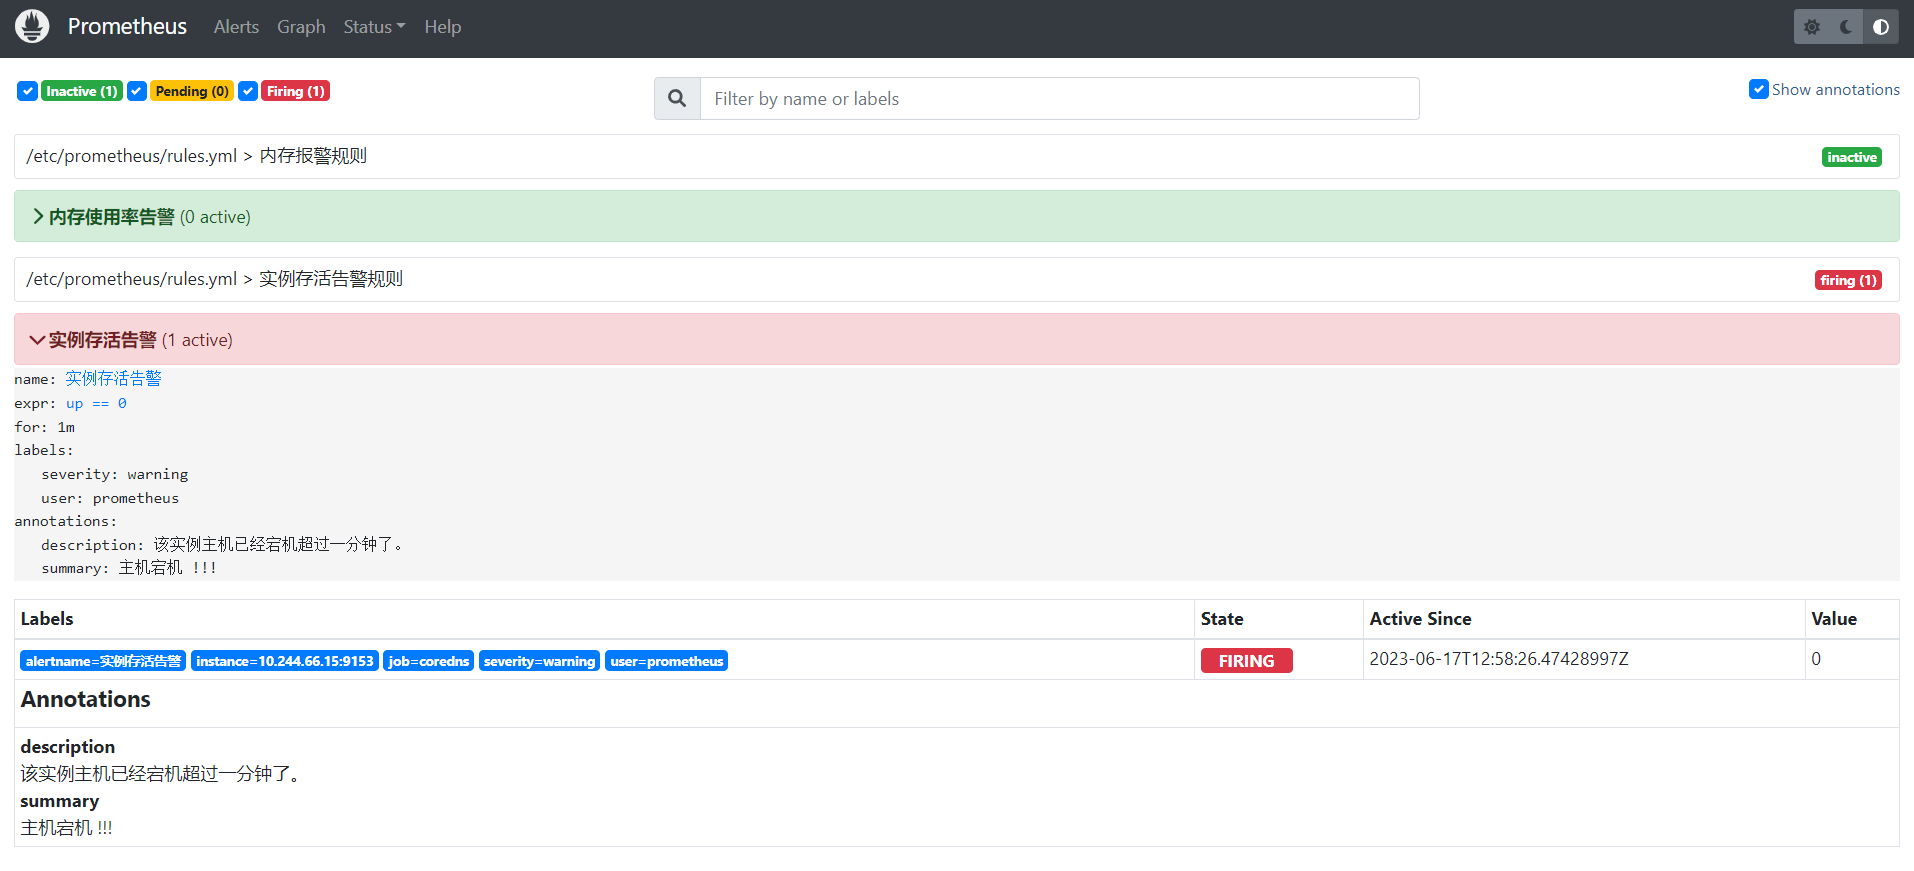
至此,告警配置完成,后面要添加新的告警规则,只需要按照上面介绍的方法依次添加规则即可。
本文提供了详细的YAML配置示例,涵盖了从数据采集、存储、展示到告警的完整监控闭环,为K8s集群运维人员提供了实用的监控解决方案。欢迎评论区交流。
更多推荐


 29
 0
- 0


 已为社区贡献39条内容

所有评论(0)