
12万预算干翻大模型:字节跳动 MMProLong 撕开了“伪长文”的遮羞布
在多模态大模型的竞赛中,支持 100 万甚至 200 万 Token 的上下文窗口似乎已成为“标配”。然而,在实际应用中,面对数百页的 PDF 或复杂的长文档,许多模型依然表现得力不从心——胡说八道、定位失效、检索不到关键信息。
这种空有“大窗口”却无“强检索”的现象,被业内戏称为“伪长文”。
近日,字节跳动 Seed 团队联合香港科技大学发布了 MMProLong 多模态长文档模型,直接颠覆了行业对长上下文训练的传统认知。
令人震惊的并非它支持多长的窗口,而是其实现路径:仅消耗 12.8 万 Token 的极低训练预算,便在 51.2 万 Token 的长文本测试中,全面碾压了 InternVL3-38B、Gemma3-27B 等体量大数倍的模型。
01
一、范式转移:为什么“抄书式”训练失效了?
要理解 MMProLong 的突破,必须先看清传统多模态长文档模型的“死胡同”。
过去,大多数模型提升长文本能力依赖的是 OCR(光学字符识别)转录。逻辑很简单:把文档里的图片、表格全部转录成文本,再让模型进行纯文本训练。
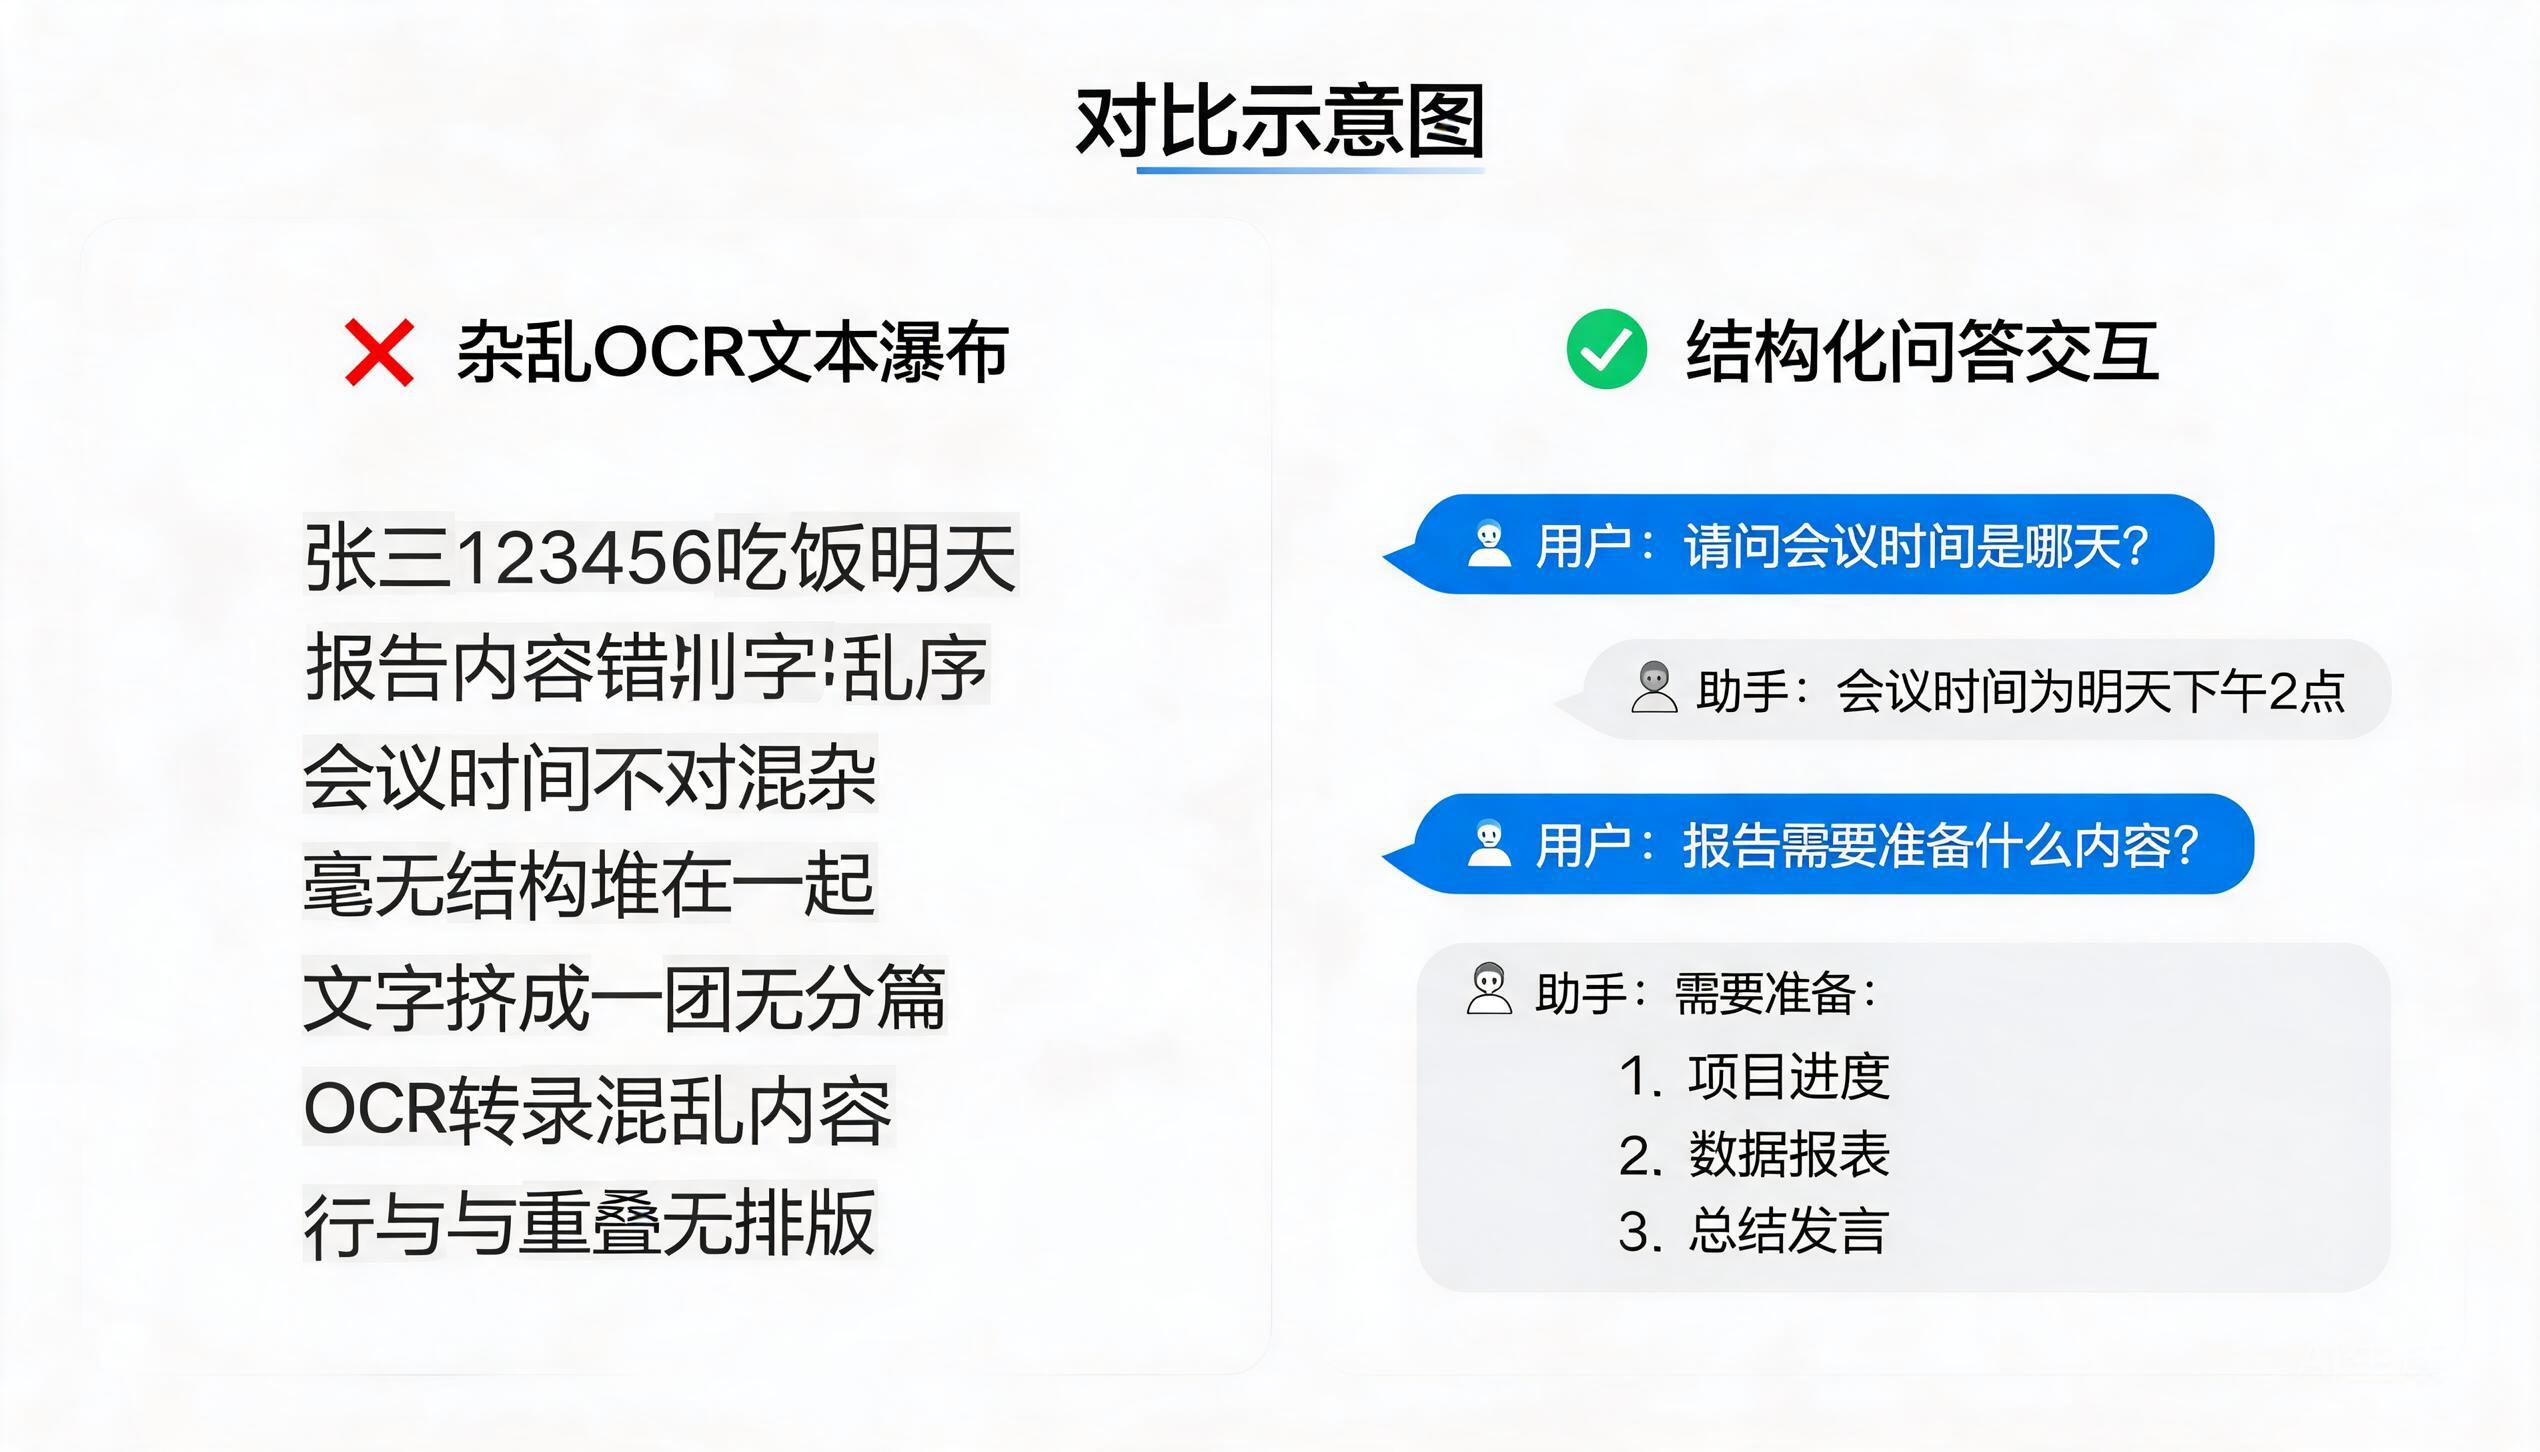
但这就像是训练一个学生去图书馆找资料,你却让他先把馆内所有的书一字不落地抄一遍。实验证明:纯文本转录作为训练任务,不仅不能提升模型的长上下文定位能力,反而会导致性能下降。
模型在海量的转录任务中学会了“复读”,却丢失了对空间布局、跨页关联以及关键细节的敏感度。这就是为什么大模型在面对“大海捞针”测试时,常常在数万字的信息海洋中迷失方向。
02
二、字节的“考试法”:用 QA 问答对重塑数据逻辑
MMProLong 的核心创新在于,它将“抄书”变成了“针对性备考”。
字节团队彻底摒弃了枯燥的 OCR 转录任务,转而利用自家的 Seed2.0 模型,针对长文档生成了大量高质量、细粒度的长上下文问答对(QA)。
这种训练方式的精妙之处在于:
- 引导注意力:通过问题引导模型去文档中主动检索信息,而不是被动灌输。
- 多模态对齐:QA 任务强制模型理解图像内容与文本语境的深度关联,真正实现了“看图说话”到“看图思考”的跨越。
- 极高的数据效能:因为每一组 QA 都是“考点”,模型在极小的训练样本下就能建立起强大的信息定位能力。
03
三、以小博大的奇迹:8B 模型的“超纲”表现
在技术圈,通常认为“参数量决定性能上限”。但 MMProLong 却完成了一次华丽的越级挑战。
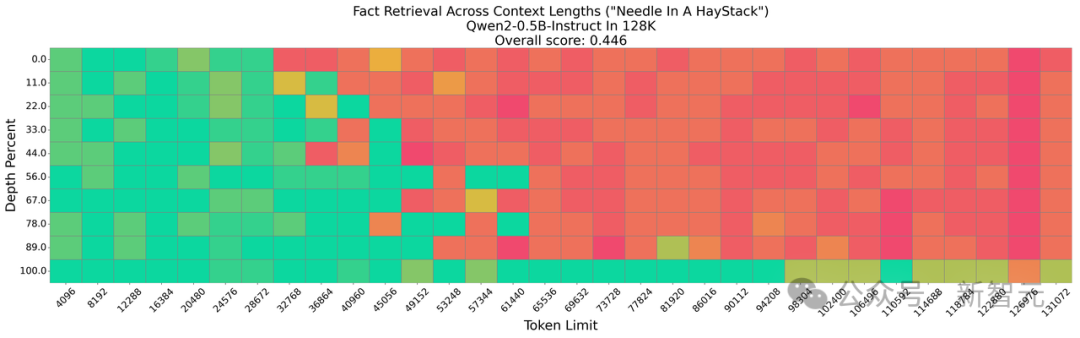
根据 最新发布的研究数据 显示,MMProLong 在 MMLongBench 基准测试中的综合得分,超过了拥有更多参数的 InternVL3-38B。而在 MM-NIAH(大海捞针)测试中,其稳定性更是惊人。
最让人意外的是它的外推能力。大多数模型在输入长度超过训练窗口的 2 倍后,性能会发生断崖式下跌。而 MMProLong 在仅有 128K 的训练窗口下,被拉到 512K(约 38 万字)进行推理,检索准确率依然保持在高位。
这就好比一名平时只练习百米冲刺的选手,在四百米甚至八百米的比赛中,依然能够凭借高效的呼吸调节拿到冠军。这种“超纲”的鲁棒性,证明了数据组织形式对模型潜能的深度挖掘作用。
04
四、路线之争:效率与结构的胜利
MMProLong 的出现,标志着长上下文技术演进进入了“双龙戏珠”的阶段。
一类是以 DeepSeek 为代表的架构改进派,通过改变视觉信息的压缩与排序机制,从底层重构模型。另一类则是字节跳动为代表的数据驱动派,不改动底层架构,通过优化训练数据的结构化水平来实现跨越。
字节的路线显然更具“普适性”与“经济性”。
由于不需要大动架构,这种训练策略理论上可以平移到 Qwen、Llama 等任何现有的开源多模态模型上。它降低了整个行业的技术门槛——企业不再需要堆砌昂贵的算力去硬磕架构,只需通过高质量的数据蒸馏,就能让小模型焕发第二春。
05
结语:AI 的下半场,数据质量重于模型参数
过去两年,我们见证了 AI 行业从“卷参数”到“卷窗口”的盲目竞争。但 MMProLong 的实践告诉我们:窗口的大小固然重要,但在大窗口里精准捕捉信息的能力,才是真正的“技术护城河”。
未来的 AI 竞争,将从“大力出奇迹”转向“精工出细活”。字节跳动通过对问题本质的深刻洞察,用最经济的方式解决了最棘手的行业痛点。这不仅是一次技术创新,更是一场关于“如何让 AI 更聪明地学习”的思维革命。
本文部分图片来源于网络,版权归原作者所有,如有疑问请联系删除。
更多推荐
 9
 0
- 0


 已为社区贡献14条内容

所有评论(0)