
Flink零基础入门,一篇吃透Flink核心概念+本地环境搭建+首个实战程序
前言
在大数据领域,离线计算看Hadoop,实时计算看Flink几乎是行业共识。
日常开发中,用户行为日志、支付订单、直播弹幕、物联网设备数据都是源源不断产生的实时数据,传统离线计算框架只能T+1统计数据,完全无法满足实时大屏、实时风控、实时推荐等业务需求。
而 Apache Flink 作为当下最主流的分布式实时流处理框架,凭借低延迟、高吞吐、 Exactly-Once 精准一次性语义、支持批流一体等优势,已成为互联网、金融、物流行业实时数仓的核心技术。
一、Flink是什么?通俗理解
官方定义:Apache Flink 是一个分布式、高性能、实时的批流统一计算框架,用于对无界(实时流)和有界(离线批)数据流进行状态化计算。
1.1 通俗类比
-
离线计算(Hadoop/Spark Batch):像水库蓄水,攒够一天/一小时数据,统一放水统计,延迟高、实时性差
-
实时计算(Flink):像河流流水,数据来一条处理一条,秒级响应,实时性极强
1.2 核心定位:批流一体
Flink 打破了批处理和流处理的边界:流是本质,批是流的特例。
-
无界流(实时):用户行为、订单数据、设备日志,持续不断产生
-
有界流(离线):历史文件、批量日志,数据有起始和结束
二、Flink 核心优势
2.1 低延迟、高吞吐
基于增量流式计算,数据秒级处理,支持高并发海量数据写入,远超Spark Streaming微批延迟。
2.2 精准一次性语义(Exactly-Once)
这是Flink最核心的杀手锏!通过状态+检查点(Checkpoint)机制,保证数据不丢、不重,金融、支付等对数据一致性要求极高的场景首选。
2.3 天然支持状态计算
支持窗口计算、聚合统计、累计计算等带状态业务,比如统计当日UV、实时销售额、累计访问量。
2.4 丰富的分层API
从底层到高层全覆盖,适配不同开发场景:
-
Process API(底层):极致灵活,自定义复杂逻辑
-
DataStream API(主流):日常实时开发核心API
-
Table API & Flink SQL(高层):类SQL开发,上手简单、效率高
2.5 高可用、容错性强
故障自动重启、状态自动恢复,7*24小时稳定运行,适配生产环境。
三、Flink 核心架构与组件
Flink 分布式架构主要分为四大核心组件,理解这部分就能看懂Flink运行机制。
3.1 JobManager(管理者)
-
集群核心调度中心,全局唯一主节点
-
负责接收任务、解析任务、生成执行计划、分配资源、故障恢复
-
相当于团队的项目经理,负责统筹调度
3.2 TaskManager(工作者)
-
集群工作节点,多节点部署
-
负责真正执行计算任务、缓存数据、维护状态
-
相当于团队的开发人员,负责具体干活
-
核心概念:Slot(任务槽),是TaskManager的资源最小单位,决定并行度
3.3 Client(客户端)
负责提交任务到Flink集群,任务提交后不参与运行,仅负责提交和参数解析。
3.4 WebUI(可视化监控)
默认端口 8081,可实时查看集群状态、任务运行情况、资源占用、日志、报错信息,调试必备。
四、本地环境搭建
4.1 前置环境
-
JDK 8 / JDK11(Flink主流兼容版本)
-
Maven 3.6+
-
Mac/Linux/Windows均可
4.2 下载安装Flink
推荐使用1.18.x稳定版(企业生产主流版本)
官网下载:http://Downloads | Apache Flink
解压安装包:
tar -zxvf flink-1.18.0-bin.tgz cd flink-1.18.04.3 启动本地单机集群
start-cluster.sh启动成功后,访问WebUI:http://localhost:8081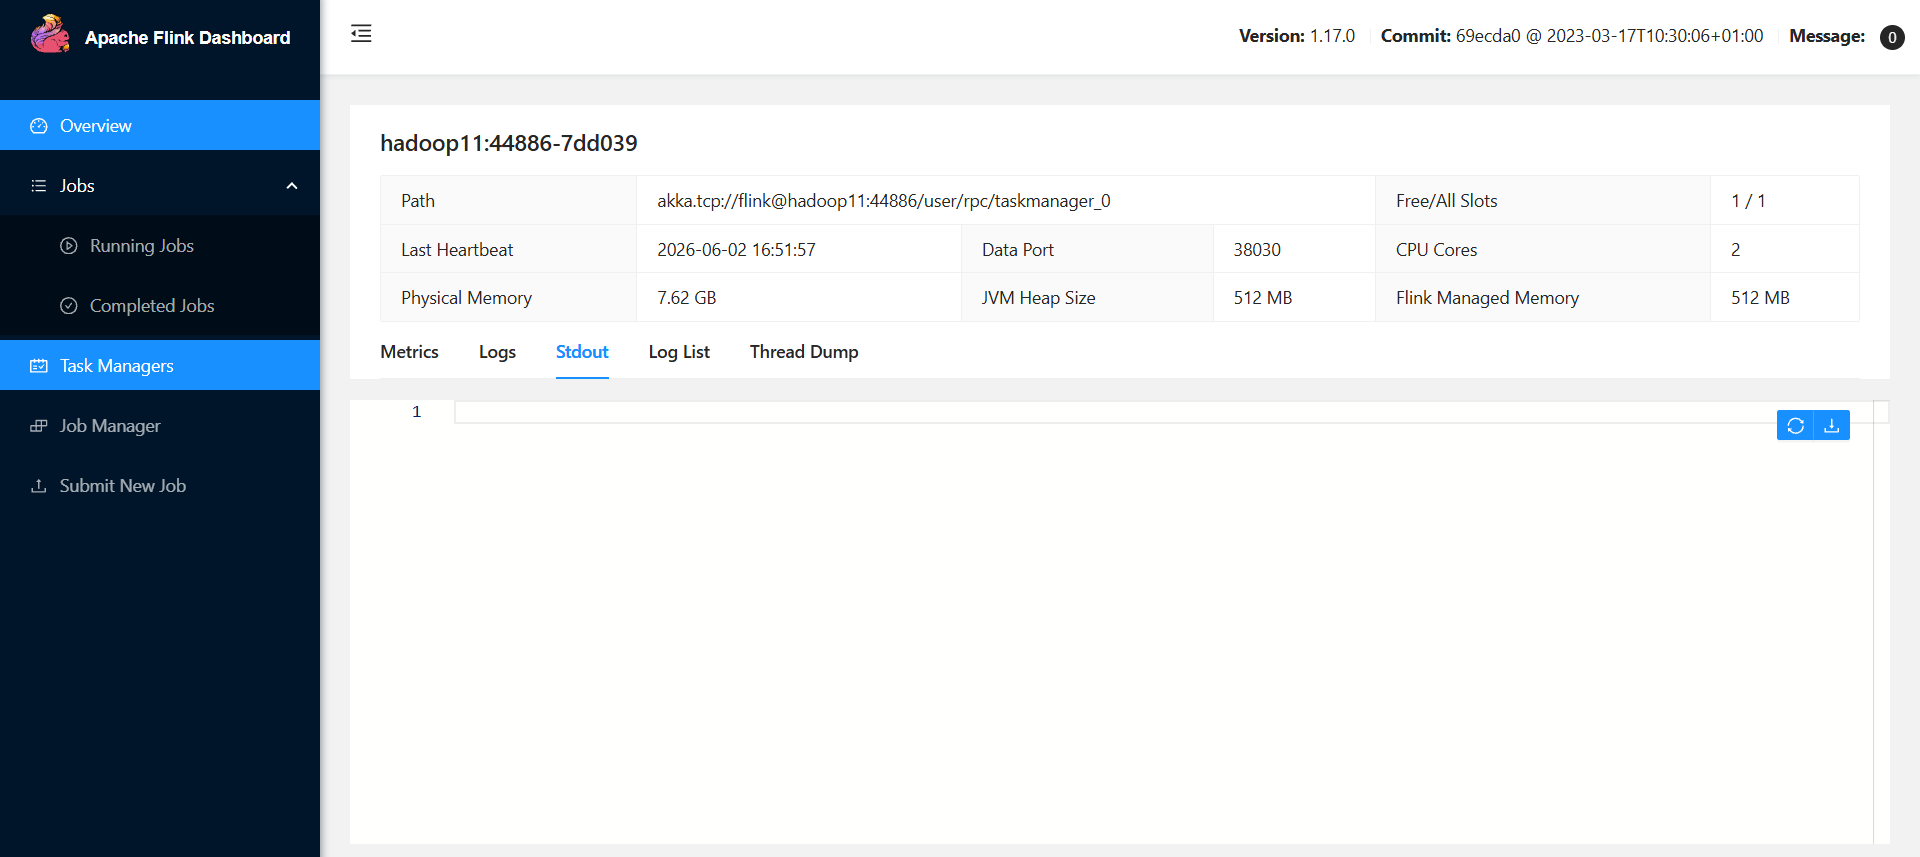
可以看到集群节点、可用资源、任务列表,代表环境搭建成功!
停止集群命令:
stop-cluster.sh五、IDEA项目搭建 + 首个Flink实战程序(WordCount)
我们用最经典的流式WordCount入门,实现:实时读取数据、分词、计数、输出结果。
5.1 Maven核心依赖
新建Maven项目,引入Flink核心依赖(统一版本1.18.0)
<dependencies>
    <!-- Flink 流式计算核心依赖 -->
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-streaming-java</artifactId>
        <version>1.18.0</version>
        <scope>provided</scope>
    </dependency>
    <!-- Flink 客户端依赖 -->
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-clients</artifactId>
        <version>1.18.0</version>
        <scope>provided</scope>
    </dependency>
</dependencies>
5.2 完整实战代码(可直接运行)
本地流式WordCount,监听端口数据,实时统计单词次数
package com.bigdata.day01;

import org.apache.flink.api.common.functions.FlatMapFunction;
import org.apache.flink.api.common.functions.MapFunction;
import org.apache.flink.api.java.functions.KeySelector;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.KeyedStream;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.util.Collector;

public class SocketDemo02 {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        // 监听linux上的socket输入
        DataStreamSource<String> dataStreamSource = env.socketTextStream("hadoop11", 8888);

        SingleOutputStreamOperator<String> flattedMap = dataStreamSource.flatMap(new FlatMapFunction<String, String>() {
            @Override
            public void flatMap(String line, Collector<String> collector) throws Exception {
                String[] arr = line.split(" ");
                for (String word : arr) {
                    collector.collect(word);
                }
            }
        });
        SingleOutputStreamOperator<Tuple2<String, Integer>> map = flattedMap.map(new MapFunction<String, Tuple2<String, Integer>>() {
            @Override
            public Tuple2<String, Integer> map(String word) throws Exception {
                return Tuple2.of(word, 1);
            }
        });

        KeyedStream<Tuple2<String, Integer>, String> keyedStream = map.keyBy(new KeySelector<Tuple2<String, Integer>, String>() {
            @Override
            public String getKey(Tuple2<String, Integer> value) throws Exception {
                return value.f0;
            }
        });

        SingleOutputStreamOperator<Tuple2<String, Integer>> sum = keyedStream.sum(1);

        sum.print();

        env.execute();
    }
}
5.3 运行测试步骤
第一步:开启端口监听
新开终端,启动8888端口数据流:
nc -lk 8888第二步:运行Java程序
启动FlinkWordCount主类,程序会持续监听端口。
第三步:输入测试数据
在nc终端输入内容:
flink java flink bigdata java flink第四步:查看控制台实时统计结果
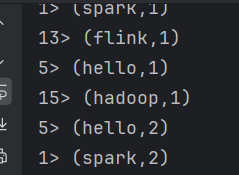
可以看到数据实时累加,每输入一行,实时更新统计结果,真正实现来一条处理一条!
六、Flink核心运行机制(新手必懂)
6.1 惰性执行机制
Flink所有转换操作都是懒加载,代码执行到 env.execute() 才会真正触发任务运行,前面只是构建执行拓扑图。
6.2 编程通用流程
所有Flink流式程序,都遵循固定五步法:
-
获取流执行环境
StreamExecutionEnvironment -
读取数据源(文件、端口、Kafka、数据库)
-
数据转换处理(flatMap、filter、keyBy、sum等)
-
数据输出(打印、写入Kafka、MySQL、Hive)
-
触发任务执行
env.execute()
6.3 并行度机制
并行度决定任务执行线程数,可在三个层级设置:
-
代码级别:
env.setParallelism()(优先级最高) -
提交任务级别:命令行指定并行度
-
集群默认配置级别(优先级最低)
七、Flink常见应用场景
学完基础,了解企业真实落地场景,明确学习方向:
-
实时大屏:电商实时销售额、实时UV、订单量统计
-
实时风控:金融刷单、盗刷、异常交易实时拦截
-
实时推荐:根据用户实时行为调整推荐内容
-
实时数仓:替代离线数仓,实现秒级数据更新
-
日志实时分析:运维日志、业务日志实时监控告警
-
物联网实时计算:设备数据实时采集、清洗、统计
八、新手避坑总结
-
忘记execute():不写执行方法,任务不会运行,新手最高频错误
-
并行度过高:本地测试建议设置并行度为1,避免输出日志混乱
-
端口占用:8888端口被占用可更换其他端口,保证代码与监听端口一致
-
版本不兼容:依赖版本和集群版本必须统一,否则报类找不到异常
九、总结与后续学习路线
本文我们从零入门Flink,掌握了:
-
Flink核心定位、优势、批流一体思想
-
集群核心组件架构与运行原理
-
本地环境搭建、集群启停、WebUI使用
-
完整流式WordCount实战,掌握Flink编程五步法
更多推荐


 5
 0
- 0


 已为社区贡献5条内容

所有评论(0)