
从ResNet到YOLOv11:深度学习如何让计算机“看懂“图像?
·
从ResNet到YOLOv11:深度学习如何让计算机"看懂"图像?
上一篇我们学习了ResNet,理解了深度学习的基础。这一篇我们来看看ResNet的思想如何应用到实际任务中——以YOLOv11为例,了解目标检测的奥秘。
一、回顾ResNet:我们学到了什么?
1.1 ResNet的核心思想
传统网络:学习完整的映射 H(x)
ResNet:学习残差 F(x) = H(x) - x,输出 F(x) + x

关键创新:跳跃连接(Skip Connection)
作用:解决深层网络的梯度消失问题
1.2 ResNet的结构
输入 x
  │
  ├─────────────────┐
  ↓                 │
Conv → BN → ReLU    │
  ↓                 │
Conv → BN           │
  ↓                 │
  ⊕ ←───────────────┘
  ↓
ReLU
  ↓
输出
1.3 ResNet的影响
ResNet不仅是一个分类网络,它的思想影响了后续几乎所有深度学习模型:
| 网络 | 应用 | 借鉴ResNet的地方 |
|---|---|---|
| FPN | 特征金字塔 | 多尺度特征融合 |
| U-Net | 图像分割 | 跳跃连接 |
| YOLO | 目标检测 | Backbone特征提取 |
| PointNet | 点云处理 | 残差思想 |
今天,我们来看看YOLOv11如何借鉴ResNet的思想。
二、什么是目标检测?(先搞懂任务)
2.1 图像分类 vs 目标检测
图像分类(ResNet做的):
输入:一张图像
输出:一个类别标签

例子:
输入:猫的照片
输出:这是"猫"(概率95%)
目标检测(YOLO做的):
输入:一张图像
输出:多个物体的位置和类别

例子:
输入:街景照片
输出:
- 这里有一辆车(位置:[100, 200, 300, 400],类别:汽车,概率98%)
- 这里有一个人(位置:[500, 100, 600, 500],类别:行人,概率95%)
- 这里有一辆车(位置:[700, 300, 900, 500],类别:汽车,概率92%)
2.2 目标检测的输出格式
每个检测结果包含:
1. 边界框(Bounding Box):[x1, y1, x2, y2]
   - (x1, y1):左上角坐标
   - (x2, y2):右下角坐标

2. 类别(Class):汽车、行人、自行车等

3. 置信度(Confidence):0-100%,表示有多确定

例子:
{
    "bbox": [100, 200, 300, 400],
    "class": "car",
    "confidence": 0.98
}
2.3 目标检测的应用
| 领域 | 应用 | 例子 |
|---|---|---|
| 自动驾驶 | 车辆行人检测 | 检测周围的车、人、交通标志 |
| 安防监控 | 异常行为检测 | 检测入侵、遗留物 |
| 医学影像 | 病灶检测 | 检测肿瘤、病变 |
| 工业质检 | 缺陷检测 | 检测产品缺陷 |
| 零售分析 | 客流统计 | 统计顾客数量 |
2.4 目标检测的挑战
1. 多尺度问题
   - 远处的车很小(20×20像素)
   - 近处的车很大(200×200像素)
   - 网络需要同时检测大小物体

2. 密集目标
   - 一群人站在一起
   - 物体相互遮挡
   - 需要准确区分每个物体

3. 实时性要求
   - 自动驾驶需要实时检测
   - 每秒处理30帧以上
   - 速度和精度要平衡
三、YOLO系列发展历史(了解背景)
3.1 目标检测的两大流派
两阶段检测器(Two-Stage):
第一阶段:生成候选区域(Region Proposals)
第二阶段:对候选区域分类和回归

代表:R-CNN系列(R-CNN → Fast R-CNN → Faster R-CNN)

优点:精度高
缺点:速度慢
单阶段检测器(One-Stage):
直接在图像上预测边界框和类别
不需要候选区域生成

代表:YOLO系列、SSD

优点:速度快
缺点:早期版本精度较低
3.2 YOLO的发展历程
YOLOv1 (2016)
    │
    ↓ 开创性的单阶段检测
YOLOv2 (2017)
    │
    ↓ 引入Anchor Box
YOLOv3 (2018)
    │
    ↓ 多尺度检测
YOLOv4 (2020)
    │
    ↓ 大量技巧集成
YOLOv5 (2020)
    │
    ↓ 工程化优化,PyTorch实现
YOLOv8 (2023)
    │
    ↓ 解耦头,Anchor-Free
YOLOv11 (2024)
    │
    ↓ 更高效的架构
3.3 为什么叫YOLO?
YOLO = You Only Look Once
传统方法:看很多次
- 滑动窗口:在图像上滑动几千次
- 候选区域:先找可能有物体的地方,再分类

YOLO:只看一次
- 把图像分成网格
- 每个网格直接预测
- 一次前向传播得到所有结果

类比:
传统方法:用放大镜一个区域一个区域扫描
YOLO:用眼睛扫一眼,同时看到所有东西
四、YOLOv11的网络架构(核心内容)
4.1 整体架构:Backbone-Neck-Head
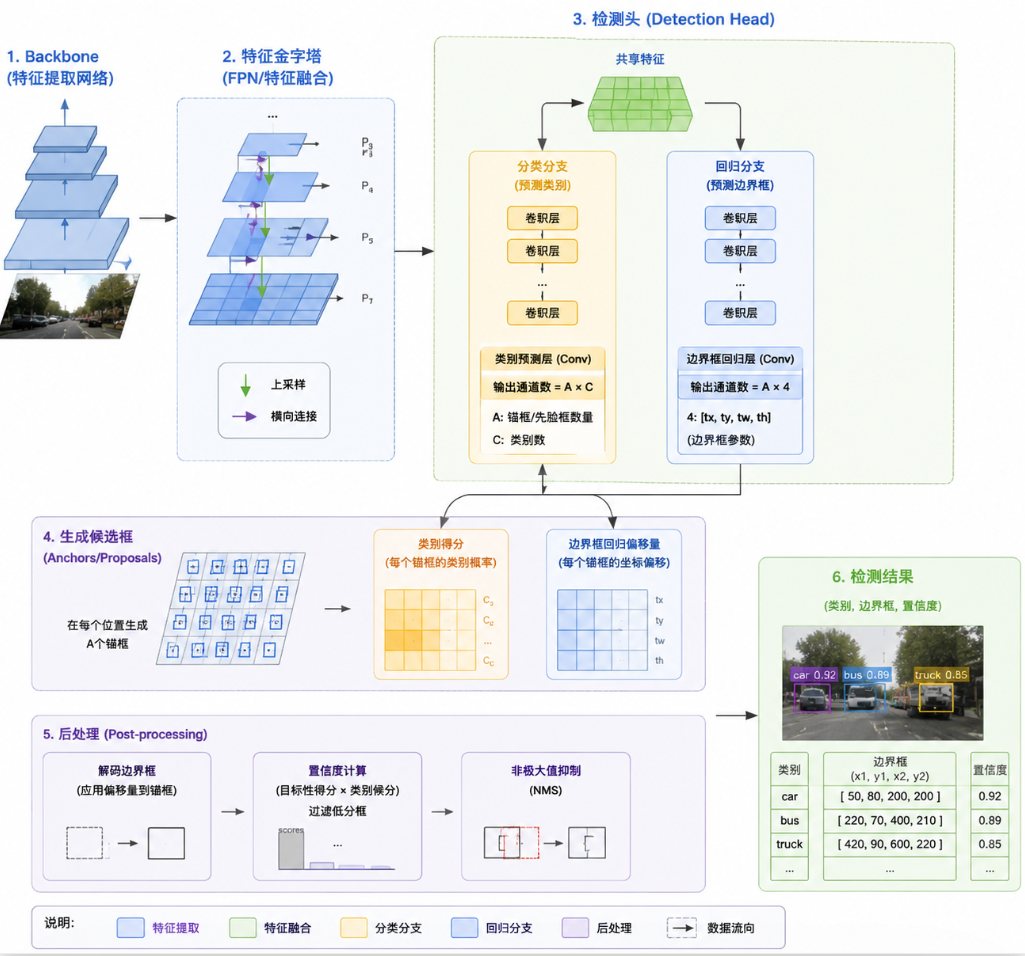
输入图像
    │
    ↓
┌─────────────────────────────────────┐
│           Backbone(骨干网络)        │
│    提取图像特征                      │
│    类似ResNet的作用                  │
└─────────────────────────────────────┘
    │
    ↓
┌─────────────────────────────────────┐
│           Neck(颈部网络)           │
│    融合多尺度特征                    │
│    连接Backbone和Head               │
└─────────────────────────────────────┘
    │
    ↓
┌─────────────────────────────────────┐
│           Head(检测头)             │
│    预测边界框和类别                  │
│    输出最终检测结果                  │
└─────────────────────────────────────┘
    │
    ↓
检测结果:[边界框, 类别, 置信度]
4.2 Backbone:特征提取(借鉴ResNet)
Backbone的作用:
输入:原始图像 [H, W, 3]
输出:多尺度特征图

特征图大小:
- P1: H/2 × W/2    (浅层,细节特征)
- P2: H/4 × W/4
- P3: H/8 × W/8    (中层)
- P4: H/16 × W/16
- P5: H/32 × W/32  (深层,语义特征)
YOLOv11的Backbone结构:
输入图像 [640×640×3]
    │
    ↓
┌─────────────────┐
│ Conv 3×3, stride=2 │  → [320×320×16]
└─────────────────┘
    │
    ↓
┌─────────────────┐
│ Conv 3×3, stride=2 │  → [160×160×32]
└─────────────────┘
    │
    ↓
┌─────────────────┐
│ C3k2 Block      │  → [160×160×64]
│ (类似ResNet残差块) │
└─────────────────┘
    │
    ↓
┌─────────────────┐
│ Conv 3×3, stride=2 │  → [80×80×128]
└─────────────────┘
    │
    ↓
┌─────────────────┐
│ C3k2 Block ×3   │  → [80×80×128]
└─────────────────┘
    │
    ↓
┌─────────────────┐
│ Conv 3×3, stride=2 │  → [40×40×256]
└─────────────────┘
    │
    ↓
┌─────────────────┐
│ C3k2 Block ×3   │  → [40×40×256]
└─────────────────┘
    │
    ↓
┌─────────────────┐
│ Conv 3×3, stride=2 │  → [20×20×512]
└─────────────────┘
    │
    ↓
┌─────────────────┐
│ C3k2 Block      │  → [20×20×512]
└─────────────────┘
    │
    ↓
┌─────────────────┐
│ SPPF            │  → [20×20×512]
│ (空间金字塔池化)   │
└─────────────────┘
    │
    ↓
┌─────────────────┐
│ C2PSA           │  → [20×20×512]
│ (注意力机制)      │
└─────────────────┘
4.3 C3k2 Block:YOLOv11的核心模块
C3k2是什么?
C3 = Cross-Stage Partial (跨阶段部分连接)
k2 = 双kernel大小 (1×1和3×3)

类比ResNet:
- ResNet用残差块
- YOLOv11用C3k2块

两者都用跳跃连接解决梯度消失!
C3k2的结构:
输入
  │
  ├──────────────────────────────┐
  ↓                              │
┌─────────────────┐              │
│ Conv 1×1        │  ← 分支1     │
│ (降低通道数)      │              │
└─────────────────┘              │
  │                              │
  ↓                              │
┌─────────────────┐              │
│ Conv 3×3        │              │
│ (特征提取)       │              │
└─────────────────┘              │
  │                              │
  ├──────────────────────────────┤
  │                              │
  ↓                              ↓
┌─────────────────┐              │
│ Conv 1×1        │              │
│ (降低通道数)      │              │
└─────────────────┘              │
  │                              │
  ↓                              │
┌─────────────────┐              │
│ Conv 3×3        │              │
│ (特征提取)       │              │
└─────────────────┘              │
  │                              │
  ↓                              │
Concat(拼接)←───────────────────┘
  │
  ↓
Conv 1×1(融合)
  │
  ↓
输出
为什么叫"跨阶段部分连接"?
输入分成两部分:
- 一部分直接传到输出(跳跃连接)
- 一部分经过卷积处理

最后拼接两部分

好处:
- 减少计算量(只处理一部分)
- 保持梯度流动(跳跃连接)
4.4 SPPF:空间金字塔池化
SPPF的作用:
输入:20×20×512的特征图
输出:同样大小,但融合了不同尺度的信息

原理:
用不同大小的池化核提取特征
- 5×5 最大池化
- 9×9 最大池化
- 13×13 最大池化

然后拼接所有特征
代码实现:
class SPPF(nn.Module):
    """空间金字塔池化 - 快速版本"""

    def __init__(self, c1, c2, k=5):
        """
        c1: 输入通道数
        c2: 输出通道数
        k: 池化核大小
        """
        super().__init__()
        c_ = c1 // 2  # 隐藏层通道数

        # 1×1卷积降低通道数
        self.cv1 = Conv(c1, c_, 1, 1)

        # 最大池化
        self.m = nn.MaxPool2d(kernel_size=k, stride=1, padding=k // 2)

        # 1×1卷积融合
        self.cv2 = Conv(c_ * 4, c2, 1, 1)

    def forward(self, x):
        x = self.cv1(x)           # [B, c_, H, W]

        y1 = self.m(x)            # [B, c_, H, W]
        y2 = self.m(y1)           # [B, c_, H, W]
        y3 = self.m(y2)           # [B, c_, H, W]

        # 拼接所有特征
        return self.cv2(torch.cat([x, y1, y2, y3], 1))
4.5 C2PSA:注意力机制
什么是注意力机制?
人类视觉:自动聚焦重要区域
- 看照片时,眼睛会自动看向人脸、文字等重要区域
- 忽略背景、天空等不重要的区域

注意力机制:让网络也学会"聚焦"
- 自动学习哪些特征重要
- 给重要特征更大的权重
C2PSA的结构:
输入
  │
  ├──────────────────────────────┐
  ↓                              │
┌─────────────────┐              │
│ Conv 1×1        │              │
└─────────────────┘              │
  │                              │
  ↓                              │
┌─────────────────┐              │
│ PSA注意力模块     │              │
│ (学习关注哪里)    │              │
└─────────────────┘              │
  │                              │
  ↓                              │
┌─────────────────┐              │
│ Conv 1×1        │              │
└─────────────────┘              │
  │                              │
  ↓                              │
Concat(拼接)←───────────────────┘
  │
  ↓
Conv 1×1(融合)
  │
  ↓
输出
PSA注意力模块:
class PSA(nn.Module):
    """位置敏感注意力模块"""

    def __init__(self, c1, c2):
        super().__init__()

        # 通道注意力
        self.channel_attn = nn.Sequential(
            nn.AdaptiveAvgPool2d(1),
            nn.Conv2d(c1, c1 // 16, 1),
            nn.ReLU(),
            nn.Conv2d(c1 // 16, c1, 1),
            nn.Sigmoid()
        )

        # 空间注意力
        self.spatial_attn = nn.Sequential(
            nn.Conv2d(2, 1, 7, padding=3),
            nn.Sigmoid()
        )

    def forward(self, x):
        # 通道注意力
        channel_attn = self.channel_attn(x)
        x = x * channel_attn

        # 空间注意力
        avg_out = torch.mean(x, dim=1, keepdim=True)
        max_out, _ = torch.max(x, dim=1, keepdim=True)
        spatial_attn = self.spatial_attn(torch.cat([avg_out, max_out], dim=1))
        x = x * spatial_attn

        return x
4.6 Neck:特征融合(FPN+PAN)
为什么需要特征融合?
浅层特征(P1, P2):
- 分辨率高,细节丰富
- 适合检测小物体
- 但语义信息少

深层特征(P4, P5):
- 分辨率低,细节少
- 语义信息丰富
- 适合检测大物体

问题:如何同时检测大小物体?
答案:融合多尺度特征!
FPN(特征金字塔):
P5 (20×20) ──────────────────→ 输出5
  │
  ↓ 上采样
  │
P4 (40×40) ──────────────────→ 输出4
  │
  ↓ 上采样
  │
P3 (80×80) ──────────────────→ 输出3
  │
  ↓ 上采样
  │
P2 (160×160) ─────────────────→ 输出2

FPN:从上到下,把深层语义信息传递给浅层
PAN(路径聚合网络):
输出2 ←──────────────────── P2 (160×160)
  │
  ↓ 下采样
  │
输出3 ←──────────────────── P3 (80×80)
  │
  ↓ 下采样
  │
输出4 ←──────────────────── P4 (40×40)
  │
  ↓ 下采样
  │
输出5 ←──────────────────── P5 (20×20)

PAN:从下到上,把浅层位置信息传递给深层
YOLOv11的Neck:FPN + PAN:
P5 ─────────────────────────────────────→ 输出5
  │                                     ↑
  ↓ 上采样                              │
  │                                     │
P4 ─────────────────────────────────────→ 输出4
  │          ↑                          ↑
  ↓ 上采样   │ 下采样                   │
  │          │                          │
P3 ─────────────────────────────────────→ 输出3
  │          ↑                          ↑
  ↓ 上采样   │ 下采样                   │
  │          │                          │
P2 ─────────────────────────────────────→ 输出2

双向融合:既传递语义信息,又传递位置信息
4.7 Head:检测头
YOLOv11的解耦头:
特征图
  │
  ├─────────────────┐
  ↓                 │
┌─────────────┐     │
│ 分类分支      │     │
│ (预测类别)    │     │
└─────────────┘     │
                    │
  ↓                 │
┌─────────────┐     │
│ 回归分支      │     │
│ (预测边界框)  │     │
└─────────────┘     │
                    │
  ↓                 ↓
  ┌─────────────────┐
  │   检测结果       │
  │ [类别, 边界框]   │
  └─────────────────┘
为什么用解耦头?
耦合头(早期YOLO):
- 一个分支同时预测类别和边界框
- 两个任务互相干扰

解耦头(YOLOv11):
- 分类和回归分开
- 各自独立优化
- 精度更高
五、ResNet与YOLOv11的对比(核心内容)
5.1 共同点
| 方面 | ResNet | YOLOv11 | 共同点 |
|---|---|---|---|
| 残差连接 | ✓ | ✓ | 都用跳跃连接解决梯度消失 |
| BatchNorm | ✓ | ✓ | 都用BN加速训练 |
| ReLU激活 | ✓ | ✓ | 都用ReLU引入非线性 |
| 深层网络 | ✓ | ✓ | 都可以训练很深的网络 |
| 特征提取 | ✓ | ✓ | 都是骨干网络的一部分 |
5.2 不同点
| 方面 | ResNet | YOLOv11 |
|---|---|---|
| 任务 | 图像分类 | 目标检测 |
| 输出 | 一个类别标签 | 多个边界框+类别 |
| 结构 | 单一骨干网络 | Backbone+Neck+Head |
| 多尺度 | 不需要 | 必须处理多尺度 |
| 实时性 | 不要求 | 必须实时 |
| 应用场景 | 通用分类 | 自动驾驶、安防等 |
5.3 架构对比图
ResNet:
输入图像 → Backbone → 全局池化 → 分类头 → 类别
           [ResNet]

YOLOv11:
输入图像 → Backbone → Neck → Head → 检测结果
           [C3k2]    [FPN   [解耦头]
                      +PAN]
5.4 详细对比:残差块 vs C3k2块
ResNet的残差块:
输入 x
  │
  ├─────────────────┐
  ↓                 │
Conv 3×3 → BN → ReLU
  ↓                 │
Conv 3×3 → BN       │
  ↓                 │
  ⊕ ←───────────────┘
  ↓
ReLU
  ↓
输出

特点:
- 两层卷积
- 跳跃连接
- 简单有效
YOLOv11的C3k2块:
输入
  │
  ├──────────────────────────────┐
  ↓                              │
Conv 1×1 → Conv 3×3              │
  │                              │
  ├──────────────────────────────┤
  │                              │
  ↓                              │
Conv 1×1 → Conv 3×3              │
  │                              │
  ↓                              │
Concat ←─────────────────────────┘
  │
  ↓
Conv 1×1
  │
  ↓
输出

特点:
- 多分支结构
- 跨阶段连接
- 更高效的特征复用
5.5 共同的设计哲学
1. 层次化特征提取
ResNet:
浅层 → 中层 → 深层
(边缘)  (形状)  (物体)

YOLOv11 Backbone:
浅层 → 中层 → 深层
(细节)  (中层)  (语义)
2. 跳跃连接解决梯度消失
# ResNet
output = conv(x) + x  # 残差连接

# YOLOv11 C3k2
output = concat(branch1, branch2)  # 跨阶段连接

# 本质相同:让梯度有"高速公路"
3. 渐进式特征抽象
第1层:学习简单特征(边缘、纹理)
第2层:学习中等特征(形状、图案)
第3层:学习复杂特征(物体部件)
第4层:学习高级语义(整个物体)
六、代码实现对比
6.1 ResNet的残差块
class ResidualBlock(nn.Module):
    """ResNet的残差块"""

    def __init__(self, in_channels, out_channels, stride=1):
        super().__init__()

        # 主路径
        self.conv1 = nn.Conv2d(in_channels, out_channels, 3, stride, 1, bias=False)
        self.bn1 = nn.BatchNorm2d(out_channels)
        self.relu = nn.ReLU(inplace=True)

        self.conv2 = nn.Conv2d(out_channels, out_channels, 3, 1, 1, bias=False)
        self.bn2 = nn.BatchNorm2d(out_channels)

        # 跳跃连接
        self.shortcut = nn.Sequential()
        if stride != 1 or in_channels != out_channels:
            self.shortcut = nn.Sequential(
                nn.Conv2d(in_channels, out_channels, 1, stride, bias=False),
                nn.BatchNorm2d(out_channels)
            )

    def forward(self, x):
        # 主路径
        out = self.relu(self.bn1(self.conv1(x)))
        out = self.bn2(self.conv2(out))

        # 跳跃连接
        out += self.shortcut(x)
        out = self.relu(out)

        return out
6.2 YOLOv11的C3k2块
class C3k2(nn.Module):
    """YOLOv11的C3k2块"""

    def __init__(self, c1, c2, n=1, shortcut=True):
        """
        c1: 输入通道数
        c2: 输出通道数
        n: 重复次数
        shortcut: 是否使用跳跃连接
        """
        super().__init__()
        c_ = c2 // 2  # 隐藏层通道数

        # 两个分支
        self.cv1 = Conv(c1, c_, 1, 1)  # 分支1:1×1卷积
        self.cv2 = Conv(c1, c_, 1, 1)  # 分支2:1×1卷积

        # 分支2的后续处理
        self.m = nn.Sequential(
            *[Bottleneck(c_, c_, shortcut) for _ in range(n)]
        )

        # 融合
        self.cv3 = Conv(c2, c2, 1, 1)

    def forward(self, x):
        # 分支1:直接传递
        y1 = self.cv1(x)

        # 分支2:经过Bottleneck
        y2 = self.m(self.cv2(x))

        # 拼接并融合
        return self.cv3(torch.cat([y1, y2], 1))

class Bottleneck(nn.Module):
    """Bottleneck块"""

    def __init__(self, c1, c2, shortcut=True):
        super().__init__()

        self.cv1 = Conv(c1, c2, 1, 1)  # 1×1卷积
        self.cv2 = Conv(c2, c2, 3, 1)  # 3×3卷积

        self.shortcut = shortcut and c1 == c2

    def forward(self, x):
        if self.shortcut:
            return x + self.cv2(self.cv1(x))  # 残差连接!
        else:
            return self.cv2(self.cv1(x))
关键发现:YOLOv11的Bottleneck也用了残差连接!
6.3 YOLOv11的Backbone
class YOLOv11Backbone(nn.Module):
    """YOLOv11的Backbone"""

    def __init__(self):
        super().__init__()

        # 初始卷积层
        self.stem = nn.Sequential(
            Conv(3, 16, 3, 2),    # 640→320
            Conv(16, 32, 3, 2),   # 320→160
            C3k2(32, 64),         # 160×160×64
        )

        # 4个阶段
        self.stage1 = nn.Sequential(
            Conv(64, 128, 3, 2),  # 160→80
            C3k2(128, 128, n=3),  # 80×80×128
        )

        self.stage2 = nn.Sequential(
            Conv(128, 256, 3, 2), # 80→40
            C3k2(256, 256, n=3),  # 40×40×256
        )

        self.stage3 = nn.Sequential(
            Conv(256, 512, 3, 2), # 40→20
            C3k2(512, 512),       # 20×20×512
        )

        # SPPF + 注意力
        self.sppf = SPPF(512, 512)
        self.c2psa = C2PSA(512, 512)

    def forward(self, x):
        # 初始层
        x = self.stem(x)         # [B, 64, 160, 160]

        # 4个阶段
        p2 = self.stage1(x)      # [B, 128, 80, 80]
        p3 = self.stage2(p2)     # [B, 256, 40, 40]
        p4 = self.stage3(p3)     # [B, 512, 20, 20]

        # SPPF + 注意力
        p5 = self.c2psa(self.sppf(p4))  # [B, 512, 20, 20]

        return [p2, p3, p4, p5]  # 返回多尺度特征
6.4 YOLOv11的完整网络
class YOLOv11(nn.Module):
    """完整的YOLOv11网络"""

    def __init__(self, num_classes=80):
        super().__init__()

        # Backbone
        self.backbone = YOLOv11Backbone()

        # Neck (FPN + PAN)
        self.neck = YOLOv11Neck()

        # Head (解耦头)
        self.head = YOLOv11Head(num_classes)

    def forward(self, x):
        # Backbone提取特征
        features = self.backbone(x)  # [p2, p3, p4, p5]

        # Neck融合特征
        fused_features = self.neck(features)  # [f2, f3, f4, f5]

        # Head预测
        predictions = self.head(fused_features)

        return predictions
七、YOLOv11的创新点
7.1 C3k2 vs C2f(YOLOv8)
YOLOv8的C2f:
输入 → Conv 1×1 → 分支1 + 分支2 → Conv 1×1 → 输出

YOLOv11的C3k2:
输入 → Conv 1×1 → 分支1 + 分支2 → Conv 1×1 → 输出
                    ↑
                    使用双kernel(1×1和3×3)

改进:
- 更高效的特征提取
- 参数量减少22%
- 精度保持或提升
7.2 C2PSA注意力机制
YOLOv8:没有注意力
YOLOv11:加入了C2PSA

作用:
- 自动学习重要特征
- 抑制不重要的特征
- 提高检测精度
7.3 Anchor-Free设计
传统YOLO(YOLOv3及以前):
- 预定义Anchor Box(先验框)
- 预测相对于Anchor的偏移

YOLOv11:
- 不需要预定义Anchor
- 直接预测边界框坐标
- 更简单,更灵活
Anchor-Free的优势:
# Anchor-Based(传统)
# 需要预定义:
anchors = [[10,13], [16,30], [33,23],  # 小物体
           [30,61], [62,45], [59,119], # 中物体
           [116,90], [156,198], [373,326]] # 大物体

# Anchor-Free(YOLOv11)
# 直接预测:
output = {
    "bbox": [x1, y1, x2, y2],  # 直接预测坐标
    "class": [0.1, 0.9, ...],   # 类别概率
}
八、实战:YOLOv11检测示例
8.1 使用Ultralytics库
from ultralytics import YOLO

# 加载预训练模型
model = YOLO("yolo11n.pt")  # nano版本,最快

# 或者更大的模型
# model = YOLO("yolo11s.pt")  # small
# model = YOLO("yolo11m.pt")  # medium
# model = YOLO("yolo11l.pt")  # large
# model = YOLO("yolo11x.pt")  # extra large

# 推理
results = model("image.jpg")

# 解析结果
for result in results:
    boxes = result.boxes  # 边界框
    for box in boxes:
        # 边界框坐标
        x1, y1, x2, y2 = box.xyxy[0].tolist()

        # 类别和置信度
        cls = int(box.cls[0])
        conf = float(box.conf[0])

        # 类别名称
        class_name = model.names[cls]

        print(f"{class_name}: {conf:.2f} at [{x1:.0f}, {y1:.0f}, {x2:.0f}, {y2:.0f}]")
8.2 模型变体对比
| 模型 | 参数量 | mAP50-95 | 速度(ms) | 应用场景 |
|---|---|---|---|---|
| YOLO11n | 2.6M | 39.5 | 1.5 | 移动端、实时检测 |
| YOLO11s | 9.4M | 47.0 | 2.5 | 边缘设备 |
| YOLO11m | 20.1M | 51.5 | 4.5 | 服务器端 |
| YOLO11l | 25.3M | 53.4 | 6.0 | 高精度需求 |
| YOLO11x | 56.9M | 54.7 | 10.0 | 极致精度 |
8.3 训练自定义数据集
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo11n.pt")

# 训练
results = model.train(
    data="coco128.yaml",  # 数据集配置
    epochs=100,           # 训练轮数
    imgsz=640,            # 图像大小
    batch=16,             # 批次大小
    device=0,             # GPU编号
)

# 验证
metrics = model.val()
print(f"mAP50-95: {metrics.box.map:.4f}")
8.4 导出和部署
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo11n.pt")

# 导出为ONNX格式
model.export(format="onnx")

# 导出为TensorRT格式(NVIDIA GPU)
model.export(format="engine")

# 导出为CoreML格式(Apple设备)
model.export(format="coreml")
九、YOLOv11在3D占用感知中的应用
9.1 从2D检测到3D占用
YOLOv11:2D目标检测
- 输入:单张图像
- 输出:2D边界框

3D占用感知:
- 输入:多视角图像或点云
- 输出:3D占用网格

联系:
YOLOv11的Backbone可以用于提取2D特征
然后将2D特征提升到3D空间
9.2 结合ResNet和YOLOv11
class OccupancyNetwork(nn.Module):
    """基于YOLOv11的3D占用预测网络"""

    def __init__(self, num_classes=16):
        super().__init__()

        # 使用YOLOv11的Backbone提取2D特征
        self.backbone = YOLOv11Backbone()

        # 2D到3D的提升
        self.lift = nn.Sequential(
            nn.Linear(512, 256),
            nn.ReLU(),
            nn.Linear(256, 128),
        )

        # 3D卷积处理
        self.conv3d = nn.Sequential(
            nn.Conv3d(128, 64, 3, padding=1),
            nn.BatchNorm3d(64),
            nn.ReLU(),
        )

        # 占用预测头
        self.occ_head = nn.Sequential(
            nn.Conv3d(64, 32, 3, padding=1),
            nn.BatchNorm3d(32),
            nn.ReLU(),
            nn.Conv3d(32, num_classes, 1),
        )

    def forward(self, images):
        """
        images: [B, N, 3, H, W] - 多视角图像
        返回: [B, X, Y, Z, num_classes] - 3D占用预测
        """
        B, N = images.shape[:2]

        # 提取2D特征
        features = []
        for i in range(N):
            feat = self.backbone(images[:, i])  # [B, C, H, W]
            features.append(feat)

        # 2D到3D提升(简化示意)
        # 实际会用更复杂的几何变换
        features_3d = self.lift_and_splat(features)  # [B, C, X, Y, Z]

        # 3D卷积
        features_3d = self.conv3d(features_3d)

        # 占用预测
        occupancy = self.occ_head(features_3d)  # [B, num_classes, X, Y, Z]

        return occupancy
十、总结:ResNet与YOLOv11的关系
10.1 核心联系
ResNet(2015)
    │
    ↓ 解决深层网络训练问题
    │
    ├──→ 成为各种网络的骨干
    │
    ├──→ YOLOv11的Backbone借鉴了ResNet的思想
    │
    └──→ 残差连接成为标准组件
10.2 关键对比
| 方面 | ResNet | YOLOv11 |
|---|---|---|
| 核心创新 | 残差连接 | 高效特征融合 |
| 解决的问题 | 梯度消失 | 多尺度检测 |
| 任务 | 分类 | 检测 |
| 结构 | 单一骨干 | Backbone+Neck+Head |
| 实时性 | 不要求 | 必须实时 |
| 应用场景 | 通用 | 自动驾驶等 |
10.3 学习路线
第一篇:ResNet
    ↓ 学习深度学习基础
    ↓ 理解残差连接
    ↓ 掌握特征提取

第二篇:YOLOv11(本文)
    ↓ 了解目标检测任务
    ↓ 学习多尺度特征融合
    ↓ 理解实时检测设计

第三篇:PointNet
    ↓ 处理3D点云数据
    ↓ 理解无序数据处理
    ↓ 为3D感知打基础
10.4 一句话总结
ResNet解决了"如何训练深层网络"的问题,YOLOv11解决了"如何实时检测多个物体"的问题。两者共同推动了深度学习在自动驾驶中的应用。
附录:关键术语表
| 术语 | 英文 | 含义 |
|---|---|---|
| 目标检测 | Object Detection | 定位和识别图像中的物体 |
| 边界框 | Bounding Box | 包围物体的矩形框 |
| 锚框 | Anchor Box | 预定义的参考框 |
| 特征金字塔 | Feature Pyramid | 多尺度特征表示 |
| 跨阶段连接 | Cross-Stage Partial | YOLOv11的特征复用方式 |
| 注意力机制 | Attention Mechanism | 学习关注重要特征 |
| 解耦头 | Decoupled Head | 分类和回归分开的检测头 |
下期预告:《从PointNet入门点云深度学习——如何处理无序的3D数据?》
作者:[你的公众号名称]
首发:微信公众号
转载请注明出处
更多推荐
 9
 0
- 0


 已为社区贡献3条内容

所有评论(0)