
微服务注册发现深度万字详解:原理、坑点、网络底层、生产兜底全闭环
很多人认为注册发现只是「存IP、拉IP」的简单通讯录功能。
但线上90%的微服务短时报错、超时、僵死连接、流量打挂空节点、网络抖动雪崩,根源全部来自注册发现的机制缺陷与认知盲区。
本文结合TCP底层原理、Socket超时机制、注册中心自我保护、消费者多级高可用兜底,一次性讲透注册发现完整体系,补齐绝大多数开发者的知识短板。
一、注册发现的核心定位(不止是地址管理)
注册中心是微服务的控制平面,核心职责不止记录 IP+端口,而是三件事:
-
生命周期管理:服务上线、下线、故障剔除
-
健康状态管控:心跳续约、故障实例清理
-
流量治理底座:灰度权重、分组隔离、元数据路由、环境隔离
核心架构角色:服务提供者、服务消费者、注册中心。
二、完整工作流程
名词定义:
- 心跳间隔(Renew Interval):客户端主动上报健康的发包周期
- 租约 TTL(Lease TTL / Check TTL):注册中心判定实例失效的最长容忍时长,连续超时无心跳则实例过期
- 容错系数 N:
TTL = N × 心跳间隔,允许丢失 N-1 次心跳才过期(抗网络抖动) - 清理任务周期:注册中心后台定时扫描、删除已过期实例的执行间隔
| 注册中心 | 心跳间隔 | 租约 TTL | 容错 N | 清理周期 | 备注 |
|---|---|---|---|---|---|
| Eureka | 30s | 90s | 3 | 60s | 同样 3 倍容错;持久实例无心跳淘汰 |
| Nacos 临时实例 | 5s | 15s | 3 | 20s | 同样 3 倍容错;持久实例无心跳淘汰 |
| Consul TTL 模式 (生产规范) | 10s | 30s | 3 | 40s | 同样 3 倍容错;持久实例无心跳淘汰 |
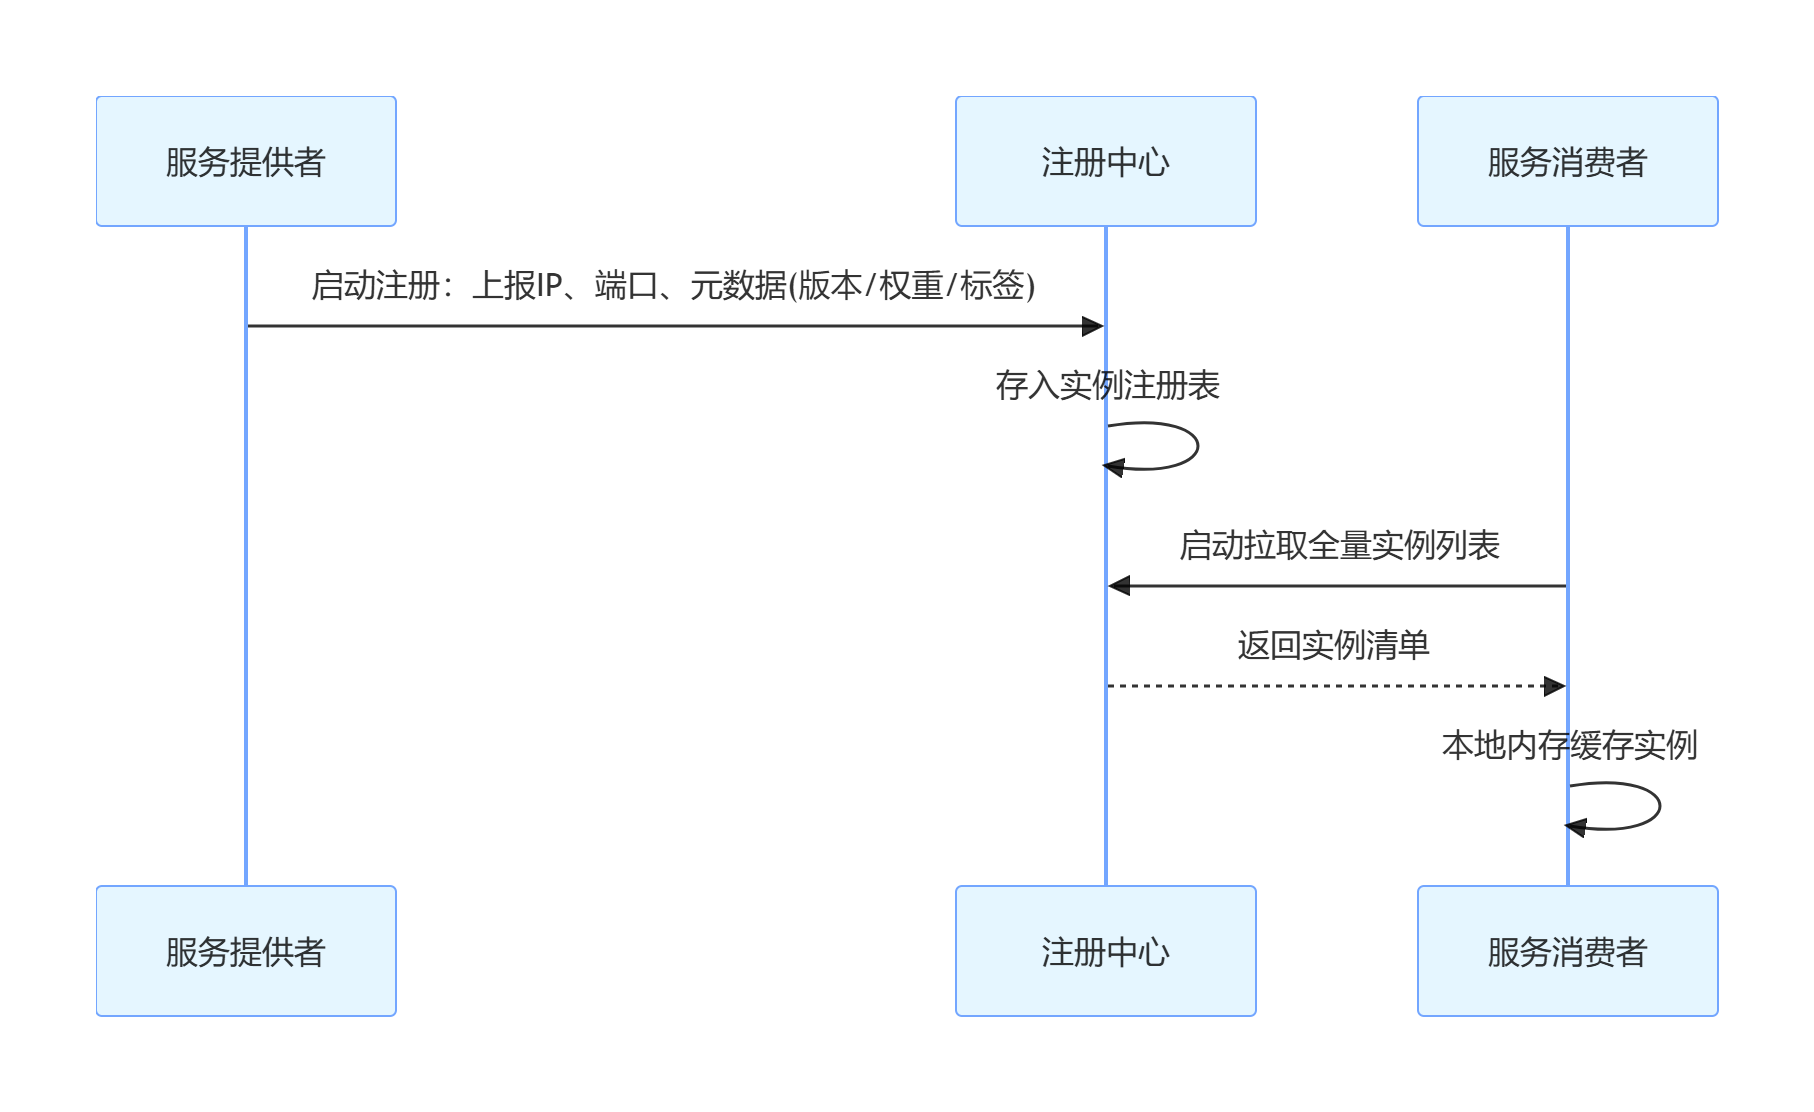
1. 服务注册
服务启动后,主动向注册中心上报自身元数据:IP、端口、服务名、版本、机房、权重、自定义标签等。注册中心持久化/内存存储,生成服务实例注册表。
2. 心跳续约(保活核心)
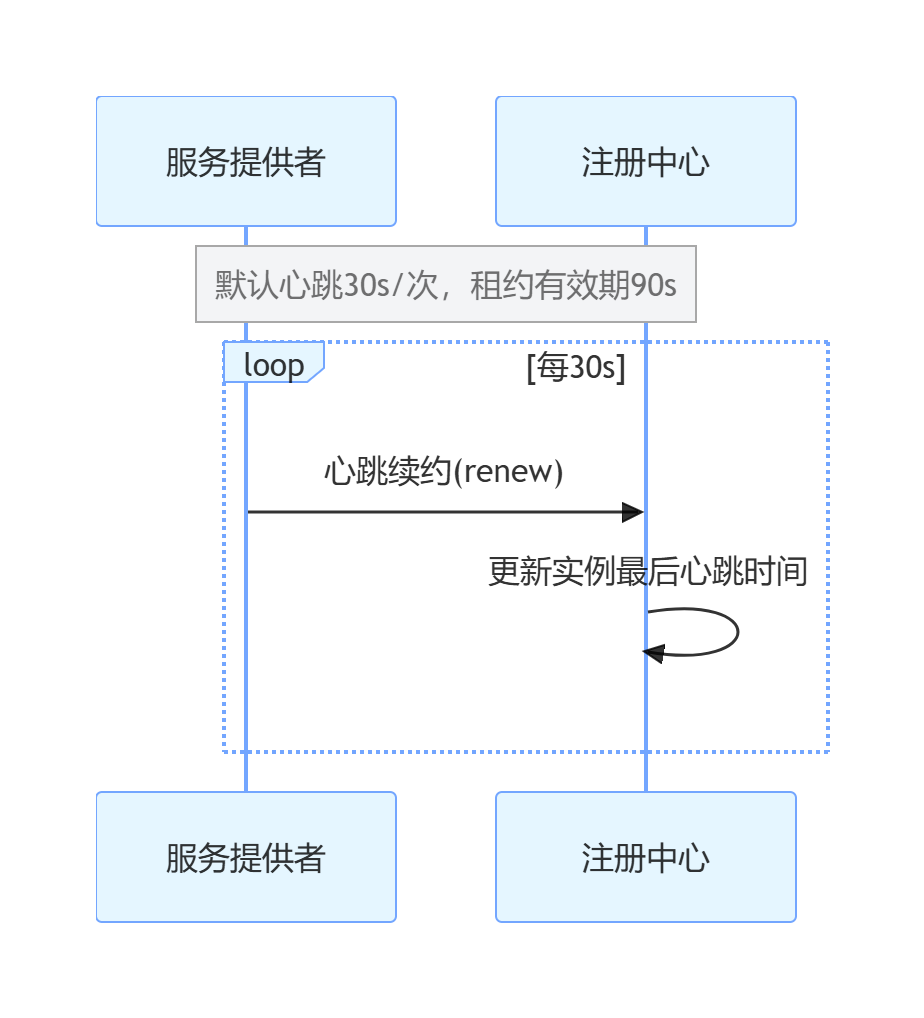
服务不会只注册一次,会定时发送心跳证明自己存活。
通用默认标准(Nacos/Eureka 通用):
-
心跳间隔:30s
-
租约过期时间:90s(连续3次未心跳,判定过期)
-
服务端清理任务:60s 执行一次扫描
3. 服务发现(客户端缓存核心)
消费者不会每次调用都请求注册中心,而是:
-
启动时全量拉取服务列表
-
本地内存缓存实例列表
-
定时拉取 / 长轮询订阅增量更新
核心痛点:本地缓存存在状态同步延迟,这是所有微服务短时报错的根本原因。
4. 服务下线两种模式
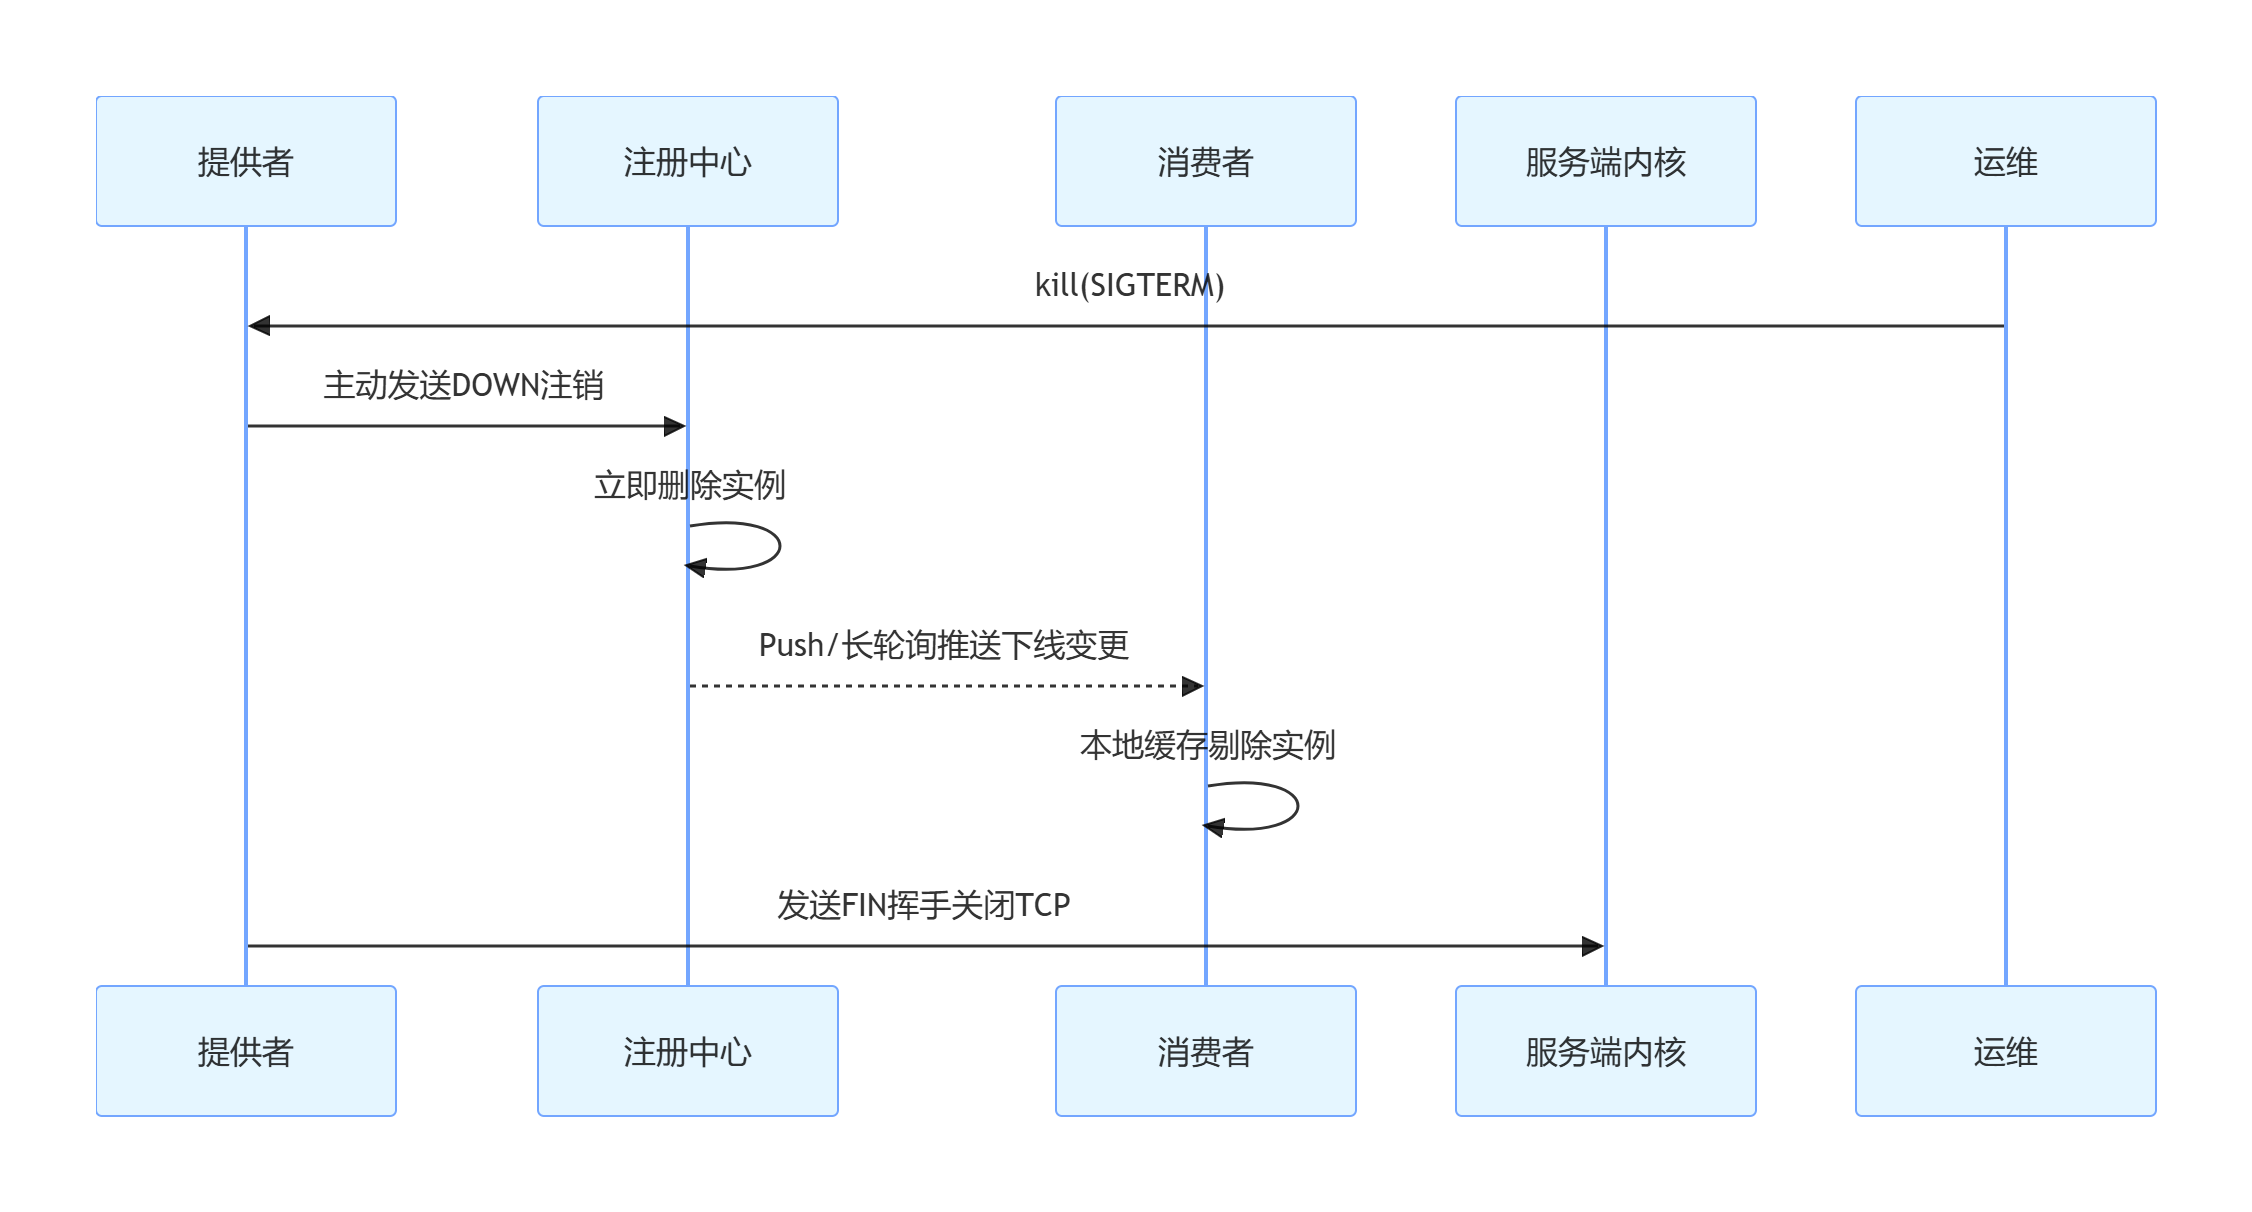
主动优雅下线:服务正常关闭,主动发送注销请求,注册中心立即删除实例、推送更新,基本无报错。
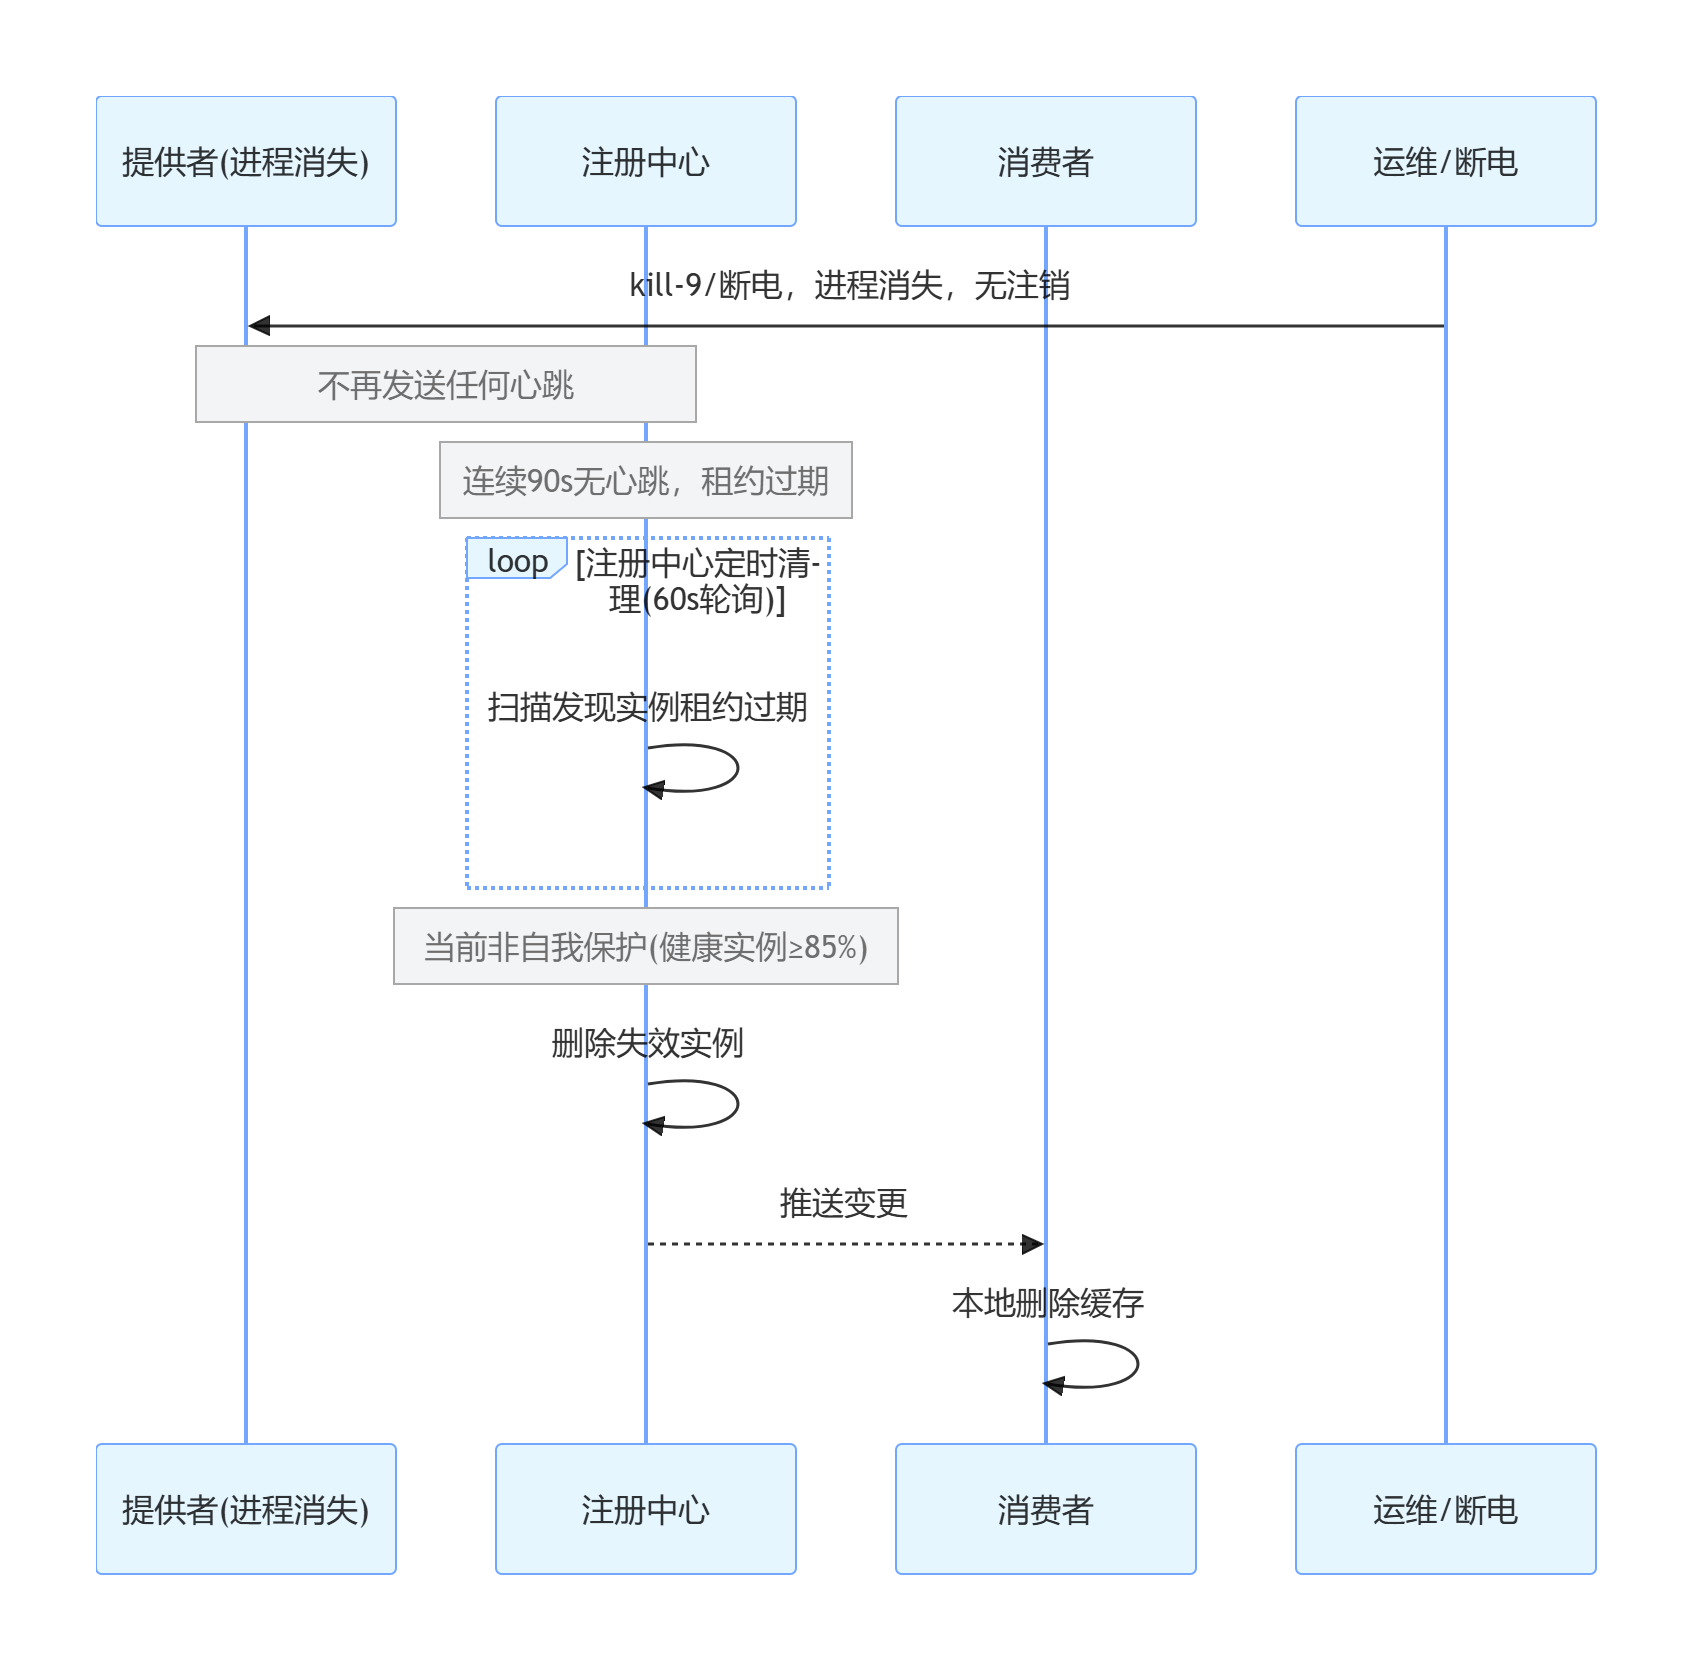
异常宕机下线:断电、kill-9、崩溃,无任何注销通知,完全依赖心跳超时被动剔除。
三、两大同步模型:Pull / Push
1. Pull 拉取模式(Eureka)
客户端定时主动拉取全量列表。优点:服务端压力小、稳定;缺点:延迟高,存在固定时间窗口的旧数据残留。
2. Push/长轮询模式(Nacos)
客户端长轮询订阅,服务端变更后实时推送增量数据。优点:延迟极低;缺点:大集群场景有推送风暴风险。
四、核心难点:实例删除 & 自我保护机制
这是面试高频、线上高可用核心的关键机制。
1. 正常剔除逻辑
当服务集群健康实例占比 ≥ 85%(保护阈值),判定为单实例故障。实例90s无心跳,扫描任务会自动剔除过期实例,同步更新给所有消费者。
2. 自我保护机制(解决网络抖动)
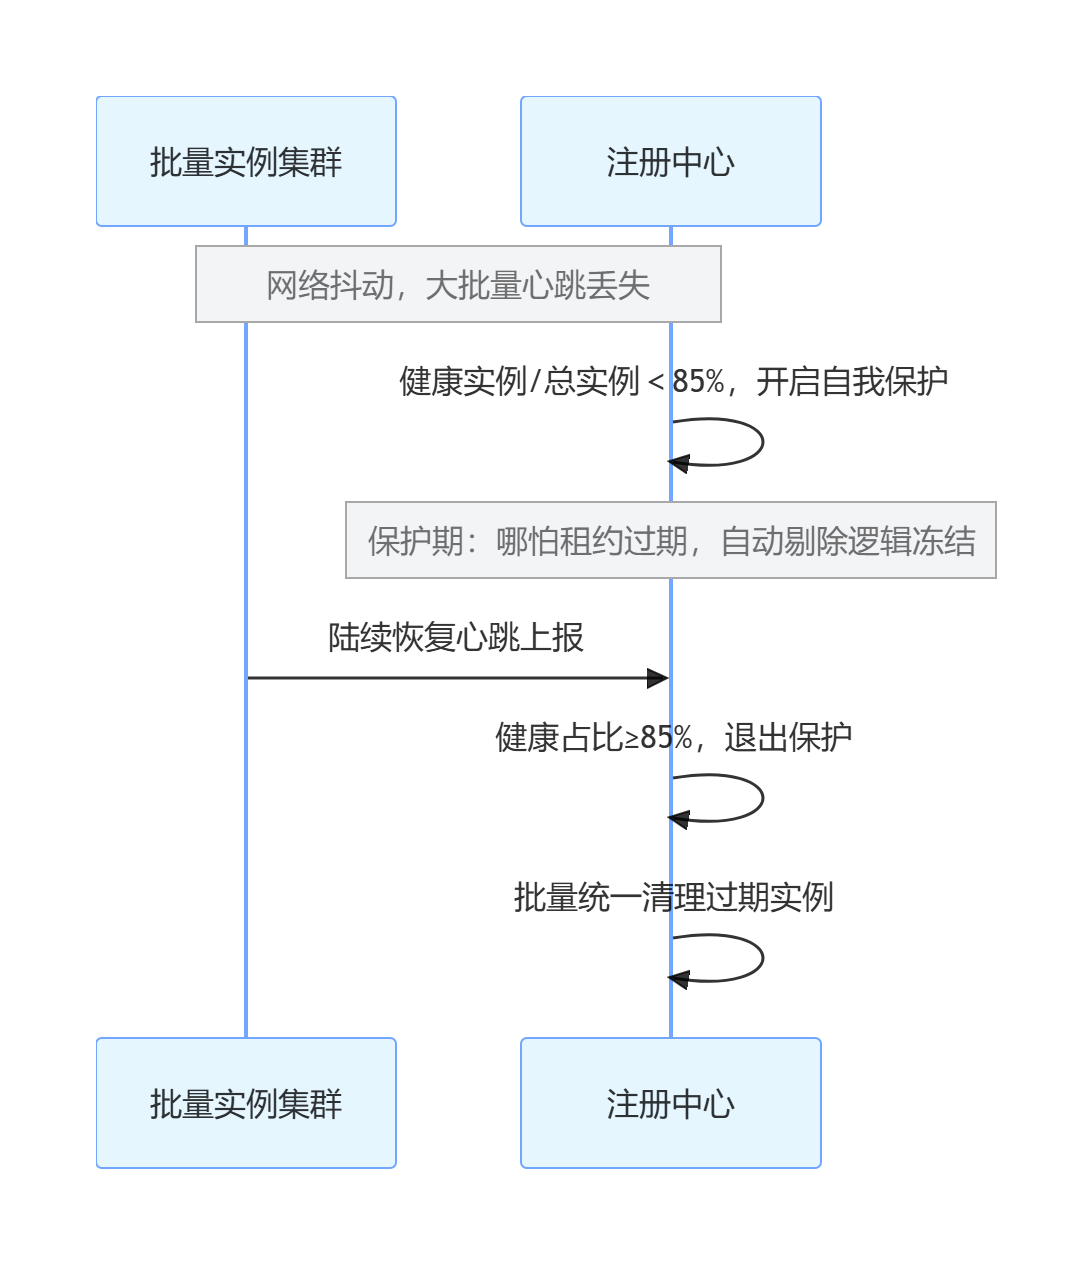
触发条件:健康实例占比 < 85%。
注册中心判定:不是批量服务挂了,是网络抖动/网络分区。
核心行为:暂停所有自动剔除操作。哪怕实例90s、几分钟无心跳,也绝不删除。
设计思想:宁可保留少量故障实例、出现局部报错,绝不清空服务列表导致全局雪崩。
3. 保护模式下,谁能被删除?
只有两种情况不受保护模式限制:
-
服务主动优雅下线(主动注销)
-
运维控制台手动强制删除
4. 退出保护模式
网络恢复、心跳批量回归,健康实例占比重新 ≥ 85%,自动退出保护模式,一次性批量清理所有过期僵死实例。
五、全网最硬核:服务下线的底层网络真相
这是微服务短时报错、超时卡死的底层根源,彻底讲透两种故障场景。
1. 场景一:服务宕机场景细分(普通kill / kill-9 / 断电)
服务进程终止分为两种完全不同的场景:普通kill优雅关闭 和 kill-9强制杀死/断电宕机,二者的TCP连接行为、消费者报错表现完全不同,也是极易混淆的核心知识点。
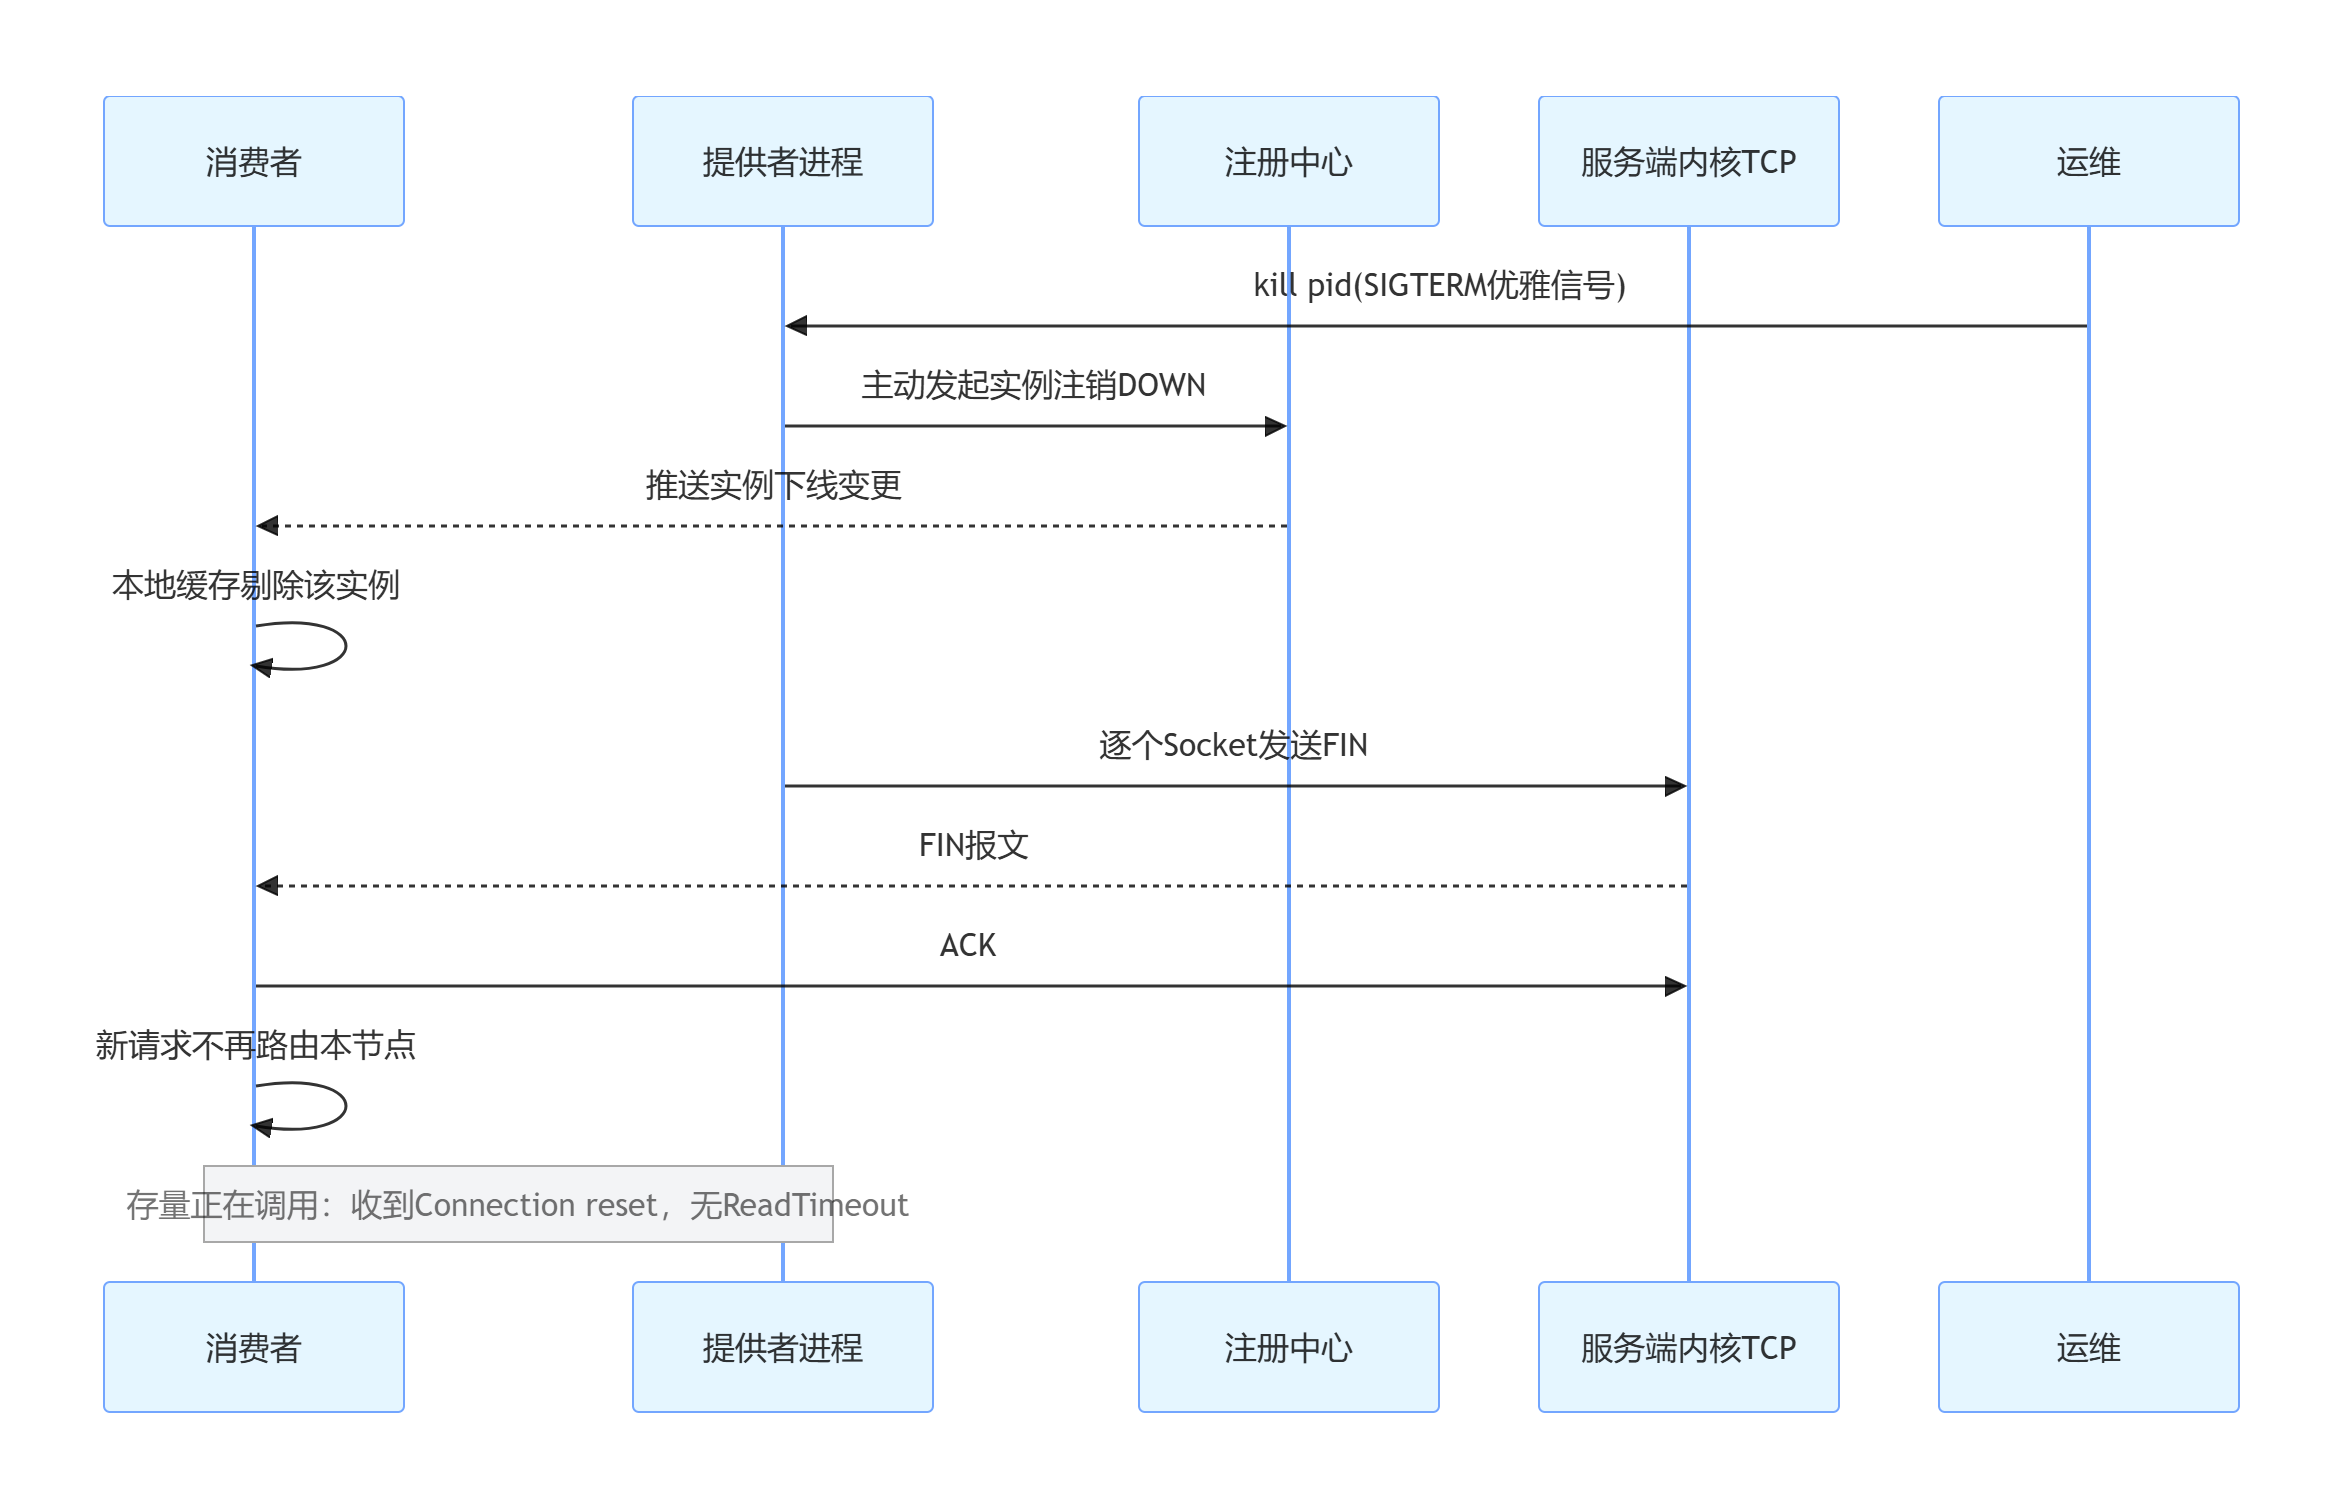
① 普通 kill 正常终止(非暴力关闭)
运维执行默认 kill 命令时,系统会给进程发送优雅退出信号,服务会执行完整的关闭逻辑:
-
服务框架触发优雅下线钩子,主动向注册中心发送注销请求
-
主动关闭长连接,正常发送 TCP FIN 断开报文
-
等待存量请求处理完毕,再销毁进程
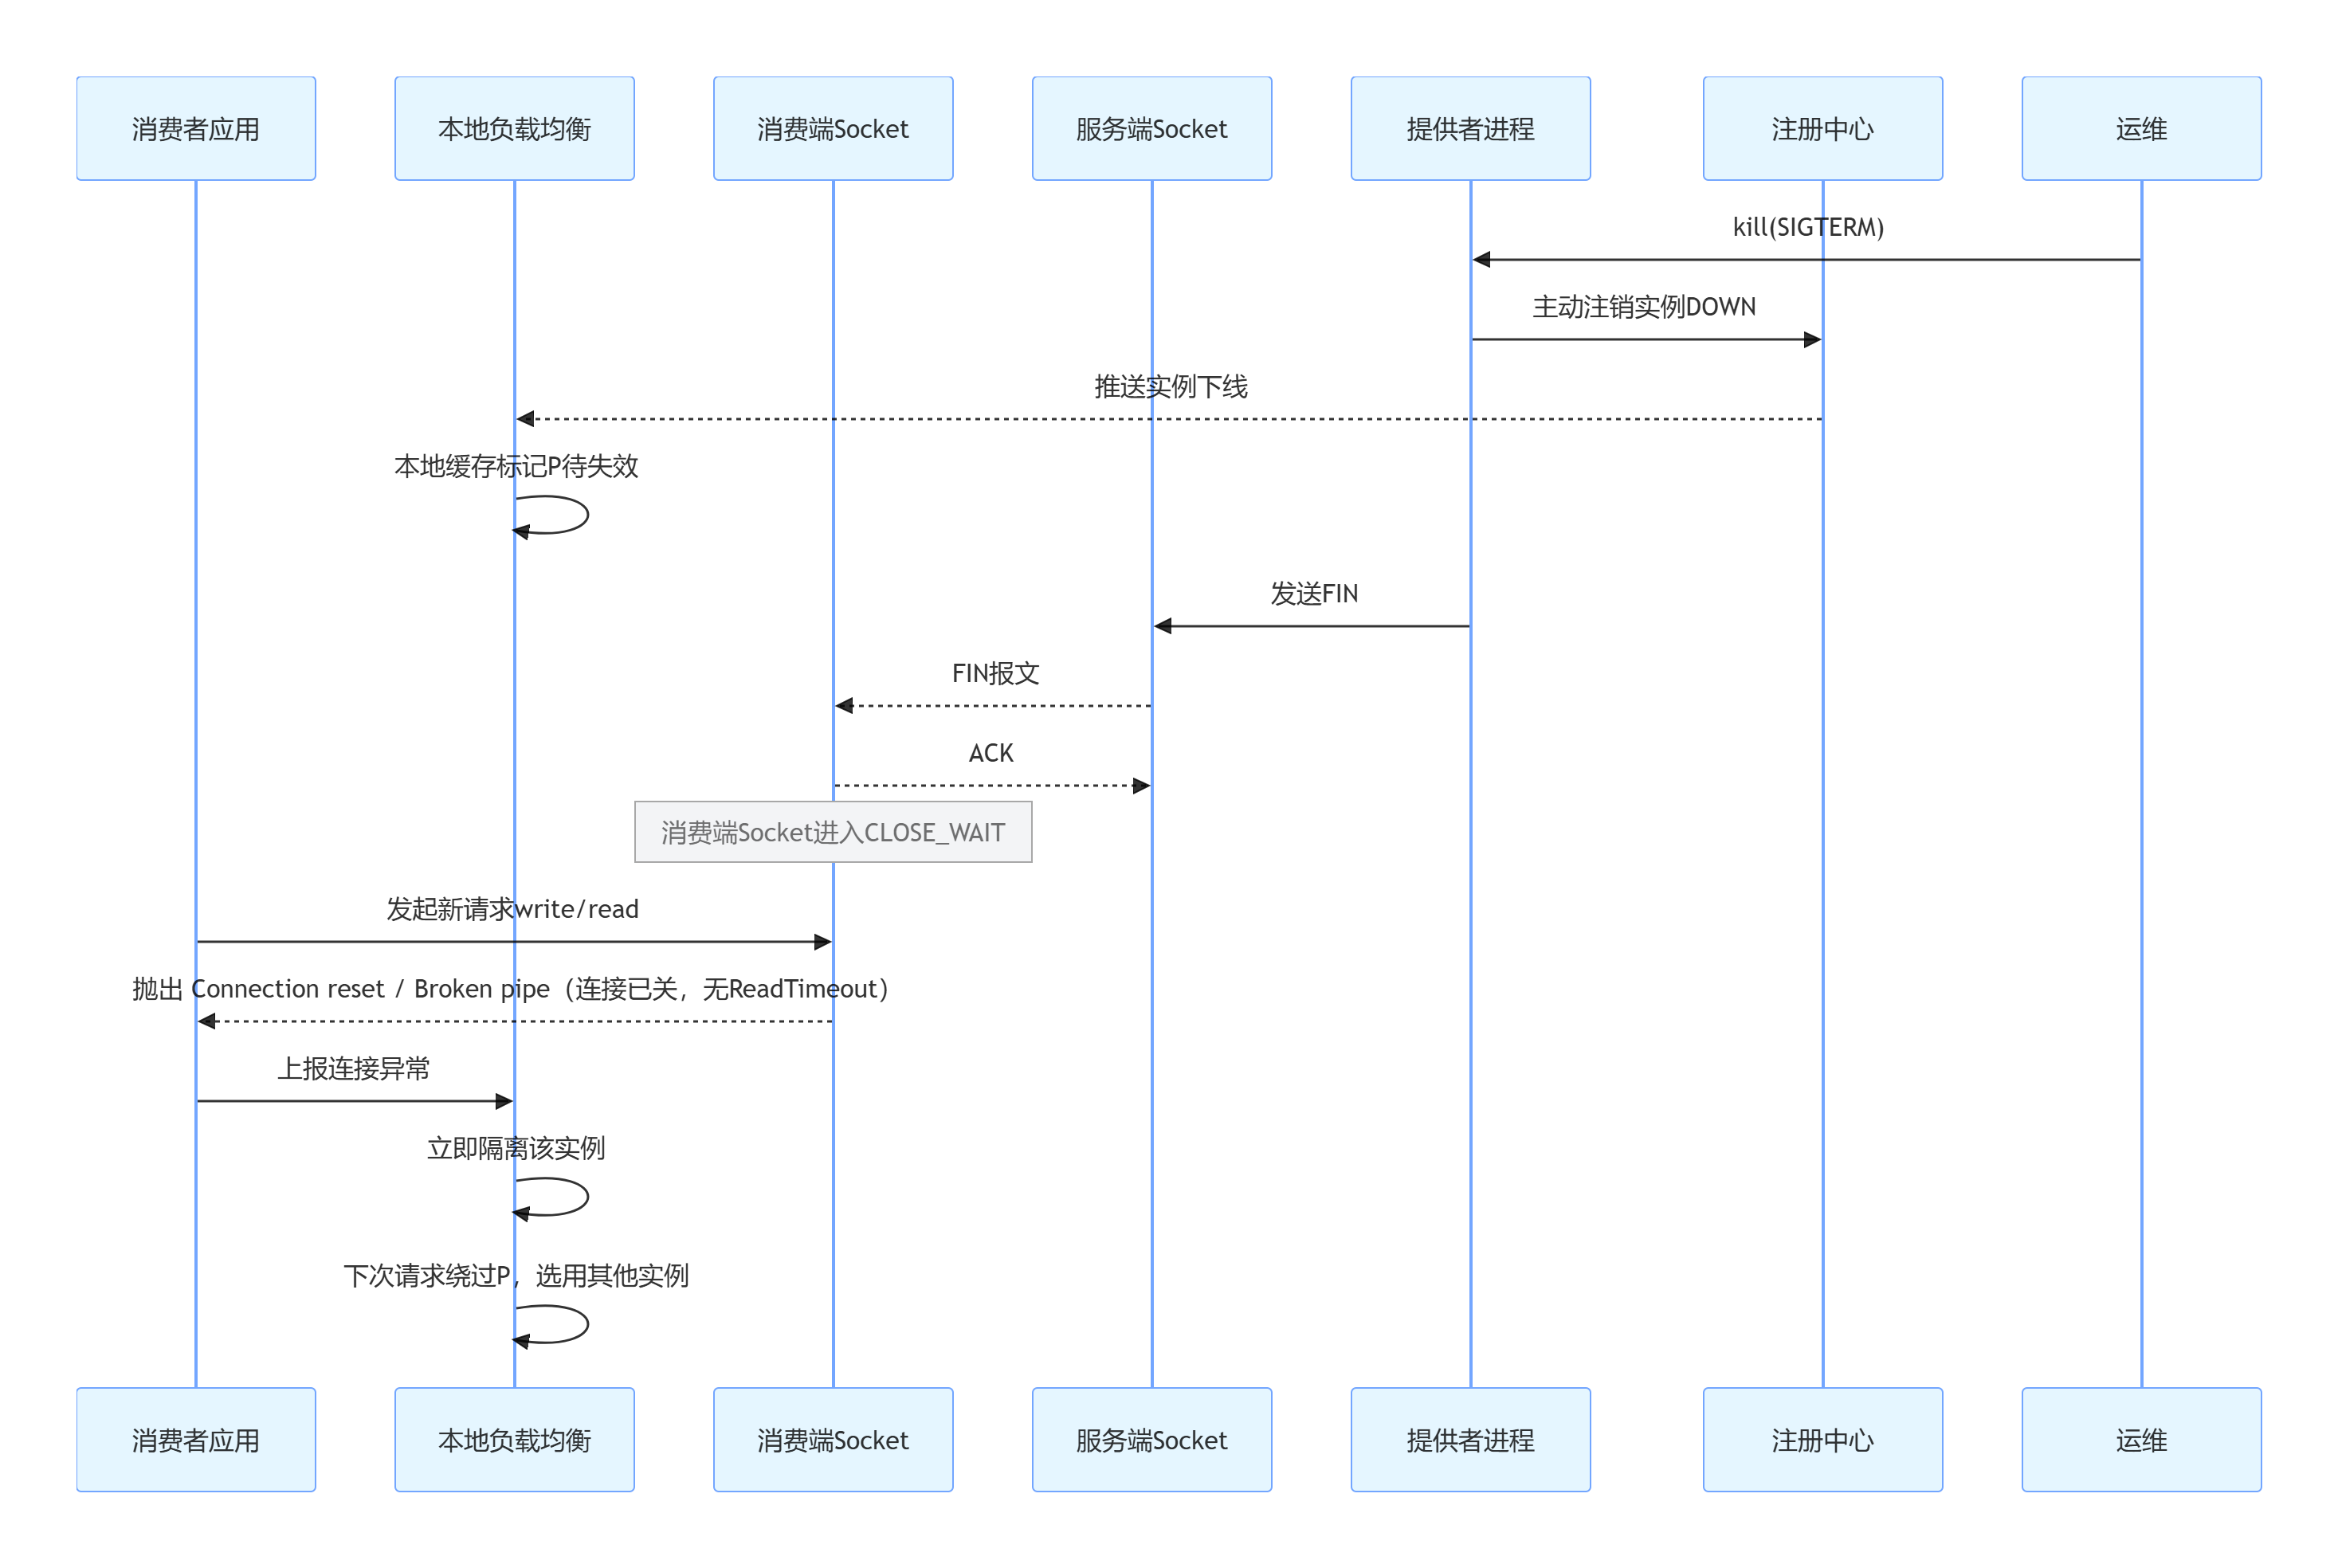
最终效果:注册中心实时剔除实例,消费者及时更新本地缓存,TCP连接正常断开,消费者会收到正常连接断开异常,几乎不会出现超时报错,是生产环境标准安全下线方式。
② kill-9 / 断电 / 内核崩溃(暴力无感知关闭)
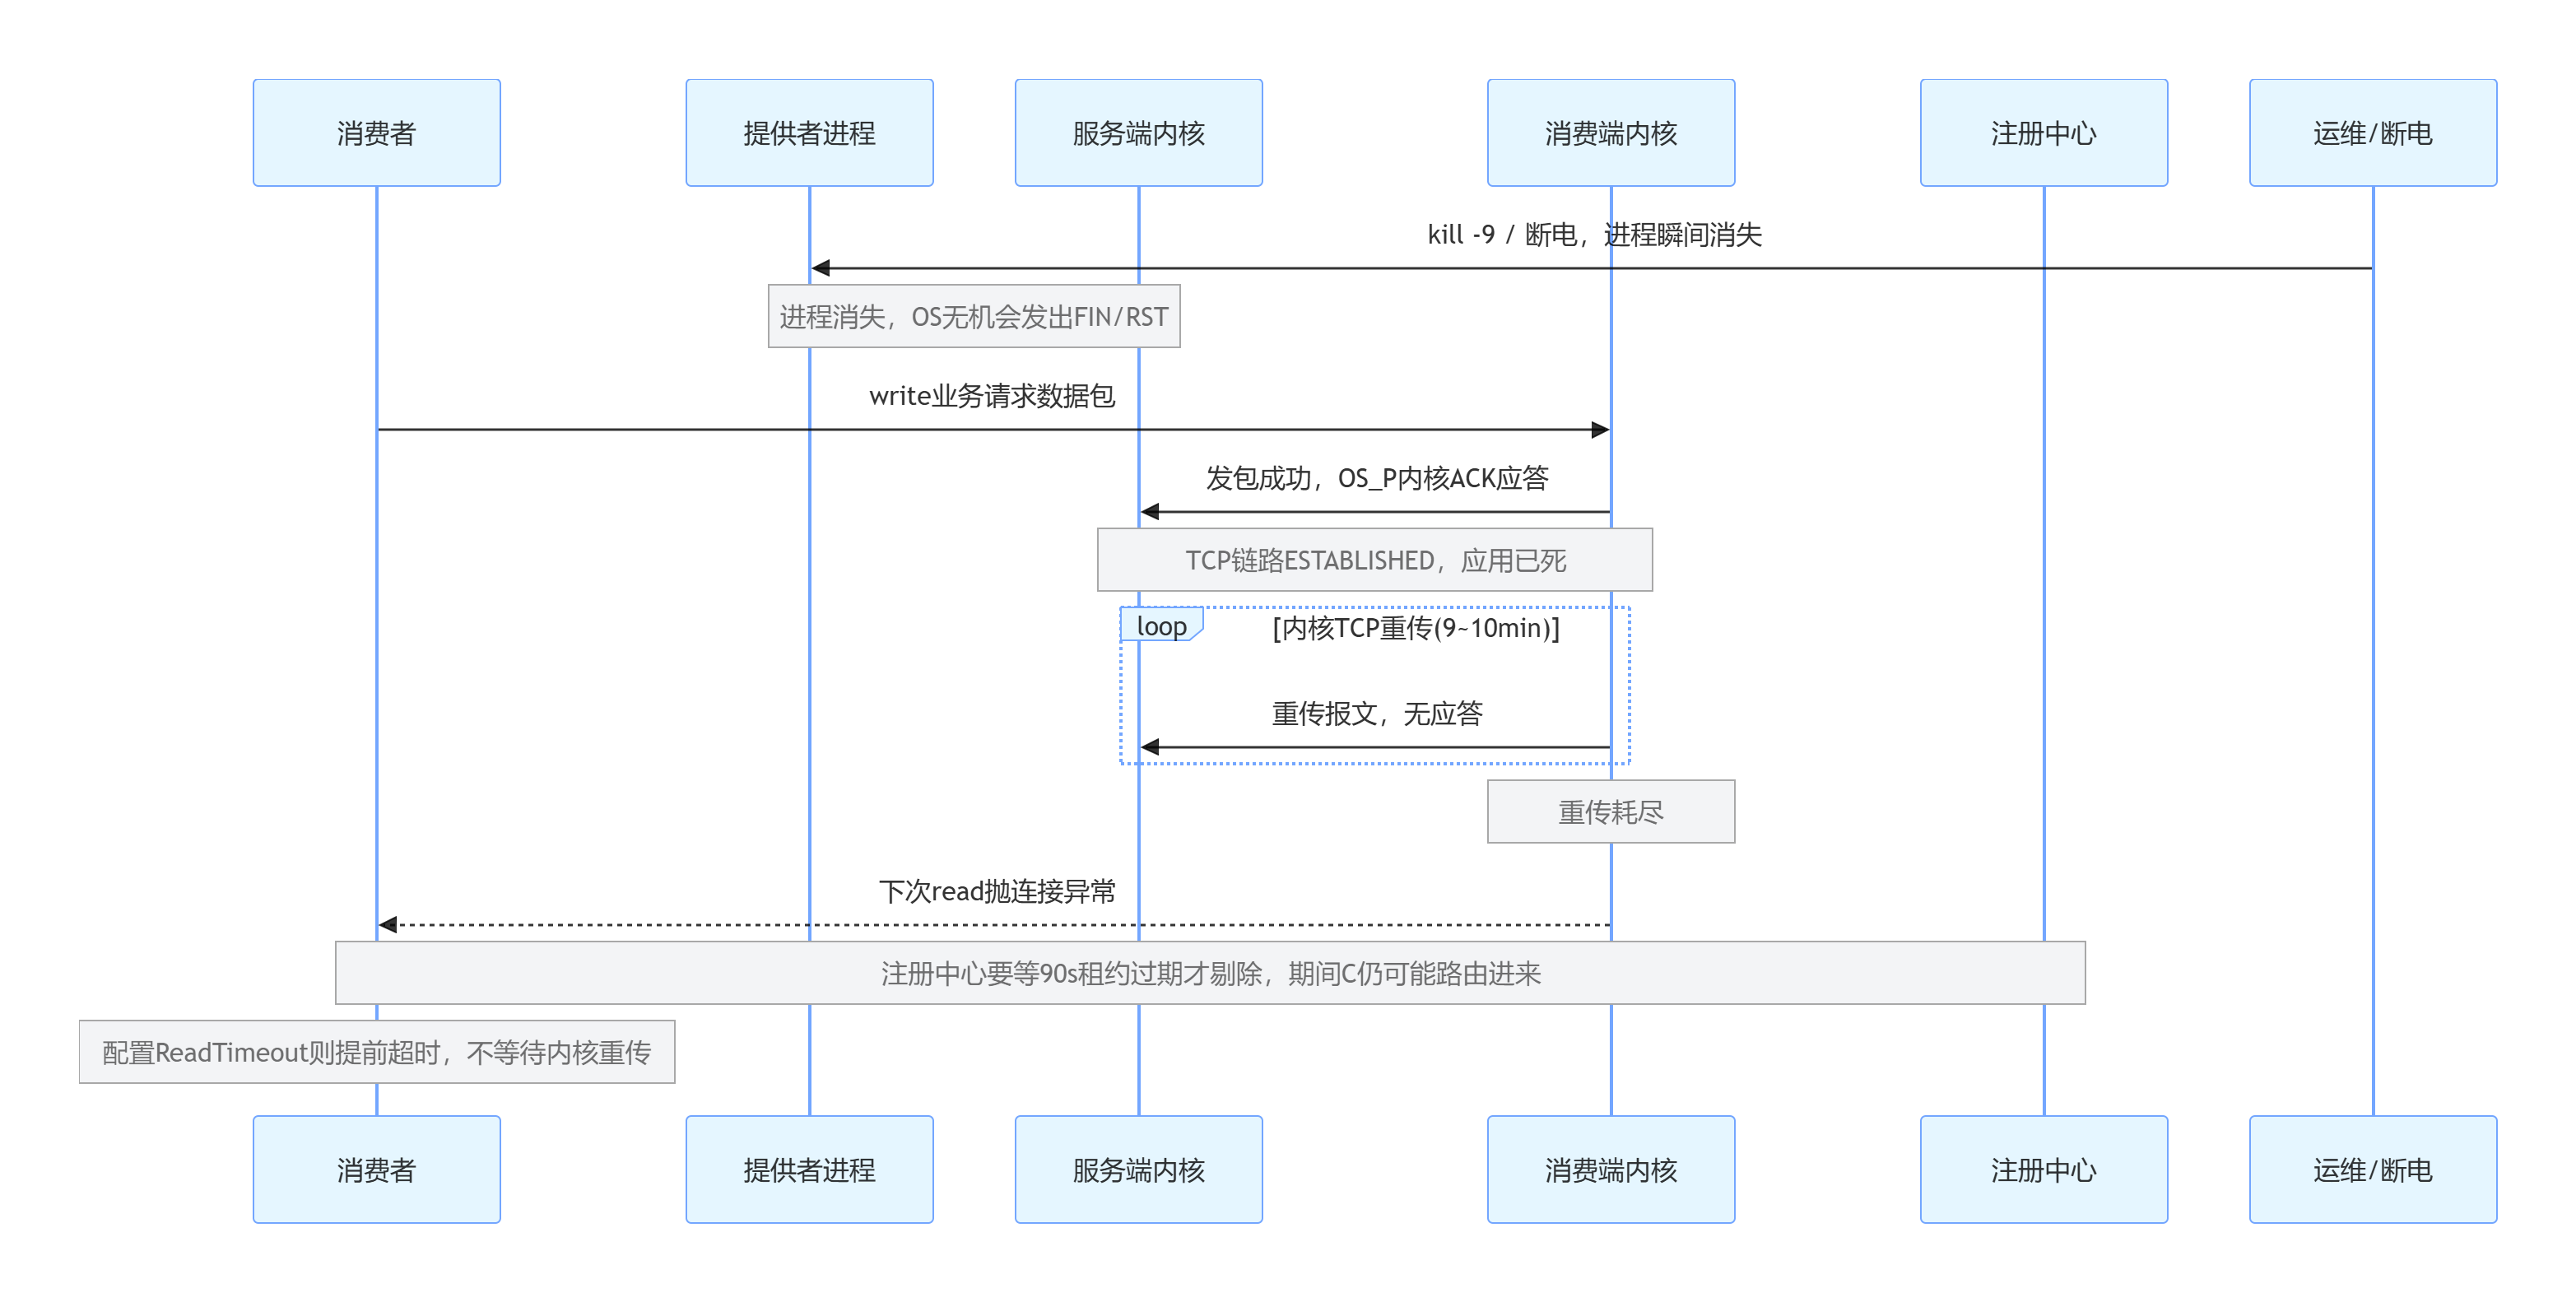
进程被系统强制终止,无任何执行机会,完全属于突发故障:
-
无法执行优雅下线逻辑,不会向注册中心发送注销请求
-
进程瞬间消失,操作系统来不及输出 TCP FIN/RST 断开报文
-
消费者侧TCP连接僵死,系统判定连接仍处于正常状态
这种暴力关闭的结果:
-
TCP连接僵死,操作系统判定连接依旧存在
-
消费者无任何连接异常、无任何错误码
-
内核默认需要9~10分钟TCP重传超时,才会强制断连接抛异常
在这10分钟内,消费者唯一能感知的只有Socket ReadTimeout。
2. 场景二:服务存活但卡死(死锁、慢SQL、FullGC、线程池打满)
这种情况更隐蔽:
-
TCP连接正常、内核正常回复 ACK
-
证明链路是通的
-
只是应用层不处理、不返回业务数据
消费者同样阻塞读,触发 Socket ReadTimeout。
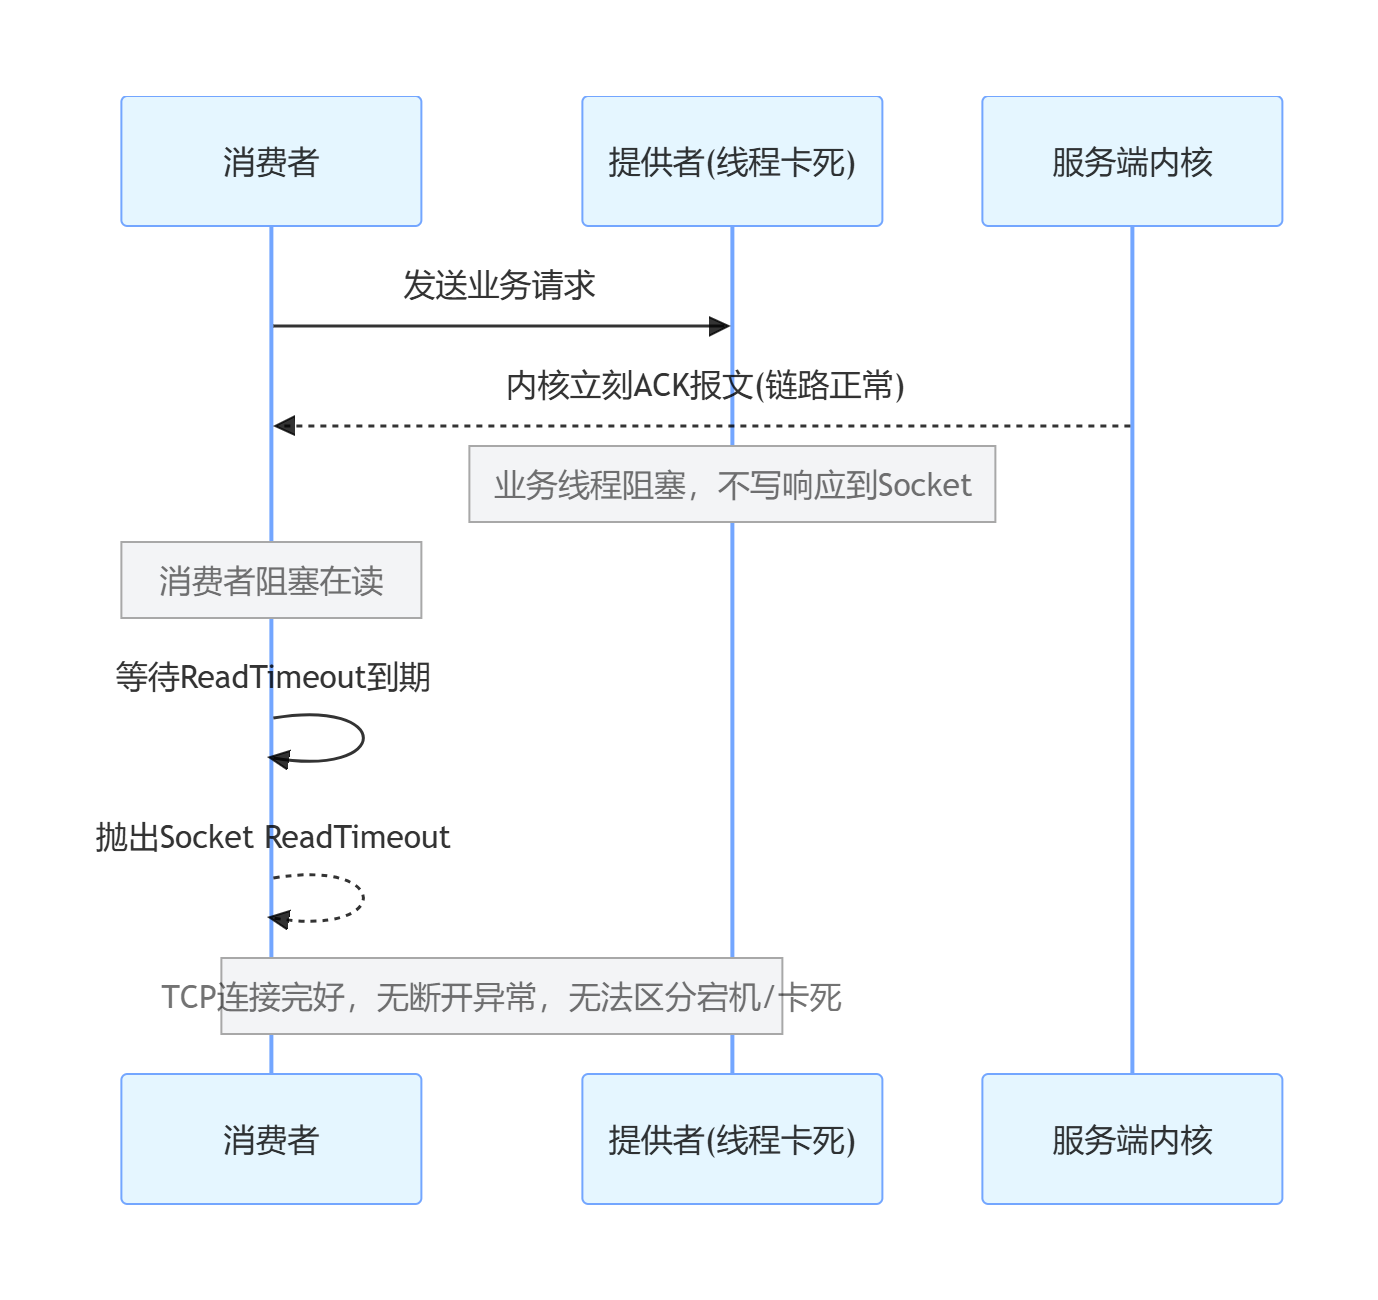
3. 终极关键结论
ReadTimeout 无法区分链路故障!
读超时只代表:规定时间内没读到数据。
它分不清:是宕机、卡死、网络慢、还是业务故意不回包。
并且:ReadTimeout 不代表连接异常,连接大概率是正常存活的。
六、TCP Keepalive 内核保活机制深度答疑
1. 默认状态:默认关闭
所有操作系统 Linux/Windows/macOS 默认 不开启 TCP Keepalive。
即使开启,默认参数极其宽松:空闲 2小时 才开始探测,完全不适合微服务。
2. 为什么默认不开?
-
RFC1122 标准强制要求默认关闭
-
防止网络短暂抖动、拥堵、路由闪断被误杀正常连接
-
早期网络按流量计费,保活包浪费带宽成本
-
TCP设计哲学:传输层不替应用层决定连接死活
3. 应用层如何感知 Keepalive 探测结果?
核心真相:内核不主动通知应用层任何结果。
-
探测正常:应用无感知
-
探测失败:内核标记连接死亡,但不推送事件
-
只有下一次读写操作时,应用才会收到 Connection reset / Broken pipe
Keepalive 唯一作用:把10分钟的内核重传等待,缩短到1分钟内快速清理僵死连接。
七、消费者终极兜底方案
注册中心只能解决「全局最终一致性」,解决不了「短时延迟报错」。必须依靠客户端五层防护,构成完整高可用体系。
1. 双层超时分离(最基础)
-
ConnectTimeout 连接超时:建连失败,直接判定链路故障,立即隔离节点
-
ReadTimeout 读超时:仅未读到数据,无法判定链路死活,仅临时规避
2. 本地负载均衡即时隔离
注册中心有延迟,客户端无延迟。单次超时/失败后,本地临时拉黑故障实例,新流量不再打入,毫秒级止损。
3. 熔断降级兜底(防雪崩)
单服务批量超时、失败率飙升,触发熔断,直接停止调用、返回兜底数据,避免线程池耗尽、服务雪崩。
八、架构师视角
-
注册发现不是简单的地址通讯录,是微服务流量治理与高可用的底座。
-
自我保护机制的核心是:宁可错留,不可清空,防止网络抖动引发全局雪崩。
-
ReadTimeout 是分布式最隐蔽的沉默故障,无法区分宕机、卡死、业务慢。
-
TCP Keepalive 默认关闭,内核不主动通知应用,只能通过下次读写感知连接死亡。
-
真正的微服务高可用 = 注册中心全局管控 + 客户端超时/隔离/重试/熔断 即时兜底。
更多推荐
 4
 0
- 0


 已为社区贡献9条内容

所有评论(0)