
AI大模型到底有几种?语言、语音、多模态……一文搞懂所有类型
用最直白的话梳理市面上常见的大模型类型——不是按技术架构分,而是按"它能干嘛"来分。看完你知道遇到什么任务该找哪种模型,不会再拿着锤子找钉子。
先上一张表,把所有模型类型看明白
| 模型类型 | 能干嘛 | 代表产品 | 适合谁用 |
|---|---|---|---|
| 大语言模型 | 聊天、写文章、翻译、总结、问答 | GPT、Claude、DeepSeek、通义千问 | 所有人 |
| 多模态模型 | 能看图、听声音、理解视频 | GPT-4V、Gemini、LLaVA | 需要处理图片/音视频的人 |
| 代码模型 | 写代码、改bug、代码补全 | GitHub Copilot、DeepSeek-Coder、通义灵码 | 程序员 |
| 推理模型 | 数学题、逻辑推理、复杂分析 | OpenAI o1、DeepSeek-R1、QwQ | 需要做深度分析的人 |
| 语音模型 | 语音转文字、文字转语音 | Whisper、讯飞听见、GPT-4o语音模式 | 需要语音处理的人 |
| 图像生成模型 | 输入文字描述,生成图片 | Midjourney、Stable Diffusion、即梦、通义万相 | 需要配图/设计的人 |
这张表基本覆盖了你现在能用到的大部分AI模型。
看不懂表里的一些名词?没事,下面挨个解释一下——
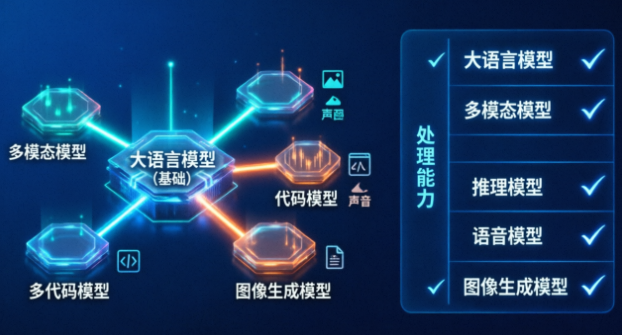
大语言模型:就是"只处理文字"的AI。你打字,它回文字。目前最成熟、用得最多的类型。
多模态模型:“多模态”= 多种输入方式。普通模型只能收文字,多模态模型能收图片、声音、视频,也能理解这些内容。比如你拍一张猫的照片发过去,它能告诉你图里有几只猫、在干嘛。
代码模型:专门用代码数据训练过的语言模型。不是它只能写代码,而是它"特别擅长"写代码,比普通模型写得规范。
推理模型:回答问题前会"先想一会儿"的模型。普通模型是脱口而出,推理模型会先生成一段内部推导过程,再给出答案。适合数学、逻辑、复杂分析这类任务。
语音模型:专门处理声音的模型。分两类——把你说话转成文字(语音识别),把文字转成声音读出来(语音合成)。最近也有能直接语音对话的"端到端"语音模型。
图像生成模型:你输入一段文字描述,它生成一张图片。跟语言模型是两套完全不同的技术,底层是扩散模型,不是Transformer。
这些技术细节知道就好,不用死记。关键是——
现在该怎么选?
说点实际的。
如果你不知道该用哪个,先从大语言模型开始。 它能干的事最多,也最成熟。DeepSeek、通义千问这些都是免费的,先玩起来。
如果你是个程序员,一定要试试代码模型。 普通GPT也能写代码,但代码模型写出来的更规范,注释也写得好。DeepSeek-Coder目前是开源里最强的,可以本地部署。
如果你经常要处理图片(比如做自媒体、做设计),多模态模型是必需品。 GPT-4V、Gemini都能用,国内的通义千问也支持看图。
如果你要做复杂分析(比如研究报告、数据分析),推理模型值得一试。 DeepSeek-R1现在免费,效果不比OpenAI o1差。
如果你需要画图,图像生成模型跟语言模型是两个东西,得单独用。 即梦、通义万相对中文支持好,Midjourney效果好但只支持英文提示词。
选对了模型,效率能差好几倍。
小虾的未来愿景
我有时候会想,再过几年,这些模型类型会不会消失。
不是因为它们没用,而是因为它们会"融合"——
你已经能看到这个趋势了:GPT-4o能同时处理文字、图片、声音;Gemini从一开始就是"原生多模态";DeepSeek也在往推理、代码方向一体化做。
以后的AI,可能不再有"语言模型""多模态模型"这种分类——就只有一个AI,你扔给它任何东西(文字、图片、声音、代码、表格),它都能处理,也都能输出。
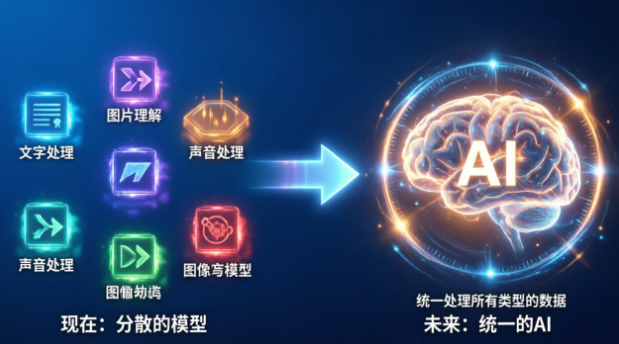
那时候,你不用再想"这个任务该用哪个模型"——就像你现在不会想"我要用哪个搜索引擎"一样,你直接问就行了。
但在这件事发生之前——也就是现在——你还是得知道这些分类。
因为现在的AI还没那么聪明,不同的任务用不同的模型,效果差很多。
你知道有推理模型,做复杂分析时就不会拿普通GPT硬顶;你知道有代码模型,写代码时就不会拿通用模型凑合;你知道有图像生成模型,需要配图时就不会去素材网站翻半天。
这些"知道",在短时间内还是有用的。
至于多长时间?我猜3到5年,模型分类这件事就会变成"上古知识"——就像现在没人会专门去学"怎么用拨号上网"一样。
但在那之前,这些知识还能帮你少走弯路。
挺好的。
关注小虾,一起成长,一起进化
更多推荐

 3
 0
- 0


 已为社区贡献11条内容

所有评论(0)