
今天来聊一聊Flink 的发展史和技术演进
从研究项目开始的起点
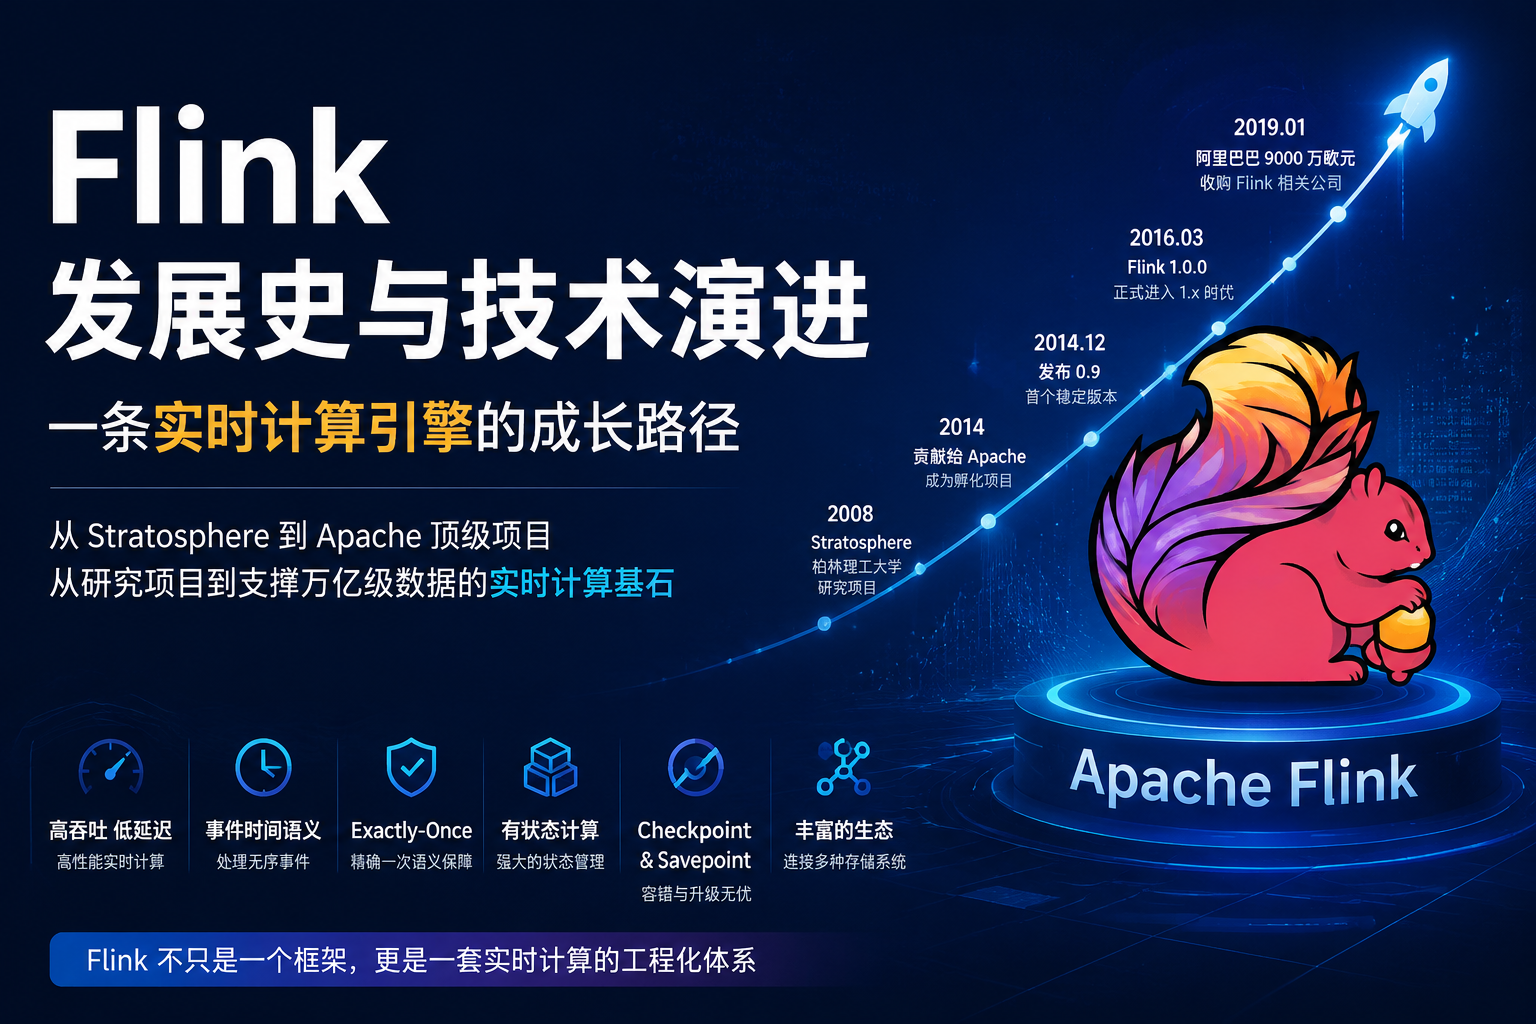
Flink 的故事起步并不在商业公司,而是在 2008 年的柏林理工大学研究项目 Stratosphere。彼时的目标很朴素:探索大规模数据处理的执行模型与优化空间。
2014 年 4 月,Stratosphere 被捐赠至 Apache 基金会,进入孵化阶段,并在同年 12 月正式成为 Apache 顶级项目。这一步意味着它从学术实验走向工程化与社区驱动的开源系统。
版本演进时间线(关键节点)
版本的推进几乎清晰地反映了 Flink 能力边界的扩展路径,尤其是在流处理稳定性与生态成熟度上的变化。
| 时间 | 版本 | 关键意义 |
|---|---|---|
| 2015-06 | 0.9 | 首个稳定版本 |
| 2016-03 | 1.0.0 | 正式进入 1.x 时代 |
| 2017-05 | 1.3.0 | 流处理能力增强 |
| 2018-11 | 1.7.0 | 生态与稳定性提升 |
| 2019-04 | 1.8.0 | SQL 与 Table API 加速发展 |
| 2020-07 | 1.11.0 | Kubernetes 支持增强 |
| 2020-12 | 1.12.0 | 统一流批处理进一步成熟 |
| 2021-04 | 1.13.0 | 生产级能力完善 |
2019 年 1 月,阿里巴巴以约 9000 万欧元收购 Flink 相关公司,这一事件显著推动了 Flink 在国内的工程化落地速度。
Flink 的核心能力结构
Flink 的设计重点一直围绕“流式计算的确定性与实时性”展开,在架构层面形成了几个长期稳定的能力模块:
统一流批处理模型
Flink 将 Batch 与 Streaming 统一为 DataStream 模型,减少了两套系统的割裂成本。
时间语义体系
支持:
- Event Time(事件时间)
- Processing Time(处理时间)
事件时间让乱序数据也能得到一致结果,这是流计算稳定性的关键基础之一。
状态与容错机制
Flink 提供:
- Stateful Computation(有状态计算)
- Checkpoint(分布式快照)
- Savepoint(可控恢复点)
其中 Checkpoint 用于自动容错恢复,Savepoint 更偏向版本升级与人工运维控制。
性能与运行时能力
- Backpressure(反压机制)
- 高吞吐 + 低延迟并存
- JVM 内自研内存管理体系
- Exactly-Once(精确一次语义)
核心能力一览对比
| 能力维度 | Flink | Spark | Storm | Storm Trident |
|---|---|---|---|---|
| 处理模型 | Native Streaming | Micro-Batch | Native Streaming | Micro-Batch |
| 语义支持 | Exactly-Once | Exactly-Once | At-Least-Once | Exactly-Once |
| 延迟 | 极低 | 中等 | 低 | 中等 |
| 吞吐量 | 高 | 高 | 中 | 中 |
| 容错机制 | Checkpoint | RDD lineage | Ack | Batch Ack |
工程化与生态能力
Flink 的工程能力不仅体现在计算模型,还体现在它对生产系统的适配程度上:
- Kafka / Elasticsearch 等连接器体系
- 支持 YARN / Kubernetes / Mesos
- 高可用架构设计,避免单点故障
- 可扩展的 Metrics 系统(监控与指标体系)
这些能力让 Flink 在复杂生产环境中具备较强的可运维性。
行业落地的真实路径
Flink 在国内互联网公司的落地节奏较早,典型案例包括:
-
美团实时数仓与业务分析
美团 Flink 实践 -
滴滴实时计算平台建设
滴滴 Flink 应用分析 -
快手流式数据处理架构
快手 Flink 实践
这些应用场景集中在实时指标计算、风控、推荐系统与日志分析等方向。
如果想从零入门学习Flink,推荐这套课程。
结尾之外的观察
Flink 的发展路径比较清晰:从学术系统出发,在流计算语义上持续加深,在工程化能力上不断补齐,最终进入大规模生产系统的核心层。
它的变化更多体现在稳定性、语义一致性与生态兼容性这些“看不见但关键”的部分,而不是单纯功能堆叠。
更多推荐


 5
 0
- 0


 已为社区贡献4条内容

所有评论(0)