
java ? Java老司机?大模型写代码,不过是背题库的学霸罢了
之于, Java, 这般语言, 大模型常常可给出颇为成熟的答案。
但如果换做小众的、样例不足的年轻语言呢?
大模型究竟是实实在在地具备了通用编程的能力, 还是会更加专长于那些在训练数据当中已经出现过不计其数回的语言呢?
一篇新论文把这个问题拉到了台前。
有一篇论文, 它的题目是《No , No , No? and LLMs for Code in No-》, 该论文已经在arXiv上发布了, 并且还标注被IEEE on 接收了。这篇论文研究的对象, 不是诸如 、Java这样需要大量资源的语言, 而是两门比较新的语言, 分别是 和Gleam。
撰写论文的作者, 是源自瑞士USI /SEART研究组的人员, 以及来自西班牙塞维利亚大学SCORE Lab/I3US的那群人。存在于SEART的长期研究方向, 是针对软件分析、开发者推荐系统以及AI4SE展开的, 这样的状况使得此项工作愈发地趋近于一次源自软件工程研究界的外部评估。
论文将它们称作no- , 这能够被理解成" 无资源编程语言"。
这里所说的“无资源”, 并非意味着语言自身能力欠缺, 只因它们太过新颖, 公开的代码数量不足够多, 教程数量不足够多, 问答数量不足够多, 项目样例数量也不足够多, 大模型于预训练阶段极有可能未曾充分见识过它们。
注意, 此篇论文在进行统计数据的时候, 选定的时间节点是24年, 到了截止时间26年6月的时候, 语言资料相对来说较为丰富。
换句话说,这篇论文问了一个现实问题:
是否存在这样一种情况, 一门语言, 其并没有被互联网语料充分覆盖, 在此情形下, 大模型能够将它写好吗?
答案是:一开始很难。
更加关键的是, 论文还呈现出另外一件事情,新语言并非仅仅只能任凭大模型自然而然地去学会, 有了足够清晰的言语设计、文档、代码以及工具链, 它能够被有条不紊地传授给大模型。
编程语言被放进了新语言考场
论文构建了三个代码生成 :、MBPP 和 -Hard。
测试的方式是十分直接的, 具体为, 给予模型自然之中的语言描述, 以及函数的签名, 接着让那模型把函数的实现给补全, 紧接着运用测试用例去判断是不是正确的。
评价指标主要是pass@1。
换言之, 模型存在着仅有的一回生成机遇, 当一回撰写出来的代码能够经由测试, 这便算为成功, 不然的话就是失败。
论文对比了三类语言:
高资源语言:、Java。
低资源语言:R、Lua、、Julia、。
无资源语言:、Gleam。
参与评测的模型包含GPT - 4o, 还有o3 - mini, 以及Qwen 2.5 Coder、Qwen 3等等。论文写明, 有方面和MBPP被翻译到了和Gleam那儿, - Hard是依据中的hard tasks来构建的, 最终造就了用于跨语言比较的函数级代码生成任务。
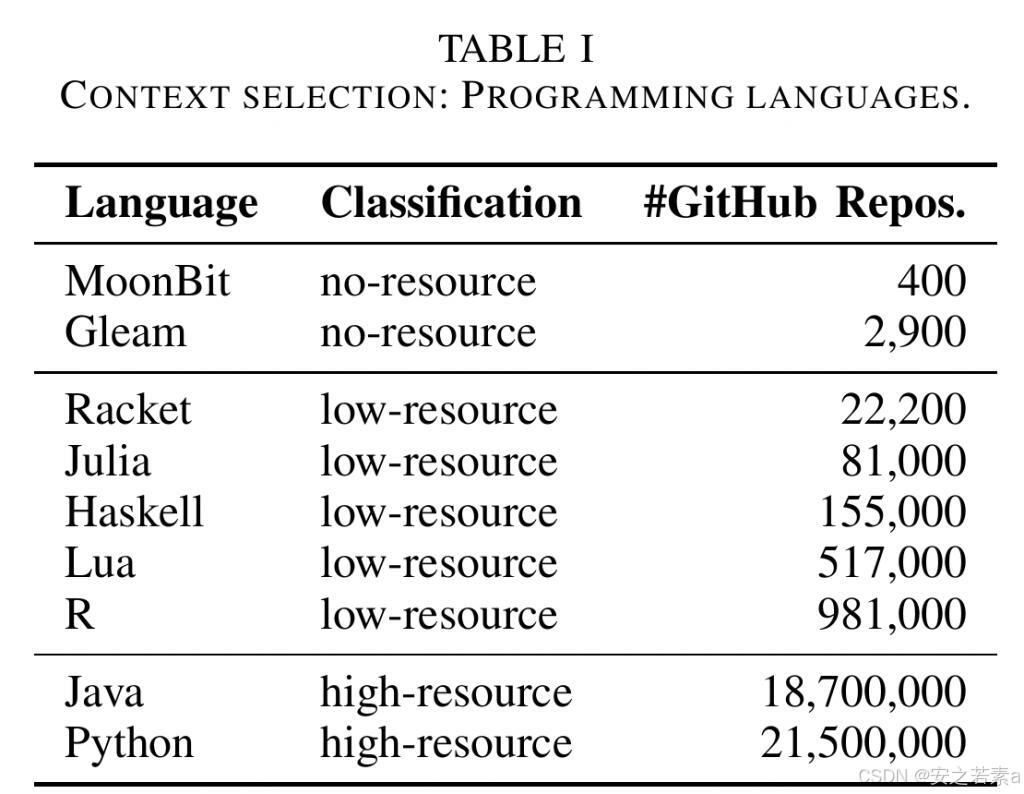
论文中对不同语言 仓库规模和资源类型的划分零样本几乎失灵
结果并不意外,但很有代表性。
在Java这类, 具有高资源特性的语言上面, 大模型的表现, 依旧是非常强劲的;在低资源语言方面, 其表现虽然存在下降情况, 不过仍然是能够使用的;然而当到了某些特定语言, 比如以及Gleam这样的新语言领域的时候, 零样本代码生成能力, 就会出现明显的下滑态势。
尤其是在更具难度的 -Hard水准上, 高资源语言的pass@1大概处于59%至89%的范围之内, 低资源语言大概处于27%至84%的范围之内, 并且无资源语言仅仅只有0%至1%。论文又表明了这一点, 无资源语言于多个模型处的表现常常处于0%至20%的范围之中, 平均大约为9%。
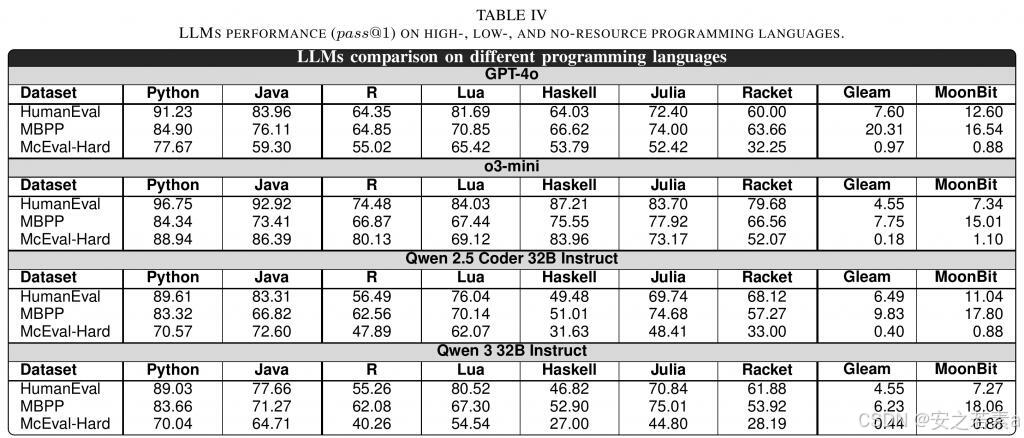
零样本设置下,不同模型在不同语言上的 pass@1 对比
更关键的是,失败原因不只是 " 算法没想明白 "。
经论文分析发觉, 于Gleam以及其上, 诸多失败源自语法错误, 这意味着, 模型时常连合法代码都无法生成出来。
这并不说明 不行。
更准确地说,是模型还没有真正学过 。
大模型进行写作, 过程当中表现得很稳, 在很大程度上是由于它见识过数量诸多之事物。 公开语料规模与成熟语言相比较而言, 前者作为一门年轻语言, 其规模远远小于后者, 所以天然地比较而言更加适宜用来针对一个问题展开观察:
AI 时代的新编程语言,如何被模型学习和理解?
临时给示例有用,但不够
论文先测试了两种常见方法:few-shot和RAG。
使用少量示例的方式, 是在其中放置几个代码示例, 以此让模型进行模仿。
RAG 会去从文档里检索与之相关的内容, 然后将这些内容放置进其中, 进而让模型能够去进行参考。
这两种办法均存在提升情况, 论文察觉到, 少见拍摄一般来讲要比方块区域小组略好些, 于那些的12组对照当中, 少见拍摄有8组比方块区域小组更具优势, 作者进行推测, 当面对陌生语言之际, 模型从代码示例里抓取语法, 常常要比从文档片段内领会规则更显直接。
但这类方法的上限也很明显。
一下子把几段代码或者文档塞进去, 仅仅能够补充一些语法方面的知识, 很难使得模型真正去掌握语言自身。
继续预训练:让模型真正学会
真正有效的是继续预训练。41DC.EAsyClAsS321.CoM
简约来讲, 便是不再使模型零时之下查阅资料, 而是径直去用代码以及官方文档持续训练模型。
论文里面, 那继续预训练的数据涵盖了大约1310万的code以及60万的某事物, 总共大概是1370万;与之相对比, 能够用来进行fine-的某数据仅仅只有大约50万。
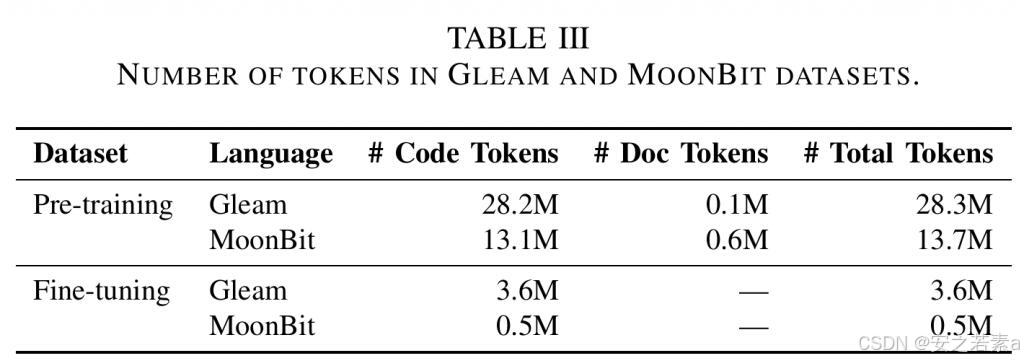
论文中用于 /Gleam 的预训练与微调数据规模
结果明显提升。
以Qwen 2.5 Coder 32B Base作为例子,在继续进行预训练以后, 模型在某方面的pass@1所达到的情况是:
:41.62%
MBPP:44.76%
-Hard:25.86%
这意味着, 从那种接近于完全不会进行书写的状态, 转变为能够在相当数量的给定任务当中, 撰写出能够顺利通过相关测试的代码, 这样的一种能力提升, 是能够被该模型以系统的方式逐步学会的。
指令迁移:既懂编程语言,也听懂开发者
不过,继续预训练还没有解决全部问题。
那个东西能够促使模型去学习语言方面的知识, 然而却不一定会使得模型在遵循用户下达的指令这件事情上变得更加擅长。真实存在的人工智能编程助手, 并非仅仅局限于代码的续写, 它还需要具备能够理解开发者所提出的要求的能力, 像是对类型错误展开解释, 对代码进行重构, 补充测试内容, 依据反馈对实现方式做出修改。
所以论文进一步使用了 。
它所秉持的思路如下: 首先借助代码以及文档促使 base model 实现学会这一状态, 而后将 model 的那种“指令跟随能力”转移至已然学过相应内容的模型之上。
如此这般所获取到的模型, 它既具备相应的理解能力, 又在很大程度上更近似于一个能够展开对话, 进而能够准确听懂相关需求的编程助手。
这一种方式呈现出了论文里头最为强劲的成果, 于Qwen 2.5 Coder 32B之上, 之后, 其pass@1达成了:
:50.71%
MBPP:53.04%
-Hard:32.60%
特别是那最难的-Hard, 从一开始的向着零样本极为靠近接近0, 提升转变到了32.60%。
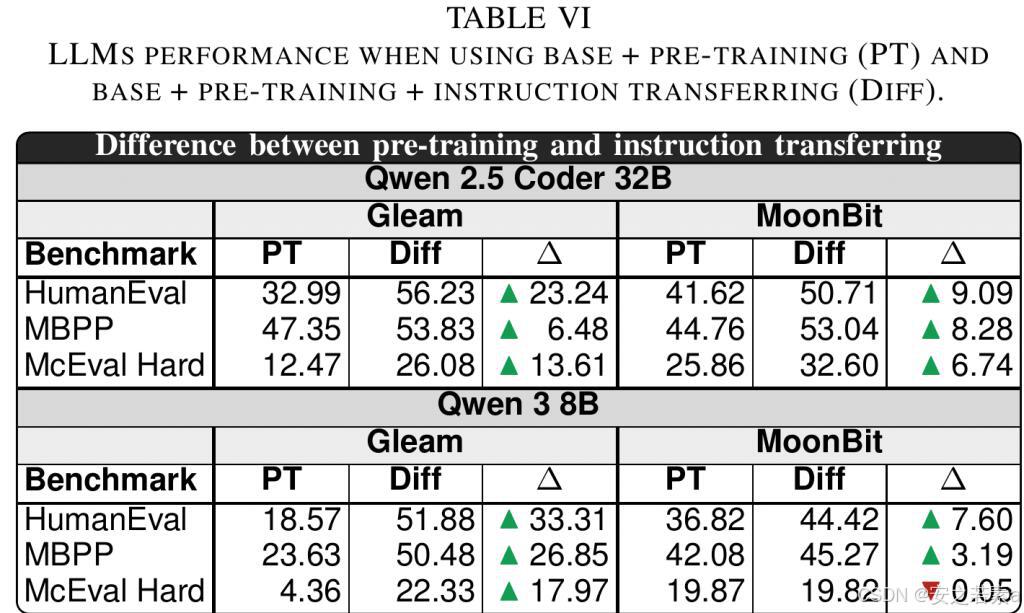
进一步预训练与 的效果对比
这儿一组数字的背后存在着一款焦点信号, 具备新语言的人工智能支持, 并非必然仅仅能去等待更为庞大的普遍模型自行覆盖, 借由具备高品质的代码, 以及官方所提供的文档,再加上适宜的训练方式, 能够以主动的方式去展开构建。
观察价值:让模型更容易学会新语言
这也是 值得观察的地方。
官方把它定义为针对云和边缘计算的 AI - 编程语言工具链, 此工具链支持 wasm、wasm - gc、js 以及后端, 并且支持于一个模块里构建混合后端的项目, 官方文档还把更小的 WASM 输出、更快的运行时性能、先进的编译性能, 还有简单实用、有着面向数据特性的语言设计当作了主要优势。
对 AI 编程来说,这一点很重要。
因AI写代码并非于一次就生成文本, 而是存在着一个循环, 语言设计越是清晰, 工具链反馈越是完整, 此循环便越是易于实现自动化。
不太明确你提供的内容中部分缺失信息后的完整句子究竟要表达什么确切意思, 不过大致按照要求改写如下: AI设计在语言结构方面也有所体现, 其官方博客曾展开某种讨论, 讨论内容为明确区分特定部分与local, 实行强制类型签名, 又采用特定方式, 以此减少额外嵌套代码块。博客还提及, 这种减少嵌套的设计不仅能够提升文本的可读性, 还对KV-cache更具某种作用, 在RAG、特定部分、特定部分等场景下有利于模型推理效率。
对于开发者而言, 这所意味的是代码组织更为清晰;对于模型来讲, 这所意味的是更适宜线性生成。模型无需于复杂嵌套结构里频繁地来回跳转, 上下文组织更加稳定, 生成错误也更易于被工具链及时发觉。
过去, 对一门编程语言作评价时, 一般会看性能, 看语法, 看类型系统, 看标准库, 看工具链, 还看生态等。到了AI编程时代, 还要再多一个维度, 这个维度就是模型是否容易学会这门语言。
这篇论文的价值正体现于此处, 它并非仅仅指出“大模型不会天然写新语言”, 更为关键的是给出了一条能够执行的路径, 先是进行构建, 从而知晓模型在哪方面存在欠缺, 接着借助真实代码以及官方文档持续开展训练, 以使模型掌握语言, 最后经由某种方式, 将指令跟随能力迁移回来。
这一路径里的表现表明, AI - 编程语言并非仅仅是个概念, 它能够在模型学习效率方面得以体现, 它能够在代码生成质量方面得以体现, 它还能够在工具链闭环里展现出工程优势。
大模型所具备的写很强的能力, 是源于它见识过数量众多的内容 , 刚开始大模型呈现出不熟悉的状态 , 这是由于其足够新颖的缘故 , 然而当模型切实接触到相关领域的代码,以及对应的文档 , 还有特定的语言设计之后 , 它能够实现快速的提升。
这也许正是 AI 时代新语言生态的核心问题:
不是等着模型在某一天自然而然地对你予以支持, 而是要起始于那语言, 起始于那文档, 起始于那工具链, 起始于那数据, 从而促使模型更易于去理解你。
更多推荐

 1
 0
- 0


 已为社区贡献96条内容

所有评论(0)