
Flink监控页面,到底该看什么?
第一次打开Flink的dashboard的时候,我也被那一堆花花绿绿的图表整懵了。
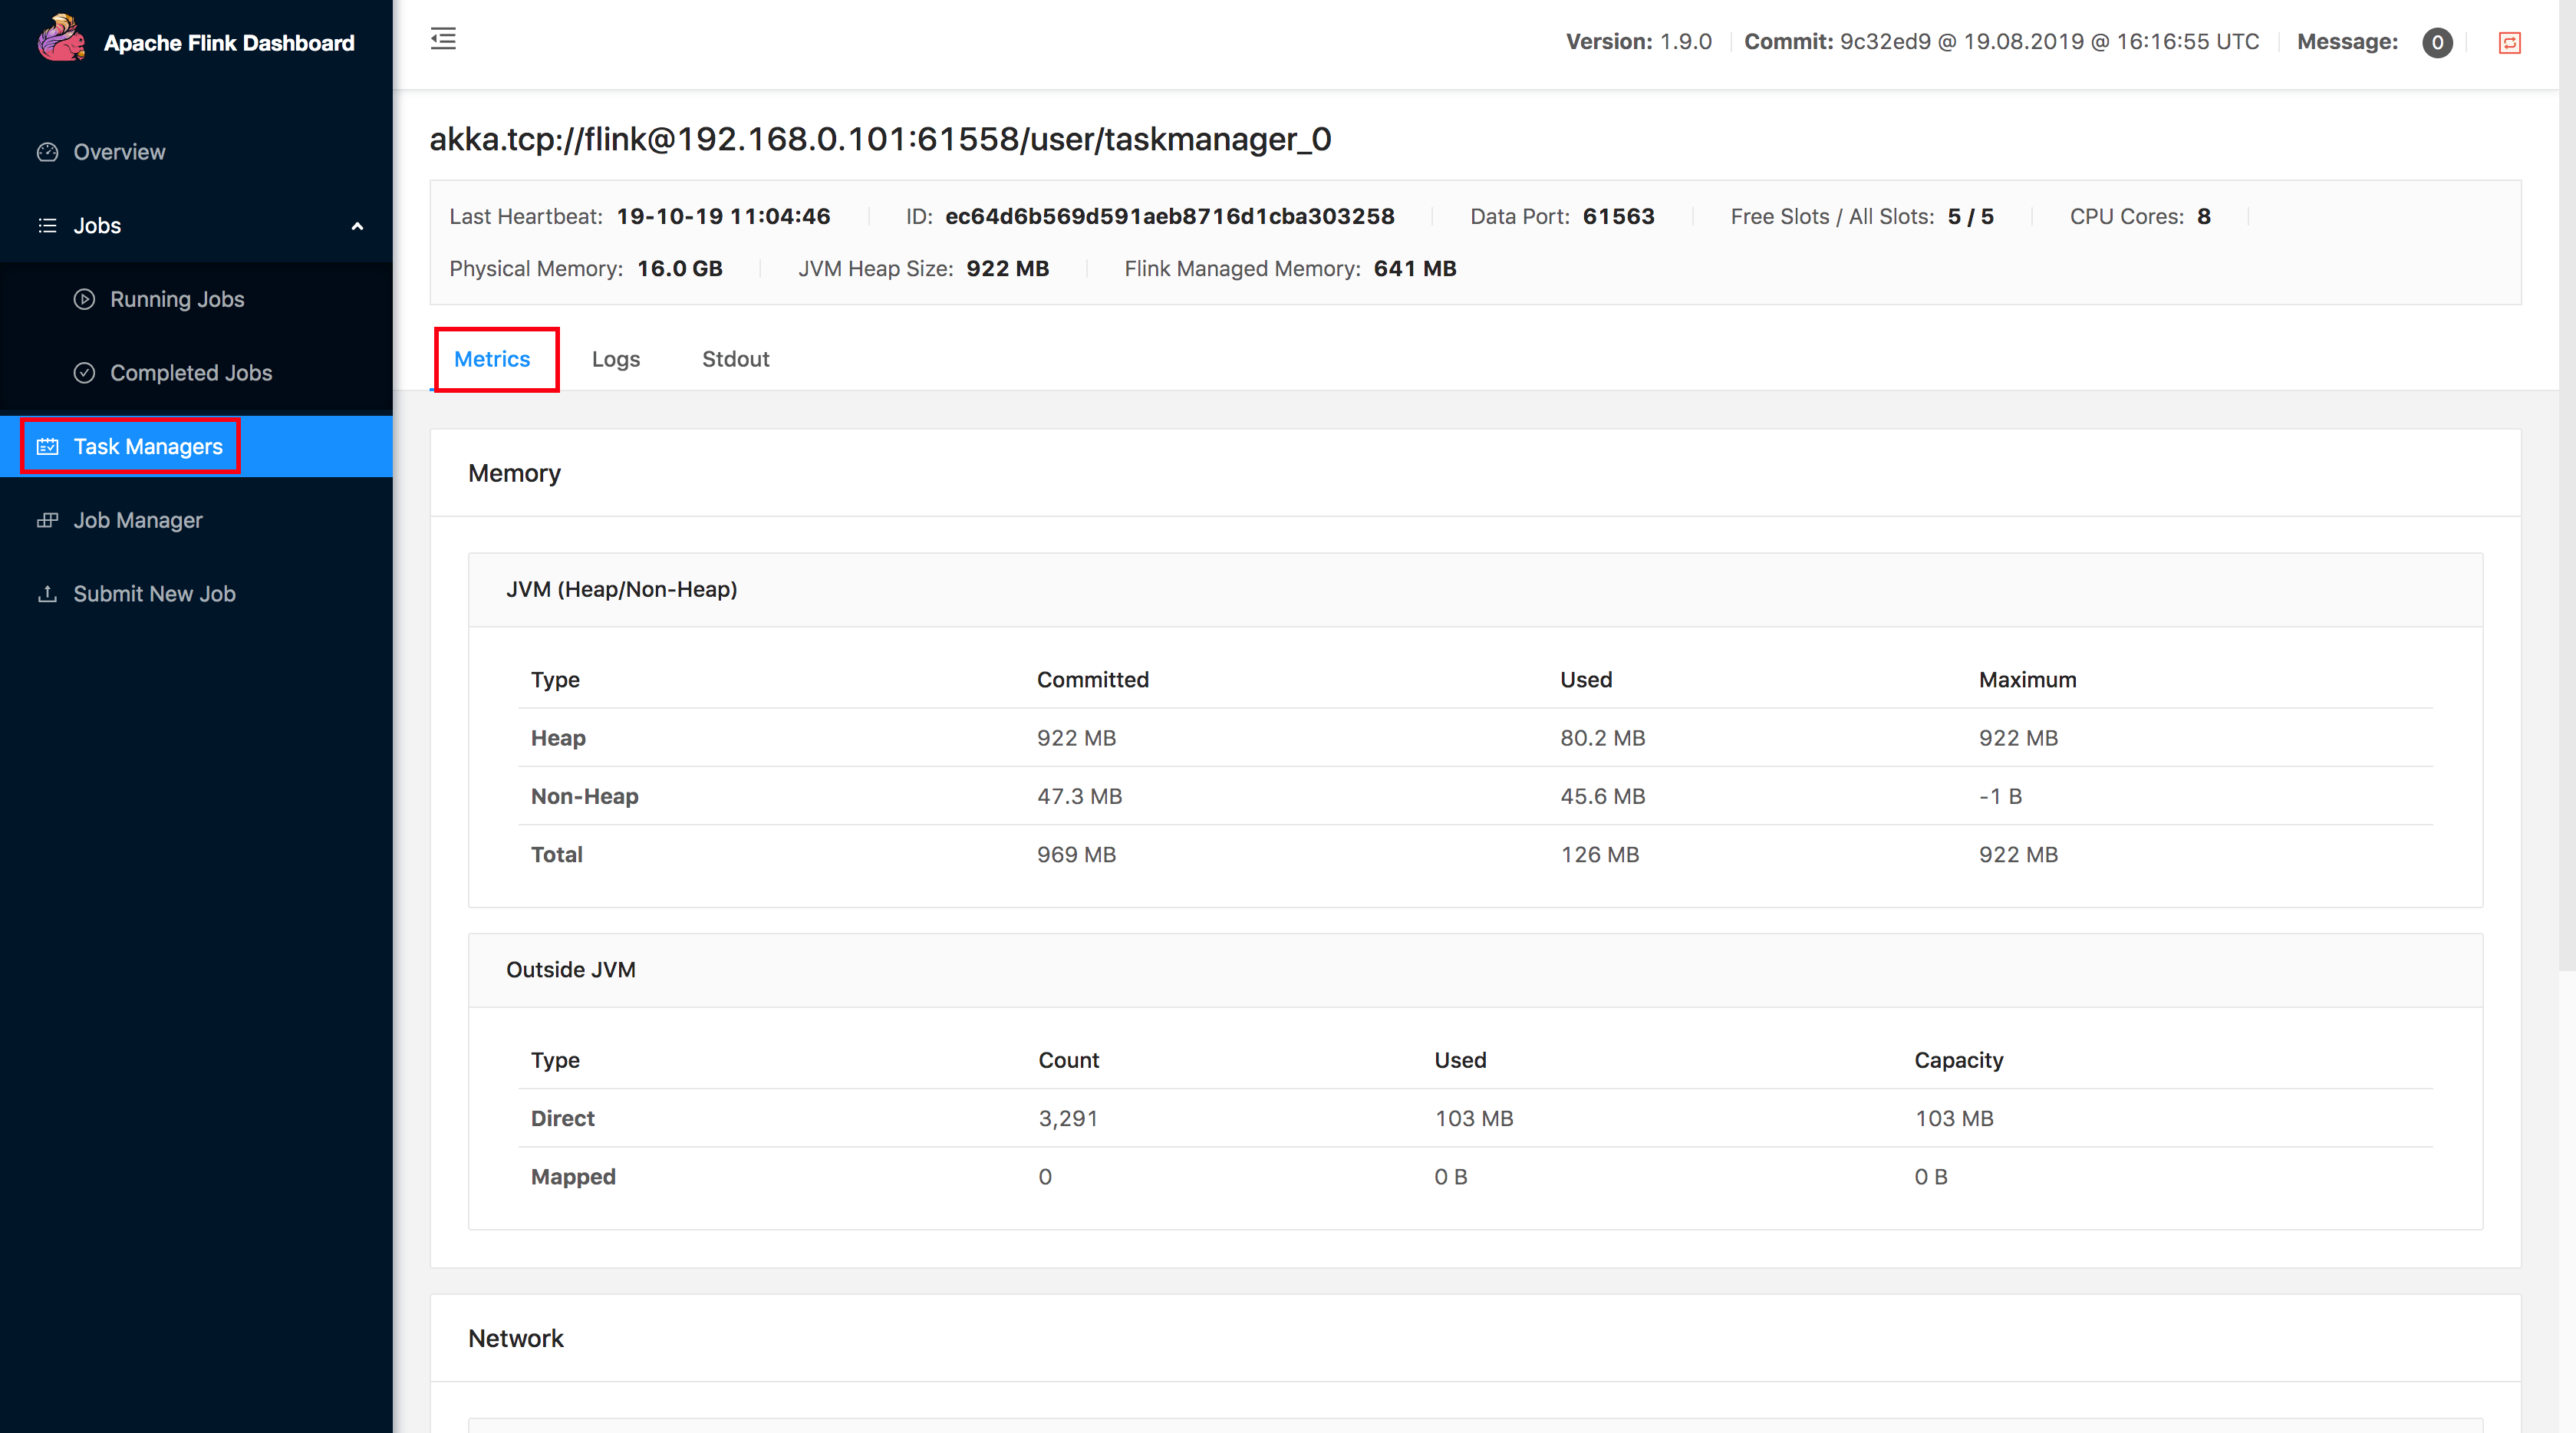
JobManager、TaskManager、Job、Task、Operator,各种名词堆在一起,直接晕了。后来学习了几年 Flink,才慢慢摸清门道。
Flink到底是个啥架构?
说实话,用Flink写SQL的人不少,但底层怎么跑的真没几个清楚。面试官问你架构答不上来?先把这张表记住。
| 角色 | 干啥的 |
|---|---|
| JobManager | 老大,调度任务 |
| TaskManager | 干活的,跑数据 |
| ResourceManager | 管资源的 |
| Dispatcher | 接客,收请求 |
你提交一个Job,Dispatcher接过来,JobManager调度,TaskManager执行。Standalone模式下你自己管机器,K8s或YARN的话集群管理器帮你管。部署模式对监控页面没啥影响,看起来都一样。
监控粒度有多细?
Flink监控分好几层,我画了个表:
| 监控层次 | 看啥 |
|---|---|
| Job 级别 | 整个作业的状态、吞吐量 |
| Task 级别 | 单个Task的执行时间 |
| Operator 级别 | 算子处理逻辑的细节 |
| 集群级别 | 整个集群的资源使用 |
| 系统级别 | CPU、内存、磁盘、网络 |
平时我看的最多的就是Job级别和集群级别。Task和Operator的,是出了问题的时候才会去看。你想啊,正常跑的时候看那些细粒度指标干嘛?
Metrics系统是干啥的?
Flink内置了一个Metrics系统,就是收集指标用的。主要有这几种:
- Counter:计数器,处理了多少条数据
- Gauge:仪表盘,当前值是多少
- Meter:速率,每秒处理多少条
- Histogram:分布,延迟分布长啥样
这些数据通过MetricReporter发送到Prometheus、InfluxDB、Grafana等地方。MetricGroup用来分组,不然指标混在一起看不过来。
打开dashboard之后看什么?
打开后几个页面:
Overview
最核心的总览页。能看到:
- 多少个TaskManager在跑
- 多少Slot可用/已用
- 正在运行的Job列表
- 最近完成的Job
这里TaskManager数量少了,说明有机器挂了,一眼就能看出来。
Jobs
所有Job的状态:
| 状态 | 啥情况 |
|---|---|
| RUNNING | 正常跑着 |
| FINISHED | 跑完了 |
| FAILED | 挂了,赶紧查 |
| CANCELED | 被人为取消的 |
看到FAILED我心都会咯噔一下。点进去看Exceptions,一般都能找到原因。
Job详情页
排查问题的核心战场。里面有几个tab:
- Timeline:执行时间线
- Exceptions:异常信息
- Configuration:配置参数
- Task列表:各个Task的状态
我排查问题就三步:先看Exceptions,再看Timeline,最后看Task指标。
TaskManager页面
看每个TaskManager的资源使用:
- CPU使用率:某个Task Manager一直飙高,可能有热点数据倾斜
- 内存使用:JVM Heap、Direct Memory、Managed Memory
- 网络使用:数据吞吐量
几个特别好用的功能
Backpressure可视化
这个功能太实用了。下游处理不过来,上游就会产生反压。Web UI上显示颜色:
| 颜色 | 状态 |
|---|---|
| 绿色 | 正常 |
| 黄色 | 轻微反压 |
| 红色 | 严重反压,赶紧处理 |
Checkpoint监控
Checkpoint是Flink的最重要的东西。我主要看这几个指标:
- Duration:一次Checkpoint花了多久
- Size:Checkpoint数据有多大
- Failed count:失败次数
要是Duration经常接近timeout阈值,说明状态太大,或者RocksDB Compaction占了时间。
Watermark
Watermark的处理乱序数据用的。Web UI可以查看每个Operator的Watermark情况。
Watermark一直不推进?那说明有数据迟到了,或者某个并行度卡住了。
Subtask分布
看看Task在各个TaskManager上的分布。数据倾斜的话,某些Subtask的数据量会远大于其他。
我有一次就是Key设计不合理,热点Key太多。加了随机前缀后才解决。
说点实在的
指标再多你也看不过来。我认为:
- Job状态和吞吐量——最直观
- Exceptions和Timeline——定位快
- 反压和Checkpoint——大部分问题跟这俩有关
- 不要过度优化——看到CPU高了就调参数,越调越差
我最开始用Flink的时候,总觉得要把所有指标都搞懂才算会了。后来才明白,指标看懂几个关键的就够了,剩下的用到再查。
更多推荐


 4
 0
- 0


 已为社区贡献4条内容

所有评论(0)