
第27篇:Java 8+新特性(一):Lambda表达式与Stream API,简化代码
一、前言
Java 8 是 Java 语言发展史上里程碑式的版本,于2014年正式发布,其中最核心、使用率最高的两大新特性就是Lambda表达式和Stream API。
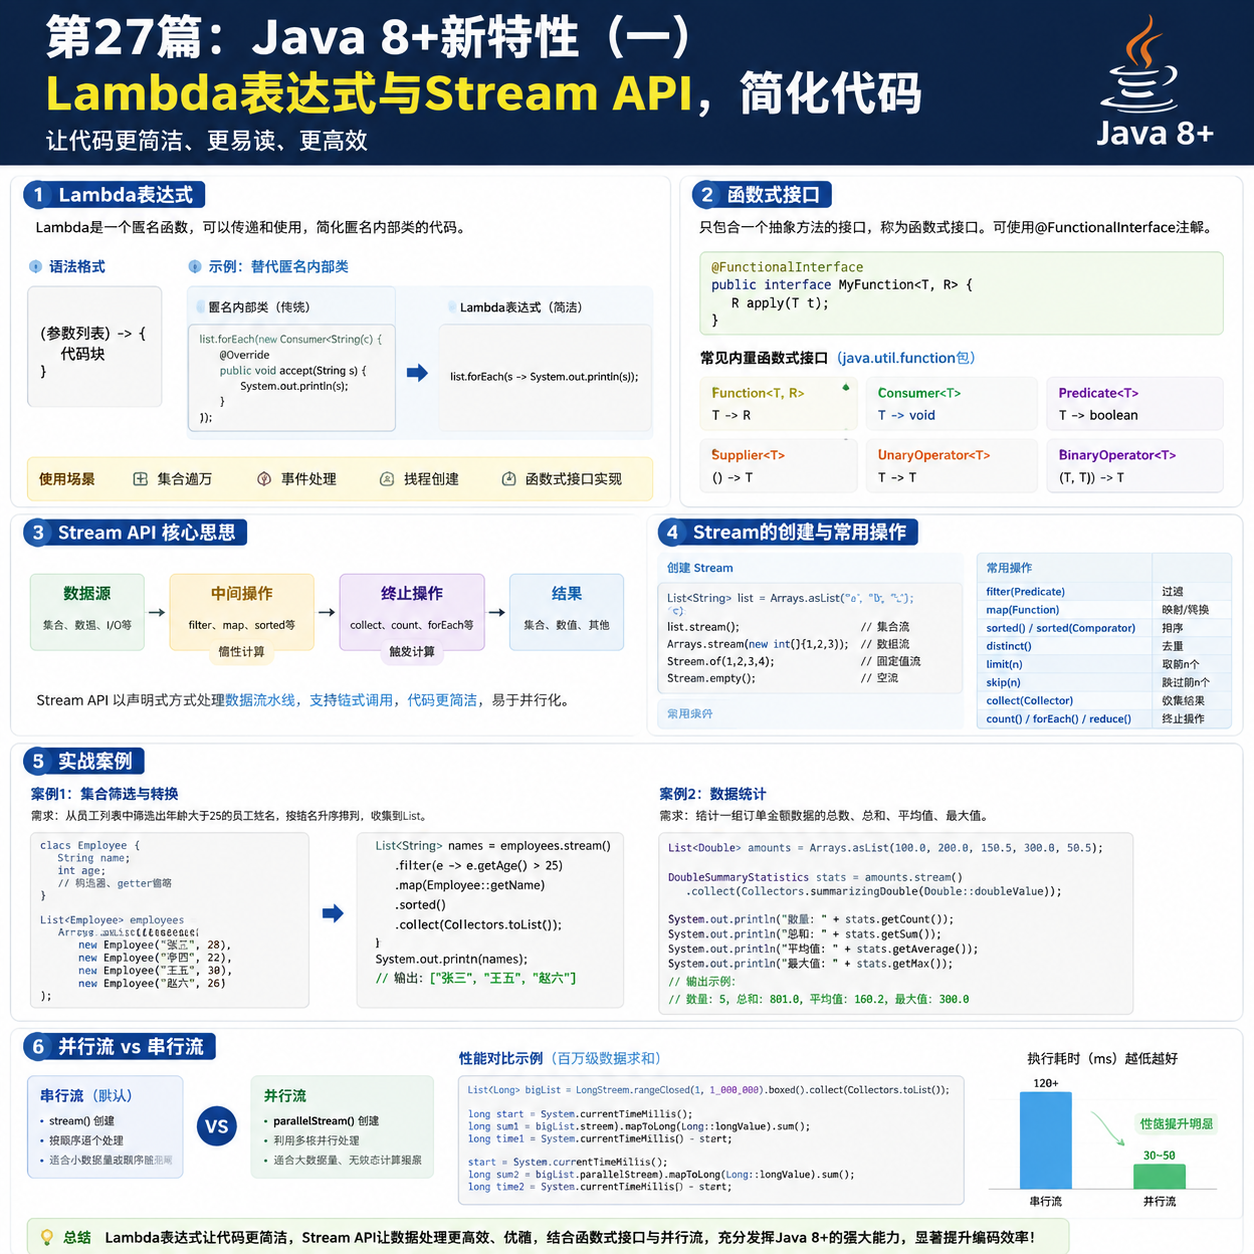
在Java 8之前,我们处理集合遍历、筛选、排序、统计等操作,往往需要编写大量冗余的匿名内部类代码,代码臃肿、可读性差、维护成本高。而Lambda表达式实现了函数式编程,简化了匿名内部类写法;Stream API则提供了一套声明式的集合操作方案,让集合数据处理从“繁琐的循环遍历”变成“简洁的链式调用”。
本文将从零讲解Lambda表达式语法、函数式接口核心概念,详解Stream API的创建、常用操作、串并行流对比,搭配实战案例,带你彻底掌握这两个高频新特性,大幅提升编码效率。
二、Lambda表达式:简化匿名内部类
2.1 什么是Lambda表达式
Lambda表达式是Java 8引入的匿名函数,没有方法名、修饰符、返回值声明,仅保留参数列表和方法体,核心作用是简化函数式接口的匿名内部类写法,让代码更简洁紧凑。
它可以将代码块作为参数传递,实现行为参数化,是Java迈向函数式编程的核心基础。
2.2 Lambda标准语法
通用语法格式:(参数列表) -> {方法体}
语法拆解与精简规则:
-
参数列表:对应抽象方法的参数,可省略参数类型(编译器自动推断);单个参数可省略括号
-
->:Lambda操作符,固定写法,分隔参数与方法体
-
方法体:方法具体逻辑,单行代码可省略大括号、return关键字
2.3 语法实战演示(新旧代码对比)
场景1:无参数、无返回值
// 传统匿名内部类写法
Runnable runnable = new Runnable() {
    @Override
    public void run() {
        System.out.println("传统线程执行");
    }
};

// Lambda简化写法
Runnable lambdaRunnable = () -> System.out.println("Lambda线程执行");
场景2:单个参数、有方法逻辑
// 传统写法
Consumer<String> consumer = new Consumer<String>() {
    @Override
    public void accept(String s) {
        System.out.println("接收参数:" + s);
    }
};

// Lambda简化写法(单参数省略括号,单行省略大括号)
Consumer<String> lambdaConsumer = s -> System.out.println("接收参数:" + s);
场景3:多参数、有返回值
// 传统写法
Comparator<Integer> comparator = new Comparator<Integer>() {
    @Override
    public int compare(Integer a, Integer b) {
        return a - b;
    }
};

// Lambda简化写法(多参数保留括号,单行返回省略return)
Comparator<Integer> lambdaComparator = (a, b) -> a - b;
2.4 Lambda使用核心前提
Lambda表达式只能用于函数式接口,这是硬性规则。想要彻底理解Lambda,必须先掌握函数式接口。
三、函数式接口(@FunctionalInterface)
3.1 定义与注解
函数式接口:有且仅有一个抽象方法的接口,专门用于适配Lambda表达式。
Java 8提供 @FunctionalInterface注解,用于强制校验接口格式:如果接口中存在多个抽象方法,编译直接报错,避免语法错误。该注解可省略,但建议显式添加,规范代码。
3.2 自定义函数式接口
@FunctionalInterface
public interface MyFunction {
    // 有且仅有一个抽象方法
    int calculate(int a, int b);
}
使用Lambda调用自定义接口:
// Lambda实现接口抽象方法
MyFunction add = (a, b) -> a + b;
MyFunction sub = (a, b) -> a - b;
System.out.println(add.calculate(10, 5)); // 15
System.out.println(sub.calculate(10, 5)); // 5
3.3 Java内置四大核心函数式接口
Java 8提前封装了常用函数式接口,无需重复定义,开发直接复用:
|
接口类型 |
抽象方法 |
作用 |
|---|---|---|
|
Consumer<T> 消费型 |
void accept(T t) |
接收参数,无返回值(消费数据) |
|
Supplier<T> 供给型 |
T get() |
无参数,返回数据(生产数据) |
|
Function<T,R> 函数型 |
R apply(T t) |
接收T参数,返回R结果(数据转换) |
|
Predicate<T> 断言型 |
boolean test(T t) |
接收参数,返回布尔值(条件判断) |
四、Stream API:高效处理集合数据
4.1 Stream核心思想
Stream(流)是Java 8专为集合、数组数据处理设计的API,核心思想是声明式编程:只需告诉程序“需要做什么”,无需关注“怎么做”。
Stream通过链式调用完成数据筛选、转换、排序、统计、聚合等操作,摒弃传统for循环的冗余代码,且不会修改原数据源,每次操作都会生成新流。
Stream操作分为三步:创建流 → 中间操作(链式处理) → 终止操作(触发执行)
注意:Stream流只能使用一次,终止操作执行后,流会自动关闭,无法重复调用。
4.2 Stream的4种创建方式
// 1. 集合创建流(最常用)
List<String> list = Arrays.asList("Java", "Python", "Go");
Stream<String> stream = list.stream(); // 串行流
Stream<String> parallelStream = list.parallelStream(); // 并行流

// 2. 数组创建流
String[] arr = {"张三", "李四", "王五"};
Stream<String> arrStream = Arrays.stream(arr);

// 3. 静态方法创建单个/多个元素流
Stream<String> ofStream = Stream.of("1", "2", "3");

// 4. 创建空流
Stream<Object> emptyStream = Stream.empty();
4.3 Stream常用中间操作(链式处理)
中间操作属于延迟执行,不会立即执行,只有触发终止操作时才会批量执行,支持链式拼接。
4.3.1 filter:条件筛选
基于Predicate断言接口,过滤符合条件的元素。
// 筛选长度大于3的字符串
List<String> filterList = list.stream()
        .filter(s -> s.length() > 3)
        .collect(Collectors.toList());
4.3.2 map:数据转换
基于Function函数接口,将元素进行类型转换、数据加工。
// 字符串转大写
List<String> upperList = list.stream()
        .map(String::toUpperCase)
        .collect(Collectors.toList());

// 数字集合翻倍
List<Integer> numList = Arrays.asList(1,2,3,4);
List<Integer> doubleList = numList.stream()
        .map(n -> n * 2)
        .collect(Collectors.toList());
4.3.3 sorted:排序
支持自然排序(无参)和自定义规则排序(带比较器)。
// 自然排序(升序)
List<Integer> sortList = numList.stream()
        .sorted()
        .collect(Collectors.toList());

// 自定义降序排序
List<Integer> descList = numList.stream()
        .sorted((a,b) -> b - a)
        .collect(Collectors.toList());
4.3.4 其他常用中间操作
-
distinct():去重,基于equals和hashCode方法
-
limit(n):截取前n个元素
-
skip(n):跳过前n个元素
-
flatMap():扁平化处理,将嵌套集合转为单层集合
4.4 Stream常用终止操作
终止操作触发流的执行,执行后流关闭,是链式调用的最后一步。
4.4.1 collect:收集结果(最核心)
将流数据收集为集合、字符串、Map等格式,Collectors提供丰富收集规则。
// 收集为List
list.stream().collect(Collectors.toList());
// 收集为Set
list.stream().collect(Collectors.toSet());
// 拼接字符串
String joinStr = list.stream().collect(Collectors.joining(","));
4.4.2 数据统计操作
// 统计数量
long count = numList.stream().count();
// 最大值、最小值
Integer max = numList.stream().max(Integer::compareTo).get();
Integer min = numList.stream().min(Integer::compareTo).get();
// 求和、平均值
int sum = numList.stream().mapToInt(Integer::intValue).sum();
double avg = numList.stream().mapToInt(Integer::intValue).average().getAsDouble();
4.4.3 遍历与匹配
// 遍历
numList.stream().forEach(System.out::println);
// 匹配判断
boolean anyMatch = numList.stream().anyMatch(n -> n > 3); // 存在元素满足条件
boolean allMatch = numList.stream().allMatch(n -> n > 0); // 全部元素满足条件
五、Stream串行流与并行流对比
5.1 核心区别
-
串行流(stream()):单线程执行,按集合顺序逐个处理元素,线程安全,适合小数据量、有序操作
-
并行流(parallelStream()):基于Fork/Join框架多线程并行执行,拆分任务并发处理,效率更高,适合大数据量、无序统计操作
5.2 代码演示与效率对比
// 生成100万条数据
List<Integer> bigList = new ArrayList<>();
for (int i = 0; i < 1000000; i++) {
    bigList.add(i);
}

// 串行流求和
long start1 = System.currentTimeMillis();
long sum1 = bigList.stream().mapToLong(Long::valueOf).sum();
long end1 = System.currentTimeMillis();
System.out.println("串行流耗时:" + (end1 - start1) + "ms");

// 并行流求和
long start2 = System.currentTimeMillis();
long sum2 = bigList.parallelStream().mapToLong(Long::valueOf).sum();
long end2 = System.currentTimeMillis();
System.out.println("并行流耗时:" + (end2 - start2) + "ms");
5.3 使用场景建议
-
优先串行流:数据量小、需要保证遍历顺序、存在线程安全操作
-
优先并行流:大数据量、纯计算无共享变量、无需保证顺序、统计聚合操作
-
禁忌:并行流中操作共享变量、依赖执行顺序,会出现数据错乱问题
六、综合实战案例:集合数据处理
需求:定义用户集合,完成筛选、转换、排序、统计全套操作,对比传统for循环与Stream+Lambda写法。
6.1 实体类定义
@Data
@AllArgsConstructor
@NoArgsConstructor
class User {
    private String name; // 姓名
    private Integer age; // 年龄
    private Integer score; // 分数
}
6.2 传统for循环写法(代码冗余)
// 初始化数据
List<User> userList = Arrays.asList(
        new User("张三", 22, 85),
        new User("李四", 20, 92),
        new User("王五", 25, 78),
        new User("赵六", 21, 96)
);

// 需求:筛选年龄>20、分数>80的用户,按分数降序,提取姓名
List<String> userNameList = new ArrayList<>();
// 筛选
for (User user : userList) {
    if (user.getAge() > 20 && user.getScore() > 80) {
        userNameList.add(user.getName());
    }
}
// 排序
Collections.sort(userNameList, (a,b) -> b.compareTo(a));
System.out.println("传统写法结果:" + userNameList);
6.3 Stream+Lambda极简写法
List<String> resultList = userList.stream()
        // 条件筛选:年龄大于20且分数大于80
        .filter(user -> user.getAge() > 20 && user.getScore() > 80)
        // 按分数降序排序
        .sorted((u1, u2) -> u2.getScore() - u1.getScore())
        // 只提取用户姓名
        .map(User::getName)
        // 收集为集合
        .collect(Collectors.toList());

System.out.println("Stream写法结果:" + resultList);

// 额外统计:平均分、最高分
Double avgScore = userList.stream()
        .mapToInt(User::getScore)
        .average()
        .getAsDouble();
Integer maxScore = userList.stream()
        .mapToInt(User::getScore)
        .max()
        .getAsInt();

System.out.println("平均分:" + avgScore + ",最高分:" + maxScore);
七、总结:新特性带来的编码提升
通过本文的学习,我们可以清晰感受到Java 8 Lambda+Stream API的核心优势:
-
代码极简:彻底告别匿名内部类、冗余for循环,几十行代码可精简为几行,大幅减少模板代码
-
可读性强:链式调用逻辑清晰,代码语义直白,一眼看懂“筛选、排序、转换”的业务逻辑
-
效率更高:并行流轻松实现多线程并发处理,大数据量场景下性能远超传统循环
-
编程范式升级:从面向过程的循环遍历,升级为函数式、声明式编程,贴合现代编程思想
Lambda表达式与Stream API是Java开发的必备技能,日常开发中集合处理、数据统计、筛选排序等场景均可无脑使用,熟练掌握可大幅提升开发效率和代码质量。后续章节将继续讲解Java8其他新特性(Optional、日期时间新API等)。
更多推荐


 10
 0
- 0


 已为社区贡献13条内容

所有评论(0)