
企业混用多 AI 大模型,实际故障低估幅度高达 2.25 倍
不少企业会搭建多模型调度架构,将用户请求分流至代码专用模型、逻辑推理模型与通用大模型,默认不同模型能够互补短板。但一项覆盖 21 家厂商、67 款前沿大模型的全新研究证实:该设想存在根本性数学缺陷,学界将其命名为共故障上限(co-failure ceiling)。
一、大众误区:多模型天然互补避错
行业普遍存在一套理想化逻辑:只要多款模型极少在同一提示词上出错,组合部署就能构建容错防护网。
但多模型调度方案真正的性能瓶颈,不在于模型输出分歧的频次,而在于全部模型同步答错同一问题的提示词占比。企业忽视共故障上限,耗费大量成本搭建复杂调度系统,最终却无法兑现预期性能提升。好在研发人员可借助同款数学逻辑,搭建零成本测试工具,精准判断多模型架构是否具备投入价值。
二、多模型混合部署暗藏隐性成本
目前主流多语言大模型调度架构分为三类,均会产生隐形推理开销:
- 模型路由架构:如同流量调度员,复杂请求分发至高成本高精度模型,简单请求分配低成本轻量模型;
- 级联架构:全部请求先经廉价模型处理,置信度不足时再升级至高端模型二次运算;
- 智能体混合架构(MoA):向多款模型下发同一问题,融合全部输出生成综合答案。
上述架构会带来三重隐性损耗:推理延迟升高、基础设施运维复杂度翻倍、对接多家厂商 API 带来更高合规管控风险。
工程师筛选模型组合时,通常依靠「成对错误相关性」做判断。举个例子:A 模型擅长 Python 代码但 SQL 能力薄弱,B 模型精通 SQL 却写不好 Python,二者错误相关性低。开发者便认为叠加路由层后,整套系统在代码场景几乎不会出错。
但研究指出:仅依靠低错误相关性堆砌模型,若各模型能力层级差距过大,反而会降低整体效果。多模型投票机制中,大量弱模型输出会抱团压制最优模型的正确结果。
论文作者约瑟夫・陈向 VentureBeat 透露实验数据:「对能力参差不齐的模型简单采用多数投票,整体准确率反而下降,混合高难度样本下平均得分直接降低 10 分。弱模型群体票数会盖过最优模型。」
研发实操建议:仅组合能力层级匹配的大模型;若无法做到能力对齐,直接选用单款最优模型,预算全部倾斜头部模型。
混合智能体架构(MoA)存在唯一利好:业内常用「自混合智能体 Self-MoA」方案,重复调用同一款高端模型多次再整合答案。实验证明,当模型能力处于同一梯队时,多款低相关模型组成的混合集合,性能优于单一模型重复调用的自混合方案。
但致命问题在于:企业依靠成对错误相关性预判整套系统综合准确率时,数学逻辑完全失效。
陈补充道:「企业前期承担调度带来的延迟、运维、多厂商对接成本,寄希望于模型多样性带来性能增益,现实中往往落空。当前顶尖大模型输出高度趋同,更关键的是,它们会在同一类难题上集体失效;面对边界模糊的复杂提示词,没有可靠特征能预判哪一款模型能给出正确答案。」
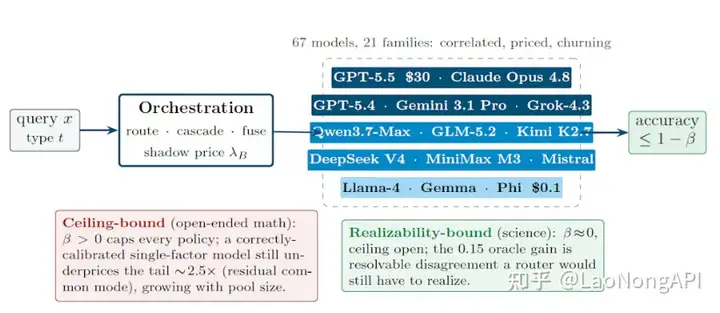
多LLM环境中67个领先LLM的研究(来源:arXiv)
三、核心理论:共故障上限为何推翻传统算法
本次研究核心指标为共故障率,即全部模型同步答错的场景占比,任何路由、投票、级联架构的准确率,都无法突破该上限。
常规业务场景下,代码、逻辑、通用三类模型单独出错的重合度很低;但共故障上限对应极其晦涩、复杂度拉满的极端边界案例。一旦提示词难度突破所有模型能力阈值,全部模型同时幻觉、答错,再智能的路由分配也无法挽回结果。
研究团队选取 GPT-5.5、Claude Opus 4.8、Gemini 3.1 Pro 等 67 款主流模型,在开放式数学基准测试集 MATH-500 开展实验:
依靠传统成对相关性算法测算,模型集体答错题目占比仅 2.3%;实测真实共故障率高达 5.2%。
传统评估方式将故障规模低估约 2.25 倍。根源并非题目本身难度独立,而是所有模型共享统一失效盲区。
陈解释「共通失效原子」概念:存在一类固定问题样本,市面上绝大多数大模型都会同步出错,这类盲区无法通过成对相关性统计发现;即便新增第 20 款模型,也无法覆盖这类极端失效场景,失效长尾问题是全行业共性。
同时任务形式会直接加剧共故障现象:研究采用 GPQA 研究生科学考题,将选择题改为开放式问答题后,全模型同步答错的样本占比飙升至 12.7%。
研发仍有优化方案,但结论并不乐观:「多模型架构在开放式生成场景(企业最需要容错的场景)提升效果最弱。但凡能将文本生成转化为结果校验、限定输出格式(结构化输出、可核验答案、代码执行测试),就能突破共故障上限约束。」
共故障上限会从两大维度限制 AI 落地,分两类场景:
- 上限约束型场景(开放式数学等):共故障率高,任务难度超出所有模型底层能力,再多路由调度也无法弥补能力短板;
- 实现约束型场景(研究生理科问答等):共故障率趋近于 0,集合中至少一款模型能答对,但模型间答案差异极小,若无全知校验工具,路由系统无法精准筛选正确输出。
四、零成本上线前校验方案:Clopper-Pearson 置信区间算法
企业投入人力开发调度系统前,可借助 Clopper-Pearson 置信区间公式,零成本测算整套系统性能理论上限。
该算法用于测算最坏情况误差区间:例如抛 10 次硬币 8 次正面,不能认定长期正面概率稳定 80%;算法仅需少量测试样本,就能给出具备数学严谨性的故障上限。
落地示例:研发团队选取 5 款模型,测试 50 条样本,仅 2 道题目全模型答错,直观判断系统准确率可达 96%;但 Clopper-Pearson 公式会修正乐观预估,结合小样本误差计算得出真实共故障率最高可达 12%。
落地实操步骤:
- 搭建独立隔离测试数据集:例如金融科技企业提取上季度 200 条复杂客服工单,人工生成标准标准答案作为基准;
- 成熟研发团队可全流程自动化上限测算,无需大量人工成本;
- 算法接入极简:仅统计现有评估日志数据,可嵌入 CI 自动化流程,模型池、业务场景更新后自动重测。
团队将候选模型批量跑测 200 条工单并记录结果,评估多模型组合方案时,仅凭共故障率即可预判系统理论最高准确率,无需重复调用模型做海量测试。
研究关键落地结论:答案可精准核验的业务场景中,除非具备极强的请求分层特征,否则多模型组合性能很难超越单款最优头部模型。
企业可核验型业务包含:零报错可执行 SQL 生成、从数十页 PDF 提取精准发票金额、严格匹配规范的 JSON 格式化输出。这类场景,直接采购顶尖单模型,远比拼接多款廉价模型、寄希望路由筛选答案更划算。
注:本次实验未覆盖营销文案等主观、无统一标准答案的场景,该结论是否适用仍待验证。
该校验工具无任何成本,企业可跟随新模型迭代持续监控自身业务共故障率。
总结:「监测零成本,各团队可跟踪历代模型的失效长尾变化,观察共故障区间是否收窄。企业优化核心抓手是差异化失效模式、跟进行业新模型迭代,而非单纯堆砌模型数量。」
Enterprises using multiple AI models are underestimating failure rates by 2.25x | VentureBeat
更多推荐


 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)